
Corso
Retrieval Augmented Generation (RAG) con LangChain
3 ore
20.8K
Wan2.1 di Qwen è un modello open-source di generazione video progettato per essere potente e accessibile, dato che può girare su GPU di fascia consumer.
Grazie alle sue ottime prestazioni, Wan2.1 compete con modelli open-source come HunyuanVideo e SkyReels e con soluzioni commerciali come Sora e Runway.
In questo articolo esplorerò cos’è Wan2.1, le sue caratteristiche principali e come funziona. Inoltre ti guiderò su come accedervi e usarlo per generare video da vari prompt, mostrando le sue capacità in azione.
Wan 2.1 è un avanzato modello di generazione video sviluppato da Qwen. Appartiene a una famiglia di foundation model video su larga scala, il che significa che può creare video di alta qualità da diversi tipi di input, in questo caso descrizioni testuali e immagini.
Wan 2.1 unisce una potente generazione video all’accessibilità. Può girare su GPU di fascia consumer, a differenza di molti altri modelli video di AI che richiedono hardware costoso, rendendolo più pratico. Inoltre è open source.
Si basa sulla tecnologia diffusion transformer, un approccio che gli consente di generare video fluidi e realistici con un’impressionante qualità del movimento. Wan 2.1 introduce anche un esclusivo Video Variational Autoencoder (VAE), che aiuta a mantenere coerenza e dettaglio, anche a risoluzioni più alte come 1080p.
Ecco le sue caratteristiche chiave:
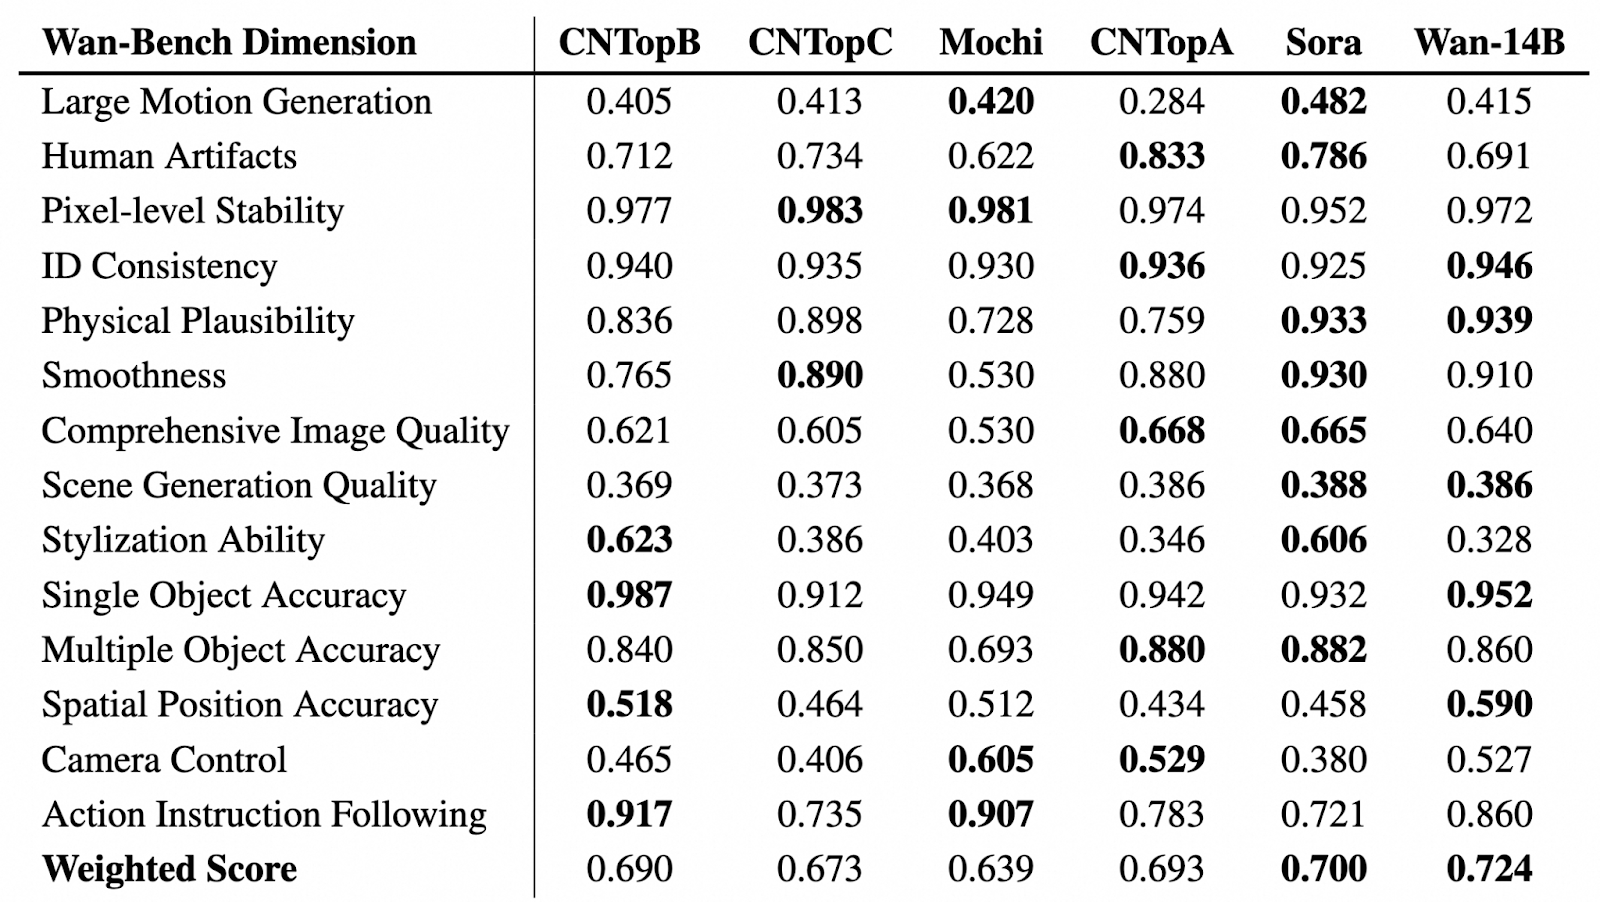
Wan 2.1 supera sia modelli video AI open-source sia commerciali in molteplici benchmark, il che significa che produce video più realistici e di qualità superiore rispetto a molte alternative.
Fonte: GitHub (Wan-Video/Wan2.1)
Nella tabella sopra, vediamo una valutazione comparativa dei modelli di generazione video lungo diverse dimensioni di Wan-Bench, che misurano prestazioni in aspetti chiave come generazione del movimento, stabilità visiva, accuratezza degli oggetti e aderenza alle istruzioni. Il modello con le prestazioni più alte in ogni categoria è evidenziato in grassetto.
Wan-14B ottiene il punteggio ponderato complessivo più alto (0,724), dimostrando solide capacità su più benchmark.
Rispetto alla maggior parte dei modelli video AI di fascia alta che richiedono hardware costoso, il modello T2V-1.3B di Wan 2.1 necessita solo di 8,19 GB di VRAM. Significa che puoi generare video con una GPU normale, come una RTX 4090, in pochi minuti senza bisogno di un supercomputer.
Con Wan, puoi fare molto più che Text-to-Video (T2V). Offre funzionalità avanzate per migliorare la generazione e la personalizzazione dei video, tra cui:
Inoltre, Wan supporta Image-to-Video (I2V), così puoi trasformare immagini statiche in video animati. Puoi aggiungere prompt testuali opzionali per un controllo maggiore sulla generazione e definire il primo e l’ultimo fotogramma per impostare composizione e flusso del video.
Wan 2.1 è il primo modello video di AI in grado di generare testo leggibile all’interno dei video sia in inglese sia in cinese. È ottimo per creare sottotitoli, testo animato e overlay grafici nei contenuti video.
Wan 2.1 utilizza un avanzato Video Variational Auto Encoder (Wan-VAE) che gli consente di:
Ci sono diversi modi per iniziare: puoi provarlo online oppure eseguirlo in locale sul tuo computer.
Se vuoi sperimentare con Wan 2.1 senza installare nulla, puoi accedervi tramite:
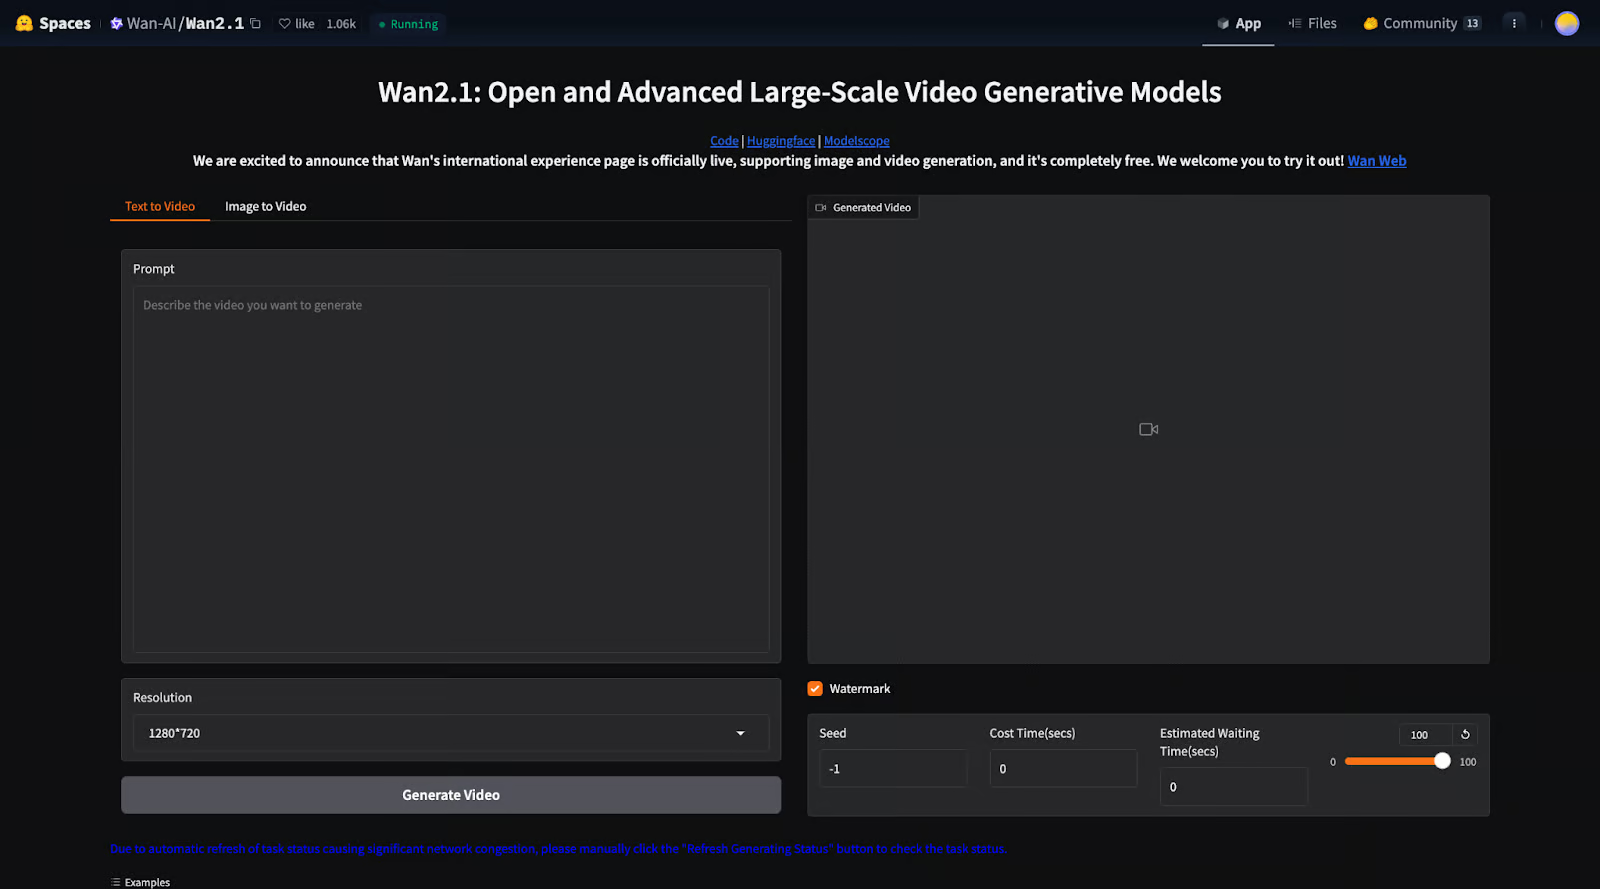
1. Space su Hugging Face: puoi eseguire il modello direttamente in un’interfaccia web.
2. Sito web di WanVideo: qui puoi fare più che generare video. Il sito ufficiale consente anche di creare immagini ed esplorare una raccolta di video e immagini generati da altri utenti, insieme ai prompt utilizzati.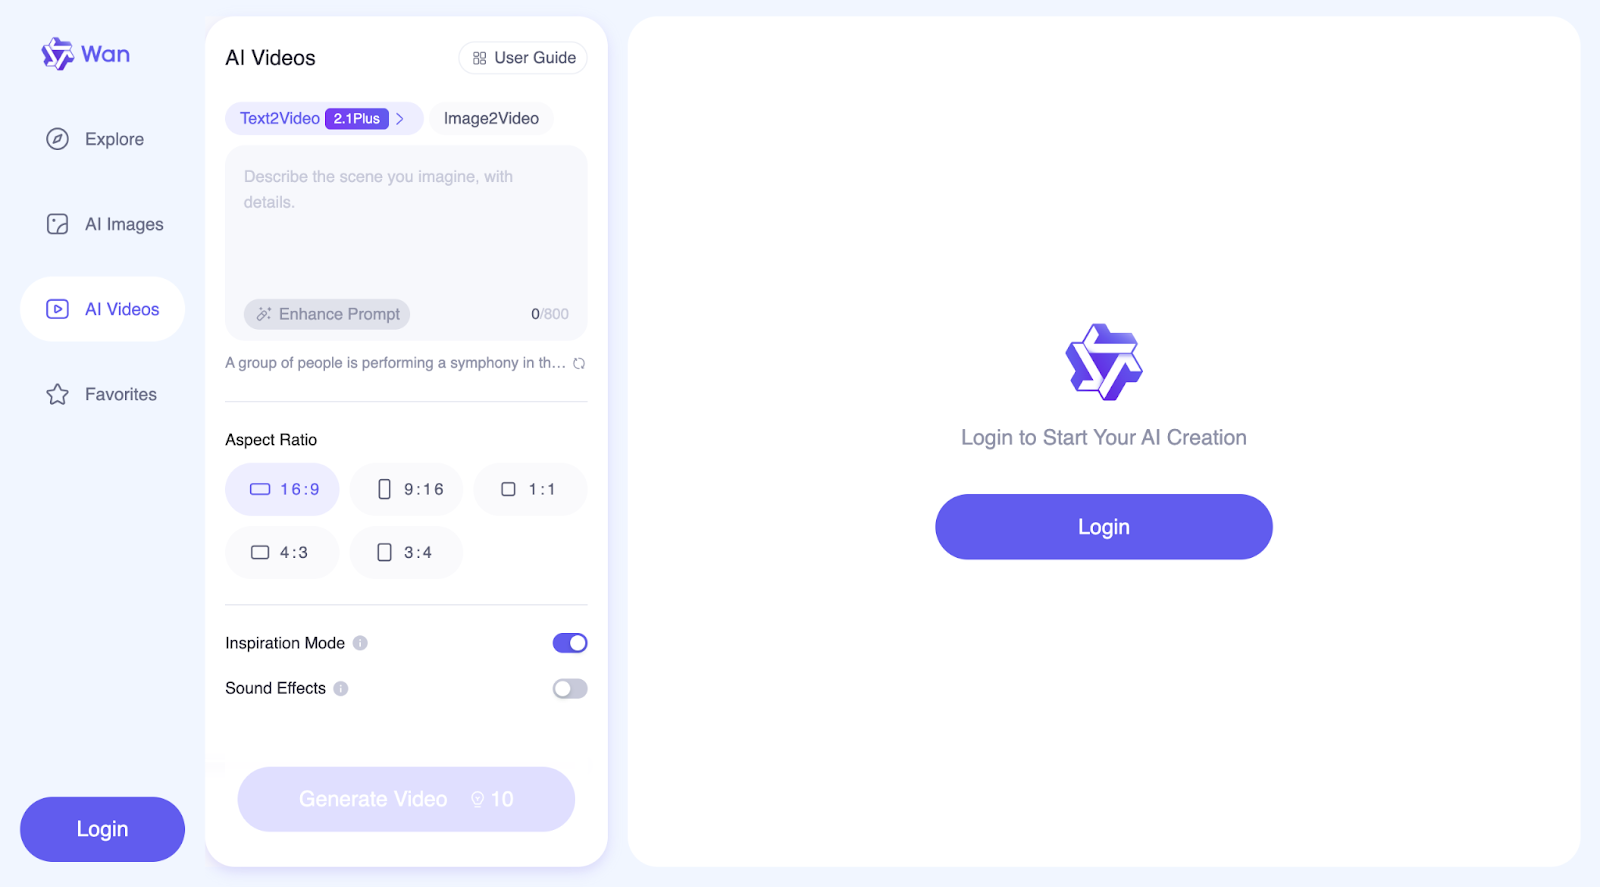
Queste opzioni ti permettono di testare rapidamente il modello senza preoccuparti di setup o hardware.
Se vuoi pieno controllo e personalizzazione, puoi installare Wan 2.1 sulla tua macchina. Vediamo passo passo come fare:
Per prima cosa, scarica il codice di Wan 2.1 da GitHub:
git clone https://github.com/Wan-Video/Wan2.1.git
cd Wan2.1Assicurati di avere Python e PyTorch (versione 2.4.0 o successive) installati, quindi installa le librerie richieste:
pip install -r requirements.txtDevi scaricare i file del modello pre-addestrato da Hugging Face (maggiori info qui) o ModelScope (maggiori info qui).Esistono diversi modelli che puoi scaricare:
|
Modelli |
Link per il download |
Note |
|
T2V-14B |
Supporta 480P e 720P |
|
|
I2V-14B-720P |
Supporta 720P |
|
|
I2V-14B-480P |
Supporta 480P |
|
|
T2V-1.3B |
Supporta 480P |
Il modello 1.3B può generare video in risoluzione 720P, ma dato che ha avuto un addestramento più limitato a questa qualità, i risultati potrebbero essere meno stabili rispetto a 480P. Per le prestazioni migliori, è consigliata la risoluzione 480P.
Wan 2.1 ti permette di generare video da descrizioni testuali usando due versioni del modello:
Se vuoi semplicemente generare un video velocemente, puoi usare i seguenti comandi, dove il miglioramento del prompt non è abilitato.
Per il modello T2V-14B (qualità più alta, modello più grande):
python generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt "A futuristic city with flying cars and neon lights."Per il modello T2V-1.3B (più piccolo, gira su GPU meno potenti):
python generate.py --task t2v-1.3B --size 832*480 --ckpt_dir ./Wan2.1-T2V-1.3B --prompt "A futuristic city with flying cars and neon lights."Se il tuo computer esaurisce la memoria (errore OOM), puoi usare --offload_model True e --t5_cpu per ridurre l’uso di memoria.
Se hai più GPU, puoi velocizzare la generazione video eseguendo questo comando:
torchrun --nproc_per_node=8 generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --dit_fsdp --t5_fsdp --ulysses_size 8 --prompt "A futuristic city with flying cars and neon lights.`Questo consente di suddividere il carico su più GPU, rendendo il processo più veloce.
Wan 2.1 può migliorare automaticamente il tuo prompt, così da rendere il video più dettagliato e visivamente accattivante.
Ci sono due modi per estendere il prompt:
Per usare la Dashscope API:
DASH_API_KEY=your_key python generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt "A futuristic city with flying cars and neon lights." --use_prompt_extend --prompt_extend_method 'dashscope'Per usare il tuo modello locale:
python generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt "A futuristic city with flying cars and neon lights." --use_prompt_extend --prompt_extend_method 'local_qwen'Se preferisci usare la libreria Diffusers di Hugging Face invece di eseguire script grezzi, puoi generare un video con Python:
import torch
from diffusers.utils import export_to_video
from diffusers import AutoencoderKLWan, WanPipeline
from diffusers.schedulers.scheduling_unipc_multistep import UniPCMultistepScheduler
# Available models: Wan-AI/Wan2.1-T2V-14B-Diffusers, Wan-AI/Wan2.1-T2V-1.3B-Diffusers
model_id = "Wan-AI/Wan2.1-T2V-14B-Diffusers"
# Load the autoencoder for video generation
vae = AutoencoderKLWan.from_pretrained(model_id, subfolder="vae", torch_dtype=torch.float32)
# Define the scheduler for controlling video motion flow
flow_shift = 5.0  # 5.0 for 720P, 3.0 for 480P
scheduler = UniPCMultistepScheduler(
    prediction_type='flow_prediction',
    use_flow_sigmas=True,
    num_train_timesteps=1000,
    flow_shift=flow_shift
)
# Load the video generation pipeline with the model
pipe = WanPipeline.from_pretrained(model_id, vae=vae, torch_dtype=torch.bfloat16)
pipe.scheduler = scheduler
pipe.to("cuda")
# New prompt
prompt = "A futuristic city at sunset, filled with flying cars and neon lights. The buildings have a sleek, cyberpunk design, and people walk on glowing sidewalks. The scene is full of vibrant colors, reflections, and dynamic movement."
# New negative prompt
negative_prompt = "Dull colors, grainy texture, washed-out details, static frames, incorrect lighting, unnatural shadows, distorted faces, artifacts, low-resolution elements, flickering, blurry motion, repetitive patterns, unrealistic reflections, overly simplistic backgrounds, three legged people, walking backwards."
# Generate the video frames
output = pipe(
     prompt=prompt,
     negative_prompt=negative_prompt,
     height=720,
     width=1280,
     num_frames=81,
     guidance_scale=5.0,
).frames[0]
# Export the generated frames as a video
export_to_video(output, "output.mp4", fps=16)
Lo script inizia caricando il modello Wan2.1-T2V-14B-Diffusers, usato per creare video. Carica anche un VAE (Autoencoder), che aiuta a processare e migliorare i fotogrammi. Per controllare la fluidità del movimento nel video, lo script usa uno scheduler (UniPCMultistepScheduler). L’impostazione flow_shift regola come viene gestito il movimento: 5,0 è migliore per risoluzioni più alte (720P) e 3,0 per quelle più basse (480P).
Successivamente, lo script configura la pipeline di generazione video (WanPipeline) e applica lo scheduler per garantire transizioni più morbide tra i frame. Il prompt descrive una città futuristica con auto volanti e luci al neon, mentre il prompt negativo aiuta a rimuovere effetti indesiderati, come dettagli sfocati, colori slavati e sfarfallii.
Il modello quindi crea 81 frame, che corrispondono a circa 5 secondi di video a 16 fotogrammi al secondo (FPS). Il guidance_scale è impostato a 5,0, il che aiuta il modello a seguire il prompt lasciando comunque spazio alla creatività. Una volta generato, i frame vengono combinati e salvati come "output.mp4" a 16 FPS.
Il prompt negativo gioca un ruolo importante nel migliorare il video finale indicando al modello cosa evitare. Aiuta a eliminare elementi come scarsa qualità d’immagine, distorsioni strane o qualsiasi cosa possa rendere il video poco realistico. In questo caso, assicura che la scena futuristica risulti pulita, nitida e gradevole.
Se preferisci un’interfaccia web interattiva per generare video invece di usare il codice, puoi eseguire Wan 2.1 con Gradio:
Per l’estensione del prompt con Dashscope:
DASH_API_KEY=your_key python t2v_14B_singleGPU.py --prompt_extend_method 'dashscope' --ckpt_dir ./Wan2.1-T2V-14BPer l’estensione del prompt locale:
python t2v_14B_singleGPU.py --prompt_extend_method 'local_qwen' --ckpt_dir ./Wan2.1-T2V-14BAnalogamente al text-to-video, anche l’image-to-video è suddiviso in processi con e senza il passaggio di estensione del prompt. Per maggiori dettagli sull’implementazione, puoi visitare il GitHub ufficiale. Puoi anche unirti al loro canale Discord per discutere di Wan2.1, condividere le tue creazioni, ricevere aggiornamenti su nuove funzionalità e sviluppi, e visitare il sito ufficiale per esplorare esempi generati.
Wan 2.1 è costruito usando tecniche di AI avanzate per generare video realistici e di alta qualità. Segue un approccio basato sulla diffusione e integra i transformer per garantire che i movimenti siano fluidi, coerenti e dettagliati tra i frame.
Wan 2.1 usa una tecnica chiamata modelli di diffusione, che funzionano in due fasi:
È un po’ come sviluppare una foto in camera oscura: l’immagine inizia sfocata e granulosa, ma diventa più nitida a ogni passaggio di elaborazione.
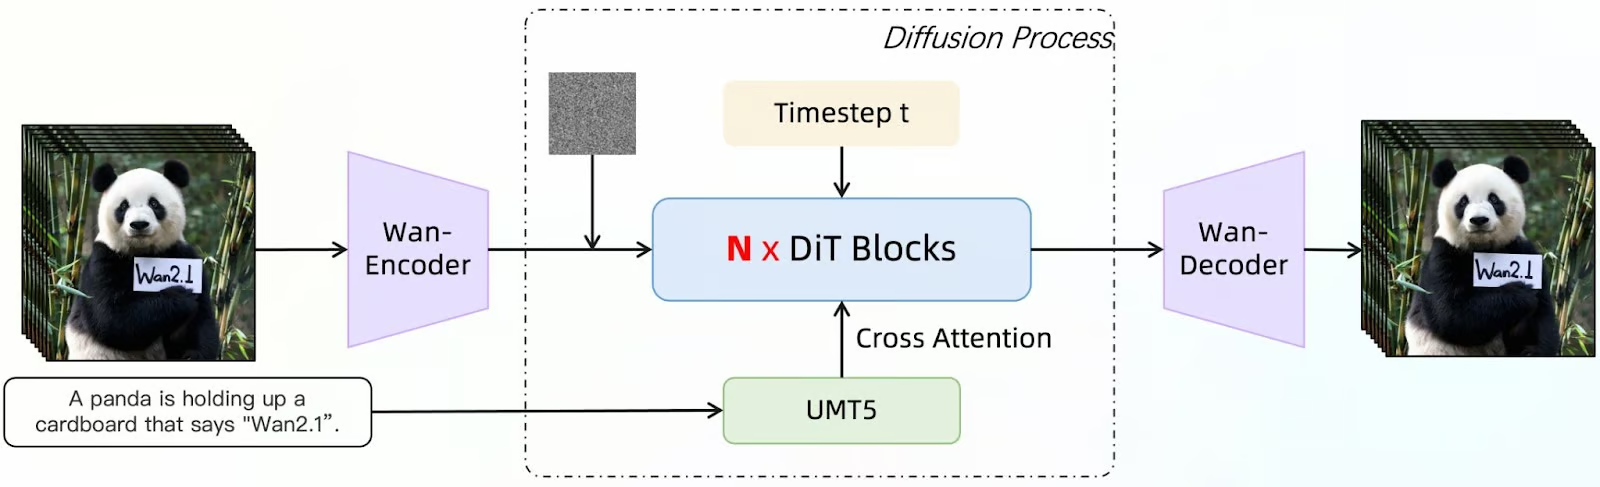
Wan 2.1 migliora questo approccio usando un Diffusion Transformer (DiT), che aiuta a mantenere dettagli nitidi e movimento fluido durante la generazione di più fotogrammi.
Fonte: GitHub (Wan-Video/Wan2.1)
Questo diagramma mostra come Wan 2.1 genera i fotogrammi usando un modello di diffusione potenziato da un Diffusion Transformer (DiT). Il processo parte da una descrizione di input (ad es., "Un panda regge un cartello su cui c’è scritto 'Wan2.1'"). Questo testo è elaborato da UMT5, un modello linguistico che aiuta il sistema a comprendere e rifinire il prompt.
Contemporaneamente, viene introdotta un’immagine iniziale rumorosa come punto di partenza. Il Wan-Encoder elabora quindi questi input, codificandoli in una forma che il modello può manipolare. I blocchi DiT (N x) raffinano iterativamente l’immagine.
Il modello di diffusione rimuove progressivamente il rumore dai frame, usando la cross-attention per allineare l’output al prompt fornito. Il timestep (t) indica i passaggi progressivi di denoising, assicurando che il video si sviluppi in modo fluido nel tempo.
Dopo molteplici passaggi di raffinamento, il Wan-Decoder ricostruisce i fotogrammi finali dai dati elaborati. L’output è una serie di frame allineati alla descrizione originale, con dettagli nitidi, movimento fluido e coerenza.
Wan 2.1 include Wan-VAE, un potente strumento di compressione che aiuta il modello a:
È come quando zippi file video: comprime e memorizza i dettagli chiave, poi li ricostruisce accuratamente durante la generazione del video.
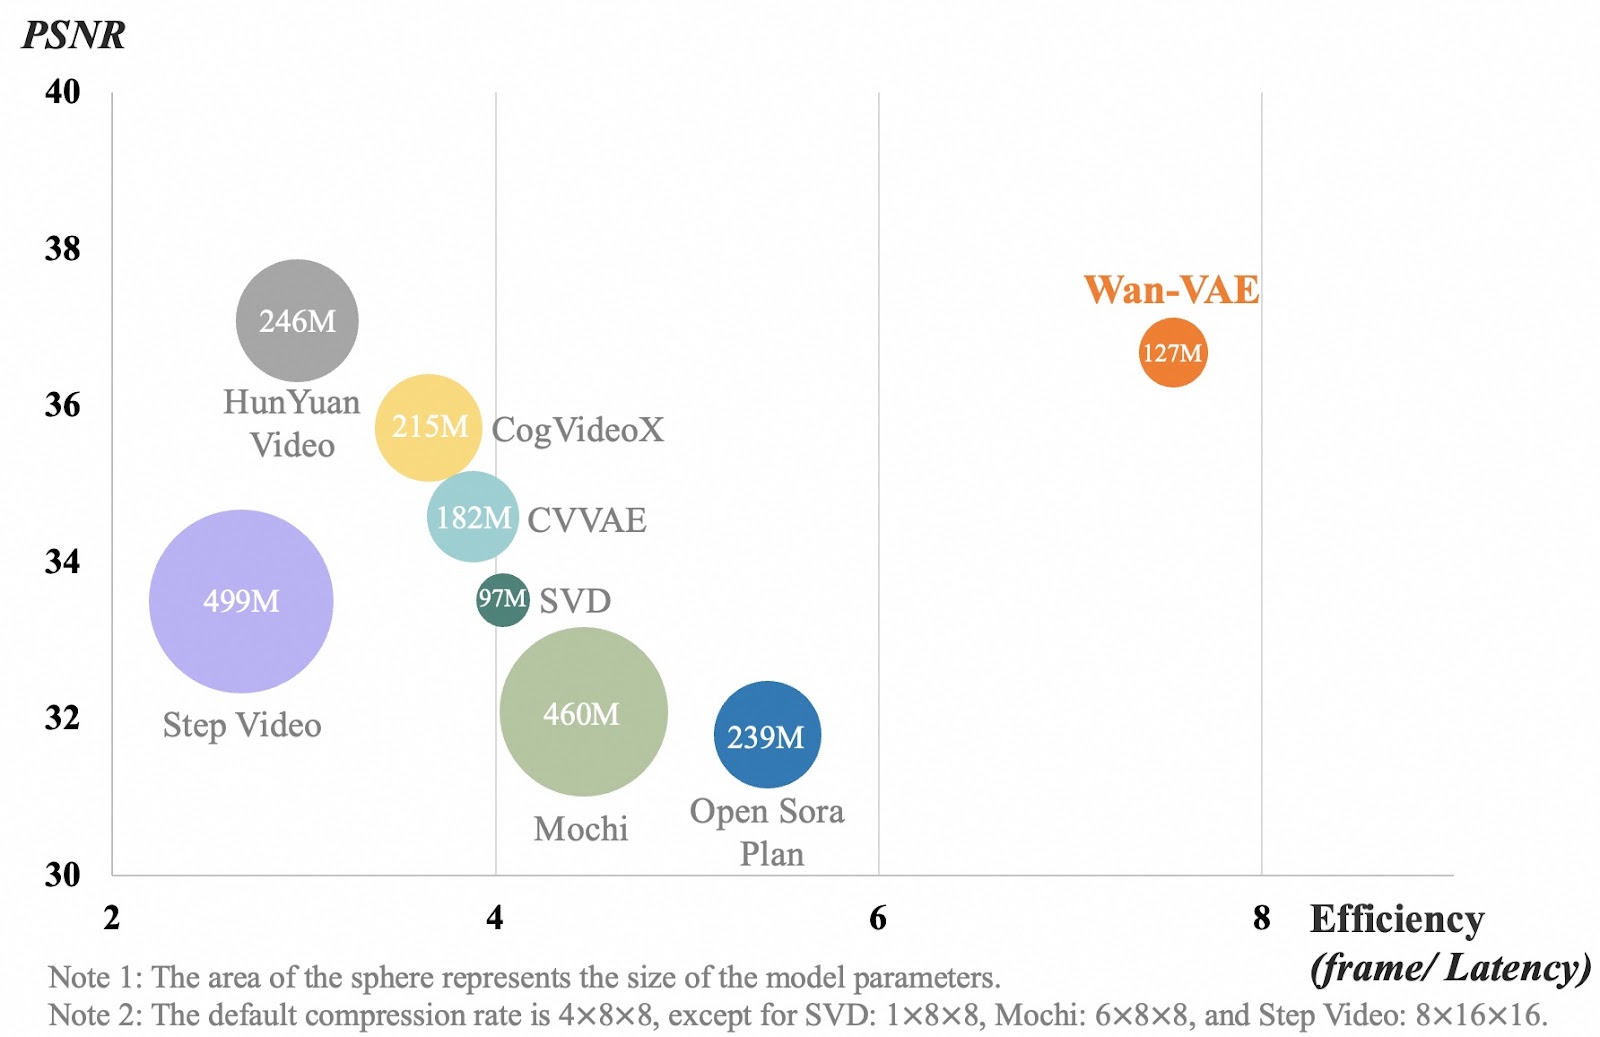
Fonte: GitHub (Wan-Video/Wan2.1)
Il grafico confronta diversi modelli di compressione video in base alla qualità (PSNR) e all’efficienza (velocità di elaborazione dei frame). Ogni bolla rappresenta un modello e la sua dimensione indica quanto è grande. L’asse x misura l’efficienza nell’elaborazione dei frame: più alto è il numero, più veloce è il modello. L’asse y mostra la qualità video: più alto è il valore, più chiari e dettagliati sono i video.
Wan-VAE, mostrato in arancione, offre prestazioni migliori degli altri modelli bilanciando alta qualità video e velocità di elaborazione, restando relativamente compatto (127M di parametri). Altri modelli, come Step Video e Mochi, sono molto più grandi ma non elaborano i frame con la stessa efficienza. Questo significa che Wan-VAE può generare video lunghi e di alta qualità mantenendo dettagli nitidi e movimento fluido, senza rallentamenti.
Wan 2.1 è un modello versatile di generazione video con AI utilizzabile in molti settori. In questa sezione proverò alcuni esempi per diversi casi d’uso.
Wan 2.1 può aiutarti a generare contenuti video originali senza attrezzatura costosa o lunghe ore di montaggio. Quindi immaginiamo che io sia una lifestyle influencer e voglia creare dei contenuti su una giornata cozy della mia vita.Userò il seguente prompt per creare una clip per il mio video:
Un’animazione in time-lapse di un caffè accogliente dalla mattina alla sera, con persone che vanno e vengono, il caffè che viene preparato e il tramonto che si riflette sulle finestre.
Perché volevo fosse il più realistico possibile, ho usato anche la modalità ispirazione. Questo è il risultato che ho ottenuto:
Quando il video è stato generato, a prima vista sono rimasta molto colpita. Ma guardandolo meglio, ho notato un paio di cose. Innanzitutto, qualcuno scompare sullo sfondo. Inoltre, non è un time-lapse e non viene preparato alcun caffè. Quindi, anche se il video sembra piuttosto realistico, non riflette accuratamente il prompt.
Ora, immagina di essere uno sviluppatore di videogiochi. Potresti usare Wan 2.1 per generare cutscene realistiche, animazioni di sfondo o concept art per i tuoi progetti. Per esempio, se hai già un concept di personaggio e il team creativo ha fornito alcuni design, potresti dargli vita usando la funzione image-to-video di Wan.
Oltre all’animazione dei personaggi, Wan 2.1 può aiutarti a creare ambienti dinamici, come effetti meteo mutevoli, paesaggi urbani brulicanti o scenari mistici, senza dover animare manualmente ogni frame.
Inoltre, con il controllo del rapporto d’aspetto, puoi assicurarti che le animazioni si adattino perfettamente a diverse scene di gioco, come cinematiche widescreen (16:9), inquadrature verticali per mobile (9:16) o composizioni quadrate (1:1) per teaser sui social.
Puoi persino usare la funzione effetti sonori per generare ambiente di sottofondo, come il fruscio delle foglie, il ronzio di una città futuristica o soundscape di battaglia.
Proviamo qualcosa!Ho generato questa bozza di un cavaliere medievale con DALL-E:
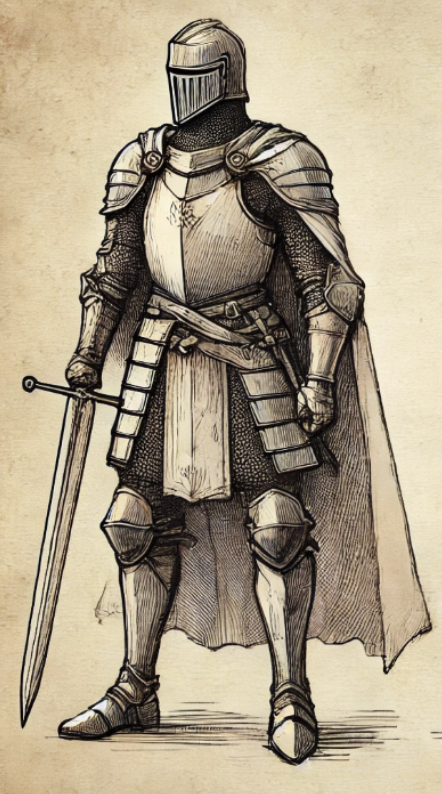
Usando Wan, ho inserito il seguente prompt con GPT-4o-mini:
Un cavaliere medievale sta in posa eroica, impugnando una grande spada con entrambe le mani. Il suo mantello sventola al vento mentre osserva il campo di battaglia. Il cavaliere gira lentamente la testa, scrutando l’orizzonte con espressione determinata. L’animazione ha uno stile cinematografico.Poi ho cliccato su Enhanced Prompt e questo è ciò che ho ottenuto:
Cavaliere medievale cinematografico: un valoroso cavaliere sta risoluto, rivestito di armatura a piastre completa, impugnando con entrambe le mani una possente spada a due mani. L’elmo con visiera e le spalline brillano al sole, mentre un nobile stemma adorna il suo petto. Una fascia gli cinge la vita, fissando l’insieme. Il mantello cremisi sventola drammaticamente nella brezza, accrescendo la sua presenza imponente. Con sguardo d’acciaio, ruota la testa, osservando il vasto campo di battaglia sabbioso. La scena si dispiega su carta dalla texture simile a pergamena, evocando il sentimento di un antico manoscritto. È un’inquadratura ampia a figura intera, che cattura il cavaliere in una posa trionfante, reminiscente del grande cinema medievale.
Ho disattivato la Modalità Ispirazione ma ho abilitato gli Effetti Sonori. Ecco il risultato:
Niente male! Anche se devo ammettere che mi aspettavo una versione più cinematografica della bozza, piuttosto che un’animazione della bozza stessa. Ma forse avrei potuto essere più chiara nel prompt. La musica è interessante e direi che si sposa bene con l’animazione!
Se sei un marketer, puoi usare Wan 2.1 per creare video promozionali per brand, prodotti e servizi o anche per animare loghi.
Immagina di avere un’attività di gelati e di voler animare il tuo logo per inserirlo alla fine delle tue inserzioni o dei video promozionali.Per testare l’idea, ho generato di nuovo questa immagine con DALL-E:
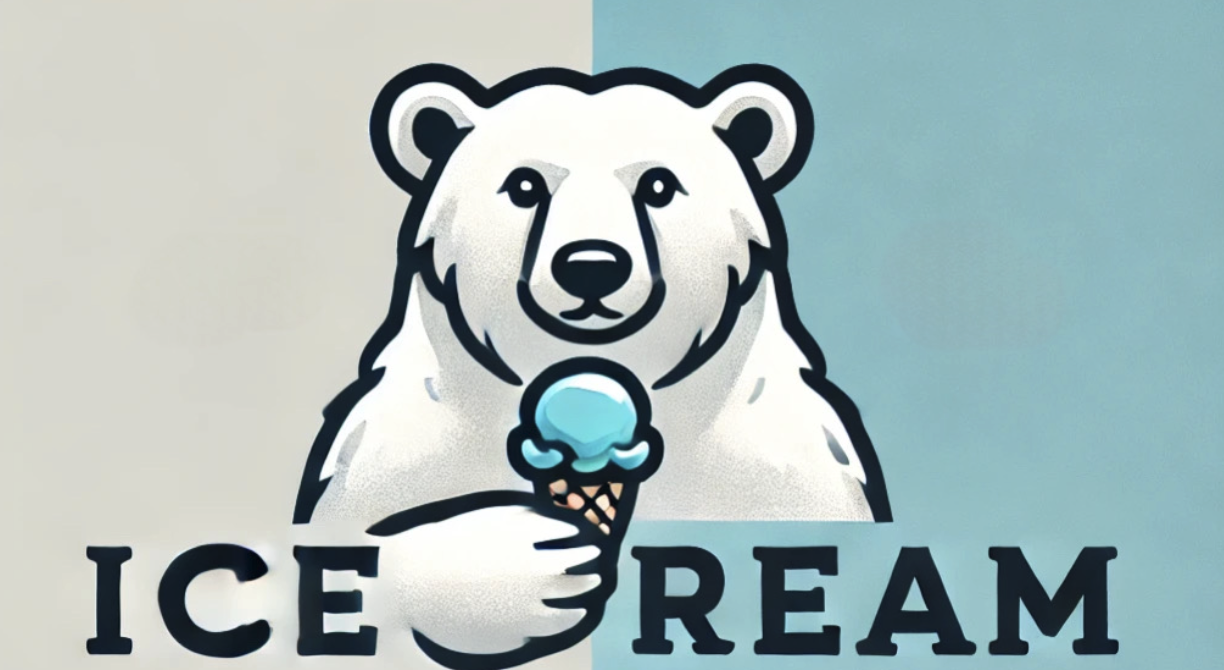
Poi ho usato questo prompt: L’orso polare mangia il gelato. Questo è il risultato della generazione image-to-video:
Impara l’AI con questi corsi!
Corso
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



