
Corso
Concetti di DevOps
4 ore
15K
Quando ho iniziato a lavorare come ingegnere MLOps, ho dovuto distribuire una piccola applicazione che includeva un modello di ML per la classificazione di immagini. Il primo rilascio è andato bene. Ma quando ho aggiornato il modello, è iniziato il caos. Per prima cosa, il Pod che ospitava il mio nuovo modello non si è avviato a causa di alcune differenze tra l'ambiente di test e l'ambiente di produzione. Inoltre, i clienti non potevano lavorare perché il Pod con il vecchio modello era già stato sostituito con il mio nuovo Pod che non partiva. Un incubo. Ho dovuto fare rollback manualmente e chiedere scusa agli utenti di quel modello.
Da allora ho imparato la lezione e sono passato alla strategia di blue-green deployment. Questo approccio DevOps permette di distribuire nuovi aggiornamenti senza downtime né rollback notturni.
In questa guida ti mostrerò come funziona il blue-green deployment nella pratica: come configurarlo, i compromessi, le lezioni che non trovi nella documentazione. Che tu stia creando servizi ML, API o applicazioni full-stack, questo approccio può dare al tuo team la rete di sicurezza di cui ha bisogno per rilasciare nuove funzionalità con fiducia.
Il blue-green deployment sembra più complicato di quanto sia (almeno a me, all'inizio sembrava difficile quando ne ho sentito parlare).
È solo un trucco intelligente per rilasciare nuove versioni senza interrompere gli utenti. Lo fa mantenendo due ambienti di produzione identici e commutando il traffico tra di loro.
Se ti è mai capitato che l'app funzionasse in staging ma andasse in crash in produzione, questa è la strategia giusta per te!
L'idea di base: mantieni due ambienti di produzione identici. Uno si chiama blue e l'altro green.
Quello blue è l'ambiente con cui gli utenti stanno attualmente interagendo. Quando hai una nuova versione da rilasciare, la distribuisci nell'ambiente green, la testi e, quando sei sicuro che funzioni, reindirizzi il traffico di produzione dall'ambiente blue al green.
Questa strategia significa niente downtime, niente "scusa stiamo aggiornando". Solo una transizione nascosta dietro le quinte che gli utenti nemmeno notano.
Nella pratica, la magia avviene nel load balancer. Lo configuri per instradare il traffico verso un ambiente o l'altro, a seconda dello stato del deployment. Questo offre un controllo granulare sul traffico e rende i rollback semplici quanto riportare il traffico all'ambiente blue.
Questa strategia risolve il momento "ma in staging funzionava", che ho vissuto con il mio nuovo modello di ML. Poiché l'ambiente green è anch'esso un ambiente di produzione, stai testando il mondo reale prima che gli utenti lo usino davvero.
Ecco una rapida panoramica del flusso tipico:
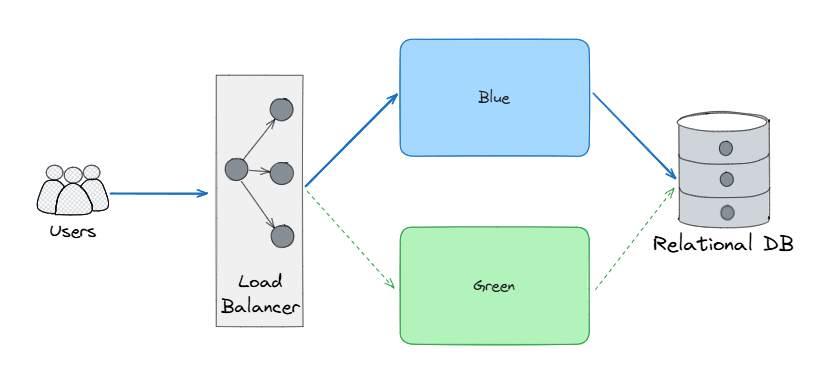
Blue-green deployment Fase 1: nuova applicazione in green per i test, traffico ancora instradato su blue (Immagine dell'autore).
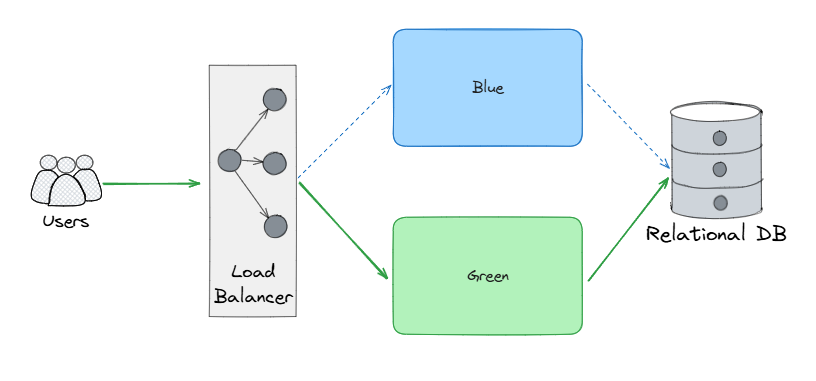
Blue-green deployment Fase 2: traffico reindirizzato all'ambiente green (Immagine dell'autore).
L'approccio blue‑green è stato coniato e utilizzato in ThoughtWorks intorno al 2005 da Daniel Terhorst‑North e Jez Humble. È stato poi documentato e reso popolare nel libro del 2010 Continuous Delivery di Jez Humble e Dave Farley.
Da allora, è stato usato ovunque, dalle startup ai giganti cloud-native di oggi, come Netflix e chiunque effettui deploy più volte al giorno senza drammi.
Le piattaforme cloud hanno accelerato questo cambiamento. Con infrastructure-as-code, gruppi di auto-scaling e strumenti di orchestrazione dei container come Kubernetes, creare e mantenere ambienti duplicati è diventato semplice.
I blue-green deployment hanno persino ispirato altri modelli di rilascio, come i canary release e i feature flag. Se capisci il blue-green, hai anche le basi per comprendere gli altri.
Nuovo a DevOps? Inizia con il corso DevOps Concepts. Una base chiara e pratica che ti aiuta a capire le strategie core prima di tuffarti in workflow avanzati.
Essere sincero: la prima volta che ho sentito parlare di blue-green deployment, pensavo non avesse senso mantenere due ambienti di produzione. Tuttavia, ho visto quanto fosse facile rilasciare nuovi modelli di ML e come ricevessi meno lamentele ed escalation dagli utenti: è stato chiaro che ne valeva la pena.
Nei prossimi capitoli metterò in evidenza i benefici del blue-green deployment.
Questo è il più evidente: nessuno vuole downtime.
Con il blue-green, puoi spostare istantaneamente il traffico dal vecchio al nuovo ambiente senza attendere un degrado del servizio. I tuoi utenti non si accorgono della commutazione, come è giusto che sia.
È un cambio di passo quando gestisci API rivolte agli utenti, dashboard o pipeline ML che non possono permettersi nemmeno pochi minuti di interruzione.
Immagina di rilasciare una nuova versione per poi renderti conto, dopo pochi minuti, che sta generando molti internal server error. Con il blue-green deployment, puoi semplicemente riportare il load balancer all'ambiente blue e correggere l'errore senza dover correre.
Questo livello di sicurezza rende i team più sicuri a rilasciare spesso. Basta con il "mai cambiare un sistema che funziona".
Puoi testare in produzione senza esporre gli utenti al rischio. È questa la bellezza dell'ambiente green. Puoi eseguire test di carico, verifiche di integrazione e persino simulare il comportamento degli utenti prima che traffico reale raggiunga l'app.
A differenza degli ambienti di staging tradizionali, esegui i test sulla stessa infrastruttura, configurazione e tutto il resto.
Questo rende i test molto più aderenti alla realtà.
Quando hai due ambienti di produzione identici in esecuzione, puoi farci ancora di più. Potresti instradare il 90% del traffico alla versione blue e il 10% alla versione green.
Puoi anche integrare feature flag per controllare quali funzionalità mettere live, quando e dove, con il blue-green deployment come solida base di rilascio sottostante.
Se vuoi approfondire la delivery progressiva, dai un'occhiata a CI/CD in Data Engineering. Spiega come impostare pipeline che supportano A/B test e rollout graduali.
Il blue-green deployment aiuta a:
Se stai distribuendo servizi di machine learning critici o strumenti dati interni da cui le persone dipendono ogni giorno, questo è fondamentale.
Prima di implementare un blue-green deployment, è essenziale capirlo in profondità.
Vediamo cosa ti serve in termini di architettura, considerazioni sui costi e preparazione interna.
Devi avere due ambienti di produzione identici. Questo significa doppia configurazione e doppia manutenzione.
Ma prima di farti prendere dal panico per i costi, ricorda che non significa costi raddoppiati sempre. Con piattaforme cloud o Kubernetes, puoi attivare le risorse per l'ambiente green solo quando necessario e disattivarle dopo.
Ecco cosa può aiutare a configurare i due ambienti:
Ricorda anche che on-prem le cose si complicano, perché dovrai garantire:
Puoi confrontare la confronto dei servizi AWS, Azure e GCP per decidere cosa sia più semplice per la tua piattaforma.
Gli scettici sottolineano sempre l'aumento dei costi nel mantenere due ambienti di produzione. E sì, gestire due ambienti non è gratis. Tuttavia, c'è un compromesso tra i costi aggiuntivi del secondo ambiente e il costo del downtime per il tuo business.
Chiediti:
Questo è il grande punto di forza del blue-green: meno outage, iterazioni più rapide e meno pressione e burnout per l'ingegneria.
Consigli per ottimizzare i costi:
Una pipeline CI/CD ben configurata può gestire automaticamente anche questo scaling.
Questa parte è spesso trascurata, ma è piuttosto essenziale.
Anche con budget per infrastruttura e strumenti, il blue-green deployment non funzionerà se la cultura del team e i sistemi non sono pronti.
Ti serviranno:
Se non sei sicuro di dove si trovi il tuo team, considera CI/CD for Machine Learning. Fornisce una panoramica completa di come appare un setup di deploy maturo e come raggiungerlo.
Finora abbiamo visto perché usare i blue-green deployment. In questa sezione ti mostrerò come implementarli.
Scomporrò un tipico ciclo di vita del blue-green deployment, concentrandomi sull'aspetto più impegnativo: la gestione dei database.
Imparerai cosa automatizzare, cosa monitorare e cosa non saltare.
Un blue-green deployment ben implementato segue un ordine preciso. Ecco come si presenta di solito nella pratica:
Rendi il rollback veloce quanto il rollout, così un membro del team può invertire un deploy in meno di un minuto.
La guida CI/CD in Data Engineering è un'ottima risorsa per impostare queste fasi automatizzate.
Questa parte è insidiosa. La tua app è stateless, ma il tuo database no.
Se non gestisci bene questa parte, non potrai fare rollback facilmente, e il senso del blue-green deployment svanisce.
Ecco come puoi gestirla:
Se ti interessa usare MLOps a livello production-grade, ti consiglio il corso MLOps Deployment and Life Cycling.
Il blue-green è spesso usato come base per altre strategie di rilascio, offrendo varianti per affrontare diversi problemi nel processo di deploy.
A seconda dell'architettura, della frequenza di rilascio e del livello di complessità desiderato, valuta alternative o anche mixa alcuni approcci in uno nuovo.
Confrontiamo lo scenario più comune: blue-green vs. canary deployment.
Queste strategie spesso si mescolano, ma hanno obiettivi diversi.
Blue-green è un modello di rilascio con switch completo. Distribuisci su green, lo testi e, quando sei pronto, sposti il 100% del traffico.
Il canary, invece, è uno switch graduale. Distribuisci la nuova versione accanto alla vecchia e trasferisci gradualmente una piccola percentuale di traffico (ad es., 1%, poi 10%, poi 50%) mentre monitori possibili problemi.
Differenze chiave tra le due strategie:
Caratteristica | Blue-Green | Canary |
Commutazione del traffico | Tutta in una volta | Graduale |
Rollback | Istantaneo (torna a blue) | Rollback parziale o progressivo |
Esposizione al rischio | Impatto alto se green è rotto | Più bassa (i problemi emergono presto) |
Esigenze infrastrutturali | Due ambienti completi | Strato di routing per dividere il traffico |
Visibilità del rilascio | Switch pulito e controllato | Serve osservabilità più complessa |
Migliore per | Team piccoli, app stabili | Servizi critici, grandi bacini di utenti |
Io ho usato personalmente il blue-green per portare nuovi modelli ML in produzione, ma anche la base utenti era limitata. Se i miei modelli fossero stati esposti a bacini di utenti più ampi, probabilmente avrei preferito i canary release.
Entrambe le strategie richiedono buoni strumenti, ma le complessità sono in aree diverse.
Blue-green necessita di ambienti identici, il che aumenta il costo infrastrutturale. Tuttavia, il routing è abbastanza semplice, perché si tratta di spostare il traffico da un ambiente all'altro.
Il canary, invece, è più leggero in termini di costi infrastrutturali, ma richiede più logica per permettere lo switch graduale del traffico. Richiede anche osservabilità più dettagliata per intercettare i problemi il prima possibile.
Ecco altri fattori da considerare:
Quindi, cosa fa per te?
Se il tuo team sta ancora crescendo nella maturità CI/CD, il blue-green può essere il modo migliore per costruire fiducia. È anche un buon punto di partenza, che ti permette di fare esperienza.
Tuttavia, se hai una grande base utenti o rilasci cambiamenti con rischio significativo (come la logica di pricing), il canary può essere adatto.
Per i team focalizzati su Azure, il tutorial Azure DevOps mostra come implementare un buon CI/CD su Azure.
Basta teoria. Passiamo alla tecnica. Vediamo come il blue-green deployment è implementato sulle piattaforme che i team data usano ogni giorno, come Kubernetes, servizi cloud gestiti e strumenti di automazione.
Ognuna offre funzionalità diverse, ma l'idea di base non cambia: ti servono due ambienti identici e uno switch del traffico.
Implementare il blue-green deployment con Kubernetes è semplice, perché tutti gli strumenti necessari sono già integrati in Kubernetes.
Ci sono vari modi per configurarlo:
my-app-blue e my-app-green come due deployment distinti, condividendo label e service.Il componente chiave qui è il Service di Kubernetes. Agisce da load balancer, indirizzando il traffico ai pod blue o green tramite i label selector.
Poniamo di avere:
selector: version: blueDopo aver validato la versione green, aggiorni il selector del service a version: green e il traffico viene reindirizzato all'istante.
Ti consiglio di usare le readinessProbes per assicurarti che la nuova versione sia completamente pronta prima di instradare qualunque traffico.
Questo processo può essere automatizzato con strumenti come Argo Rollouts e Flagger, che gestiscono:
Vuoi andare più a fondo nell'infrastruttura orientata all'ML? Dai un'occhiata a Fully Automated MLOps.
Se usi AWS, Azure o GCP, la buona notizia è che il blue-green deployment è già integrato: devi solo abilitarlo.
AWS CodeDeploy (con Elastic Beanstalk o EC2):
Azure Container Apps o Azure App Service:
Google Cloud (Cloud Run o GKE):
Ogni cloud provider ha configurazioni e funzionalità proprie, ma tutti ti semplificano la vita perché non devi implementare molto da solo.
Usare servizi gestiti ha anche sempre il vantaggio di non dover mantenere tutto in proprio: i provider aggiornano i loro servizi e tu devi solo preoccuparti di configurarli correttamente.
Nuovo a GCP? Dai un'occhiata a Cloud Run: guida al deploy di app containerizzate in GCP.
Cloud Foundry è una piattaforma PaaS open-source che astrae gran parte dell'infrastruttura sottostante, consentendo agli sviluppatori di concentrarsi sul codice. È particolarmente popolare nelle grandi enterprise per automazione, funzionalità di compliance e workflow di deploy rapidi.
Ecco come funziona un tipico blue-green deployment in Cloud Foundry tramite la CLI ufficiale:
demo-time:cf create-route example.com --hostname my-appcf push my-appcf map-route my-app example.com --hostname my-appmy-app.example.com.cf create-route example.com --hostname my-app-tempcf push my-app-greencf map-route my-app-green example.com --hostname my-app-tempmy-app.example.com per blue e my-app-temp.example.com per green).bashcf map-route my-app-green example.com -n my-appcf unmap-route my-app example.com -n my-appcf delete my-appcf unmap-route my-app-green example.com --hostname my-app-tempQuesto processo minimizza il downtime e ti dà il pieno controllo su quando e come cambiare versione.
Se vuoi migliorare ulteriormente questo workflow con pipeline visuali, approvazioni manuali o rollback automatici, strumenti come Octopus Deploy, Codefresh o Spinnaker sono ottime opzioni. Si integrano perfettamente con le pipeline CI/CD, permettendo di automatizzare cicli di deploy complessi.
Il blue-green deployment è fantastico e può essere di grande aiuto, ma può anche diventare disordinato in fretta se non gestisci correttamente costi, rischi o automazione. Ho visto team soffrire per setup eccessivamente complessi o edge case inaspettati.
Vediamo cosa fare per evitarlo e rendere la tua strategia blue-green un successo.
Duplicare gli ambienti comporta ovviamente un costo extra.
Ma puoi minimizzarli con le strategie seguenti:
Non dovresti mai spostare il traffico senza essere completamente sicuro che l'app green funzioni come previsto.
Usa questi livelli di test per costruire fiducia prima dello switch:
Integra questi test nella tua pipeline CI/CD in modo che vengano eseguiti automaticamente dopo un deploy riuscito.
Ti serve un ripasso su come costruire questi flow? CI/CD for Machine Learning copre come strutturare validazioni automatizzate nel tuo ciclo di deploy.
Questa è una parte delicata, perché la tua app può girare in due ambienti, ma di solito il database è lo stesso per entrambi.
Ecco come effettuare la transizione in sicurezza:
Combinare blue-green con feature flag offre ancora più flessibilità.
Con i flag puoi:
Usa strumenti come LaunchDarkly, ConfigCat o Unleash per semplificare la gestione senza richiedere modifiche al codice.
Monitoring e osservabilità sono cruciali per commutare il traffico in sicurezza, perché ti permettono di valutare correttamente se green è pronto per sostituire blue.
Dovresti avere:
readinessProbes di Kubernetes, URL di revision in Azure, ecc.Tuttavia, monitoring e osservabilità robusti dovrebbero far parte della tua infrastruttura in ogni caso, indipendentemente dall'uso del blue-green deployment.
Ogni tanto qualcosa andrà storto. L'obiettivo è rendere il recupero da un errore il più semplice e rapido possibile.
Ecco come fare:
Per consigli pratici di automazione DevOps, dà un'occhiata al tutorial Azure DevOps.
Avere due ambienti significa anche avere due potenziali punti di attacco.
Alcuni suggerimenti per avere una sicurezza adeguata:
Il blue-green deployment non è semplicemente una strategia di rilascio sofisticata usata solo in processi sovraingegnerizzati. È una strategia pratica e affidabile per i team che danno priorità all'uptime, al feedback rapido e a notti di sonno tranquille.
Ti offre:
Ma è perfetto per ogni situazione? Direi di no. Devi avere un solido setup CI/CD, con strumenti che supportino il percorso. Altrimenti, può diventare disordinato in fretta.
Ma non è un motivo per evitarlo. È piuttosto un segnale che dovresti migliorare le tue pratiche di deploy.
Abbiamo migliorato drasticamente il nostro flusso di rilascio adottando i blue-green deployment e abbiamo avuto giornate di rilascio notevolmente più tranquille dopo, tanto da essere abbastanza sicuri da rilasciare anche di venerdì.
Se vuoi approfondire, inizia da DevOps Concepts o MLOps Deployment and Life Cycling, perché ti aiuteranno a costruire le fondamenta su cui si basa il blue-green.
Ora vai e distribuisci la tua applicazione con fiducia.
I migliori corsi DataCamp
Corso
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min



