
Corso
Lavorare con l'API di OpenAI
3 ore
184.5K
L’ultimo modello linguistico di OpenAI, GPT-3.5 Turbo, rappresenta un enorme passo avanti nelle capacità dei large language model. Basato sulla famiglia di modelli GPT-3, GPT-3.5 Turbo può generare testo straordinariamente simile a quello umano, risultando al contempo più economico e accessibile rispetto alle versioni precedenti. Tuttavia, il vero punto di forza di GPT-3.5 Turbo sta nella possibilità di personalizzarlo tramite un processo chiamato fine-tuning.
Il fine-tuning permette agli sviluppatori di usare i propri dati per adattare il modello a casi d’uso specifici e incrementare in modo significativo le prestazioni su compiti specializzati. Con il fine-tuning, GPT-3.5 Turbo è arrivato persino a eguagliare o superare GPT-4 in alcune applicazioni ristrette.
Questo nuovo livello di personalizzazione apre la strada a imprese e sviluppatori che vogliono distribuire GPT-3.5 Turbo per creare applicazioni di IA su misura e ad alte prestazioni. Con la disponibilità del fine-tuning per GPT-3.5 Turbo e, più avanti quest’anno, per il più potente GPT-4, siamo all’alba di una nuova era dell’IA applicata.
Il fine-tuning è diventato una tecnica cruciale per sfruttare al massimo modelli linguistici di grandi dimensioni come GPT-3.5 Turbo. Abbiamo anche una guida separata sul fine-tuning di GPT-3, per esempio.
Sebbene i modelli pre-addestrati possano generare testo sorprendentemente naturale fin da subito, le loro vere capacità si sbloccano con il fine-tuning. Il processo consente agli sviluppatori di personalizzare il modello addestrandolo su dati specifici di dominio, adattandolo a casi d’uso specializzati oltre ciò che l’addestramento generico può ottenere. Il fine-tuning migliora pertinenza, accuratezza e prestazioni per applicazioni di nicchia.
Il fine-tuning consente agli sviluppatori di personalizzare il modello per creare esperienze uniche e differenziate, rispondendo a requisiti e domini specifici. Addestrando il modello su dati di dominio, potrà generare output più pertinenti e accurati per quella nicchia. Questo livello di personalizzazione permette alle aziende di costruire applicazioni di IA su misura.
Il fine-tuning migliora la capacità del modello di seguire le istruzioni e di produrre formattazioni di output affidabili e coerenti. Attraverso l’addestramento su dati già formattati, il modello impara la struttura e lo stile desiderati, aumentando la governabilità. Il risultato sono output più prevedibili e controllabili.
Il fine-tuning può migliorare in modo significativo le prestazioni del modello, consentendo persino a GPT-3.5 Turbo personalizzato di eguagliare o superare le capacità di GPT-4 in alcuni compiti specializzati. Ottimizzando il modello per un dominio ristretto, si ottengono risultati superiori in quello spazio di problemi rispetto a un modello generalista. Il guadagno di prestazioni dato dal fine-tuning è sostanziale.
Dai un’occhiata alla nostra guida su 12 alternative open source a GPT-4, che esplora alcuni strumenti in grado di offrire prestazioni simili richiedendo meno risorse computazionali.
Nei test beta condotti da OpenAI, è emerso che i clienti che hanno effettuato il fine-tuning del modello hanno riscontrato notevoli miglioramenti nelle prestazioni su varie applicazioni standard. Ecco alcuni punti chiave:
Grazie al fine-tuning, le aziende possono guidare meglio il modello a rispettare determinate linee guida. Ad esempio, se un’azienda desidera risposte concise o necessita che il modello risponda sempre in una lingua specifica, il fine-tuning può aiutare a raggiungere l’obiettivo. Un esempio classico è che gli sviluppatori possono tarare il modello per rispondere sempre in tedesco quando richiesto.
Uno dei benefici più evidenti del fine-tuning è la capacità di rendere gli output del modello più uniformi. Ciò è particolarmente prezioso per i compiti che richiedono una struttura di risposta specifica, come suggerimenti di codice o la generazione di interazioni API. Per esempio, con il fine-tuning gli sviluppatori possono fare affidamento sul modello per trasformare le richieste degli utenti in JSON di qualità, compatibile con i loro sistemi.
Il fine-tuning può essere utilizzato per allineare le risposte del modello alla voce o allo stile unici di un’azienda. Le aziende con un tone of voice distintivo possono sfruttare questa funzione per assicurare che il tono del modello rispecchi l’essenza del brand.
Il fine-tuning consente di personalizzare un modello linguistico pre-addestrato come GPT-3.5 Turbo proseguendo il processo di addestramento sui tuoi dati. Questo adatta il modello al tuo caso d’uso specifico e ne migliora sensibilmente le prestazioni.
Per iniziare il fine-tuning, serve innanzitutto l’accesso all’API di OpenAI. Dopo esserti registrato sul sito di OpenAI, puoi ottenere una chiave API che ti consente di interagire con l’API e i modelli.
Poi devi preparare un dataset per il fine-tuning. Ciò comporta la selezione di esempi di prompt di testo e delle risposte desiderate del modello. I dati dovrebbero rispecchiare il formato con cui la tua applicazione utilizzerà il modello. È importante anche pulire e formattare i dati nella struttura JSONL richiesta.
La CLI di OpenAI fornisce strumenti utili per convalidare e pre-processare i tuoi dati di addestramento.
Una volta convalidati, puoi caricare i dati sui server di OpenAI.
Infine, avvii un job di fine-tuning tramite l’API, selezionando il modello base GPT-3.5
Turbo e passando il file dei dati di addestramento. Il processo di fine-tuning può richiedere ore o giorni, a seconda della dimensione dei dati. Puoi monitorare i progressi dell’addestramento tramite l’API.
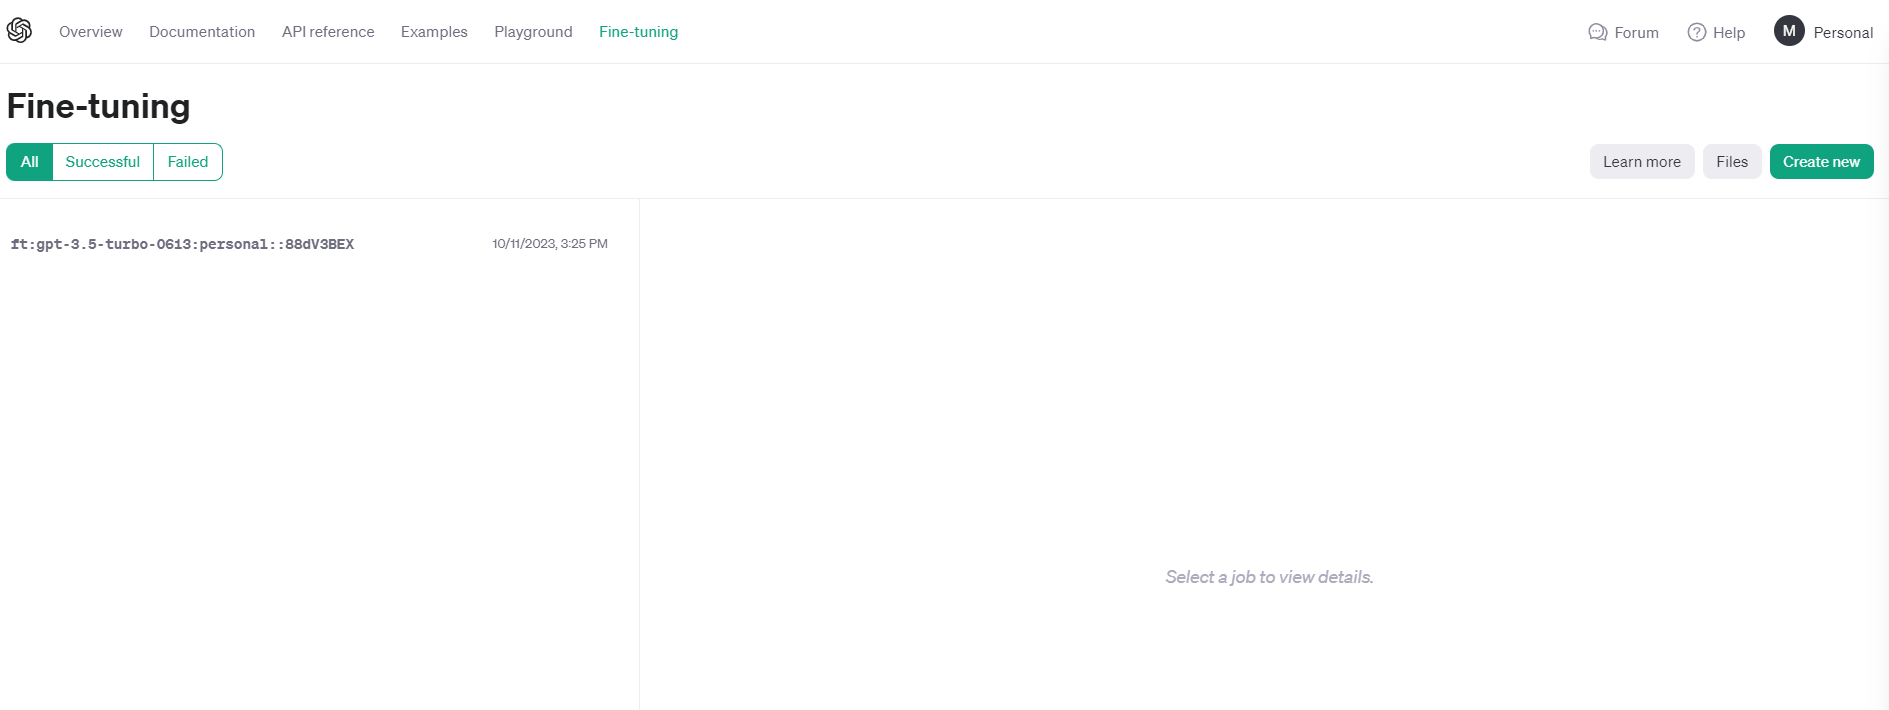
OpenAI ha rilasciato di recente un’interfaccia UI per il fine-tuning dei modelli linguistici. In questo tutorial userò la UI di OpenAI per creare un modello GPT con fine-tuning. Per seguire questa parte, devi avere un account e una chiave OpenAI.
A scopo dimostrativo, ho curato un piccolo dataset di domande e risposte, attualmente salvato come DataFrame di Pandas.
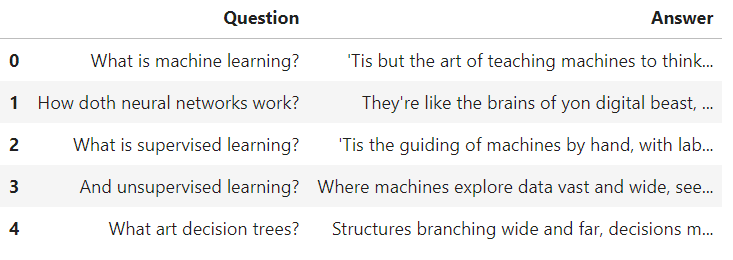
Per mostrarti cosa ho fatto, ho creato 50 domande di machine learning e le rispettive risposte in stile shakespeariano. Con questo job di fine-tuning, sto personalizzando lo stile e il tono del modello GPT-3.5 Turbo.
Anche se non è un caso d’uso molto pratico, dato che potresti semplicemente aggiungere “Rispondi in stile shakespeariano” nel prompt, GPT-3.5 conosce certamente Shakespeare e genererà risposte nel tono richiesto.
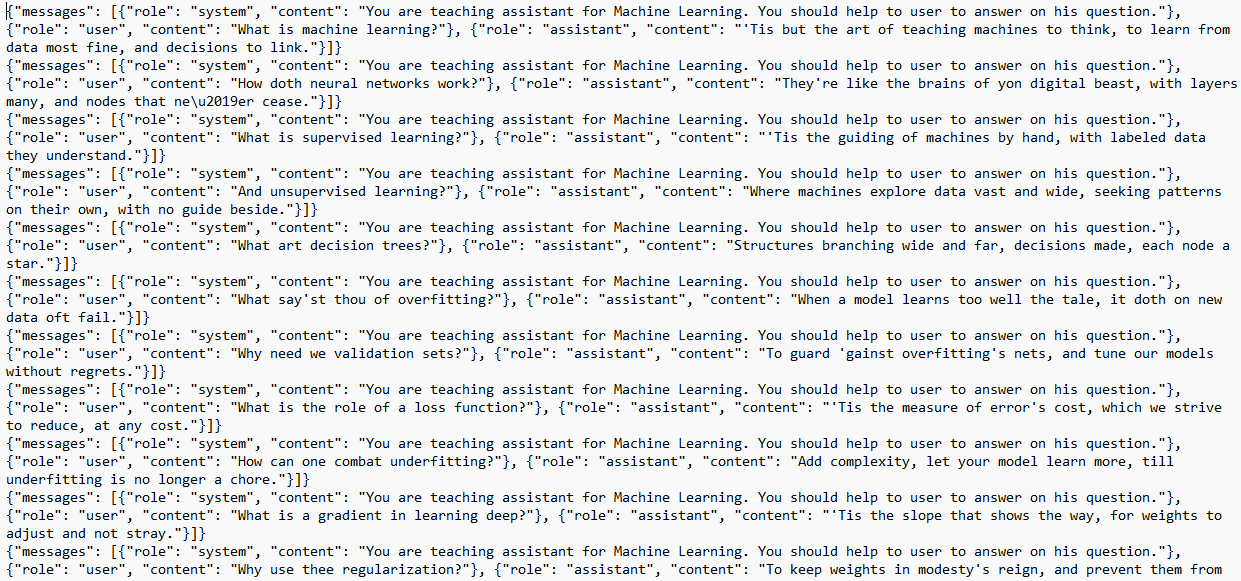
Per OpenAI i dati devono essere in formato jsonl. JSONL è un formato in cui ogni riga è un oggetto JSON valido, separato da a capo. Ho scritto un semplice codice per convertire un pd.DataFrame in jsonl.
import json
import pandas as pd

DEFAULT_SYSTEM_PROMPT = 'You are a teaching assistant for Machine Learning. You should help the user to answer his question.'

def create_dataset(question, answer):
    return {
        "messages": [
            {"role": "system", "content": DEFAULT_SYSTEM_PROMPT},
            {"role": "user", "content": question},
            {"role": "assistant", "content": answer},
        ]
    }

if __name__ == "__main__":
    df = pd.read_csv("path/to/file.csv", encoding='cp1252')
    with open("train.jsonl", "w") as f:
        for _, row in df.iterrows():
            example_str = json.dumps(create_dataset(row["Question"], row["Answer"]))
            f.write(example_str + "\n")
Ecco come appare il mio file jsonl:
Vai su platform.openai.com, apri Fine-tuning nel menu in alto e fai clic su Create New.
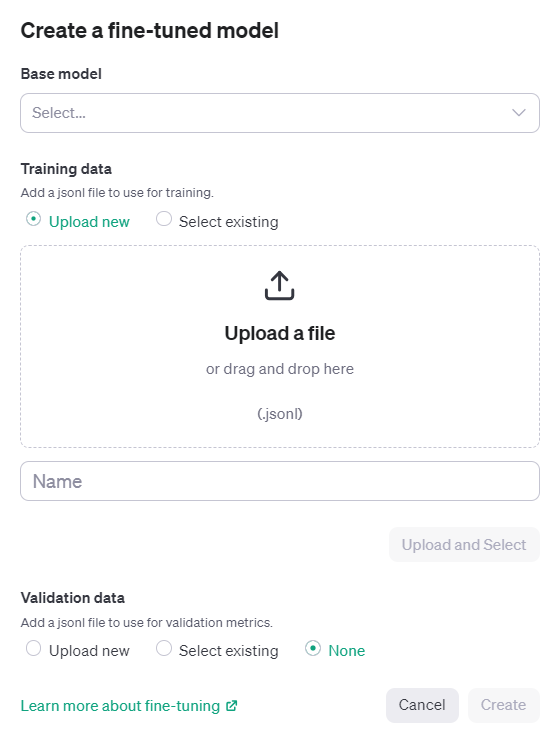
Seleziona il modello base. Al momento sono disponibili solo 3 modelli per il fine-tuning (babbage-002, davinci-002, gpt-3.5-turbo-0613).
Quindi carica semplicemente il file jsonl, assegna un nome al job e fai clic su Create.
Il job di tuning può richiedere diverse ore o persino giorni, a seconda della dimensione del dataset. Nel mio esempio, il dataset aveva solo 5.500 token e il fine-tuning ha richiesto ben oltre 6 ore. Il costo di questo job è stato trascurabile (<$1 = 5.500/1000 x $0,08).
Questo tutorial mostra come utilizzare la UI per fare fine-tuning dei modelli GPT. Se vuoi imparare a ottenere lo stesso risultato usando l’API, dai un’occhiata al tutorial Fine-tuning di GPT-3 usando l’API di OpenAI e Python di Zoumana Keita su DataCamp.
Una volta completato il job di tuning, puoi usare il modello personalizzato tramite API o tramite il playground disponibile su platform.openai.com.
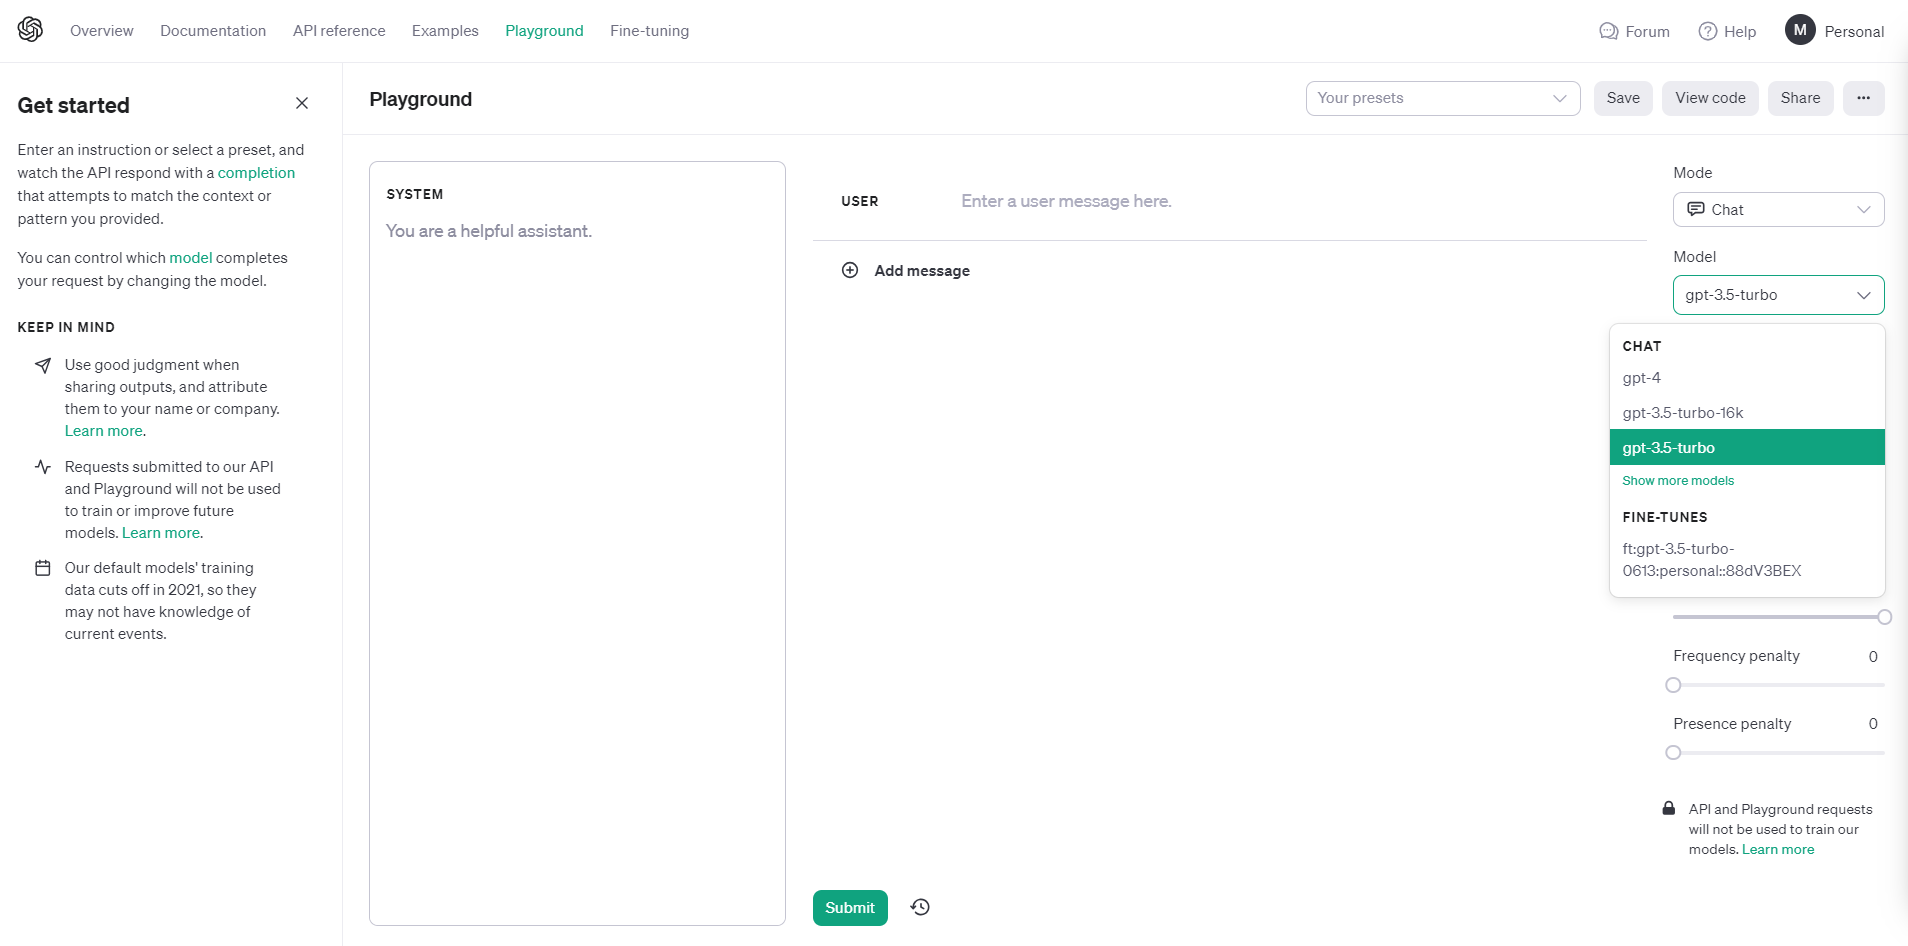
Nota che, nel menu a discesa Model, ora è disponibile un 3.5-turbo personale da selezionare. Facciamo una prova.
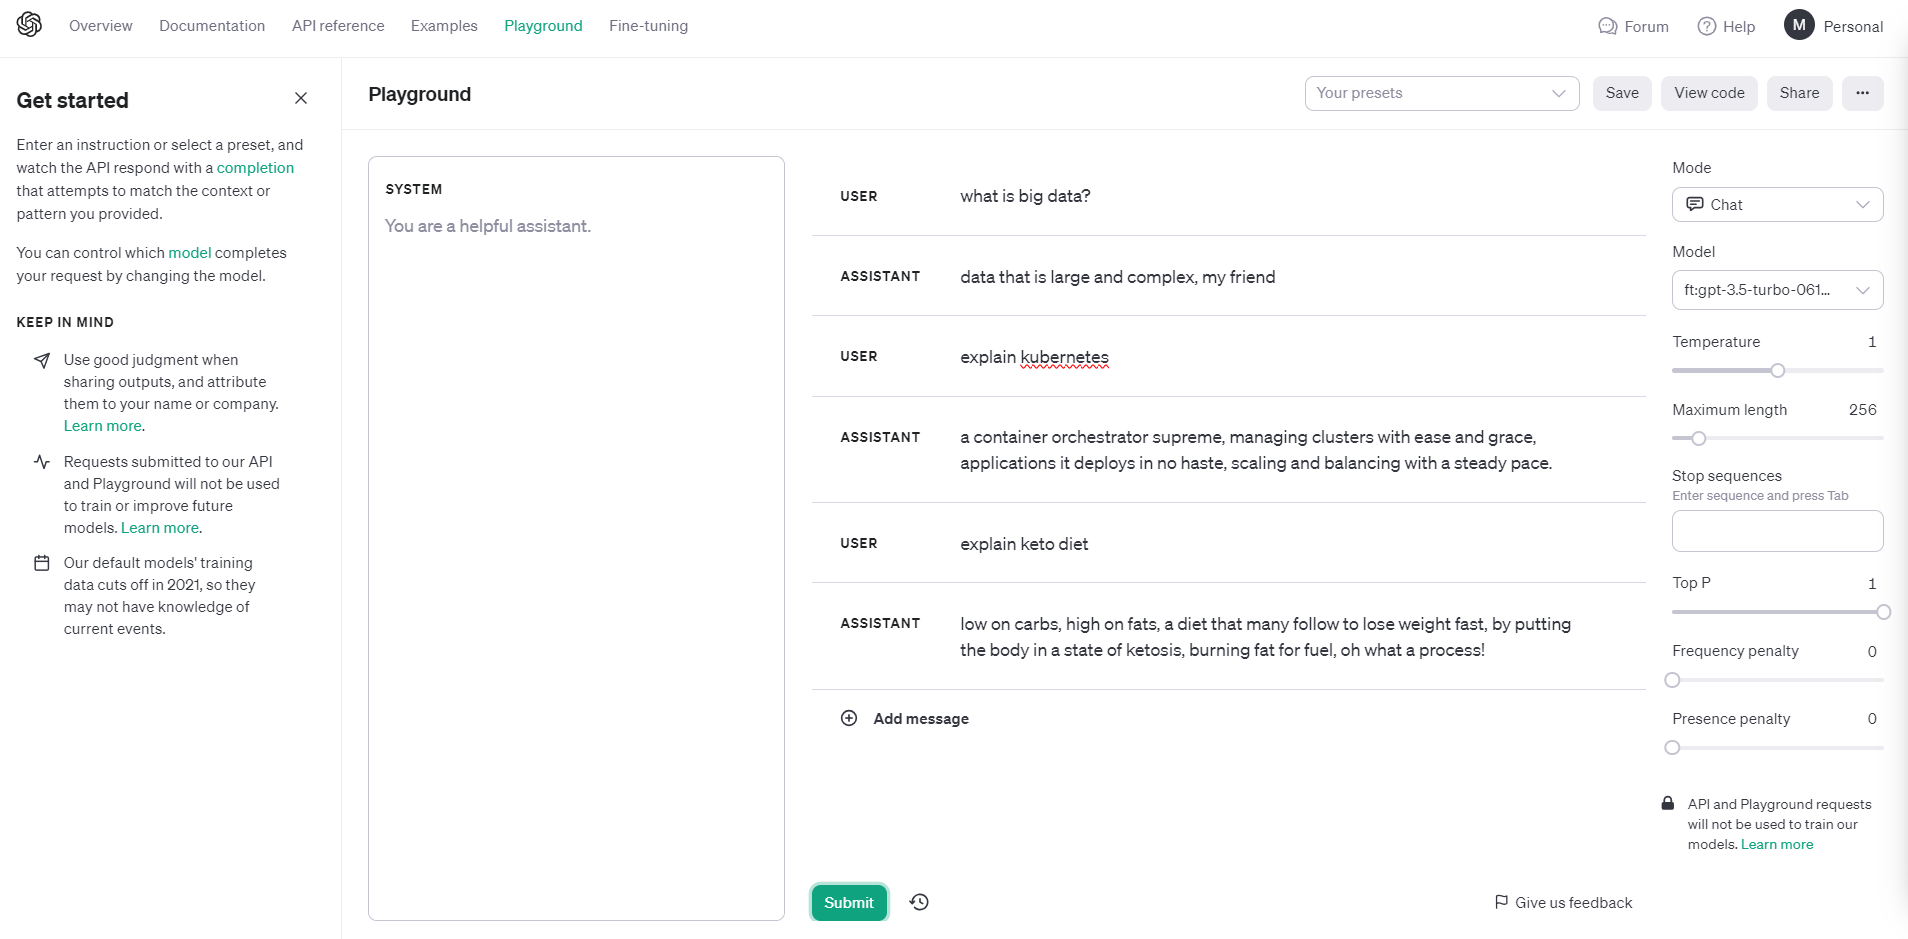
Nota il tono e lo stile delle risposte.
Se vuoi imparare a lavorare con il pacchetto Python di OpenAI per avere conversazioni programmatiche con ChatGPT, leggi il post Usare GPT-3.5 e GPT-4 tramite l’API di OpenAI in Python su DataCamp.
OpenAI prende molto sul serio la sicurezza e adotta processi rigorosi prima di rilasciare nuovi modelli, tra cui test, feedback di esperti, tecniche per migliorare il comportamento del modello e sistemi di monitoraggio. L’obiettivo è rendere i sistemi di IA potenti e al contempo ridurre al minimo i rischi prevedibili.
Il fine-tuning permette di personalizzare modelli come GPT-3.5 Turbo preservando importanti funzioni di sicurezza. OpenAI applica interventi a più livelli — misurazioni, modifiche al modello, policy, monitoraggio — per mitigare i rischi e allineare i modelli.
OpenAI rimuove le informazioni personali dai dati di addestramento quando possibile e ha policy contro la generazione di contenuti con informazioni di privati. Questo riduce al minimo i rischi per la privacy.
Per i casi d’uso comuni senza dati sensibili, i modelli OpenAI possono essere utilizzati in sicurezza. Ma per dati proprietari o regolamentati, opzioni come l’offuscamento dei dati, processori di IA privati o modelli interni possono essere preferibili.
Ci sono tre voci di costo associate al fine-tuning e all’utilizzo del modello GPT-3.5 Turbo con fine-tuning.
Vediamo un esempio di scenario di costo d’uso:
Nota: i token sono divisi per 1000 perché i prezzi di OpenAI sono indicati per 1K token.
Impara a usare ChatGPT in un progetto di data science end-to-end reale. Dai un’occhiata a Guida all’uso di ChatGPT per progetti di data science per scoprire come usare ChatGPT per pianificazione del progetto, analisi dei dati, preprocessing, selezione del modello, tuning degli iperparametri, sviluppo di una web app e deploy su Spaces.
Esplorando il fronte delle capacità dei large language model, GPT-3.5 Turbo spicca non solo per la generazione di testo simile a quello umano, ma anche per il potenziale trasformativo sbloccato dal fine-tuning. Questo processo di personalizzazione consente agli sviluppatori di affinare la competenza del modello per applicazioni di nicchia, raggiungendo risultati superiori che in domini specializzati possono persino eguagliare o superare quelli dei suoi successori.
I miglioramenti in dirigibilità, strutturazione delle risposte e personalizzazione del tono sono evidenti nelle applicazioni calibrate su requisiti specifici, consentendo alle aziende di offrire esperienze di IA uniche. Tuttavia, a grandi poteri corrispondono grandi responsabilità. È fondamentale comprendere i costi associati e prestare attenzione a sicurezza e privacy quando si implementano modelli generativi e linguistici.
Accedi a oltre 60 prompt di ChatGPT per compiti di data science con il Cheat Sheet di ChatGPT per la Data Science.
Inizia oggi il tuo percorso con OpenAI!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



