
Cours
Travailler avec l'API OpenAI
3 h
173.1K
Le dernier modèle linguistique d’OpenAI, GPT-3.5 Turbo, marque une avancée majeure dans les capacités des grands modèles de langage. Construit sur la famille de modèles GPT-3, GPT-3.5 Turbo génère un texte remarquablement naturel tout en étant plus abordable et accessible que les versions précédentes. Toutefois, sa véritable force réside dans sa personnalisation grâce à un processus appelé fine-tuning (affinage).
L’affinage permet aux développeurs d’apporter leurs propres données pour adapter le modèle à des cas d’usage précis et d’améliorer nettement ses performances sur des tâches spécialisées. Avec l’affinage, GPT-3.5 Turbo a même égalé ou dépassé GPT-4 sur certaines applications très ciblées.
Ce nouveau niveau de personnalisation ouvre la voie aux entreprises et aux développeurs pour déployer GPT-3.5 Turbo et créer des applications d’IA sur mesure, performantes. Alors que l’affinage se généralise pour GPT-3.5 Turbo et, d’ici la fin de l’année, pour le plus puissant GPT-4, nous sommes aux portes d’une nouvelle ère de l’IA appliquée.
L’affinage est devenu essentiel pour tirer le meilleur parti de grands modèles de langage comme GPT-3.5 Turbo. Nous proposons par ailleurs un guide dédié sur l’affinage de GPT-3, par exemple.
Si les modèles préentraînés génèrent déjà des textes très naturels, c’est l’affinage qui en déverrouille tout le potentiel. Le processus permet d’entraîner le modèle sur des données spécifiques à un domaine pour l’adapter à des cas d’usage spécialisés, au-delà de ce qu’un entraînement généraliste peut offrir. L’affinage améliore la pertinence, la précision et les performances pour des applications de niche.
L’affinage permet de façonner le modèle pour créer des expériences uniques et différenciantes, répondant à des exigences et à des domaines précis. En l’entraînant sur des données spécifiques, le modèle génère des résultats plus pertinents et plus exacts pour la niche visée. Ce degré de personnalisation permet aux entreprises de bâtir des applications d’IA sur mesure.
L’affinage améliore la capacité du modèle à suivre des instructions et à produire des sorties fiables et cohérentes. En s’entraînant sur des données formatées, le modèle apprend la structure et le style attendus, ce qui renforce sa pilotabilité. Les sorties deviennent plus prévisibles et contrôlables.
L’affinage peut nettement doper les performances, au point de permettre à un GPT-3.5 Turbo affiné d’égaler, voire de dépasser, GPT-4 sur certaines tâches spécialisées. En optimisant le modèle pour un domaine étroit, on obtient de bien meilleurs résultats que ceux d’un modèle généraliste. Le gain de performance apporté par l’affinage est substantiel.
Consultez notre guide sur 12 alternatives open source à GPT-4, qui présente des outils offrant des performances comparables tout en exigeant moins de ressources de calcul.
Lors des bêta-tests menés par OpenAI, les clients qui ont affiné le modèle ont constaté des améliorations notables de ses performances sur divers usages standards. Voici les principaux enseignements :
Grâce à l’affinage, les entreprises peuvent mieux guider le modèle pour respecter certaines directives. Par exemple, si une société souhaite des réponses concises ou a besoin de réponses dans une langue donnée, l’affinage y aide. Un cas classique : configurer le modèle pour répondre systématiquement en allemand lorsqu’on le demande.
L’un des atouts marquants de l’affinage est d’uniformiser les sorties du modèle. C’est précieux pour les tâches qui exigeant une structure de réponse particulière, comme les suggestions de code ou la génération d’appels d’API. Avec l’affinage, les développeurs peuvent faire confiance au modèle pour transformer des requêtes utilisateurs en JSON de qualité, compatible avec leurs systèmes.
L’affinage peut aligner les réponses du modèle sur la voix et le style propres à une marque. Les entreprises dotées d’une identité éditoriale très marquée peuvent s’assurer que le ton du modèle reflète fidèlement leur essence.
L’affinage permet de personnaliser un modèle de langage préentraîné comme GPT-3.5 Turbo en poursuivant son entraînement sur vos propres données. Le modèle s’adapte ainsi à votre cas d’usage et ses performances s’améliorent nettement.
Pour commencer, vous devez disposer d’un accès à l’API OpenAI. Après votre inscription sur le site d’OpenAI, vous pourrez obtenir une clé d’API pour interagir avec l’API et les modèles.
Ensuite, préparez un jeu de données pour l’affinage. Il s’agit de sélectionner des exemples d’invites (prompts) et de réponses attendues. Les données doivent correspondre au format d’utilisation de votre application. Le nettoyage et la mise en forme au format JSONL requis sont également importants.
L’interface en ligne de commande (CLI) d’OpenAI fournit des outils utiles pour valider et prétraiter vos données d’entraînement.
Une fois validées, vous pouvez téléverser les données sur les serveurs d’OpenAI.
Enfin, lancez une tâche d’affinage via l’API, en sélectionnant le modèle de base GPT-3.5
Turbo et en fournissant votre fichier d’entraînement. Le processus peut durer de quelques heures à plusieurs jours selon la taille des données. Vous pouvez suivre la progression via l’API.
OpenAI a récemment mis à disposition une interface pour affiner ses modèles de langage. Dans ce tutoriel, j’utiliserai l’interface OpenAI pour créer un modèle GPT affiné. Pour suivre cette partie, vous devez disposer d’un compte et d’une clé OpenAI.
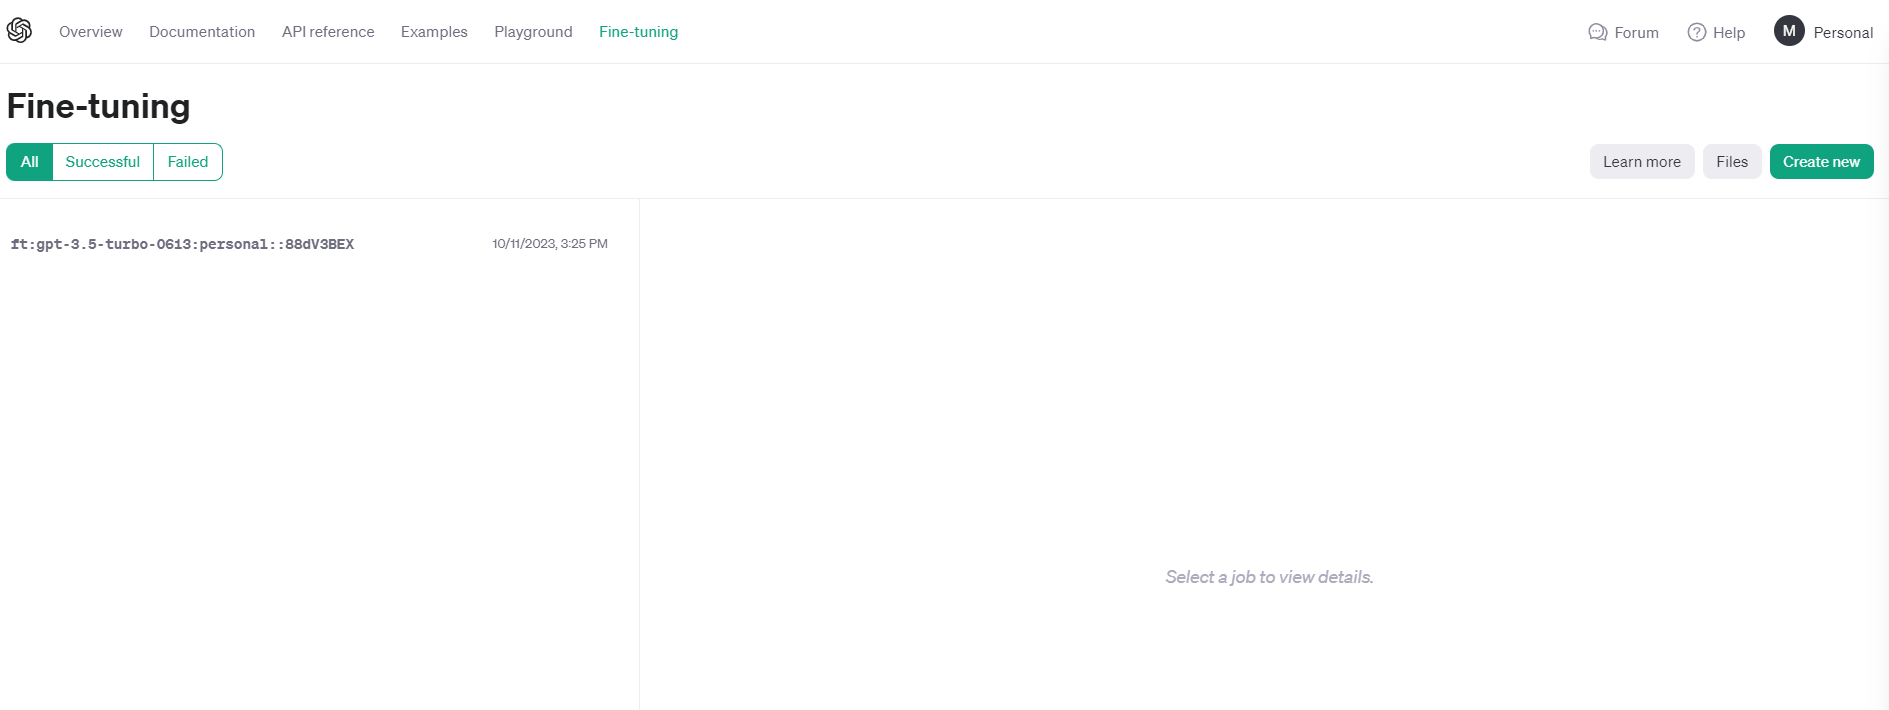
Pour la démonstration, j’ai réuni un petit jeu de questions-réponses, actuellement stocké dans un DataFrame Pandas.
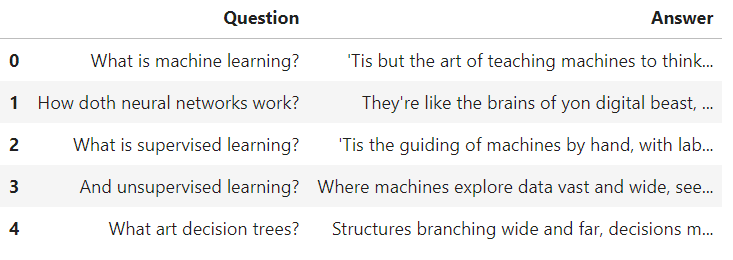
Pour illustrer la démarche, j’ai créé 50 questions sur l’apprentissage automatique et leurs réponses, dans le style de Shakespeare. Par cet affinage, je personnalise le style et le ton du modèle gpt-3.5-turbo.
Même si ce n’est pas un cas d’usage très pratique — vous pourriez simplement ajouter « Répondez dans le style de Shakespeare » dans le prompt —, GPT-3.5 connaît évidemment Shakespeare et générera des réponses dans le ton requis.
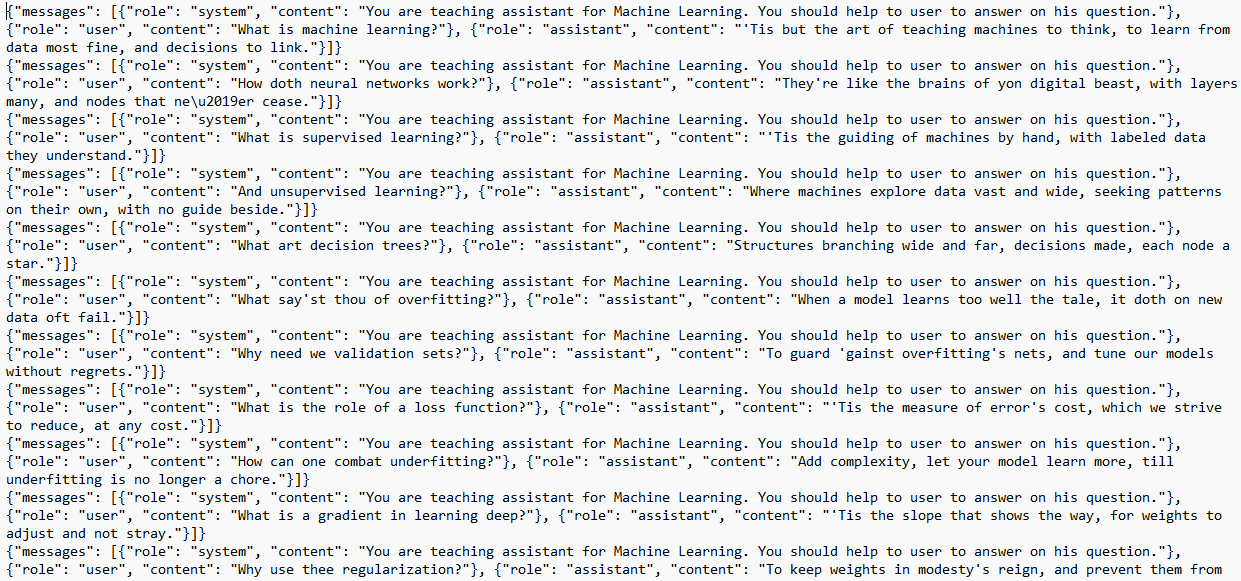
Chez OpenAI, les données doivent être au format jsonl. JSONL est un format où chaque ligne est un objet JSON valide, séparé par des retours à la ligne. J’ai écrit un court code pour convertir un pd.DataFrame en jsonl.
import json
import pandas as pd

DEFAULT_SYSTEM_PROMPT = 'You are a teaching assistant for Machine Learning. You should help the user to answer his question.'

def create_dataset(question, answer):
    return {
        "messages": [
            {"role": "system", "content": DEFAULT_SYSTEM_PROMPT},
            {"role": "user", "content": question},
            {"role": "assistant", "content": answer},
        ]
    }

if __name__ == "__main__":
    df = pd.read_csv("path/to/file.csv", encoding='cp1252')
    with open("train.jsonl", "w") as f:
        for _, row in df.iterrows():
            example_str = json.dumps(create_dataset(row["Question"], row["Answer"]))
            f.write(example_str + "\n")
Voici à quoi ressemble mon fichier jsonl :
Rendez-vous sur platform.openai.com, accédez à Fine-tuning dans le menu supérieur et cliquez sur Create New.
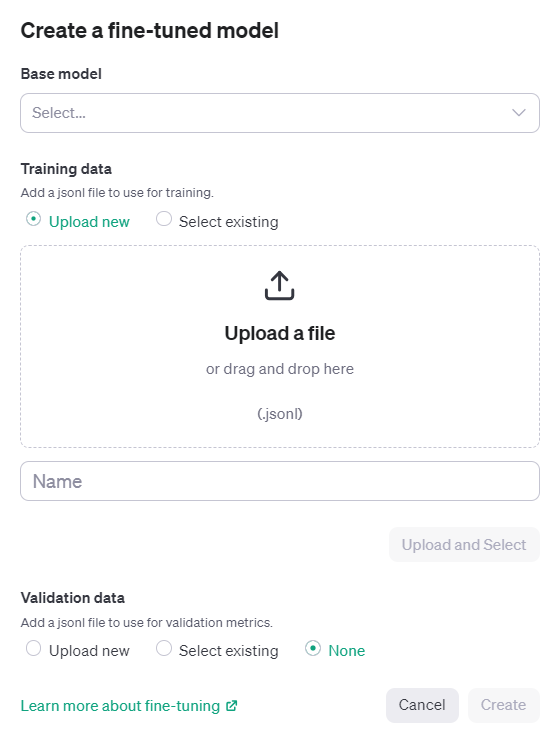
Sélectionnez le modèle de base. À l’heure actuelle, seuls 3 modèles sont disponibles pour l’affinage (babbage-002, davinci-002, gpt-3.5-turbo-0613).
Téléversez ensuite le fichier jsonl, nommez la tâche et cliquez sur Create.
L’affinage peut prendre plusieurs heures, voire plusieurs jours, selon la taille du jeu de données. Dans mon exemple, le jeu contenait seulement 5 500 tokens et l’affinage a tout de même dépassé 6 heures. Le coût a été négligeable (< 1 $ = 5 500/1 000 x 0,08 $).
Ce tutoriel montre comment utiliser l’interface pour affiner des modèles GPT. Si vous préférez réaliser la même chose via l’API, consultez le tutoriel Fine-Tuning GPT-3 Using the OpenAI API and Python de Zoumana Keita sur DataCamp.
Une fois l’affinage terminé, vous pouvez utiliser le modèle via l’API ou le playground disponible sur platform.openai.com.
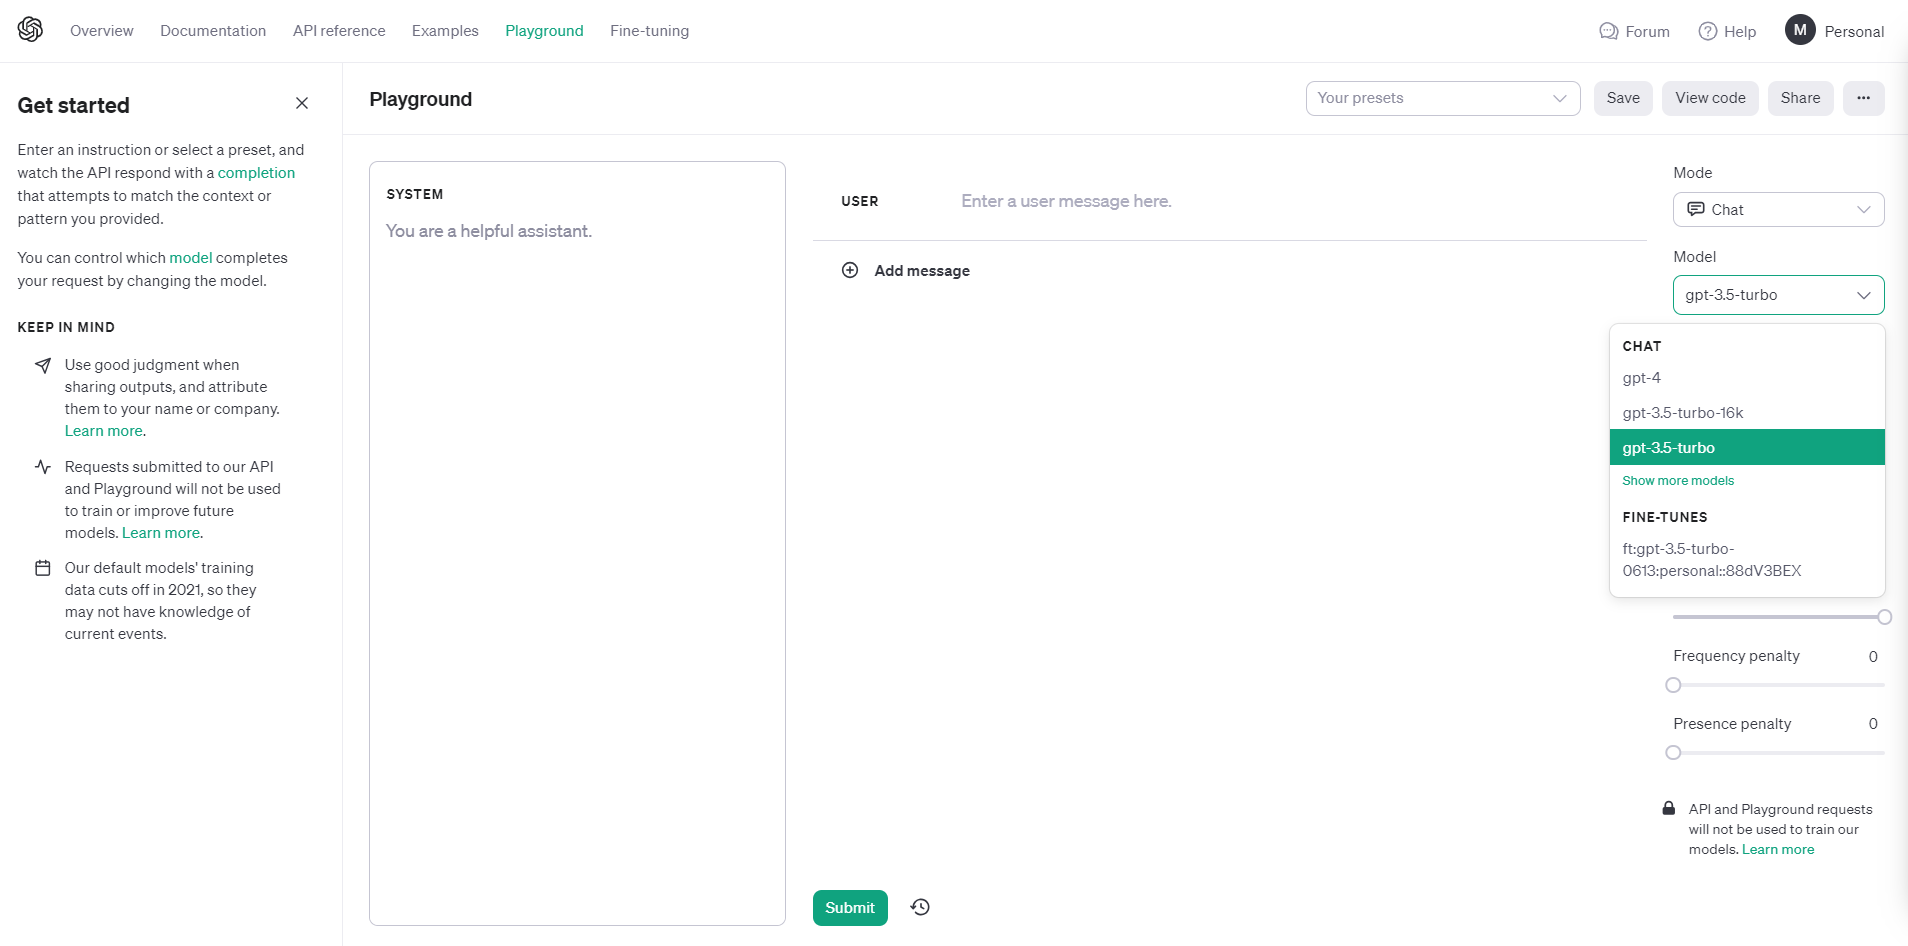
Dans la liste déroulante Model, vous verrez désormais un 3.5-turbo personnel sélectionnable. Essayons-le.
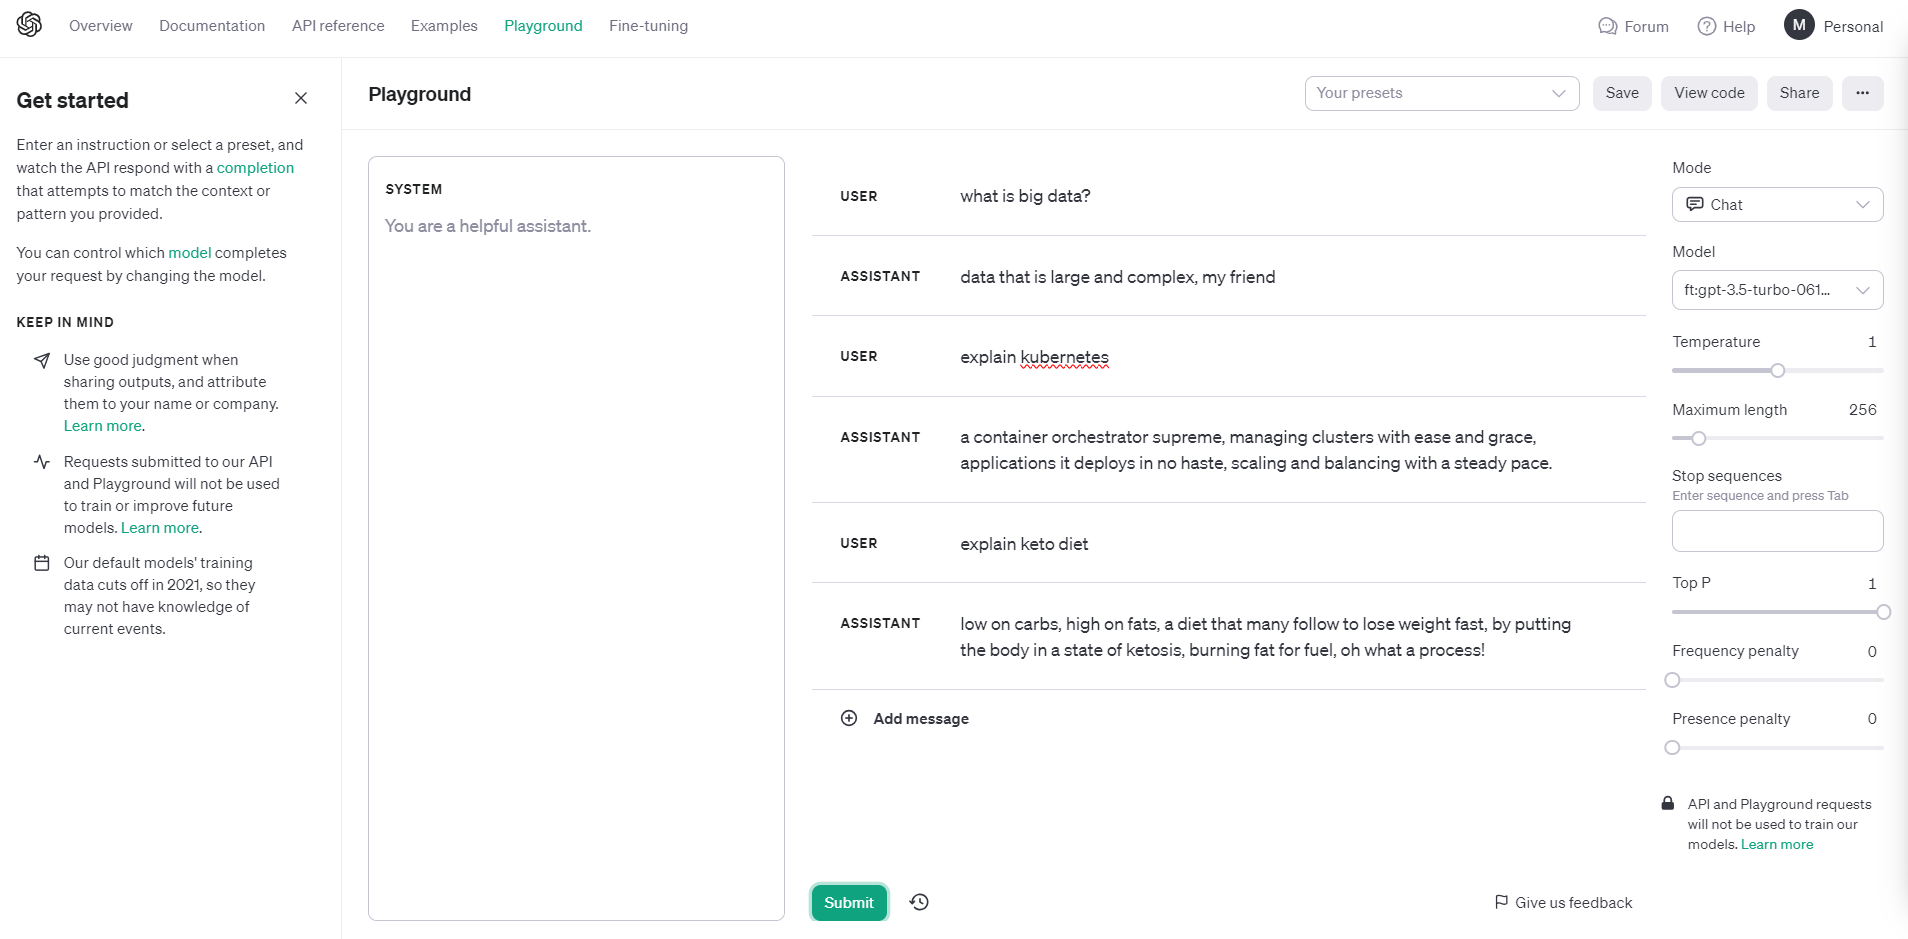
Observez le ton et le style des réponses.
Si vous souhaitez apprendre à utiliser le package Python d’OpenAI pour dialoguer par programmation avec ChatGPT, consultez l’article Using GPT-3.5 and GPT-4 via the OpenAI API in the Python sur DataCamp.
OpenAI prend la sécurité très au sérieux et applique des processus rigoureux avant toute mise en production : tests, retours d’experts, techniques d’amélioration du comportement des modèles et systèmes de supervision. Leur objectif est de rendre les systèmes d’IA puissants utiles tout en minimisant les risques prévisibles.
L’affinage permet de personnaliser des modèles comme GPT-3.5 Turbo tout en préservant des garde-fous essentiels. OpenAI intervient à plusieurs niveaux — mesures, ajustements de modèles, politiques, surveillance — pour atténuer les risques et aligner les modèles.
OpenAI supprime les informations personnelles des données d’entraînement lorsque c’est possible et interdit la génération de contenus contenant des données d’individus privés. Cela réduit les risques pour la vie privée.
Pour des usages courants sans données sensibles, les modèles OpenAI peuvent être utilisés en toute sécurité. Mais pour des données propriétaires ou réglementées, des options comme l’obfuscation, des exécutions privées ou des modèles internes peuvent être préférables.
Trois postes de coût sont liés à l’affinage et à l’utilisation d’un modèle GPT-3.5 Turbo affiné.
Prenons un exemple de scénario d’usage :
Remarque : les tokens sont divisés par 1 000 car la tarification d’OpenAI est indiquée pour 1 K tokens.
Apprenez à utiliser ChatGPT dans un projet de data science de bout en bout. Consultez A Guide to Using ChatGPT For Data Science Projects pour l’utiliser dans la planification, l’analyse, le prétraitement, le choix du modèle, le réglage des hyperparamètres, le développement d’une appli web et son déploiement sur Spaces.
Alors que nous explorons les frontières des grands modèles de langage, GPT-3.5 Turbo se distingue non seulement par sa génération de texte proche de l’humain, mais aussi par le potentiel transformateur de l’affinage. Cette personnalisation permet d’aiguiser le modèle pour des applications de niche et d’obtenir des résultats supérieurs, parfois à la hauteur, voire au-delà, de ses successeurs sur des domaines spécialisés.
Les gains en directivité, en structuration des réponses et en personnalisation du ton sautent aux yeux dans les applications réglées sur des besoins précis, permettant aux entreprises de proposer des expériences uniques pilotées par l’IA. Mais ce pouvoir implique aussi des responsabilités : il est essentiel de bien comprendre les coûts associés et de rester vigilant sur les aspects sécurité et confidentialité lors du déploiement de l’IA générative et des modèles de langage.
Accédez à plus de 60 prompts ChatGPT pour la data science avec la ChatGPT Cheat Sheet for Data Science.
Débutez votre parcours OpenAI dès aujourd’hui !
Cours
Cours
Cours