courses
개발자를 위한 AI 보조 코딩
1 시 30 분
9.9K
작고 빠르다고 해서 자동으로 성능이 떨어지는 시대는 지났습니다. DeepSeek이 공개한 평가에 따르면, DeepSeek-V4-Flash-0731은 DeepSeek-V4-Pro보다 훨씬 작은 활성 파라미터 풋프린트를 사용하면서도 최전선에 가까운 에이전트 성능을 보여줍니다. Terminal Bench 2.1에서 82.7점을 기록했으며, 이는 GLM-5.2의 81.0점, Opus 4.8의 85.0점과 비교할 수 있습니다. 또한 Agents’ Last Exam 25.2점으로 Opus 4.8의 25.7점과 근접합니다.
가중치가 공개되어 있어, 충분한 RAM 또는 VRAM을 확보하면 이론적으로 자체 하드웨어에서 모델을 실행해 추론과 프로젝트 데이터를 직접 통제할 수 있습니다.
이 가이드에서는 3개의 GPU를 갖춘 RunPod 환경을 구성하고, Unsloth Studio를 설치 및 실행한 뒤, DeepSeek-V4-Flash-0731의 Q8 버전을 GPU에 분산 로드하고, Studio에서 모델을 테스트하며, 로컬 추론 서버를 OpenCode에 연결한 다음 코딩 에이전트로 대화형 주식 분석 웹사이트를 구축·실행합니다.
DeepSeek-V4-Flash-0731은 초기 프리뷰를 대체하는 공식 릴리스로, 코딩, 도구 사용, 자율 에이전트 작업에서 큰 개선이 이뤄졌습니다. Mixture-of-Experts 아키텍처를 통해 토큰마다 모델의 일부만 활성화하여, 효율성을 유지하면서도 높은 성능을 제공합니다.
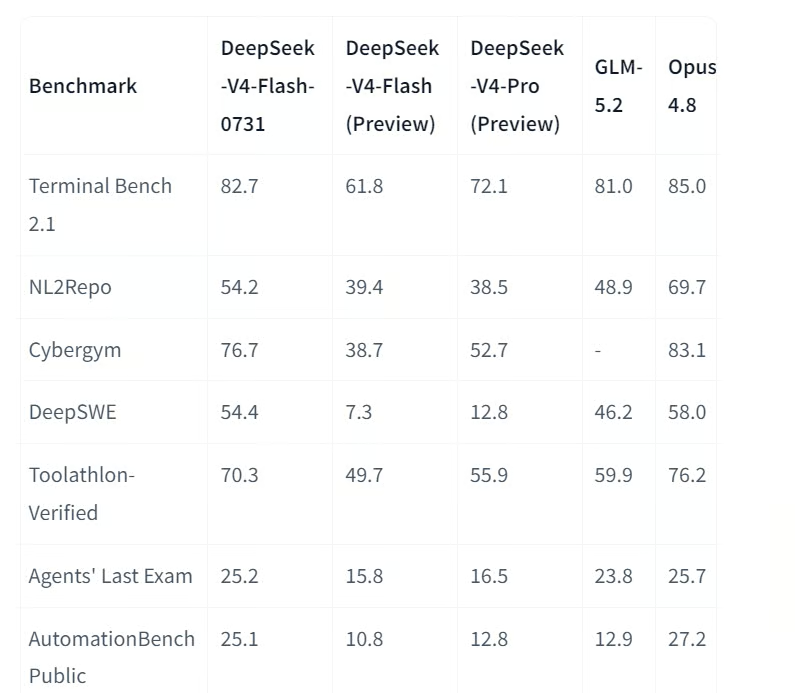
출처: deepseek-ai/DeepSeek-V4-Flash-0731 · Hugging Face
DeepSeek은 Terminal Bench 2.1 점수가 61.8에서 82.7로, DeepSWE가 7.3에서 54.4로 향상되었으며, 일부 에이전트 벤치마크에서 더 큰 DeepSeek-V4-Pro Preview를 능가했다고 보고합니다.
이 모델은 최대 100만 토큰의 컨텍스트 윈도를 지원합니다. 대규모 코드베이스, 긴 문서, 많은 문맥을 요구하는 복잡한 워크플로에 적합합니다. 작업에 투입할 추론 시간을 고려해 낮음, 높음, 최대의 추론 노력 수준을 선택할 수도 있습니다.
또한 DSpark 추측 디코딩을 포함합니다. DSpark는 메인 모델이 검증하기 전에 여러 토큰을 초안으로 생성하여, 호환 추론 엔진과 함께 사용할 때 생성 속도를 60%~85%까지 높일 수 있다고 합니다.
먼저 DeepSeek-V4-Flash-0731의 Q8 버전을 실행하고 Unsloth Studio와 OpenCode가 생성한 웹사이트를 호스팅할 수 있을 만큼의 GPU 메모리와 스토리지를 갖춘 RunPod 환경을 만듭니다.
Pod를 다음과 같이 구성하세요:
/workspace를 퍼시스턴트 볼륨 마운트 경로로 지정HF_TOKEN으로 추가8910과 9101 개방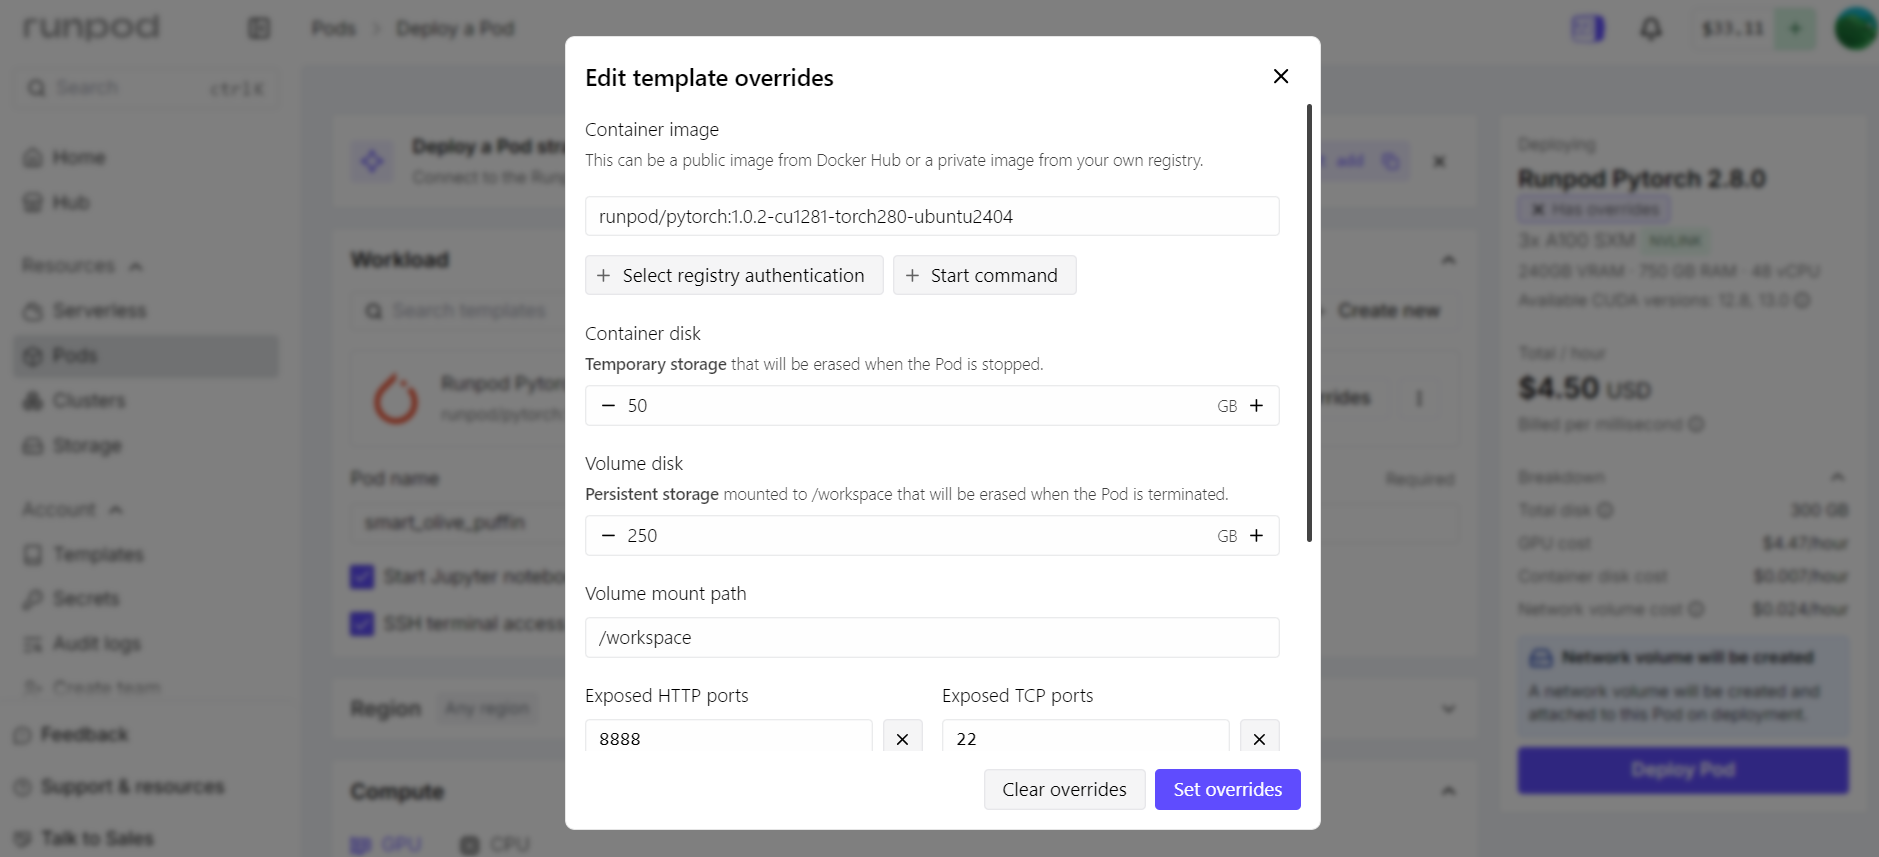
포트 8910은 Unsloth Studio와 로컬 추론 API에 사용됩니다. 포트 9101은 OpenCode가 생성한 대화형 웹사이트를 호스팅합니다.
RunPod는 HTTP 프록시를 통해 이러한 서비스를 노출하므로, 두 애플리케이션 모두 127.0.0.1만이 아니라 0.0.0.0에서 수신하도록 설정해야 합니다.
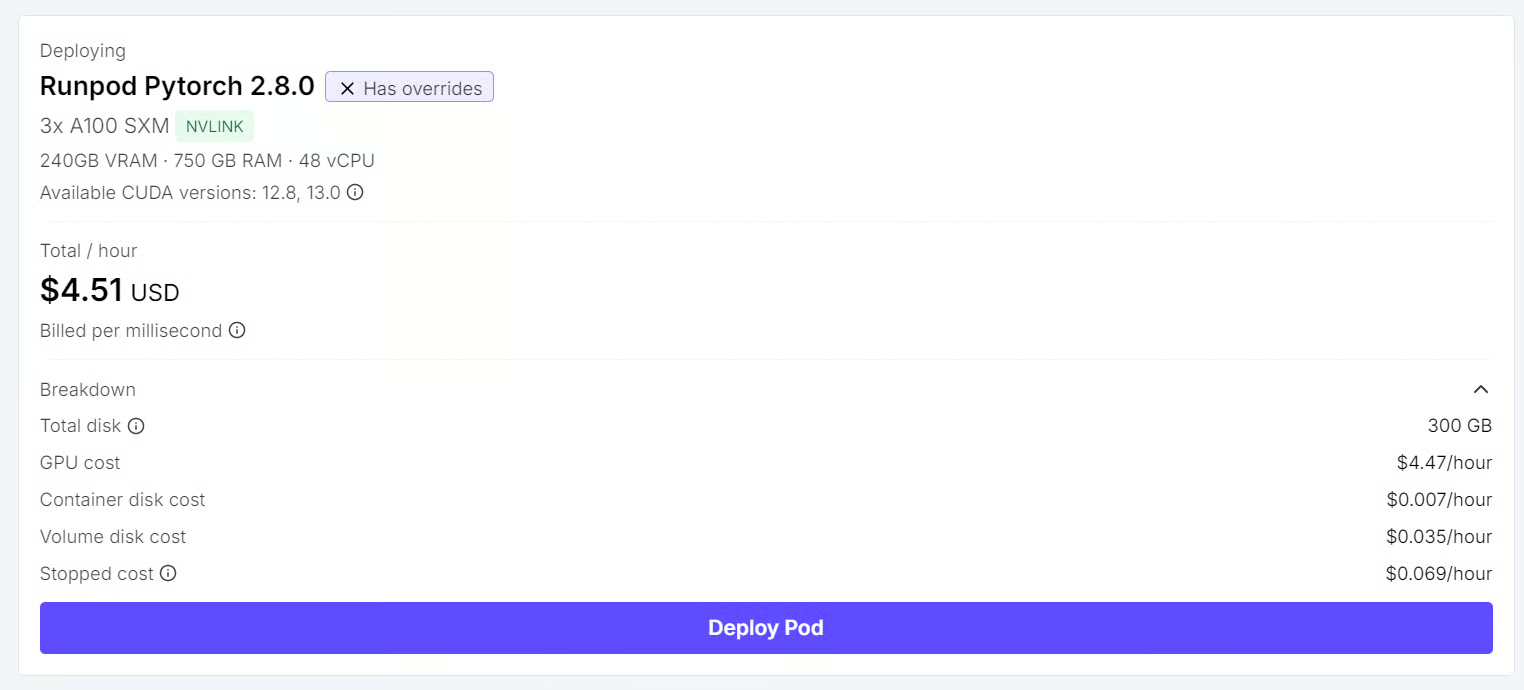
Pod를 배포한 후 Connect 탭을 열고 JupyterLab을 실행한 다음, 터미널 세션을 세 개 만듭니다:
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
작업을 별도 터미널로 분리하면 GPU 모니터링, 모델 문제 해결, 코딩 에이전트 실행을 동시에 더 쉽게 관리할 수 있습니다.
다음으로 Unsloth Studio를 설치하고, 지속 가능한 Hugging Face 캐시를 구성한 뒤, 인터페이스를 포트 8910에서 실행합니다.
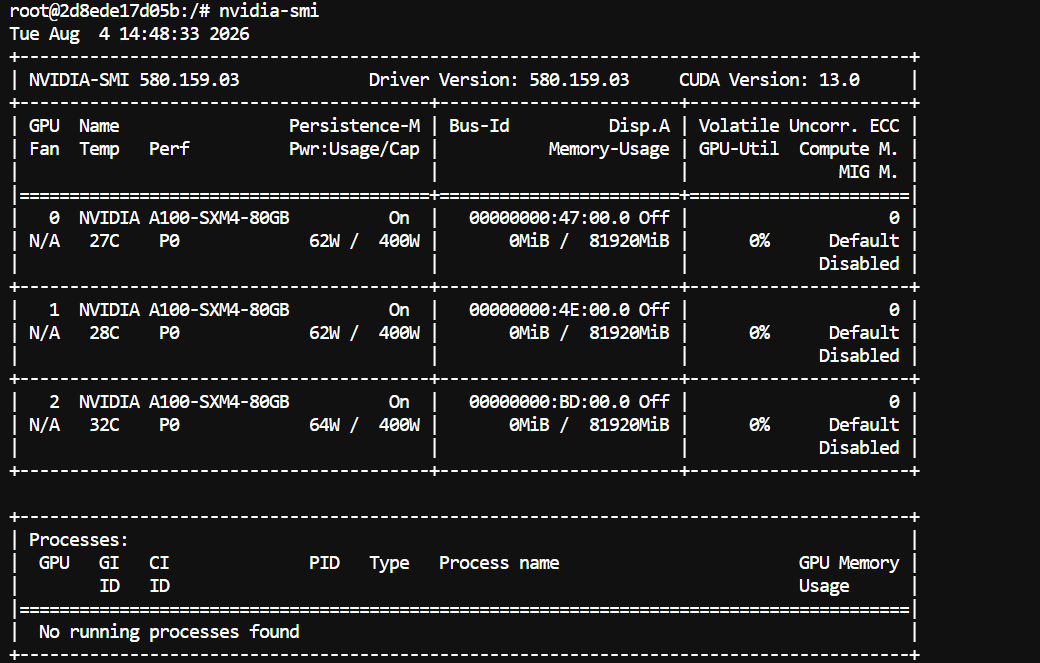
터미널 1에서 세 GPU가 모두 사용 가능한지 확인합니다:
nvidia-smiLinux 서버에 A100 GPU 3대가 모두 표시되어야 합니다.
RunPod 볼륨에 다운로드한 모델이 남도록, /workspace 내부에 지속 가능한 Hugging Face 캐시를 만듭니다:
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
다음으로 필요한 시스템 패키지와 Unsloth Studio를 설치합니다:
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh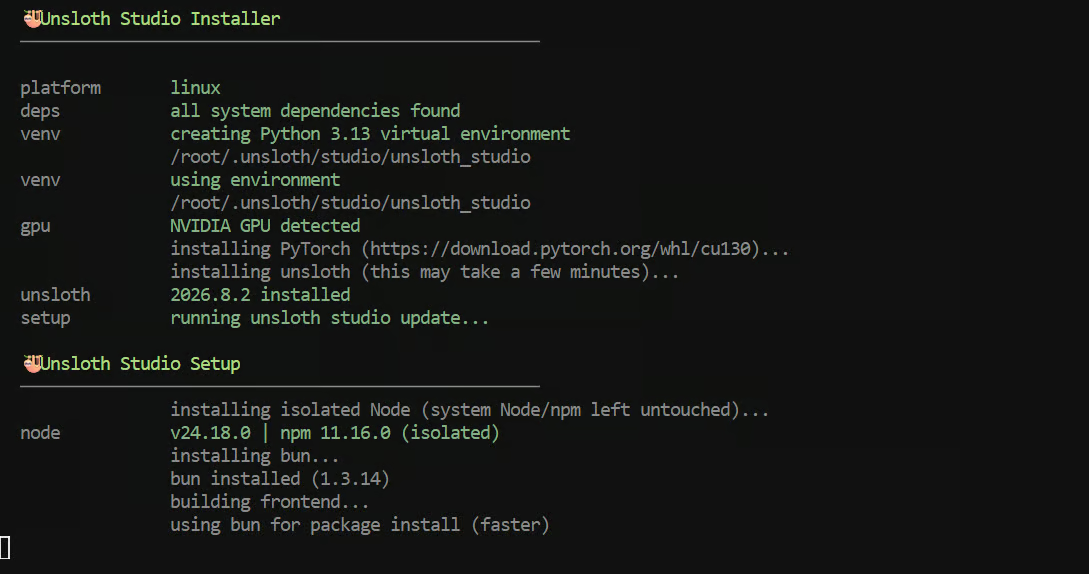
설치 관리자는 Studio 인터페이스, Python 환경, 의존성, 로컬 추론 컴포넌트를 설정합니다.
첫 설치에는 몇 분이 걸릴 수 있습니다.
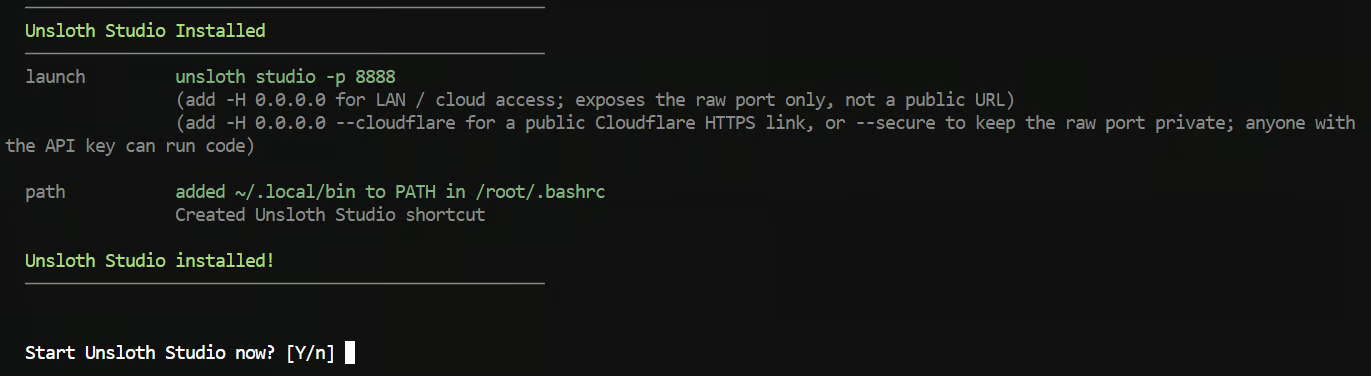
설치 관리자에서 Unsloth Studio를 지금 시작할지 묻는다면 “n”을 입력하세요.
포트 8910을 사용하고 올바른 네트워크 주소에서 수신하도록 수동으로 실행하겠습니다.
새 명령을 사용할 수 있도록 셸을 재시작합니다:
exec bash
cd /workspace
Studio를 실행하기 전에 기본 비밀번호를 재설정하세요:
unsloth studio reset-password설정 중 표시된 임시 비밀번호를 복사해 두세요. 재설정을 완료하는 데 필요할 수 있습니다.
이제 Unsloth Studio를 실행합니다:
unsloth studio \
  -H 0.0.0.0 \
  -p 8910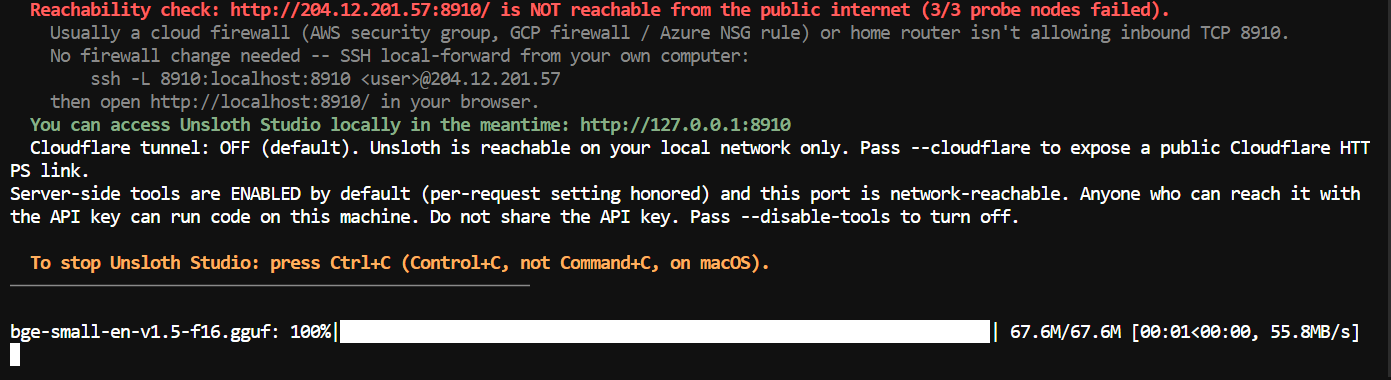
이제 Studio가 포트 8910에서 실행 중임을 표시해야 합니다. Unsloth Studio와 OpenCode를 사용하는 동안 터미널 1을 열어 두세요.
RunPod의 Connect 페이지로 돌아가 포트 8910의 HTTP Service를 엽니다.
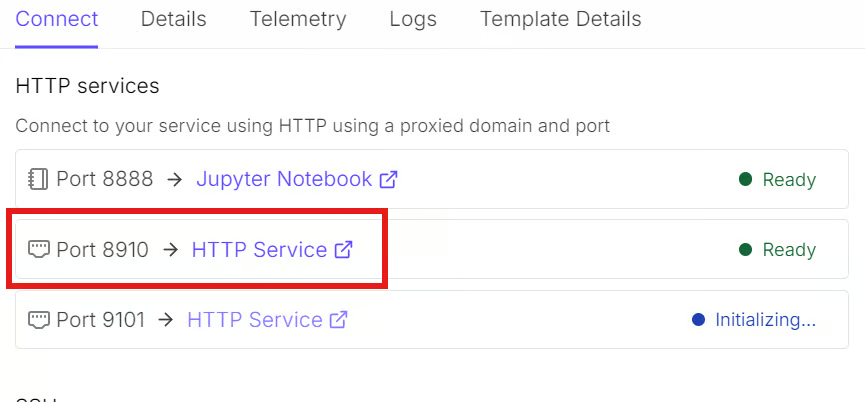
앞서 생성한 임시 비밀번호로 재설정을 완료한 뒤, 새로 만든 비밀번호로 로그인하세요.
온보딩 단계를 완료하거나 건너뛰고 Chat 페이지를 엽니다.
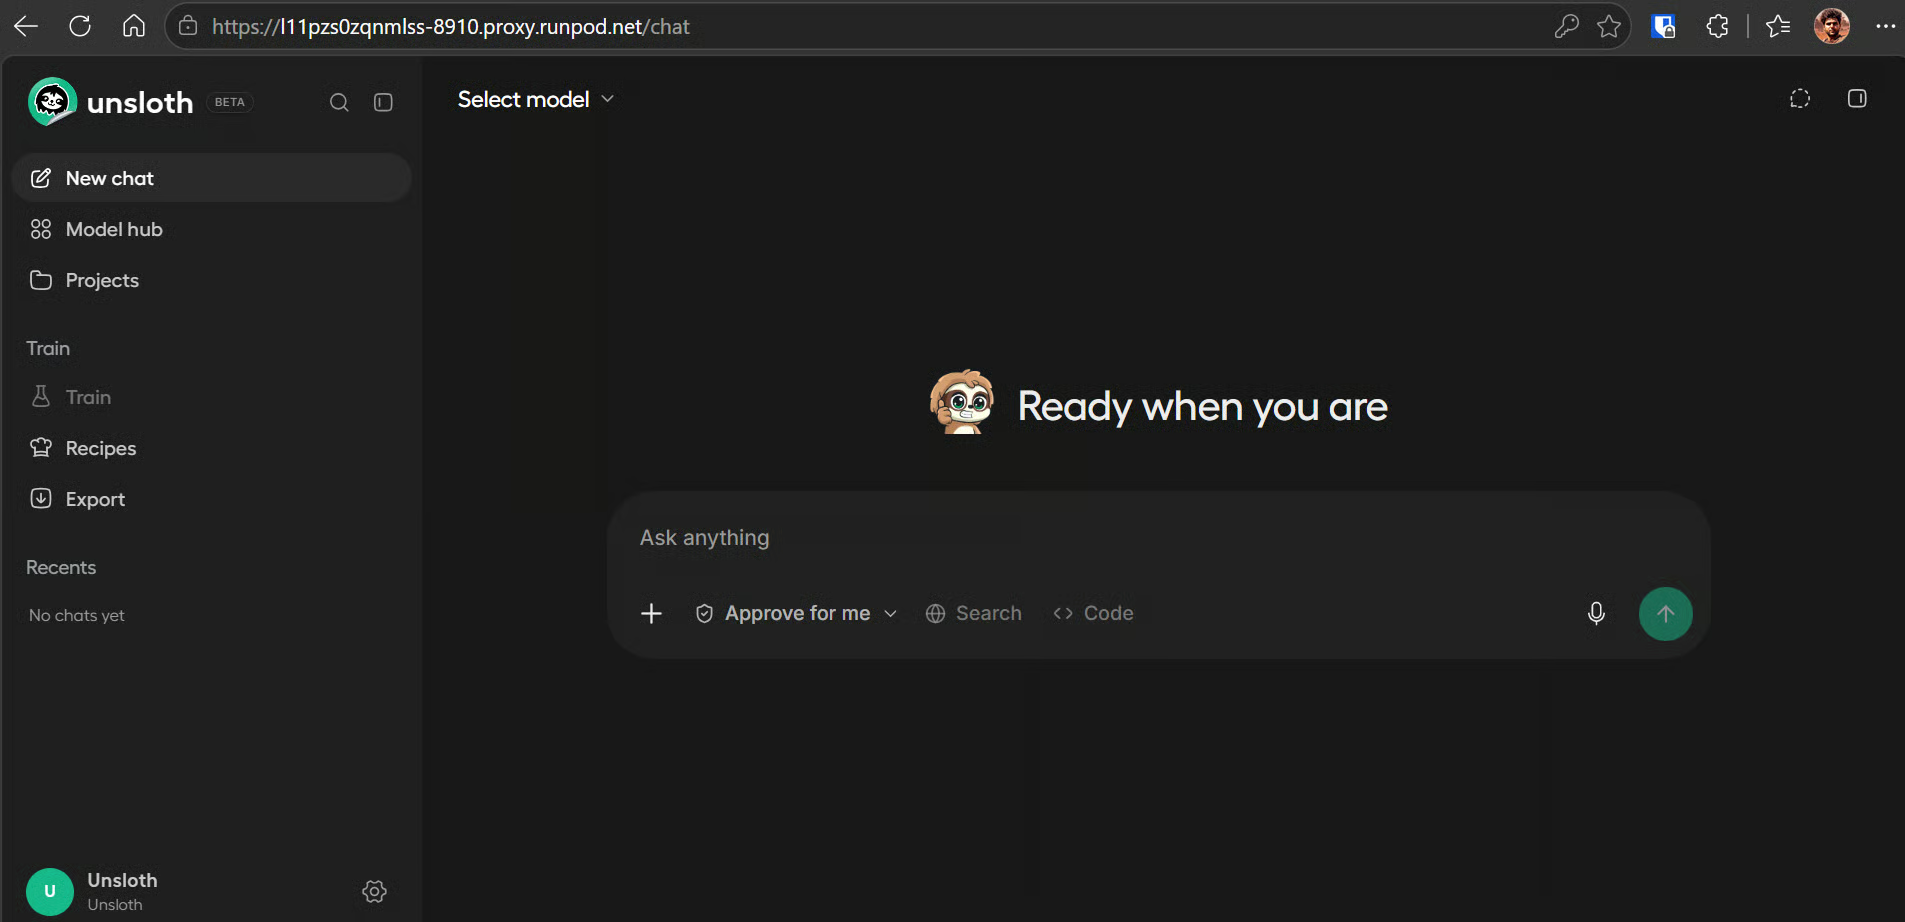
이제 Unsloth Studio가 실행 중이므로, Q8 모델을 다운로드해 세 GPU에 걸쳐 로드하고, 채팅과 도구 사용 기능을 테스트해 보겠습니다.
왼쪽 상단의 모델 선택기를 열고 unsloth/DeepSeek-V4-Flash-0731-GGUF를 검색한 후, Q8 양자화인 UD-Q8_K_XL을 선택합니다.
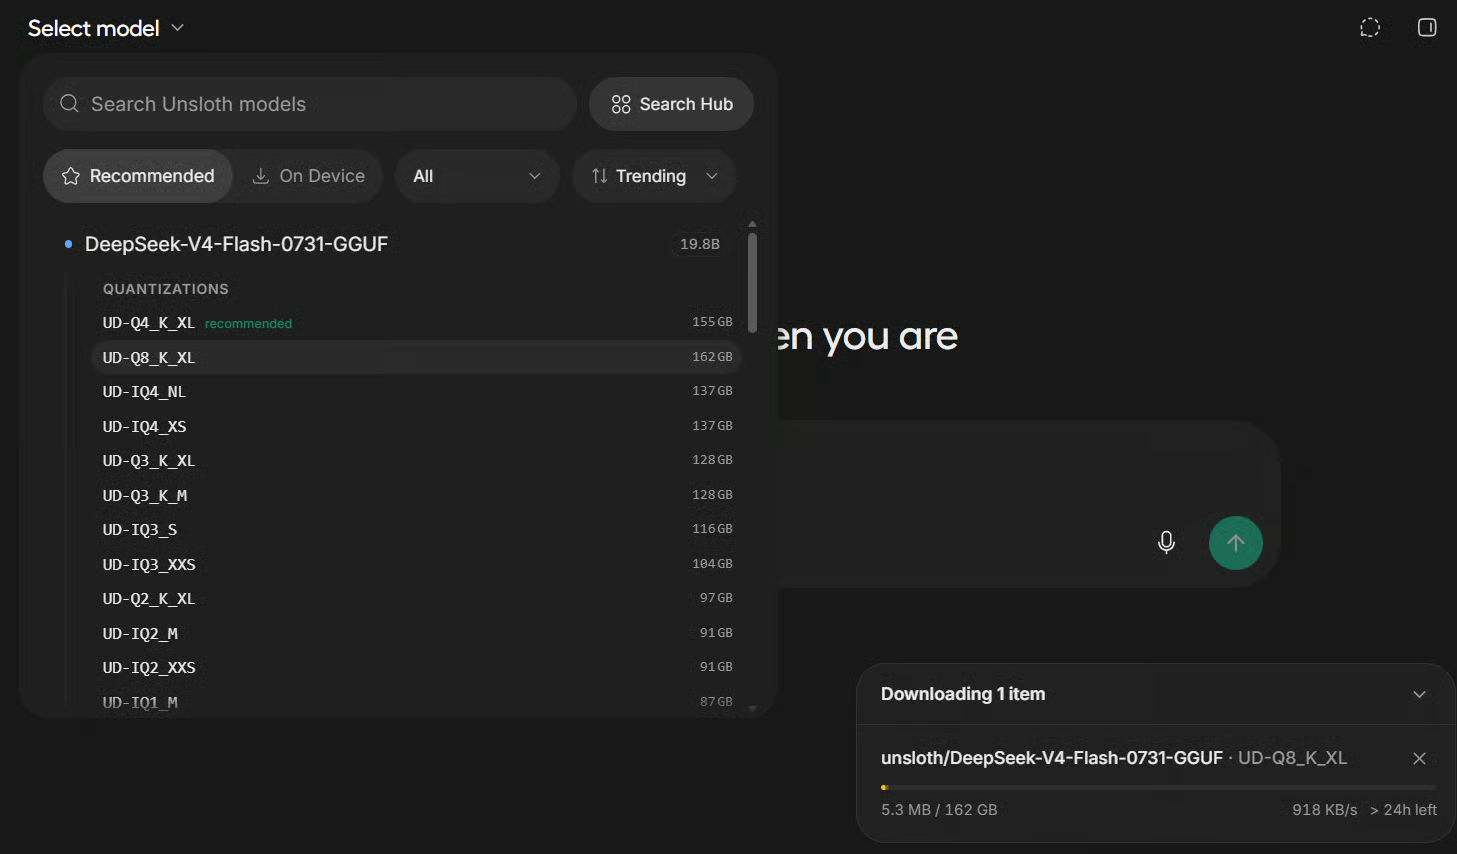
세 대의 A100 GPU는 VRAM이 충분하므로 Q8을 사용합니다. 하드웨어 메모리가 제한된 경우보다 낮은 양자화가 유용하지만, Q8은 원본 모델에 더 가까운 품질을 보존합니다.
다운로드가 완료되면 Unsloth Studio가 자동으로 모델을 GPU 메모리에 로드하기 시작합니다. Q8 모델은 매우 커서 몇 분이 걸릴 수 있습니다.
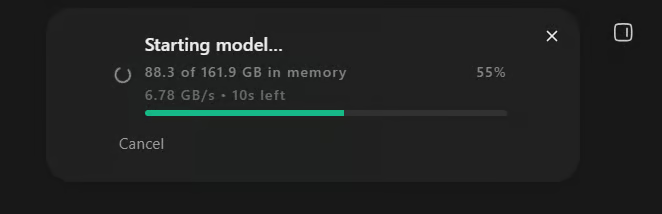
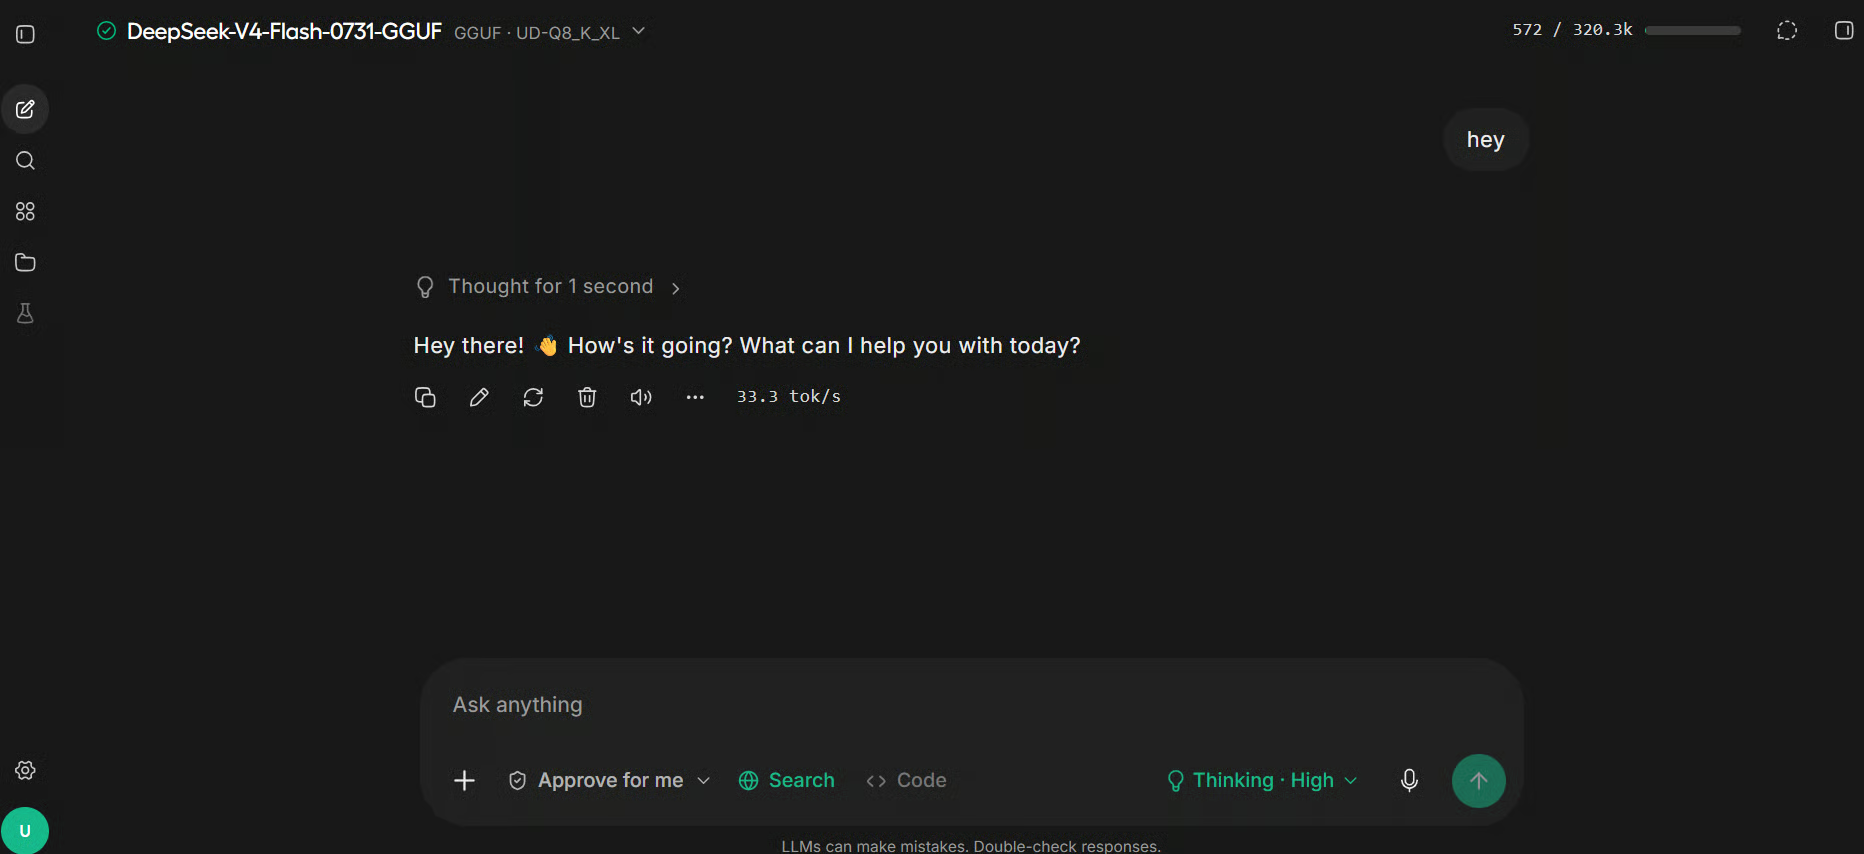
로드가 끝나면 Chat 페이지에서 간단한 프롬프트로 모델을 테스트하세요.
테스트에서는 추측 디코딩 없이 초당 약 33 토큰의 생성 속도가 나왔으며, 이 크기 모델로서는 합리적인 결과입니다.
Studio의 웹 검색 도구를 활성화해 최신 금/은 시세처럼 최신 정보를 조회하도록 요청할 수도 있습니다. 이는 모델이 내부 지식에만 의존하지 않고 외부 도구를 호출할 수 있음을 확인하는 유용한 방법입니다.
터미널 2에서 모델이 GPU에 어떻게 분산되었는지 확인합니다:
nvidia-smi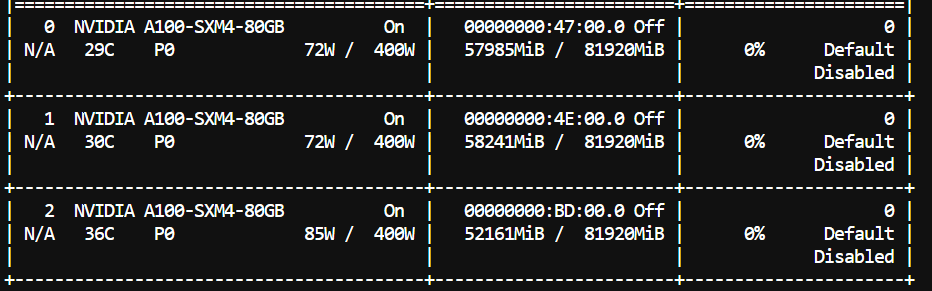
세 GPU 모두에서 상당한 메모리 사용량을 확인할 수 있어야 합니다.
테스트에서는 각 GPU가 약 70% 정도 사용되었습니다. 다만 이는 컨텍스트 윈도, KV 캐시, 추론 버퍼 등에 추가 VRAM이 필요하므로, Q8 모델 전체가 80GB GPU 두 대에 여유롭게 들어간다고 보장하지는 않습니다.
마지막으로 우리가 구축할 애플리케이션을 위한 계획 프롬프트로 모델을 테스트합니다:
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
모델은 애플리케이션 아키텍처, 컴포넌트, 데이터 흐름, 차트 라이브러리, 재무 계산, 인터페이스 설계를 아우르는 구조화된 개발 계획을 반환합니다.
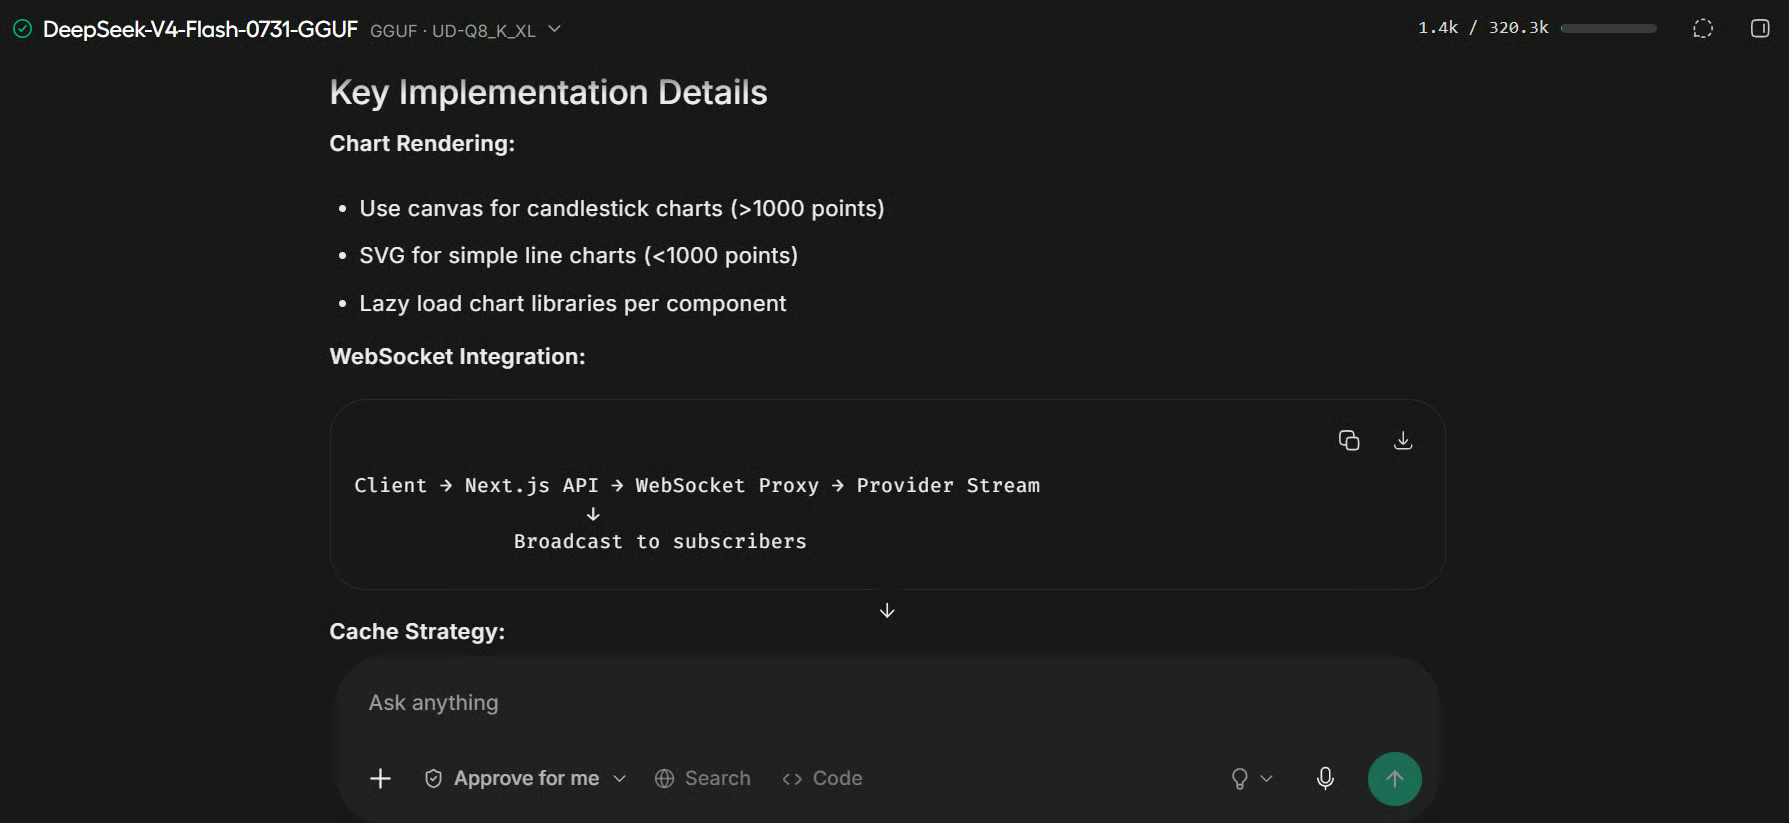
이제 모델이 Unsloth Studio에서 실행 중이므로, OpenCode에 연결해 로컬 코딩 에이전트로 사용할 수 있습니다.
터미널 3에서 Studio URL을 설정합니다:
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
새 프로젝트 디렉터리를 만듭니다:
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
Unsloth Studio를 통해 OpenCode를 시작합니다:
unsloth start opencode이 명령을 처음 실행하면 OpenCode 설치 권한을 요청합니다. “y”를 입력하세요.
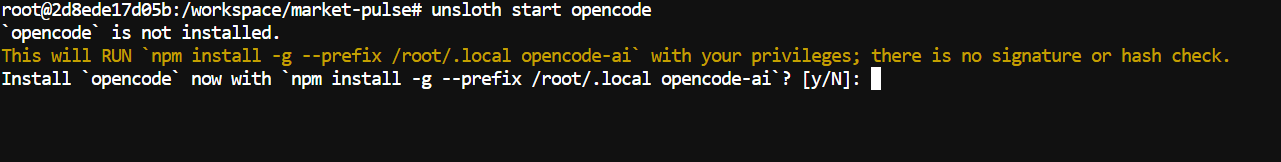
설치가 완료되면, 로컬에서 실행 중인 DeepSeek-V4-Flash-0731 모델이 이미 구성된 상태로 OpenCode가 시작됩니다.
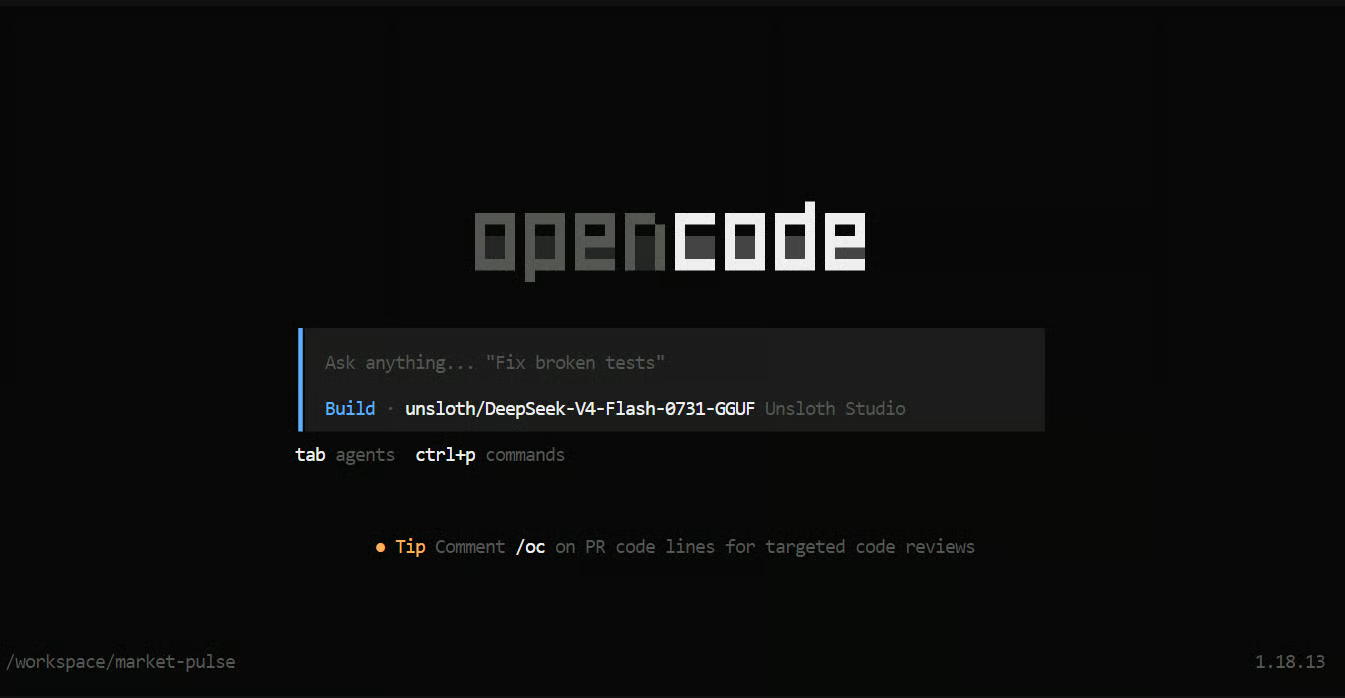
다음 두 줄 프롬프트를 OpenCode에 붙여넣습니다:
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
몇 초 내로 코딩 에이전트가 상세 작업 목록을 만들고 프로젝트를 단계별로 진행하기 시작할 것입니다.
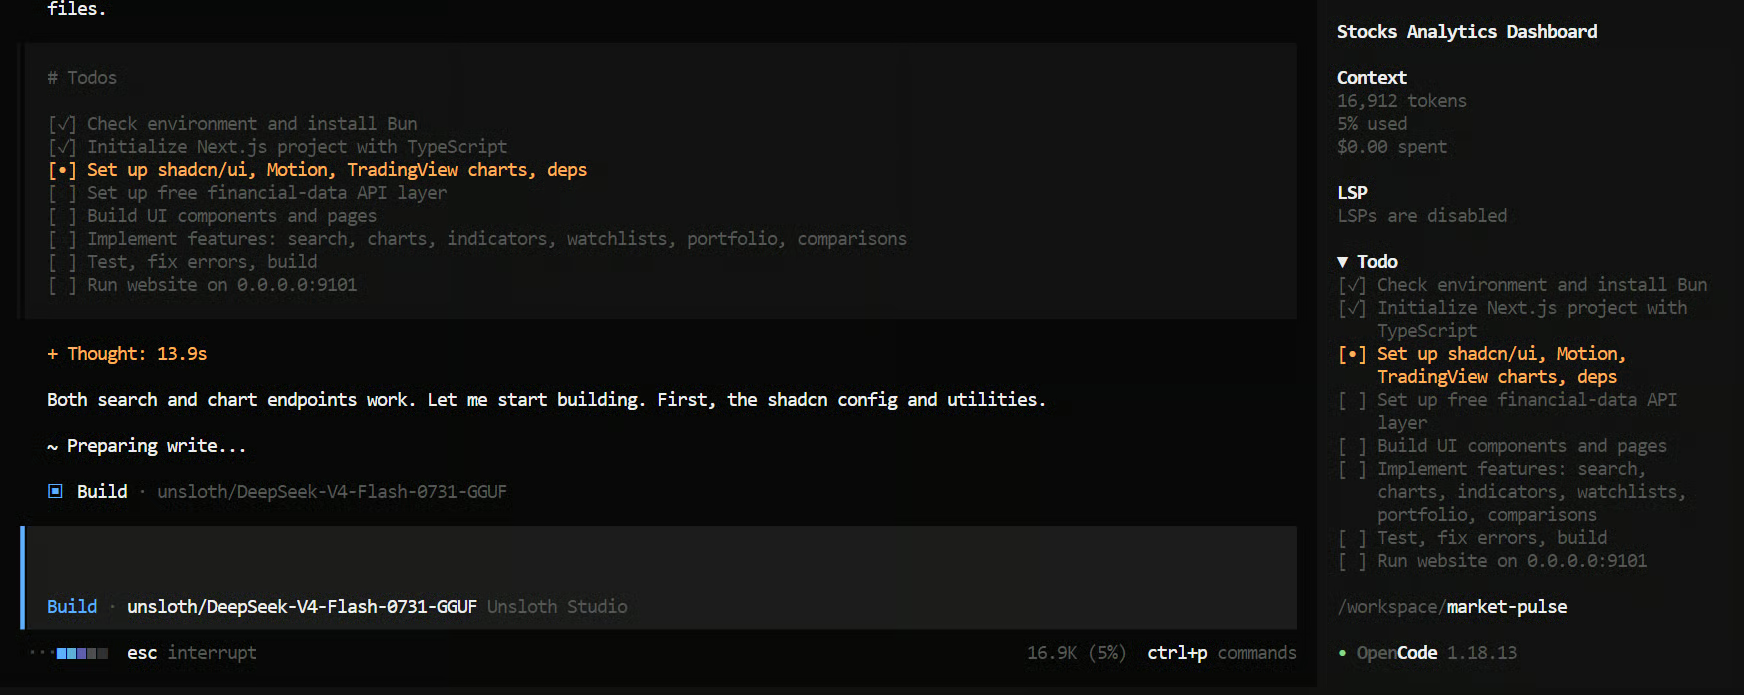
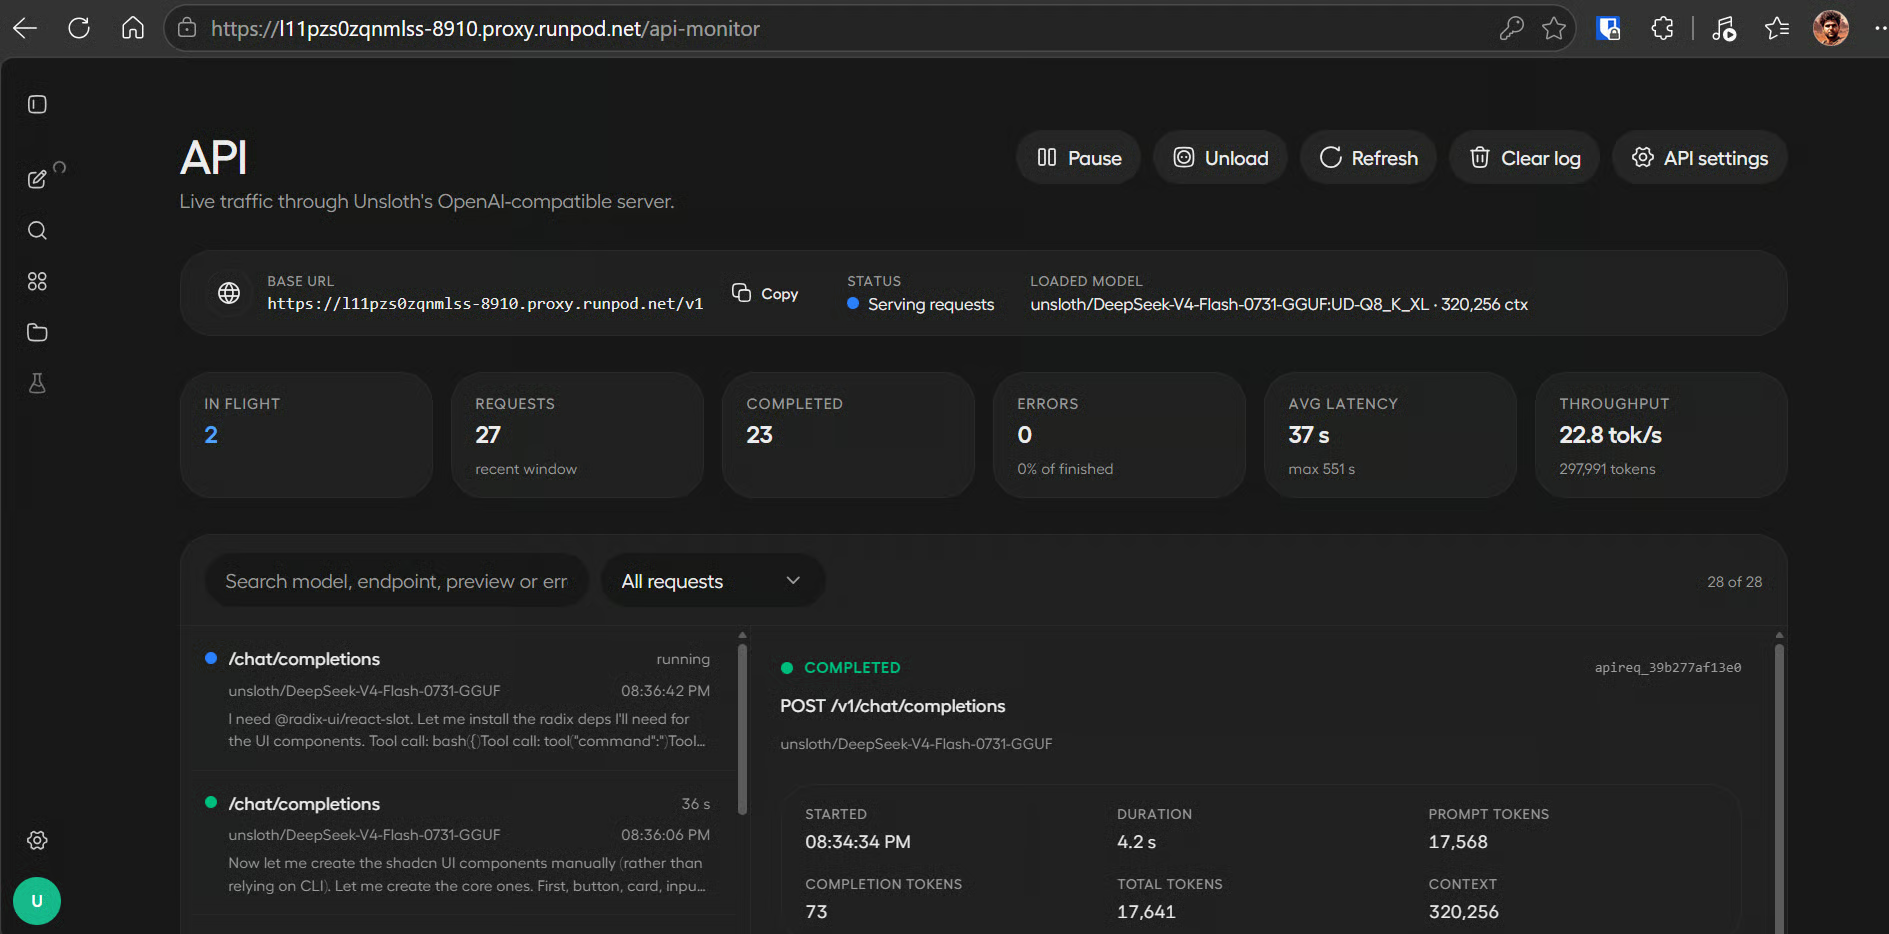
전체 빌드는 테스트에서 약 20분이 걸렸습니다. 실행 중에는 Unsloth Studio의 Settings의 API 모니터링 페이지를 열어 모델 사용량과 생성 속도를 확인할 수 있습니다.
코딩 워크플로 중 평균 초당 약 22.6 토큰을 관찰했습니다. 대화와 프로젝트 컨텍스트가 커질수록 속도는 느려질 수 있습니다.
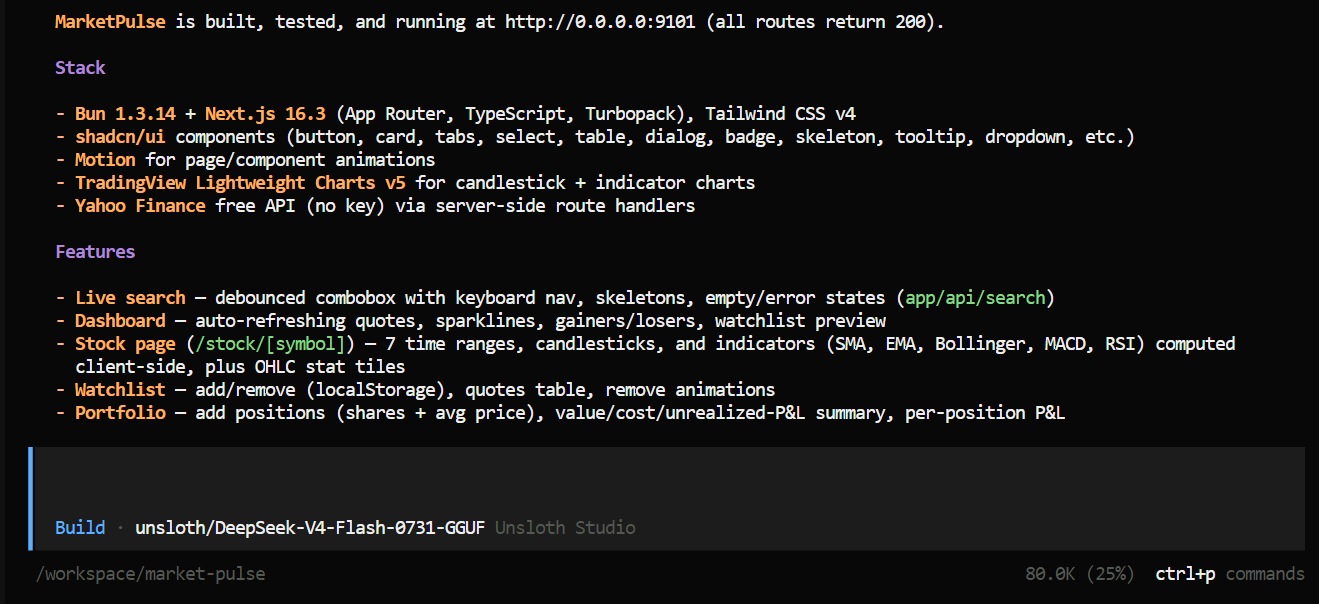
작업이 완료되면 OpenCode가 생성한 파일, 기능, 명령의 요약을 제공하고, 완성된 웹사이트를 포트 9101에서 시작해야 합니다.
RunPod의 Connect 페이지로 돌아가 포트 9101의 HTTP Service를 엽니다.
결과는 놀라울 정도로 완성도가 높았습니다. 웹사이트는 깔끔하고 애니메이션이 적용되어 전문 트레이딩 대시보드를 연상시켰습니다. 단 한 번의 프롬프트로 인터페이스, 데이터 뷰, 차트, 내비게이션을 포함한 웹 애플리케이션을 완성했습니다.
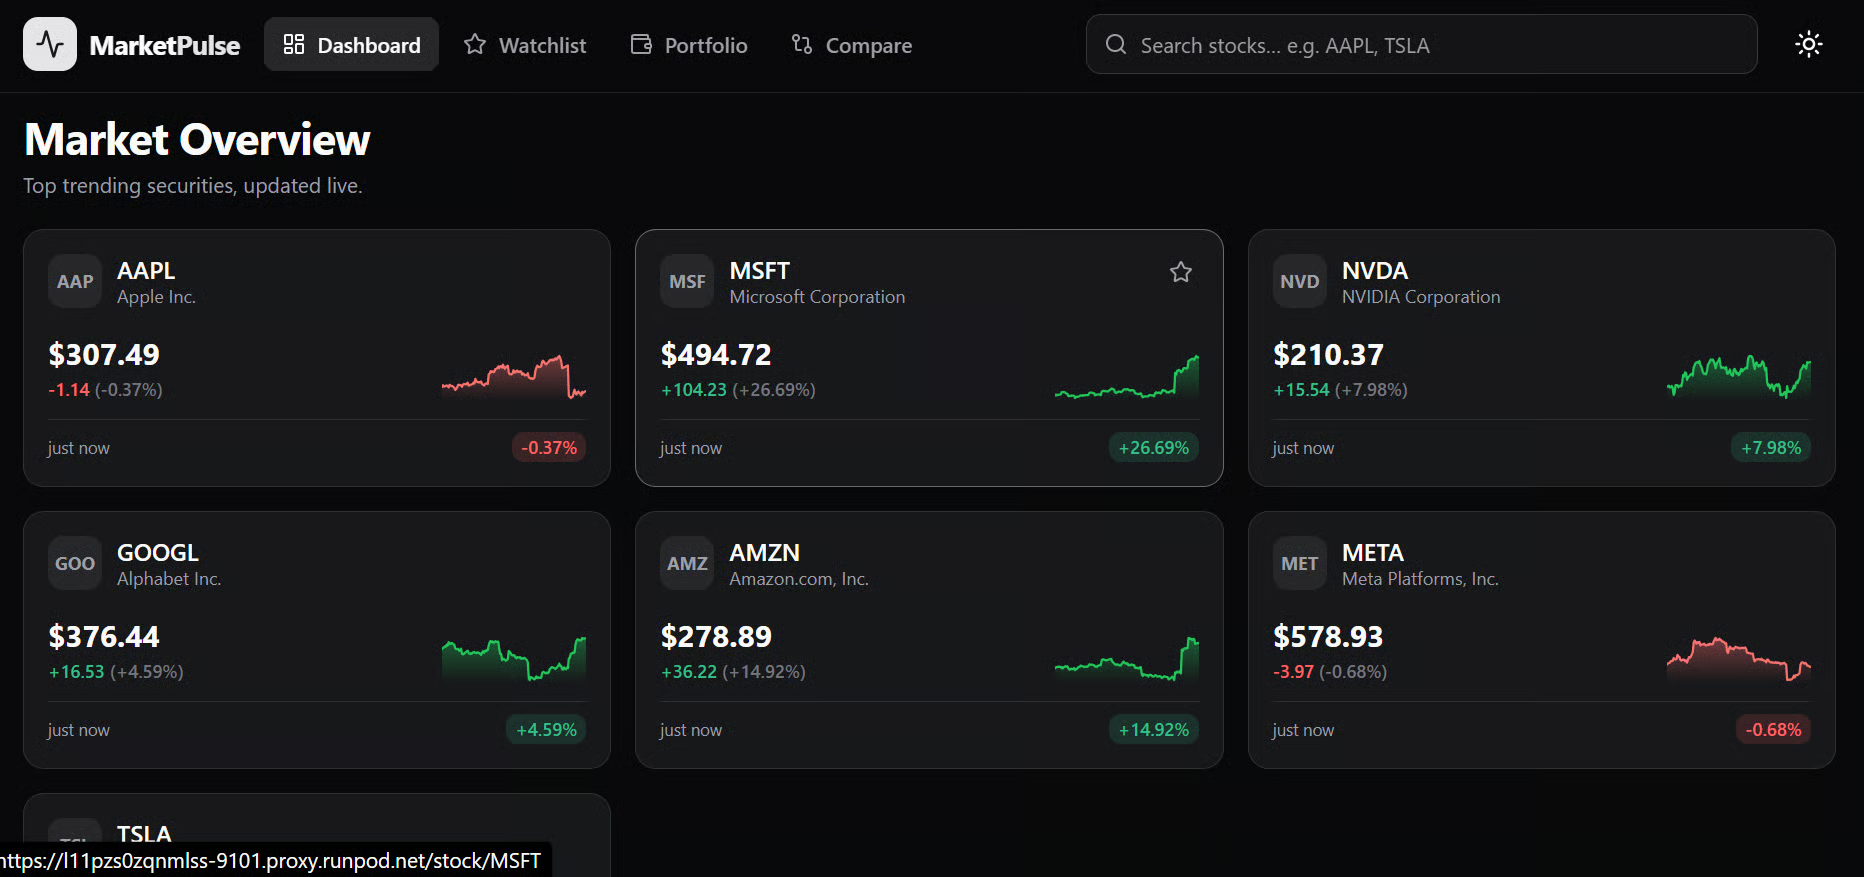
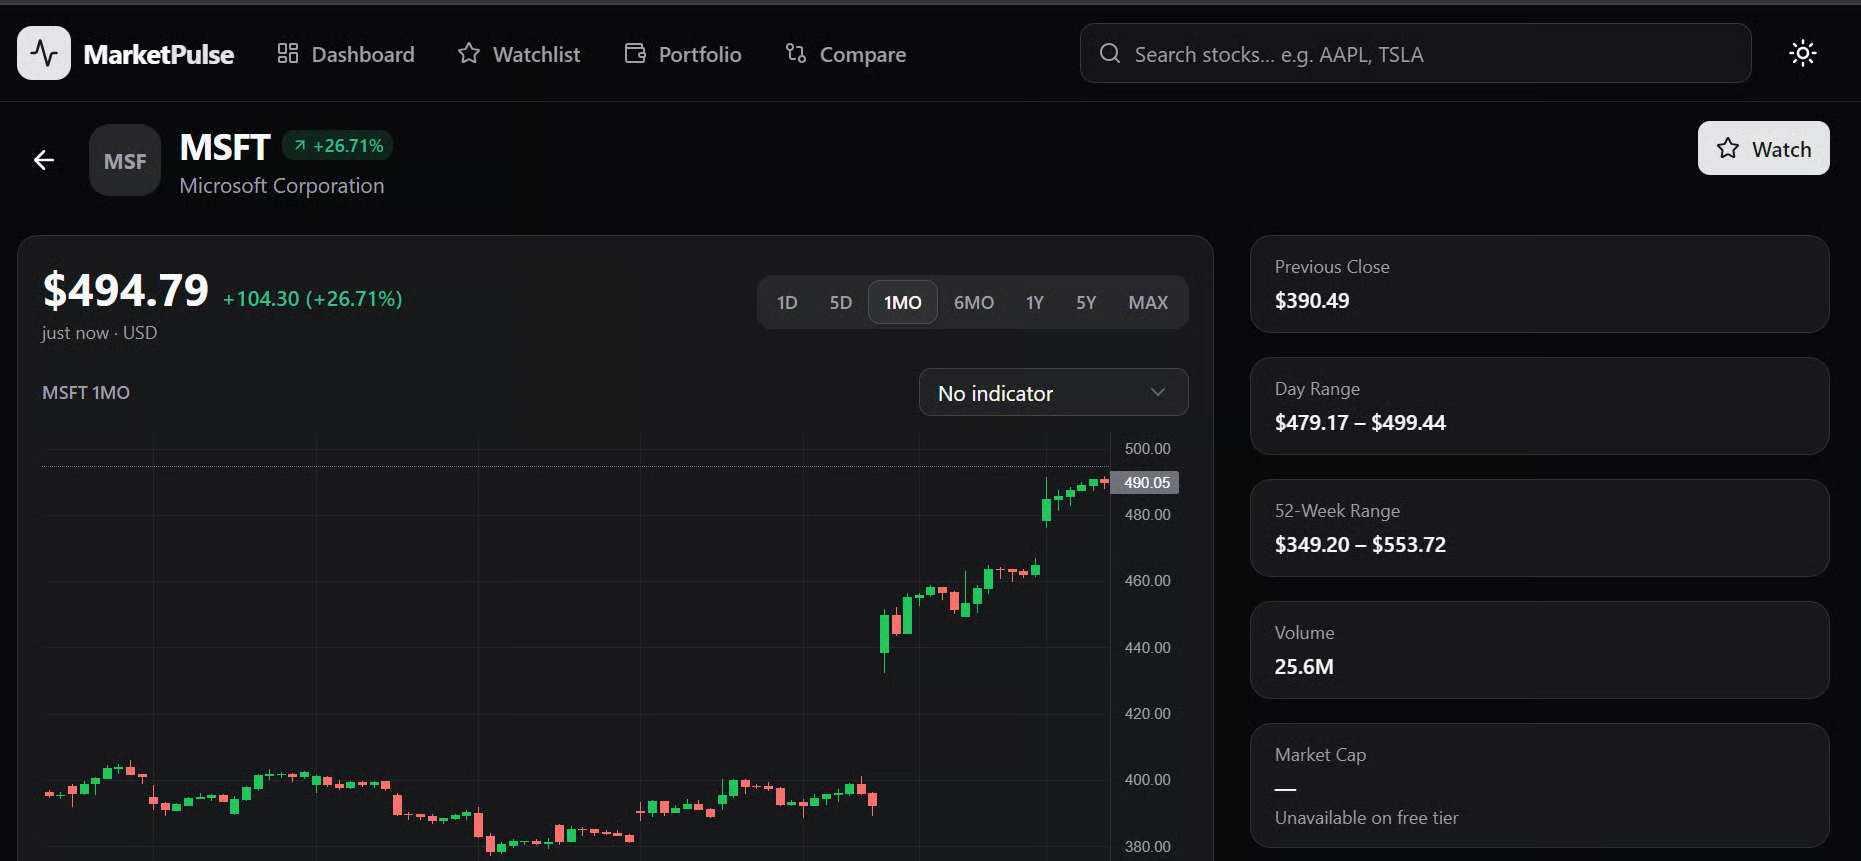
개별 종목 티커를 선택해 캔들스틱 차트, 과거 성과, 지표, 추가 기업 정보를 볼 수 있습니다.
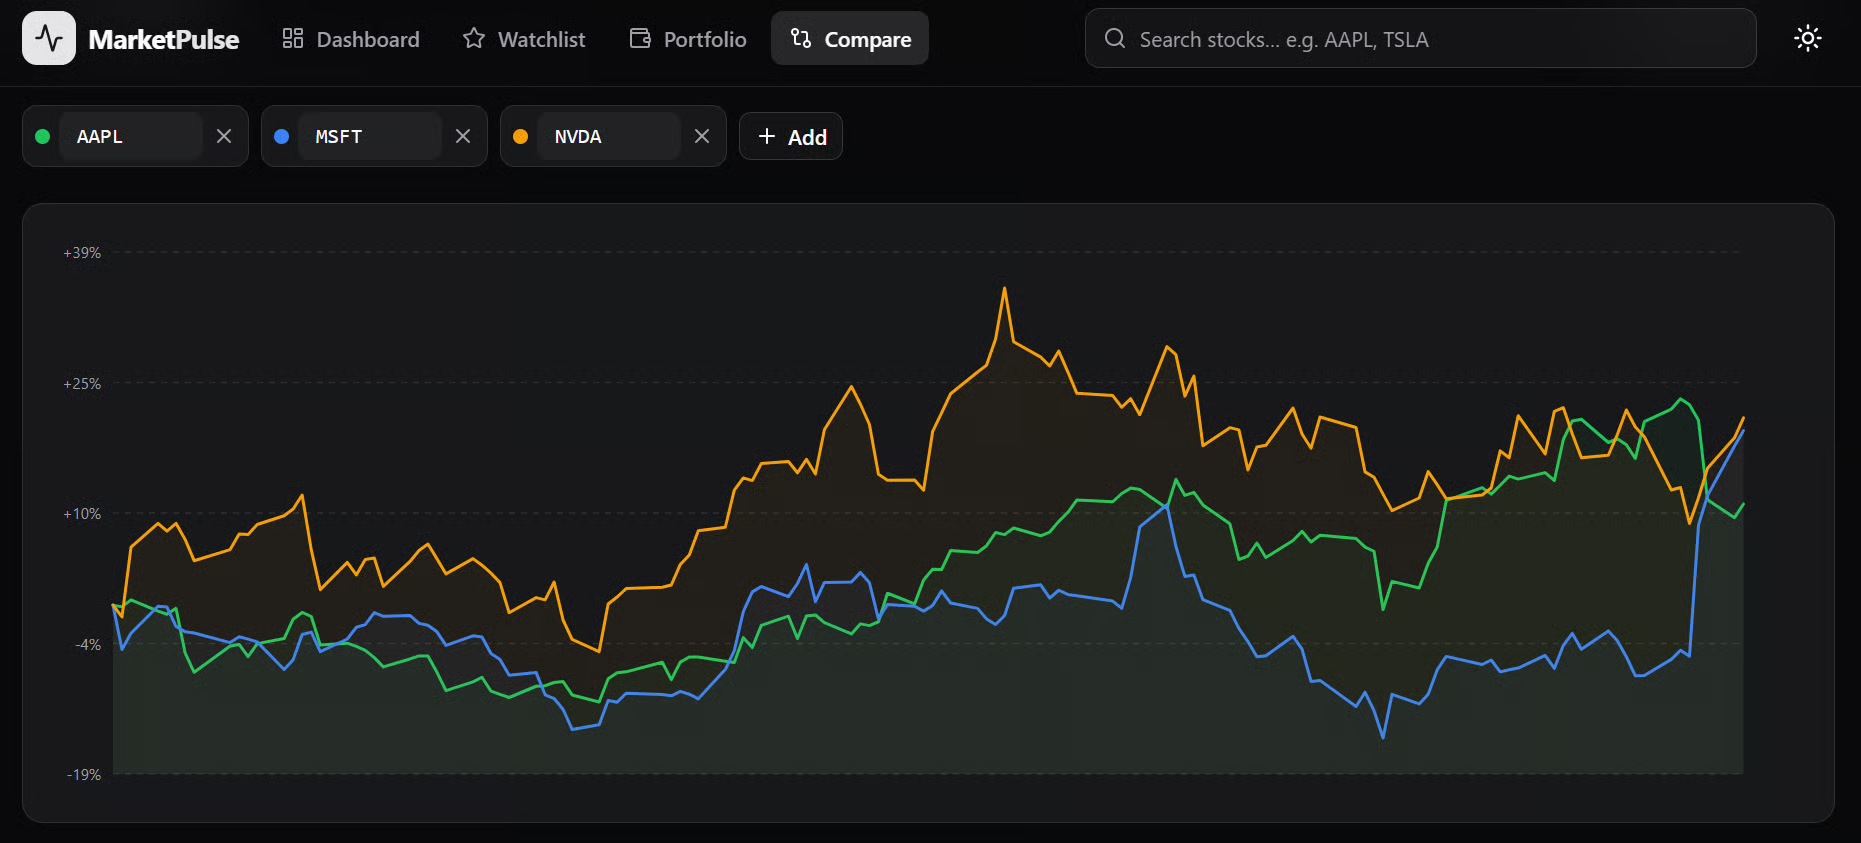
또한 Compare 탭에서는 여러 종목을 비교해 선택한 기간 동안 어떤 종목의 성과가 더 좋았는지 확인할 수 있습니다.
더 작은 로컬 모델이 단 하나의 프롬프트로 전체 웹사이트를 구축할 수 있었다는 점이 정말 놀라웠습니다.
애플리케이션 테스트 결과, 실시간 주가, 과거 시장 데이터, 차트, 지표, 비교 도구 등 주요 기능이 모두 의도한 대로 작동했습니다.
로컬 모델의 발전 속도가 매우 빠르며, 복잡하고 엔드 투 엔드에 가까운 개발 작업을 완료하는 능력이 눈에 띄게 향상되고 있습니다.
개인적으로 DeepSeek-V4-Flash-0731은 지금까지 테스트한 로컬 모델 중 최고였습니다.
Inkling, 2비트 GLM-5.2 양자화, 그리고 이전에 제가 선호하던 Qwen3.6-27B보다 더 뛰어난 성능을 보였습니다. 이는 공식 벤치마크가 아닌 제 경험에 기반하지만, 현재 제가 가장 선호하는 로컬 모델입니다.
대부분의 실용적인 워크로드에서는 여전히 공식 DeepSeek API로 시작하길 권합니다. 비용이 매우 저렴하기 때문입니다.
현재 V4 Flash 요금은 캐시되지 않은 입력 토큰 100만 개당 $0.14, 캐시된 입력 토큰 100만 개당 $0.0028, 출력 토큰 100만 개당 $0.28입니다. 이 요율로 캐시된 입력 토큰 10억 개 비용은 출력 비용을 제외하고 약 $2.80입니다.
Unsloth Studio를 선택하기 전에 llama.cpp로 모델을 실행해 보았습니다. 미리 빌드된 설치 관리자는 제 환경에 적합한 최신 CUDA 바이너리를 제공하지 않았고, 소스에서 최신 버전을 컴파일했음에도 DSpark 추측 디코딩을 활성화할 때 추가 문제가 발생했습니다.
결국 Unsloth Studio가 가장 간단한 설정을 제공해 대부분의 수동 구성을 없애 주었습니다. OpenCode와도 잘 작동했지만, 전체 애플리케이션 빌드에는 약 20분이 소요되었습니다.
Top DataCamp Courses
courses
courses
tracks