Courses
面向开发者的 AI 辅助编码
1小时30分钟
9.9K
更小更快不再意味着能力更弱。根据 DeepSeek 发布的评测结果,DeepSeek-V4-Flash-0731 激活参数占用远小于 DeepSeek-V4-Pro,但在智能体任务上仍接近前沿水平:在 Terminal Bench 2.1 中得分 82.7,而 GLM-5.2 为 81.0 和 Opus 4.8 为 85.0,此外,其 25.2 Agents’ Last Exam 得分也已非常接近 Opus 4.8 的 25.7。
由于权重开源,理论上只要合并后的 RAM 或 VRAM 足够,您就可以在自有硬件上运行该模型,将推理与项目数据完全掌控在本地。
本指南将配置一个三 GPU 的 RunPod 环境,安装并启动 Unsloth Studio,下载并在多 GPU 上加载 DeepSeek-V4-Flash-0731 的 Q8 版本,通过 Studio 测试模型,将本地推理服务器连接到 OpenCode,并使用编码智能体构建并启动一个交互式股票分析网站。
DeepSeek-V4-Flash-0731 是替代早期预览版的正式版本,在编码、工具使用和自主智能体任务方面有重大改进。其专家混合(Mixture-of-Experts)架构在每个 token 上只激活模型的一部分,从而在保持高效的同时,仍能提供强劲表现。
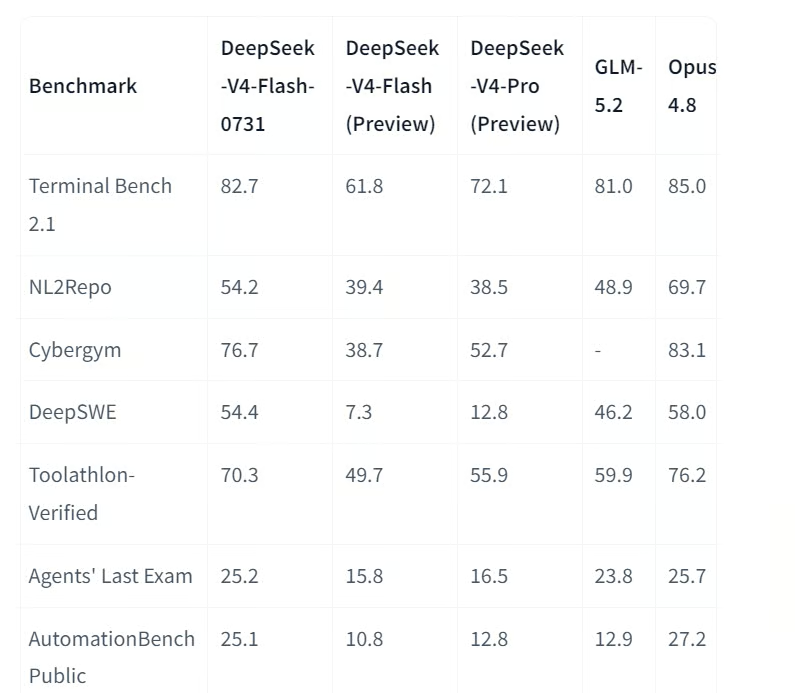
来源:deepseek-ai/DeepSeek-V4-Flash-0731 · Hugging Face
DeepSeek 报告称,模型在 Terminal Bench 2.1 上从 61.8 提升到 82.7,在 DeepSWE 上从 7.3 提升到 54.4,并在多项智能体基准上超越了更大的 DeepSeek-V4-Pro 预览版。
该模型支持最高一百万 token 的上下文窗口,适合大型代码库、长文档和需要大量上下文的复杂工作流。用户还可在低、 高和最大推理力度之间选择,以控制模型在解决任务上投入的时间。
DeepSeek-V4-Flash-0731 还引入了 DSpark 试探式解码。DSpark 会先草拟多个 token,再由主模型验证;据 DeepSeek 介绍,在兼容的推理引擎中可将生成速度提升 60%~85%。
我们将创建一个具备足够 GPU 显存和存储的 RunPod 环境,以运行 DeepSeek-V4-Flash-0731 的 Q8 版本,并同时托管 Unsloth Studio 和由 OpenCode 生成的网站。
将 Pod 配置为:
/workspace 作为持久卷挂载路径HF_TOKEN8910 和 9101 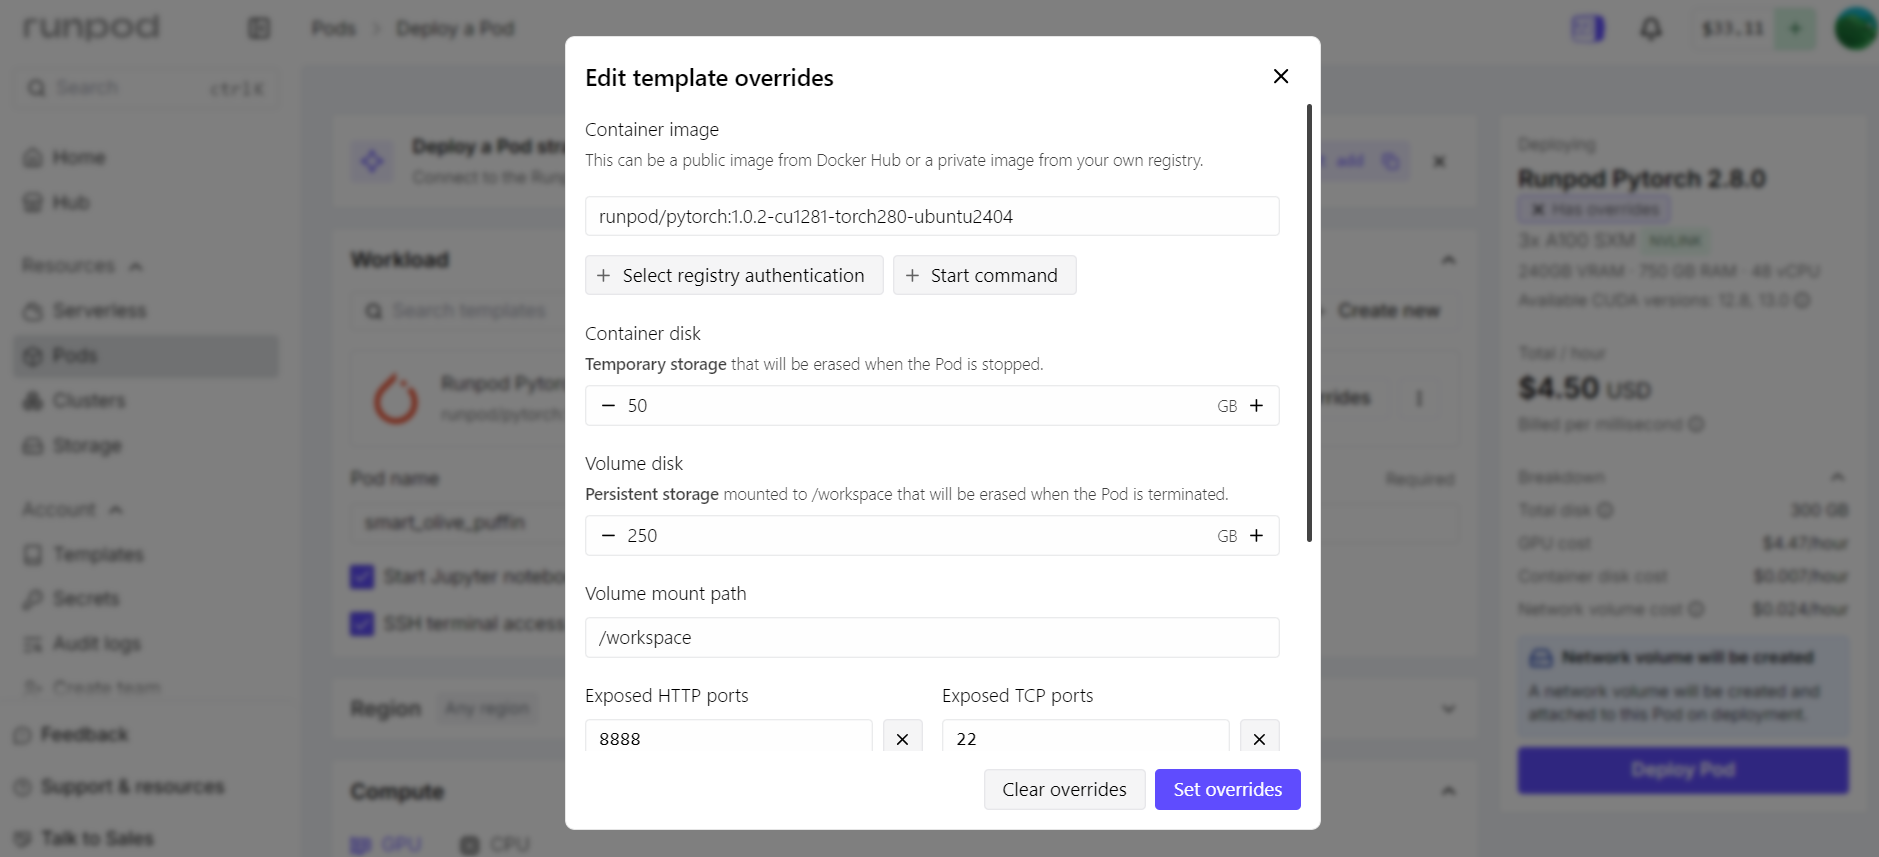
端口 8910 将用于 Unsloth Studio 及其本地推理 API。端口 9101 将用于承载 OpenCode 创建的交互式网站。
RunPod 通过其 HTTP 代理暴露这些服务,因此两款应用都必须监听 0.0.0.0,而非仅监听 127.0.0.1。
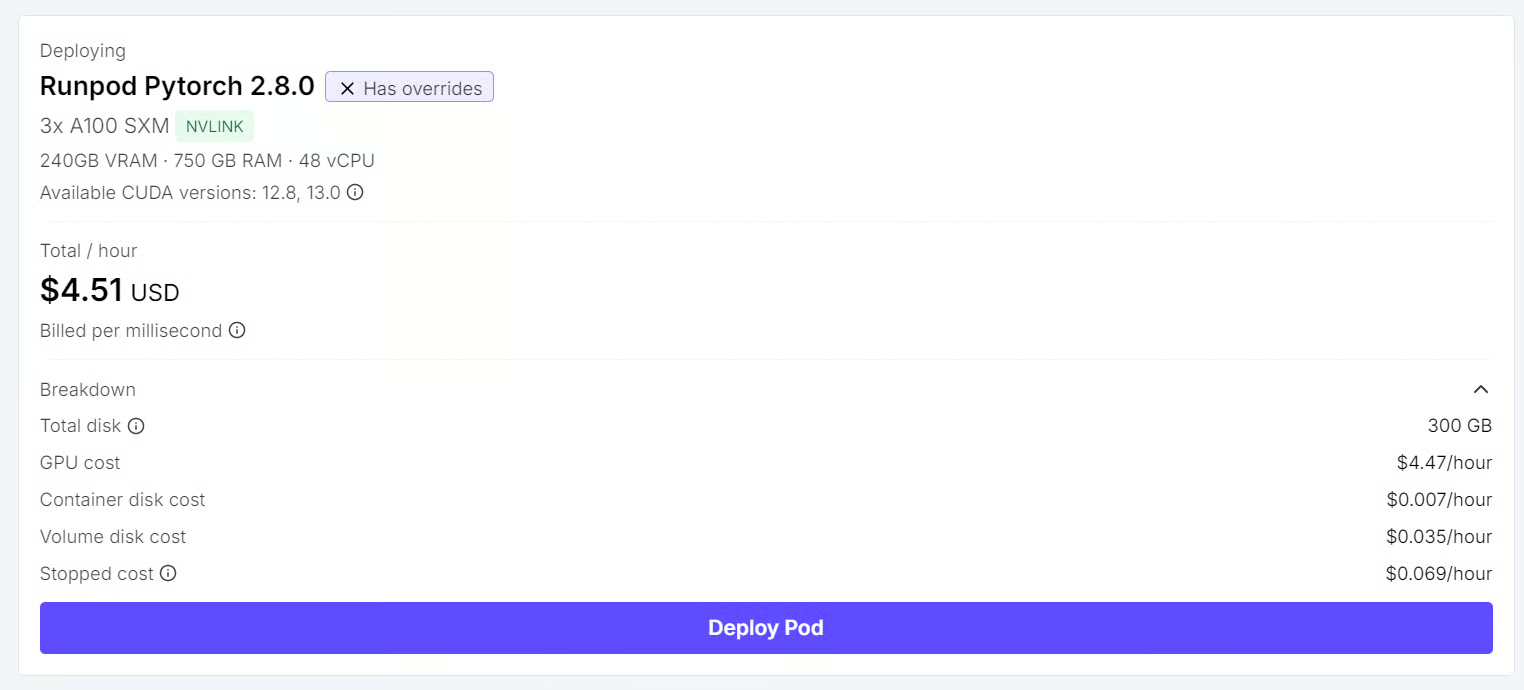
部署 Pod 后,打开“Connect”选项卡,启动 JupyterLab,并创建三个终端会话:
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
将任务分开到不同终端,便于同时监控 GPU、排查模型问题并运行编码智能体。
接下来,我们将安装 Unsloth Studio,配置持久化的 Hugging Face 缓存,并在端口 8910 上启动界面。
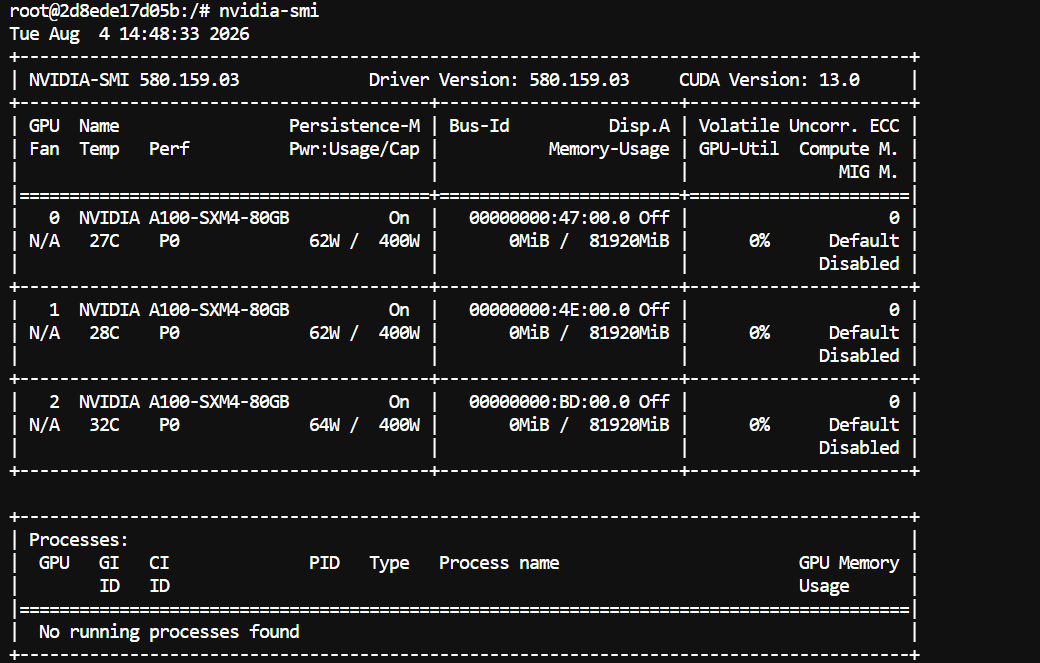
在终端 1 中,先确认三张 GPU 均可用:
nvidia-smi您应能看到 Linux 服务器上列出的三张 A100 GPU。
在 /workspace 内创建持久化的 Hugging Face 缓存,以便下载的模型保留在 RunPod 卷中:
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
接着,安装必需的系统软件包和 Unsloth Studio:
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh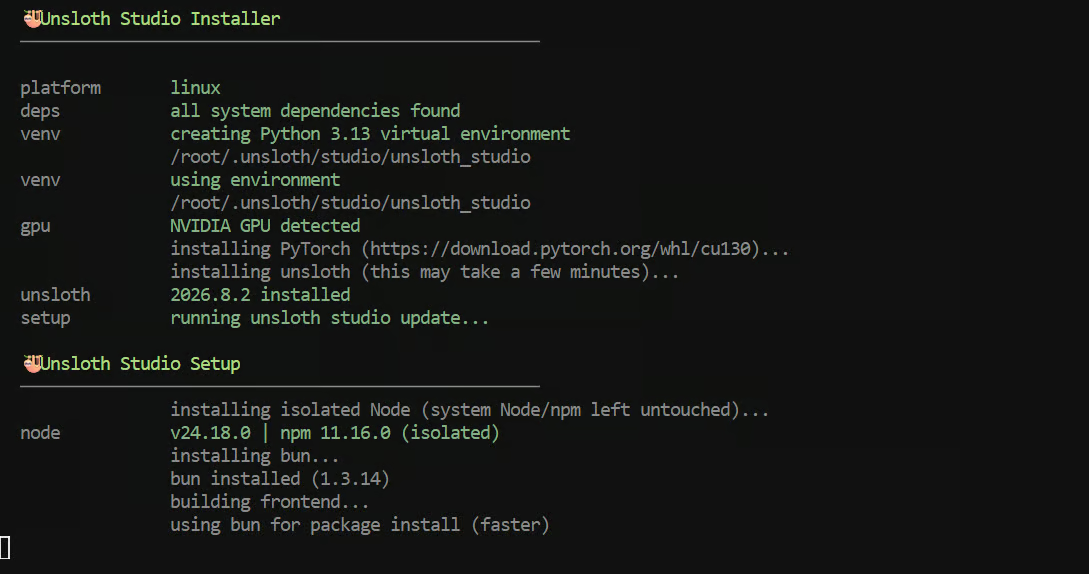
安装程序会配置 Studio 界面、Python 环境、依赖项和本地推理组件。
首次安装可能需要数分钟。
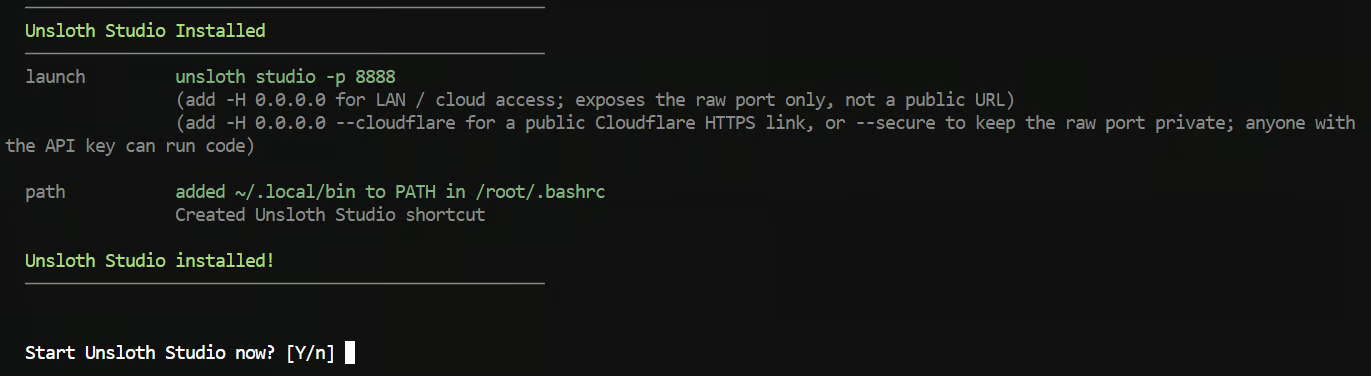
当安装程序询问是否立即启动 Unsloth Studio 时,输入“n”。
我们将手动启动,使其使用端口 8910 并监听正确的网络地址。
重启当前 shell,使新命令可用:
exec bash
cd /workspace
启动 Studio 前,先重置默认密码:
unsloth studio reset-password复制设置过程中显示的临时密码,您可能需要它来完成重置。
现在启动 Unsloth Studio:
unsloth studio \
  -H 0.0.0.0 \
  -p 8910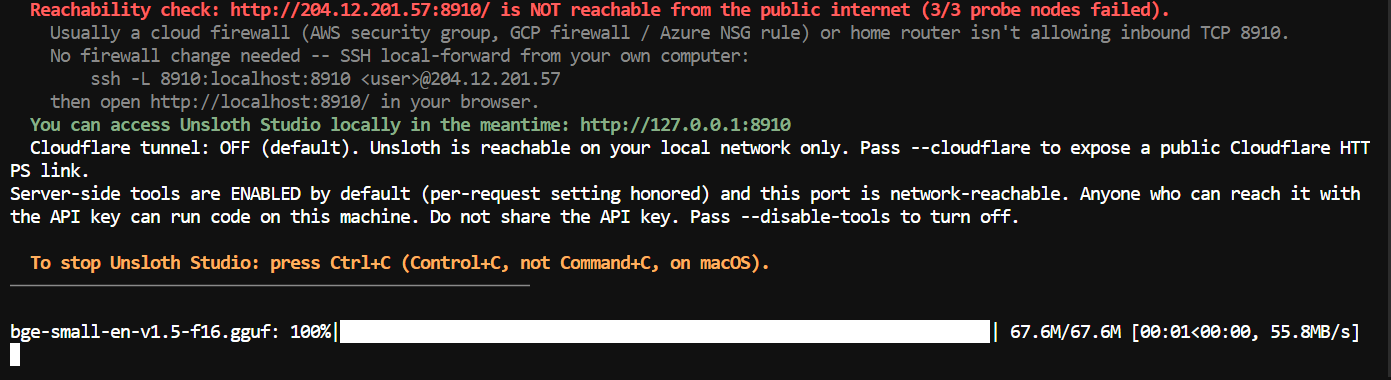
此时 Studio 应提示其运行在端口 8910。在使用 Unsloth Studio 和 OpenCode 期间,请保持终端 1 处于打开状态。
回到 RunPod 的“Connect”页面,打开端口 8910 的 HTTP Service。
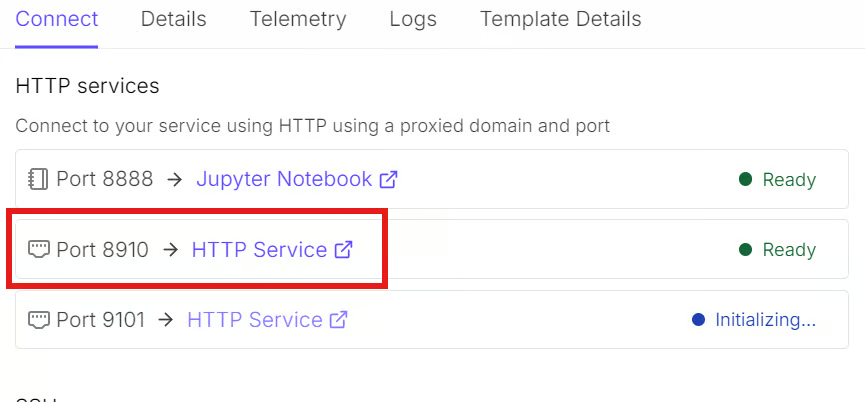
使用先前生成的临时密码完成重置,然后用您新设置的密码登录。
完成或跳过引导步骤后,打开 Chat 页面。
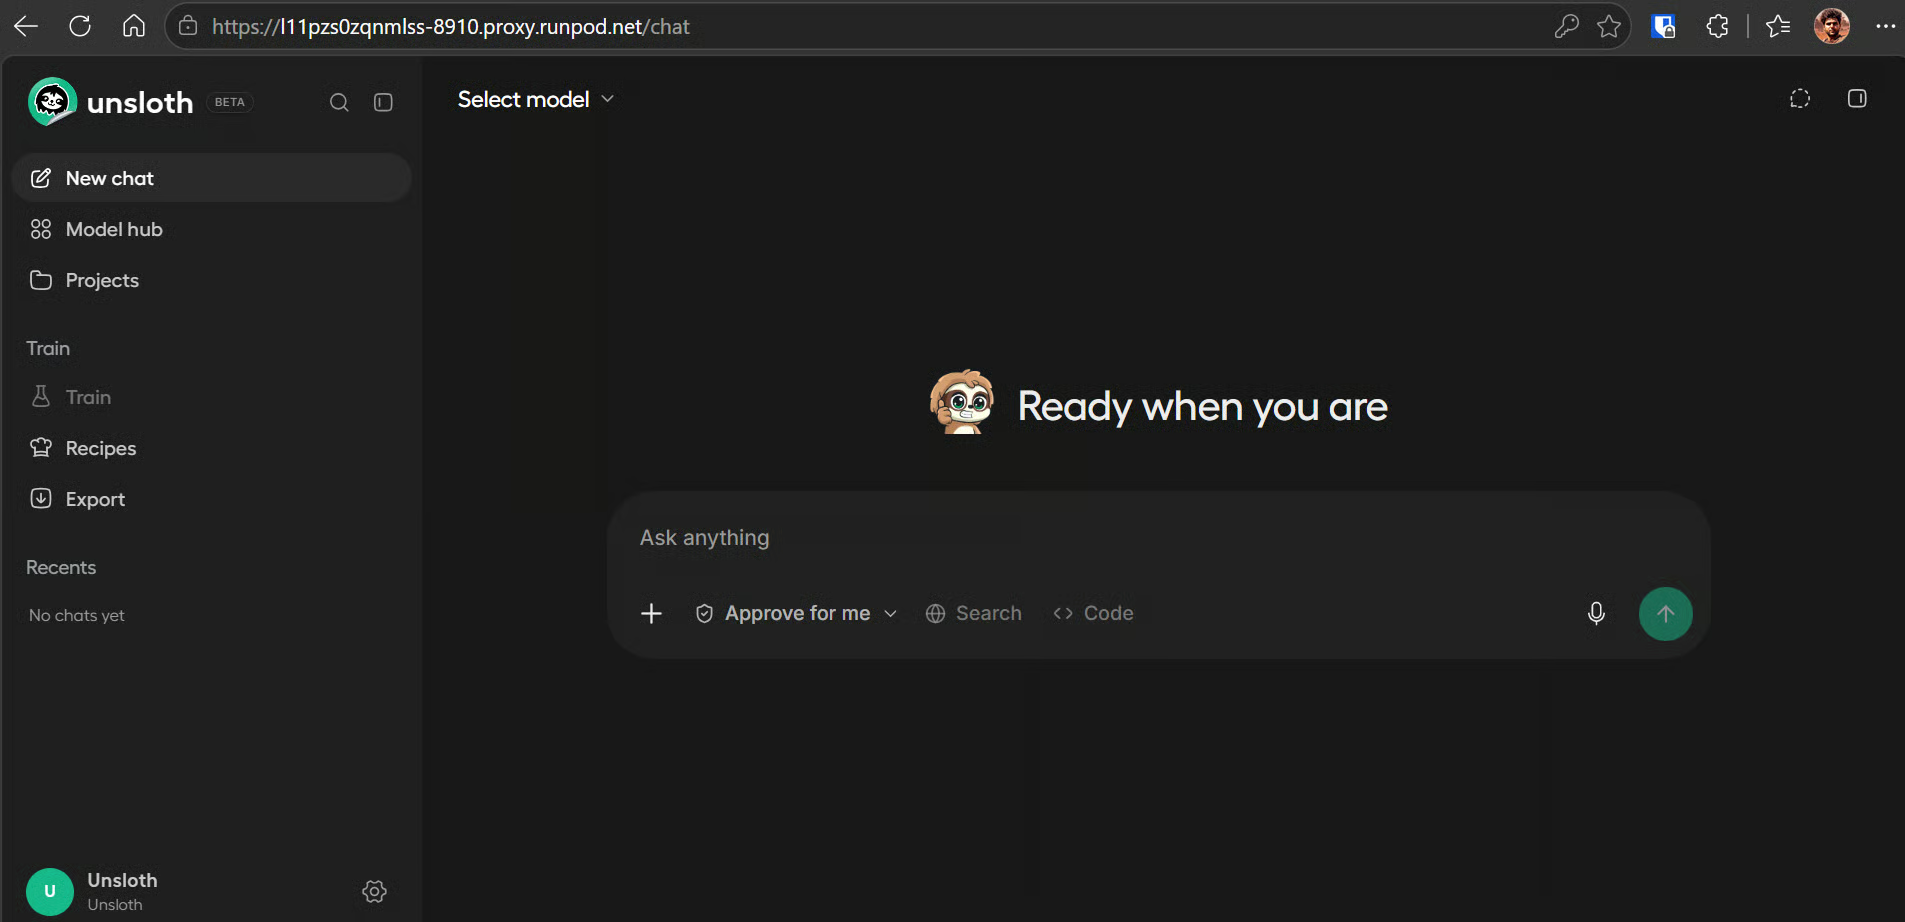
现在 Unsloth Studio 已运行,我们可以下载 Q8 模型,将其分布加载到三张 GPU 上,并测试其聊天与工具调用能力。
打开左上角的模型选择器,搜索 unsloth/DeepSeek-V4-Flash-0731-GGUF,然后选择 Q8 量化的 UD-Q8_K_XL。
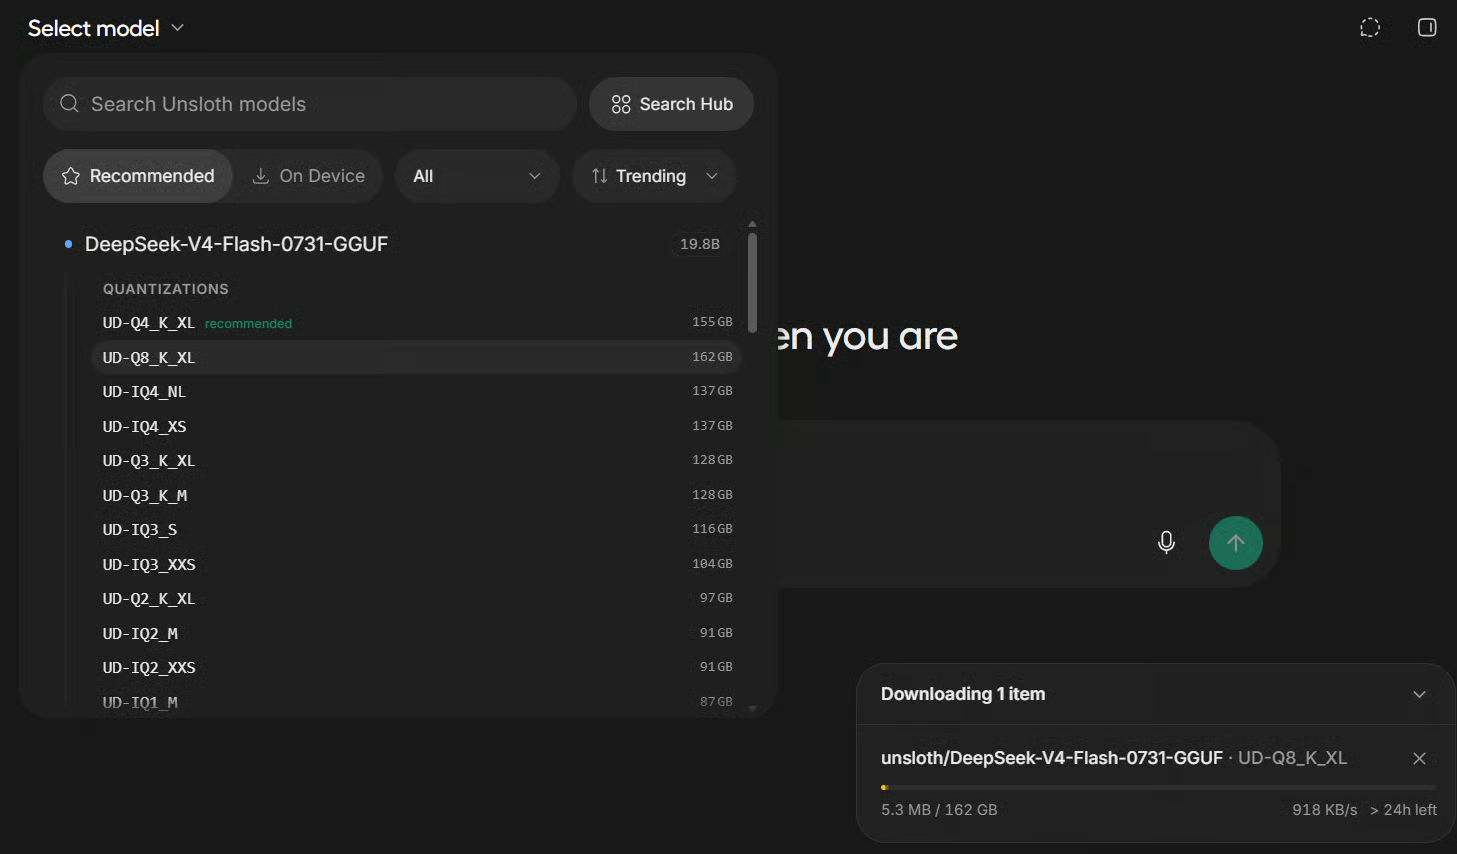
之所以使用 Q8,是因为三张 A100 GPU 的合计显存足够。该量化更接近原模型质量;当硬件内存受限时,更低位量化会更实用。
下载完成后,Unsloth Studio 会自动开始将模型加载到显存中。由于 Q8 模型非常大,这一步可能需要几分钟。
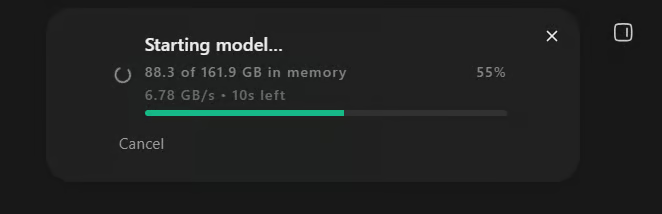
加载完成后,使用“Chat” 页面用几个简单提示测试模型。
在我们的测试中,在未启用试探式解码的情况下生成速度约为每秒 33 token,对该规模模型而言是一个合理速度。
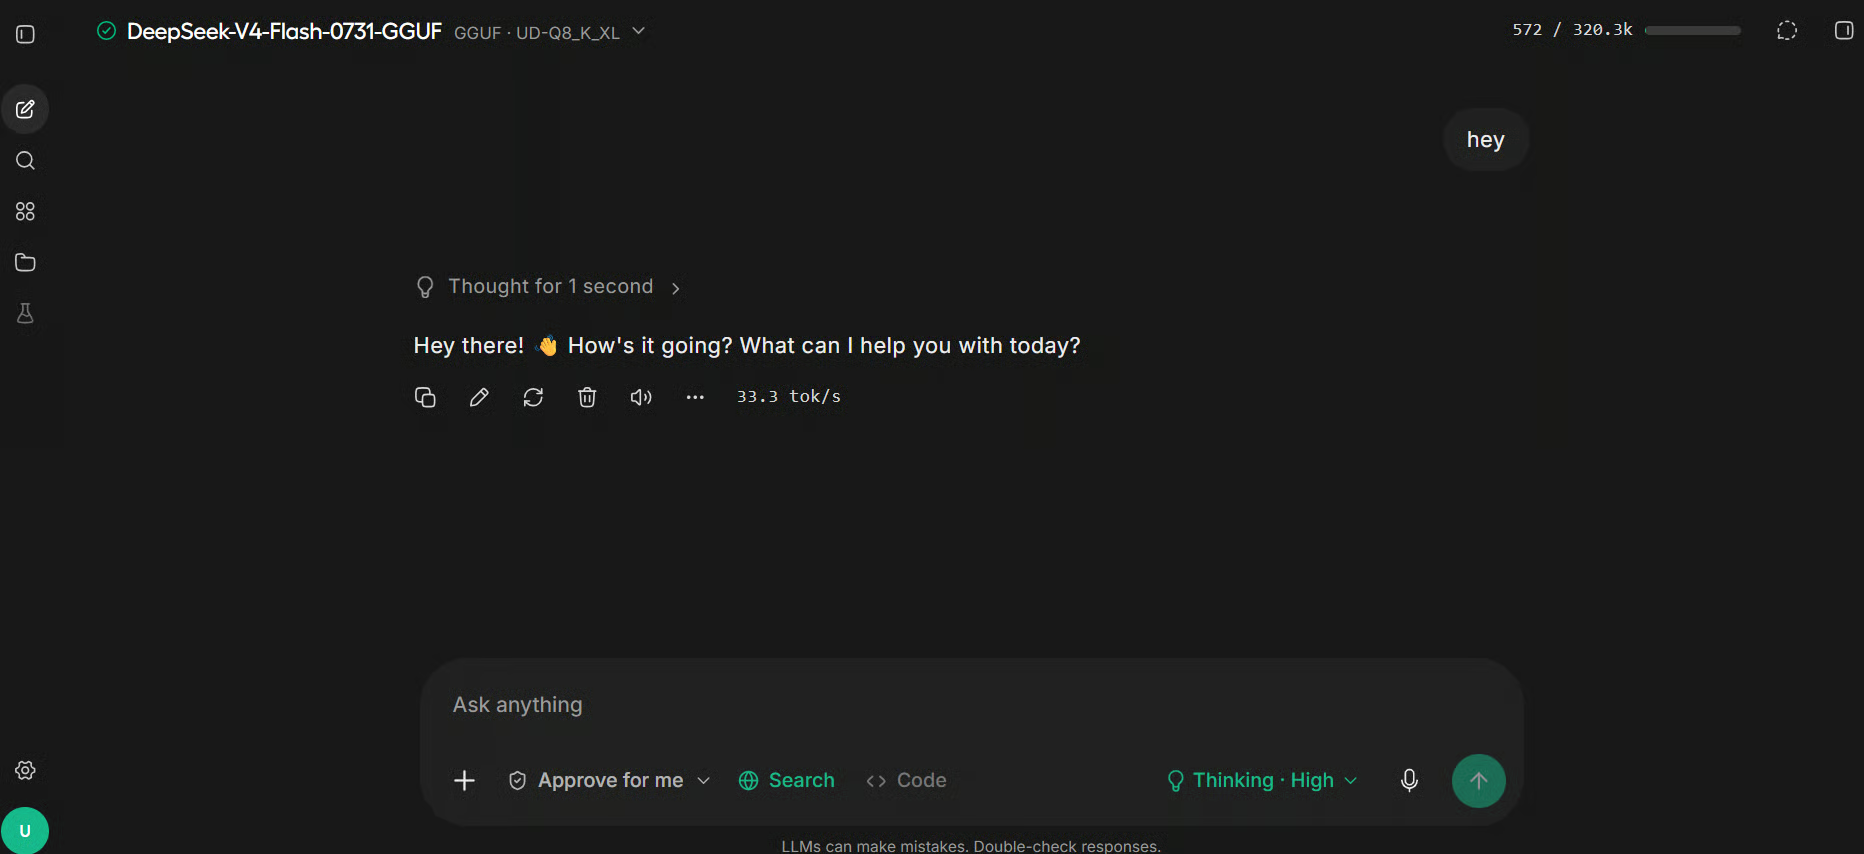
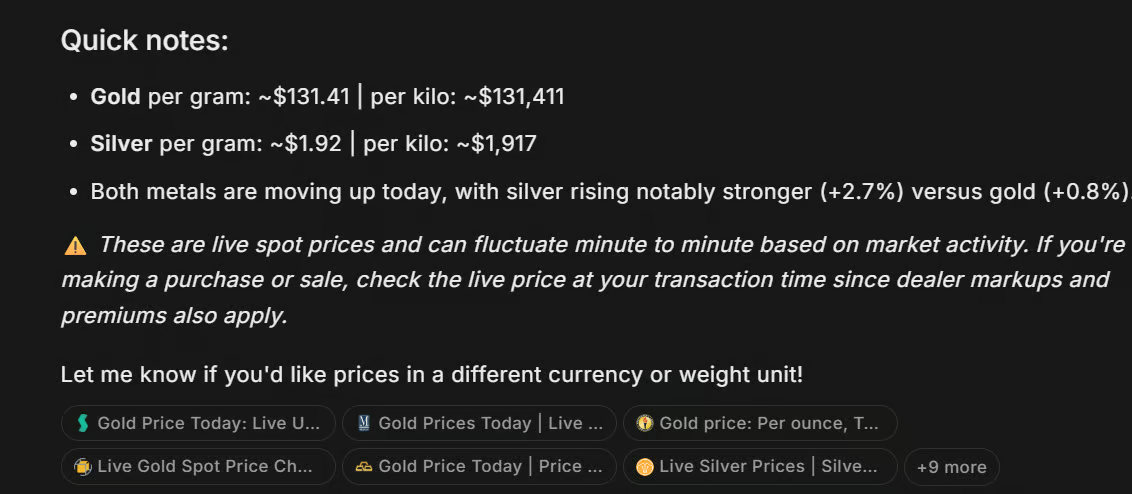
您也可以启用 Studio 的网页搜索工具,让模型查询最新信息,如黄金和白银的最新价格。这有助于确认模型能调用外部工具,而不仅依赖其内部知识。
在终端 2 中,查看模型在多 GPU 上的分布情况:
nvidia-smi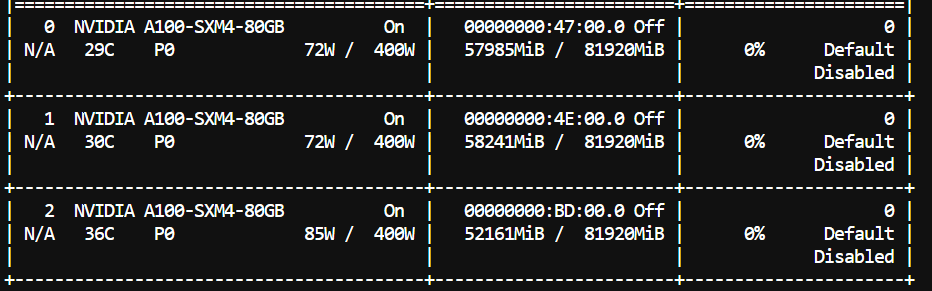
您应能看到三张 GPU 的显存占用都很高。
在我们的测试中,每张 GPU 均约 70% 占用。但这并不必然意味着完整 Q8 模型可以在两张 80GB GPU 上从容放下,因为还需要额外 VRAM 用于上下文窗口、KV 缓存和推理缓冲。
最后,使用我们即将构建的应用的规划提示测试模型:
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
模型会返回涵盖应用架构、组件、数据流、图表库、金融计算与界面设计的结构化开发计划。
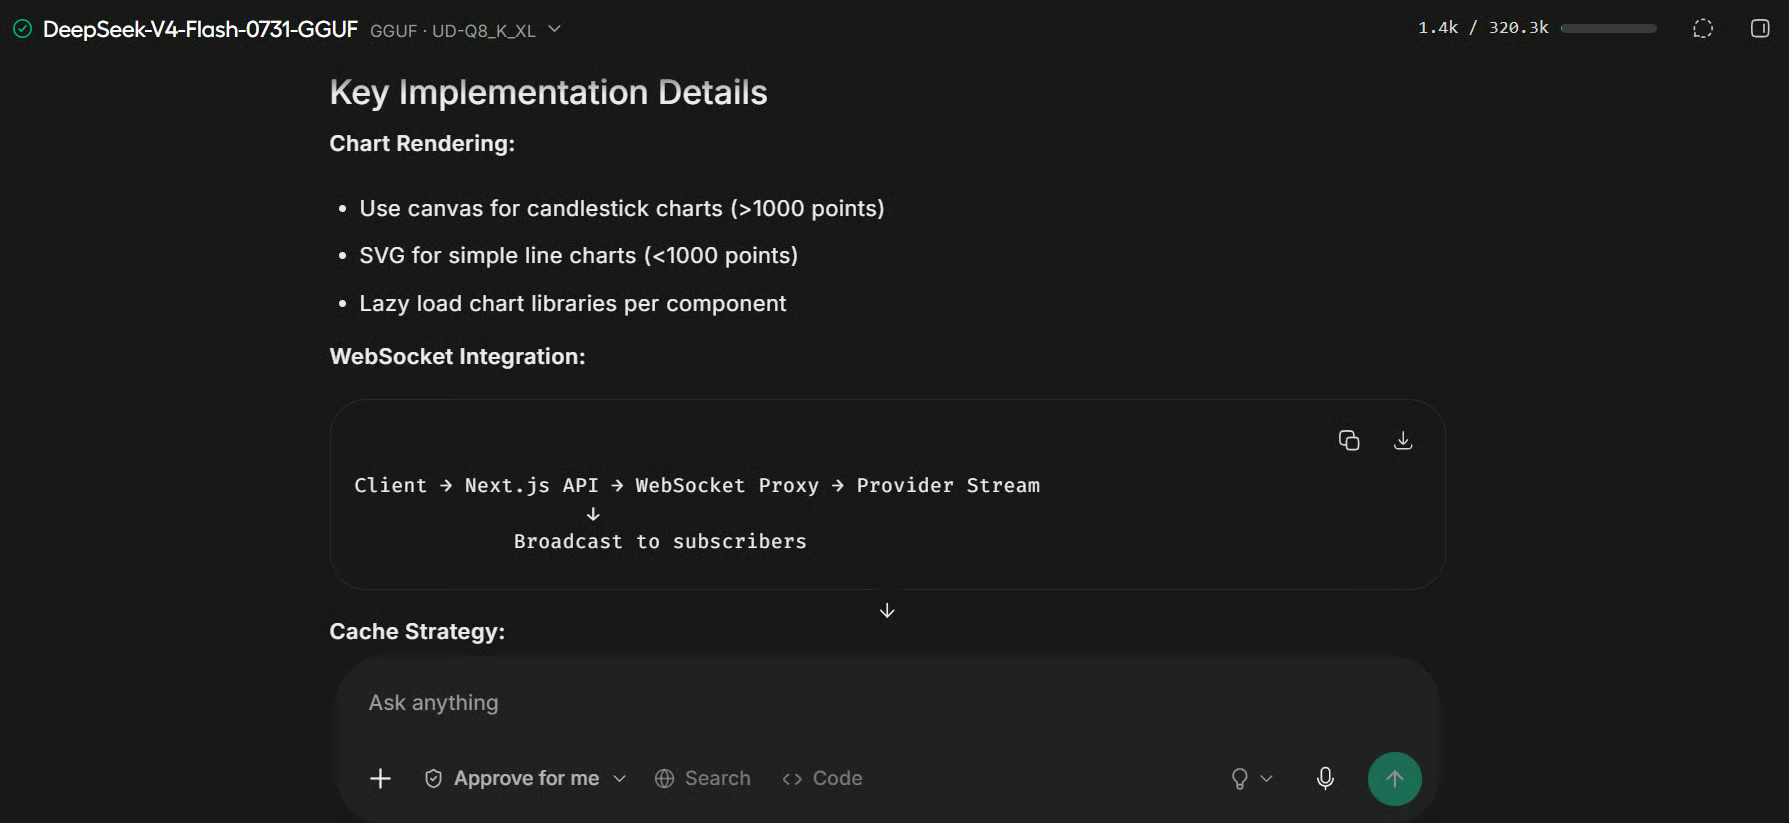
现在模型已在 Unsloth Studio 中运行,我们可以将其连接至 OpenCode,将其作为本地编码智能体使用。
在终端 3 中,设置 Studio URL:
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
创建新项目目录:
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
通过 Unsloth Studio 启动 OpenCode:
unsloth start opencode首次运行该命令会请求安装 OpenCode 的权限。输入“y”。
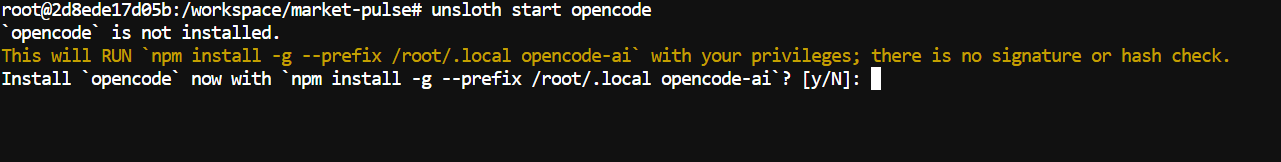
安装完成后,OpenCode 将与本地运行的 DeepSeek-V4-Flash-0731 模型自动完成配置并启动。
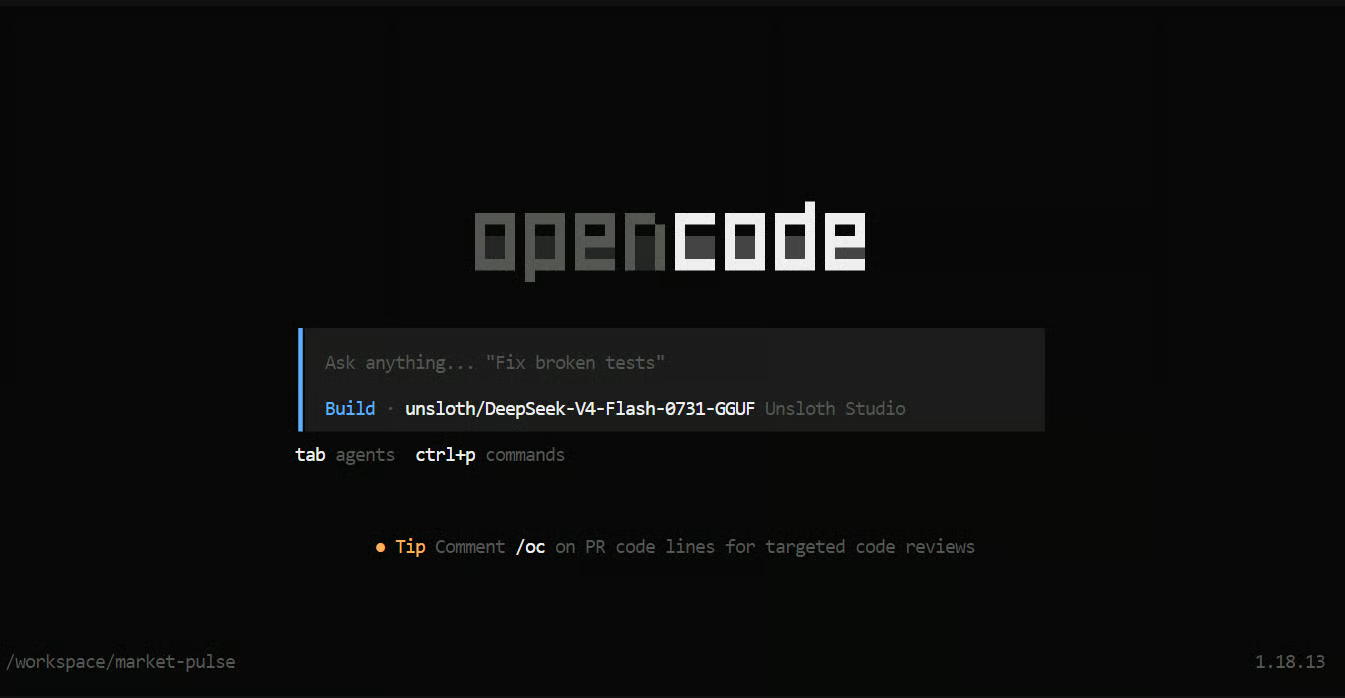
将以下两行提示粘贴到 OpenCode:
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
几秒内,编码智能体应会创建详细任务清单,并按步骤推进项目。
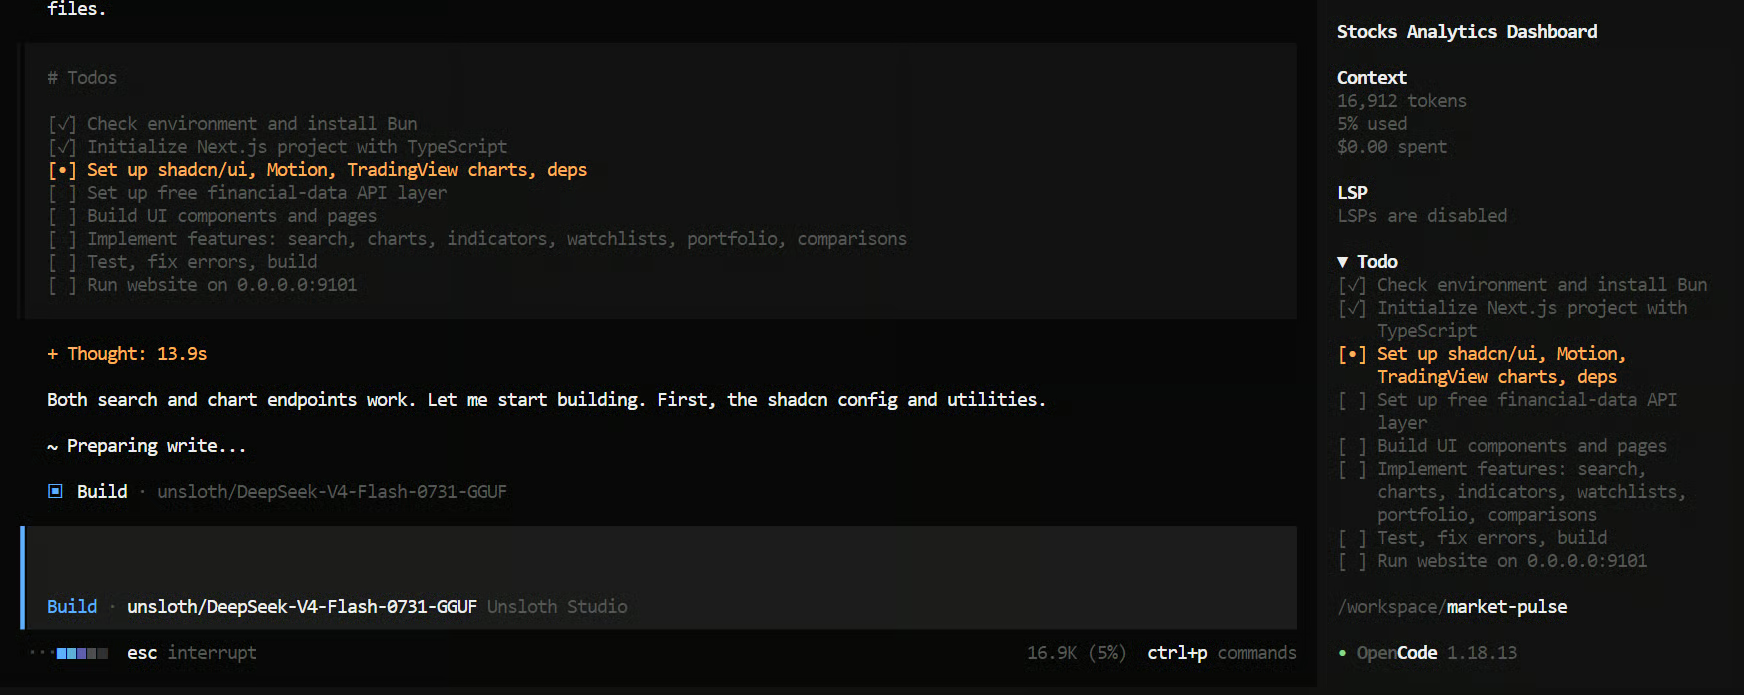
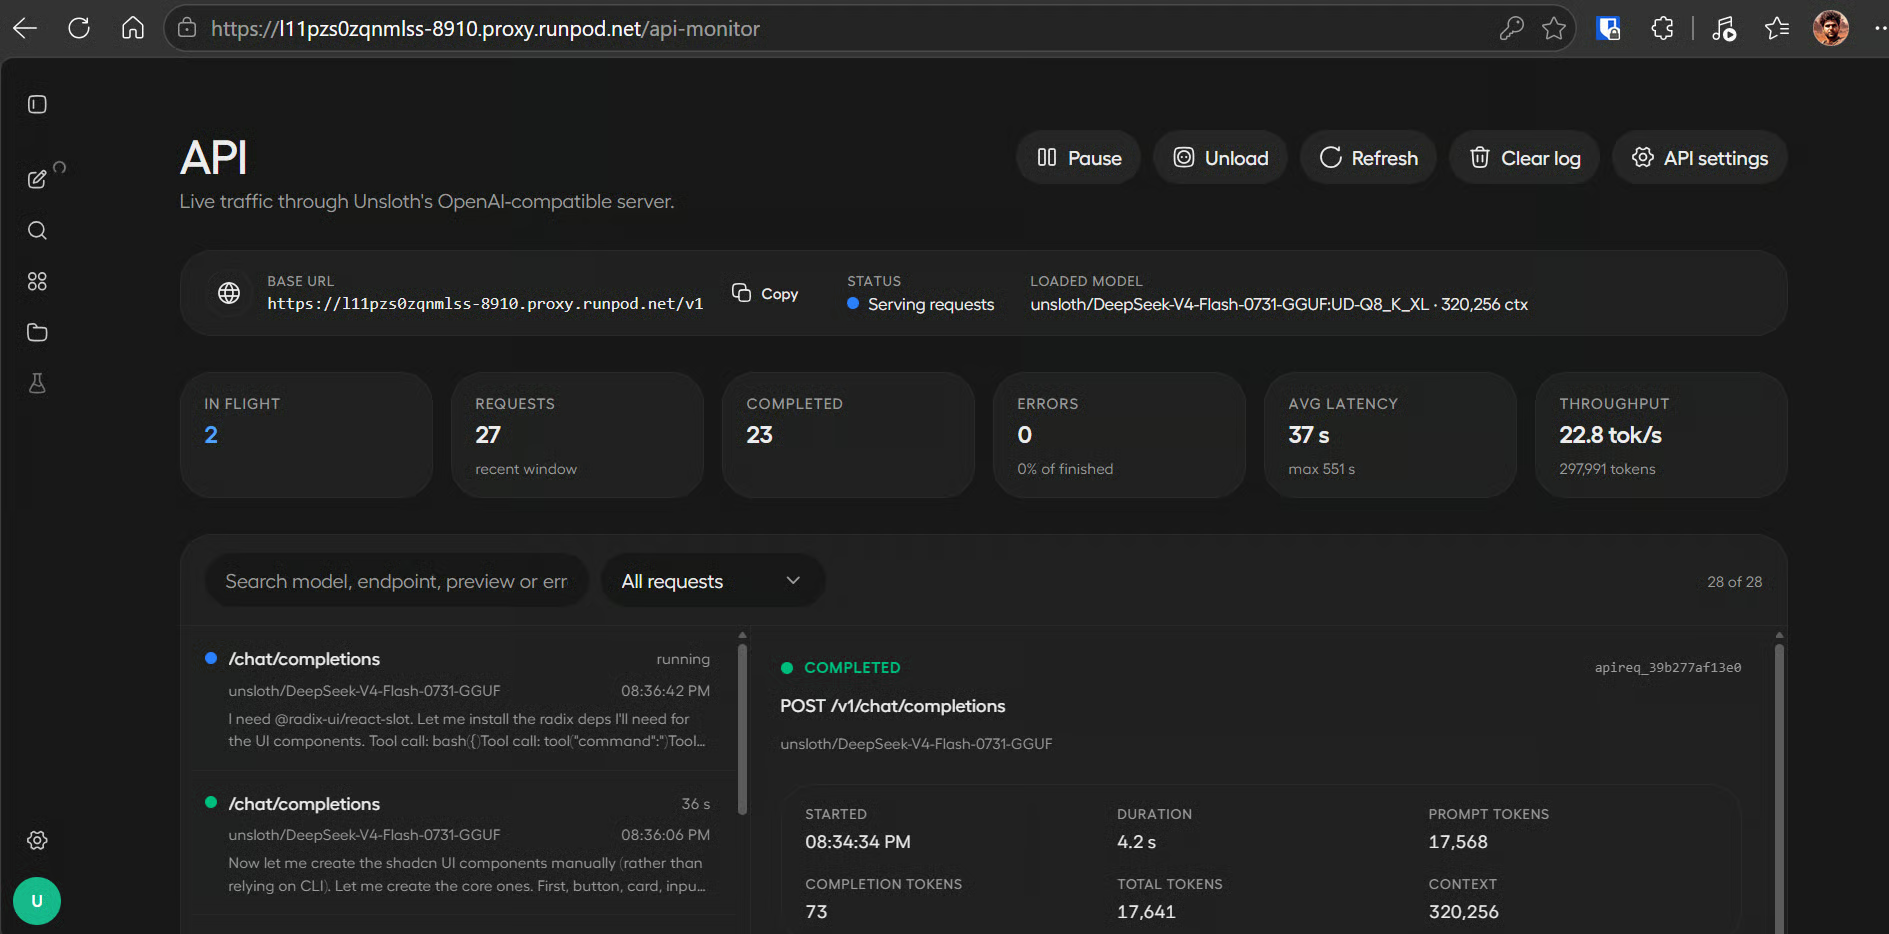
在我们的测试中,完整构建约耗时 20 分钟。期间,您可返回 Unsloth Studio,在“Settings” 中打开 API 监控页面,跟踪模型使用情况和生成速度。
在编码工作流中,我们观察到平均约每秒 22.6 token 的速度。随着对话与项目上下文增大,速度可能有所下降。
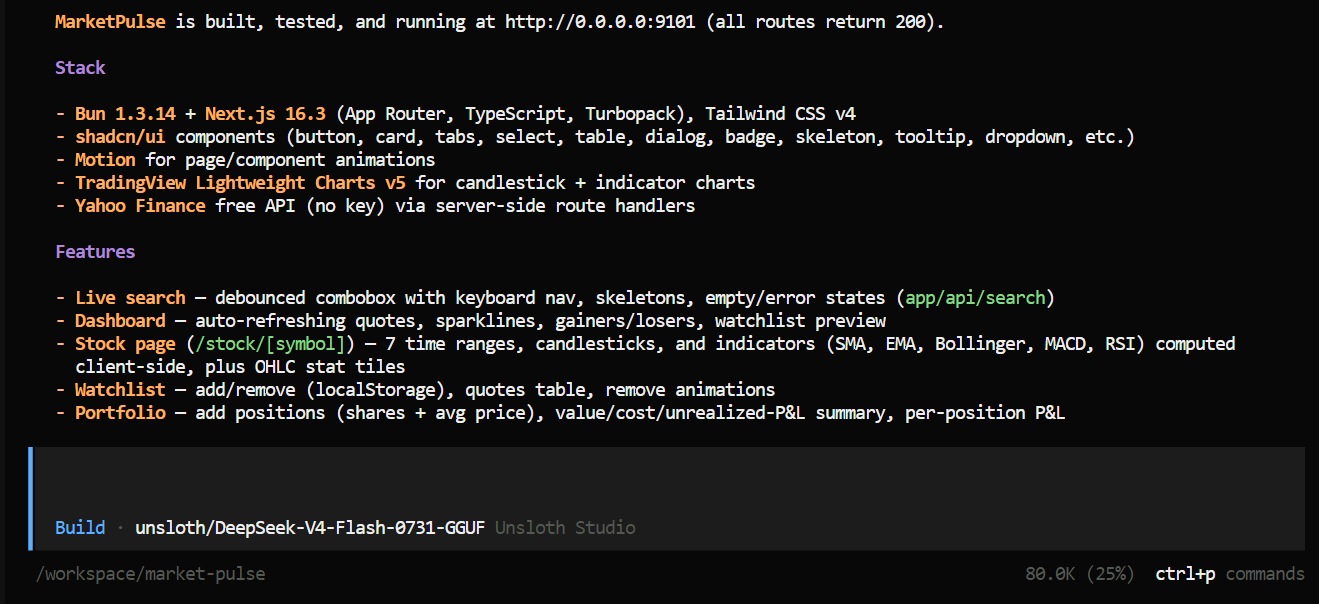
任务完成后,OpenCode 将提供其创建的文件、功能与命令的摘要,并在端口 9101 上启动最终网站。
返回 RunPod 的“Connect” 页面,打开端口 9101 的 HTTP Service。
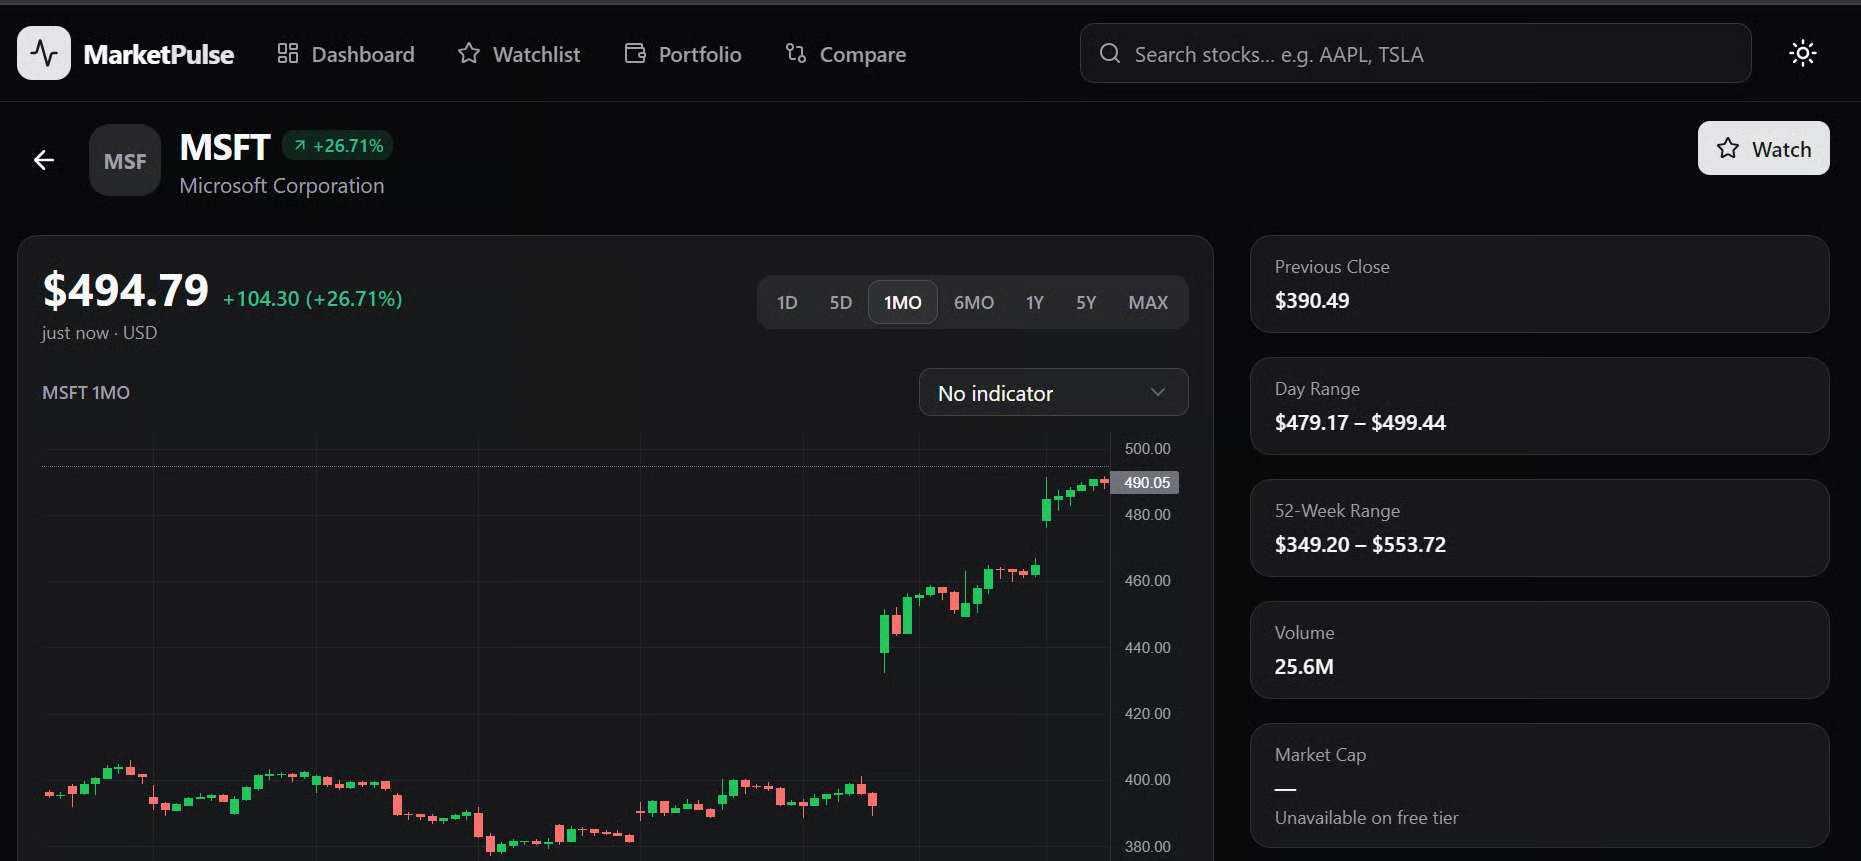
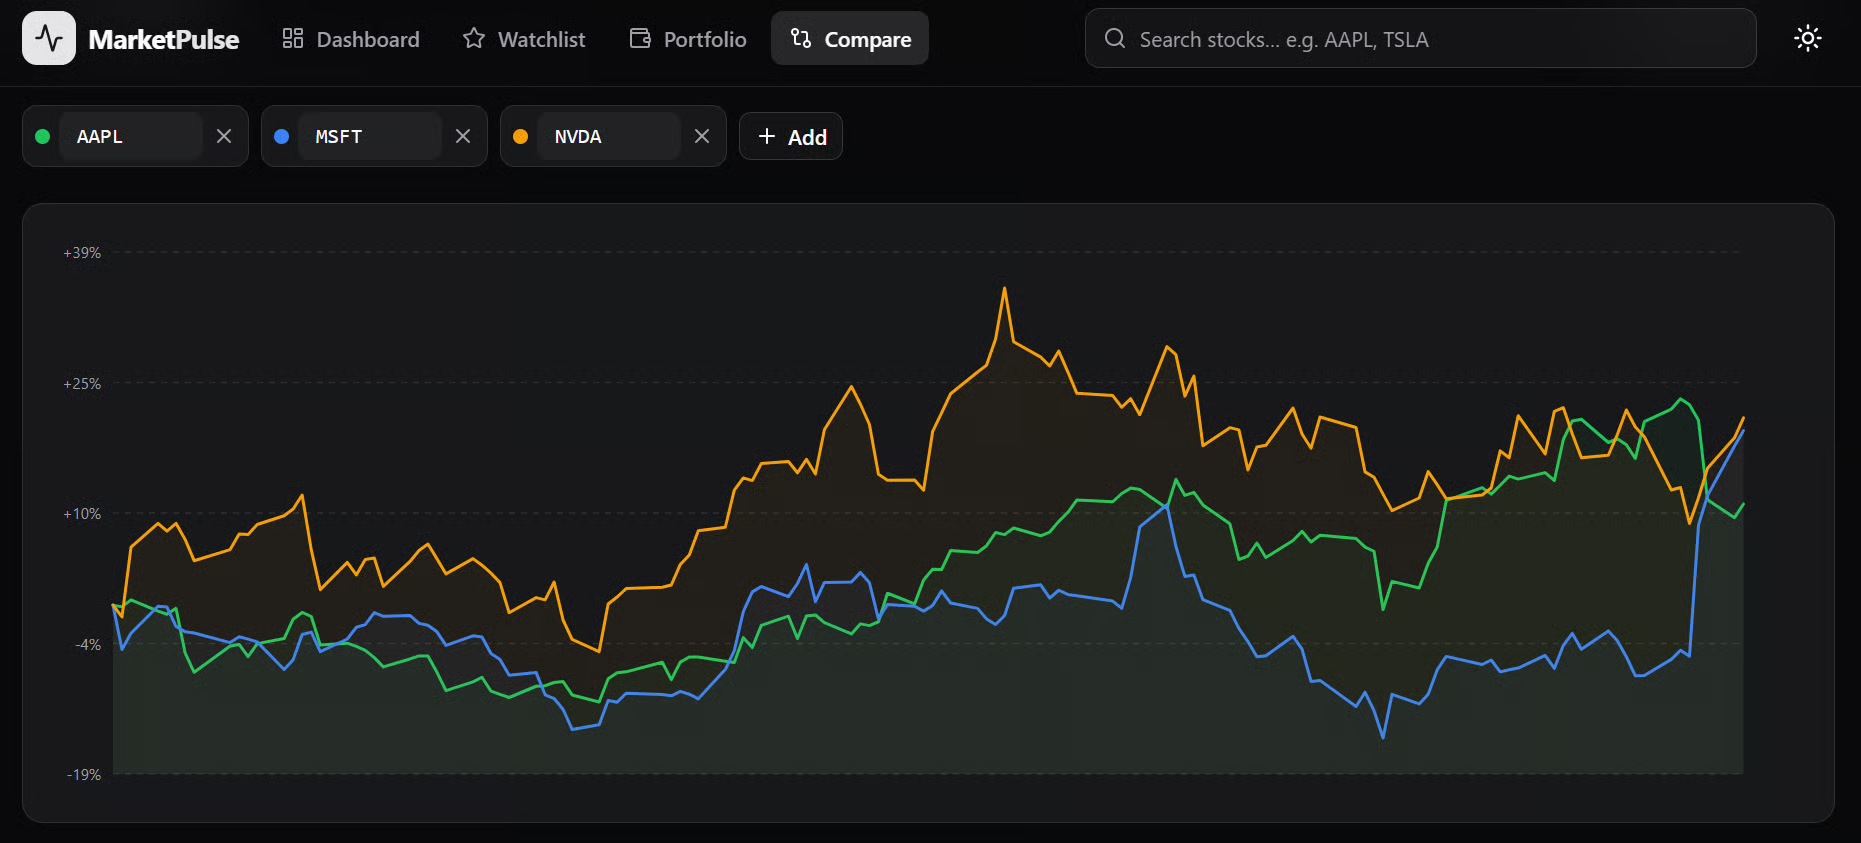
成品效果出乎意料地精致。网站观感干净、动画顺滑,风格接近专业交易看板。模型以单条提示完成了整个 Web 应用,包括界面、数据视图、图表与导航。
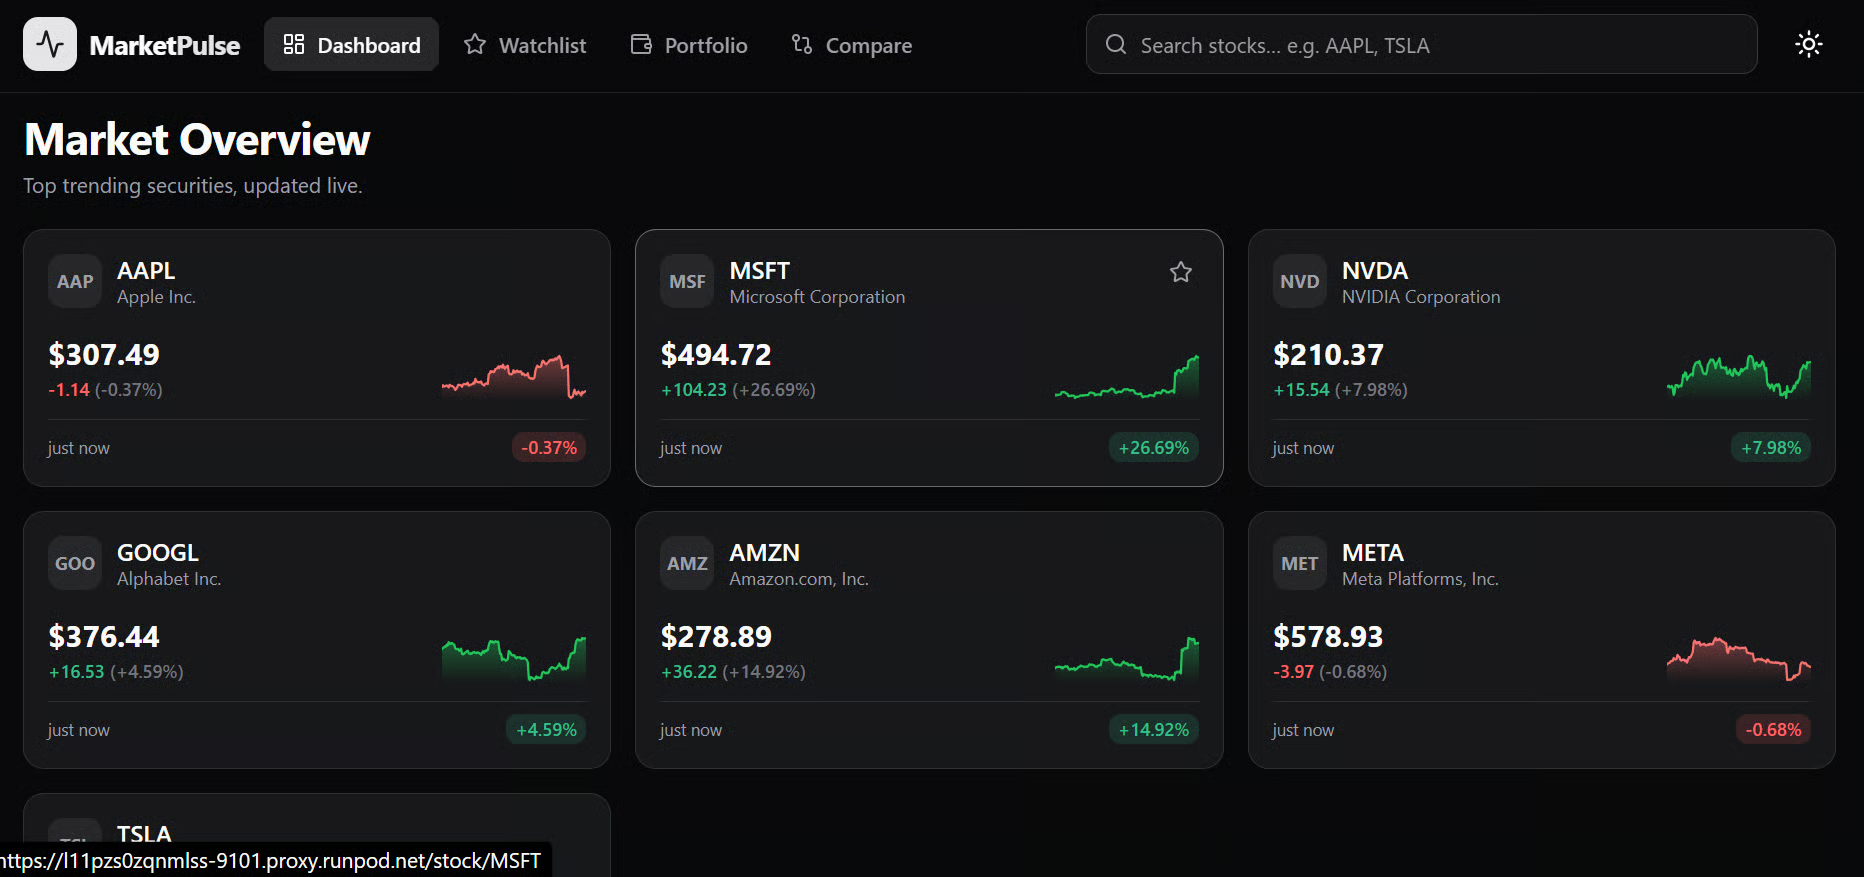
您可以选择单只股票查看 K 线图、历史表现、技术指标以及更多公司信息。
此外,“Compare” 标签可对多只股票进行对比,查看在所选区间内谁的表现更好。
我确实惊讶于一个更小的本地模型竟能凭借单条提示构建完整网站。
在测试该应用后,所有主要功能均按预期工作,包括实时报价、历史市场数据、图表、指标与对比工具。
本地模型的进步之快令人惊叹,它们在完成复杂的端到端开发任务方面已相当能干。
对我而言,DeepSeek-V4-Flash-0731 是目前我测试过的最佳本地模型。
它的表现优于 Inkling、2-bit 的 GLM-5.2 量化版,以及我此前最喜欢的 Qwen3.6-27B。虽然这是基于个人体验而非正式基准,但它已经成为我偏好的本地模型。
在多数实际工作负载中,我仍会优先使用官方 DeepSeek API,因为其价格极具吸引力。
V4 Flash 目前的价格为每百万未缓存输入 token 0.14 美元、每百万缓存输入 token 0.0028 美元、每百万输出 token 0.28 美元。按此费率,十亿缓存输入 token 的费用约为 2.80 美元(不含输出费用)。
在确定使用 Unsloth Studio 之前,我也尝试过通过 llama.cpp 运行模型。预编译安装包未能提供适合我环境的最新 CUDA 二进制;即便我从源码编译了最新版,在启用 DSpark 试探式解码时仍遭遇问题。
最终,Unsloth Studio 提供了最简便的配置,省去了大部分手动设置。它与 OpenCode 配合良好,但完整构建应用大约耗时 20 分钟。
热门 DataCamp 课程
Courses
Courses
Tracks