Kurs
KI-gestütztes Programmieren für Entwickler
1 Std. 30 Min.
9.9K
Kleiner und schneller bedeutet längst nicht mehr automatisch weniger fähig. Laut den veröffentlichten Auswertungen von DeepSeek nutzt DeepSeek-V4-Flash-0731 deutlich weniger aktivierte Parameter als DeepSeek-V4-Pro und liefert dennoch nahezu Spitzenleistung bei agentischen Aufgaben: Es erreicht 82,7 auf dem Terminal Bench 2.1, im Vergleich zu 81,0 bei GLM-5.2 und 85,0 bei Opus 4.8. Beim Agents’ Last Exam liegt es mit 25,2 nah an den 25,7 von Opus 4.8.
Da die Gewichte offen verfügbar sind, kannst du das Modell theoretisch auf eigener Hardware ausführen, sofern genügend kombinierter RAM bzw. VRAM vorhanden ist – Inferenz und Projektdaten bleiben damit unter deiner Kontrolle.
In dieser Anleitung konfigurieren wir eine RunPod-Umgebung mit drei GPUs, installieren und starten Unsloth Studio, laden die Q8-Version von DeepSeek-V4-Flash-0731 verteilt über die GPUs, testen das Modell im Studio, verbinden den lokalen Inferenzserver mit OpenCode und nutzen den Coding-Agenten, um eine interaktive Aktien-Analytics-Website zu erstellen und zu starten.
DeepSeek-V4-Flash-0731 ist das offizielle Release und ersetzt die frühere Vorschauversion – mit deutlichen Verbesserungen beim Coden, der Tool-Nutzung und autonomen Agentenaufgaben. Seine Mixture-of-Experts-Architektur aktiviert pro Token nur Teile des Modells. So bleibt es effizient und liefert trotzdem starke Ergebnisse.
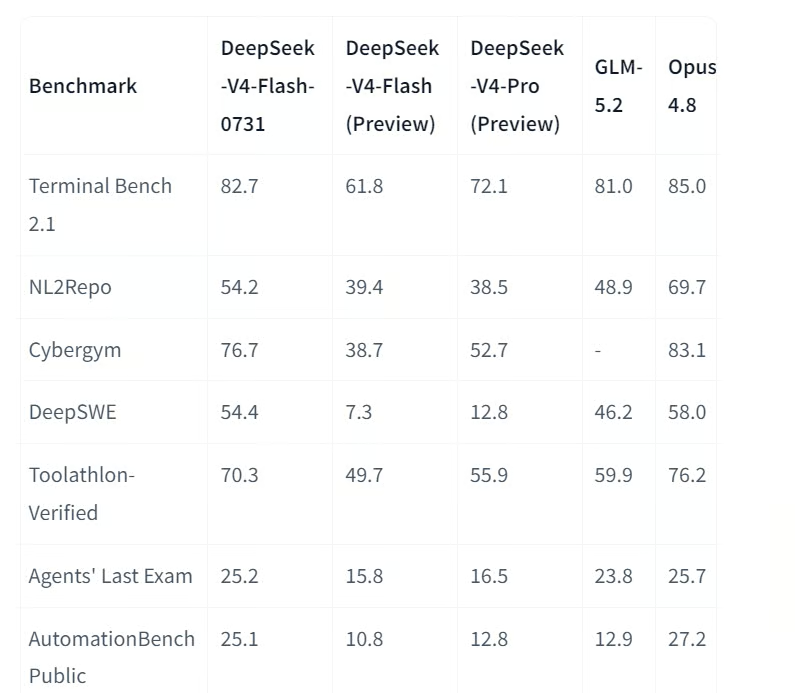
Quelle: deepseek-ai/DeepSeek-V4-Flash-0731 · Hugging Face
DeepSeek berichtet, dass sich das Modell auf dem Terminal Bench 2.1 von 61,8 auf 82,7 und bei DeepSWE von 7,3 auf 54,4 verbessert hat. Zudem übertraf es das größere DeepSeek-V4-Pro Preview in mehreren Agenten-Benchmarks.
Das Modell unterstützt Kontextfenster von bis zu einer Million Tokens. Damit eignet es sich für große Codebasen, lange Dokumente und komplexe Workflows mit viel Kontext. Nutzer können außerdem zwischen niedrigem, hohem und maximalem Reasoning-Aufwand wählen – je nachdem, wie viel Zeit das Modell für die Lösung einer Aufgabe investieren soll.
DeepSeek-V4-Flash-0731 bietet außerdem DSpark speculative decoding. DSpark entwirft mehrere Tokens, bevor das Hauptmodell sie verifiziert – laut DeepSeek kann das die Generationsgeschwindigkeit mit einer kompatiblen Inferenz-Engine um 60% bis 85% steigern.
Wir erstellen zunächst eine RunPod-Umgebung mit genügend GPU-Speicher und Storage, um die Q8-Version von DeepSeek-V4-Flash-0731 auszuführen und sowohl Unsloth Studio als auch die von OpenCode generierte Website zu hosten.
Konfiguriere den Pod mit:
/workspace als Mount-Pfad für das persistente VolumeHF_TOKEN8910 und 9101 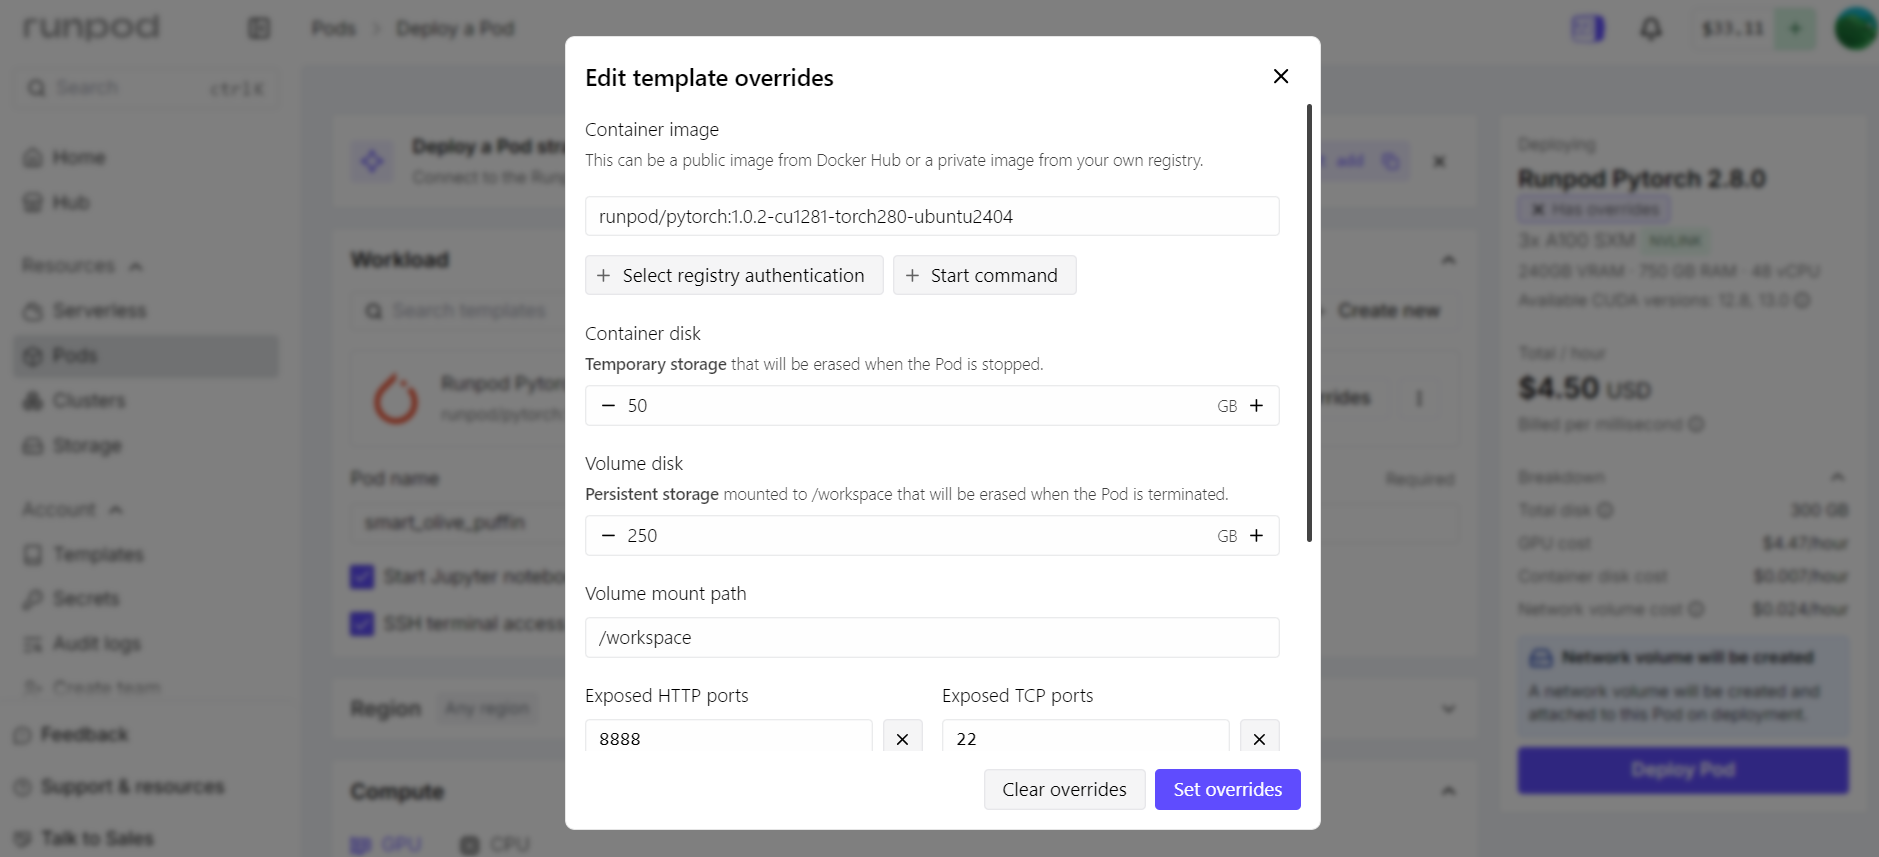
Port 8910 wird für Unsloth Studio und dessen lokale Inferenz-API genutzt. Port 9101 hostet die interaktive Website, die OpenCode erstellt.
RunPod stellt diese Dienste über seinen HTTP-Proxy bereit. Beide Anwendungen müssen daher auf 0.0.0.0 lauschen und nicht nur auf 127.0.0.1.
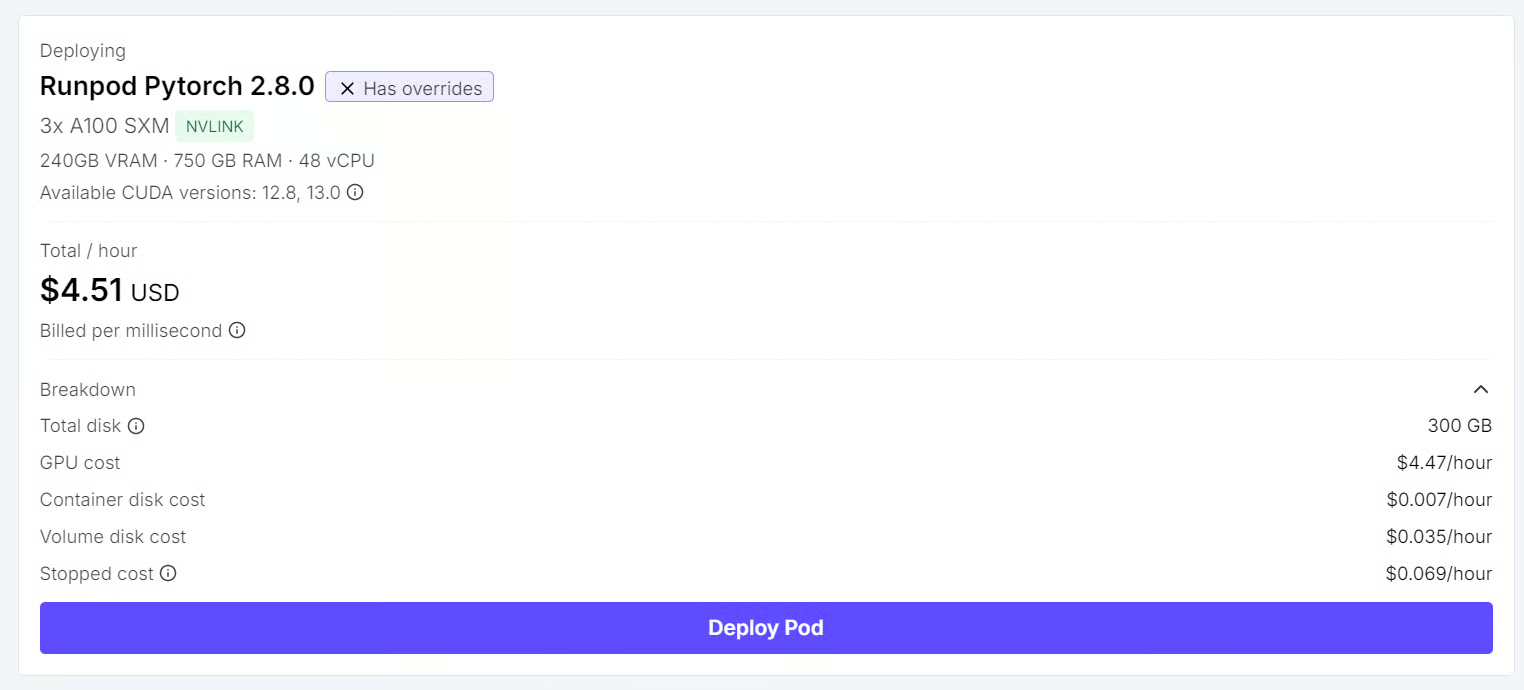
Nach dem Deployment des Pods öffne den Tab Connect, starte JupyterLab und erstelle drei Terminal-Sessions:
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
Die Aufgaben in separaten Terminals zu halten, erleichtert das GPU-Monitoring, die Fehlersuche am Modell und das parallele Ausführen des Coding-Agenten.
Als Nächstes installieren wir Unsloth Studio, richten einen persistenten Hugging-Face-Cache ein und starten das Interface auf Port 8910.
Bestätige in Terminal 1, dass alle drei GPUs verfügbar sind:
nvidia-smiDu solltest alle drei A100-GPUs auf dem Linux-Server sehen.
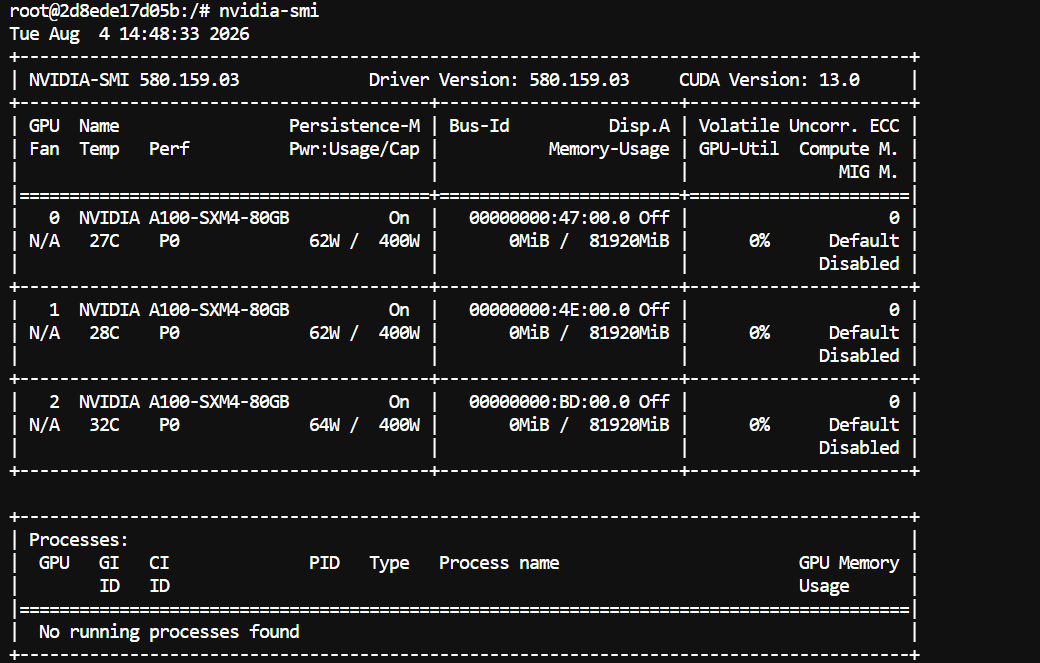
Erstelle einen persistenten Hugging-Face-Cache in /workspace, damit heruntergeladene Modelle auf dem RunPod-Volume erhalten bleiben:
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
Installiere anschließend die benötigten Systempakete und Unsloth Studio:
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh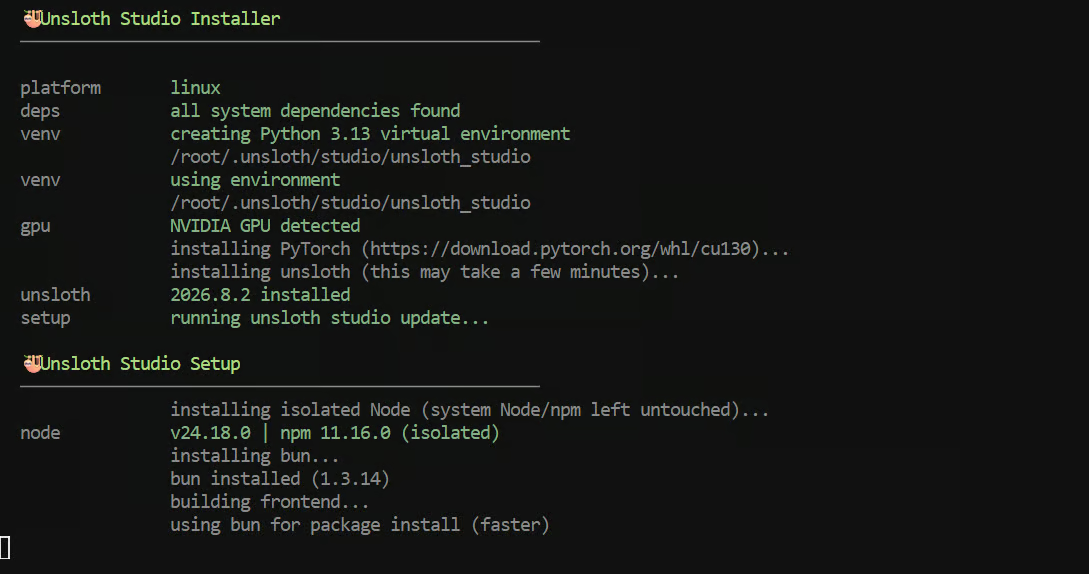
Der Installer richtet das Studio-Interface, die Python-Umgebung, Abhängigkeiten und lokale Inferenzkomponenten ein.
Die erste Installation kann mehrere Minuten dauern.
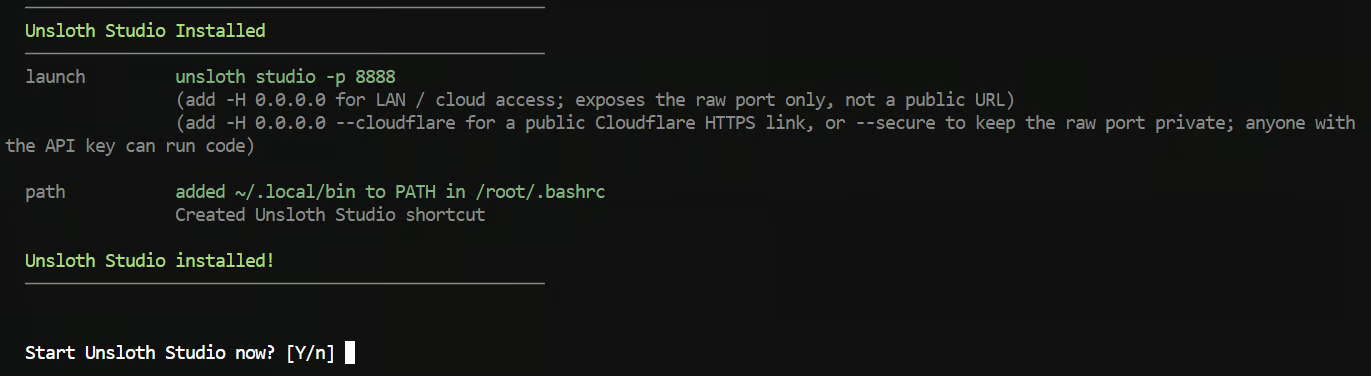
Wenn der Installer fragt, ob du Unsloth Studio sofort starten möchtest, gib „n“ ein.
Wir starten es manuell, damit Port 8910 genutzt wird und die richtige Netzwerkadresse eingestellt ist.
Starte die Shell neu, damit die neuen Befehle verfügbar sind:
exec bash
cd /workspace
Setze vor dem Start des Studios das Standardpasswort zurück:
unsloth studio reset-passwordKopiere das temporäre Passwort aus der Einrichtung, da du es für den Reset benötigen könntest.
Starte nun Unsloth Studio:
unsloth studio \
  -H 0.0.0.0 \
  -p 8910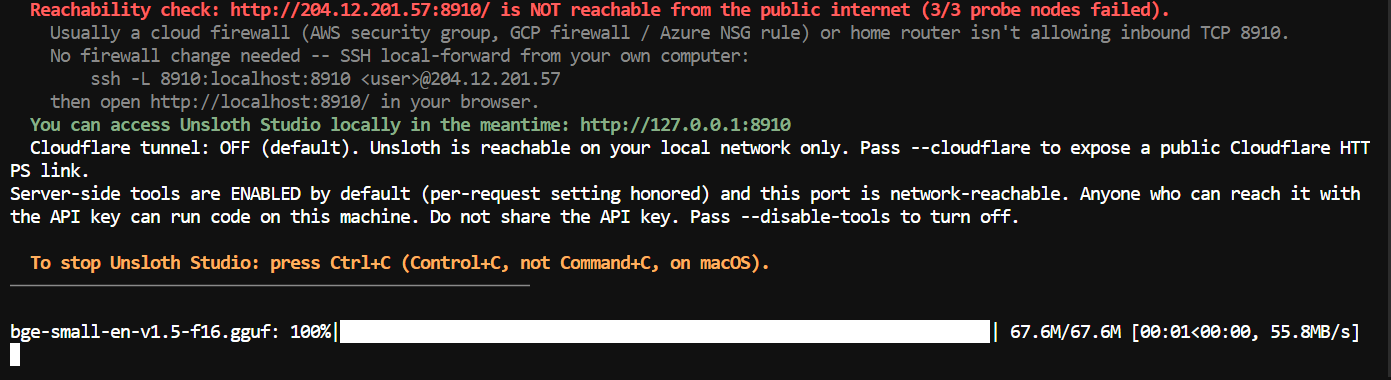
Das Studio sollte nun melden, dass es auf Port 8910 läuft. Lass Terminal 1 geöffnet, während du mit Unsloth Studio und OpenCode arbeitest.
Wechsle zurück zur RunPod-Seite Connect und öffne den HTTP-Service für Port 8910.
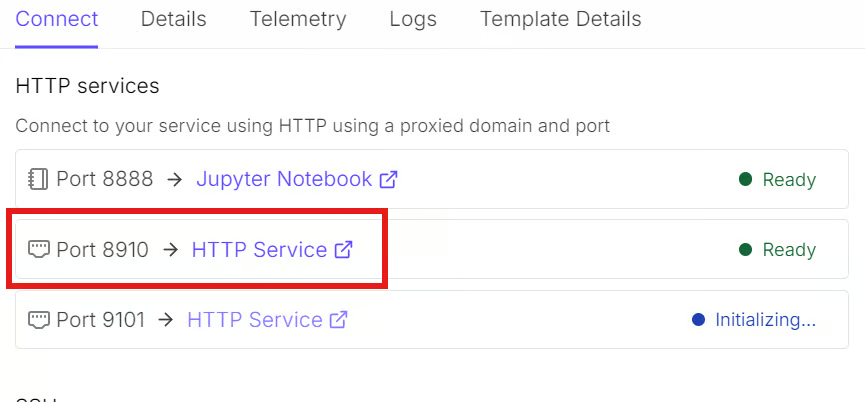
Nutze das zuvor generierte temporäre Passwort, um den Reset abzuschließen, und melde dich anschließend mit deinem neuen Passwort an.
Schließe die Onboarding-Schritte ab oder überspringe sie und öffne die Chat-Seite.
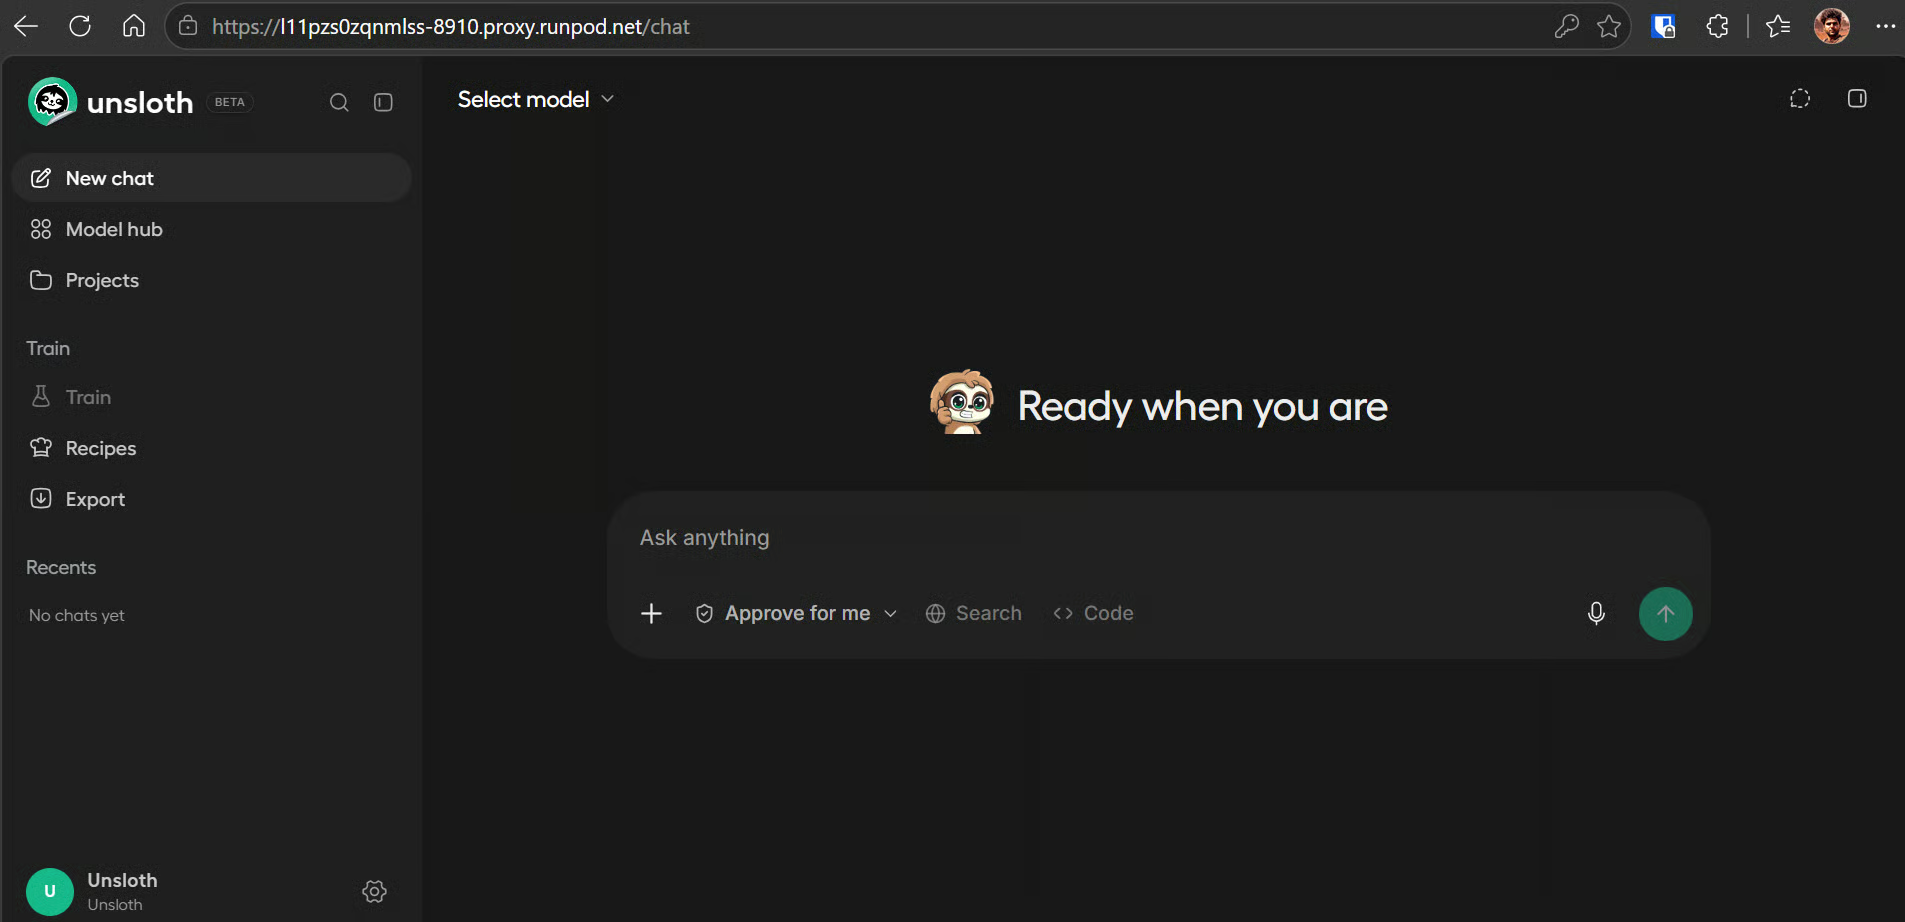
Jetzt, da Unsloth Studio läuft, können wir das Q8-Modell herunterladen, über die drei GPUs laden und Chat- sowie Tool-Nutzung testen.
Öffne den Modellwähler oben links, suche nach unsloth/DeepSeek-V4-Flash-0731-GGUF und wähle die Q8-Quantisierung UD-Q8_K_XL.
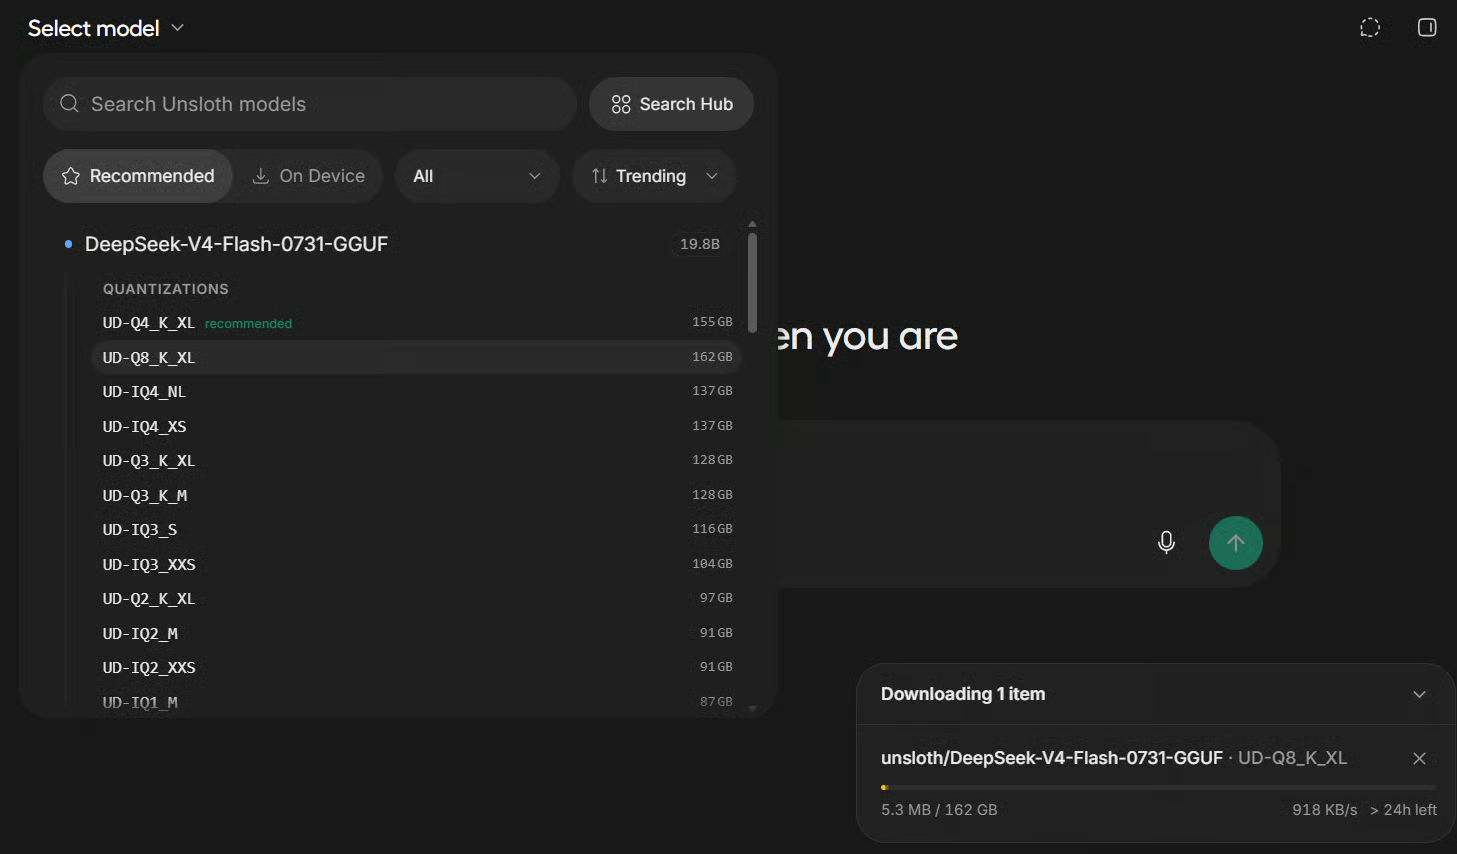
Wir verwenden Q8, weil die drei A100-GPUs zusammen genug VRAM bereitstellen. Die Qualität bleibt damit näher am Originalmodell; niedrigere Quantisierungen sind sinnvoller, wenn der Speicherausbau begrenzt ist.
Nach dem Download beginnt Unsloth Studio automatisch, das Modell in den GPU-Speicher zu laden. Das kann mehrere Minuten dauern, da das Q8-Modell sehr groß ist.
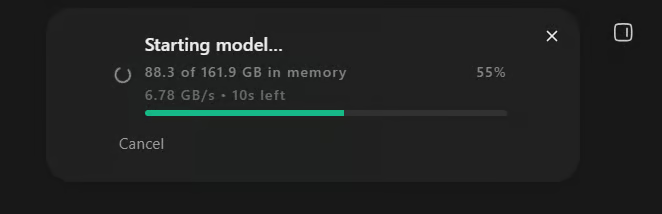
Nutze nach dem Laden die Seite Chat, um das Modell mit ein paar einfachen Prompts zu testen.
In unseren Tests erreichte die Generierung etwa 33 Tokens pro Sekunde ohne speculative decoding – ein guter Wert für ein Modell dieser Größe.
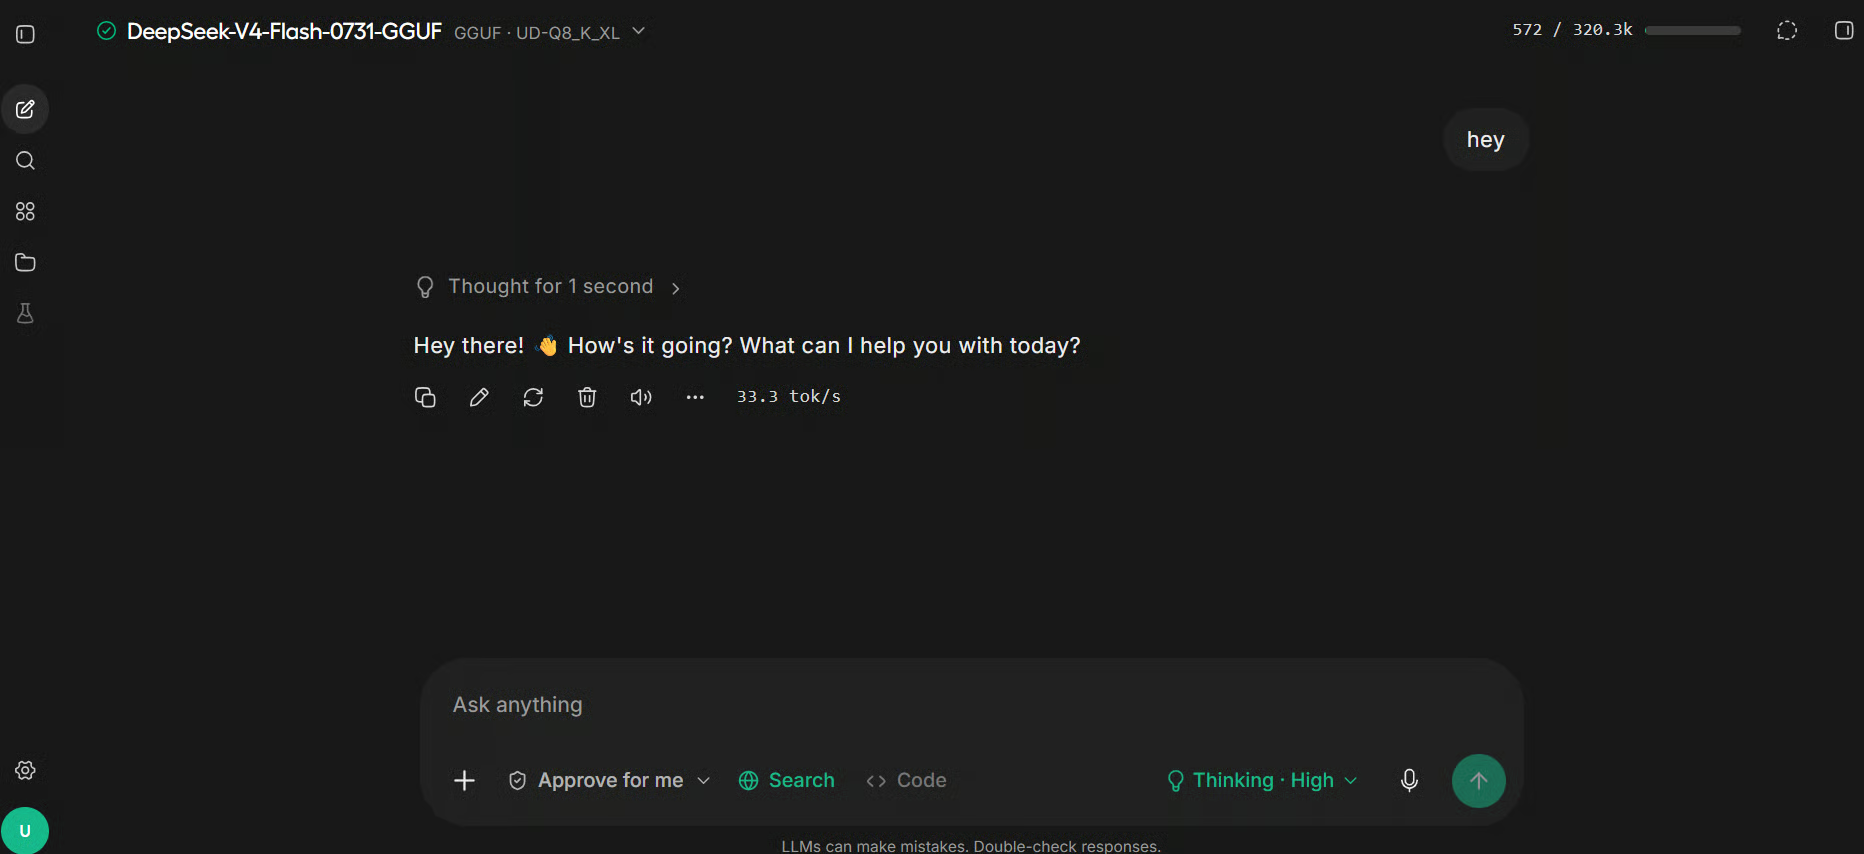
Du kannst außerdem das Websuche-Tool im Studio aktivieren und das Modell nach aktuellen Informationen suchen lassen, zum Beispiel nach den jüngsten Gold- und Silberpreisen. So prüfst du, ob das Modell externe Tools aufrufen kann und nicht nur auf internes Wissen angewiesen ist.
Prüfe in Terminal 2, wie das Modell auf die GPUs verteilt ist:
nvidia-smi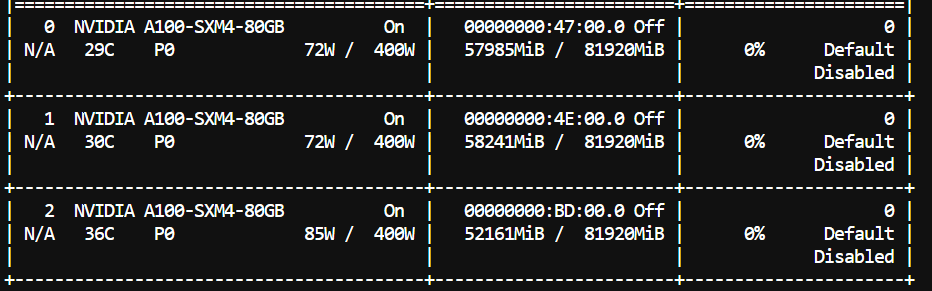
Du solltest auf allen drei GPUs eine hohe Speicherauslastung sehen.
In unserem Test waren rund 70% jeder GPU belegt. Das heißt jedoch nicht, dass das gesamte Q8-Modell bequem auf nur zwei 80GB-GPUs passt, da zusätzlicher VRAM für Kontextfenster, KV-Cache und Inferenzpuffer benötigt wird.
Teste das Modell abschließend mit dem Planungs-Prompt für die Anwendung, die wir bauen werden:
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
Das Modell liefert einen strukturierten Entwicklungsplan zur Architektur, den Komponenten, Datenflüssen, Charting-Bibliotheken, finanziellen Berechnungen und zum Interface-Design.
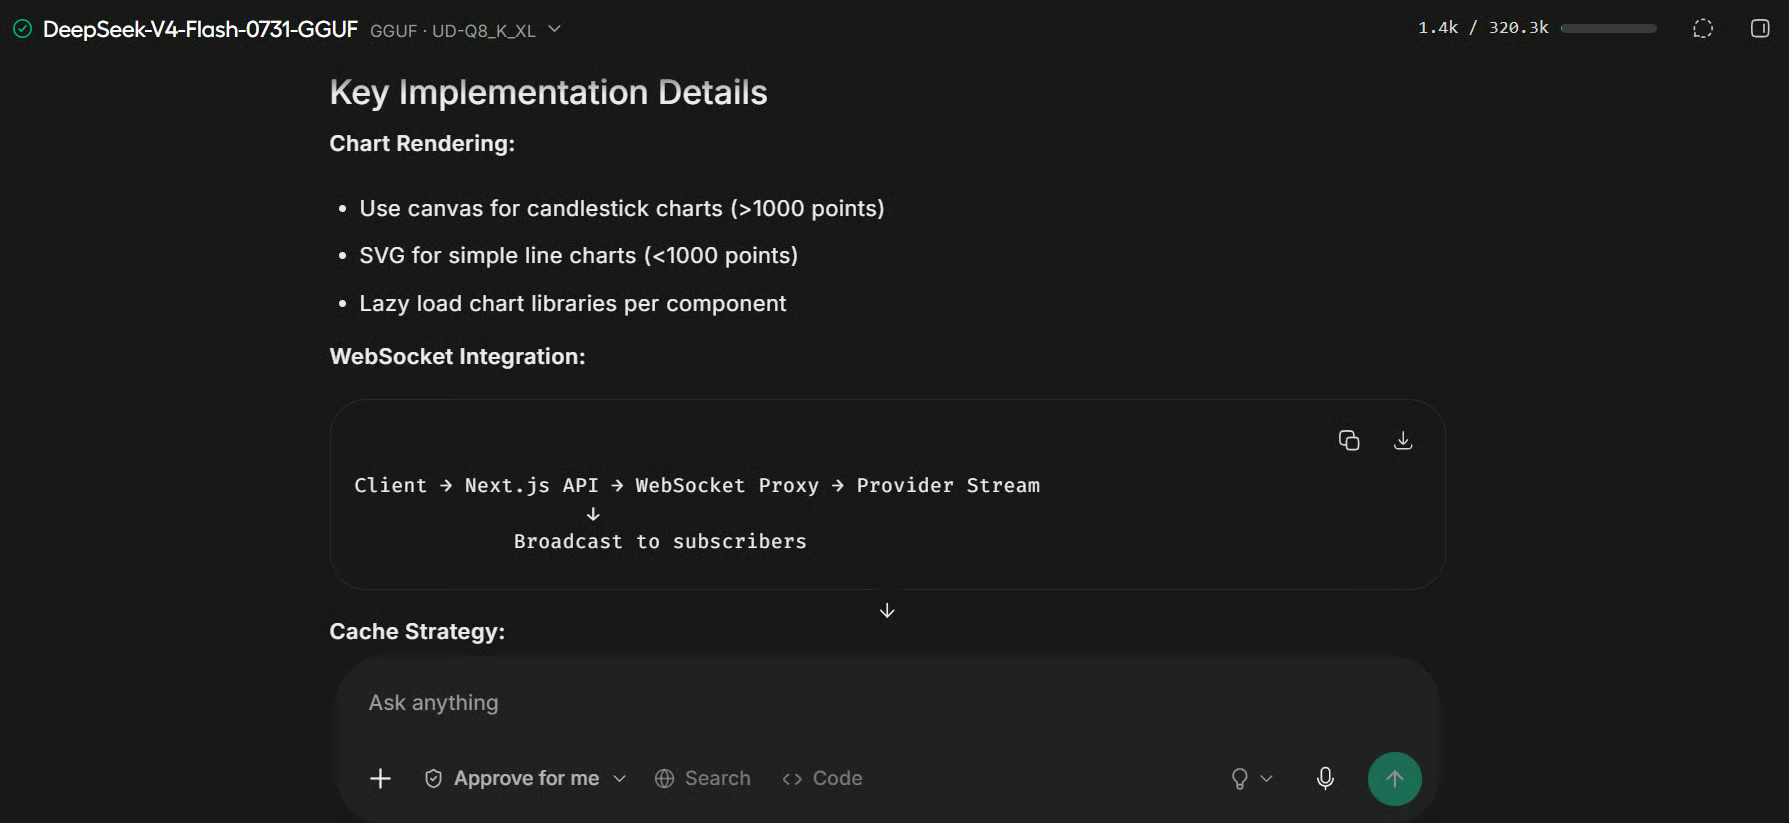
Da das Modell nun in Unsloth Studio läuft, können wir es mit OpenCode verbinden und als lokalen Coding-Agenten nutzen.
Setze in Terminal 3 die Studio-URL:
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
Erstelle ein neues Projektverzeichnis:
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
Starte OpenCode über Unsloth Studio:
unsloth start opencodeBeim ersten Aufruf fragt der Befehl nach Erlaubnis, OpenCode zu installieren. Bestätige mit „y“.
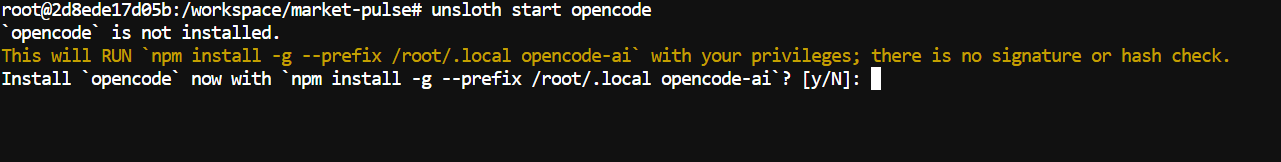
Nach Abschluss der Installation startet OpenCode mit dem lokal laufenden DeepSeek-V4-Flash-0731-Modell bereits vorkonfiguriert.
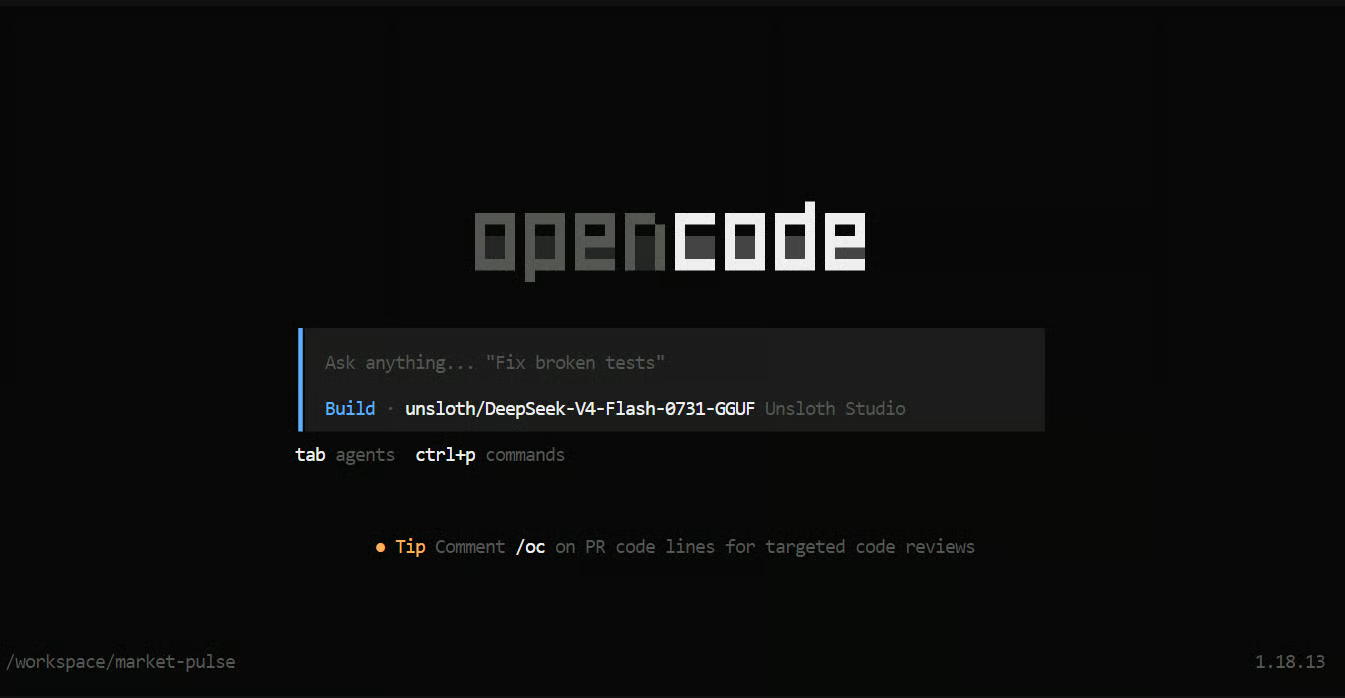
Füge den folgenden zweiteiligen Prompt in OpenCode ein:
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
Nach wenigen Sekunden sollte der Coding-Agent eine detaillierte Aufgabenliste erstellen und sich Schritt für Schritt durch das Projekt arbeiten.
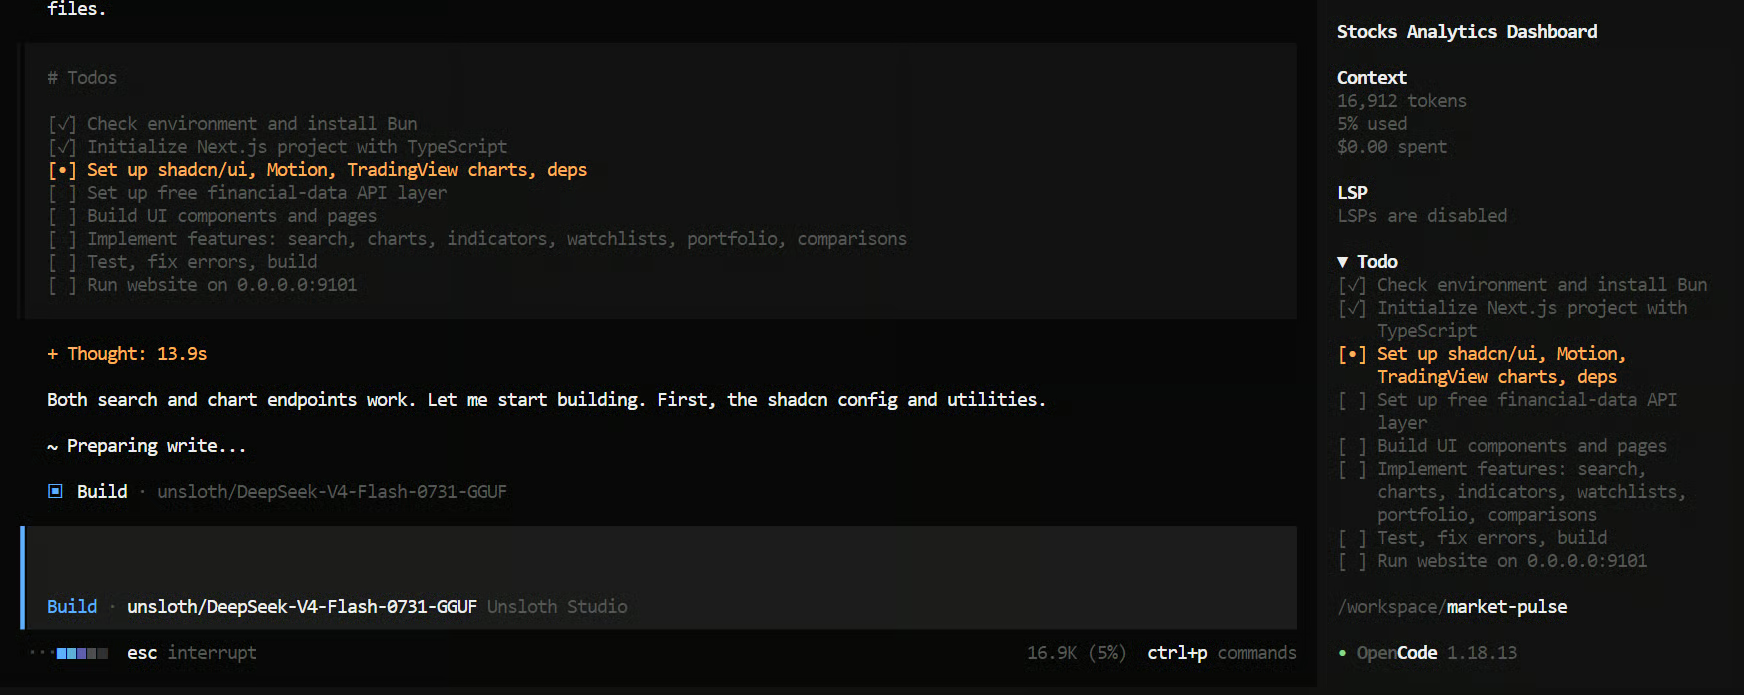
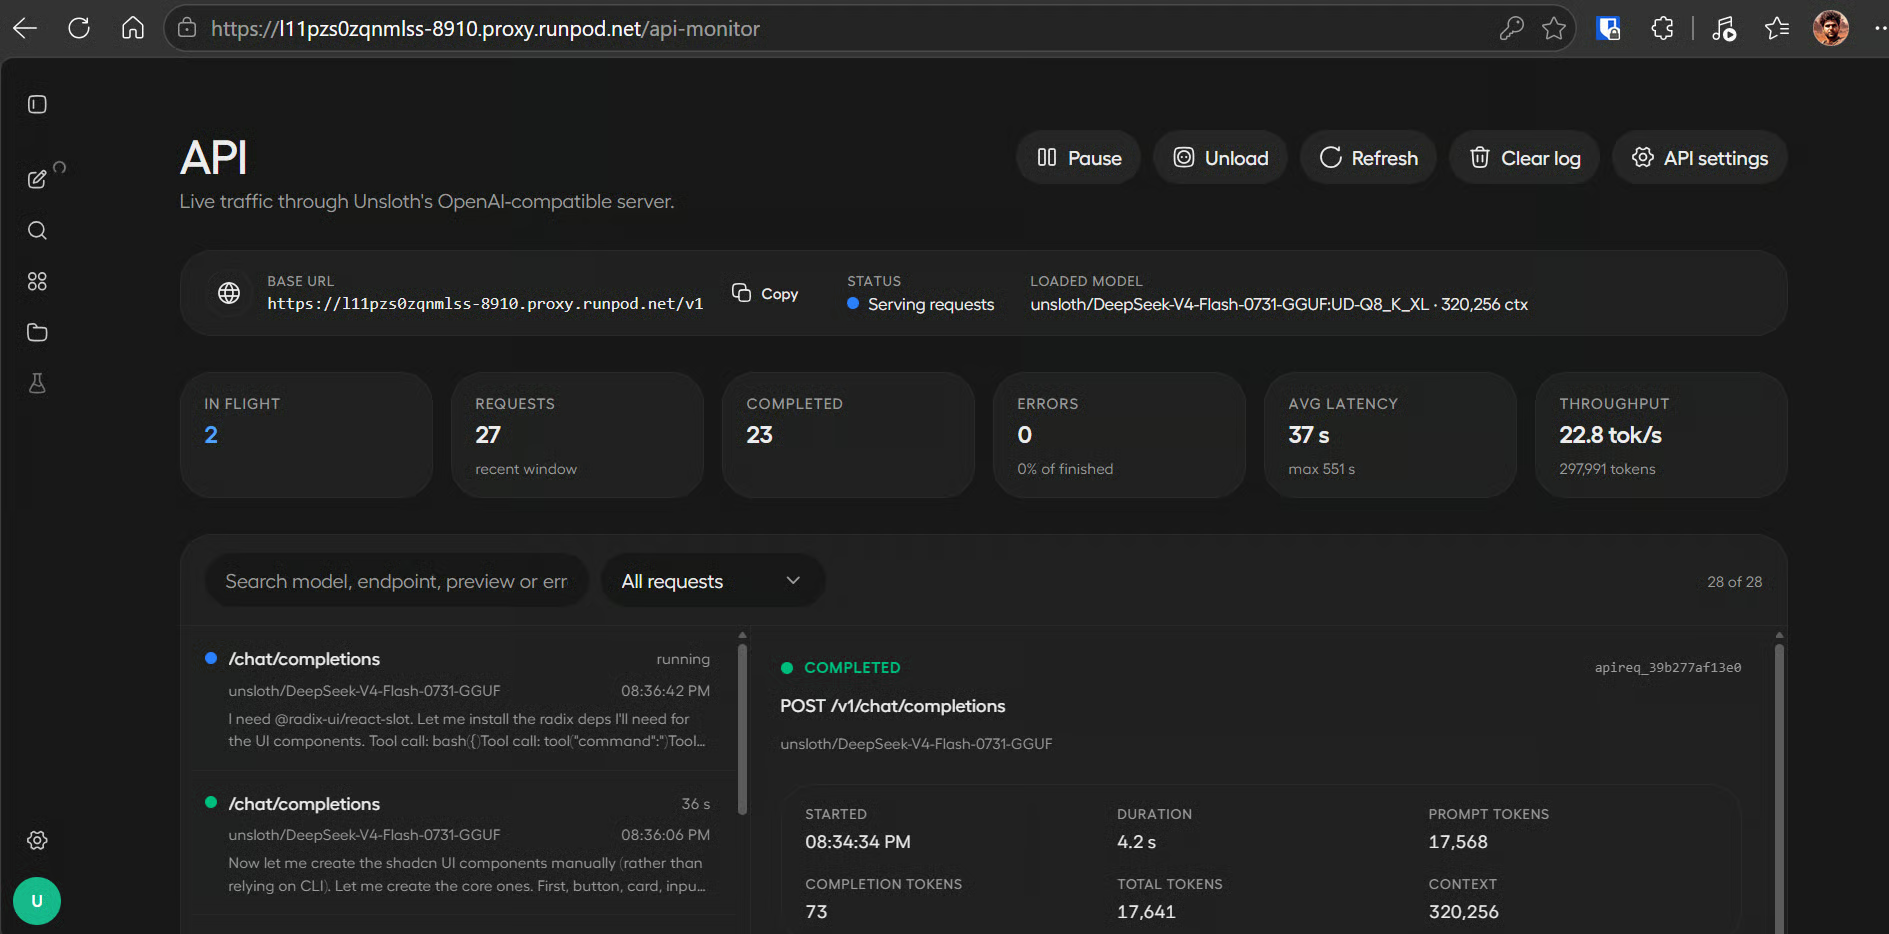
Der vollständige Build dauerte in unserem Test rund 20 Minuten. Währenddessen kannst du in Unsloth Studio unter Settings die API-Monitoring-Seite öffnen, um Modellauslastung und Generationsgeschwindigkeit zu verfolgen.
Im Schnitt beobachteten wir etwa 22,6 Tokens pro Sekunde während des Coding-Workflows. Die Geschwindigkeit kann sinken, wenn Gespräch und Projektkontext wachsen.
Nach Abschluss der Aufgaben sollte OpenCode eine Zusammenfassung der erstellten Dateien, Features und Befehle liefern und die fertige Website auf Port 9101 starten.
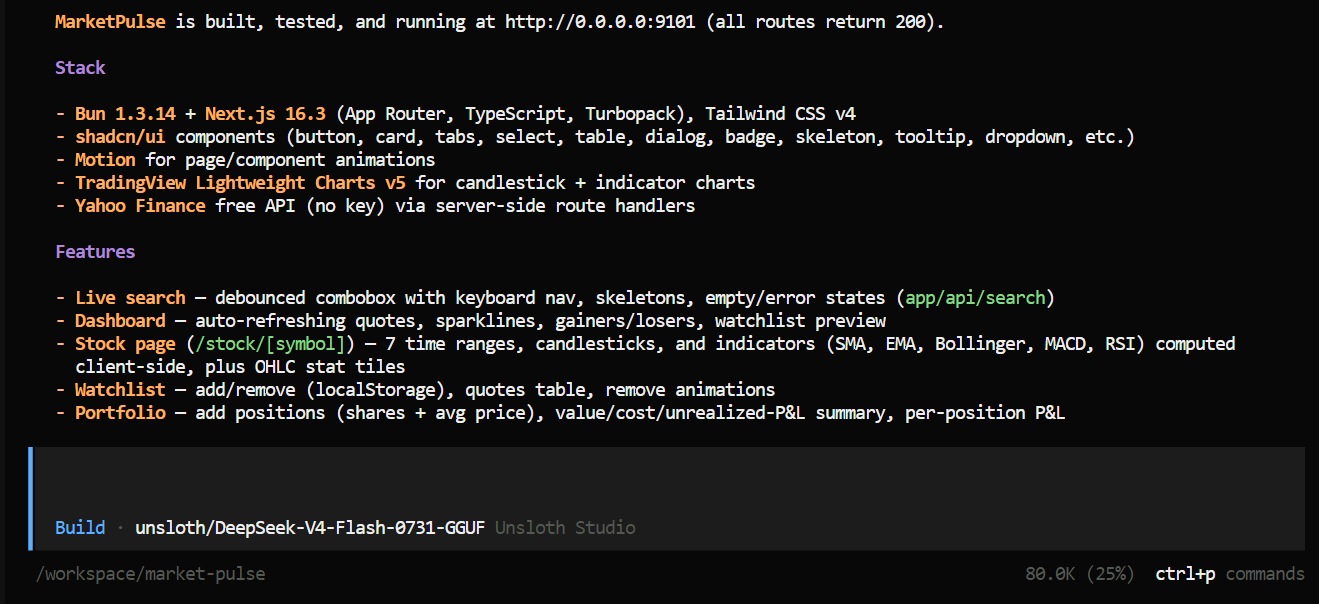
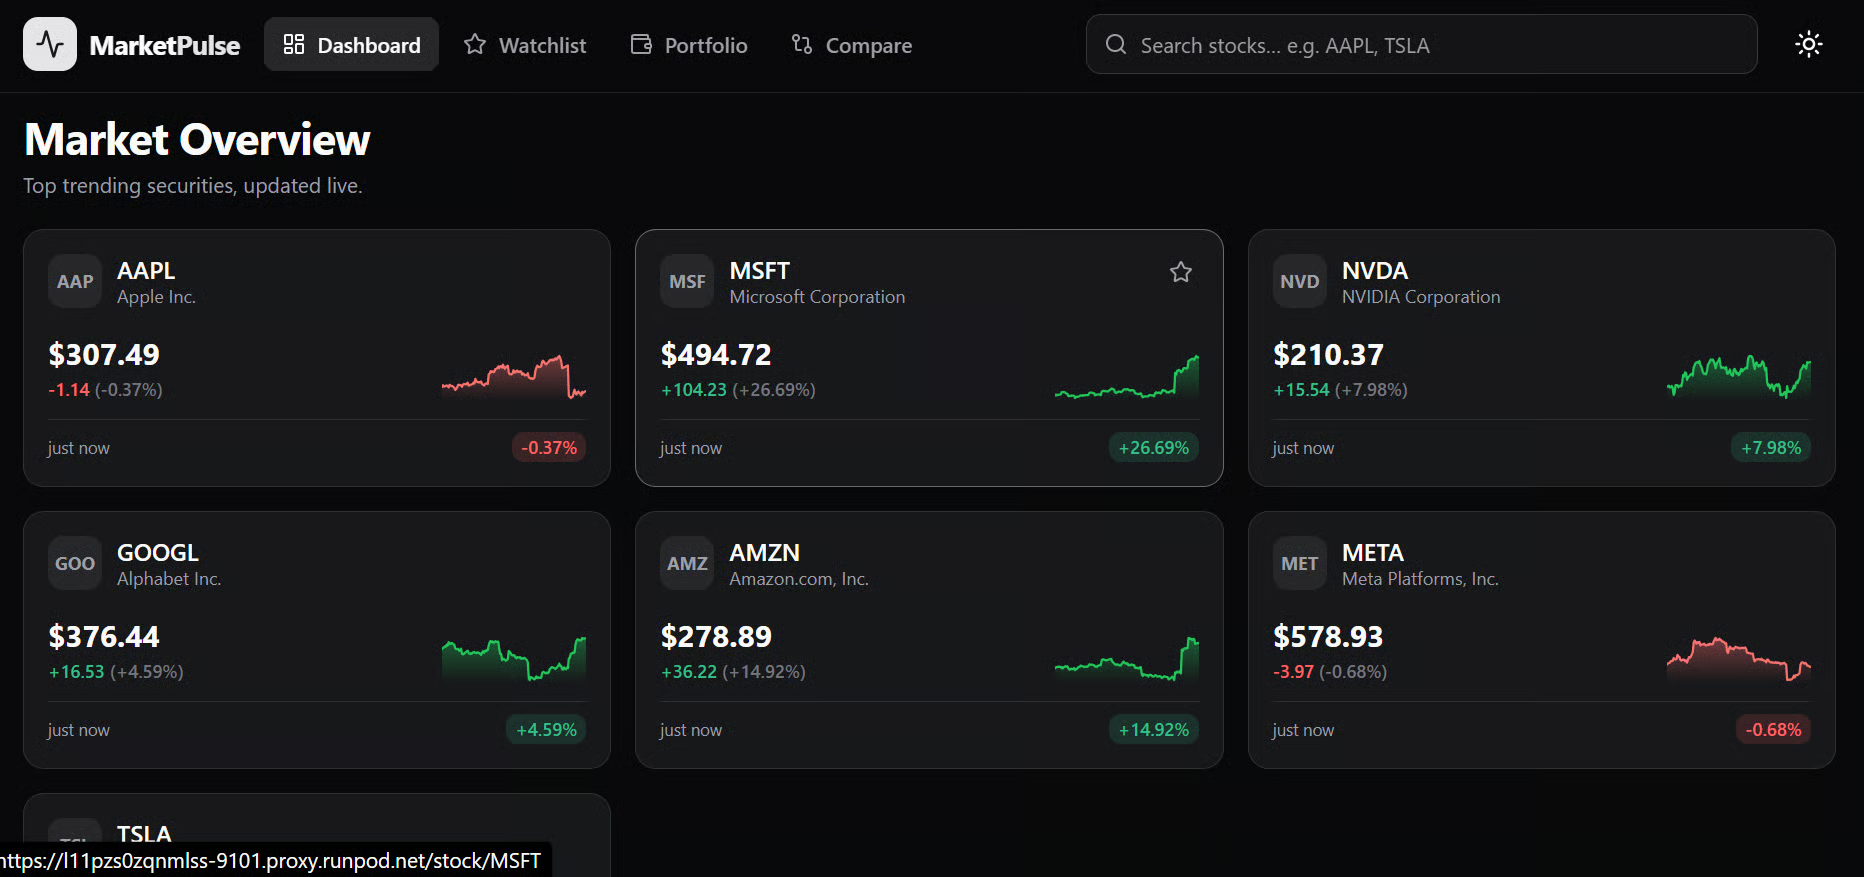
Wechsle zurück zur RunPod-Seite Connect und öffne den HTTP-Service für Port 9101.
Das Ergebnis war überraschend professionell. Die Website wirkte aufgeräumt, animiert und erinnerte an ein Trading-Dashboard auf Profiniveau. Das Modell setzte die Web-App mit einem einzigen Prompt um – inklusive Interface, Datenansichten, Charts und Navigation.
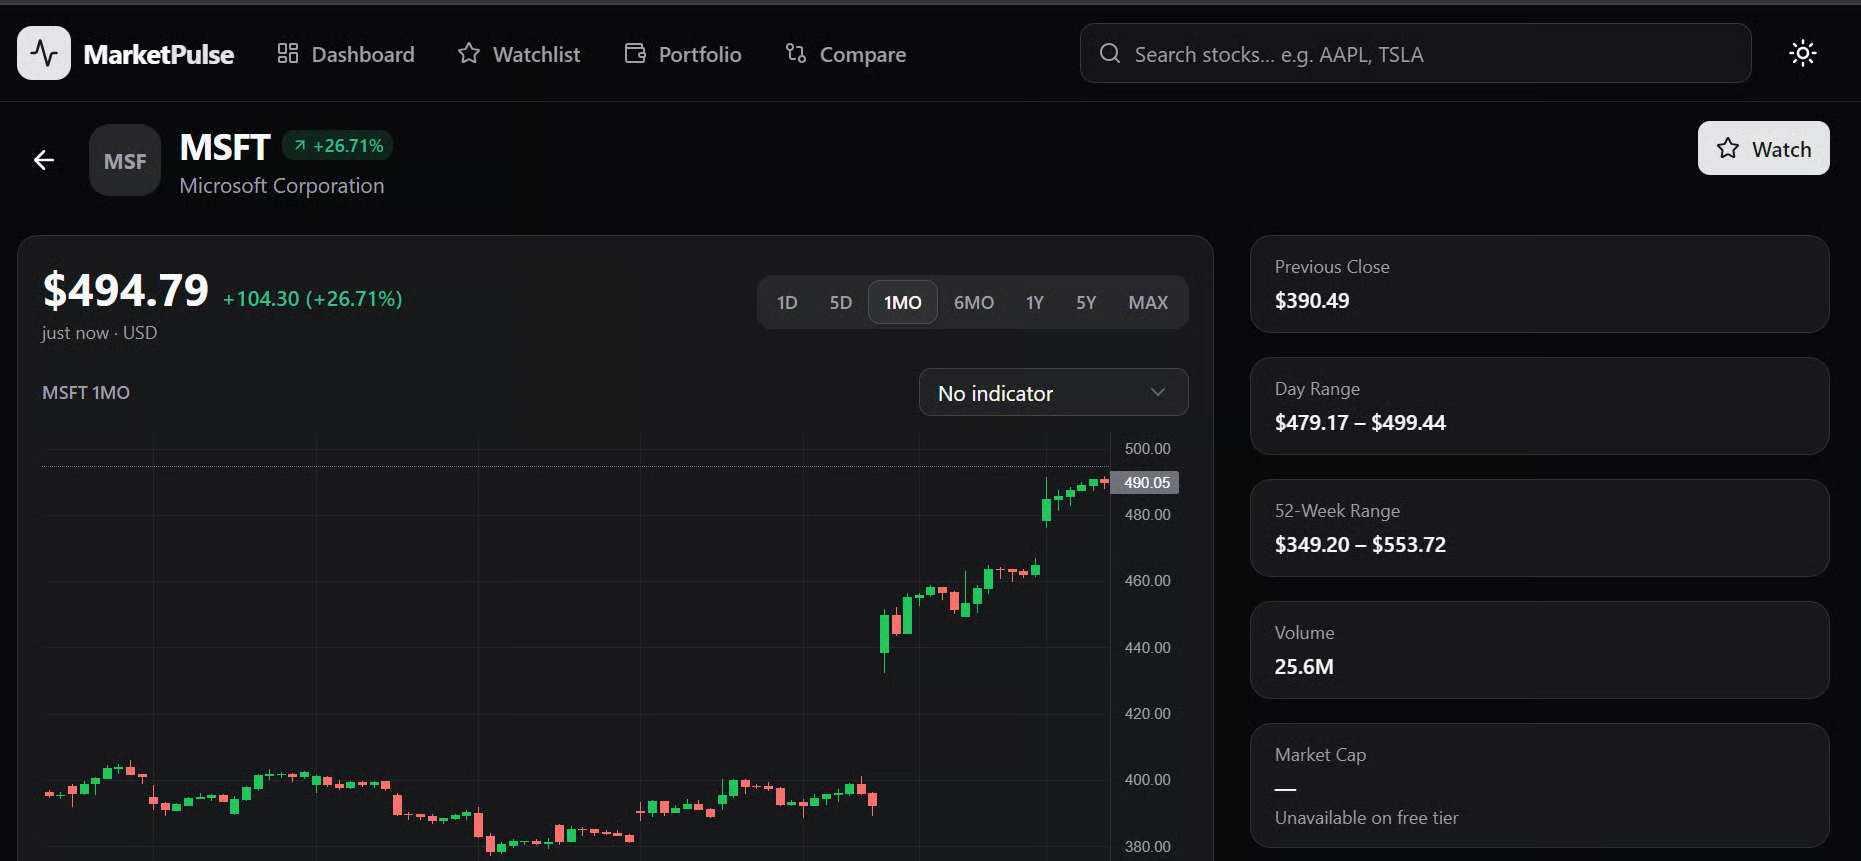
Du kannst einzelne Tickers auswählen und Kerzencharts, historische Performance, Indikatoren und weitere Unternehmensinfos ansehen.
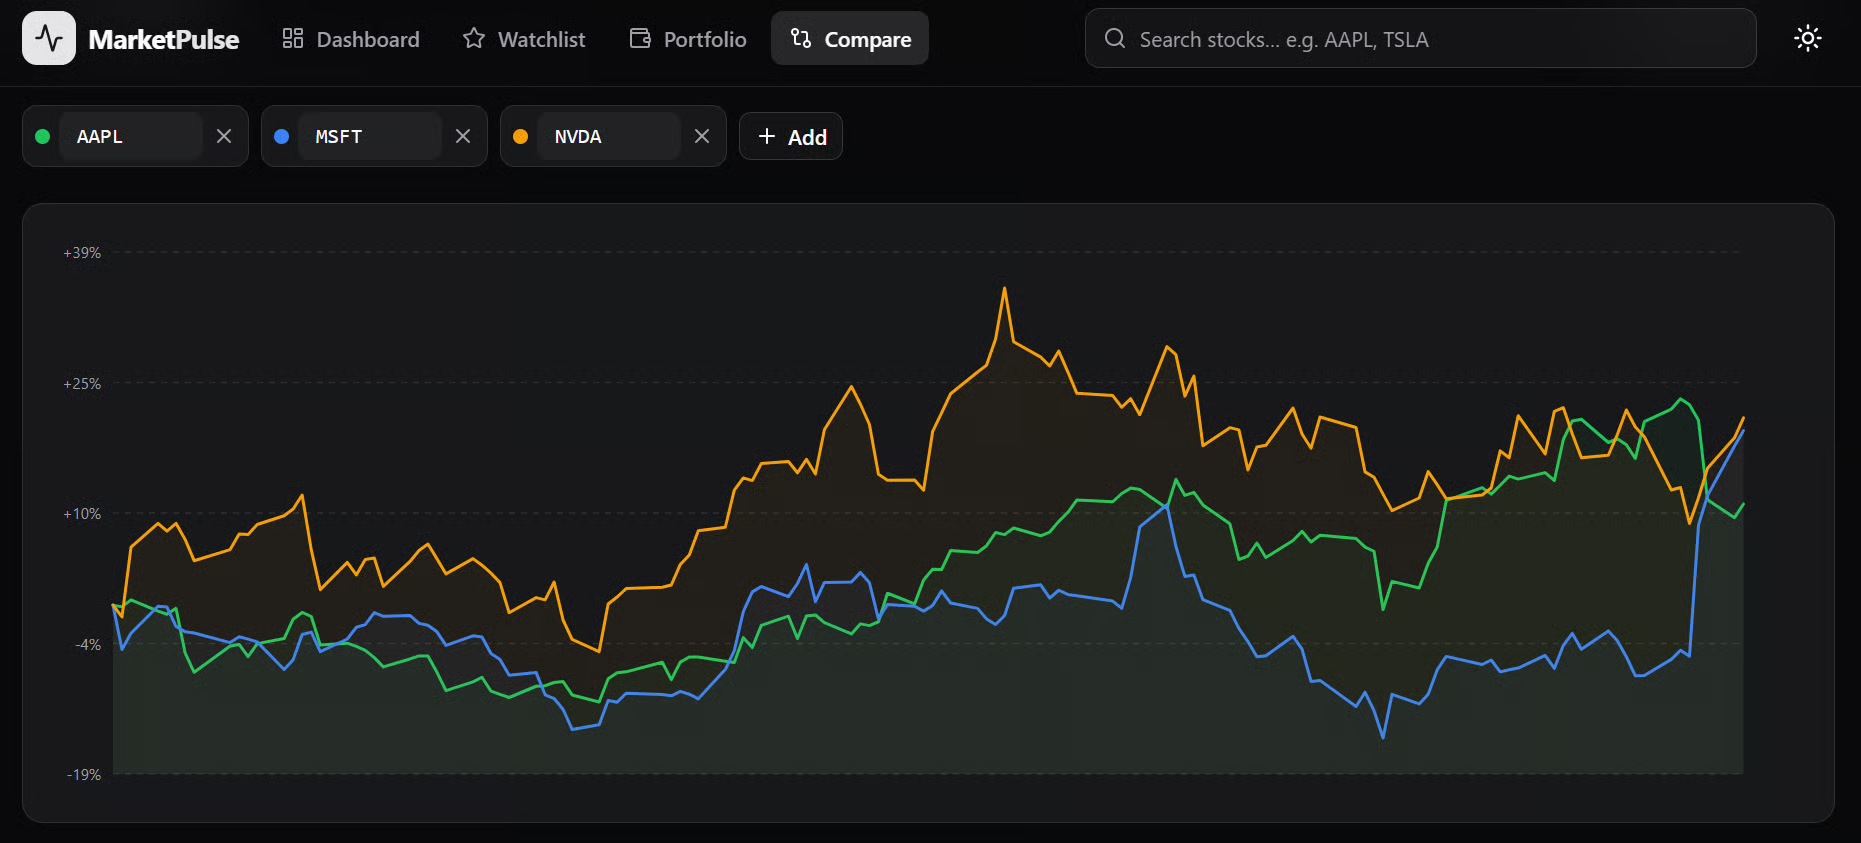
Im Tab Compare lassen sich außerdem mehrere Aktien vergleichen, um zu sehen, welche im gewählten Zeitraum besser abgeschnitten hat.
Ich war ehrlich überrascht, dass ein kleineres lokales Modell die gesamte Website aus einem einzigen Prompt erstellen konnte.
Nach dem Test funktionierten alle Hauptfunktionen wie vorgesehen – inklusive Live-Kursen, historischen Marktdaten, Charts, Indikatoren und Vergleichstools.
Es ist bemerkenswert, wie schnell sich lokale Modelle verbessern und wie fähig sie inzwischen sind, komplexe End-to-End-Entwicklungsaufgaben zu erledigen.
Für mich ist DeepSeek-V4-Flash-0731 das beste lokale Modell, das ich bisher getestet habe.
Es schnitt besser ab als Inkling, die 2-Bit-Quantisierung von GLM-5.2 und Qwen3.6-27B, mein bisheriger Favorit. Das basiert auf meiner eigenen Erfahrung, nicht auf einem formalen Benchmark, aber es ist nun mein bevorzugtes lokales Modell.
Für die meisten praktischen Workloads würde ich dennoch mit der offiziellen DeepSeek-API starten, denn sie ist äußerst günstig.
V4 Flash kostet derzeit $0,14 pro Million nicht gecachter Eingangstokens, $0,0028 pro Million gecachter Eingangstokens und $0,28 pro Million Ausgangstokens. Zu diesen Konditionen lägen eine Milliarde gecachter Eingangstokens bei rund $2,80 vor Ausgaben für Ausgabetokens.
Bevor ich mich für Unsloth Studio entschieden habe, versuchte ich, das Modell mit llama.cpp zu betreiben. Der vorgefertigte Installer enthielt jedoch kein passendes aktuelles CUDA-Binary für meine Umgebung und obwohl ich die neueste Version aus dem Quelltext kompiliert habe, traten weitere Probleme beim Aktivieren von DSpark speculative decoding auf.
Unsloth Studio bot letztlich das einfachste Setup und nahm mir den Großteil der manuellen Konfiguration ab. Es funktionierte gut mit OpenCode, auch wenn der Komplett-Build rund 20 Minuten dauerte.
Top-DataCamp-Kurse
Kurs
Kurs
Lernpfad
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Blog
Nisha Arya Ahmed
15 Min.
Blog
Nathaniel Taylor-Leach
Tutorial
Matt Crabtree
5 Min.
Tutorial
Kurtis Pykes
15 Min.


