Cursus
AI-ondersteund coderen voor developers
1 Hr 30 Min
9.9K
Kleiner en sneller betekent niet langer automatisch minder capabel. Volgens de gepubliceerde evaluaties van DeepSeek gebruikt DeepSeek-V4-Flash-0731 een veel kleinere geactiveerde parameterfootprint dan DeepSeek-V4-Pro, terwijl het bijna frontlinie agent-prestaties levert: het scoort 82,7 op Terminal Bench 2.1, vergeleken met 81,0 voor GLM-5.2 en 85,0 voor Opus 4.8, terwijl de score 25,2 op Agents’ Last Exam dicht in de buurt komt van de 25,7 van Opus 4.8.
Omdat de gewichten openlijk beschikbaar zijn, kun je het model in theorie op je eigen hardware draaien wanneer je genoeg gecombineerde RAM of VRAM hebt, zodat inferentie en projectgegevens onder jouw controle blijven.
In deze gids configureren we een RunPod-omgeving met drie GPU’s, installeren en starten we Unsloth Studio, downloaden en laden we de Q8-versie van DeepSeek-V4-Flash-0731 over de GPU’s, testen we het model via Studio, koppelen we de lokale inferentieserver aan OpenCode en gebruiken we de code-agent om een interactieve website voor stockanalyse te bouwen en te lanceren.
DeepSeek-V4-Flash-0731 is de officiële release die de eerdere preview vervangt, met grote verbeteringen in coderen, toolgebruik en autonome agenttaken. De Mixture-of-Experts-architectuur activeert slechts een deel van het model per token. Dit helpt om efficiënter te blijven en toch sterke prestaties te leveren.
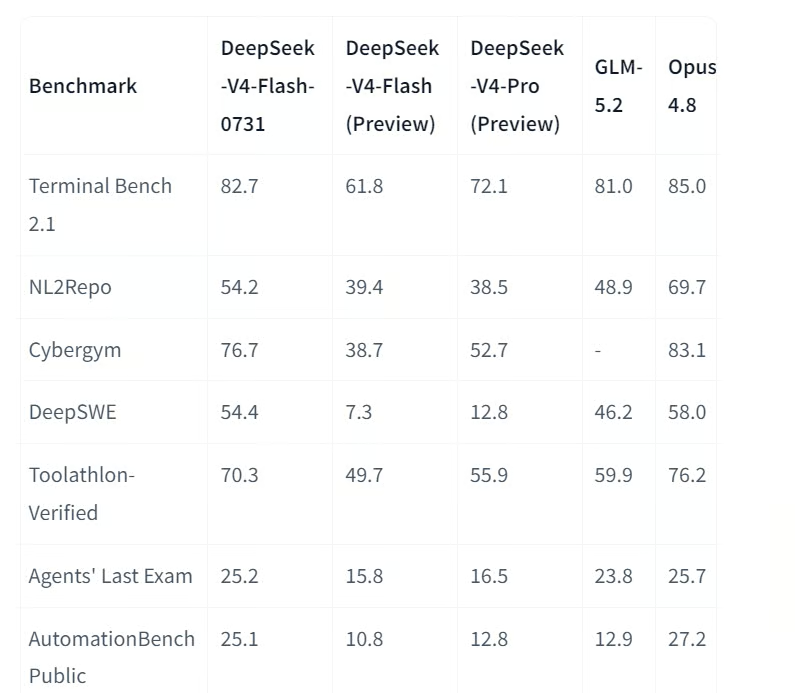
Bron: deepseek-ai/DeepSeek-V4-Flash-0731 · Hugging Face
DeepSeek meldt dat het model is verbeterd van 61,8 naar 82,7 op Terminal Bench 2.1 en van 7,3 naar 54,4 op DeepSWE. Het presteerde ook beter dan de grotere DeepSeek-V4-Pro Preview op verschillende agentbenchmarks.
Het model ondersteunt contextvensters tot één miljoen tokens. Dit maakt het geschikt voor grote codebases, lange documenten en complexe workflows die veel context vereisen. Gebruikers kunnen ook kiezen tussen lage, hoge en maximale redeneerinspanning, afhankelijk van hoeveel tijd het model aan een taak moet besteden.
DeepSeek-V4-Flash-0731 bevat ook DSpark speculative decoding. DSpark maakt eerst een concept van meerdere tokens voordat het hoofdmodel ze verifieert, wat volgens DeepSeek de genereersnelheid met 60% tot 85% kan verbeteren wanneer dit wordt gebruikt met een compatibele inferentie-engine.
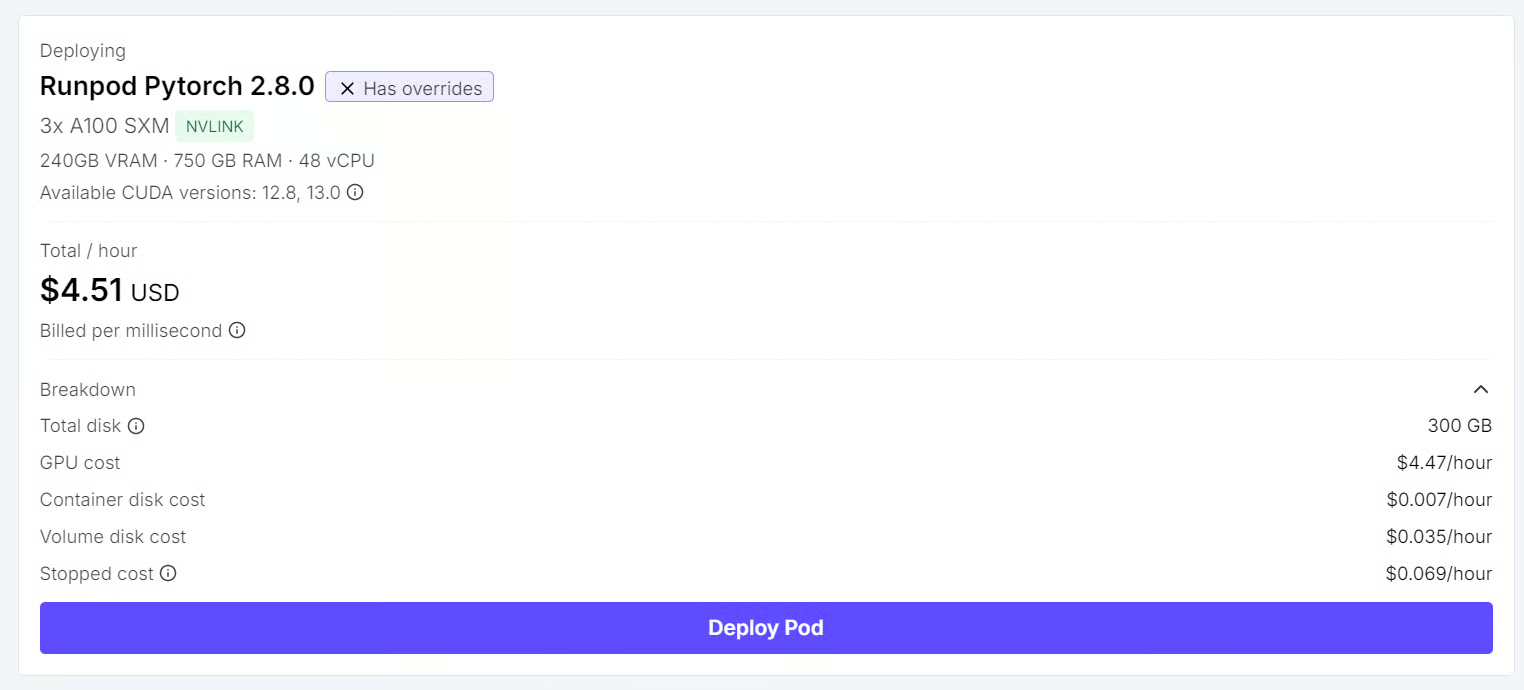
We beginnen met het creëren van een RunPod-omgeving met genoeg GPU-geheugen en opslag om de Q8-versie van DeepSeek-V4-Flash-0731 te draaien en zowel Unsloth Studio als de website die door OpenCode wordt gegenereerd te hosten.
Configureer de Pod met:
/workspace als het pad voor het mounten van het persistent volumeHF_TOKEN8910 en 9101 opengezet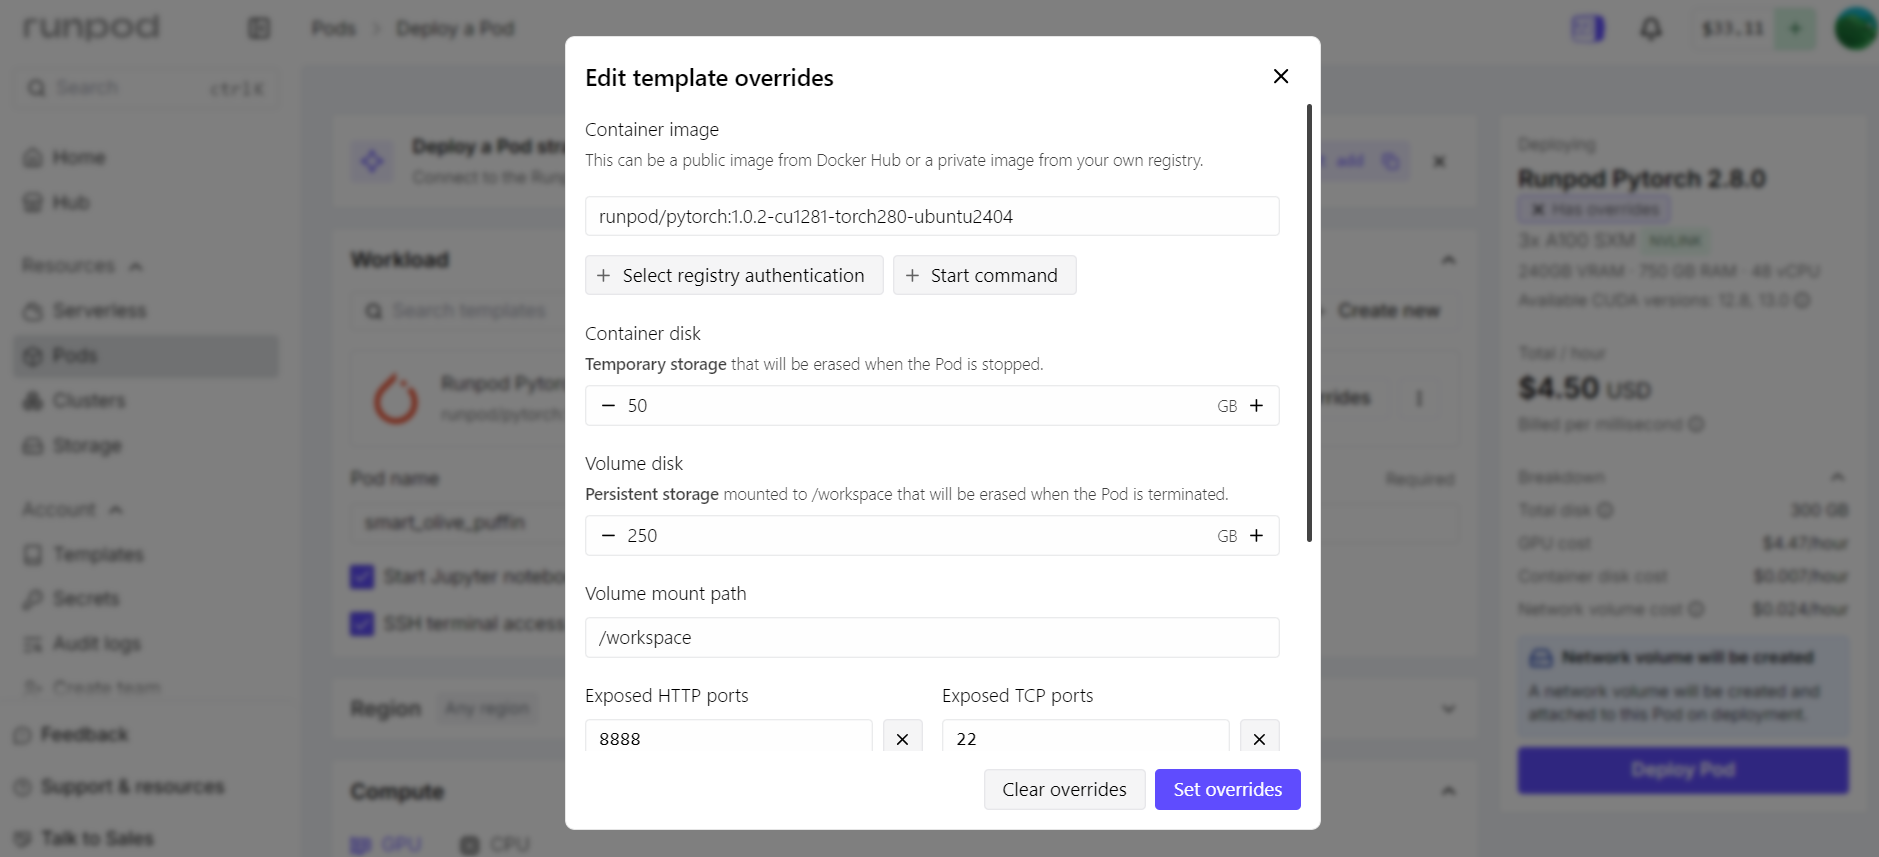
Poort 8910 wordt gebruikt voor Unsloth Studio en de lokale inferentie-API. Poort 9101 host de interactieve website die door OpenCode is gemaakt.
RunPod stelt deze services bloot via de HTTP-proxy, dus beide applicaties moeten luisteren op 0.0.0.0 in plaats van alleen op 127.0.0.1.
Na het deployen van de Pod, open je het tabblad Connect, start je JupyterLab en maak je drie terminalsessies aan:
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
De taken in afzonderlijke terminals houden maakt het eenvoudiger om de GPU’s te monitoren, problemen met het model op te lossen en tegelijkertijd de code-agent te draaien.
Vervolgens installeren we Unsloth Studio, configureren we een persistente Hugging Face-cache en starten we de interface op poort 8910.
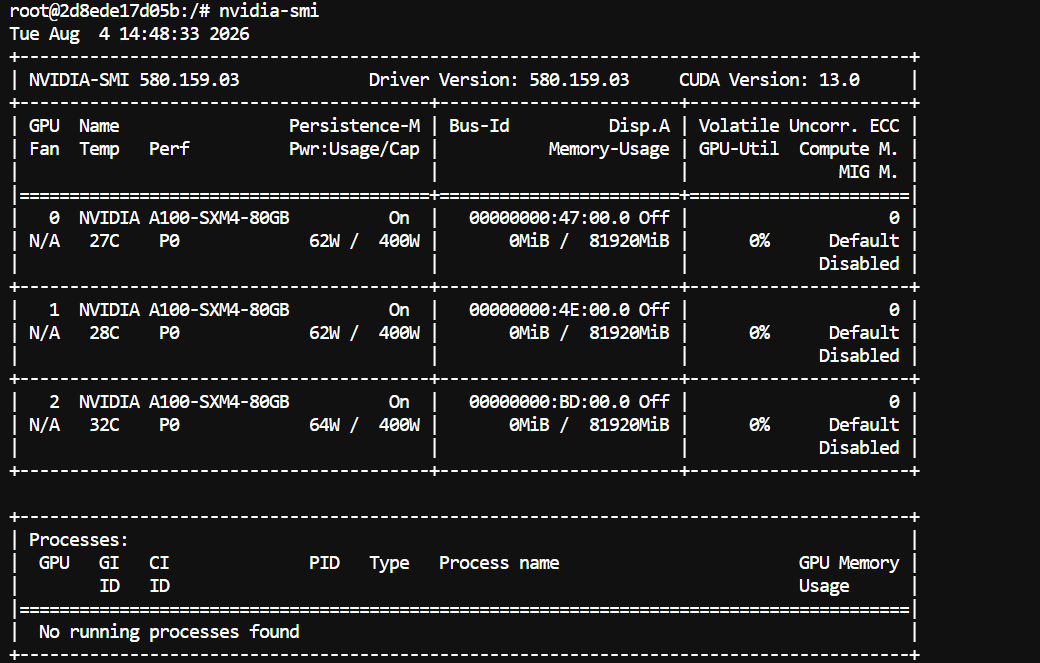
In Terminal 1 controleer je of alle drie de GPU’s beschikbaar zijn:
nvidia-smiJe zou alle drie de A100 GPU’s op de Linux-server moeten zien staan.
Maak een persistente Hugging Face-cache in /workspace zodat gedownloade modellen beschikbaar blijven op het RunPod-volume:
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
Installeer vervolgens de vereiste systeempakketten en Unsloth Studio:
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh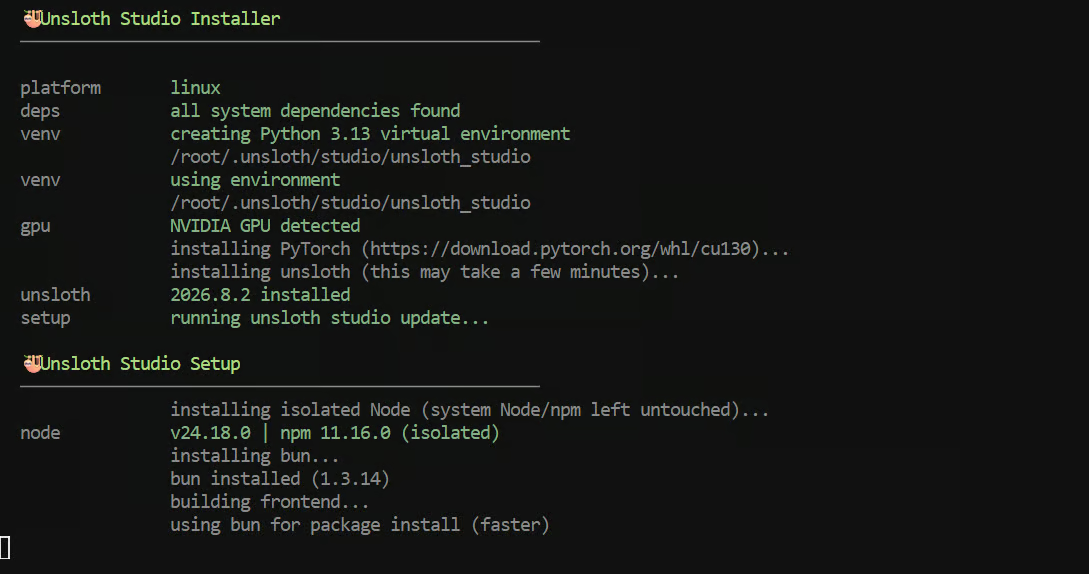
De installer configureert de Studio-interface, Python-omgeving, dependencies en lokale inferentiecomponenten.
De eerste installatie kan enkele minuten duren.
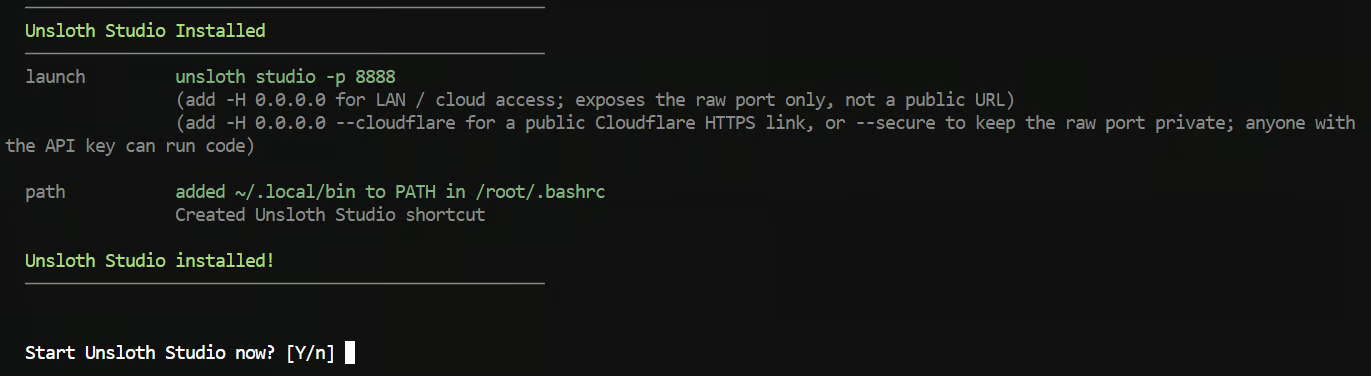
Wanneer de installer vraagt of je Unsloth Studio meteen wilt starten, voer dan “n” in.
We starten het handmatig zodat het poort 8910 gebruikt en op het juiste netwerkadres luistert.
Herstart de shell zodat de nieuwe commando’s beschikbaar zijn:
exec bash
cd /workspace
Reset voor het starten van Studio het standaardwachtwoord:
unsloth studio reset-passwordKopieer het tijdelijke wachtwoord dat tijdens de setup wordt getoond, want je hebt het mogelijk nodig om de reset te voltooien.
Start nu Unsloth Studio:
unsloth studio \
  -H 0.0.0.0 \
  -p 8910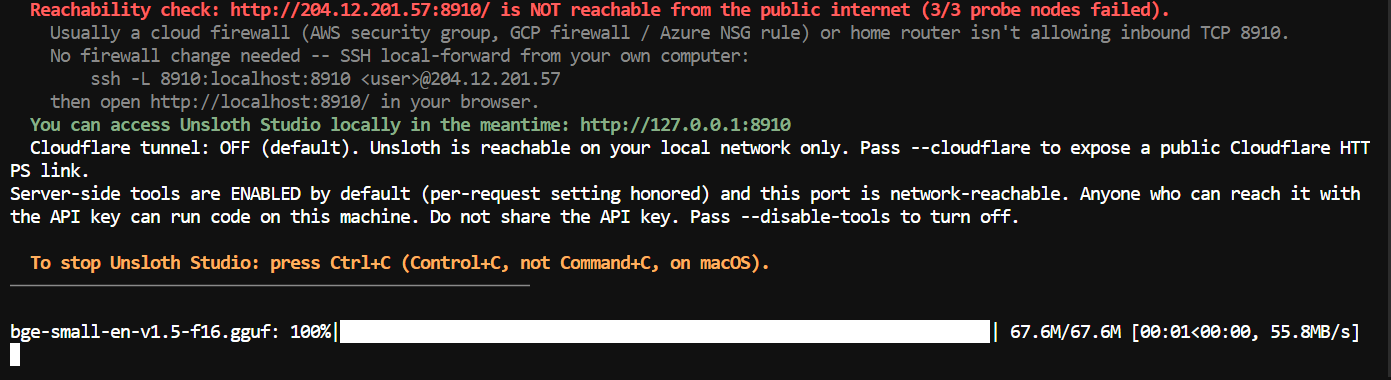
Studio zou nu moeten melden dat het draait op poort 8910. Houd Terminal 1 open tijdens het gebruik van Unsloth Studio en OpenCode.
Ga terug naar de RunPod-pagina Connect en open de HTTP Service voor poort 8910.
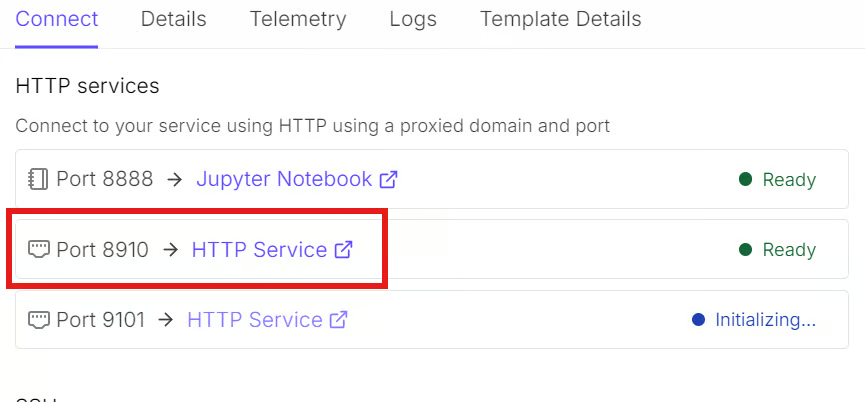
Gebruik het eerder gegenereerde tijdelijke wachtwoord om de reset te voltooien en meld je daarna aan met het nieuwe wachtwoord dat je hebt aangemaakt.
Voltooi of sla de onboarding-stappen over en open de Chat-pagina.
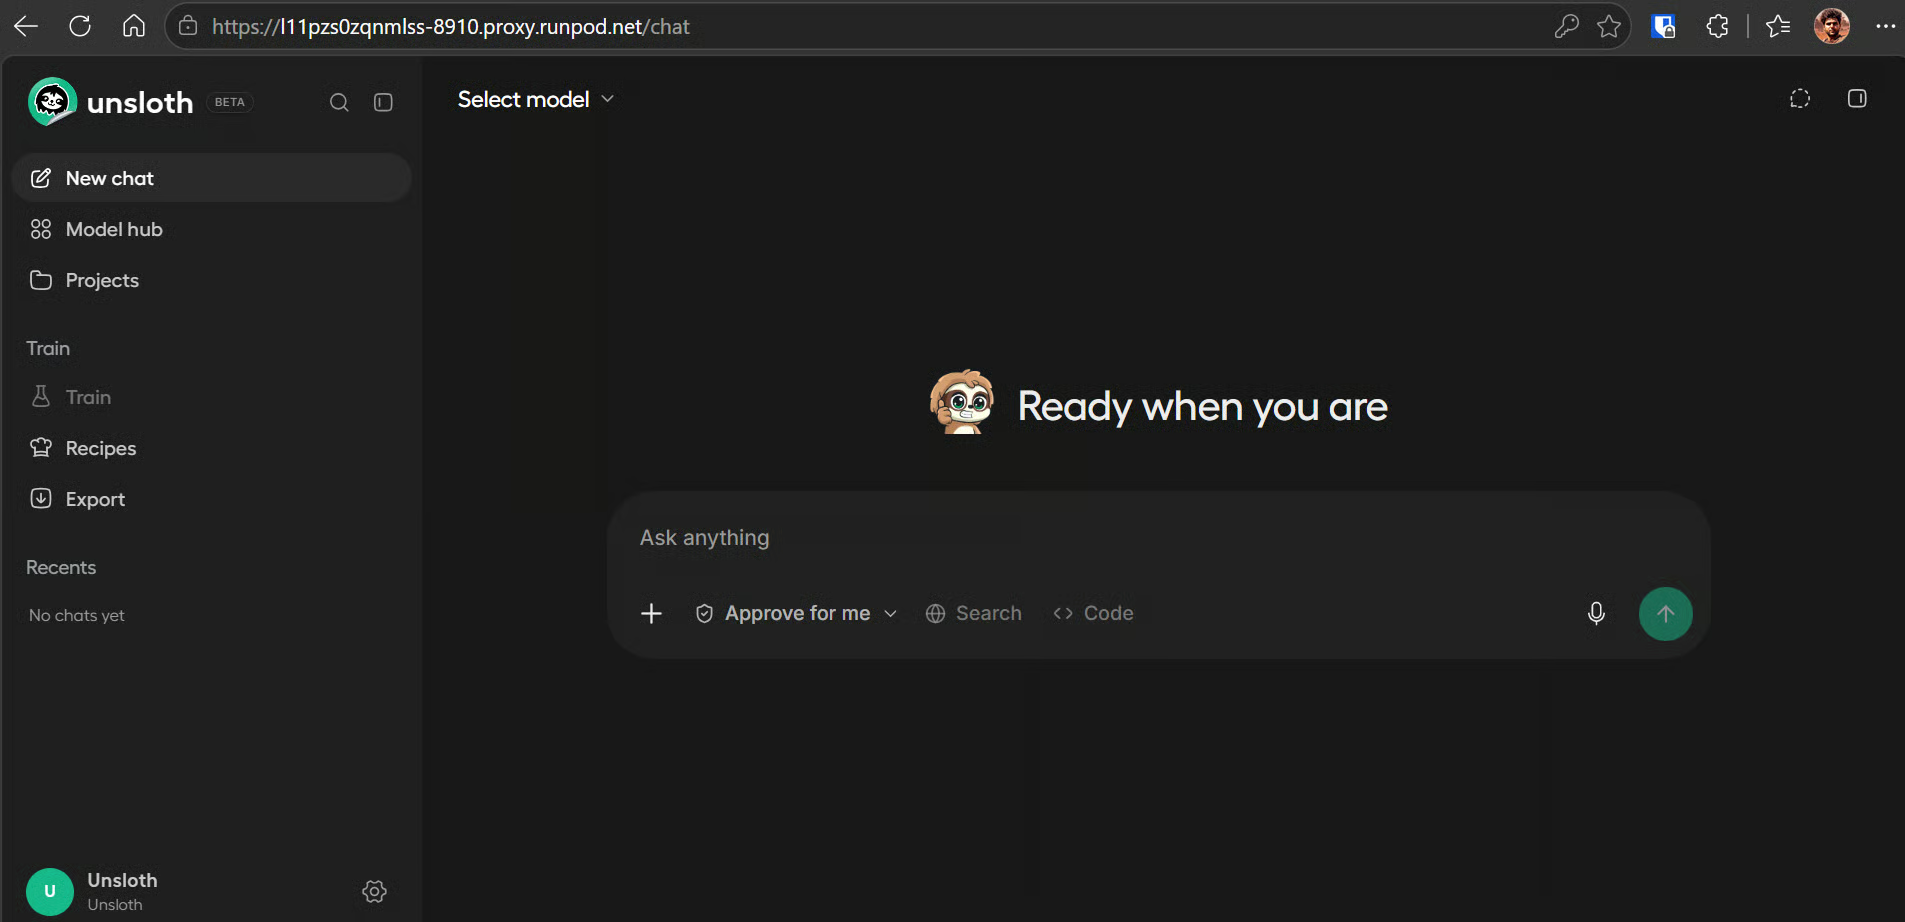
Nu Unsloth Studio draait, kunnen we het Q8-model downloaden, over de drie GPU’s laden en de chat- en toolgebruikmogelijkheden testen.
Open de modelkiezer linksboven en zoek naar unsloth/DeepSeek-V4-Flash-0731-GGUF en selecteer vervolgens de Q8-kwantisatie UD-Q8_K_XL.
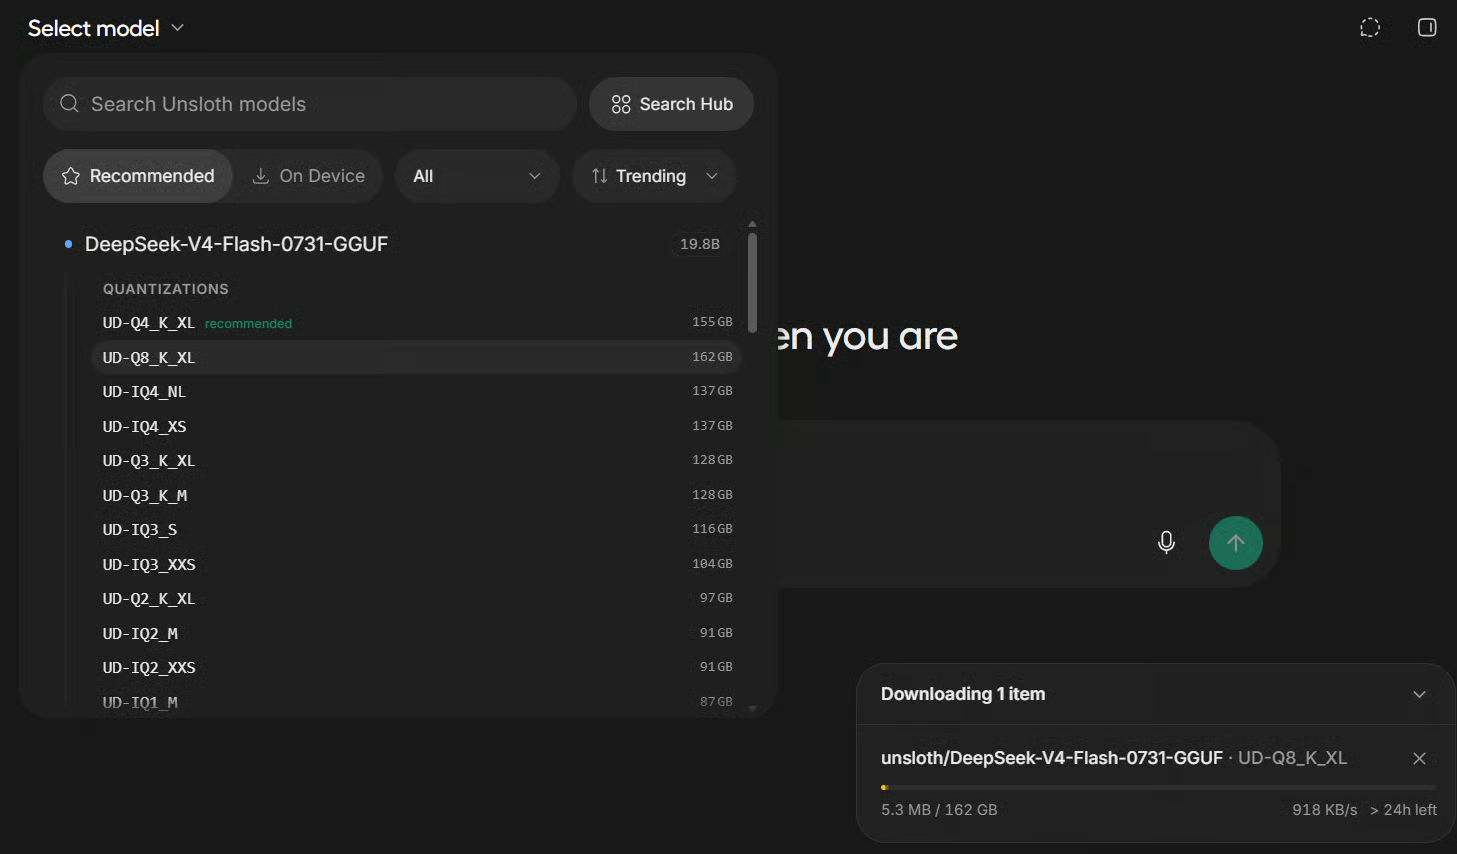
We gebruiken Q8 omdat de drie A100 GPU’s samen genoeg VRAM bieden. Dit behoudt de kwaliteit dichter bij het oorspronkelijke model, terwijl lagere kwantisaties nuttiger zijn wanneer het hardwaregeheugen beperkt is.
Zodra het downloaden is voltooid, begint Unsloth Studio automatisch met het laden van het model in GPU-geheugen. Dit kan enkele minuten duren omdat het Q8-model erg groot is.
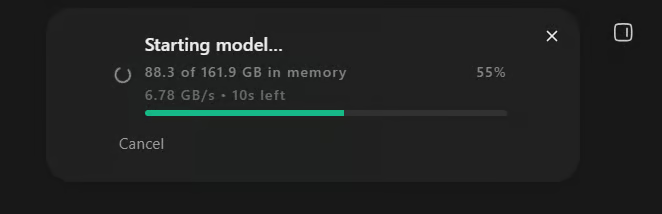
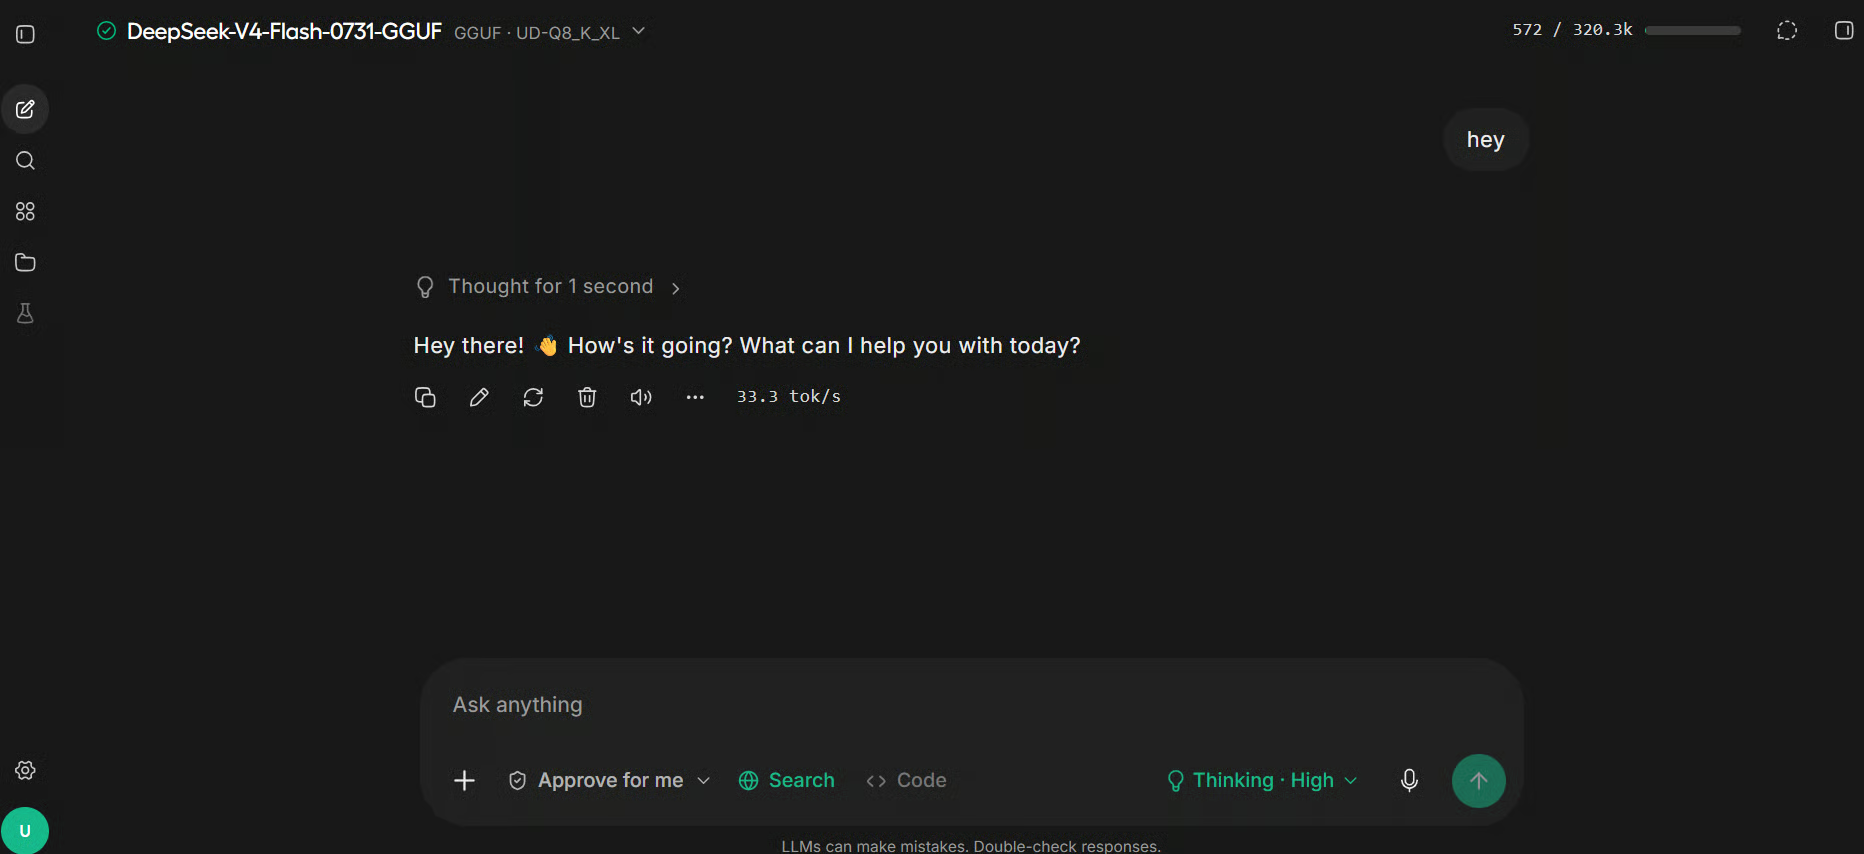
Na het laden kun je op de pagina Chat het model testen met een paar simpele prompts.
In onze tests haalde de generatie ongeveer 33 tokens per seconde zonder speculative decoding, wat een redelijk resultaat is voor een model van deze grootte.
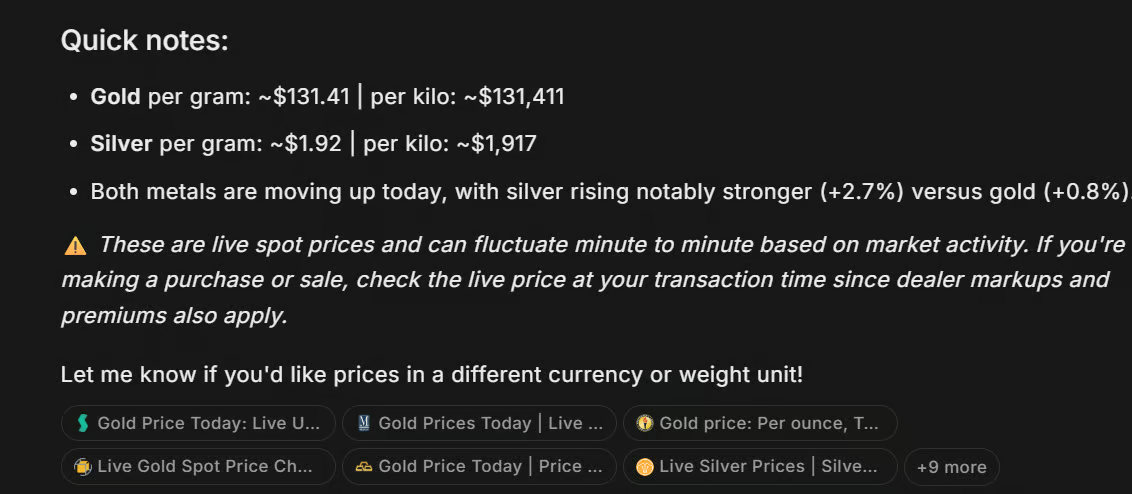
Je kunt ook de webzoektool van Studio inschakelen en het model vragen om actuele informatie op te zoeken, zoals de laatste goud- en zilverprijzen. Dit is een handige manier om te bevestigen dat het model externe tools kan aanroepen in plaats van alleen op de interne kennis te vertrouwen.
Controleer in Terminal 2 hoe het model over de GPU’s is verdeeld:
nvidia-smi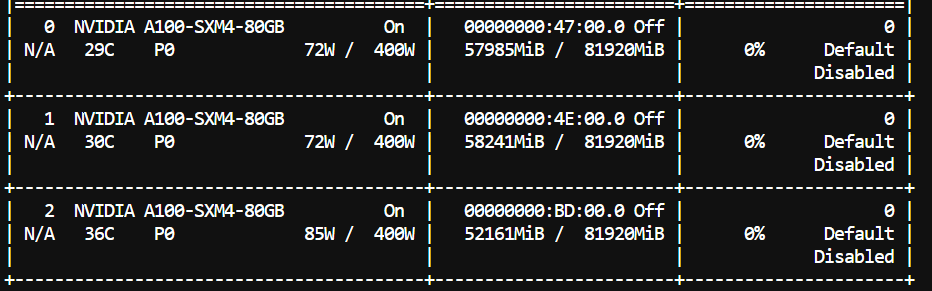
Je zou op alle drie de GPU’s aanzienlijk geheugengebruik moeten zien.
In onze test was elke GPU voor rond de 70% vol. Dit betekent echter niet per se dat het complete Q8-model comfortabel op slechts twee 80GB GPU’s past, omdat er aanvullende VRAM nodig is voor het contextvenster, de KV-cache en inferentiebuffers.
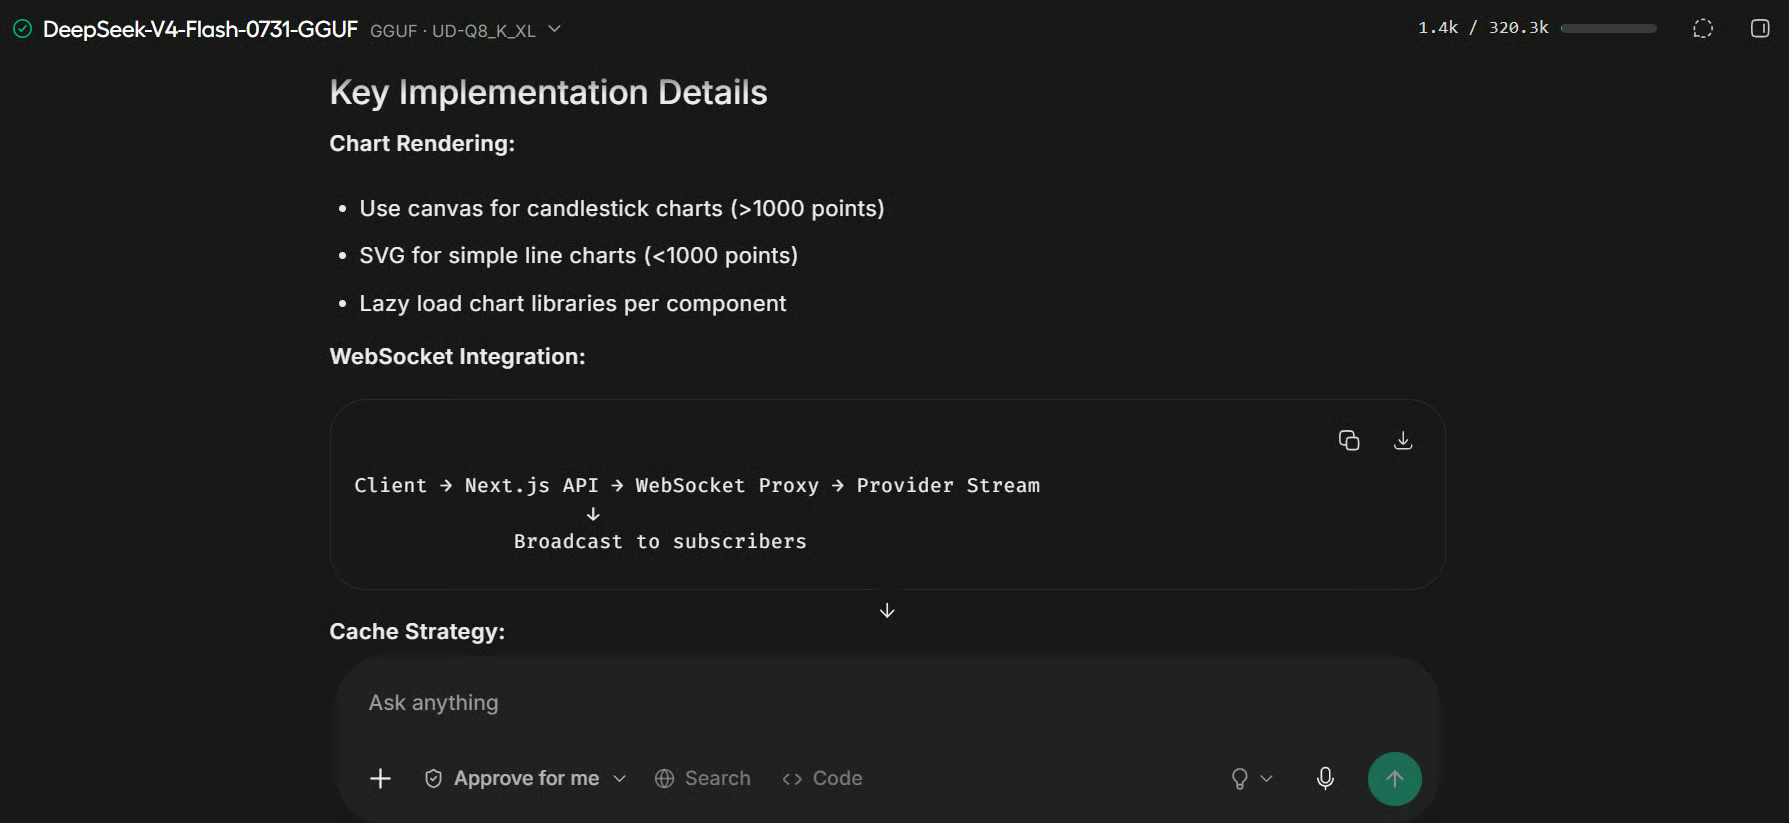
Test het model ten slotte met de planningsprompt voor de applicatie die we gaan bouwen:
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
Het model geeft een gestructureerd ontwikkelplan terug dat de applicatie-architectuur, componenten, datastroom, chartingbibliotheken, financiële berekeningen en interfaceontwerp behandelt.
Nu het model in Unsloth Studio draait, kunnen we het koppelen aan OpenCode en het gebruiken als lokale code-agent.
Stel in Terminal 3 de Studio-URL in:
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
Maak een nieuwe projectmap aan:
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
Start OpenCode via Unsloth Studio:
unsloth start opencodeDe eerste keer dat je dit commando uitvoert, zal het vragen om toestemming om OpenCode te installeren. Voer “y” in.
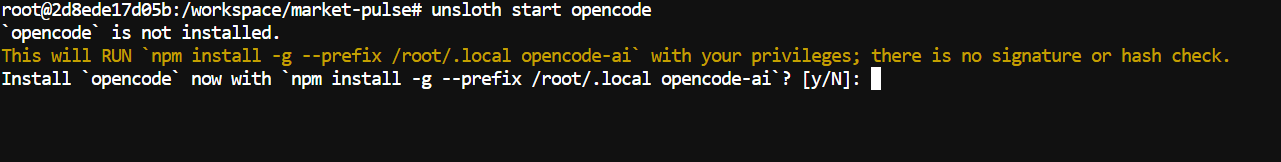
Zodra de installatie is voltooid, wordt OpenCode gestart met het lokaal draaiende DeepSeek-V4-Flash-0731-model al geconfigureerd.
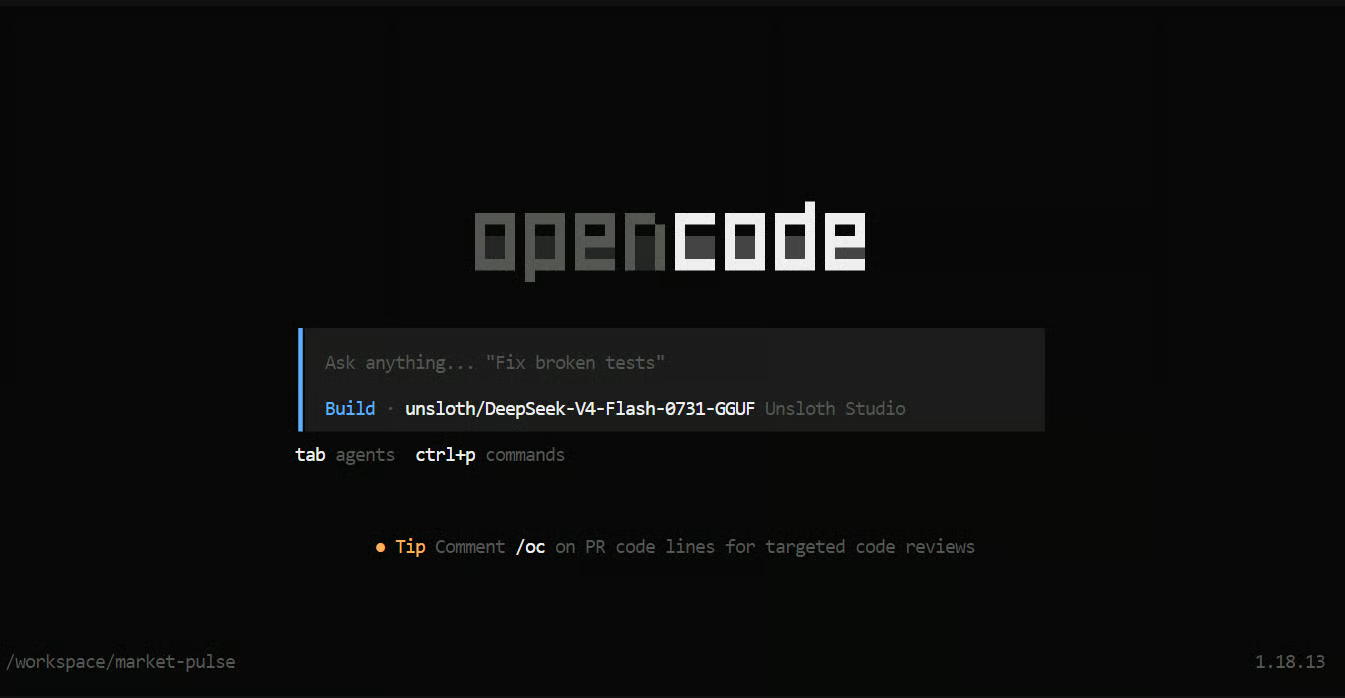
Plak de volgende tweeregelige prompt in OpenCode:
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
Binnen enkele seconden zou de code-agent een gedetailleerde takenlijst moeten maken en stap voor stap aan het project beginnen.
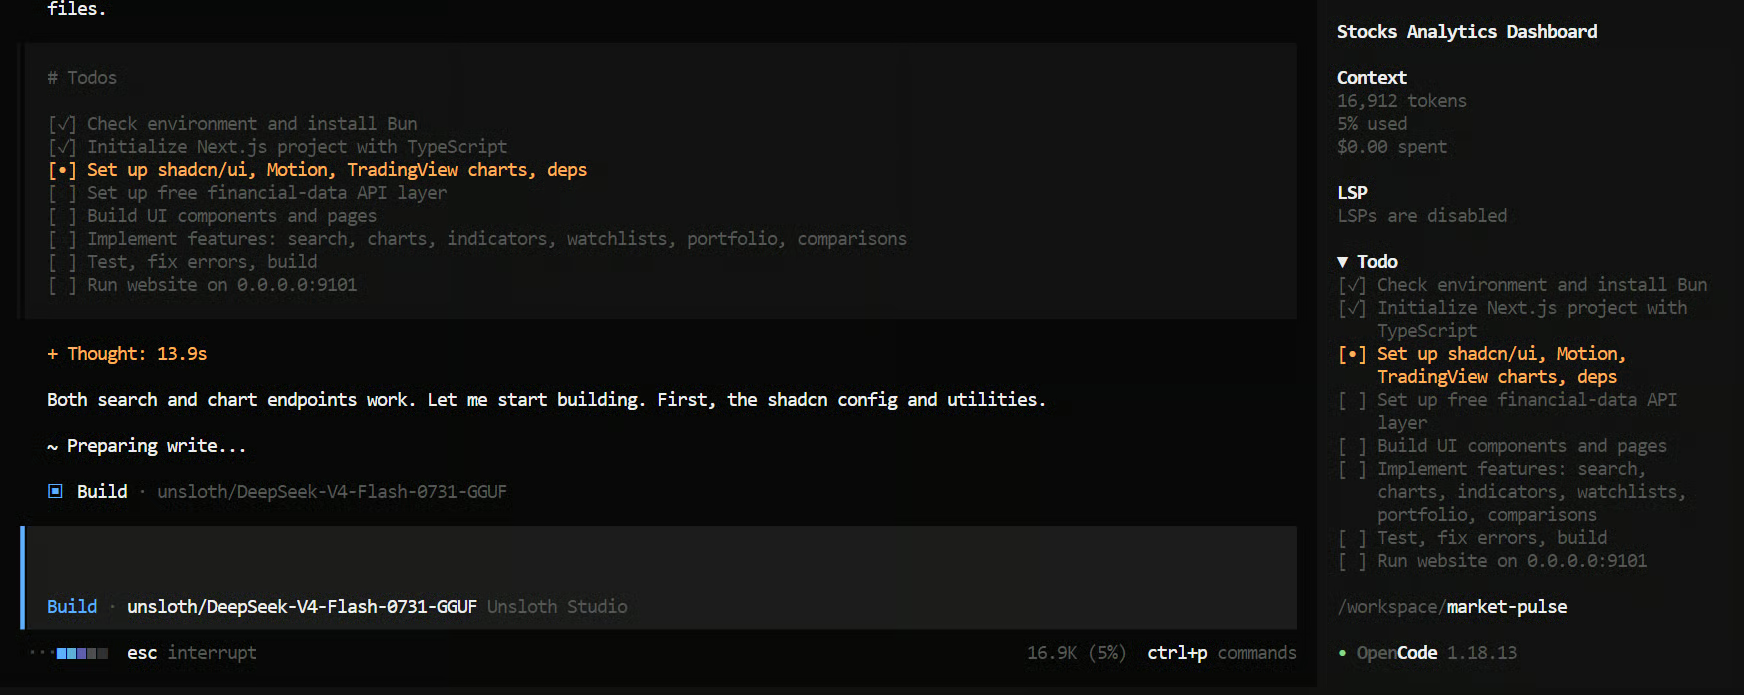
De volledige build duurde in onze test ongeveer 20 minuten. Terwijl deze draait, kun je teruggaan naar Unsloth Studio en in Settings de API-monitoringpagina openen om het modelgebruik en de genereersnelheid te volgen.
We zagen tijdens de codeworkflow een gemiddelde van ongeveer 22,6 tokens per seconde. De snelheid kan afnemen naarmate het gesprek en de projectcontext groeien.
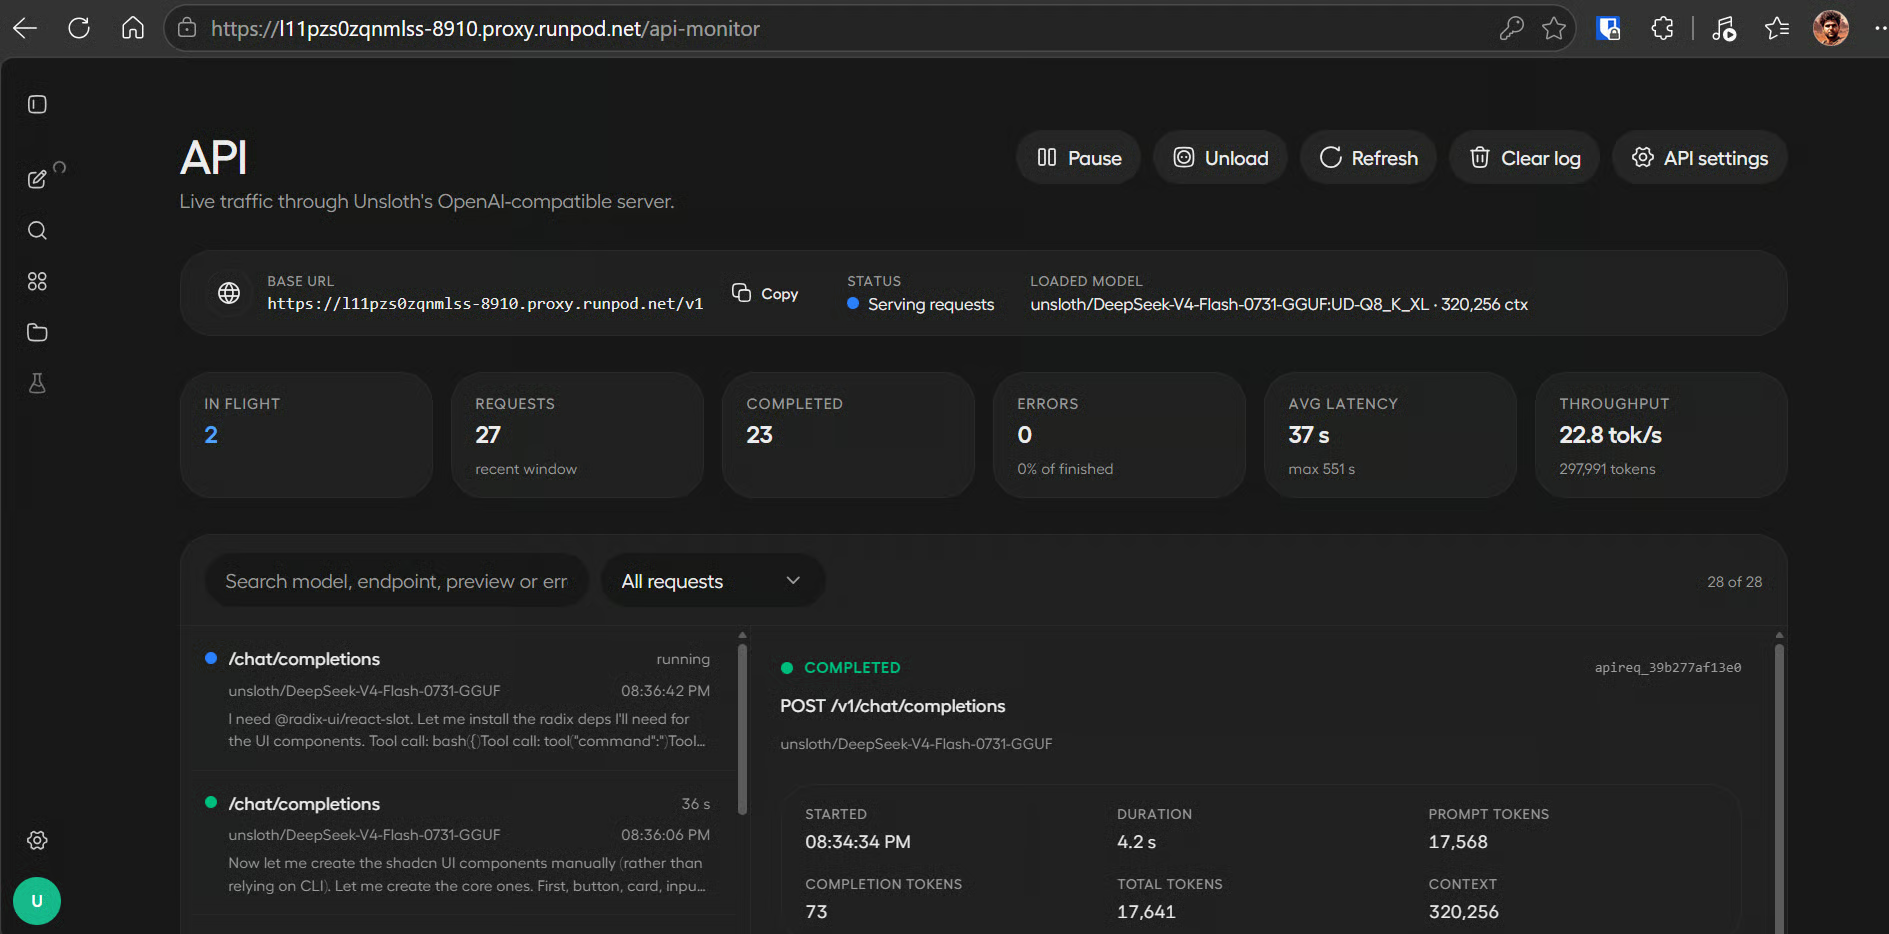
Na het voltooien van de taken zou OpenCode een samenvatting moeten geven van de bestanden, features en commando’s die zijn aangemaakt. Ook zou de voltooide website moeten worden gestart op poort 9101.
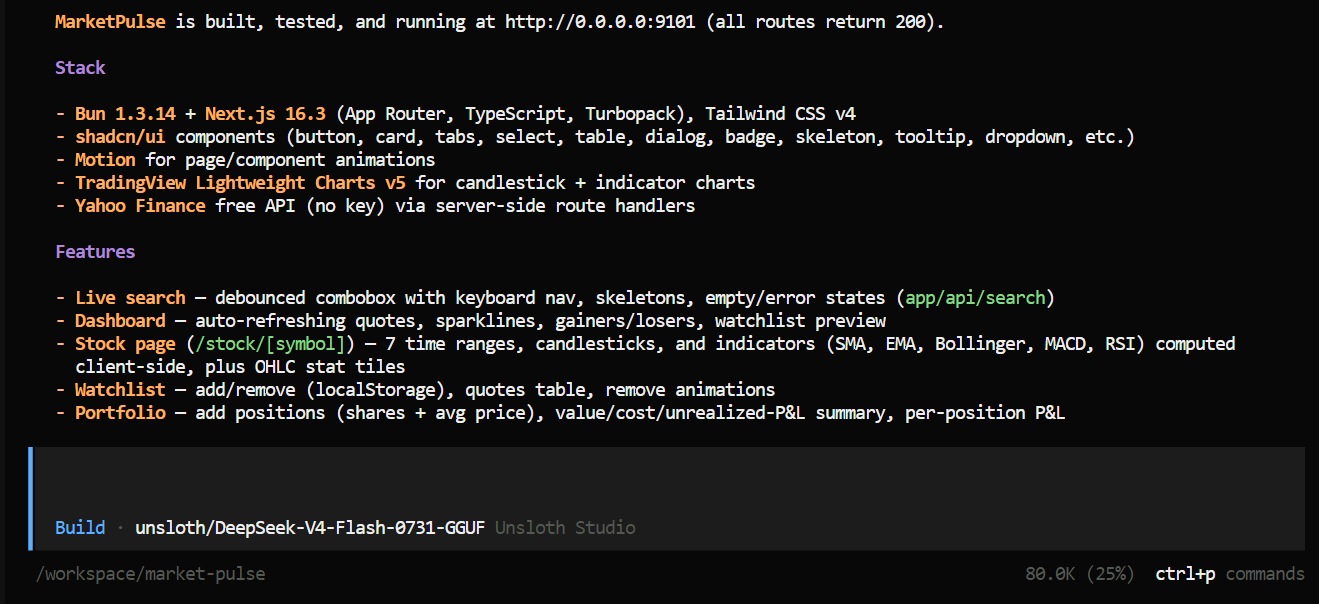
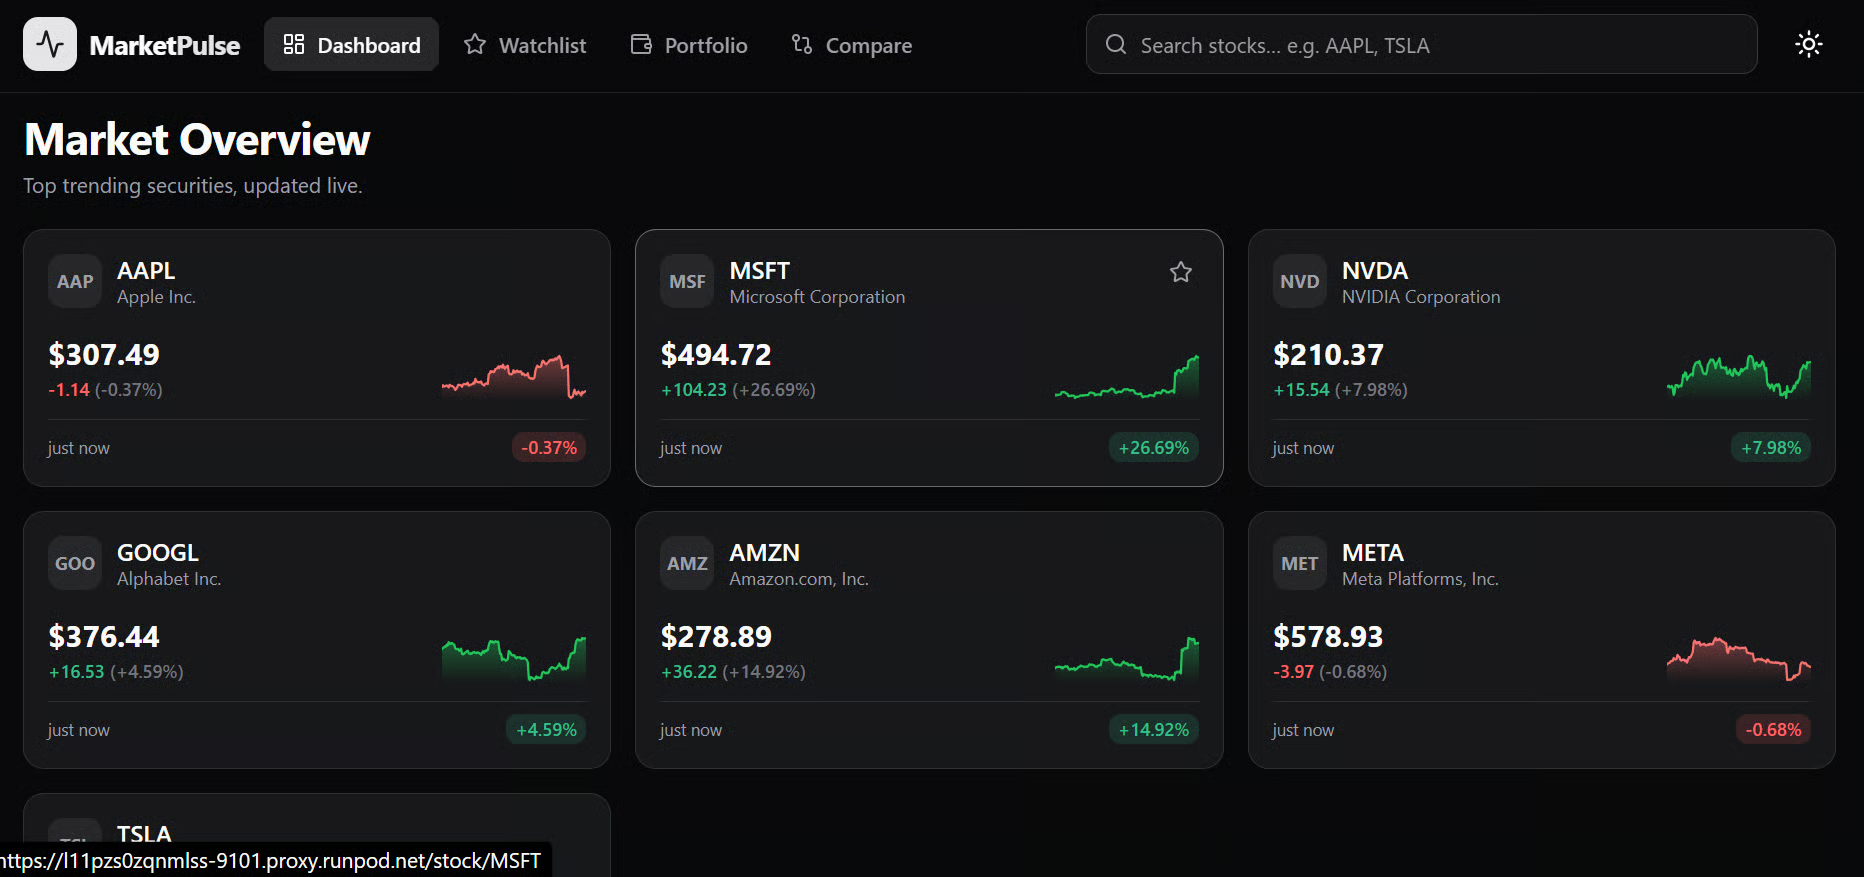
Ga terug naar de RunPod-pagina Connect en open de HTTP Service voor poort 9101.
Het resultaat was verrassend gepolijst. De website zag er strak uit, met animaties, en leek op een professionele tradingdashboard. Het model voltooide de webapplicatie met één prompt, inclusief de interface, dataviews, grafieken en navigatie.
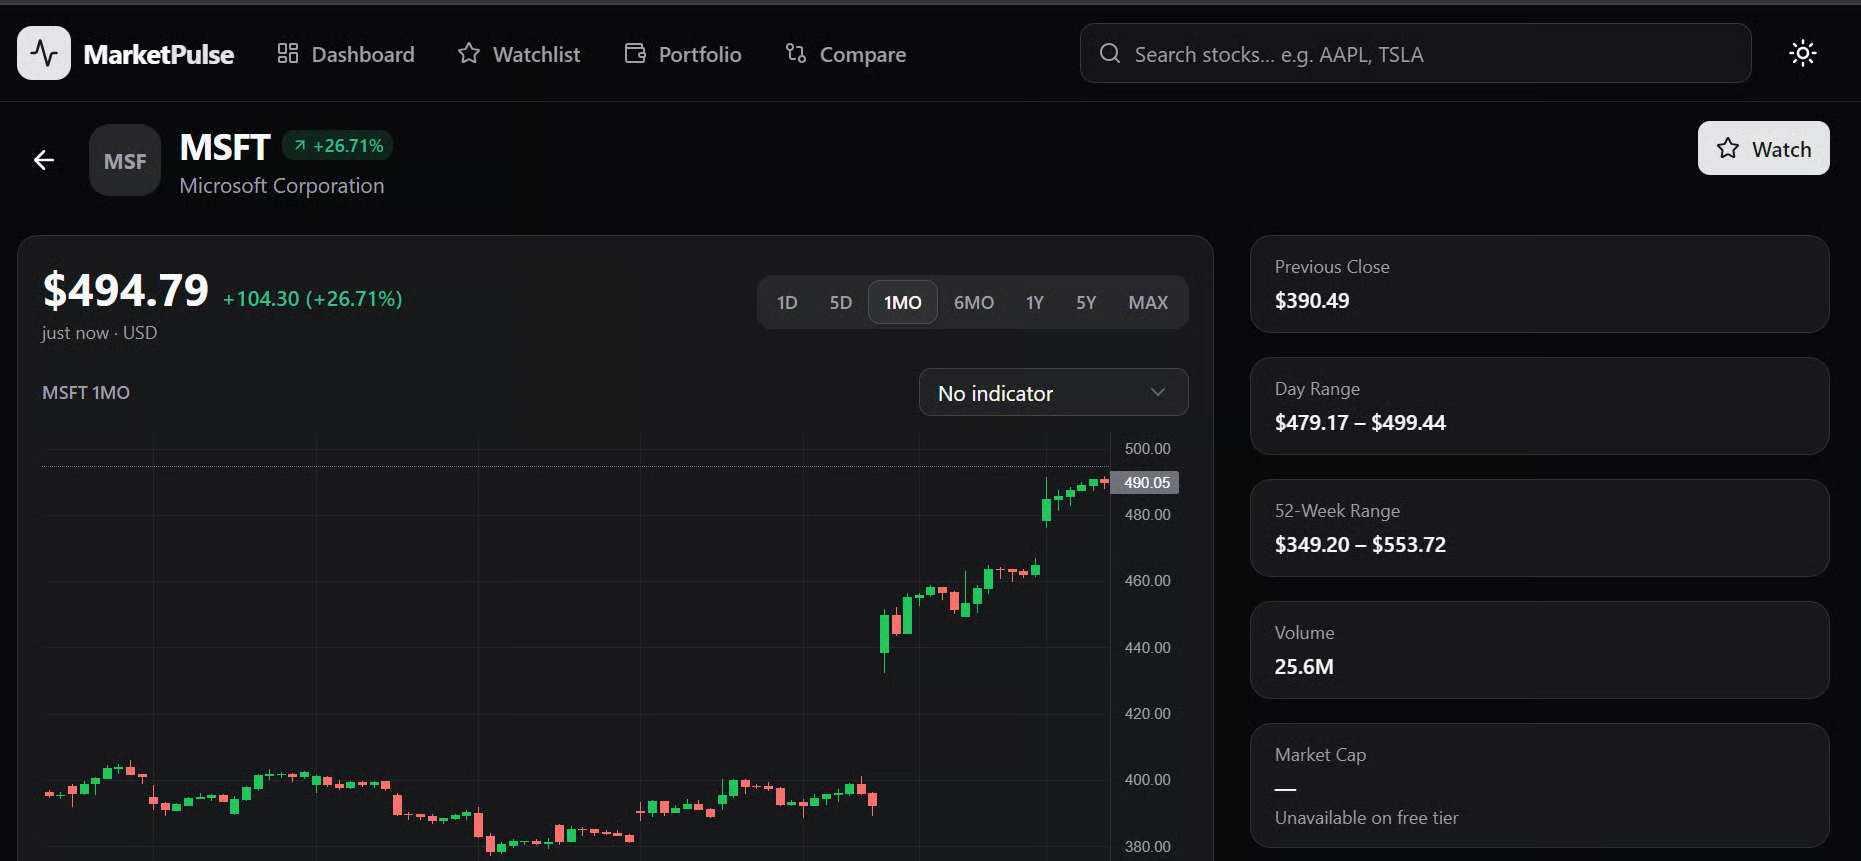
Je kunt afzonderlijke tickers selecteren om candlestick-grafieken, historische prestaties, indicatoren en extra bedrijfsinformatie te bekijken.
Het tabblad Compare laat je ook meerdere aandelen vergelijken en zien welke beter presteerden over de geselecteerde periode.
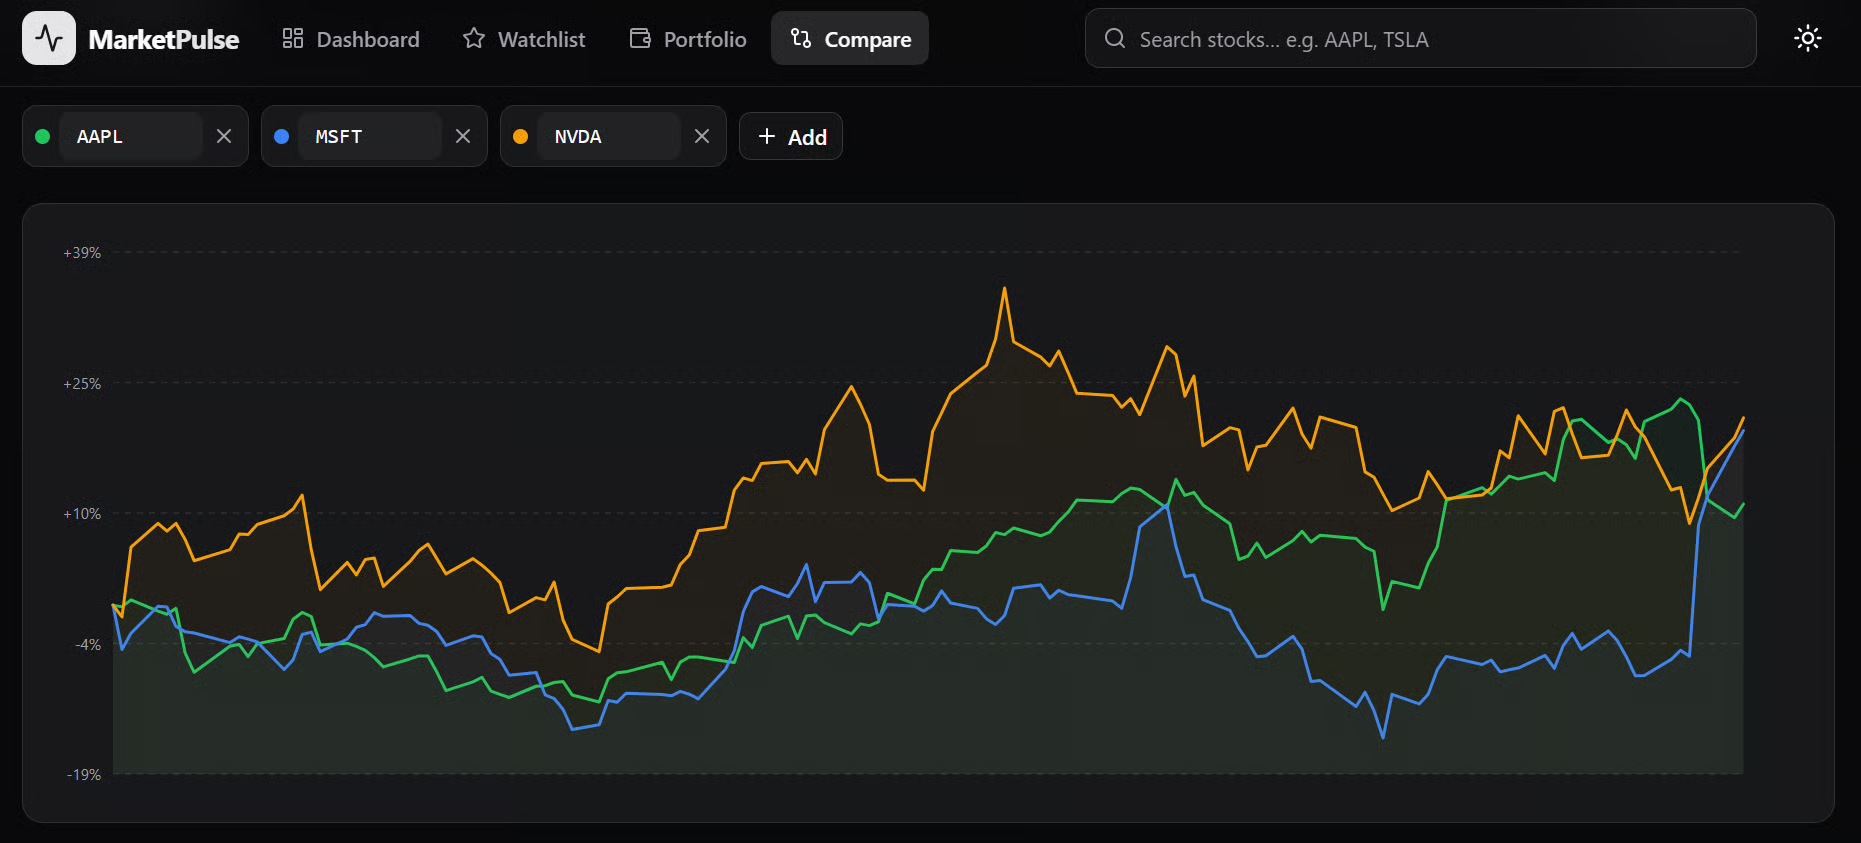
Ik was oprecht verrast dat een kleiner lokaal model de hele website kon bouwen vanuit één prompt.
Na het testen van de applicatie werkte elke belangrijke feature zoals bedoeld, inclusief live aandelenkoersen, historische marktdata, grafieken, indicatoren en vergelijkingstools.
Het is opmerkelijk hoe snel lokale modellen verbeteren en hoe capabel ze zijn geworden in het voltooien van complexe end-to-end ontwikkeltaken.
Voor mij is DeepSeek-V4-Flash-0731 het beste lokale model dat ik tot nu toe heb getest.
Het presteerde beter dan Inkling, de 2-bit GLM-5.2-kwantisatie en Qwen3.6-27B, die eerder mijn favoriet was. Dit is gebaseerd op mijn eigen ervaring en niet op een formele benchmark, maar het is nu mijn voorkeursmodel voor lokaal gebruik.
Voor de meeste praktische workloads zou ik nog steeds beginnen met de officiële DeepSeek API omdat die extreem betaalbaar is.
V4 Flash kost momenteel $0,14 per miljoen niet-gecachte inputtokens, $0,0028 per miljoen gecachte inputtokens en $0,28 per miljoen outputtokens. Tegen dat tarief kosten één miljard gecachte inputtokens ongeveer $2,80, exclusief outputkosten.
Voordat ik voor Unsloth Studio koos, probeerde ik het model te draaien via llama.cpp. De kant-en-klare installer bood geen geschikte recente CUDA-binary voor mijn omgeving, en hoewel ik de nieuwste versie uit broncode compileerde, liep ik verdere problemen tegen het lijf bij het inschakelen van DSpark speculative decoding.
Unsloth Studio bood uiteindelijk de eenvoudigste setup en haalde het meeste handmatige configuratiewerk weg. Het werkte goed met OpenCode, al duurde het bouwen van de complete applicatie ongeveer 20 minuten.
Topcursussen bij DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min