Curso
Codificação com IA para Desenvolvedores
1 h 30 min
9.9K
Menor e mais rápido não significa, automaticamente, menos capaz. Segundo as avaliações publicadas pela DeepSeek, DeepSeek-V4-Flash-0731 usa uma fração muito menor de parâmetros ativados do que o DeepSeek-V4-Pro e ainda assim entrega desempenho agentic próximo ao estado da arte: obteve 82,7 no Terminal Bench 2.1, contra 81,0 do GLM-5.2 e 85,0 do Opus 4.8. Já no Agents’ Last Exam, marcou 25,2, muito próximo dos 25,7 do Opus 4.8.
Como os pesos estão disponíveis abertamente, teoricamente você pode executar o modelo no seu próprio hardware, desde que tenha RAM ou VRAM combinada suficiente, mantendo a inferência e os dados do projeto sob seu controle.
Neste guia, vamos configurar um ambiente RunPod com três GPUs, instalar e iniciar o Unsloth Studio, baixar e carregar a versão Q8 do DeepSeek-V4-Flash-0731 distribuída entre as GPUs, testar o modelo pelo Studio, conectar o servidor local de inferência ao OpenCode e usar o agente de código para criar e publicar um site interativo de análise de ações.
DeepSeek-V4-Flash-0731 é a versão oficial que substitui o preview anterior, com avanços significativos em programação, uso de ferramentas e tarefas autônomas de agentes. Sua arquitetura Mixture-of-Experts ativa apenas parte do modelo a cada token. Assim, ele se mantém mais eficiente sem abrir mão do desempenho.
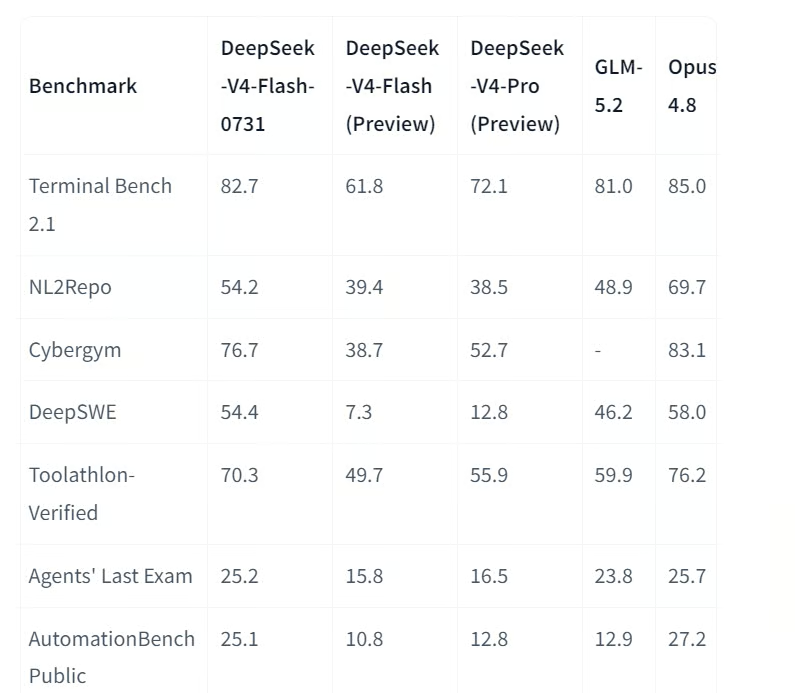
Fonte: deepseek-ai/DeepSeek-V4-Flash-0731 · Hugging Face
A DeepSeek relata que o modelo evoluiu de 61,8 para 82,7 no Terminal Bench 2.1 e de 7,3 para 54,4 no DeepSWE. Ele também superou o maior DeepSeek-V4-Pro Preview em vários benchmarks de agentes.
O modelo suporta janelas de contexto de até um milhão de tokens. Isso o torna ideal para grandes bases de código, documentos extensos e fluxos de trabalho complexos que exigem muito contexto. Você também pode escolher entre esforço de raciocínio baixo, alto e máximo, dependendo do tempo que o modelo deve dedicar para resolver uma tarefa.
O DeepSeek-V4-Flash-0731 inclui ainda o DSpark para decodificação especulativa. O DSpark rascunha vários tokens antes de o modelo principal verificá-los, o que, segundo a DeepSeek, pode acelerar a geração em 60% a 85% quando usado com um mecanismo de inferência compatível.
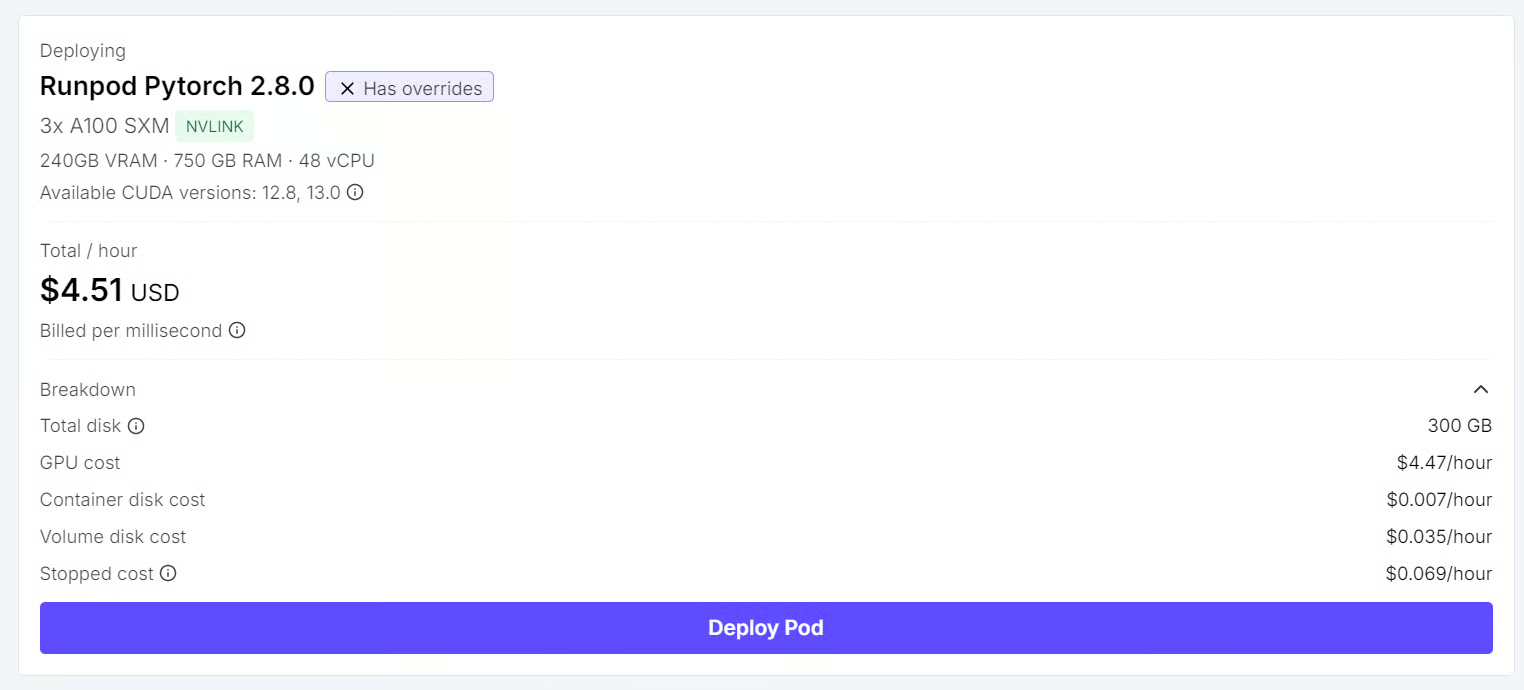
Vamos começar criando um ambiente no RunPod com memória de GPU e armazenamento suficientes para rodar a versão Q8 do DeepSeek-V4-Flash-0731 e hospedar o Unsloth Studio e o site gerado pelo OpenCode.
Configure o Pod com:
/workspace como caminho de montagem do volume persistenteHF_TOKEN8910 e 9101 expostas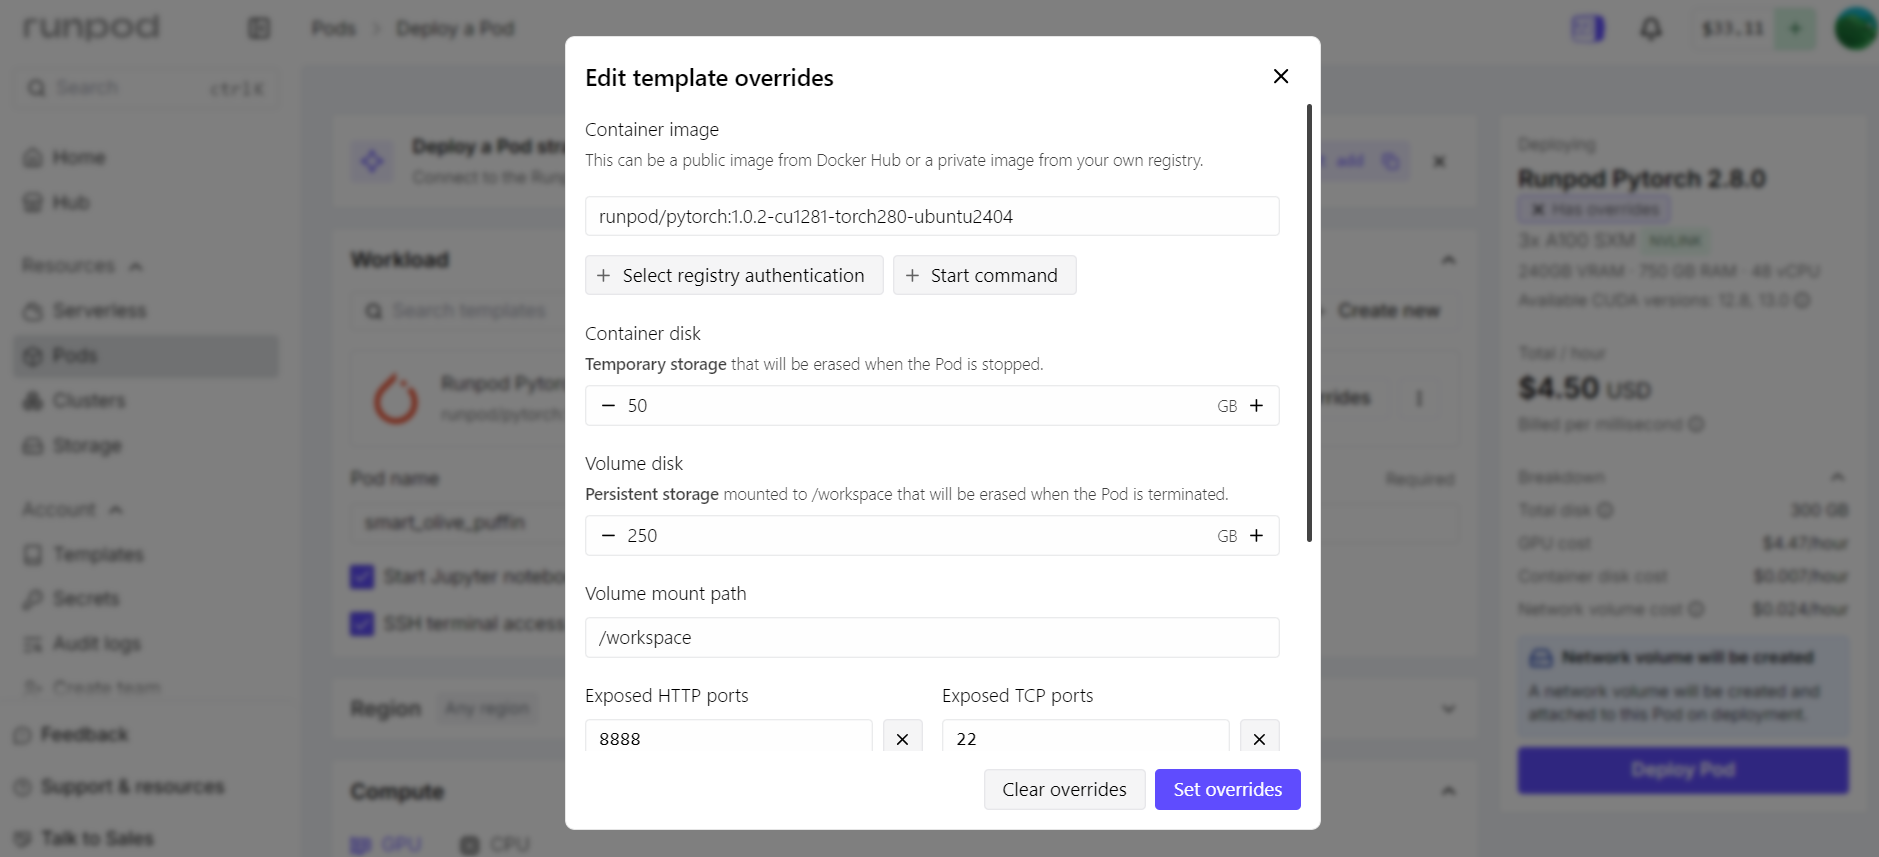
A porta 8910 será usada pelo Unsloth Studio e sua API local de inferência. A porta 9101 hospedará o site interativo criado pelo OpenCode.
O RunPod expõe esses serviços por meio de seu proxy HTTP, então ambos os aplicativos devem escutar em 0.0.0.0 em vez de apenas 127.0.0.1.
Depois de fazer o deploy do Pod, abra a aba Connect, inicie o JupyterLab e crie três sessões de terminal:
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
Manter as tarefas em terminais separados facilita monitorar as GPUs, depurar o modelo e rodar o agente de código ao mesmo tempo.
Em seguida, vamos instalar o Unsloth Studio, configurar um cache persistente do Hugging Face e iniciar a interface na porta 8910.
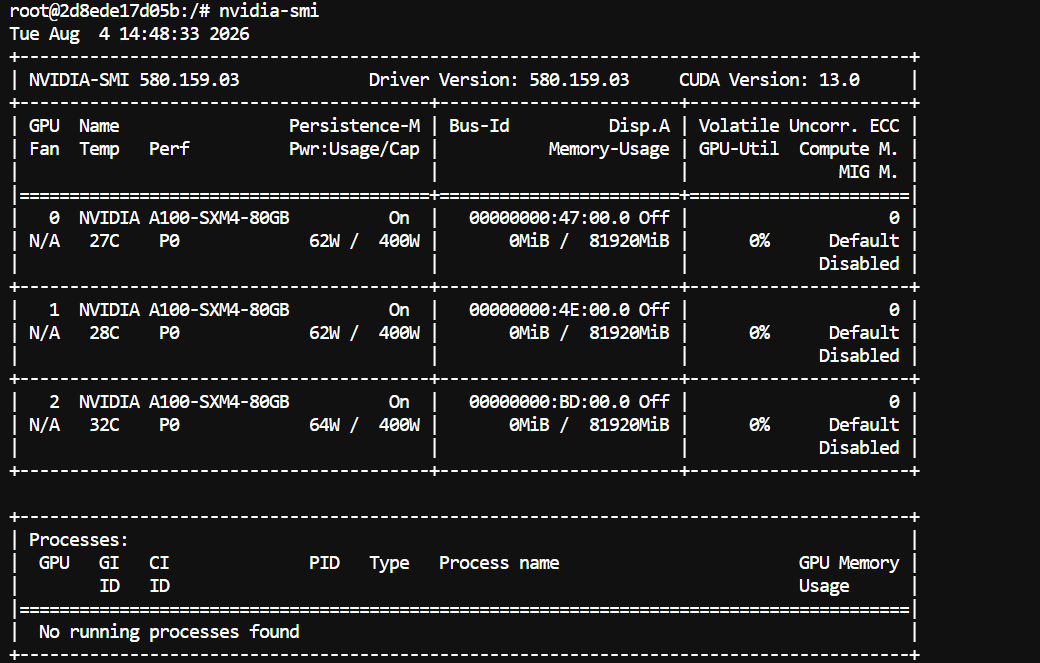
No Terminal 1, confirme que as três GPUs estão disponíveis:
nvidia-smiVocê deve ver as três GPUs A100 listadas no servidor Linux.
Crie um cache persistente do Hugging Face em /workspace para que os modelos baixados permaneçam disponíveis no volume do RunPod:
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
Agora, instale os pacotes de sistema necessários e o Unsloth Studio:
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh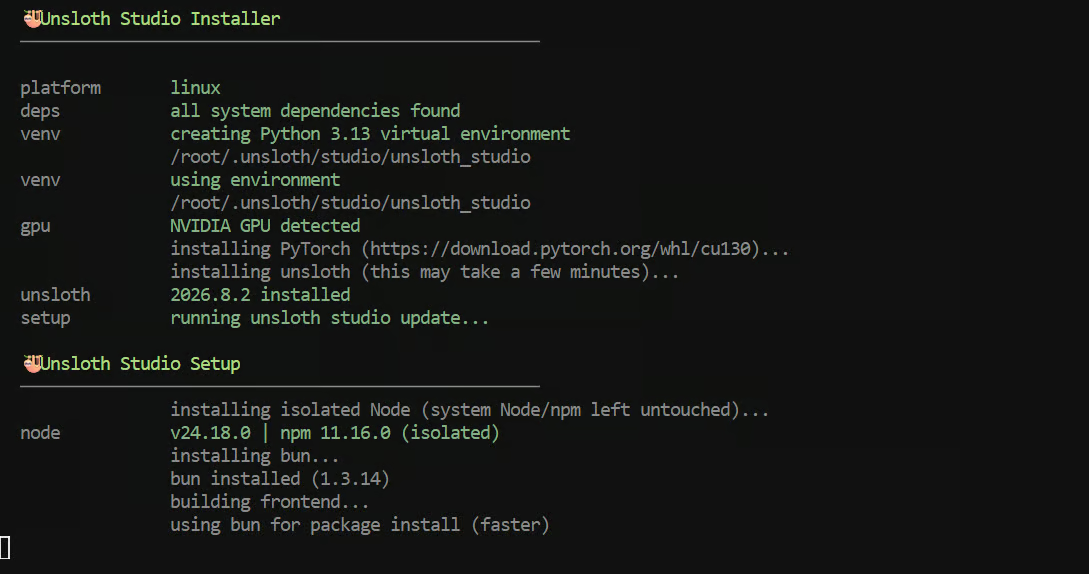
O instalador configura a interface do Studio, o ambiente Python, as dependências e os componentes de inferência local.
A primeira instalação pode levar alguns minutos.
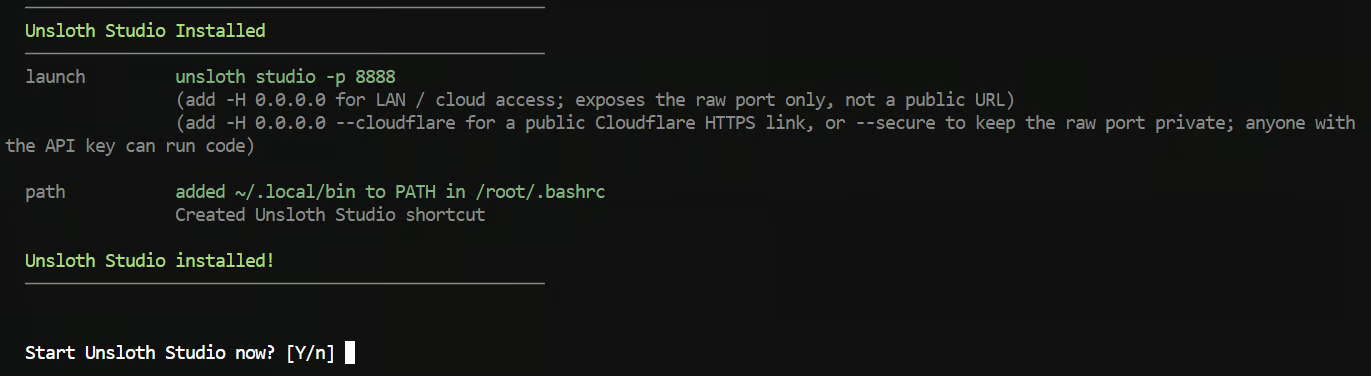
Quando o instalador perguntar se você deseja iniciar o Unsloth Studio agora, digite “n”.
Vamos iniciá-lo manualmente para usar a porta 8910 e escutar no endereço de rede correto.
Reinicie o shell para que os novos comandos fiquem disponíveis:
exec bash
cd /workspace
Antes de iniciar o Studio, redefina a senha padrão:
unsloth studio reset-passwordCopie a senha temporária exibida durante a configuração, pois você pode precisar dela para concluir a redefinição.
Agora inicie o Unsloth Studio:
unsloth studio \
  -H 0.0.0.0 \
  -p 8910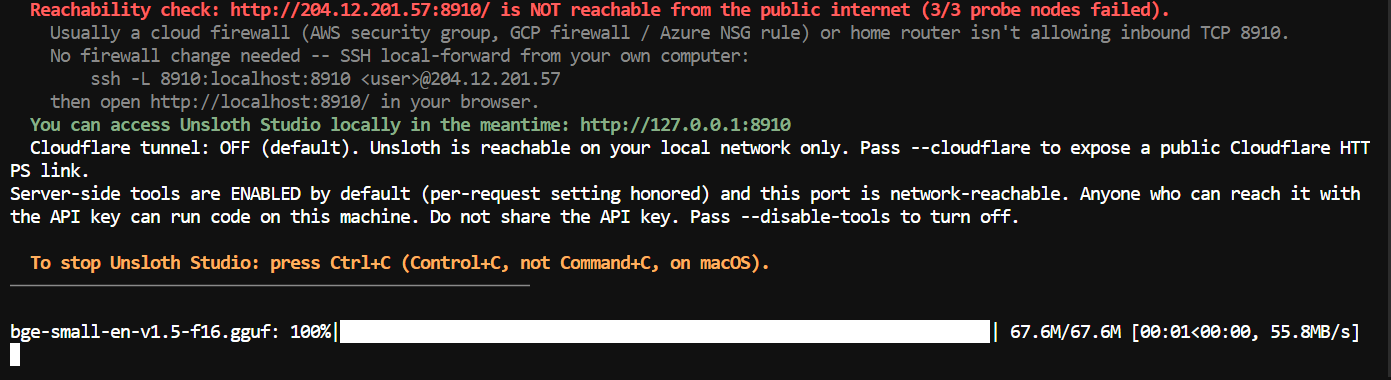
O Studio deve indicar que está rodando na porta 8910. Mantenha o Terminal 1 aberto enquanto usar o Unsloth Studio e o OpenCode.
Volte à página Connect do RunPod e abra o HTTP Service da porta 8910.
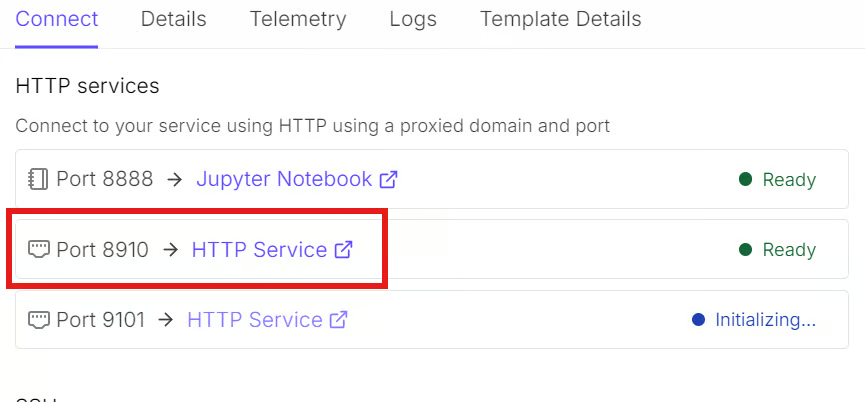
Use a senha temporária gerada anteriormente para concluir a redefinição e, em seguida, entre com a nova senha criada.
Conclua ou pule o onboarding e abra a página de Chat.
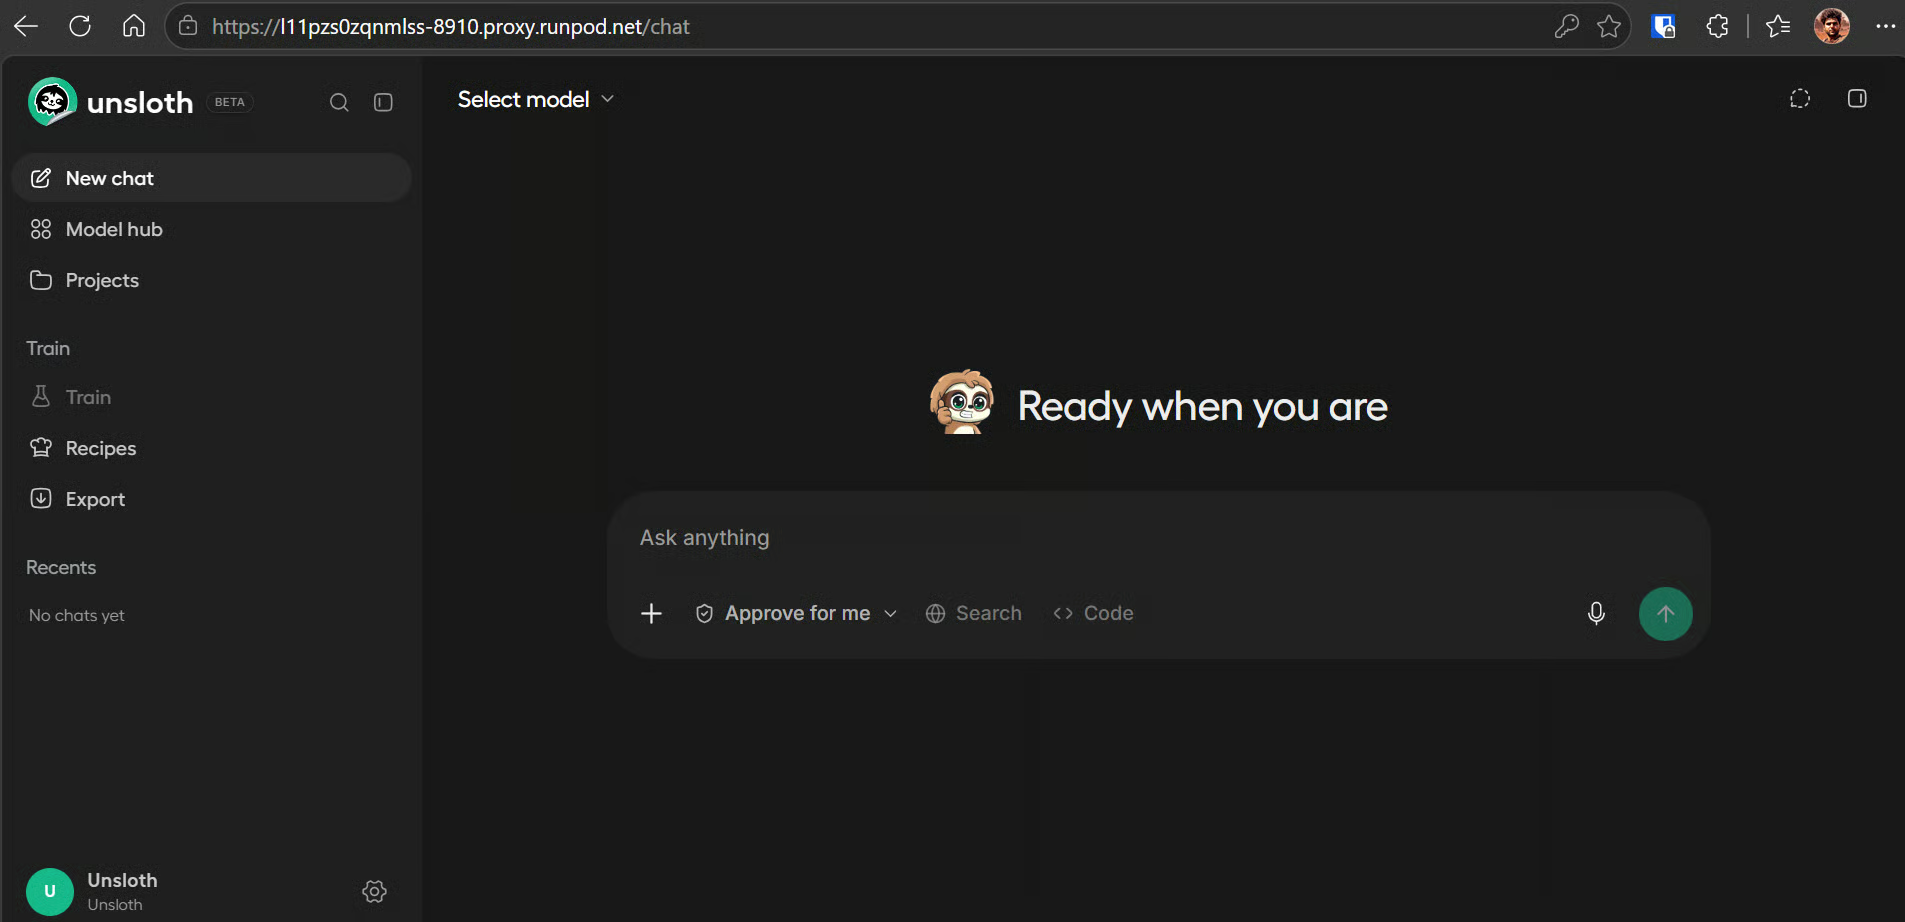
Com o Unsloth Studio em execução, podemos baixar o modelo Q8, distribuí-lo entre as três GPUs e testar suas capacidades de chat e de uso de ferramentas.
Abra o seletor de modelos no canto superior esquerdo, pesquise por unsloth/DeepSeek-V4-Flash-0731-GGUF e selecione a quantização Q8 UD-Q8_K_XL.
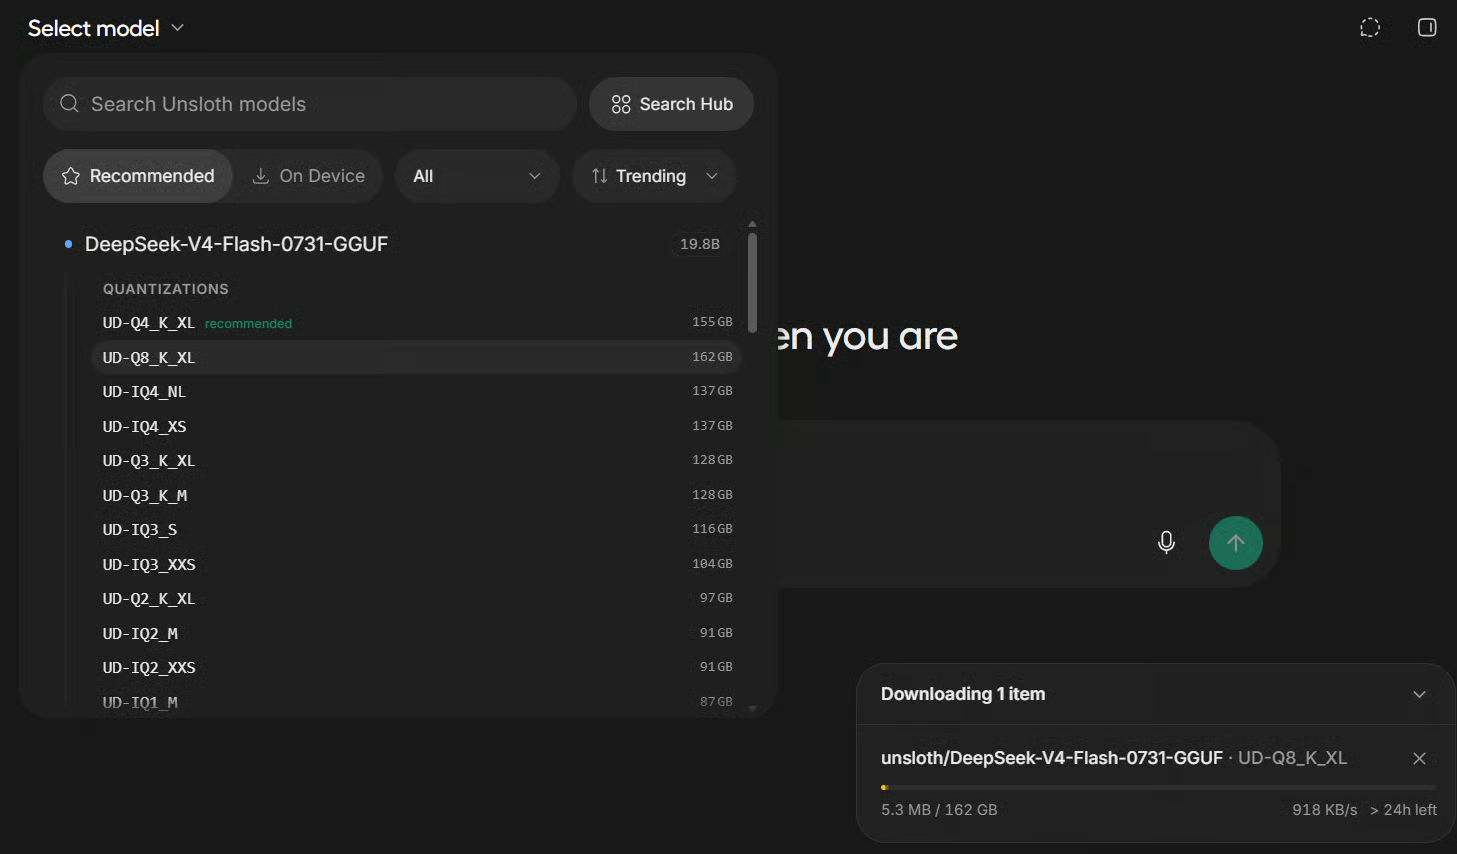
Usamos Q8 porque as três GPUs A100 oferecem VRAM combinada suficiente. Ela preserva qualidade mais próxima do modelo original, enquanto quantizações menores são mais úteis quando a memória disponível é limitada.
Após o download, o Unsloth Studio começará automaticamente a carregar o modelo na memória da GPU. Isso pode levar alguns minutos, pois o modelo Q8 é bem grande.
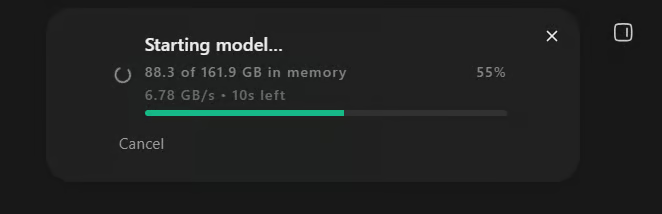
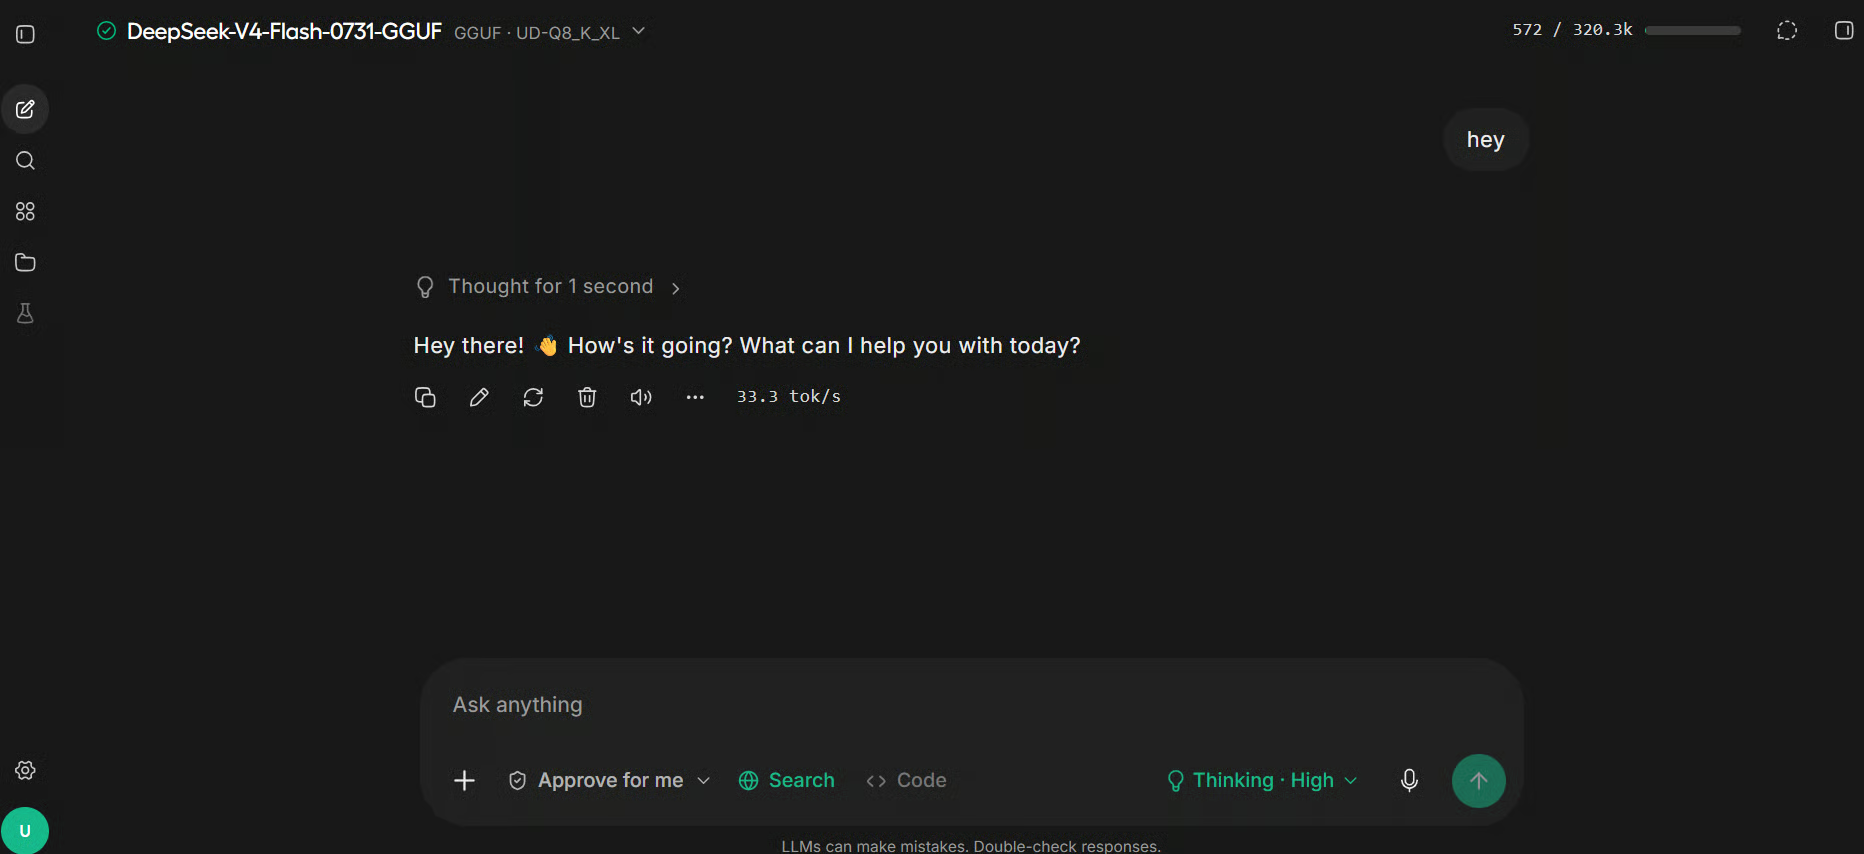
Depois de carregar, use a página Chat para testar o modelo com alguns prompts simples.
Nos nossos testes, a geração chegou a aproximadamente 33 tokens por segundo sem decodificação especulativa, um resultado bem razoável para um modelo desse porte.
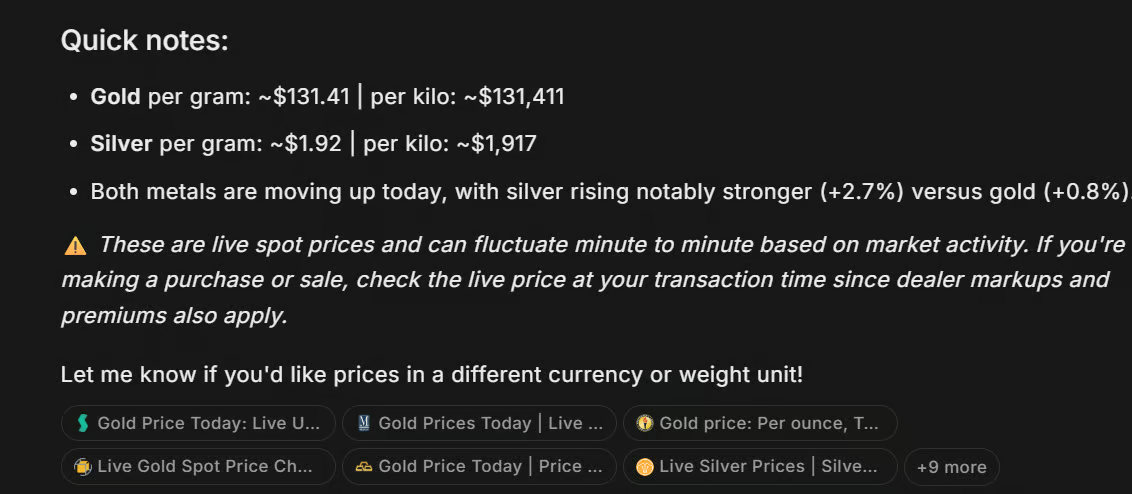
Você também pode ativar a ferramenta de busca na web do Studio e pedir para o modelo consultar informações atuais, como os preços mais recentes de ouro e prata. É uma forma prática de confirmar que o modelo consegue chamar ferramentas externas e não depende apenas do conhecimento interno.
No Terminal 2, verifique como o modelo está distribuído entre as GPUs:
nvidia-smi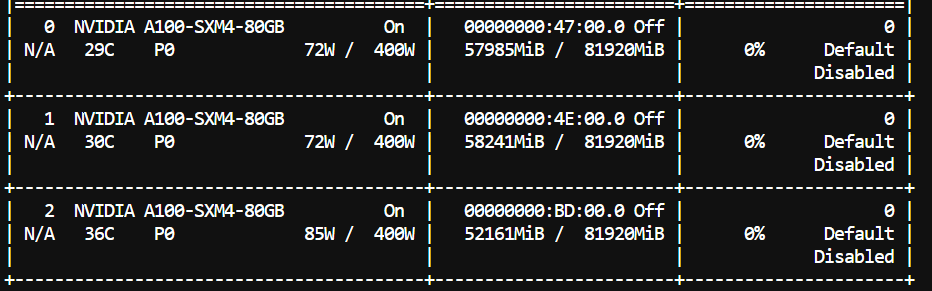
Você deverá ver um uso significativo de memória nas três GPUs.
No nosso teste, cada GPU ficou com cerca de 70% de ocupação. Porém, isso não significa necessariamente que o modelo Q8 completo caiba confortavelmente em apenas duas GPUs de 80 GB, pois ainda é preciso VRAM adicional para a janela de contexto, o cache KV e buffers de inferência.
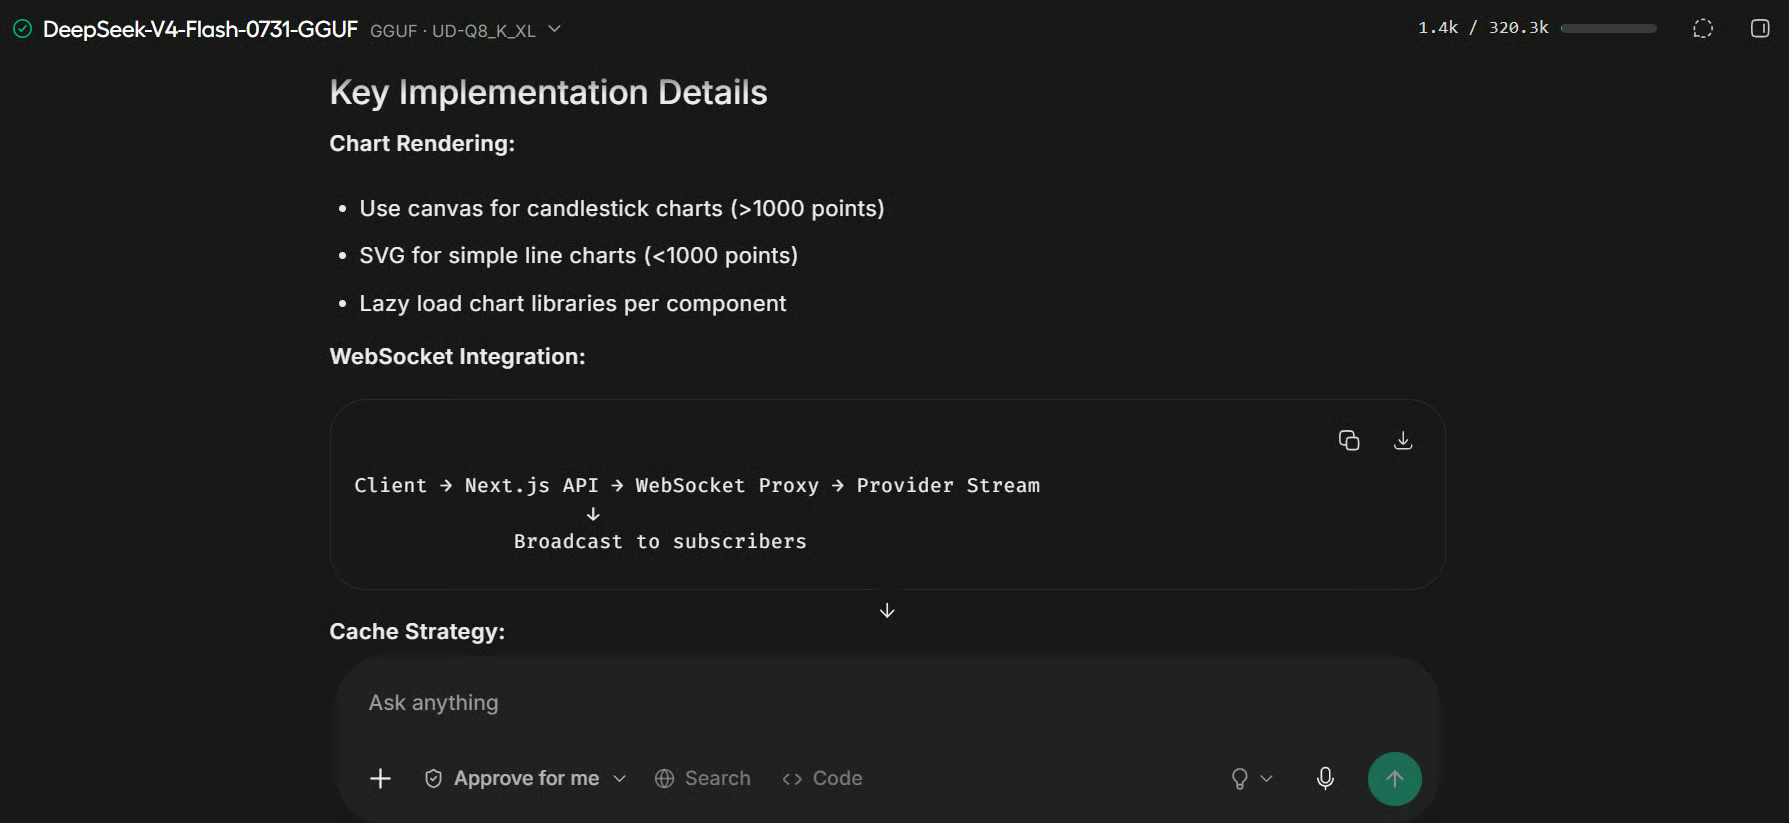
Por fim, teste o modelo com o prompt de planejamento do aplicativo que vamos construir:
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
O modelo retorna um plano de desenvolvimento estruturado cobrindo arquitetura da aplicação, componentes, fluxo de dados, bibliotecas de gráficos, cálculos financeiros e design da interface.
Com o modelo rodando no Unsloth Studio, podemos conectá-lo ao OpenCode e usá-lo como um agente local de programação.
No Terminal 3, defina a URL do Studio:
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
Crie um novo diretório de projeto:
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
Inicie o OpenCode pelo Unsloth Studio:
unsloth start opencodeNa primeira execução, o comando vai pedir permissão para instalar o OpenCode. Digite “y”.
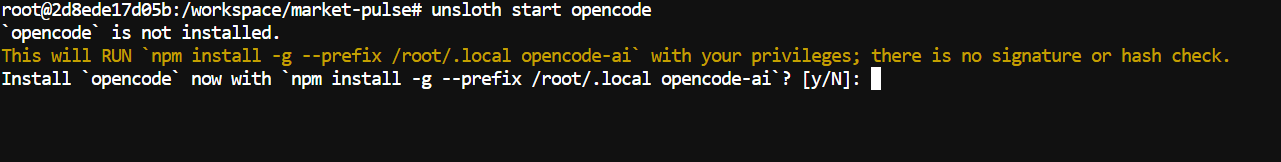
Assim que a instalação terminar, o OpenCode será iniciado já configurado com o modelo DeepSeek-V4-Flash-0731 rodando localmente.
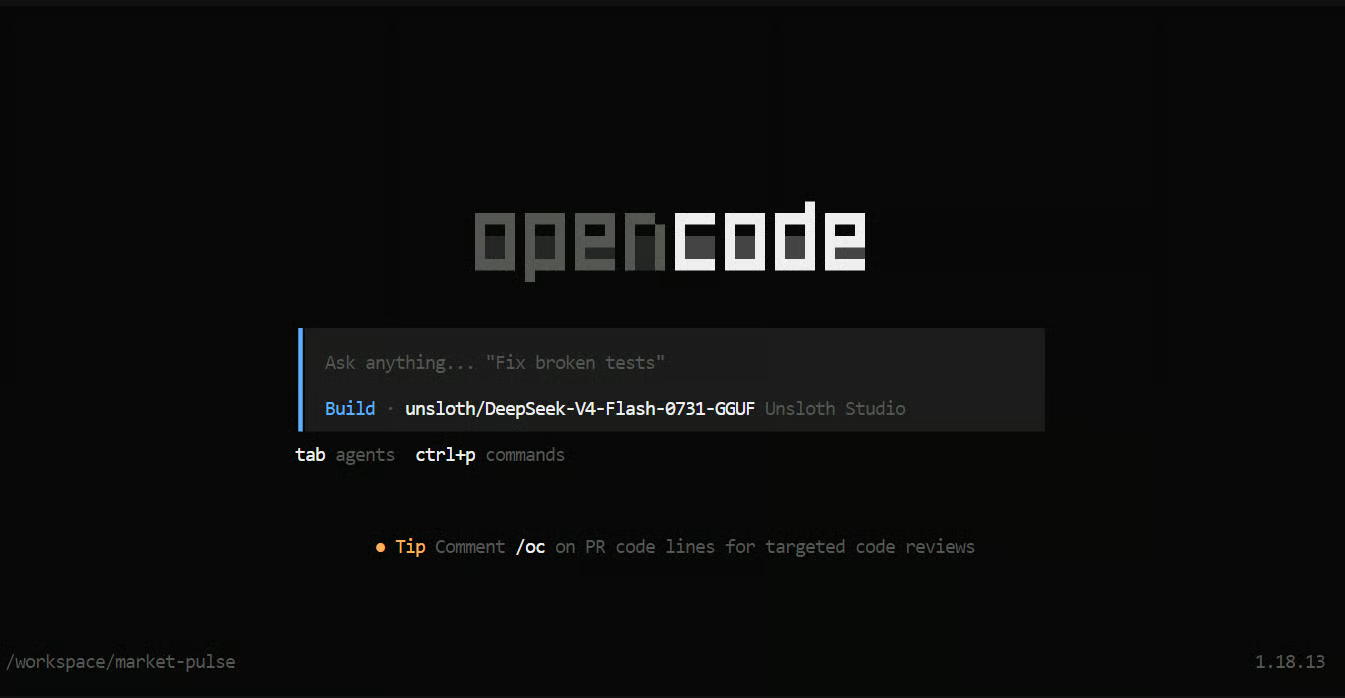
Cole o prompt de duas linhas abaixo no OpenCode:
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
Em poucos segundos, o agente de código deve criar uma lista detalhada de tarefas e começar a conduzir o projeto passo a passo.
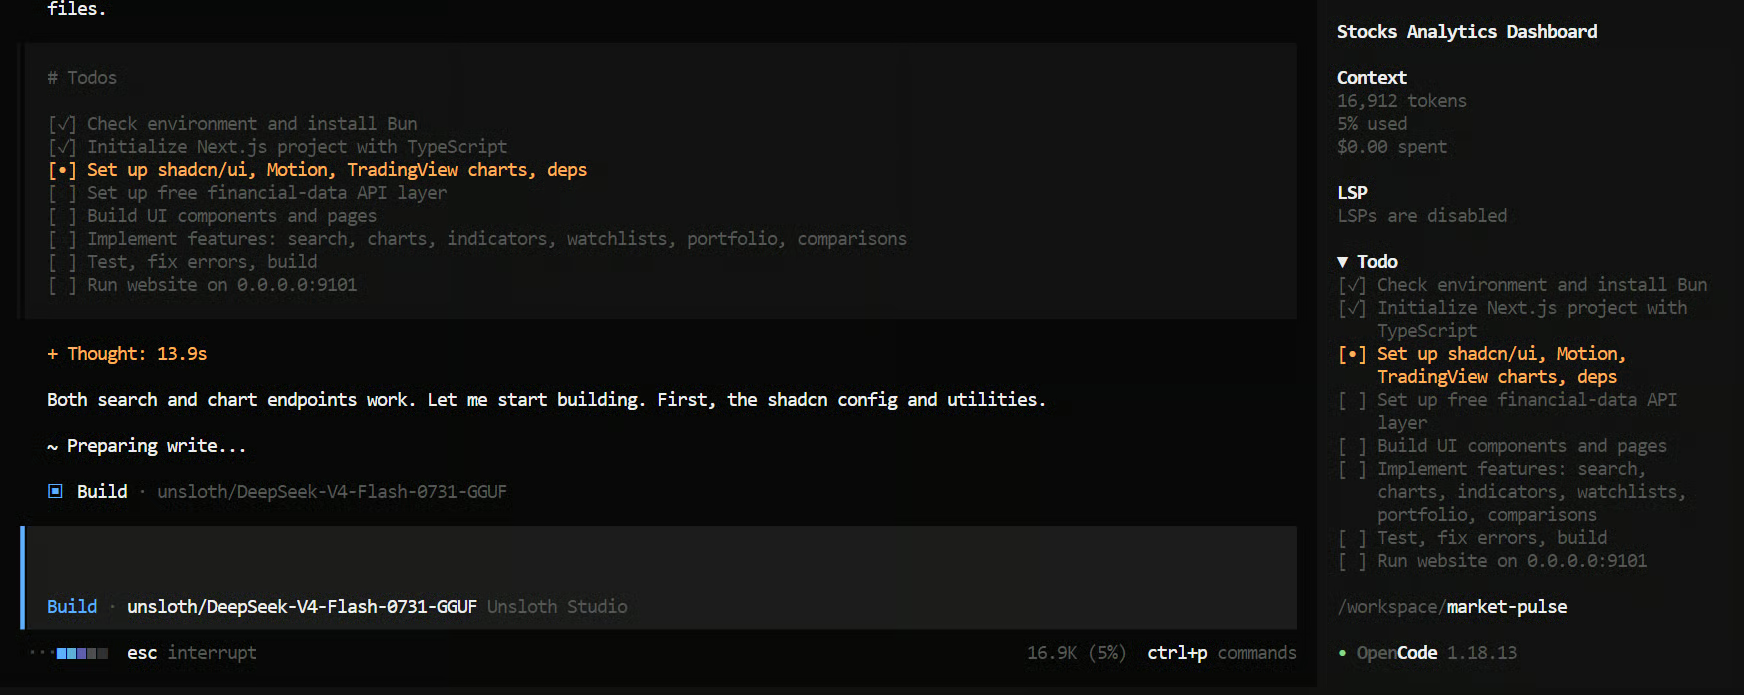
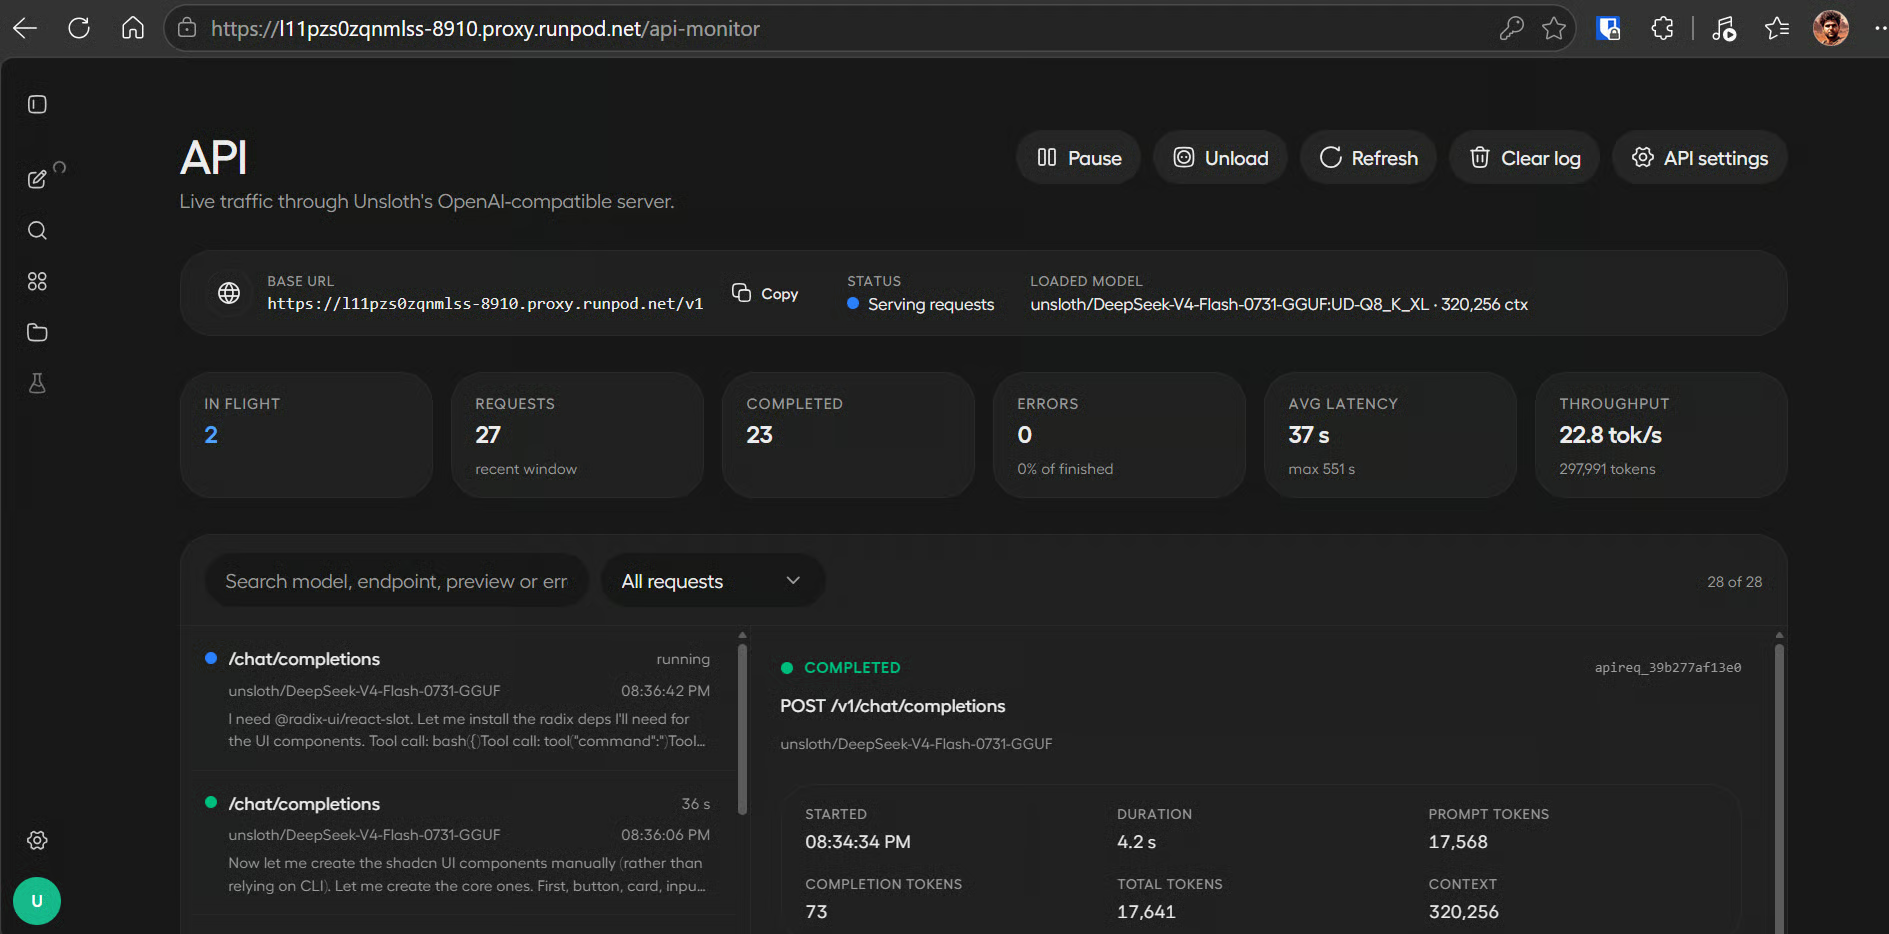
No nosso teste, a construção completa levou cerca de 20 minutos. Enquanto roda, você pode voltar ao Unsloth Studio e abrir a página de monitoramento da API em Settings para acompanhar o uso do modelo e a velocidade de geração.
Observamos uma média de aproximadamente 22,6 tokens por segundo durante o fluxo de programação. A velocidade pode cair conforme a conversa e o contexto do projeto crescem.
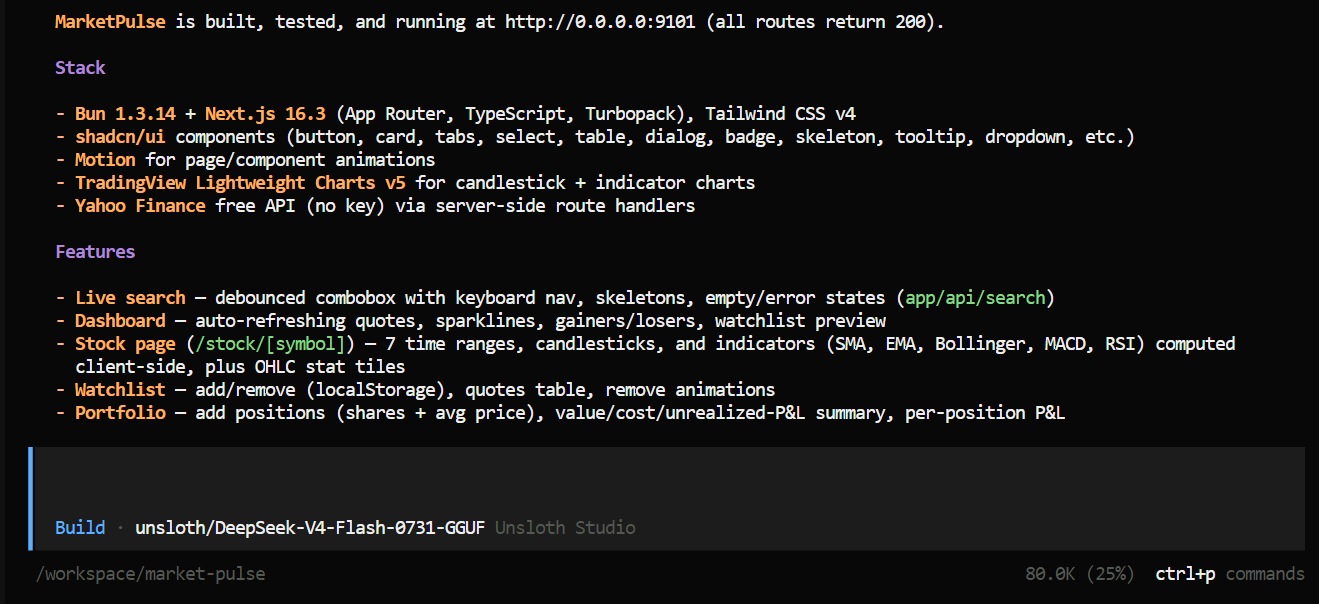
Ao finalizar as tarefas, o OpenCode deve trazer um resumo dos arquivos, recursos e comandos criados. Ele também deve iniciar o site finalizado na porta 9101.
Volte à página Connect do RunPod e abra o HTTP Service da porta 9101.
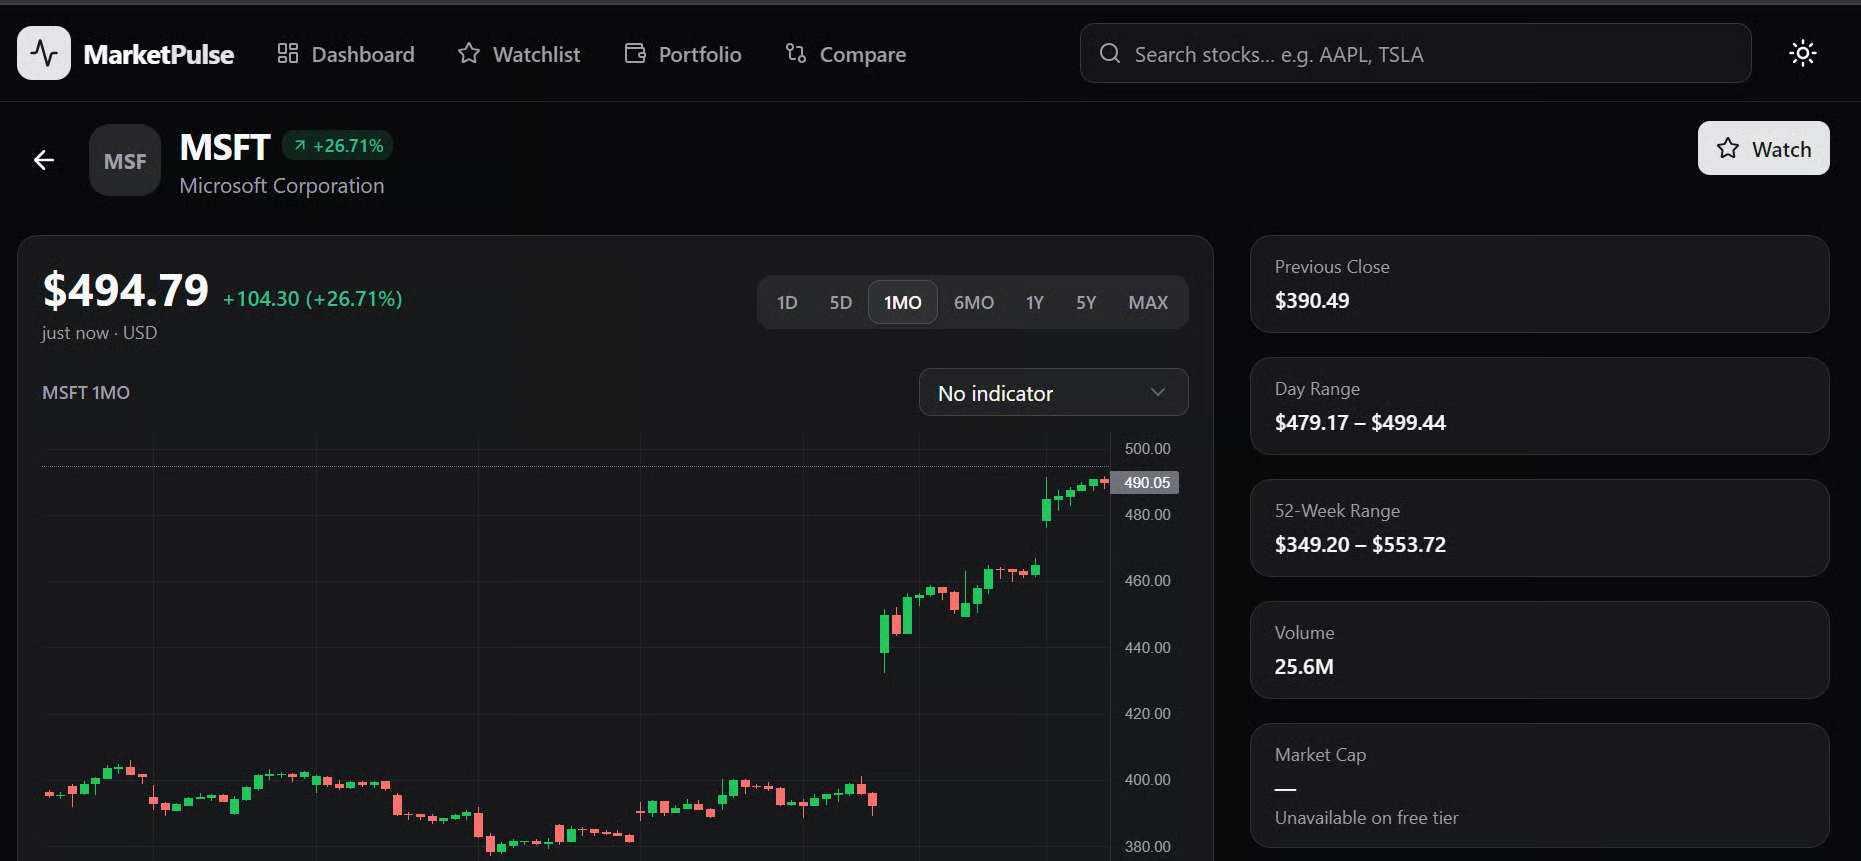
O resultado ficou surpreendentemente caprichado. O site ficou limpo, com animações e bem próximo de um dashboard profissional de trading. O modelo concluiu a aplicação web com um único prompt, incluindo interface, visões de dados, gráficos e navegação.
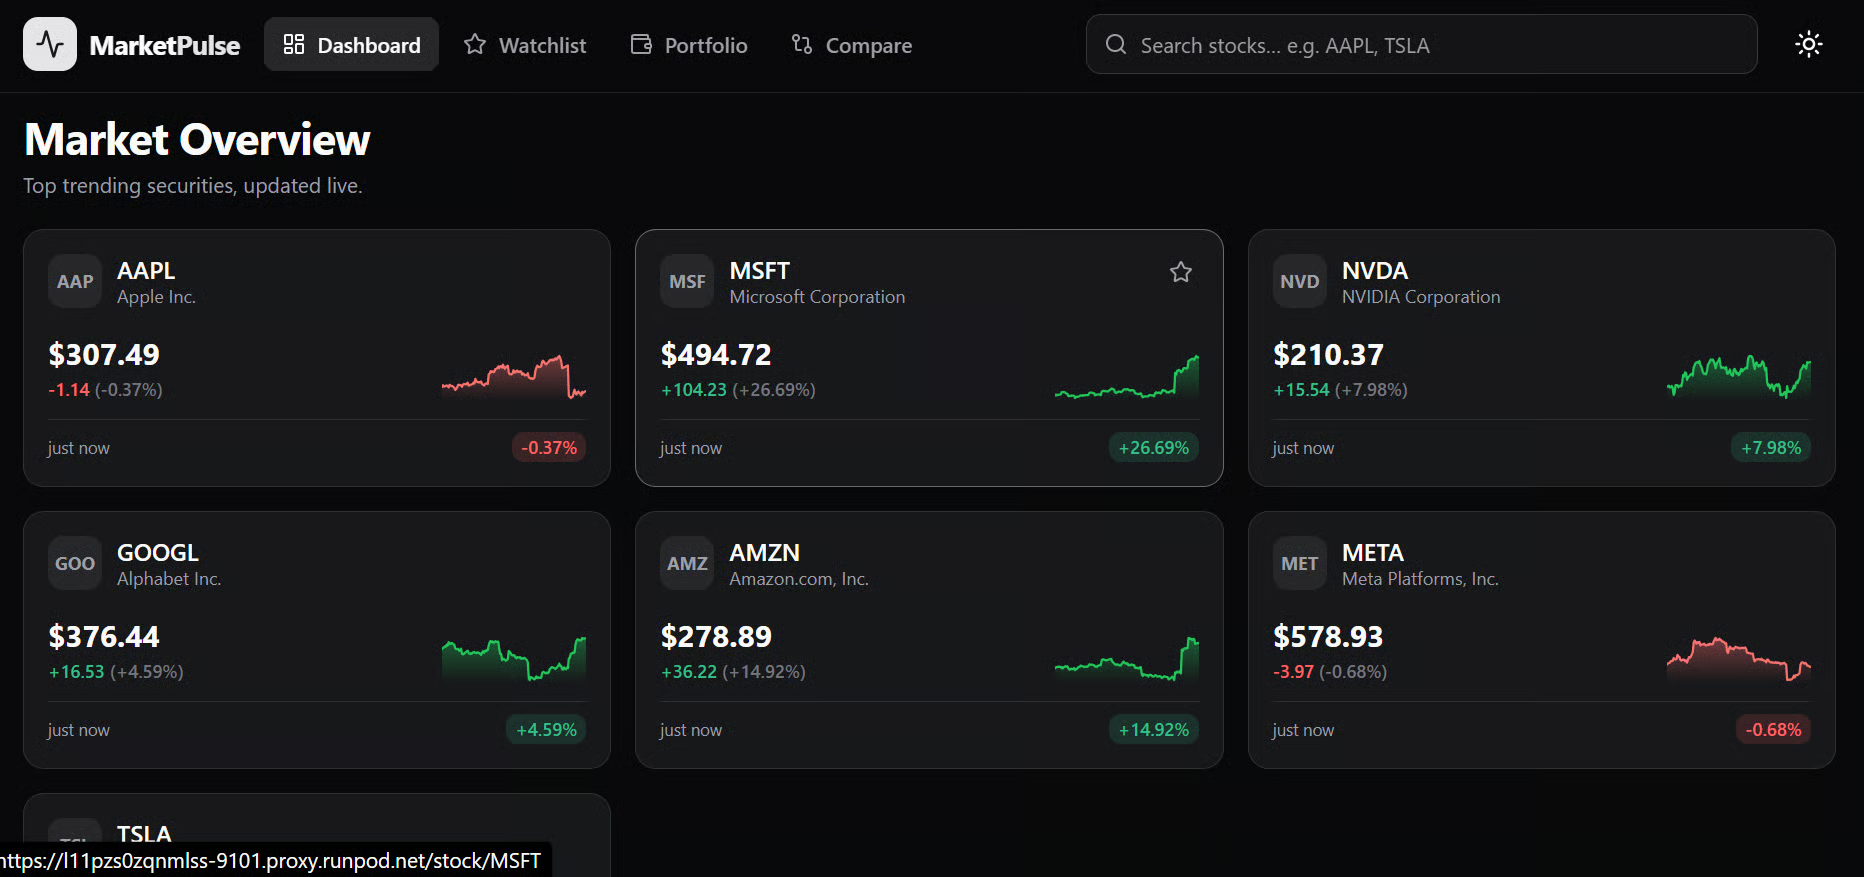
Você pode selecionar tickers individuais para ver gráficos de candles, desempenho histórico, indicadores e mais informações da empresa.
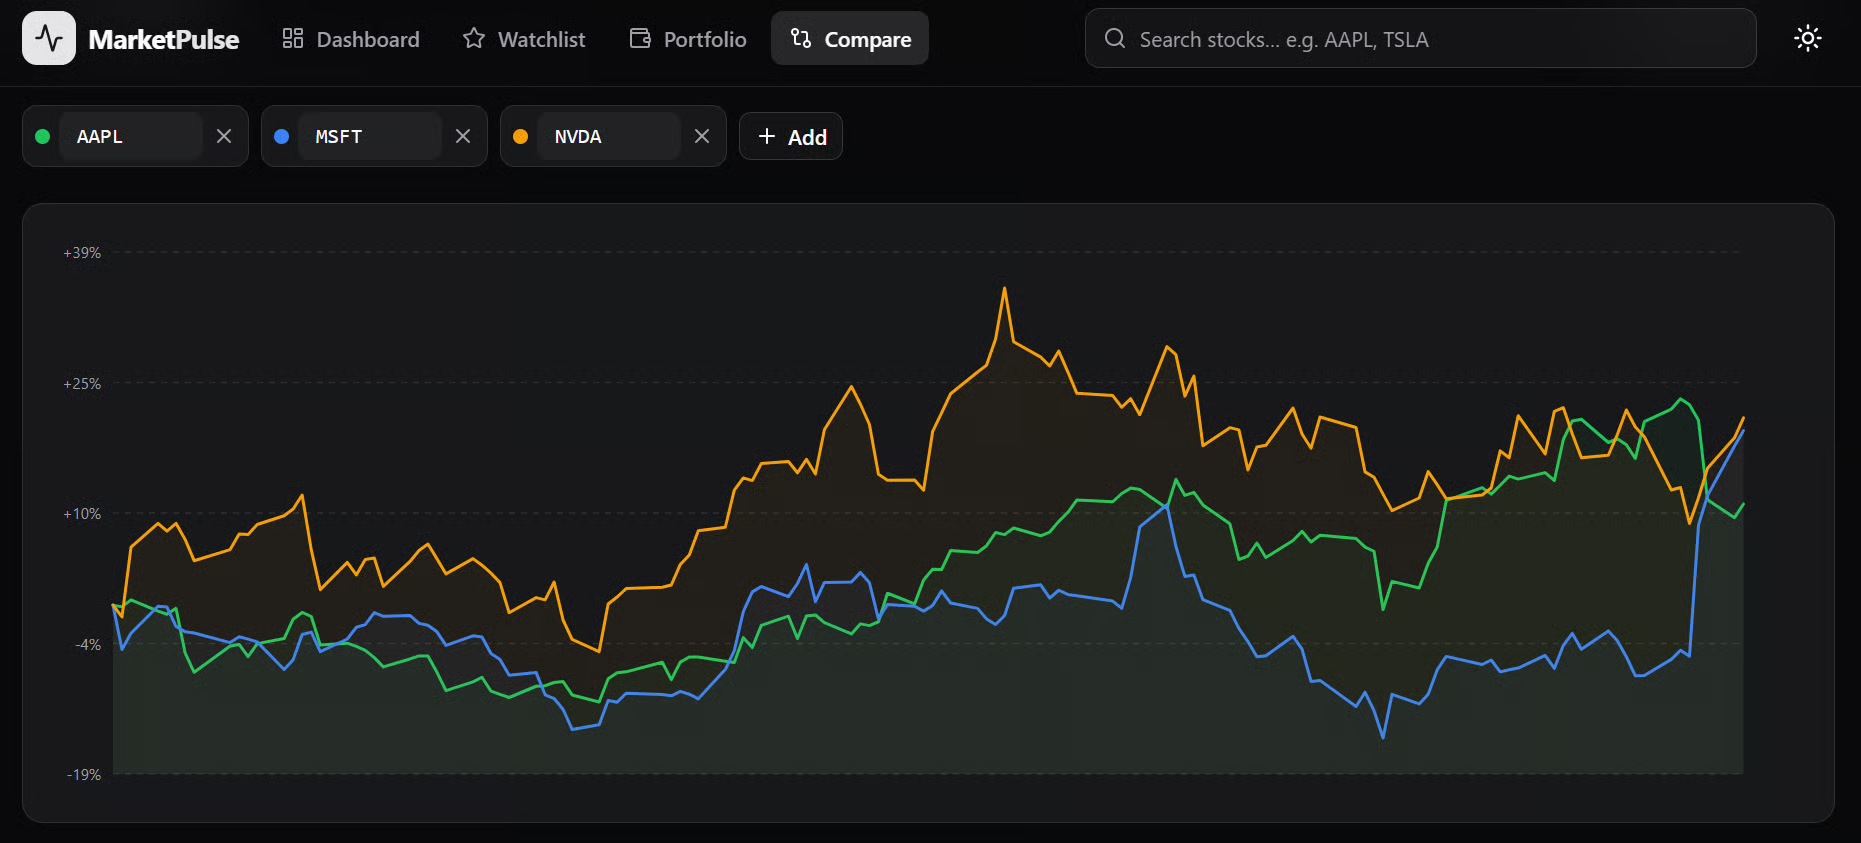
A aba Compare também permite comparar várias ações e ver qual teve melhor desempenho no período selecionado.
Fiquei genuinamente surpreso que um modelo local menor conseguiu construir o site inteiro a partir de um único prompt.
Após testar a aplicação, todos os recursos principais funcionaram como esperado, incluindo preços em tempo real, dados históricos de mercado, gráficos, indicadores e ferramentas de comparação.
Impressiona a velocidade com que os modelos locais estão evoluindo e como já são capazes de concluir tarefas complexas de desenvolvimento ponta a ponta.
Para mim, o DeepSeek-V4-Flash-0731 é o melhor modelo local que testei até agora.
Ele foi melhor do que o Inkling, a quantização 2-bit do GLM-5.2 e o Qwen3.6-27B, que antes era o meu favorito. Isso se baseia na minha experiência prática, não em um benchmark formal, mas agora é o meu modelo local preferido.
Para a maioria das cargas de trabalho do dia a dia, eu ainda começaria pela API oficial da DeepSeek, que é extremamente acessível.
Atualmente, a V4 Flash custa US$ 0,14 por milhão de tokens de entrada não armazenados em cache, US$ 0,0028 por milhão de tokens de entrada em cache e US$ 0,28 por milhão de tokens de saída. Nessa taxa, um bilhão de tokens de entrada em cache sairia por cerca de US$ 2,80, sem contar a saída.
Antes de optar pelo Unsloth Studio, tentei rodar o modelo via llama.cpp. O instalador pré-compilado não oferecia um binário CUDA recente adequado para meu ambiente e, embora eu tenha compilado a versão mais nova a partir do código-fonte, enfrentei novos problemas ao ativar o DSpark para decodificação especulativa.
No fim, o Unsloth Studio ofereceu a configuração mais simples e eliminou boa parte dos ajustes manuais. Funcionou muito bem com o OpenCode, embora a construção completa da aplicação tenha levado cerca de 20 minutos.
Principais cursos da DataCamp
Curso
Curso
Programa
blog
Abid Ali Awan
9 min
blog
Richie Cotton
7 min
blog
Dr Ana Rojo-Echeburúa
9 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Moez Ali
11 min