Cours
Coder avec l’aide de l’IA pour les développeurs
1 h 30 min
9.9K
Plus petit et plus rapide ne rime plus automatiquement avec moins performant. D’après les évaluations publiées par DeepSeek, DeepSeek-V4-Flash-0731 utilise bien moins de paramètres activés que DeepSeek-V4-Pro tout en offrant des performances agentiques proches de l’état de l’art : il obtient 82,7 sur Terminal Bench 2.1, contre 81,0 pour GLM-5.2 et 85,0 pour Opus 4.8. Son score à Agents’ Last Exam de 25,2 est proche des 25,7 d’Opus 4.8.
Comme les poids sont disponibles ouvertement, vous pouvez en théorie exécuter le modèle sur votre propre matériel si vous disposez de suffisamment de RAM ou de VRAM combinée, en gardant l’inférence et les données de vos projets sous votre contrôle.
Dans ce guide, nous allons configurer un environnement RunPod à trois GPU, installer et lancer Unsloth Studio, télécharger et charger la version Q8 de DeepSeek-V4-Flash-0731 sur les GPU, tester le modèle via Studio, connecter le serveur d’inférence local à OpenCode et utiliser l’agent de code pour créer et lancer un site web interactif d’analyse boursière.
DeepSeek-V4-Flash-0731 est la version officielle qui remplace l’aperçu précédent, avec de grandes améliorations en codage, en utilisation d’outils et en tâches d’agents autonomes. Son architecture Mixture-of-Experts n’active qu’une partie du modèle pour chaque jeton, ce qui le rend plus efficace tout en conservant d’excellentes performances.
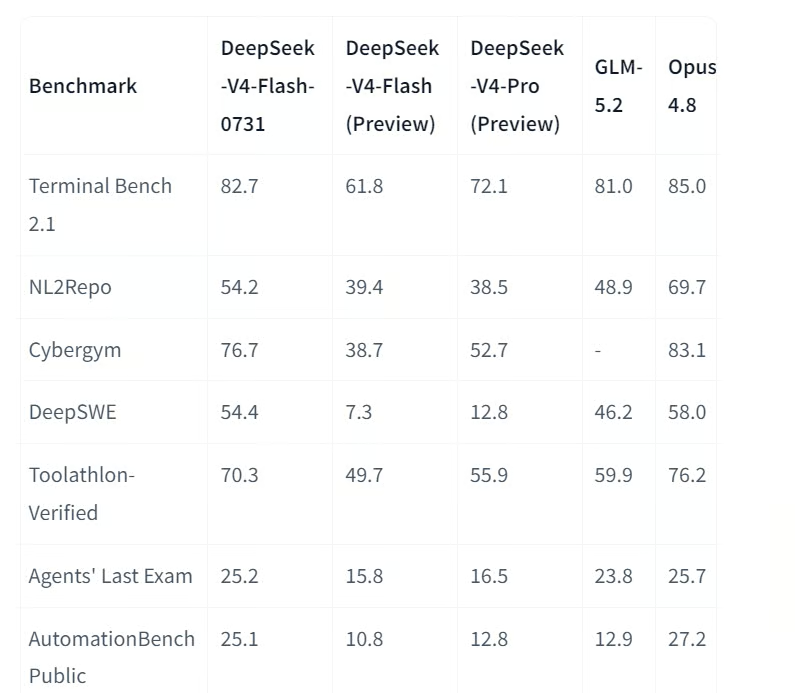
Source : deepseek-ai/DeepSeek-V4-Flash-0731 · Hugging Face
DeepSeek indique que le modèle est passé de 61,8 à 82,7 sur Terminal Bench 2.1 et de 7,3 à 54,4 sur DeepSWE. Il a également surpassé le plus grand DeepSeek-V4-Pro Preview sur plusieurs benchmarks d’agents.
Le modèle prend en charge des fenêtres de contexte allant jusqu’à un million de jetons. Il convient donc aux larges bases de code, aux documents longs et aux workflows complexes nécessitant un important contexte. Les utilisateurs peuvent aussi choisir entre un effort de raisonnement faible, élevé ou maximal selon le temps à consacrer à la résolution d’une tâche.
DeepSeek-V4-Flash-0731 inclut également le décodage spéculatif DSpark. DSpark prépare plusieurs jetons avant que le modèle principal ne les valide, ce qui, selon DeepSeek, peut améliorer la vitesse de génération de 60 % à 85 % avec un moteur d’inférence compatible.
Nous allons commencer par créer un environnement RunPod avec suffisamment de mémoire GPU et de stockage pour exécuter la version Q8 de DeepSeek-V4-Flash-0731 et héberger à la fois Unsloth Studio et le site généré par OpenCode.
Configurez le Pod avec :
/workspace comme chemin de montage du volume persistantHF_TOKEN8910 et 9101 exposés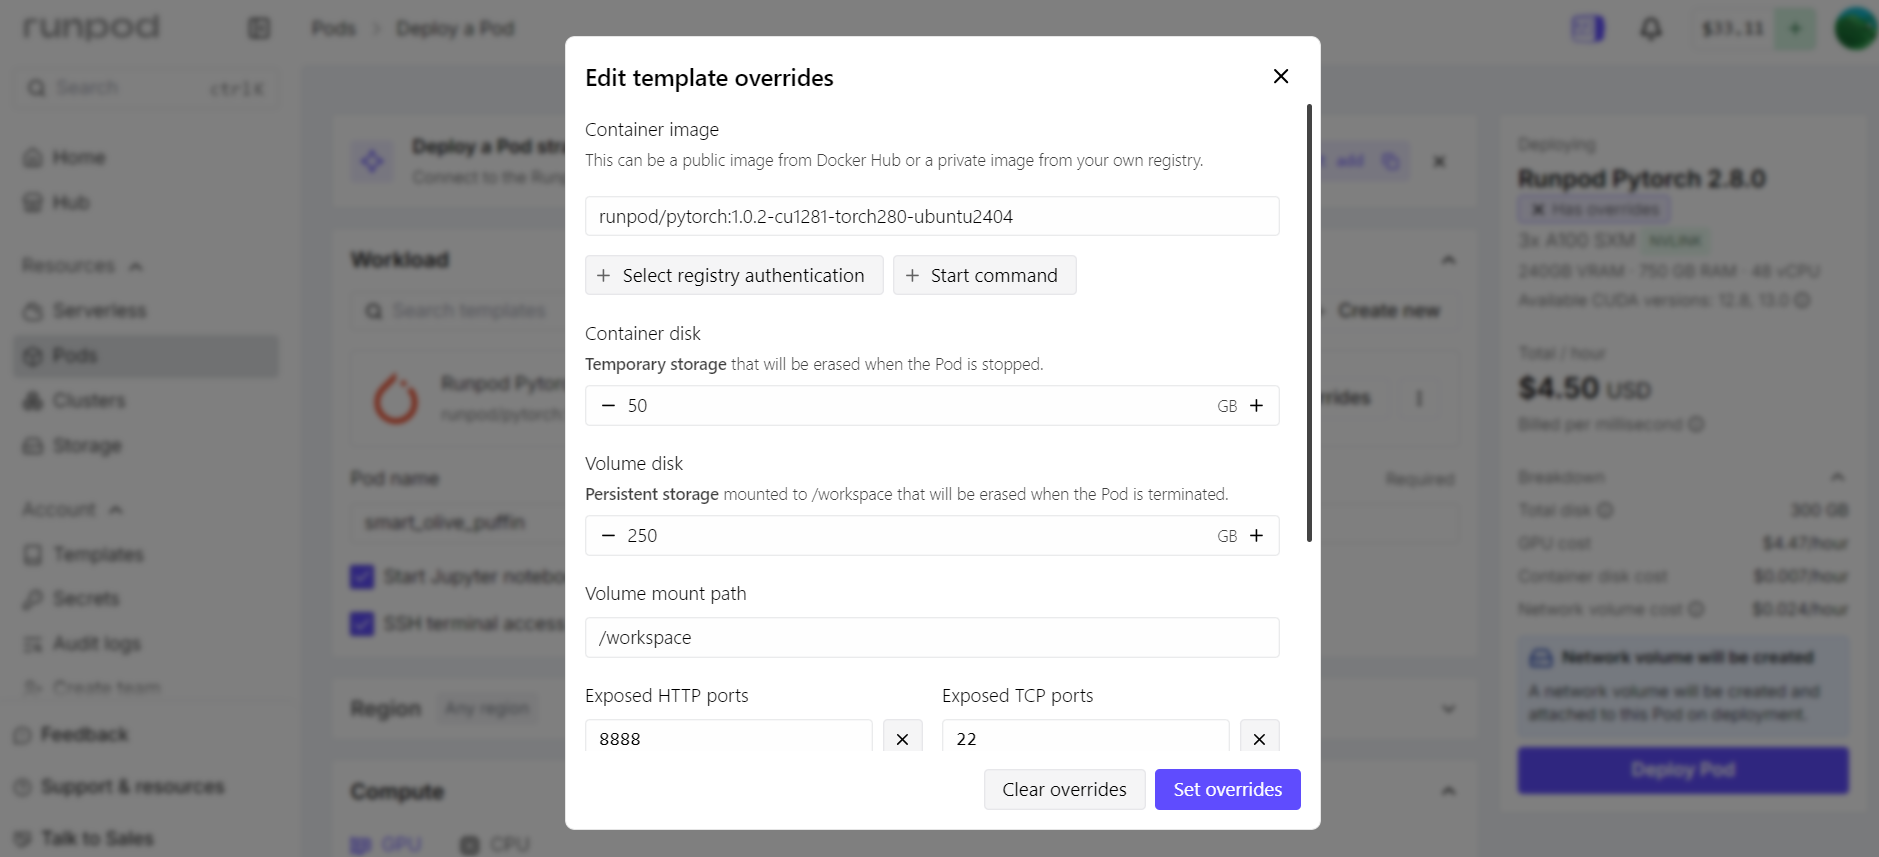
Le port 8910 sera utilisé par Unsloth Studio et son API d’inférence locale. Le port 9101 hébergera le site interactif créé par OpenCode.
RunPod expose ces services via son proxy HTTP ; les deux applications doivent donc écouter sur 0.0.0.0 plutôt que sur 127.0.0.1 uniquement.
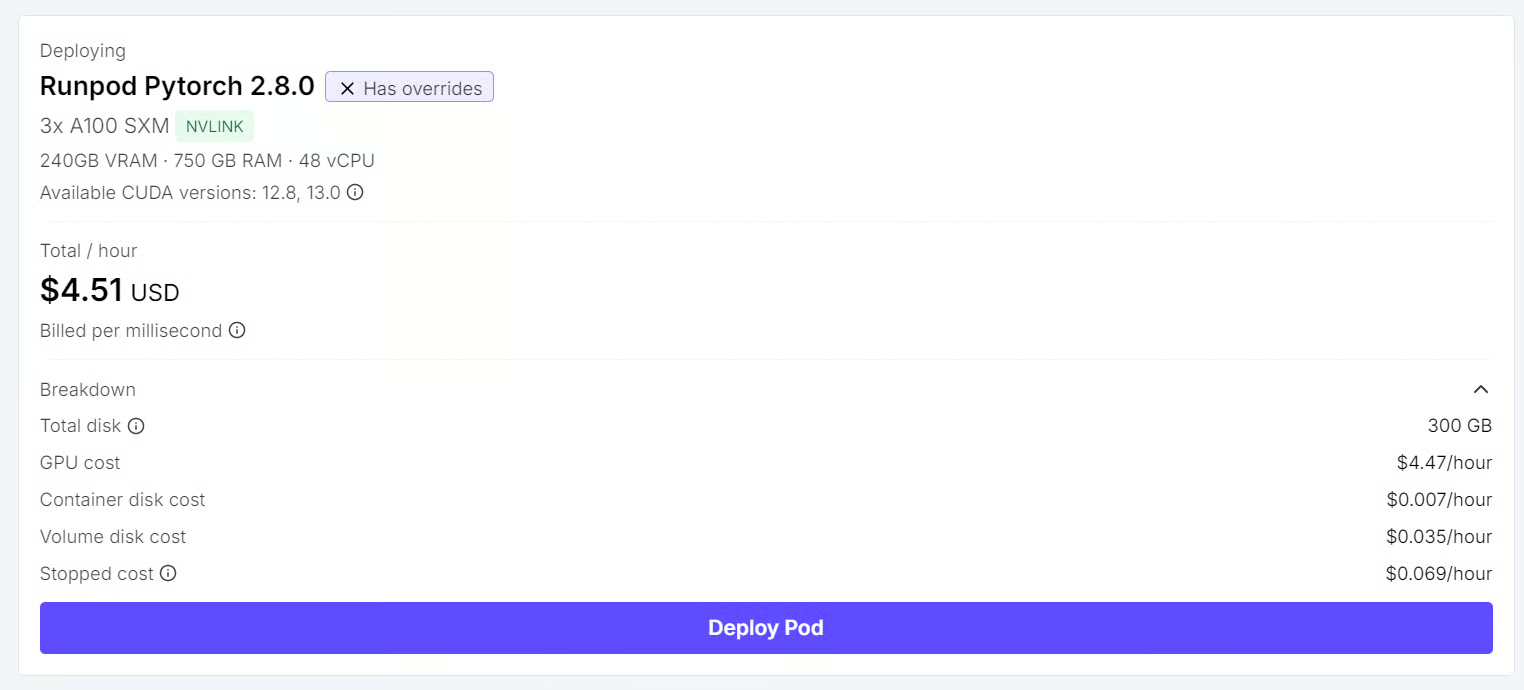
Après le déploiement du Pod, ouvrez l’onglet Connect, lancez JupyterLab et créez trois sessions terminal :
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
Séparer les tâches dans différents terminaux facilite le suivi des GPU, le diagnostic du modèle et l’exécution de l’agent de code en parallèle.
Nous allons maintenant installer Unsloth Studio, configurer un cache Hugging Face persistant et lancer l’interface sur le port 8910.
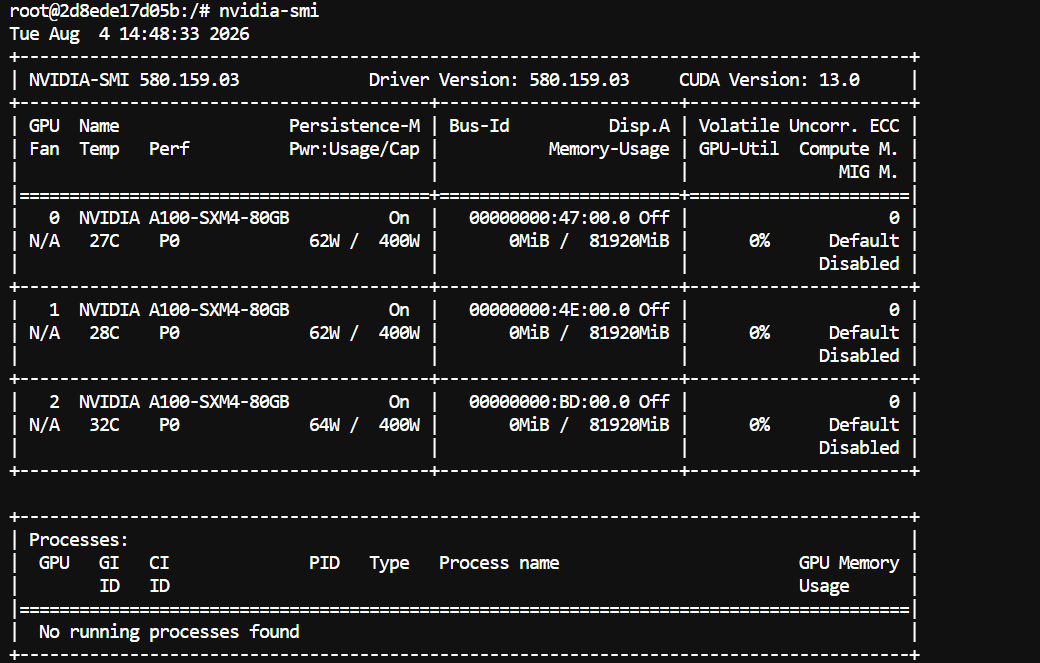
Dans le Terminal 1, vérifiez que les trois GPU sont disponibles :
nvidia-smiVous devriez voir les trois GPU A100 listés sur le serveur Linux.
Créez un cache Hugging Face persistant dans /workspace afin que les modèles téléchargés restent disponibles sur le volume RunPod :
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
Ensuite, installez les paquets systèmes requis et Unsloth Studio :
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh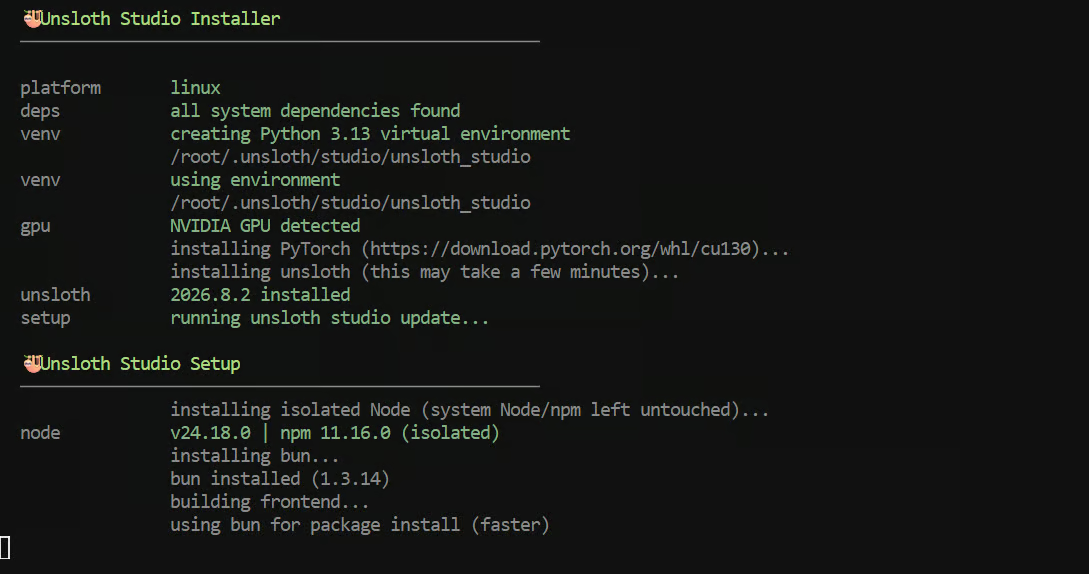
L’installeur configure l’interface Studio, l’environnement Python, les dépendances et les composants d’inférence locale.
La première installation peut prendre plusieurs minutes.
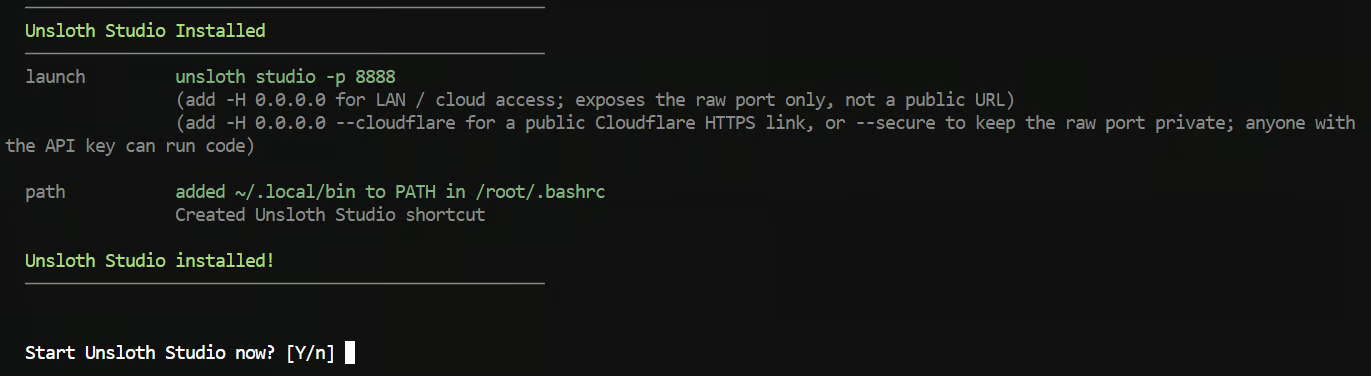
Lorsque l’installeur vous demande si vous souhaitez démarrer Unsloth Studio immédiatement, saisissez « n ».
Nous allons le lancer manuellement afin d’utiliser le port 8910 et d’écouter sur la bonne adresse réseau.
Redémarrez le shell pour rendre les nouvelles commandes disponibles :
exec bash
cd /workspace
Avant de lancer Studio, réinitialisez le mot de passe par défaut :
unsloth studio reset-passwordCopiez le mot de passe temporaire affiché pendant la configuration, il pourra être nécessaire pour finaliser la réinitialisation.
Lancez maintenant Unsloth Studio :
unsloth studio \
  -H 0.0.0.0 \
  -p 8910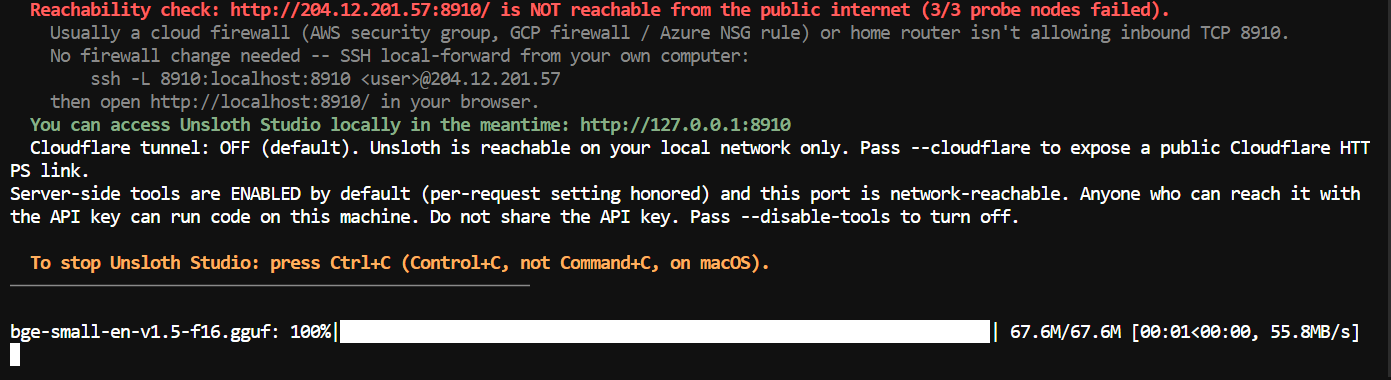
Studio devrait maintenant indiquer qu’il fonctionne sur le port 8910. Gardez le Terminal 1 ouvert pendant l’utilisation d’Unsloth Studio et d’OpenCode.
Revenez à la page Connect de RunPod et ouvrez le service HTTP pour le port 8910.
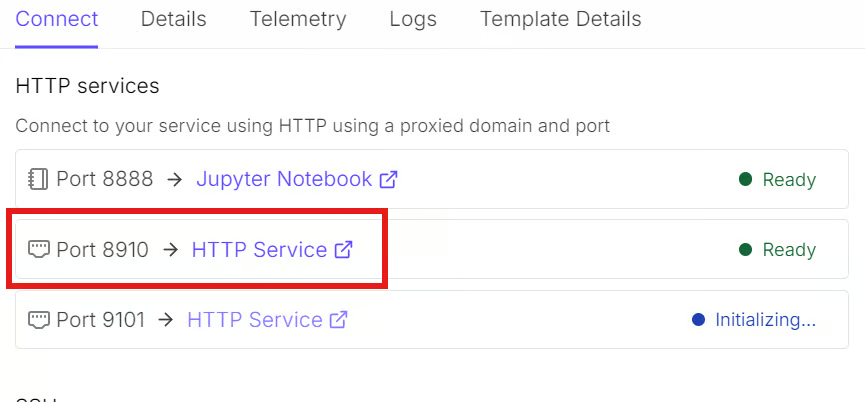
Utilisez le mot de passe temporaire généré précédemment pour finaliser la réinitialisation, puis connectez-vous avec le nouveau mot de passe que vous avez créé.
Terminez ou ignorez l’onboarding et ouvrez la page Chat.
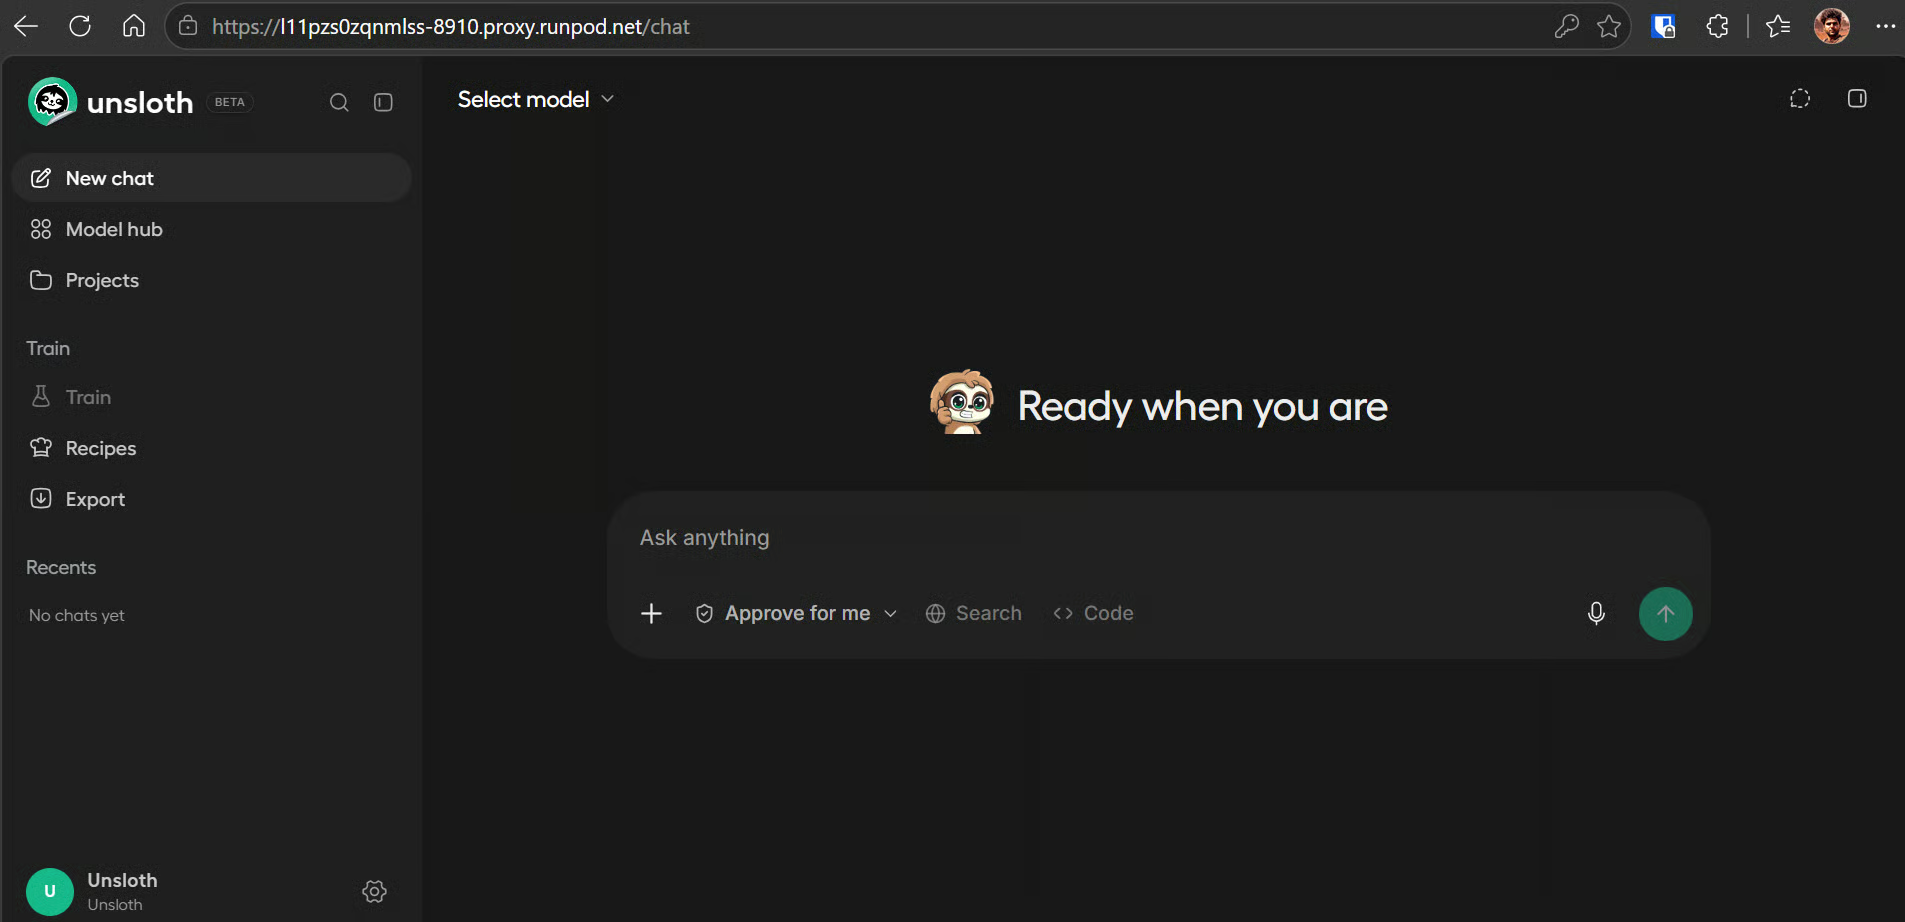
Maintenant qu’Unsloth Studio fonctionne, nous pouvons télécharger le modèle Q8, le charger sur les trois GPU et tester ses capacités de conversation et d’usage d’outils.
Ouvrez le sélecteur de modèles en haut à gauche, recherchez unsloth/DeepSeek-V4-Flash-0731-GGUF puis choisissez la quantification Q8 UD-Q8_K_XL.
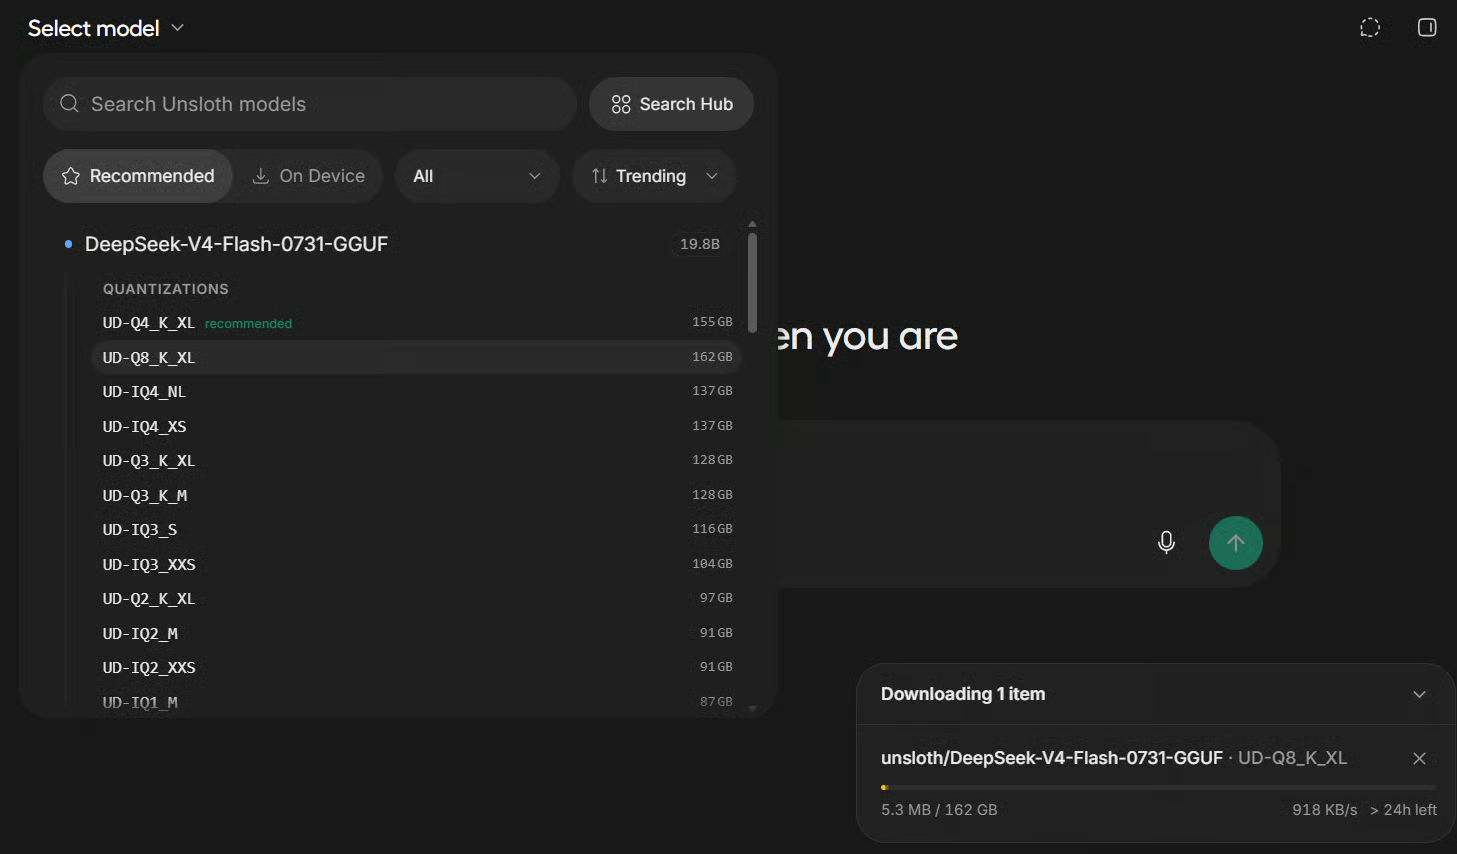
Nous utilisons Q8 car les trois GPU A100 offrent suffisamment de VRAM combinée. Cette option préserve une qualité proche du modèle d’origine, tandis que les quantifications plus basses sont plus adaptées lorsque la mémoire matérielle est limitée.
Une fois le téléchargement terminé, Unsloth Studio commencera automatiquement à charger le modèle en mémoire GPU. Cela peut prendre plusieurs minutes, la version Q8 étant très volumineuse.
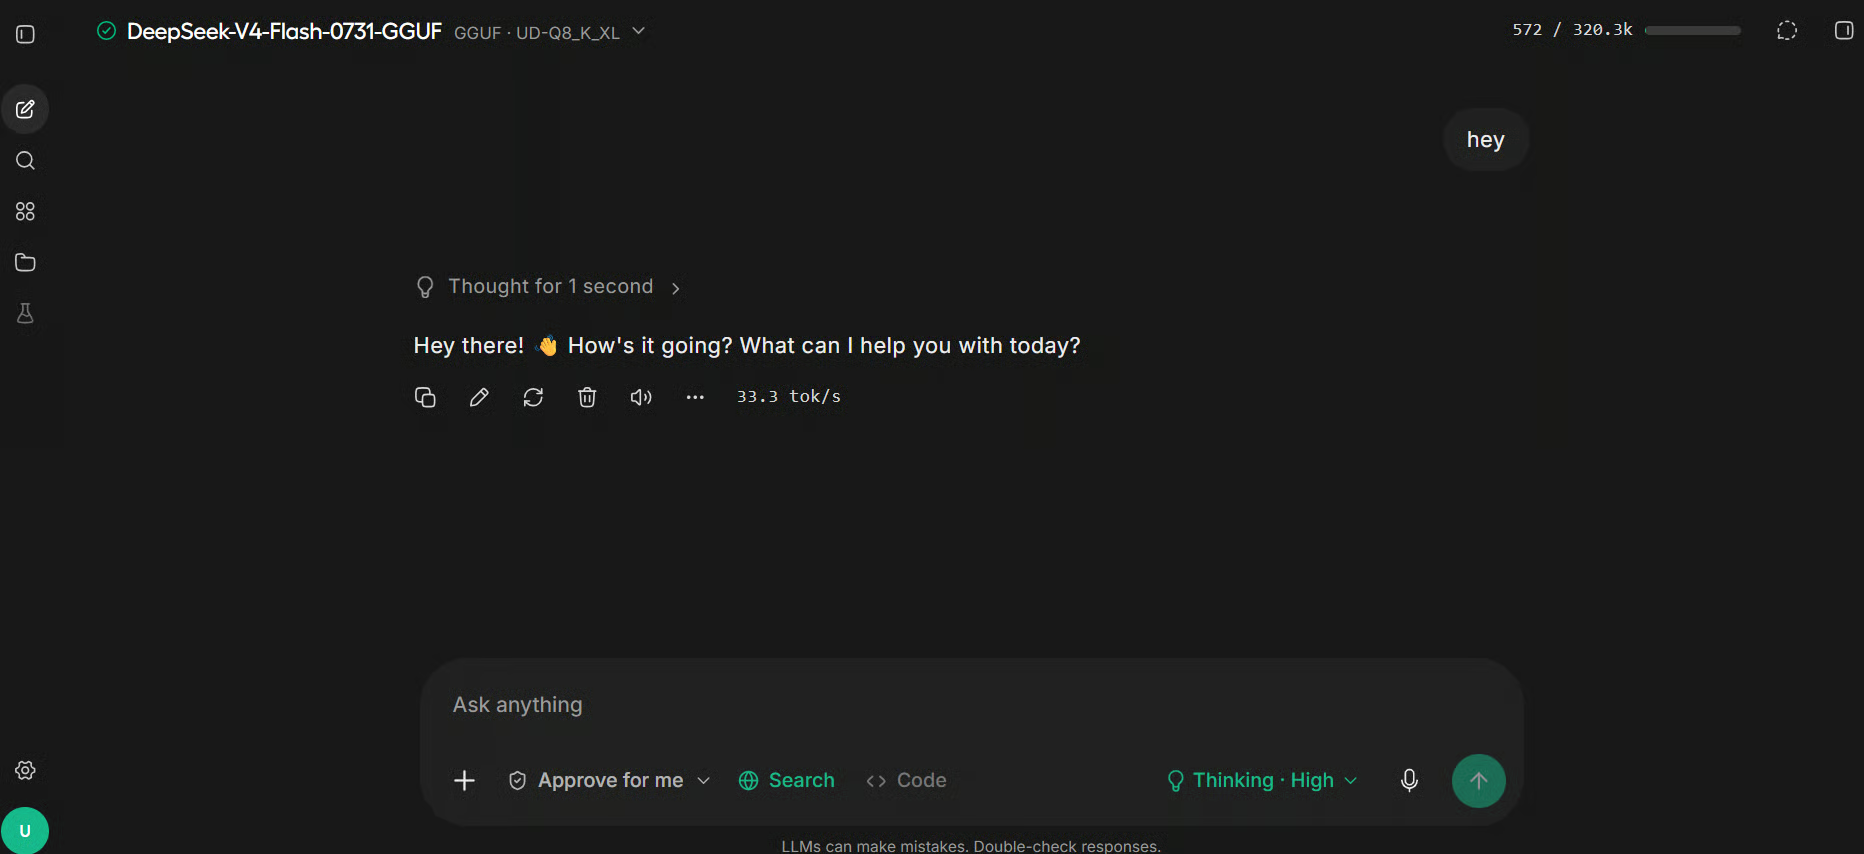
Après le chargement, utilisez la page Chat pour tester le modèle avec quelques invites simples.
Dans nos tests, la génération a atteint environ 33 jetons par seconde sans décodage spéculatif, ce qui est raisonnable pour un modèle de cette taille.
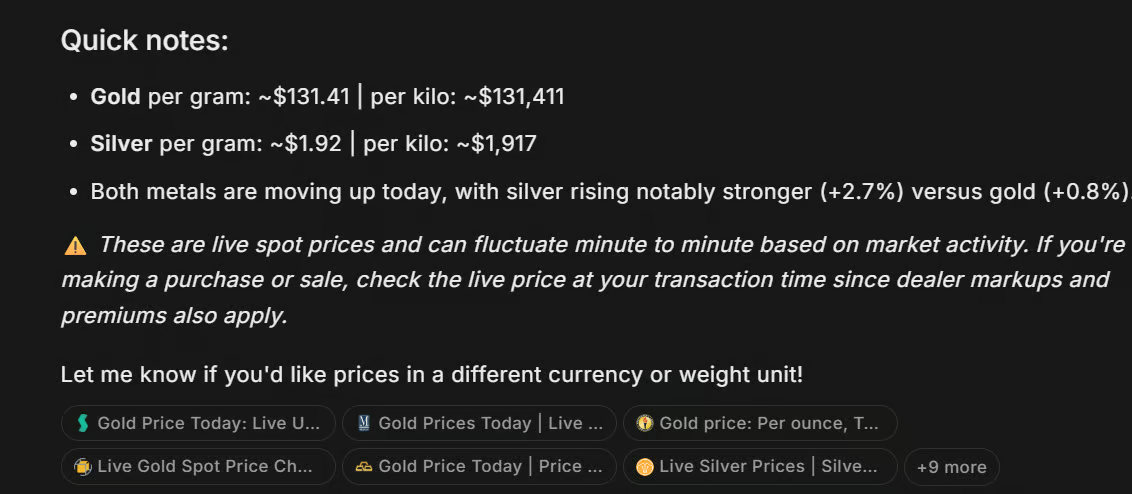
Vous pouvez également activer l’outil de recherche web de Studio et demander au modèle de consulter des informations récentes, comme les derniers cours de l’or et de l’argent. C’est une bonne façon de vérifier que le modèle sait appeler des outils externes au-delà de ses connaissances internes.
Dans le Terminal 2, vérifiez la répartition du modèle entre les GPU :
nvidia-smi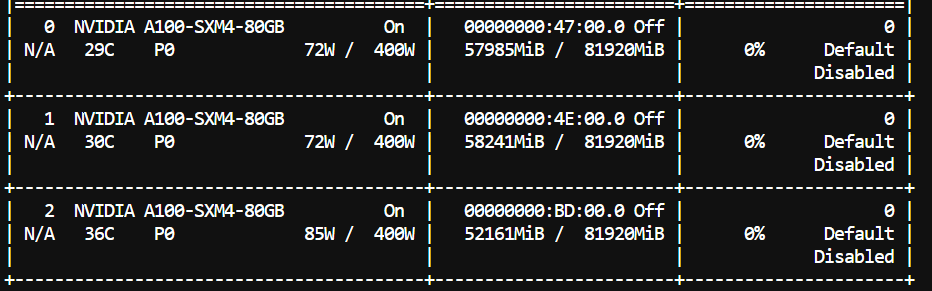
Vous devriez constater une forte utilisation mémoire sur les trois GPU.
Dans notre test, chaque GPU était rempli à environ 70 %. Cela ne signifie pas pour autant que l’intégralité du modèle Q8 tiendra confortablement sur seulement deux GPU de 80 Go, car il faut encore de la VRAM pour la fenêtre de contexte, le cache KV et les tampons d’inférence.
Enfin, testez le modèle avec l’invite de planification de l’application que nous allons construire :
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
Le modèle renvoie un plan de développement structuré couvrant l’architecture, les composants, les flux de données, les bibliothèques de graphiques, les calculs financiers et la conception d’interface.
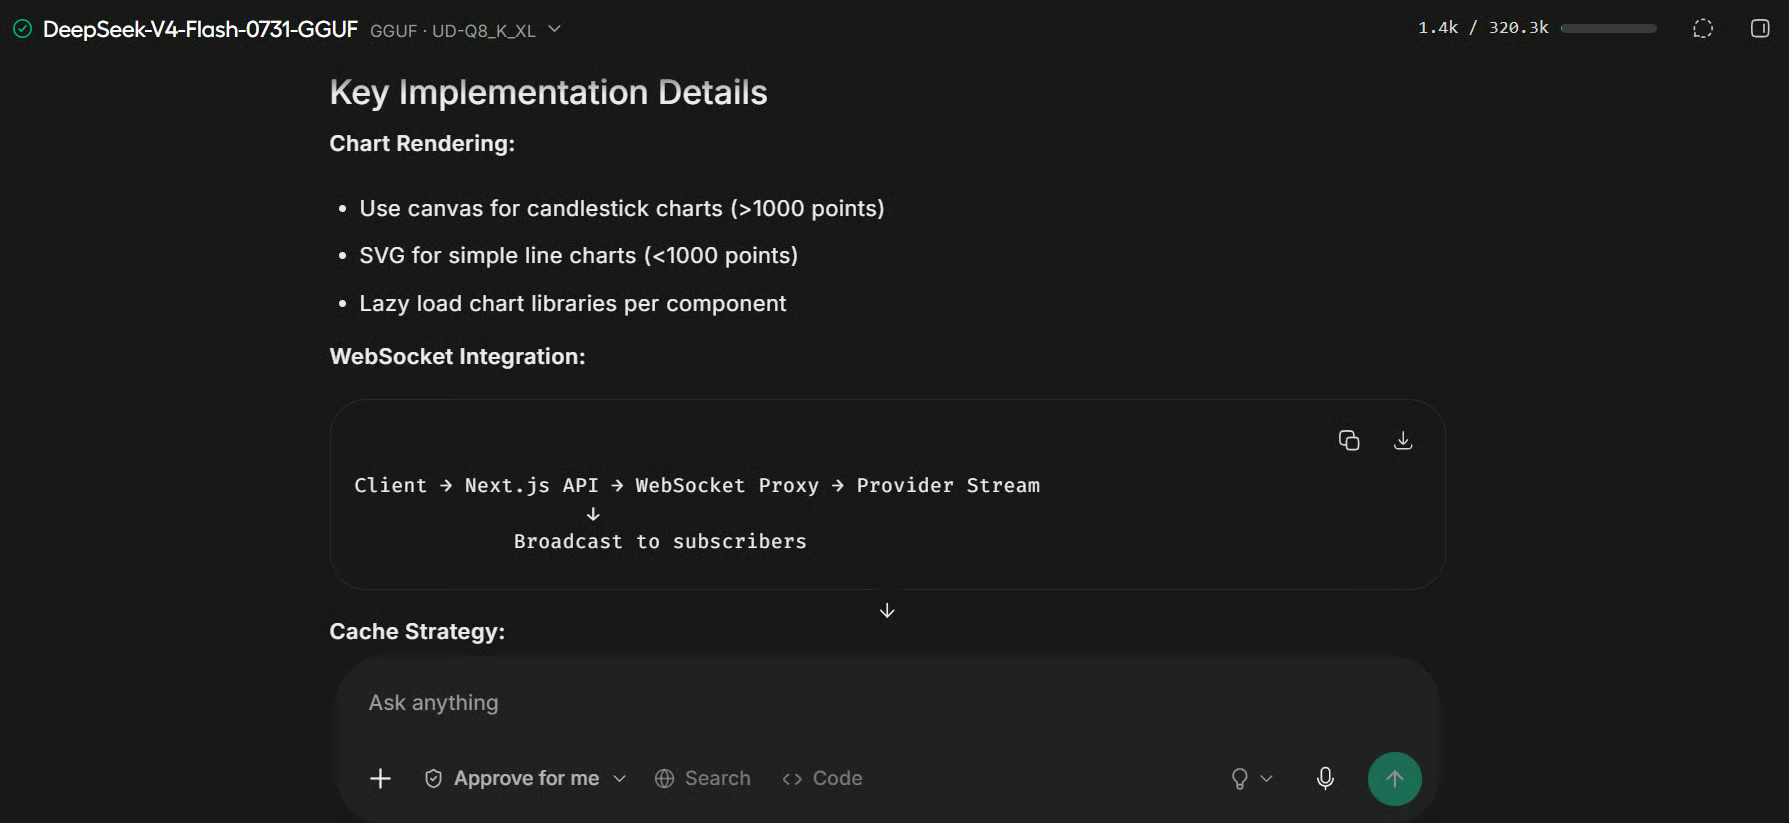
Maintenant que le modèle tourne dans Unsloth Studio, nous pouvons le connecter à OpenCode et l’utiliser comme agent de codage local.
Dans le Terminal 3, définissez l’URL de Studio :
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
Créez un nouveau répertoire de projet :
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
Démarrez OpenCode via Unsloth Studio :
unsloth start opencodeLors de la première exécution, la commande demandera l’autorisation d’installer OpenCode. Saisissez « y ».
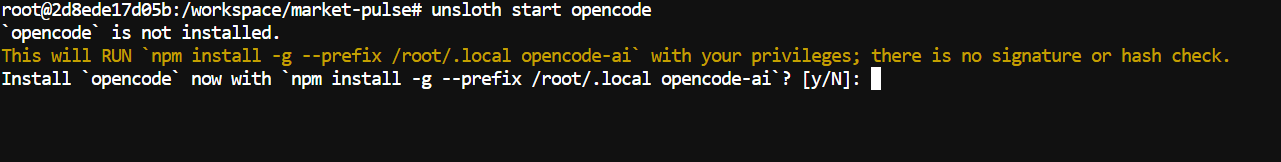
Une fois l’installation terminée, OpenCode se lancera avec le modèle DeepSeek-V4-Flash-0731 local déjà configuré.
Collez l’invite en deux lignes suivante dans OpenCode :
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
En quelques secondes, l’agent de code devrait créer une liste de tâches détaillée et commencer à dérouler le projet étape par étape.
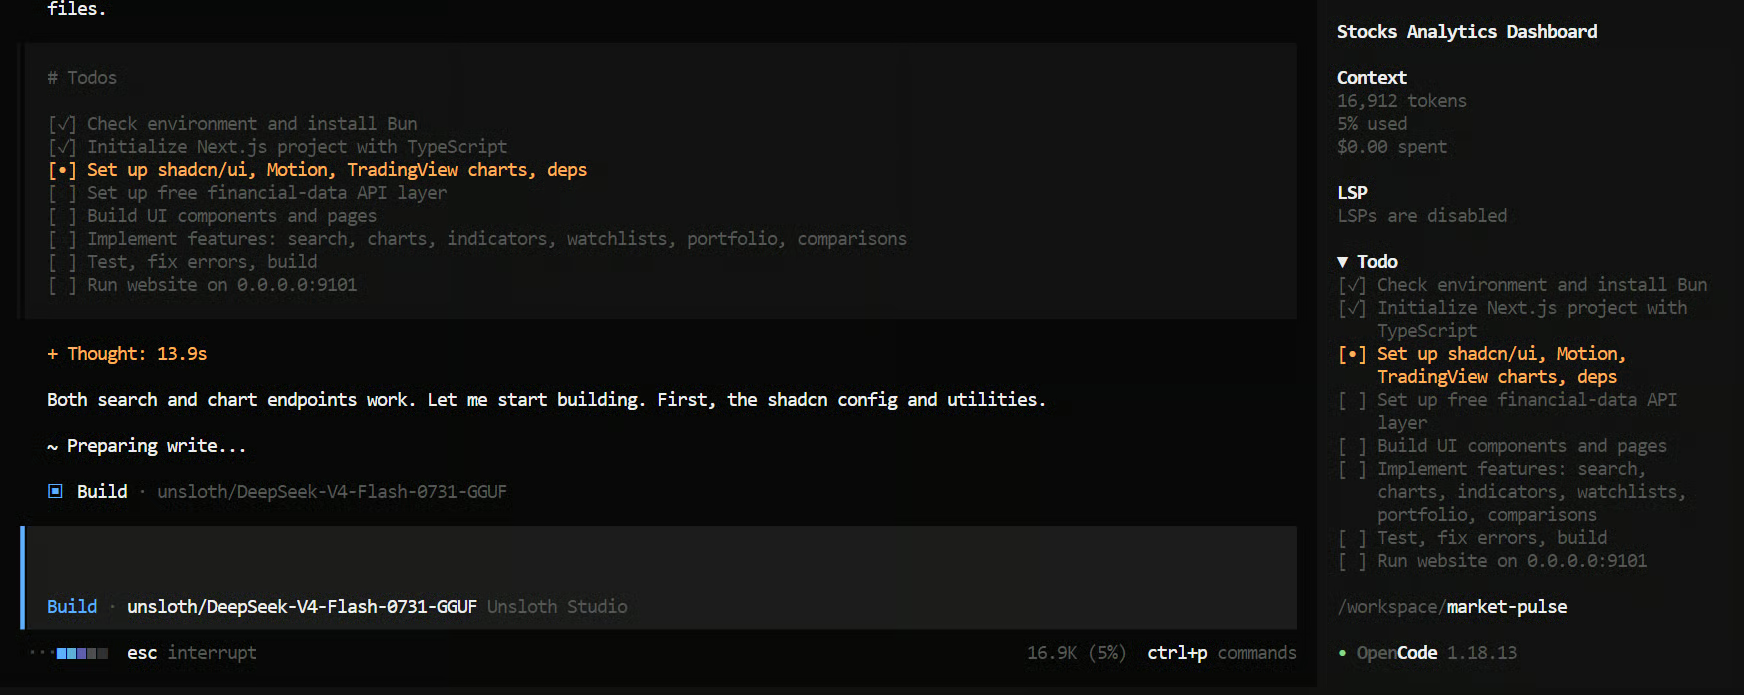
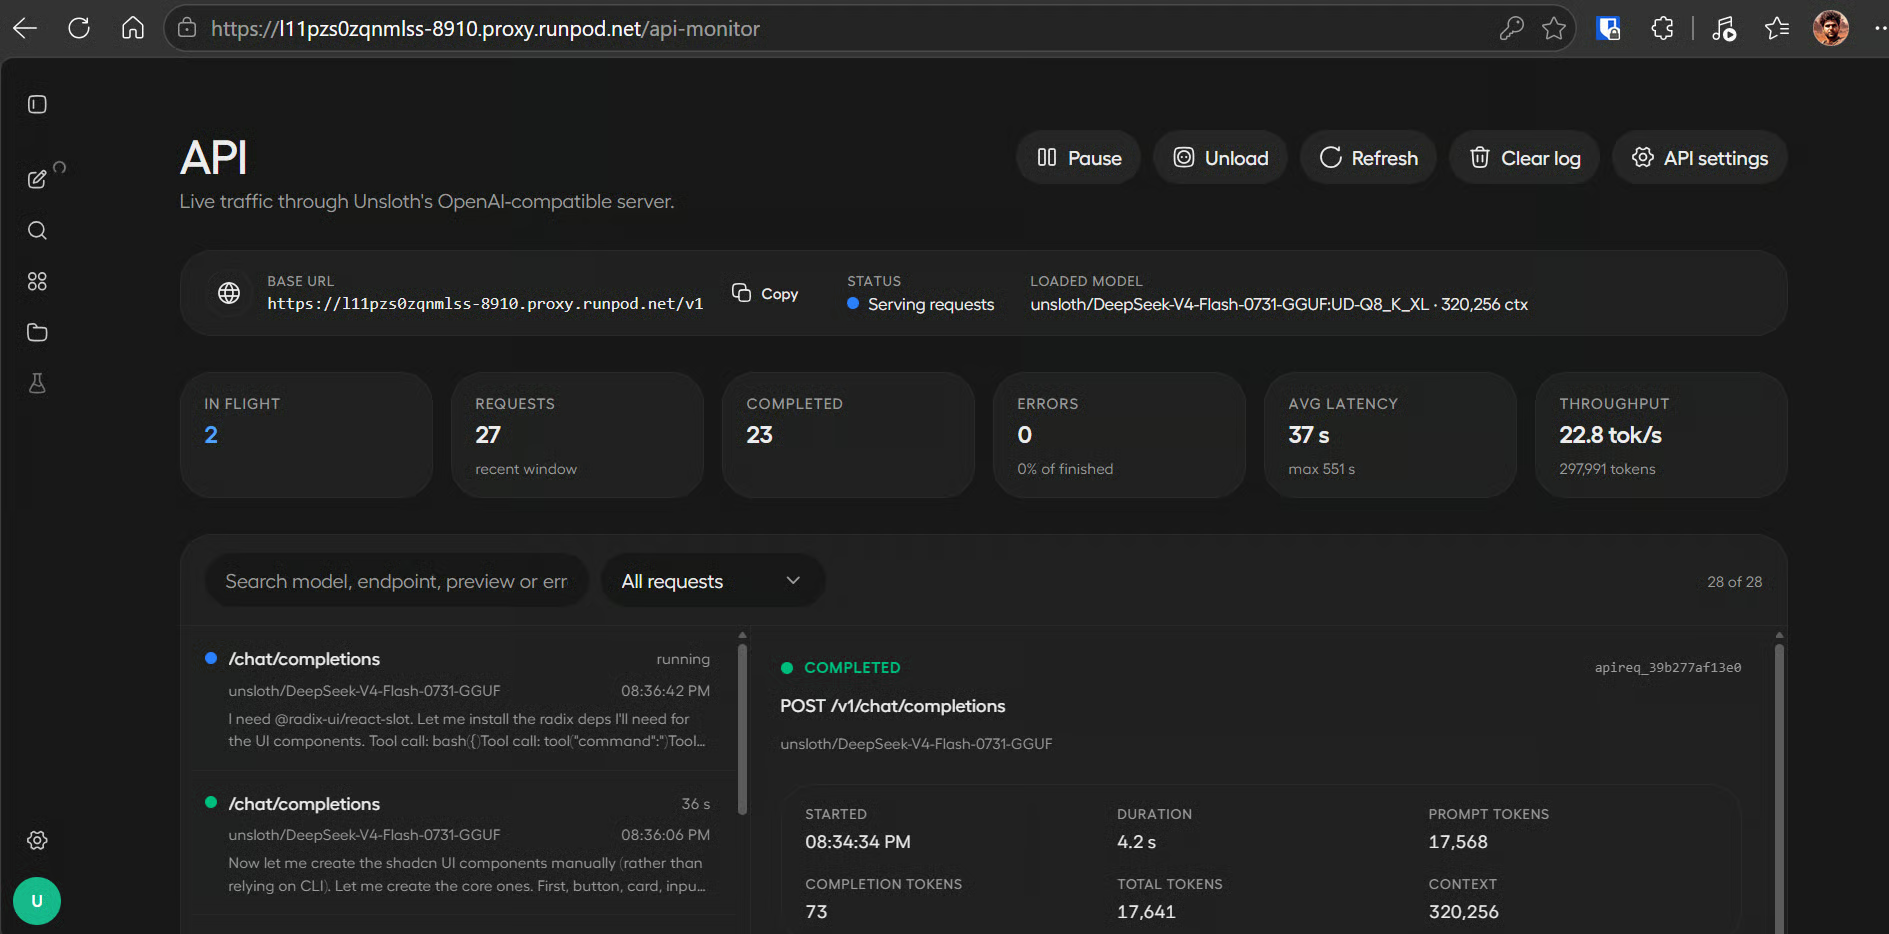
L’ensemble de la construction a pris environ 20 minutes dans notre test. Pendant l’exécution, vous pouvez revenir dans Unsloth Studio et ouvrir la page de suivi de l’API dans Settings pour suivre l’usage du modèle et la vitesse de génération.
Nous avons observé une moyenne d’environ 22,6 jetons par seconde pendant le workflow de codage. La vitesse peut diminuer à mesure que la conversation et le contexte du projet s’étoffent.
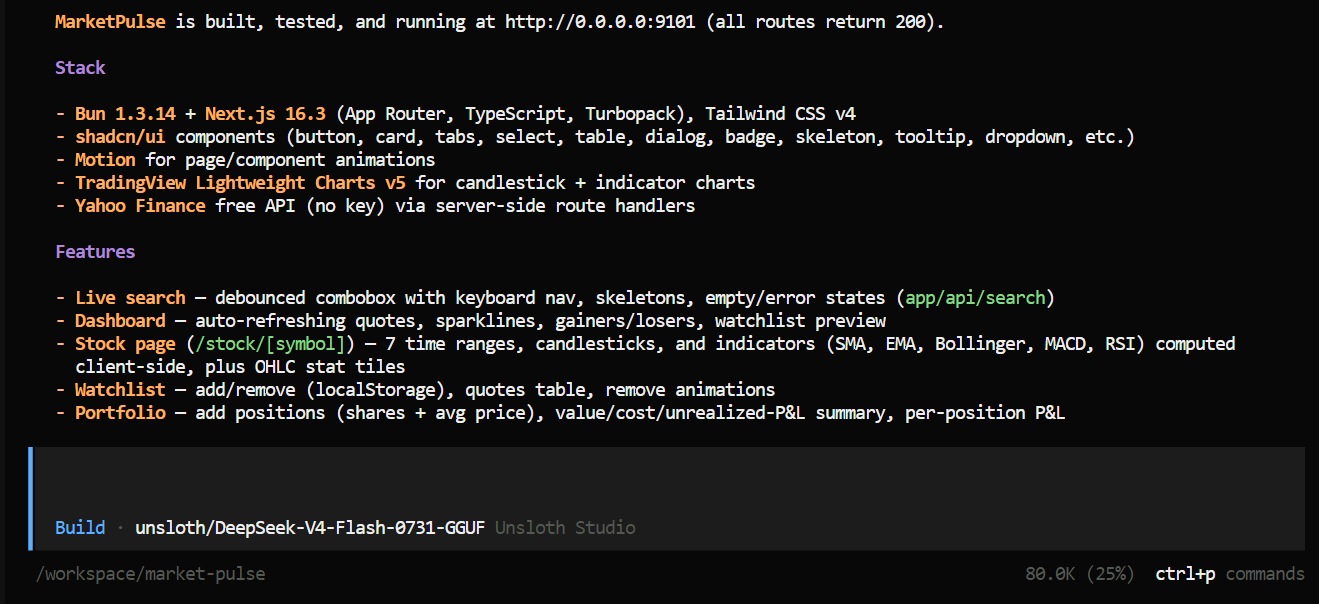
Une fois les tâches terminées, OpenCode devrait fournir un récapitulatif des fichiers, fonctionnalités et commandes créés. Il devrait également démarrer le site finalisé sur le port 9101.
Revenez à la page Connect de RunPod et ouvrez le service HTTP pour le port 9101.
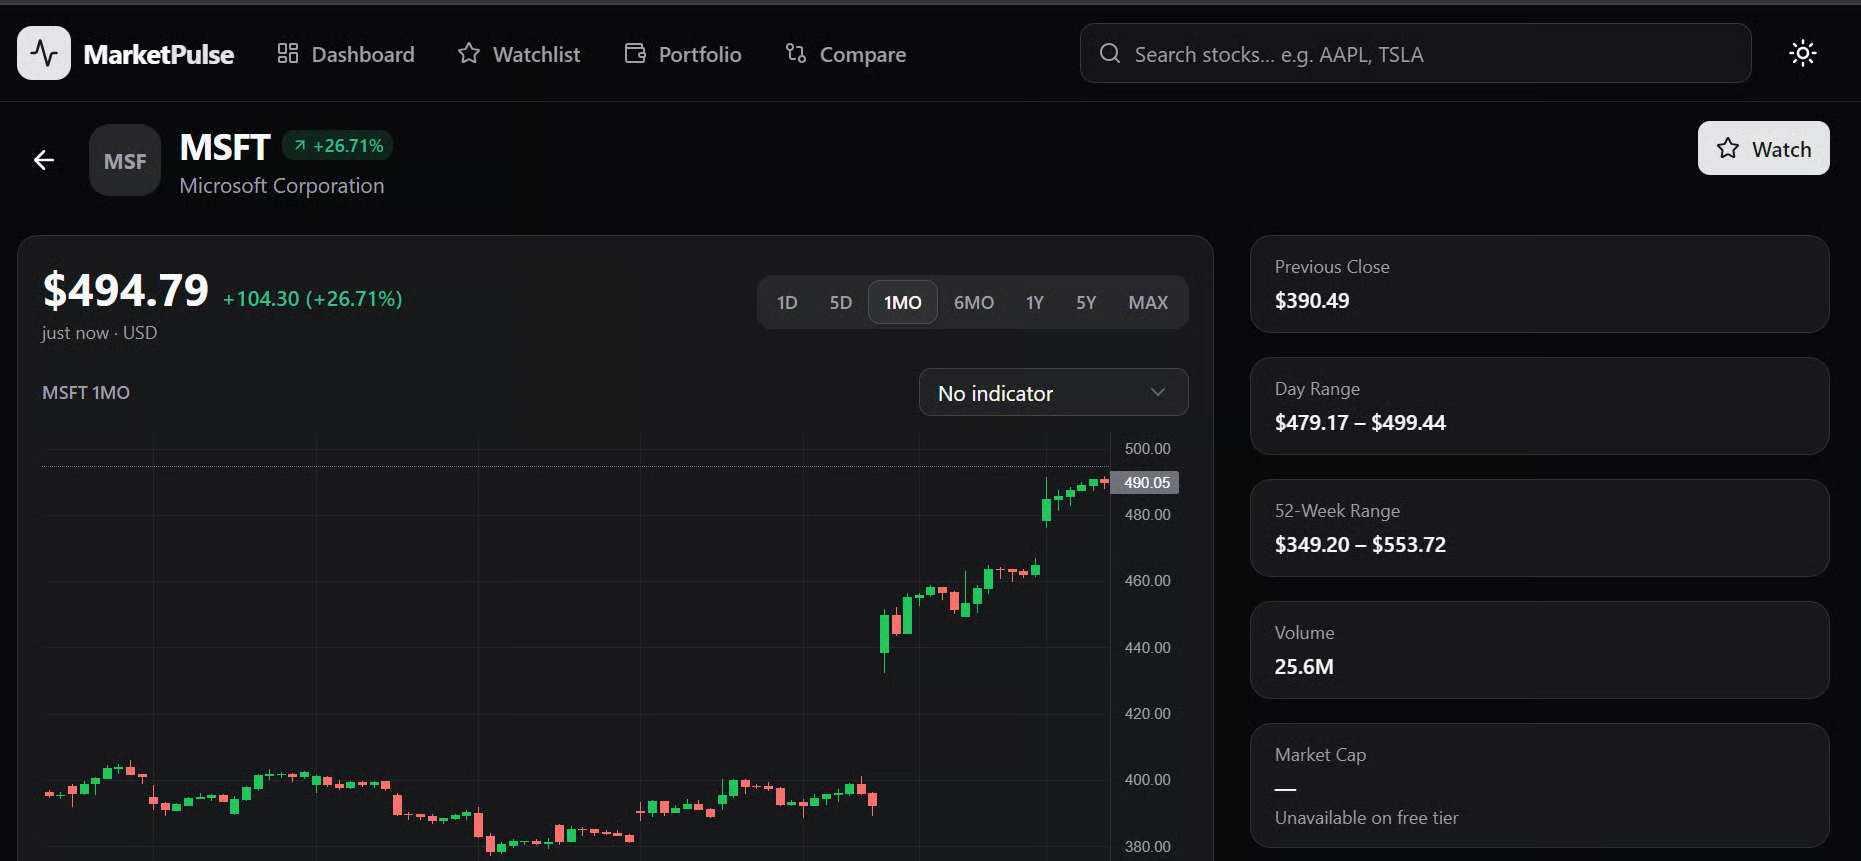
Le résultat est étonnamment soigné. Le site est propre, animé et proche d’un tableau de bord de trading professionnel. Le modèle a mené à bien l’application web en un seul prompt, interface, vues de données, graphiques et navigation compris.
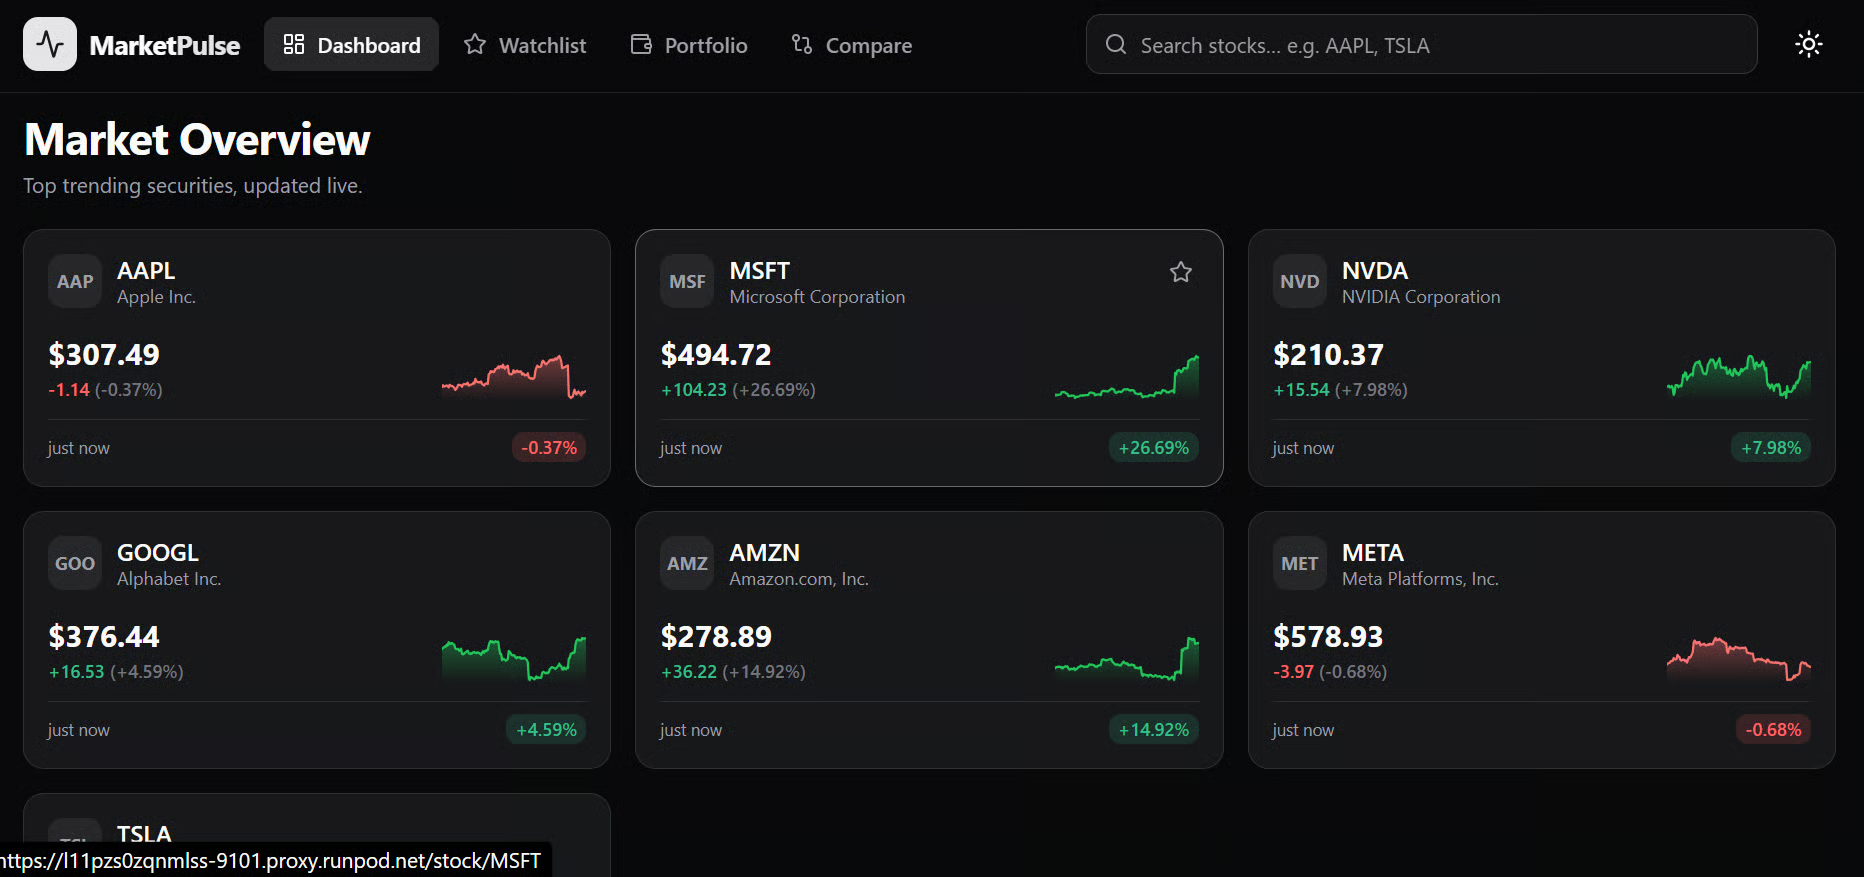
Vous pouvez sélectionner des tickers individuels pour afficher des chandeliers, la performance historique, des indicateurs et des informations complémentaires sur l’entreprise.
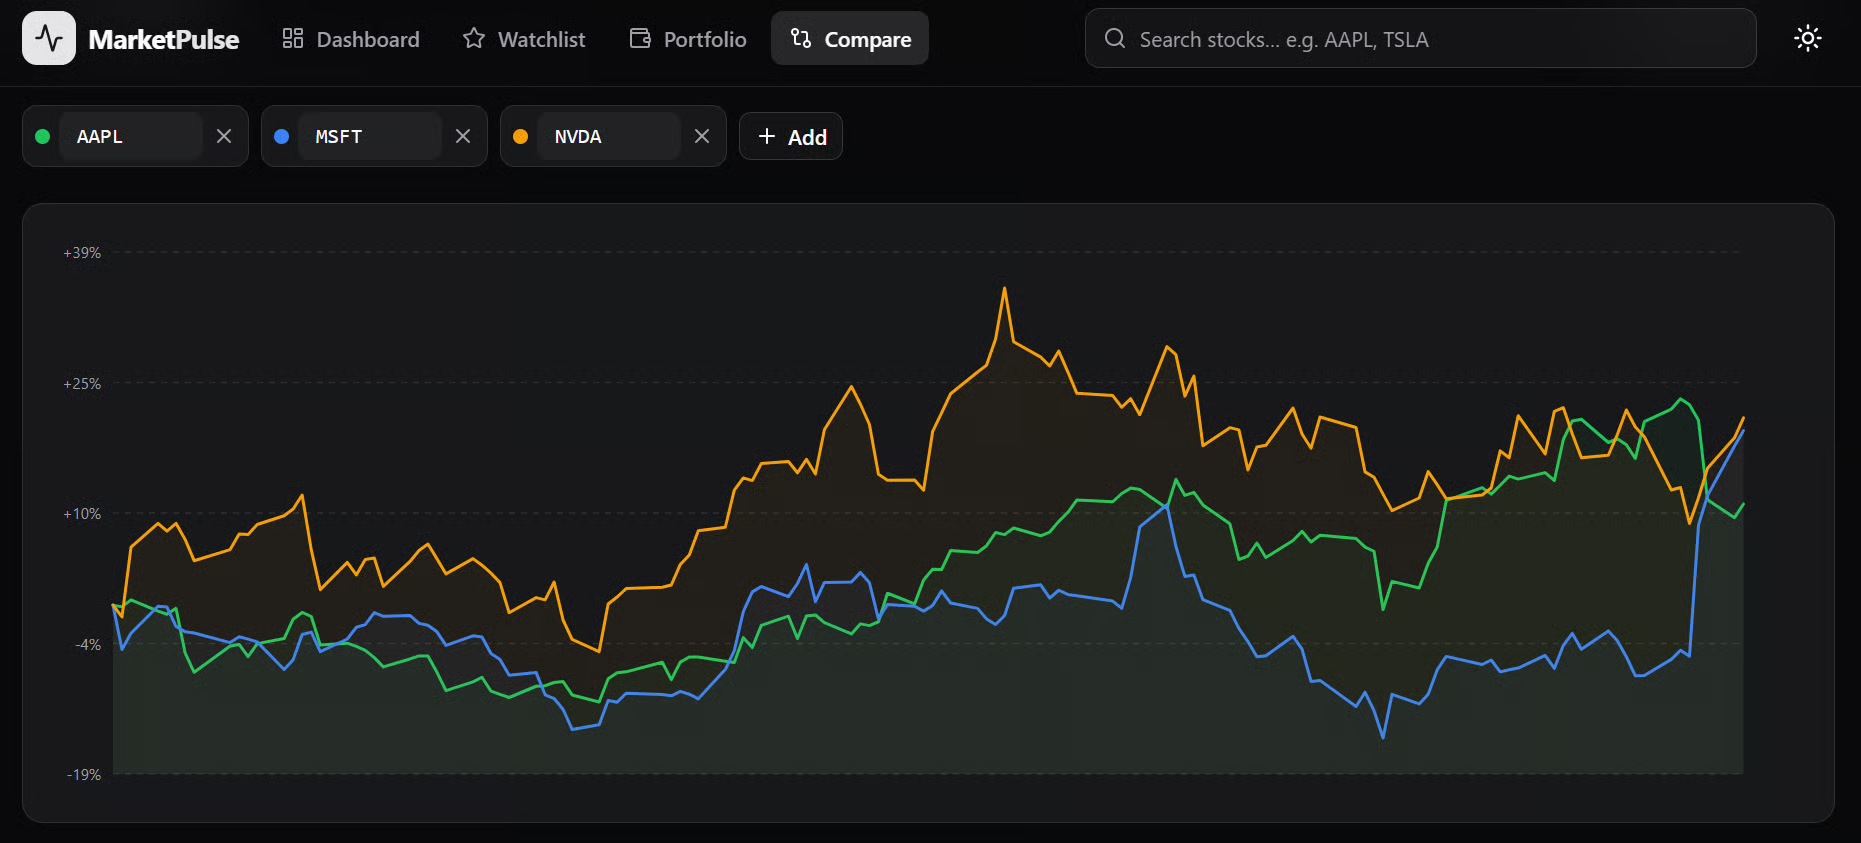
L’onglet Compare vous permet aussi de comparer plusieurs actions et d’identifier celles qui ont le mieux performé sur la période sélectionnée.
J’ai été sincèrement surpris qu’un modèle local plus petit puisse construire l’ensemble du site à partir d’un seul prompt.
Après tests, toutes les fonctionnalités majeures ont fonctionné comme prévu, y compris les cours en direct, les données de marché historiques, les graphiques, les indicateurs et les outils de comparaison.
La vitesse à laquelle les modèles locaux progressent est remarquable, tout comme leur capacité à mener des développements complexes de bout en bout.
À mes yeux, DeepSeek-V4-Flash-0731 est le meilleur modèle local que j’aie testé à ce jour.
Il a mieux performé qu’Inkling, la quantification GLM-5.2 en 2 bits et Qwen3.6-27B, qui était jusqu’alors mon favori. Cela repose sur mon expérience plutôt que sur un benchmark formel, mais c’est désormais mon modèle local préféré.
Pour la plupart des charges de travail, je commencerais tout de même par l’API officielle de DeepSeek, car elle est extrêmement abordable.
V4 Flash coûte actuellement 0,14 $ par million de jetons d’entrée non mis en cache, 0,0028 $ par million de jetons d’entrée mis en cache et 0,28 $ par million de jetons de sortie. À ce tarif, un milliard de jetons d’entrée mis en cache coûterait environ 2,80 $, hors coûts de sortie.
Avant d’opter pour Unsloth Studio, j’ai tenté d’exécuter le modèle via llama.cpp. L’installeur précompilé ne fournissait pas de binaire CUDA récent compatible avec mon environnement et, même après compilation de la dernière version depuis les sources, j’ai rencontré d’autres problèmes en activant le décodage spéculatif DSpark.
Unsloth Studio s’est finalement avéré être la solution la plus simple, en supprimant la plupart des configurations manuelles. Il a très bien fonctionné avec OpenCode, même si la construction complète de l’application a pris environ 20 minutes.
Meilleures formations DataCamp
Cours
Cours
Cursus
blog
Kurtis Pykes
9 min
blog
Lynn Heidmann
blog
Kurtis Pykes
15 min
blog
Fereshteh Forough
4 min
blog
Tutoriel