Courses
การเขียนโค้ดด้วยความช่วยเหลือของ AI สำหรับนักพัฒนา
1 30
9.9K
ขนาดเล็กลงและเร็วขึ้นไม่ได้แปลว่าความสามารถน้อยลงโดยอัตโนมัติอีกต่อไป ตามผลการประเมินที่ DeepSeek เผยแพร่ DeepSeek-V4-Flash-0731 ใช้พารามิเตอร์ที่ถูกกระตุ้น (activated) น้อยกว่า DeepSeek-V4-Pro มาก แต่ให้ประสิทธิภาพเชิงตัวแทนอัตโนมัติใกล้ระดับแนวหน้า โดยทำคะแนนได้ 82.7 บน Terminal Bench 2.1 เปรียบเทียบกับ 81.0 สำหรับ GLM-5.2 และ 85.0 สำหรับ Opus 4.8 ขณะที่คะแนน 25.2 บน Agents’ Last Exam ก็ใกล้เคียงกับ 25.7 ของ Opus 4.8
เนื่องจากเปิดเผยเวตให้ใช้ได้ คุณจึงสามารถรันโมเดลบนฮาร์ดแวร์ของตนเองได้ในทางทฤษฎีเมื่อมี RAM หรือ VRAM รวมเพียงพอ โดยคงการอนุมานและข้อมูลโครงการไว้ภายใต้การควบคุมของตนเอง
ในคู่มือนี้ เราจะตั้งค่าสภาพแวดล้อม RunPod ที่มี GPU สามตัว ติดตั้งและเปิดใช้ Unsloth Studio ดาวน์โหลดและโหลดเวอร์ชัน Q8 ของ DeepSeek-V4-Flash-0731 ข้ามหลาย GPU ทดสอบโมเดลผ่าน Studio เชื่อมต่อเซิร์ฟเวอร์อนุมานโลคอลกับ OpenCode และใช้เอเจนต์เขียนโค้ดเพื่อสร้างและเปิดเว็บไซต์วิเคราะห์หุ้นแบบโต้ตอบ
DeepSeek-V4-Flash-0731 เป็นรุ่นทางการที่มาแทนพรีวิวก่อนหน้า พร้อมการปรับปรุงครั้งใหญ่ในด้านการเขียนโค้ด การใช้เครื่องมือ และงานเอเจนต์อัตโนมัติ สถาปัตยกรรม Mixture-of-Experts จะเปิดใช้งานเฉพาะบางส่วนของโมเดลสำหรับแต่ละโทเคน ช่วยให้มีประสิทธิภาพยิ่งขึ้นพร้อมยังคงประสิทธิภาพที่แข็งแกร่ง
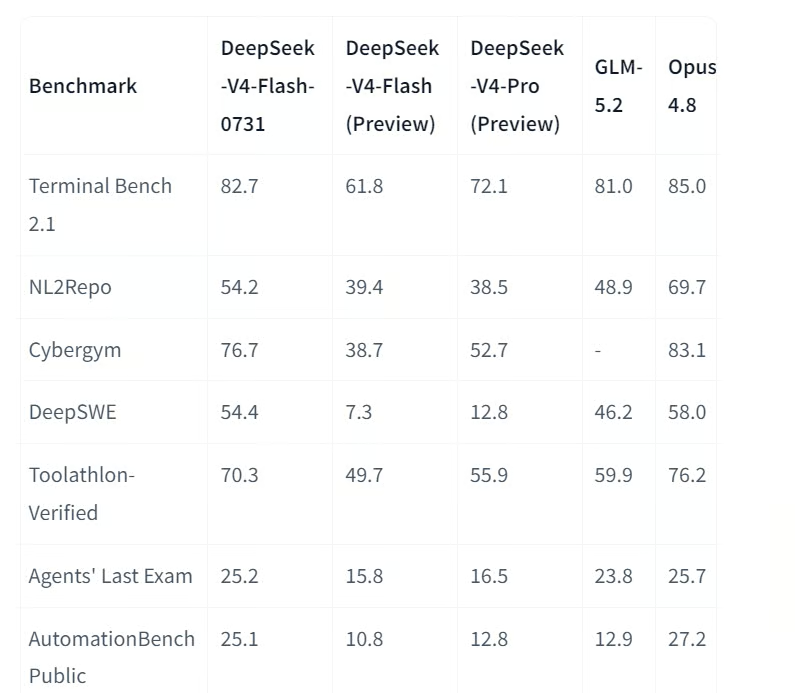
ที่มา: deepseek-ai/DeepSeek-V4-Flash-0731 · Hugging Face
DeepSeek รายงานว่าโมเดลพัฒนาจาก 61.8 เป็น 82.7 บน Terminal Bench 2.1 และจาก 7.3 เป็น 54.4 บน DeepSWE พร้อมทั้งทำได้ดีกว่า DeepSeek-V4-Pro Preview ซึ่งมีขนาดใหญ่กว่า ในเบนช์มาร์กเอเจนต์หลายรายการ
โมเดลรองรับหน้าต่างบริบทได้สูงสุดหนึ่งล้านโทเคน เหมาะกับโค้ดเบสขนาดใหญ่ เอกสารยาว และเวิร์กโฟลว์ซับซ้อนที่ต้องการบริบทมาก ผู้ใช้ยังสามารถเลือกความพยายามเชิงเหตุผลระดับต่ำ สูง และสูงสุด ขึ้นอยู่กับเวลาที่ต้องการให้โมเดลใช้ในการแก้ปัญหา
DeepSeek-V4-Flash-0731 ยังมี DSpark speculative decoding ซึ่งจะร่างหลายโทเคนก่อนให้โมเดลหลักตรวจสอบ โดย DeepSeek ระบุว่าสามารถเพิ่มความเร็วในการสร้างผลลัพธ์ได้ 60% ถึง 85% เมื่อใช้กับเอนจินอนุมานที่รองรับ
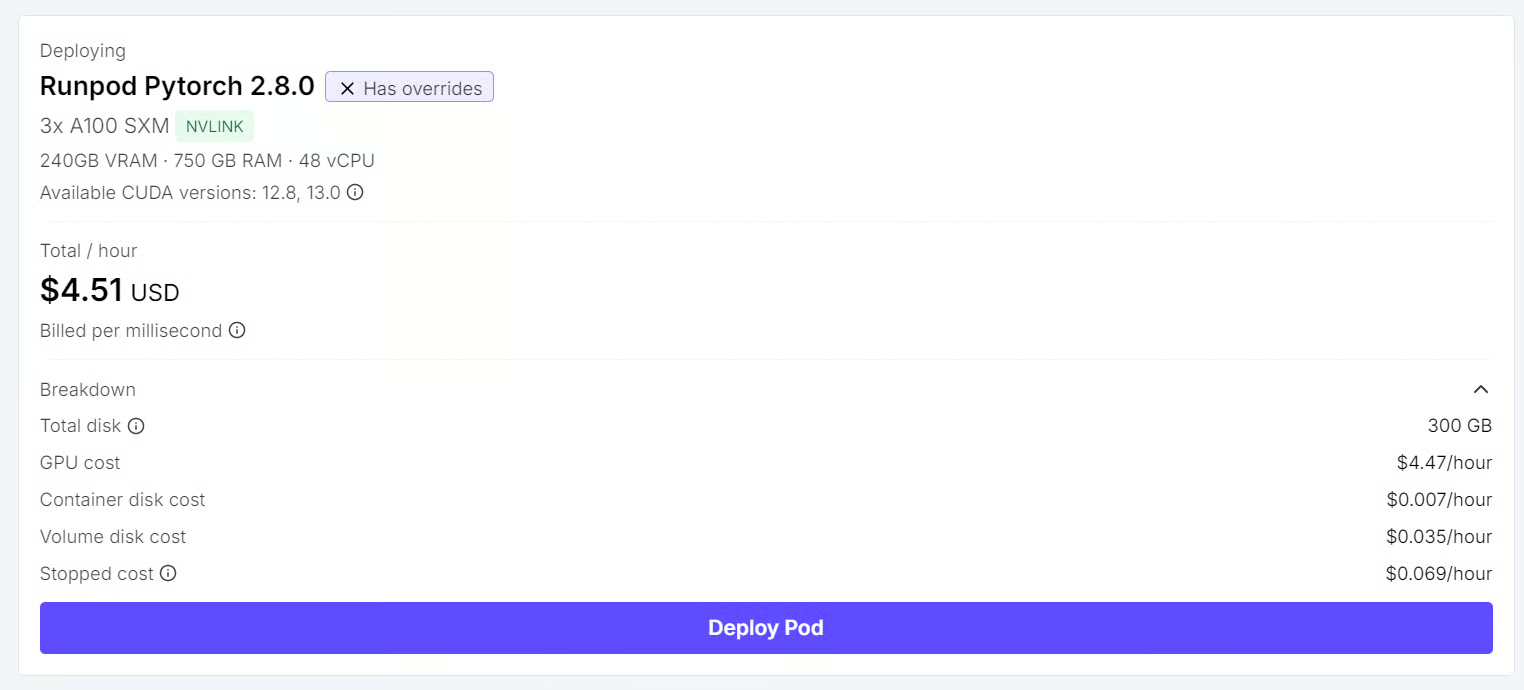
เริ่มจากสร้างสภาพแวดล้อม RunPod ที่มีหน่วยความจำ GPU และที่เก็บข้อมูลเพียงพอสำหรับรันเวอร์ชัน Q8 ของ DeepSeek-V4-Flash-0731 และโฮสต์ทั้ง Unsloth Studio และเว็บไซต์ที่สร้างโดย OpenCode
กำหนดค่า Pod ดังนี้:
/workspace เป็น path ของการเมานต์ persistent volumeHF_TOKEN8910 และ 9101 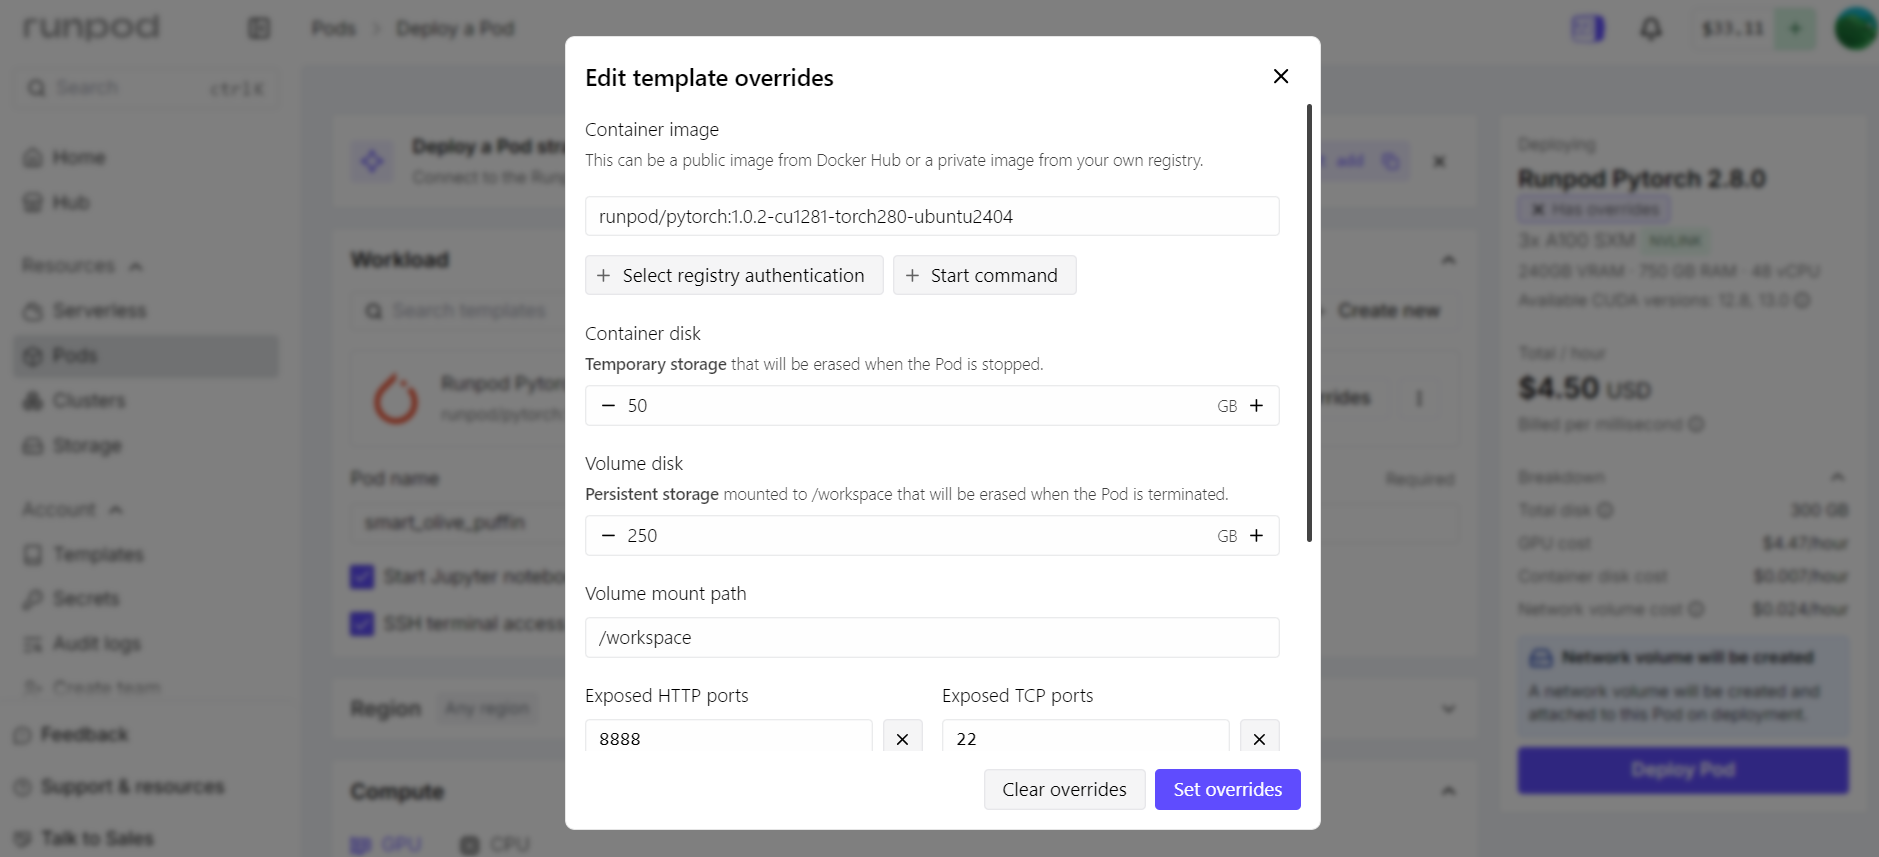
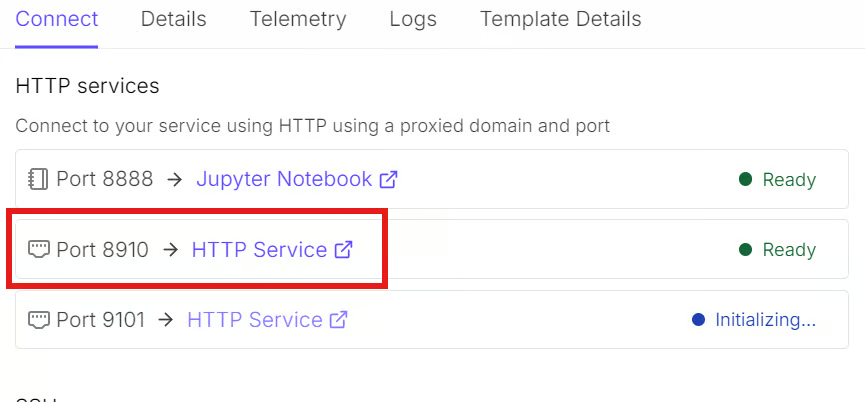
พอร์ต 8910 จะใช้สำหรับ Unsloth Studio และ API อนุมานโลคอล ส่วนพอร์ต 9101 จะโฮสต์เว็บไซต์แบบโต้ตอบที่สร้างโดย OpenCode
RunPod จะเปิดเผยบริการเหล่านี้ผ่าน HTTP proxy ดังนั้นทั้งสองแอปต้องฟังที่ 0.0.0.0 ไม่ใช่เพียง 127.0.0.1.
หลังดีพลอย Pod แล้ว ให้เปิดแท็บ Connect เปิด JupyterLab และสร้างเทอร์มินัลสามหน้าต่าง:
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
แยกงานไว้คนละเทอร์มินัลช่วยให้ง่ายต่อการติดตามการใช้ GPU แก้ไขปัญหาโมเดล และรันเอเจนต์เขียนโค้ดไปพร้อมกัน
ถัดไป เราจะติดตั้ง Unsloth Studio กำหนดค่าแคช Hugging Face แบบถาวร และเปิดอินเทอร์เฟซบนพอร์ต 8910.
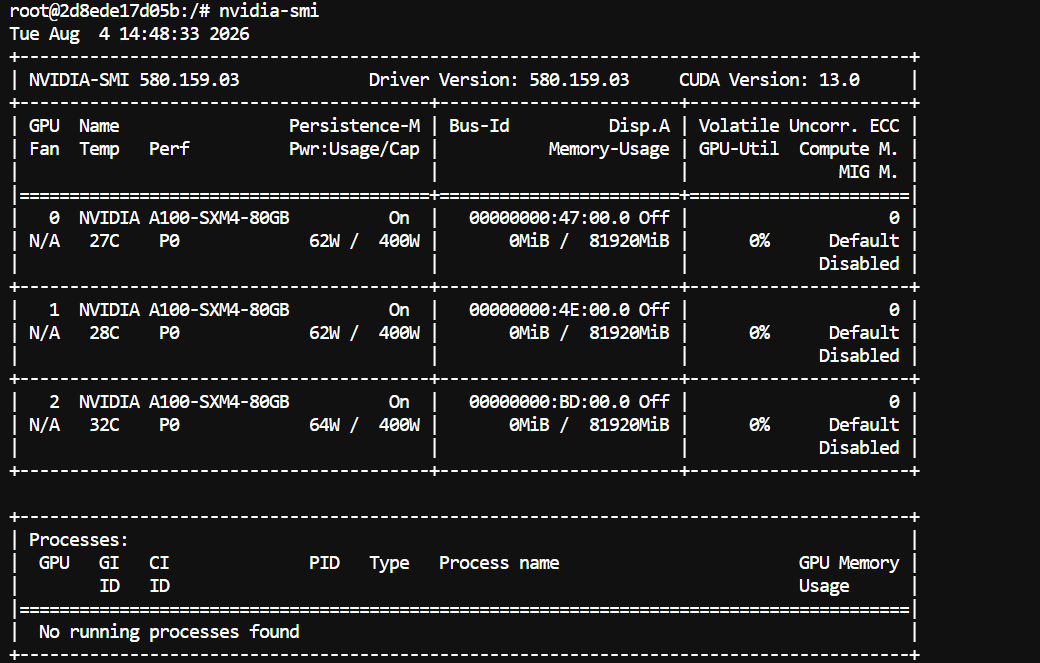
ที่ เทอร์มินัล 1 ตรวจสอบว่า GPU ทั้งสามพร้อมใช้งาน:
nvidia-smiควรเห็น GPU A100 ทั้งสามตัวที่ลิสต์อยู่บนเซิร์ฟเวอร์ลินุกซ์
สร้างแคช Hugging Face แบบถาวรภายใน /workspace เพื่อให้โมเดลที่ดาวน์โหลดพร้อมใช้งานบนโวลุมของ RunPod ต่อไป
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
จากนั้นติดตั้งแพ็กเกจระบบที่ต้องใช้และ Unsloth Studio:
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh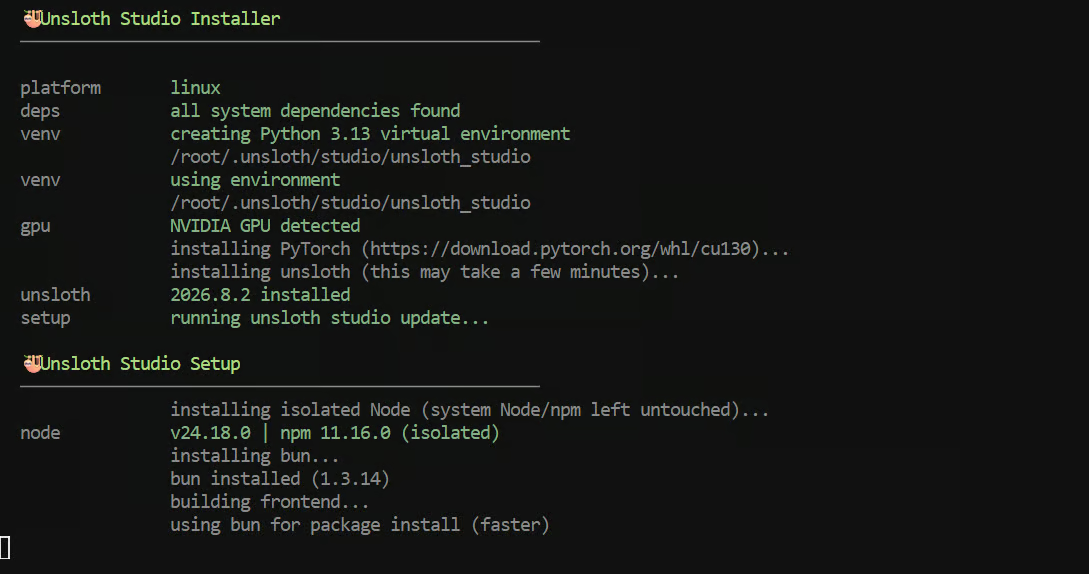
ตัวติดตั้งจะตั้งค่าอินเทอร์เฟซ Studio สภาพแวดล้อม Python ดีเพนเดนซี และคอมโพเนนต์อนุมานโลคอล
การติดตั้งครั้งแรกอาจใช้เวลาหลายนาที
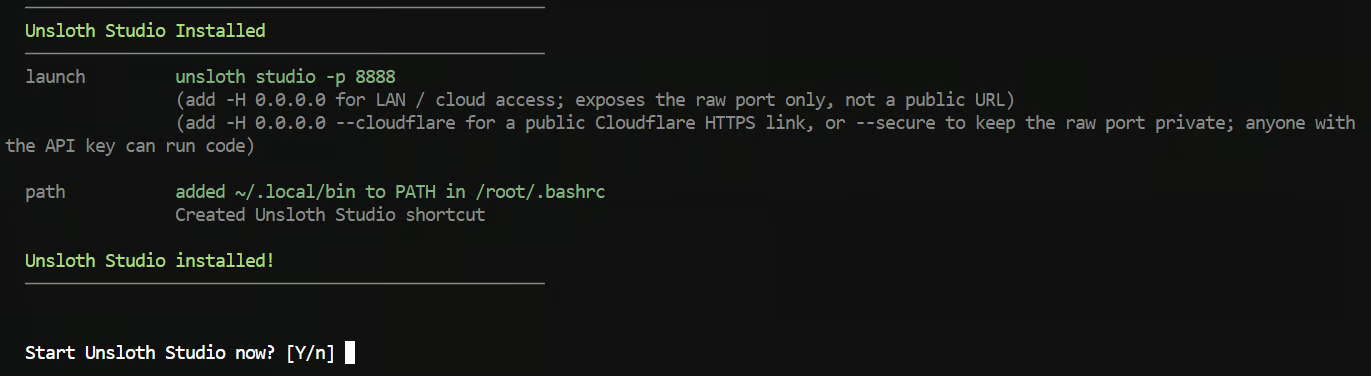
เมื่อโปรแกรมติดตั้งถามว่าต้องการเริ่ม Unsloth Studio ทันทีหรือไม่ ให้พิมพ์ “n”
เราจะเปิดเองเพื่อให้ใช้พอร์ต 8910 และฟังบนแอดเดรสเครือข่ายที่ถูกต้อง
รีสตาร์ตเชลล์เพื่อให้คำสั่งใหม่พร้อมใช้:
exec bash
cd /workspace
ก่อนเปิด Studio ให้รีเซ็ตรหัสผ่านเริ่มต้น:
unsloth studio reset-passwordคัดลอกรหัสผ่านชั่วคราวที่แสดงระหว่างการตั้งค่าไว้ อาจต้องใช้เพื่อทำการรีเซ็ตให้เสร็จสิ้น
ตอนนี้เปิด Unsloth Studio:
unsloth studio \
  -H 0.0.0.0 \
  -p 8910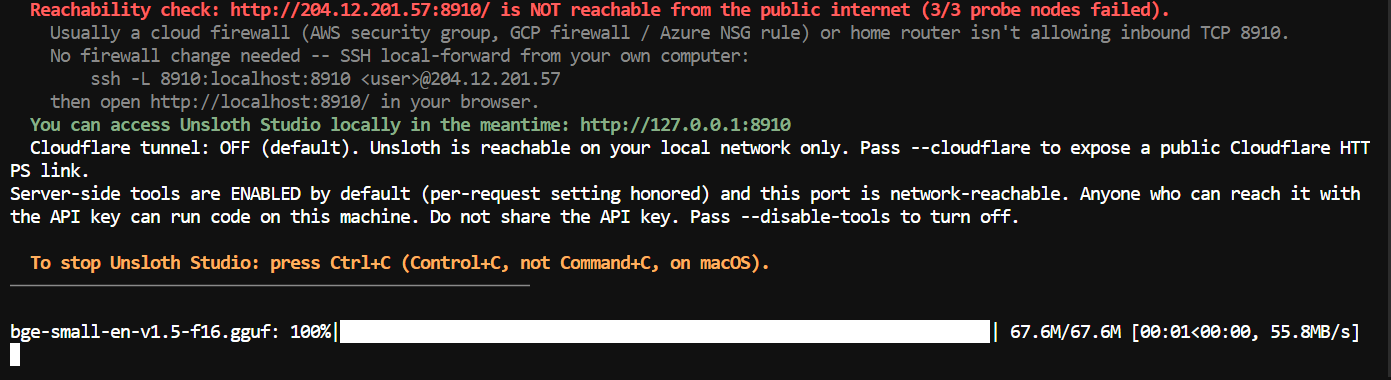
ขณะนี้ Studio ควรรายงานว่ากำลังรันบนพอร์ต 8910 ให้คง เทอร์มินัล 1 เปิดไว้ระหว่างใช้งาน Unsloth Studio และ OpenCode
กลับไปที่หน้า Connect ของ RunPod และเปิด HTTP Service สำหรับพอร์ต 8910.
ใช้รหัสผ่านชั่วคราวที่สร้างไว้ก่อนหน้าเพื่อทำการรีเซ็ตให้เสร็จ แล้วลงชื่อเข้าใช้ด้วยรหัสผ่านใหม่ที่สร้างไว้
ทำขั้นตอนแนะนำเริ่มต้นให้ครบหรือข้าม แล้วเปิดหน้า Chat
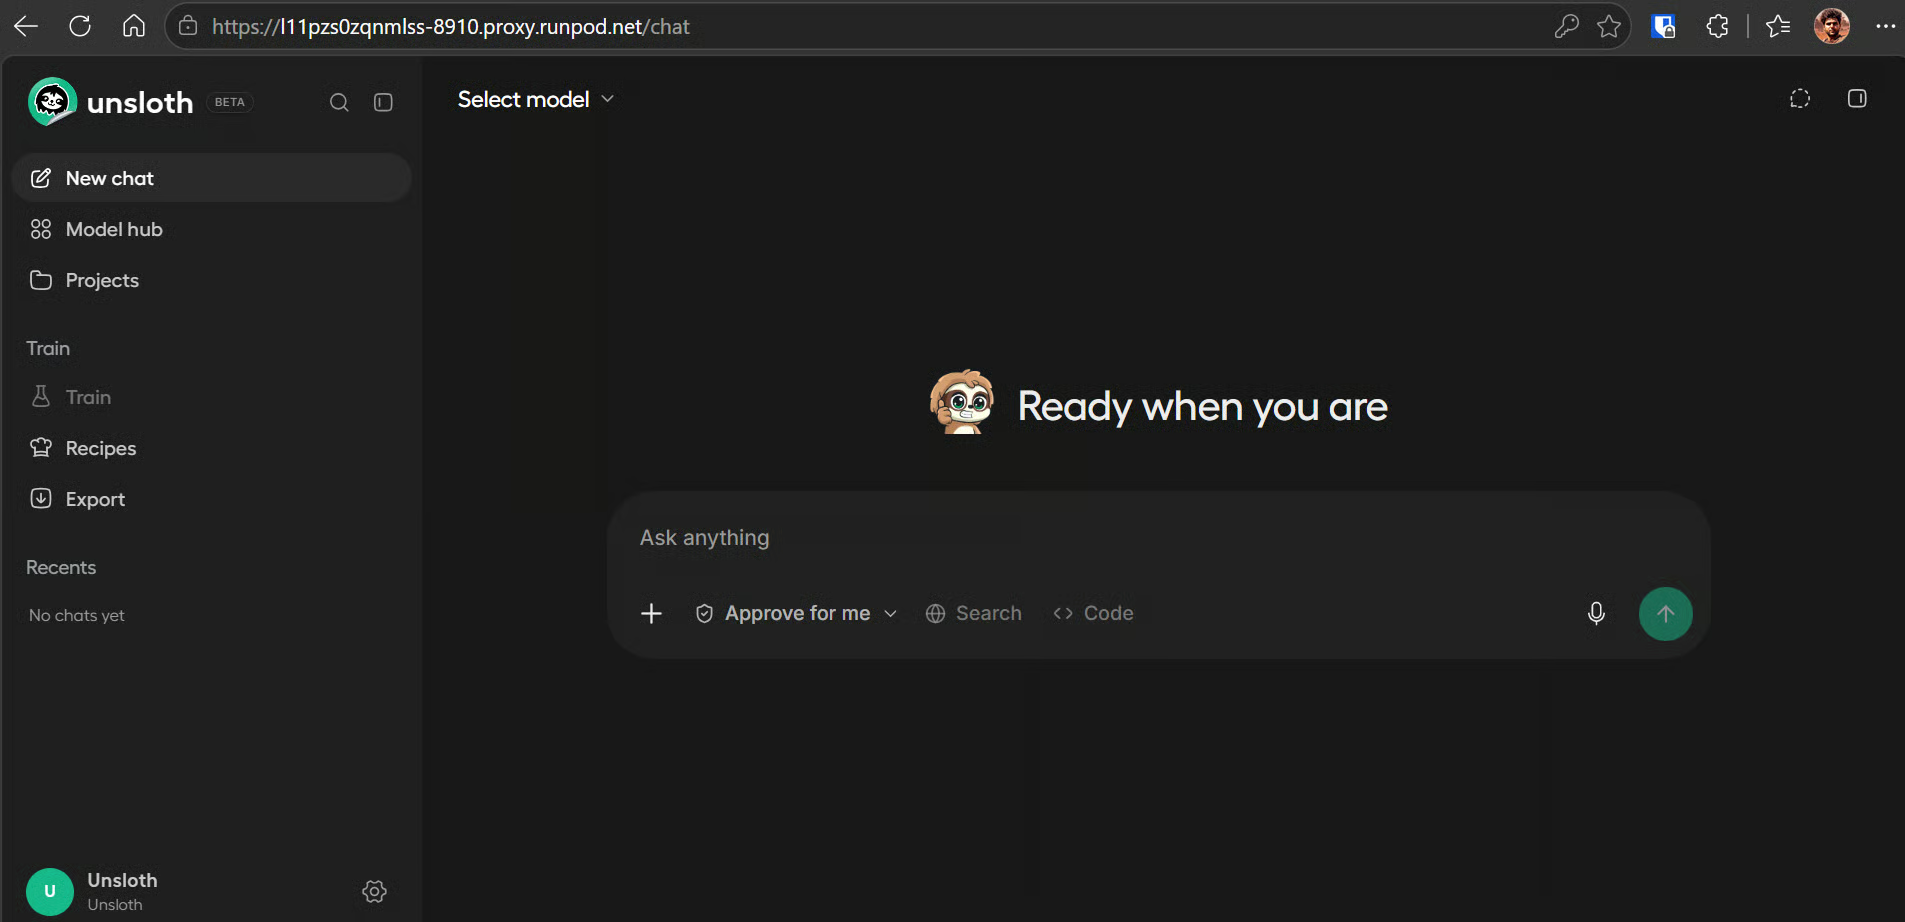
เมื่อ Unsloth Studio ทำงานแล้ว เราสามารถดาวน์โหลดโมเดล Q8 โหลดข้าม GPU ทั้งสาม และทดสอบความสามารถในการสนทนาและใช้เครื่องมือของมันได้
เปิดตัวเลือกโมเดลที่มุมซ้ายบน ค้นหา unsloth/DeepSeek-V4-Flash-0731-GGUF แล้วเลือกการควอนไทซ์ Q8 คือ UD-Q8_K_XL.
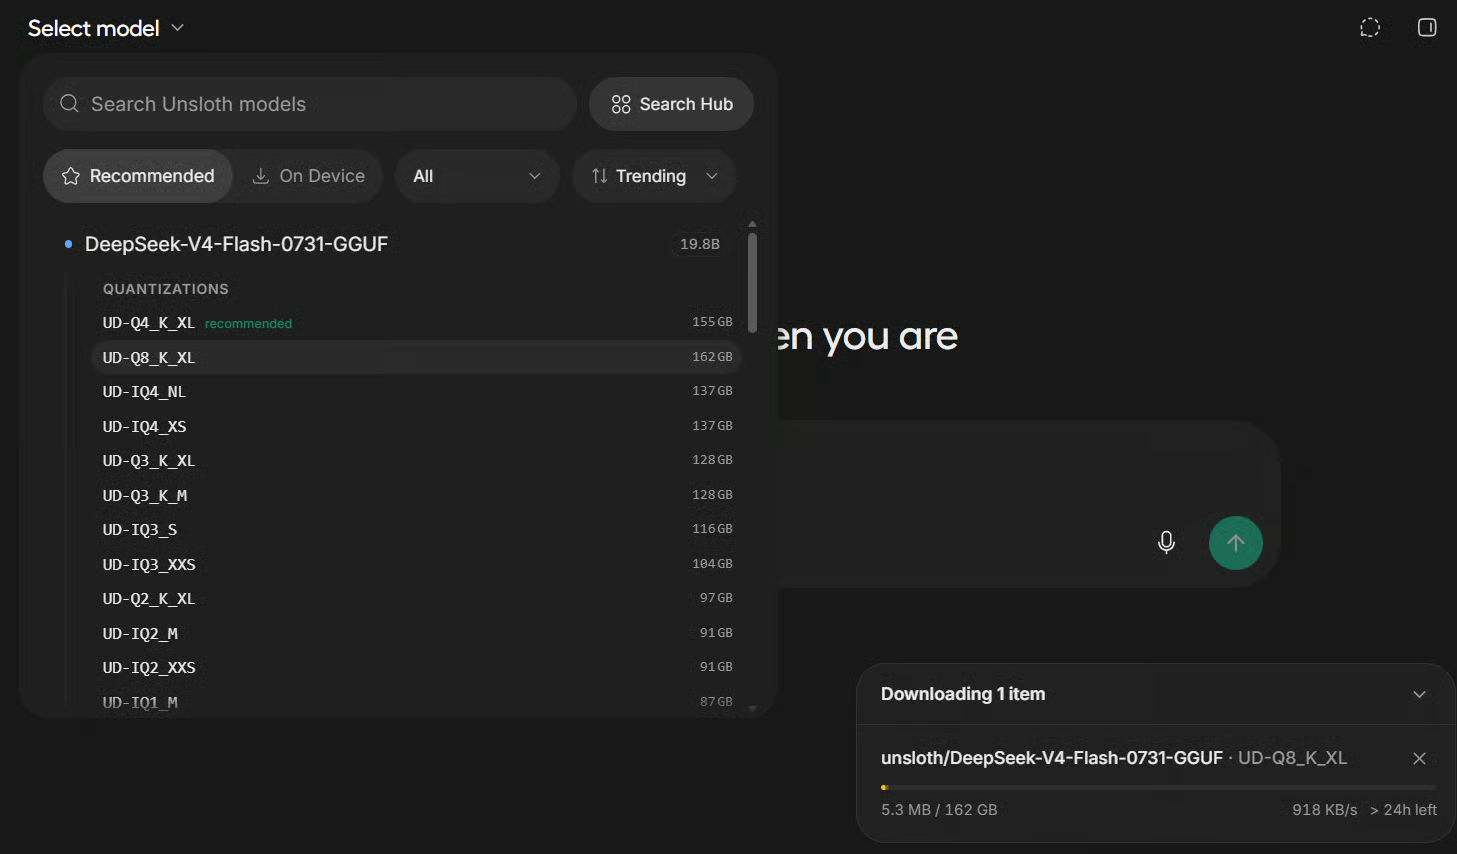
เราใช้ Q8 เพราะ GPU A100 สามตัวมี VRAM รวมเพียงพอ ช่วยคงคุณภาพใกล้ต้นฉบับ ขณะที่การควอนไทซ์ต่ำกว่าจะเหมาะเมื่อหน่วยความจำฮาร์ดแวร์จำกัด
เมื่อดาวน์โหลดเสร็จ Unsloth Studio จะเริ่มโหลดโมเดลเข้าสู่หน่วยความจำ GPU โดยอัตโนมัติ อาจใช้เวลาหลายนาทีเพราะโมเดล Q8 มีขนาดใหญ่มาก
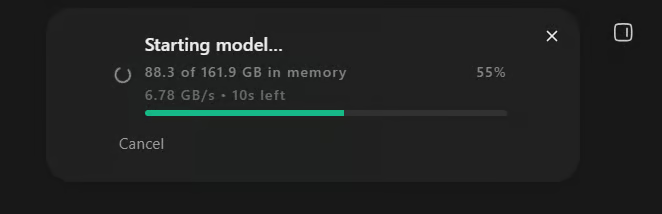
หลังโหลดเสร็จ ใช้หน้า Chat เพื่อทดสอบโมเดลด้วยพรอมต์ง่าย ๆ ไม่กี่รายการ
ในการทดสอบของเรา ความเร็วการสร้างผลลัพธ์อยู่ที่ประมาณ 33 โทเคนต่อวินาที โดยไม่ใช้ speculative decoding ซึ่งถือว่าเหมาะสมสำหรับโมเดลขนาดนี้
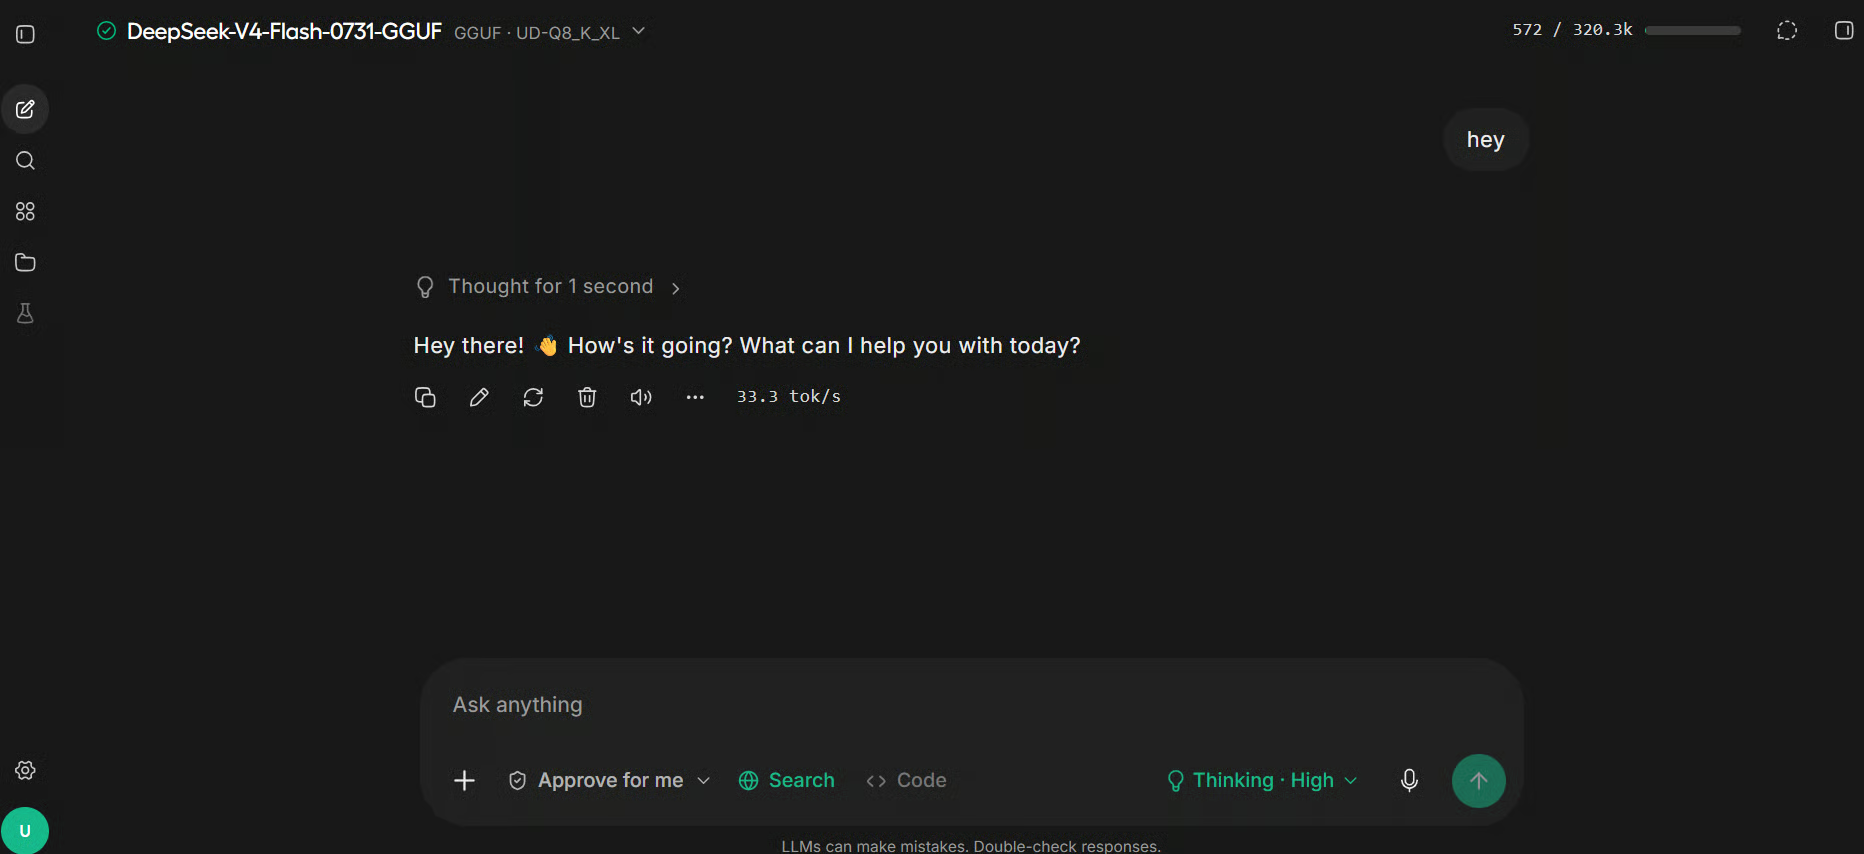
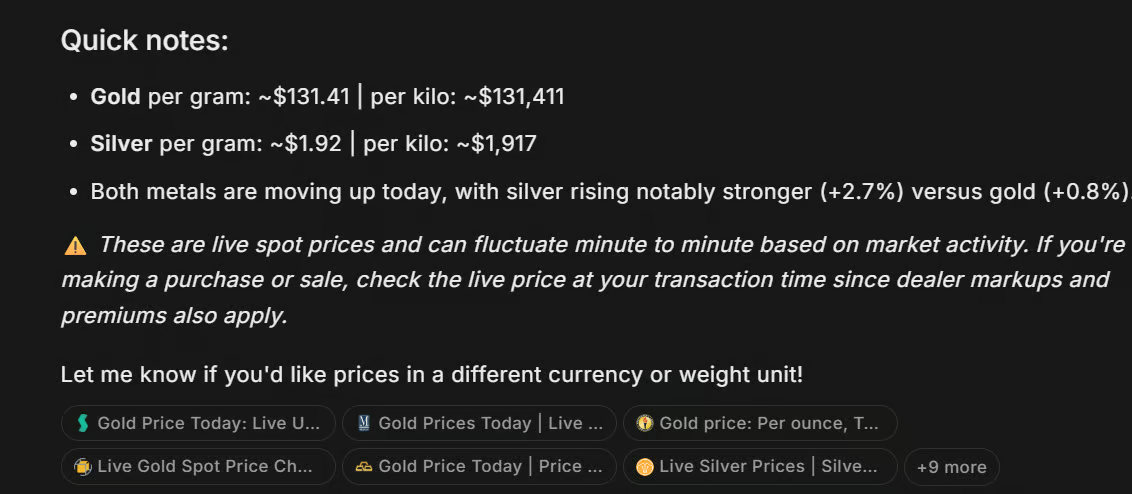
ยังสามารถเปิดใช้เครื่องมือค้นเว็บของ Studio และให้โมเดลค้นหาข้อมูลปัจจุบัน เช่น ราคาทองคำและเงินล่าสุด วิธีนี้ช่วยยืนยันว่าโมเดลสามารถเรียกใช้เครื่องมือภายนอกได้ ไม่ได้อาศัยเฉพาะความรู้ภายในเท่านั้น
ที่ เทอร์มินัล 2 ตรวจสอบว่าโมเดลถูกกระจายไปยัง GPU อย่างไร:
nvidia-smi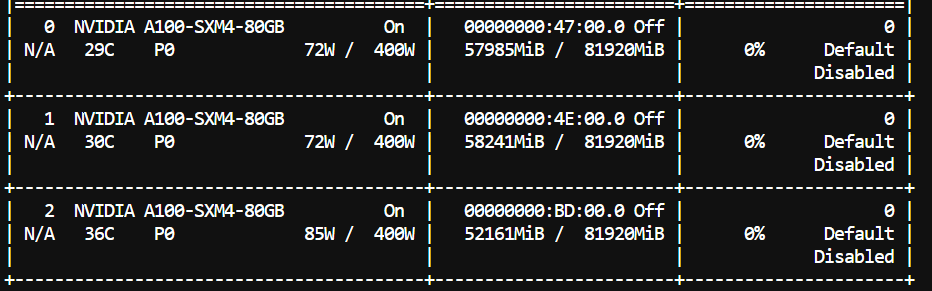
ควรเห็นการใช้หน่วยความจำจำนวนมากบน GPU ทั้งสามตัว
ในการทดสอบของเรา GPU แต่ละตัวถูกใช้ไปประมาณ 70% อย่างไรก็ตาม นั่นไม่ได้หมายความว่าโมเดล Q8 เต็มรูปจะพอเพียงกับ GPU 80GB แค่สองตัว เพราะยังต้องใช้ VRAM เพิ่มเติมสำหรับหน้าต่างบริบท KV cache และบัฟเฟอร์อนุมาน
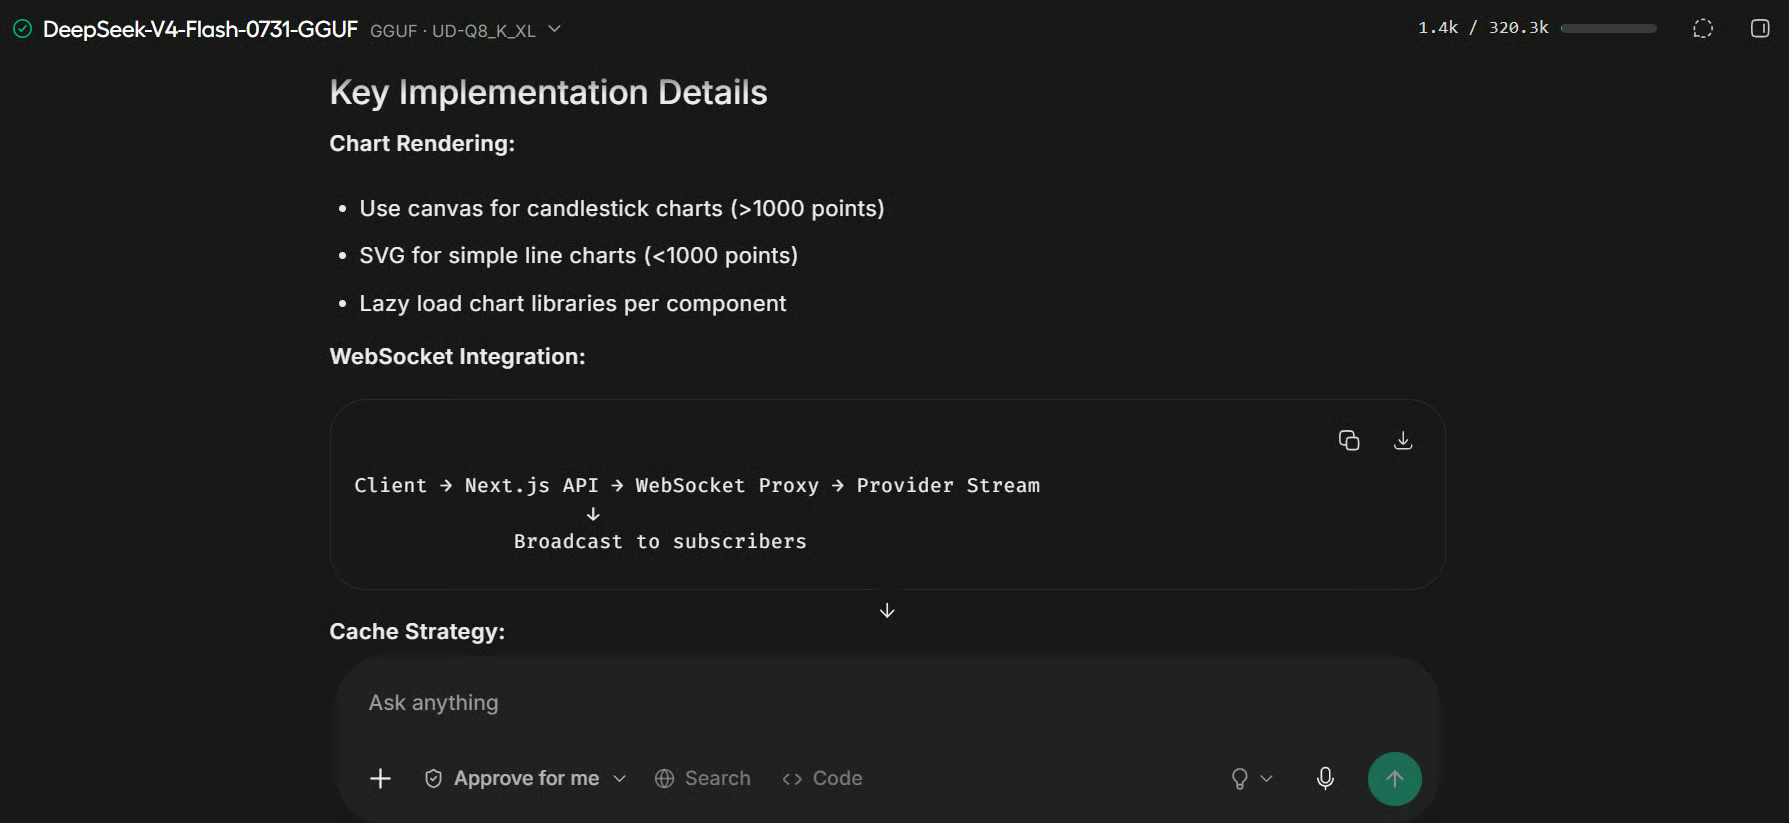
สุดท้าย ทดสอบโมเดลด้วยพรอมต์การวางแผนสำหรับแอปที่เราจะสร้าง:
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
โมเดลจะส่งคืนแผนพัฒนาแบบมีโครงสร้าง ครอบคลุมสถาปัตยกรรมแอป คอมโพเนนต์ การไหลของข้อมูล ไลบรารีกราฟ การคำนวณทางการเงิน และการออกแบบอินเทอร์เฟซ
เมื่อโมเดลทำงานใน Unsloth Studio แล้ว เราสามารถเชื่อมต่อกับ OpenCode และใช้เป็นเอเจนต์เขียนโค้ดแบบโลคอลได้
ที่ เทอร์มินัล 3 ตั้งค่า URL ของ Studio:
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
สร้างไดเรกทอรีโปรเจกต์ใหม่:
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
เริ่ม OpenCode ผ่าน Unsloth Studio:
unsloth start opencodeครั้งแรกที่รันคำสั่งนี้ ระบบจะขออนุญาตติดตั้ง OpenCode ให้พิมพ์ “y”
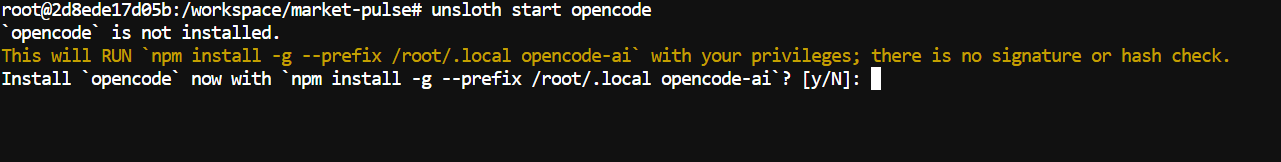
เมื่อติดตั้งเสร็จ OpenCode จะเปิดขึ้นโดยกำหนดค่าโมเดล DeepSeek-V4-Flash-0731 ที่รันแบบโลคอลไว้เรียบร้อยแล้ว
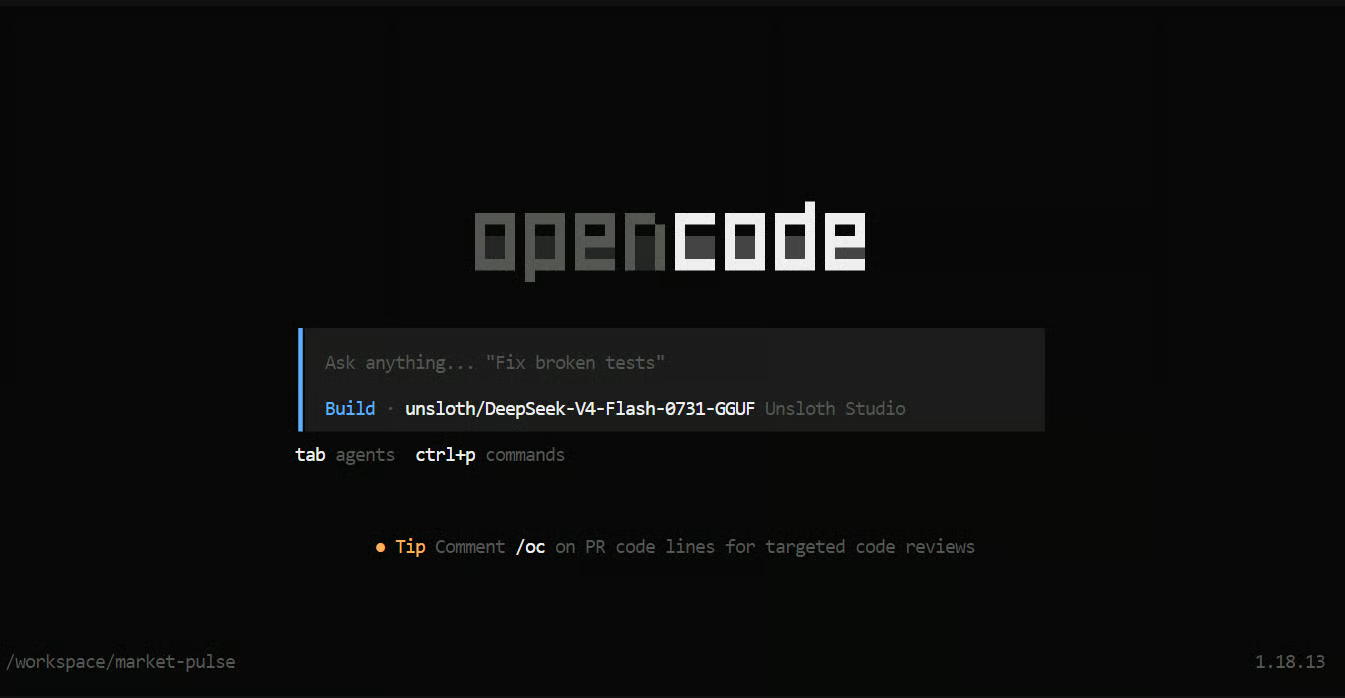
วางพรอมต์สองบรรทัดต่อไปนี้ลงใน OpenCode:
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
ภายในไม่กี่วินาที เอเจนต์เขียนโค้ดจะสร้างรายการงานอย่างละเอียดและเริ่มทำโปรเจกต์ทีละขั้นตอน
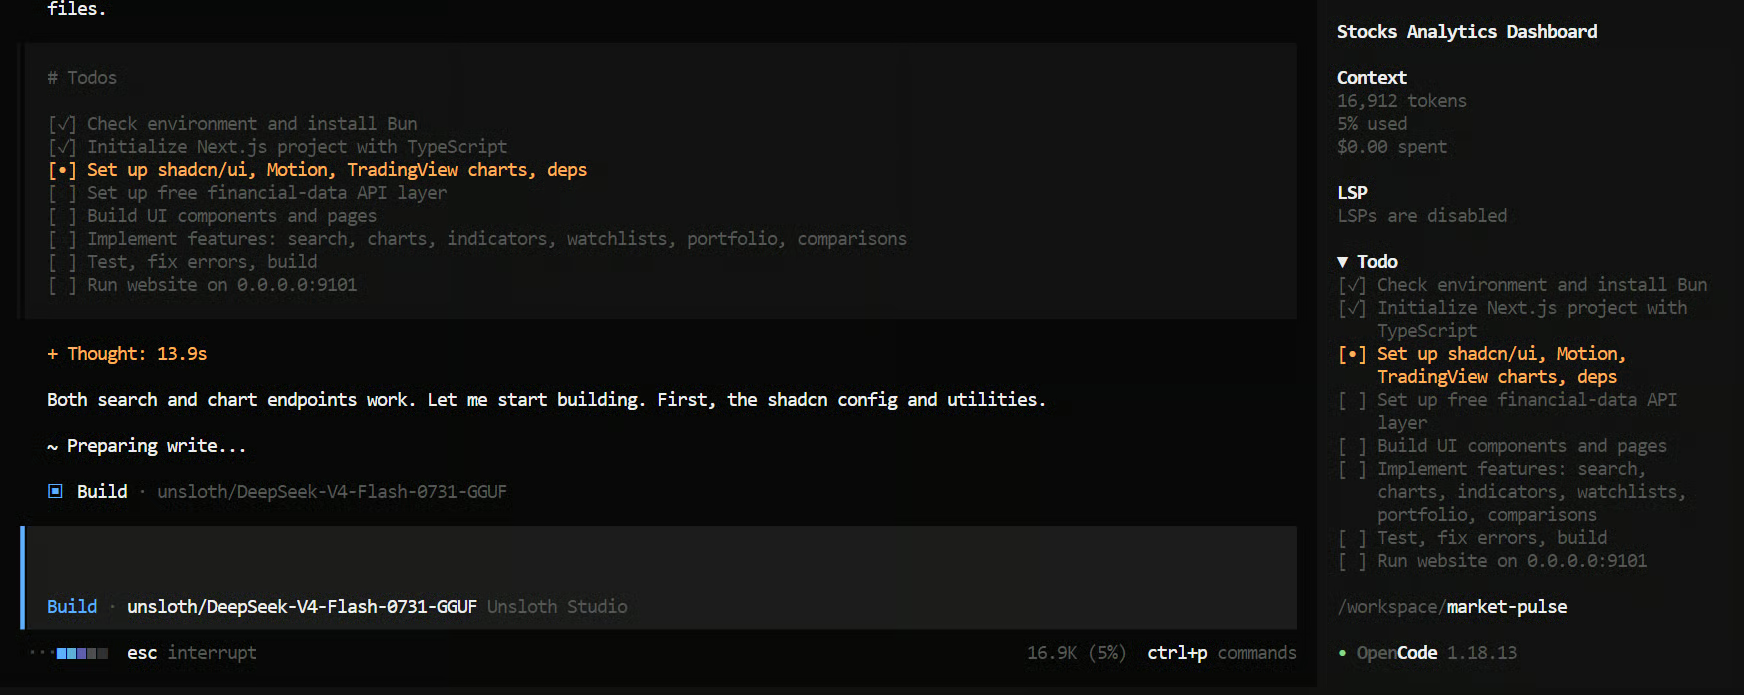
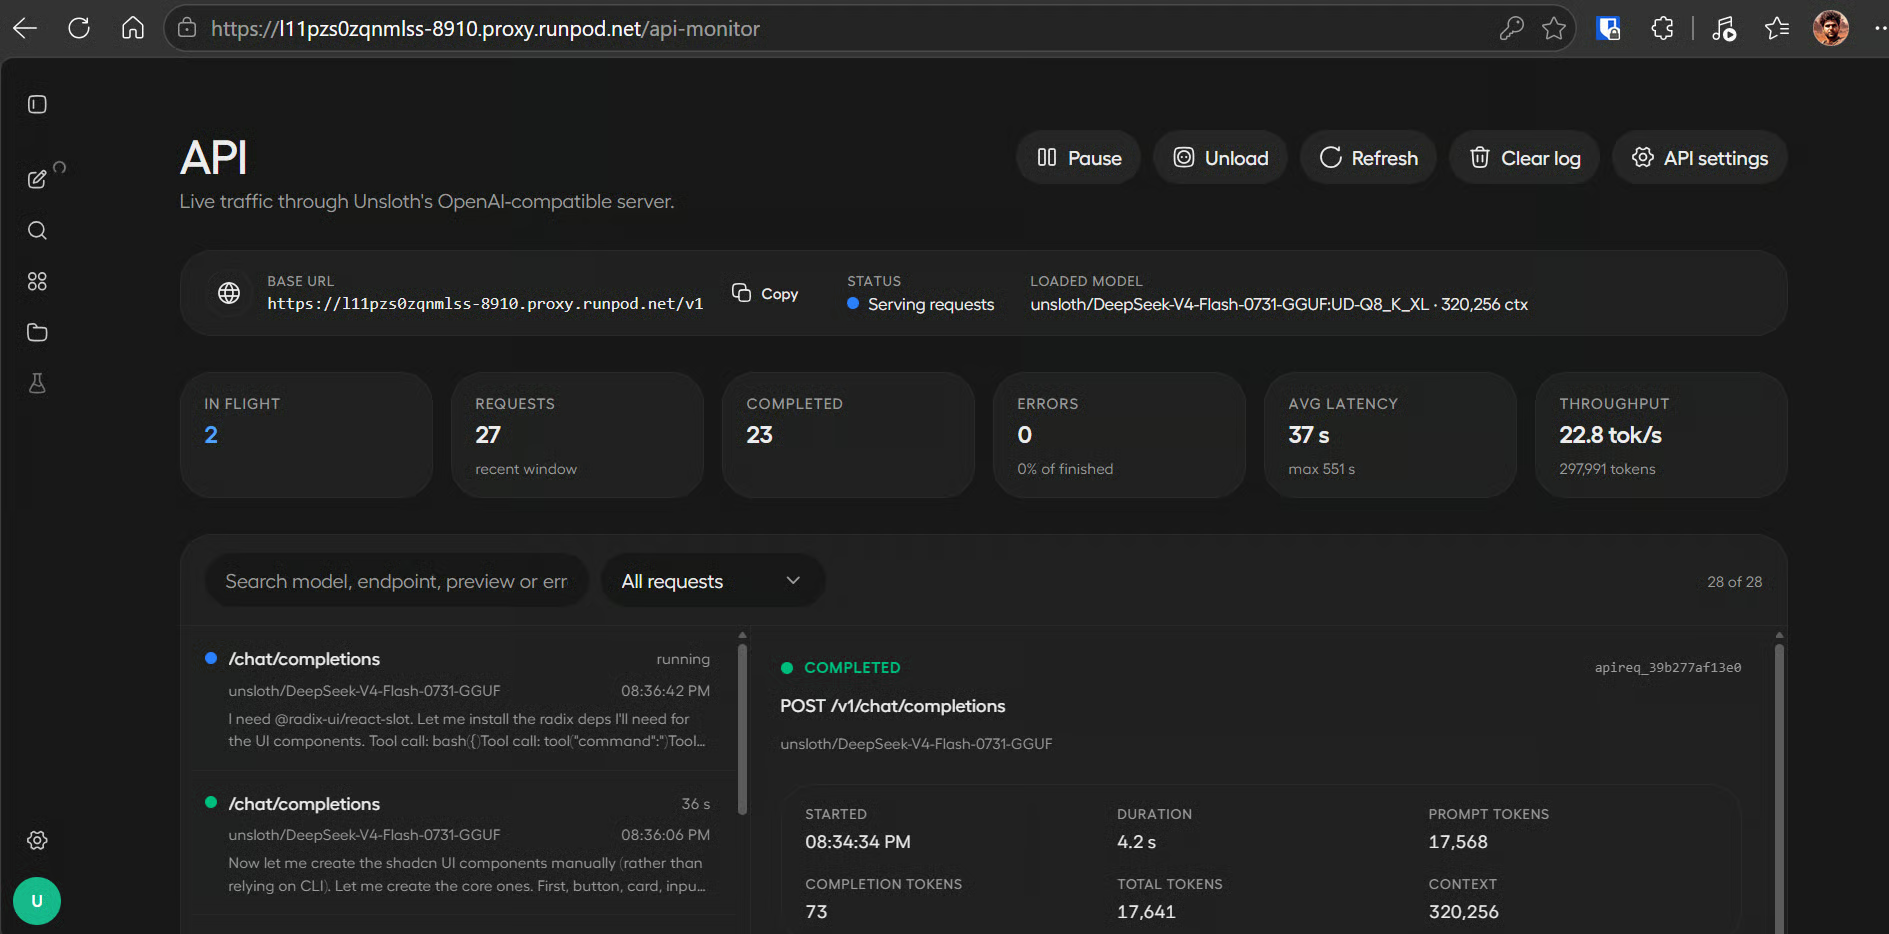
การบิลด์เต็มรูปใช้เวลาประมาณ 20 นาทีในการทดสอบของเรา ระหว่างที่กำลังทำงาน สามารถกลับไปที่ Unsloth Studio และเปิดหน้าติดตาม API ใน Settings เพื่อติดตามการใช้งานโมเดลและความเร็วการสร้างผลลัพธ์
22.6 โทเคนต่อวินาที โดยเฉลี่ยในเวิร์กโฟลว์การเขียนโค้ดที่สังเกตได้ ความเร็วอาจลดลงเมื่อบริบทการสนทนาและโปรเจกต์เพิ่มขึ้น
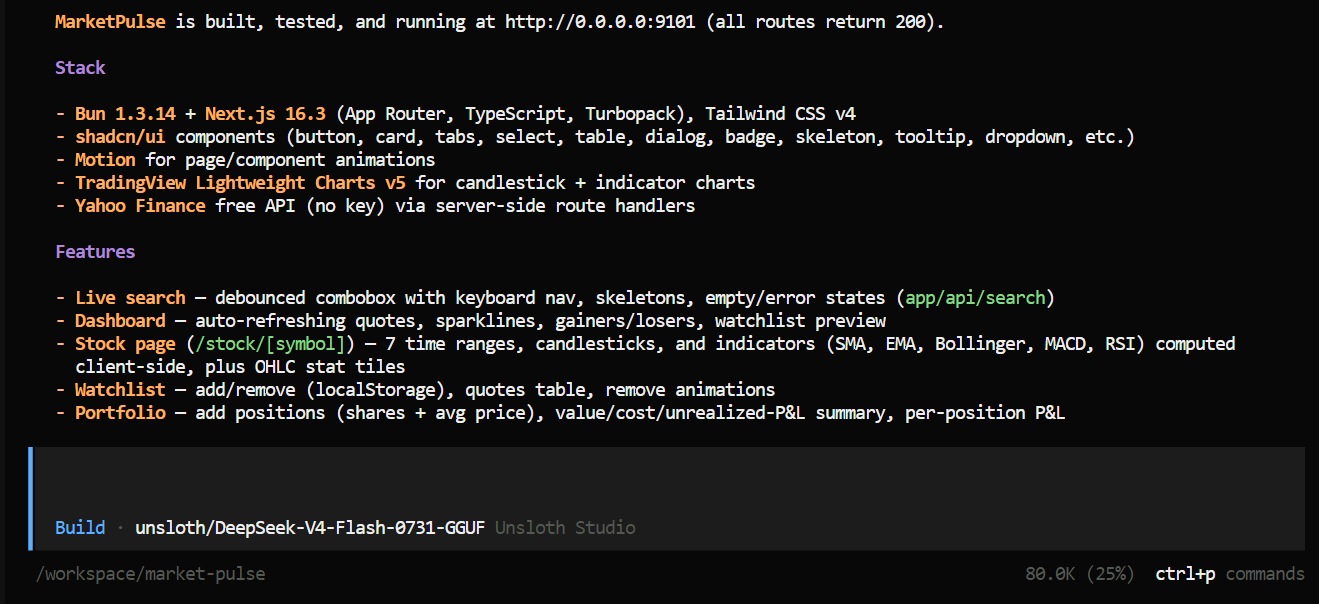
เมื่อทำงานเสร็จ OpenCode จะสรุปรายการไฟล์ ฟีเจอร์ และคำสั่งที่สร้าง พร้อมทั้งเริ่มเว็บไซต์ที่เสร็จสมบูรณ์บนพอร์ต 9101.
กลับไปที่หน้า Connect ของ RunPod และเปิด HTTP Service สำหรับพอร์ต 9101.
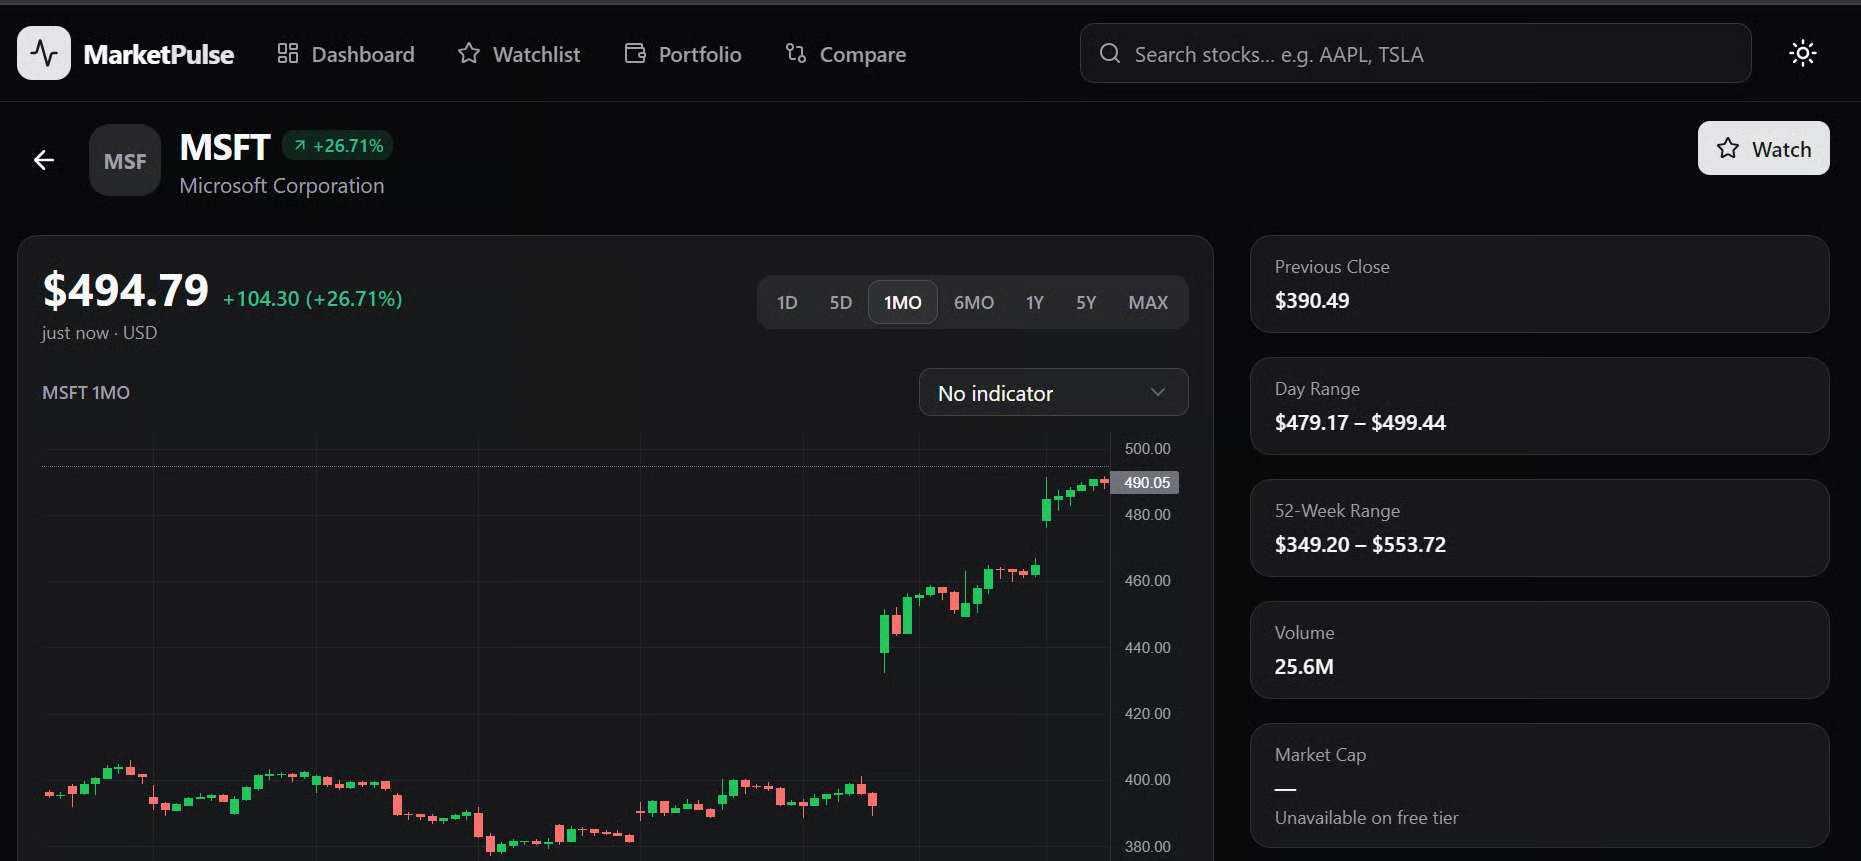
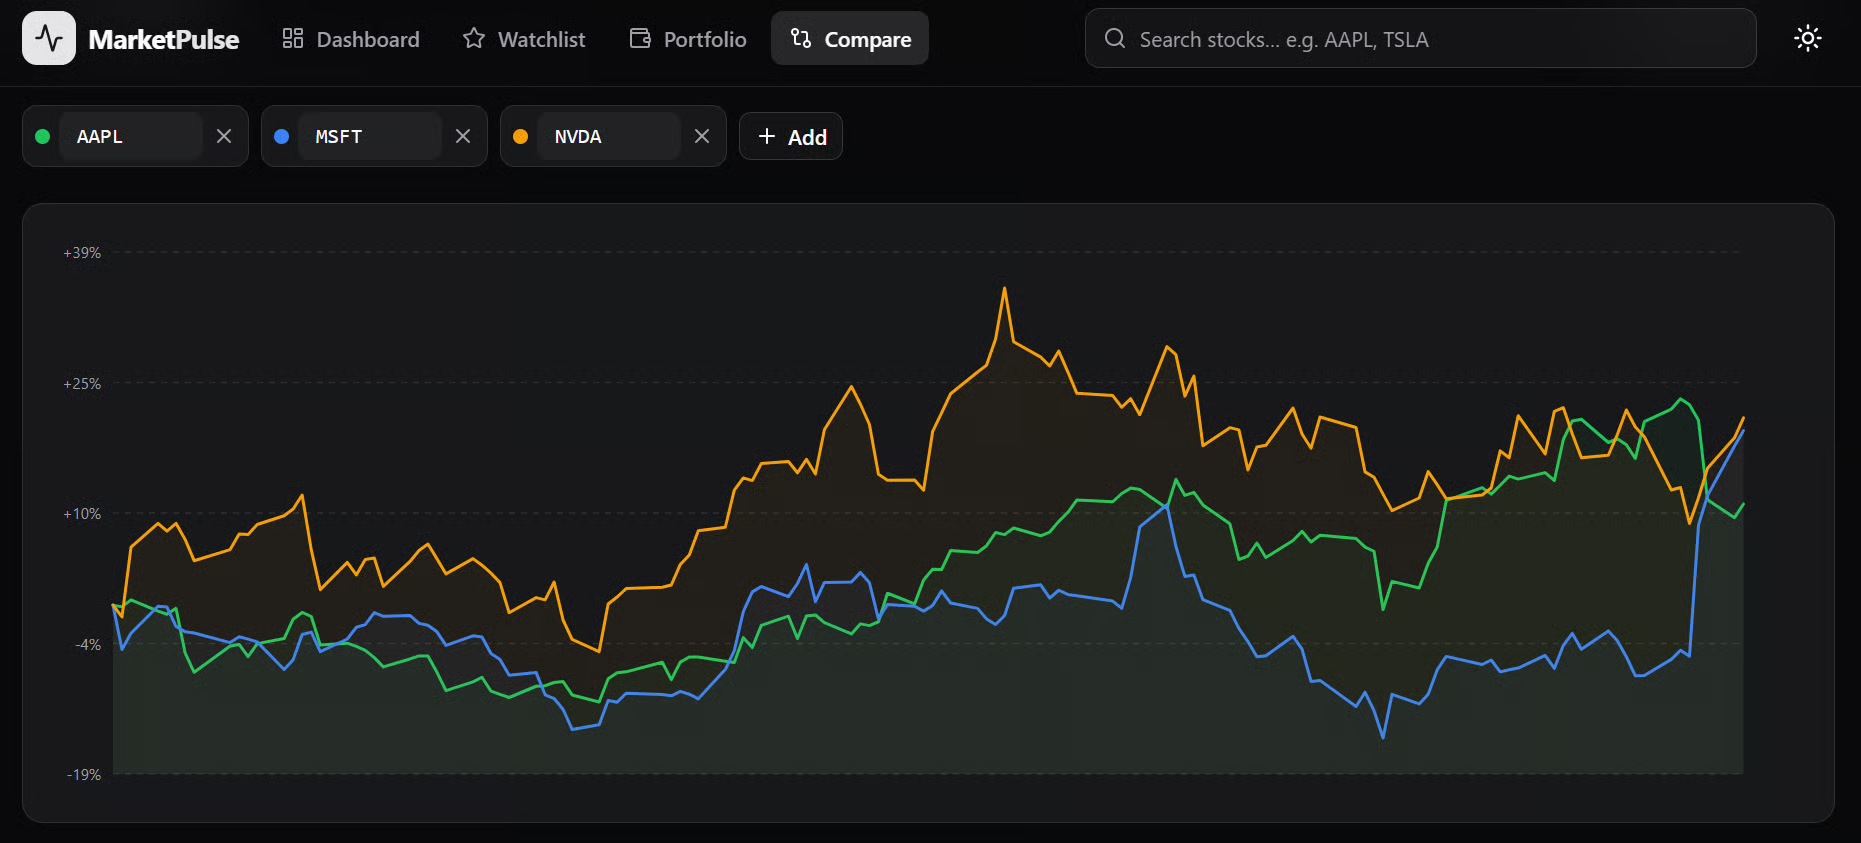
ผลลัพธ์ออกมาดูดีเกินคาด เว็บไซต์ดูสะอาดตา มีแอนิเมชัน และคล้ายแดชบอร์ดเทรดมืออาชีพ โมเดลสร้างเว็บแอปพลิเคชันเสร็จในพรอมต์เดียว ทั้งอินเทอร์เฟซ มุมมองข้อมูล กราฟ และการนำทาง
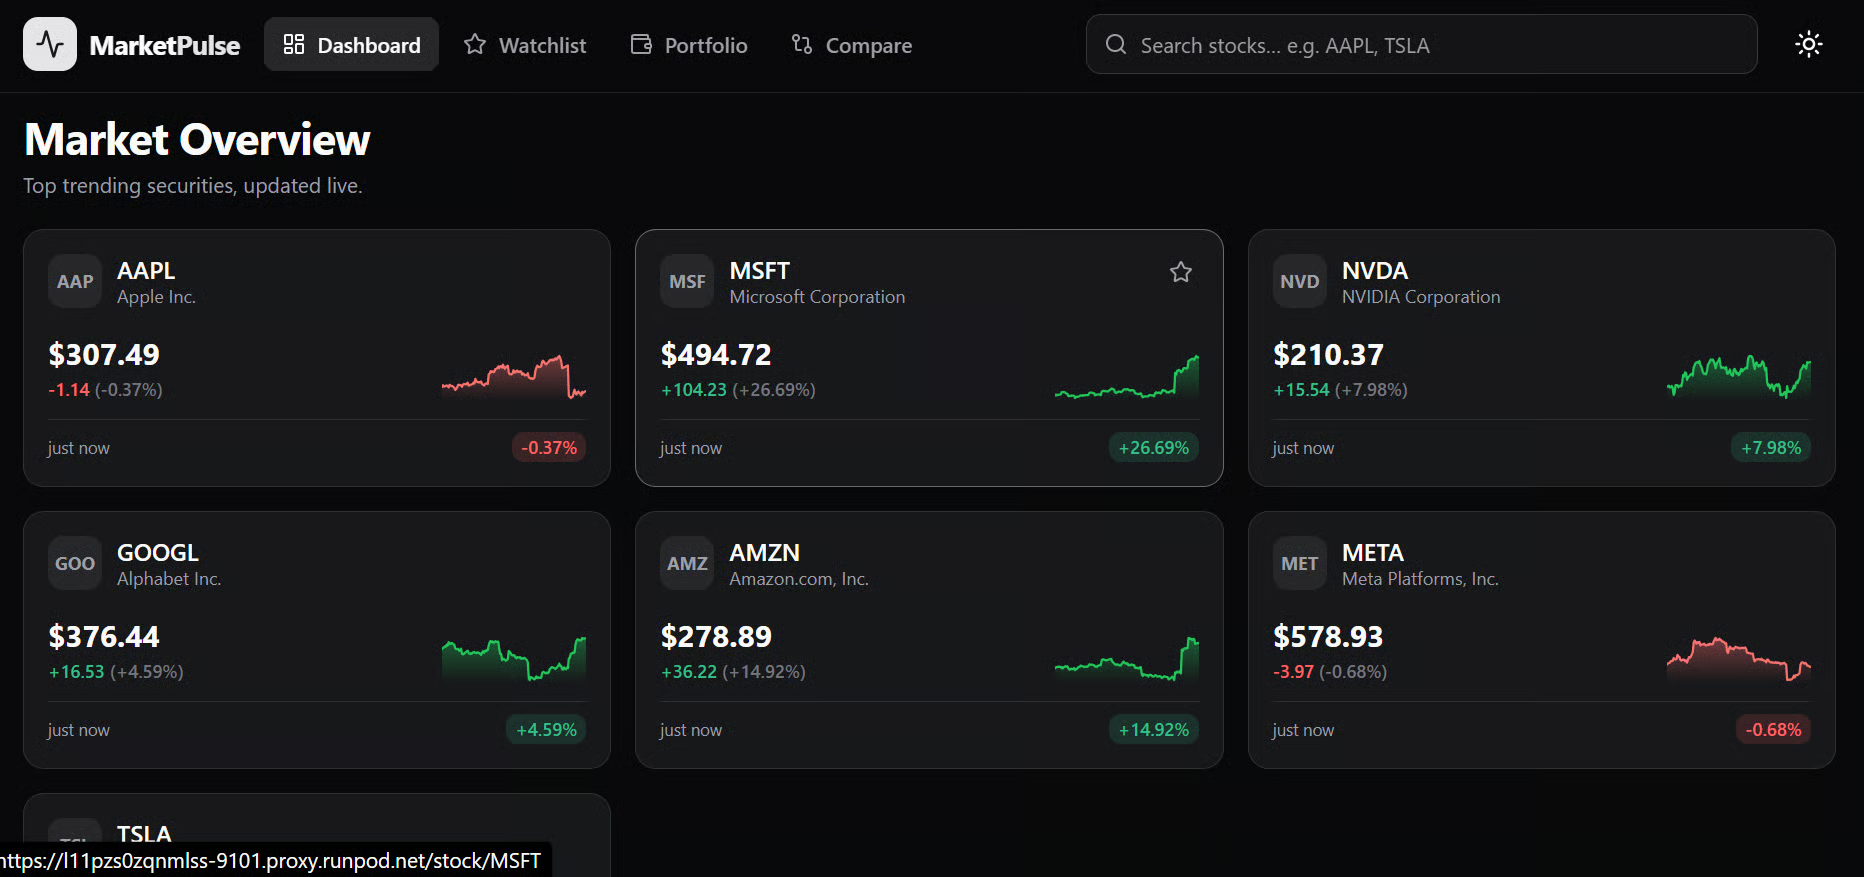
สามารถเลือกสัญลักษณ์หุ้นรายตัวเพื่อดูกราฟแท่งเทียน ผลการดำเนินงานย้อนหลัง อินดิเคเตอร์ และข้อมูลบริษัทเพิ่มเติม
แท็บ Compare ยังให้เปรียบเทียบหุ้นหลายตัวและดูว่าตัวไหนทำได้ดีกว่าในช่วงเวลาที่เลือก
ยอมรับตามตรงว่าแปลกใจที่โมเดลโลคอลขนาดเล็กกว่าสามารถสร้างเว็บไซต์ทั้งเว็บได้จากพรอมต์เดียว
หลังทดสอบแอปแล้ว ทุกฟีเจอร์หลักทำงานตามที่ตั้งใจไว้ รวมถึงราคาหุ้นสด ข้อมูลตลาดย้อนหลัง กราฟ อินดิเคเตอร์ และเครื่องมือเปรียบเทียบ
น่าทึ่งที่โมเดลโลคอลพัฒนาเร็วมากและสามารถทำงานพัฒนาแบบ end-to-end ที่ซับซ้อนได้อย่างมีความสามารถ
สำหรับฉัน DeepSeek-V4-Flash-0731 เป็นโมเดลโลคอลที่ดีที่สุดเท่าที่เคยทดสอบมาในตอนนี้
มันทำได้ดีกว่า Inkling การควอนไทซ์ GLM-5.2 แบบ 2 บิต และ Qwen3.6-27B ซึ่งก่อนหน้านี้เป็นตัวโปรดของฉัน ข้อนี้อ้างอิงจากประสบการณ์ใช้งานเอง ไม่ใช่เบนช์มาร์กอย่างเป็นทางการ แต่ตอนนี้มันคือโมเดลโลคอลที่ฉันเลือกใช้
สำหรับงานจริงส่วนใหญ่ ฉันยังคงเริ่มจาก DeepSeek API อย่างเป็นทางการเพราะมีราคาถูกมาก
ค่าใช้จ่ายของ V4 Flash ปัจจุบันคือ $0.14 ต่อหนึ่งล้านโทเคนอินพุตที่ไม่แคช $0.0028 ต่อหนึ่งล้านโทเคนอินพุตที่แคชแล้ว และ $0.28 ต่อหนึ่งล้านโทเคนเอาต์พุต ที่อัตรานี้ หนึ่งพันล้านโทเคนอินพุตที่แคชแล้วจะมีค่าใช้จ่ายราว $2.80 ก่อนคิดค่าเอาต์พุต
ก่อนตัดสินใจใช้ Unsloth Studio ฉันได้ลองรันโมเดลผ่าน llama.cpp ตัวติดตั้งสำเร็จรูปไม่มีไบนารี CUDA รุ่นใหม่ที่เหมาะกับสภาพแวดล้อมของฉัน และแม้จะคอมไพล์รุ่นล่าสุดจากซอร์สสำเร็จ ก็ยังเจอปัญหาเพิ่มเติมเมื่อเปิดใช้ DSpark speculative decoding
ท้ายที่สุด Unsloth Studio ให้การตั้งค่าที่ง่ายที่สุดและลดการกำหนดค่าด้วยตนเองลงอย่างมาก ทำงานร่วมกับ OpenCode ได้ดี แม้การบิลด์แอปพลิเคชันเต็มรูปจะใช้เวลาประมาณ 20 นาที
หลักสูตรยอดนิยมจาก DataCamp
Courses
Courses
Tracks