Course
Разработка с помощью ИИ: курс для разработчиков
1 ч 30 мин
9.9K
Меньшие и более быстрые модели больше не означают автоматически меньшую способность. Согласно опубликованным оценкам DeepSeek, DeepSeek-V4-Flash-0731 использует гораздо меньший объём активируемых параметров, чем DeepSeek-V4-Pro, при этом демонстрируя почти передовой уровень агентных возможностей: она набирает 82,7 в Terminal Bench 2.1 против 81,0 у GLM-5.2 и 85,0 у Opus 4.8, а её результат в 25,2 в Agents’ Last Exam близок к 25,7 у Opus 4.8.
Поскольку веса доступны открыто, теоретически вы можете запускать модель на собственном оборудовании при наличии достаточного суммарного объёма RAM или VRAM, сохраняя управление инференсом и данными проекта.
В этом руководстве мы настроим окружение RunPod с тремя GPU, установим и запустим Unsloth Studio, скачаем и загрузим версию DeepSeek-V4-Flash-0731 в квантизации Q8 на несколько GPU, протестируем модель через Studio, подключим локальный сервер инференса к OpenCode и с помощью кодирующего агента соберём и запустим интерактивный сайт аналитики акций.
DeepSeek-V4-Flash-0731 — это официальный релиз, заменяющий раннюю превью-версию, с серьёзными улучшениями в кодинге, использовании инструментов и автономных агентных задачах. Архитектура Mixture-of-Experts активирует лишь часть модели для каждого токена. Это помогает сохранять эффективность при высокой производительности.
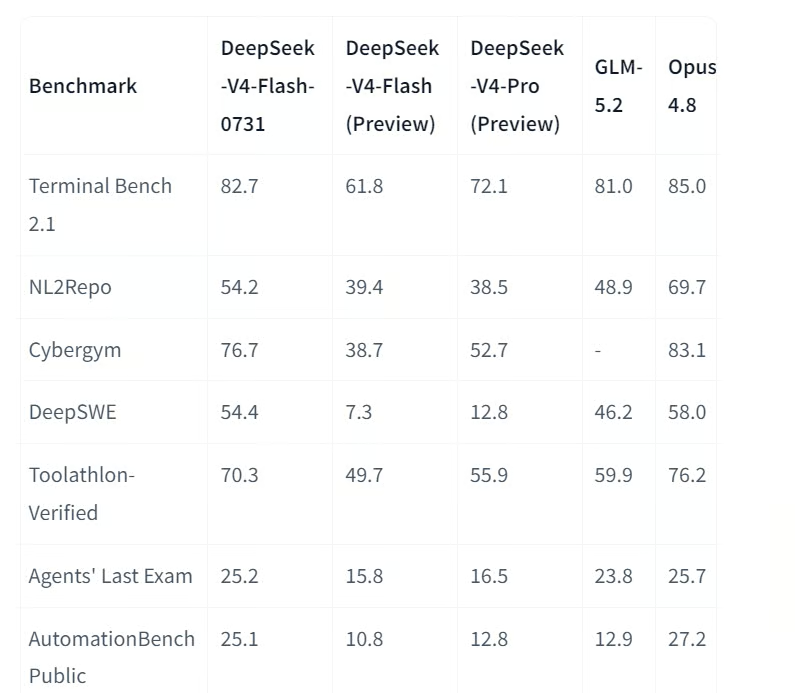
Источник: deepseek-ai/DeepSeek-V4-Flash-0731 · Hugging Face
По данным DeepSeek, модель улучшилась с 61,8 до 82,7 в Terminal Bench 2.1 и с 7,3 до 54,4 в DeepSWE. Она также превзошла более крупную DeepSeek-V4-Pro Preview в нескольких агентных бенчмарках.
Модель поддерживает окна контекста до одного миллиона токенов. Это делает её подходящей для больших кодовых баз, длинных документов и сложных рабочих процессов, требующих значительного контекста. Пользователь также может выбирать между низким, высоким и максимальным уровнем рассуждений в зависимости от требуемого времени на решение задачи.
DeepSeek-V4-Flash-0731 также включает спекулятивное декодирование DSpark. DSpark предварительно черновиком генерирует несколько токенов, прежде чем основная модель их верифицирует, что, как утверждает DeepSeek, может повысить скорость генерации на 60–85% при использовании совместимого движка инференса.
Начнём с создания окружения RunPod с достаточным объёмом памяти GPU и хранилища для запуска версии DeepSeek-V4-Flash-0731 в Q8, а также размещения Unsloth Studio и сайта, который создаст OpenCode.
Настройте Pod со следующими параметрами:
/workspace в качестве точки монтирования постоянного томаHF_TOKEN8910 и 9101 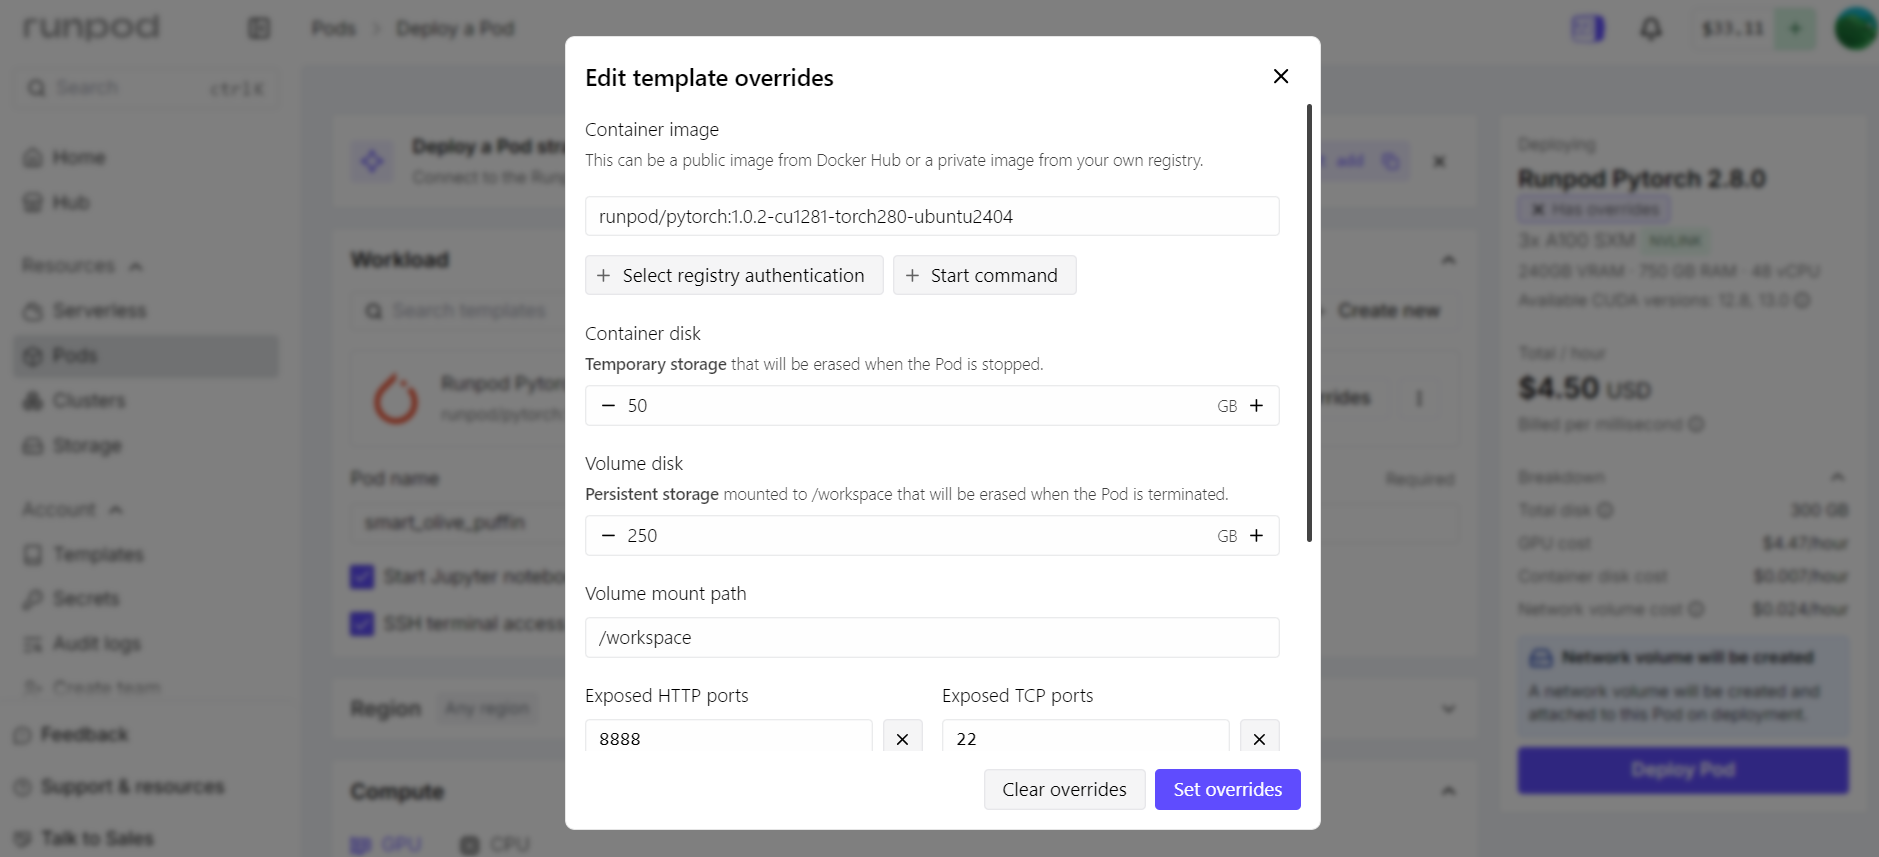
Порт 8910 будет использоваться для Unsloth Studio и его локального API инференса. Порт 9101 будет хостить интерактивный сайт, созданный OpenCode.
RunPod публикует эти сервисы через свой HTTP-прокси, поэтому оба приложения должны слушать на адресе 0.0.0.0, а не только на 127.0.0.1.
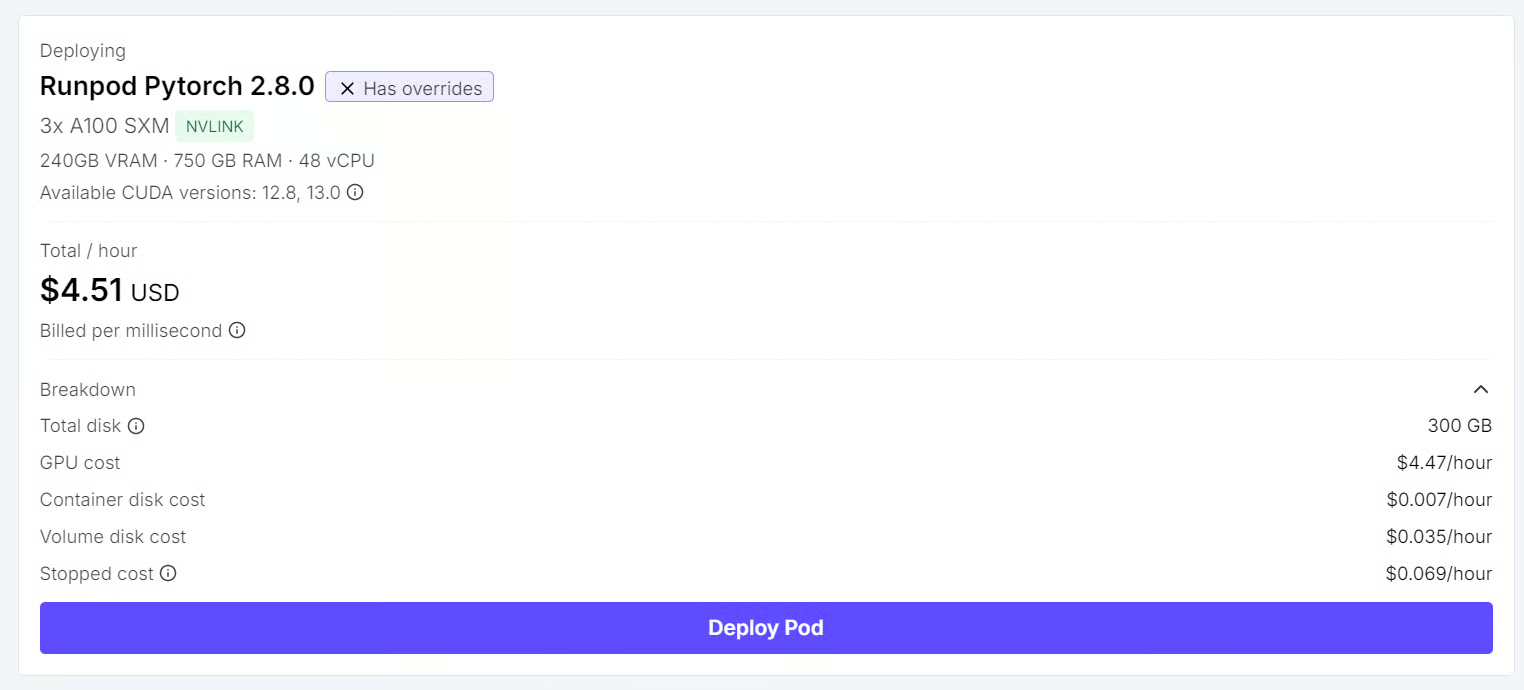
После развёртывания Pod откройте вкладку Connect, запустите JupyterLab и создайте три терминальные сессии:
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
Поддержание задач в отдельных терминалах упрощает мониторинг GPU, устранение неполадок модели и одновременный запуск кодирующего агента.
Далее мы установим Unsloth Studio, настроим постоянный кэш Hugging Face и запустим интерфейс на порту 8910.
В Терминале 1 убедитесь, что доступны все три GPU:
nvidia-smiВы должны увидеть все три A100 GPU, перечисленные на Linux-сервере.
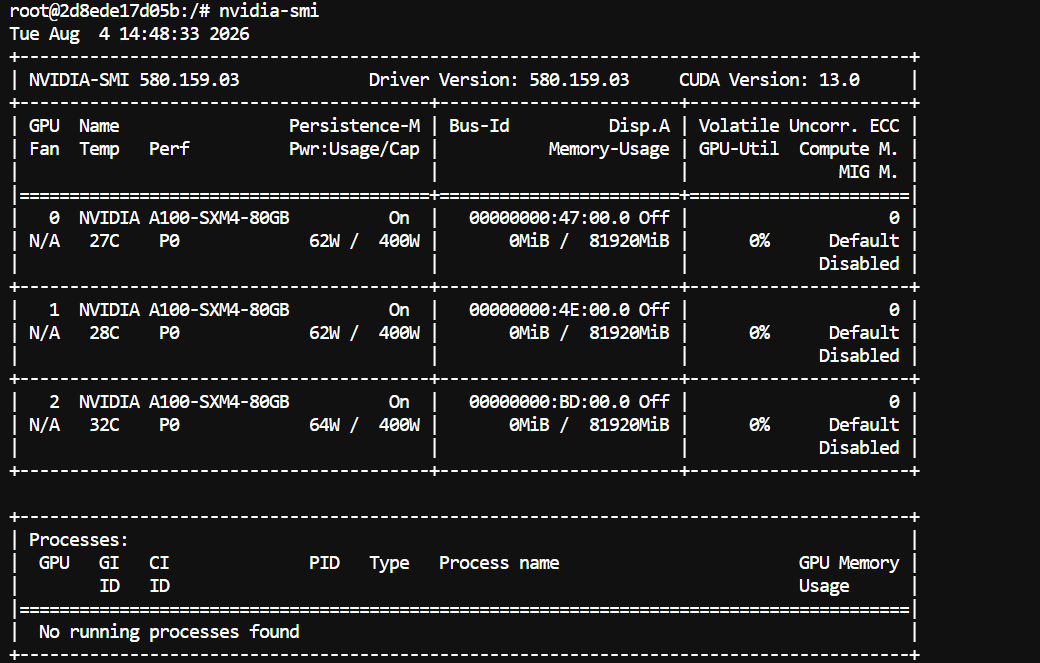
Создайте постоянный кэш Hugging Face внутри /workspace, чтобы загруженные модели оставались доступными на томе RunPod:
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
Затем установите необходимые системные пакеты и Unsloth Studio:
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh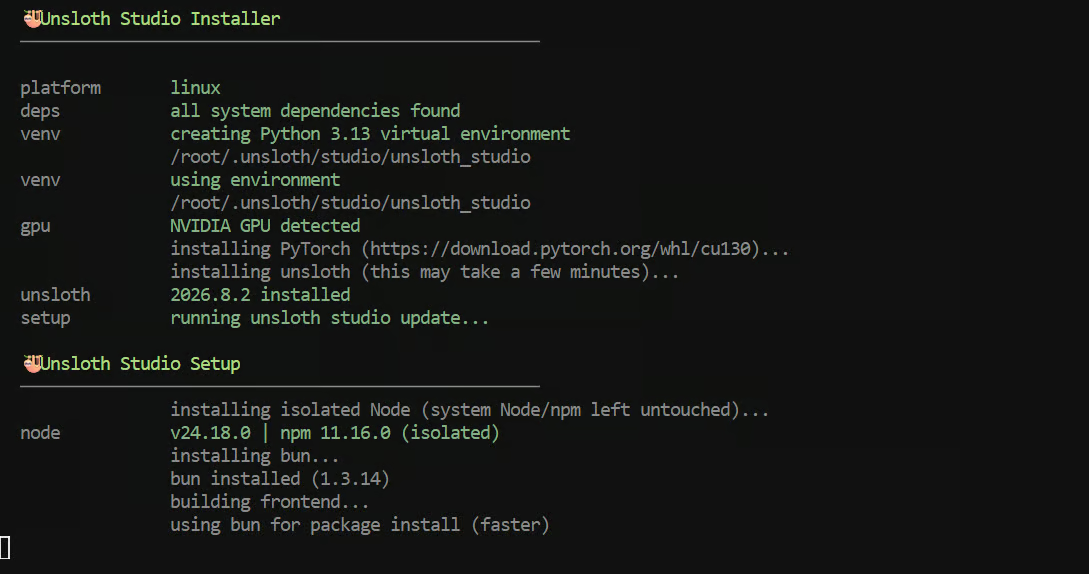
Установщик настраивает интерфейс Studio, окружение Python, зависимости и компоненты локального инференса.
Первая установка может занять несколько минут.
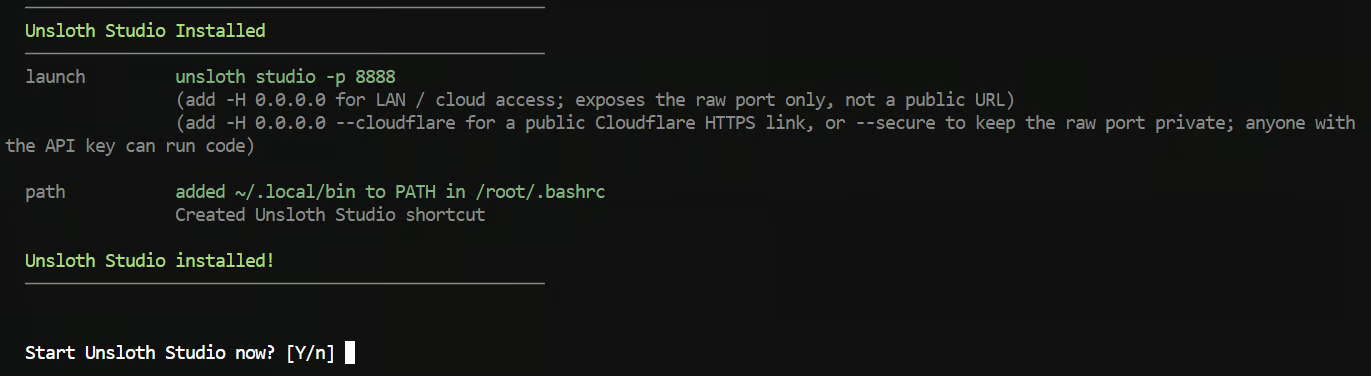
Когда установщик спросит, хотите ли вы сразу запустить Unsloth Studio, введите «n».
Мы запустим его вручную, чтобы он использовал порт 8910 и слушал нужный сетевой адрес.
Перезапустите оболочку, чтобы новые команды стали доступны:
exec bash
cd /workspace
Перед запуском Studio сбросьте пароль по умолчанию:
unsloth studio reset-passwordСкопируйте временный пароль, показанный во время настройки, так как он может понадобиться для завершения сброса.
Теперь запустите Unsloth Studio:
unsloth studio \
  -H 0.0.0.0 \
  -p 8910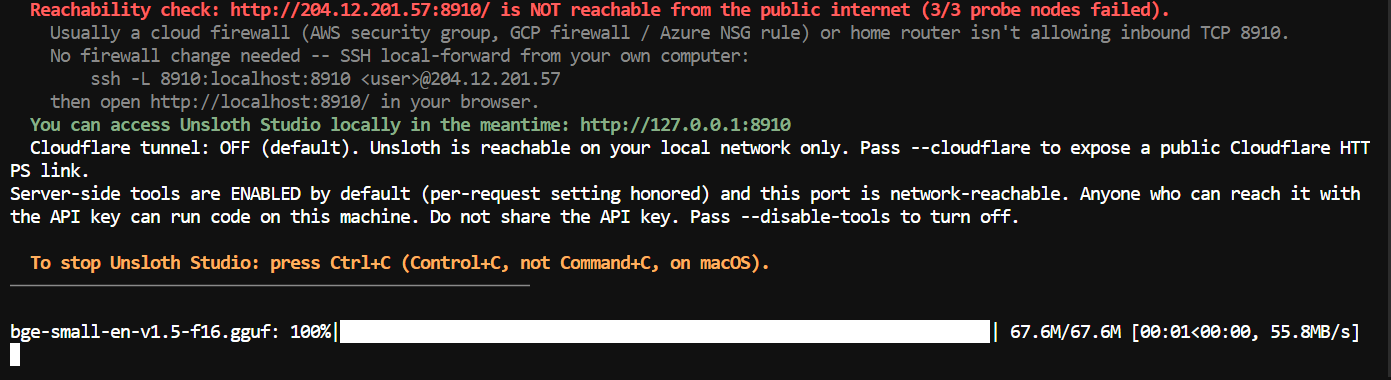
Теперь Studio должно сообщить, что работает на порту 8910. Держите Терминал 1 открытым во время работы с Unsloth Studio и OpenCode.
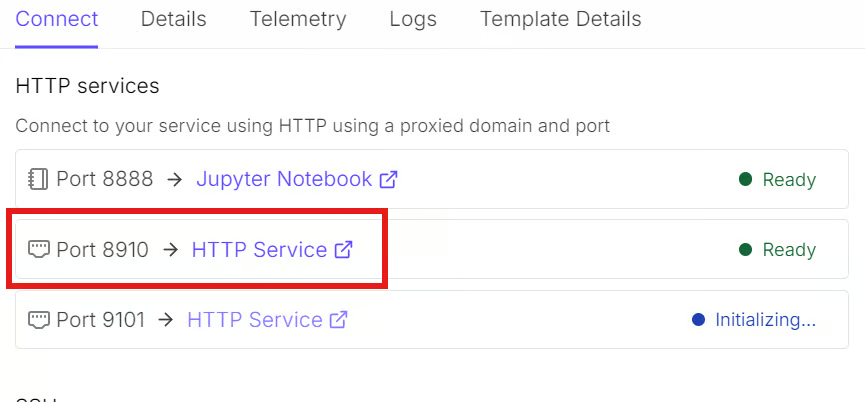
Вернитесь на страницу RunPod Connect и откройте HTTP Service для порта 8910.
Используйте ранее сгенерированный временный пароль, чтобы завершить сброс, затем войдите с новым созданным паролем.
Пройдите или пропустите онбординг и откройте страницу Chat.
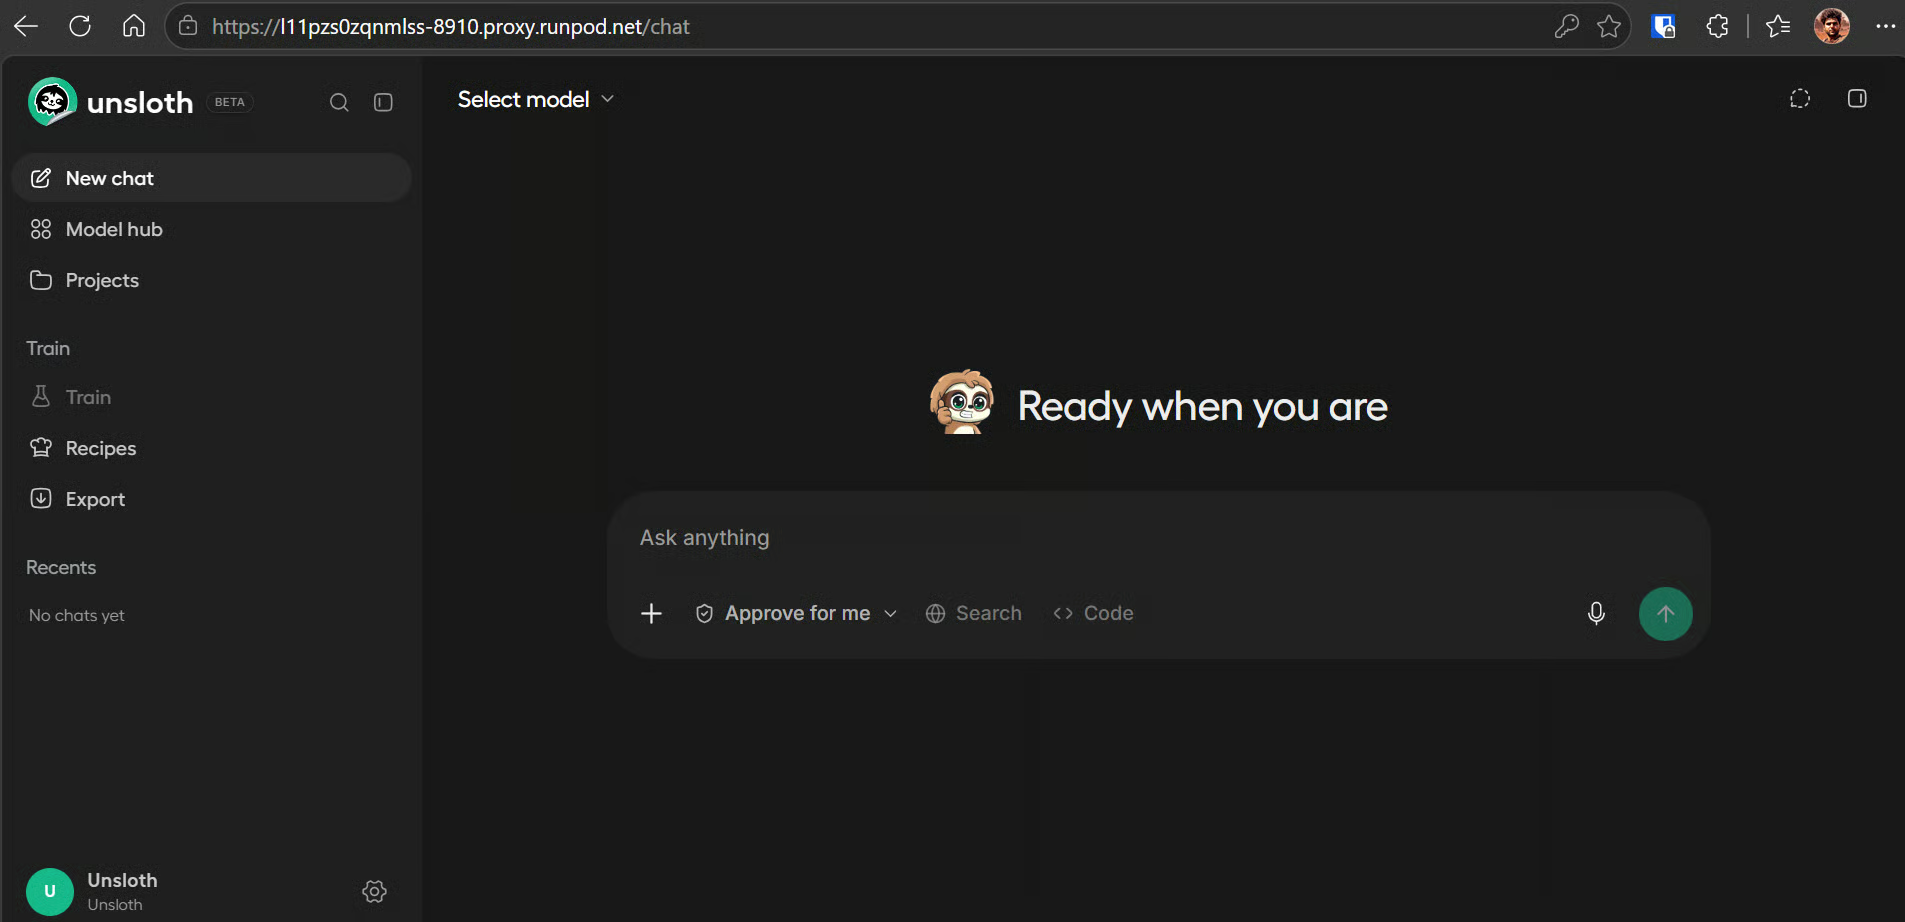
Теперь, когда Unsloth Studio запущена, мы можем скачать модель Q8, загрузить её на три GPU и протестировать возможности чата и использования инструментов.
Откройте селектор модели в левом верхнем углу, найдите unsloth/DeepSeek-V4-Flash-0731-GGUF и выберите квантизацию Q8 UD-Q8_K_XL.
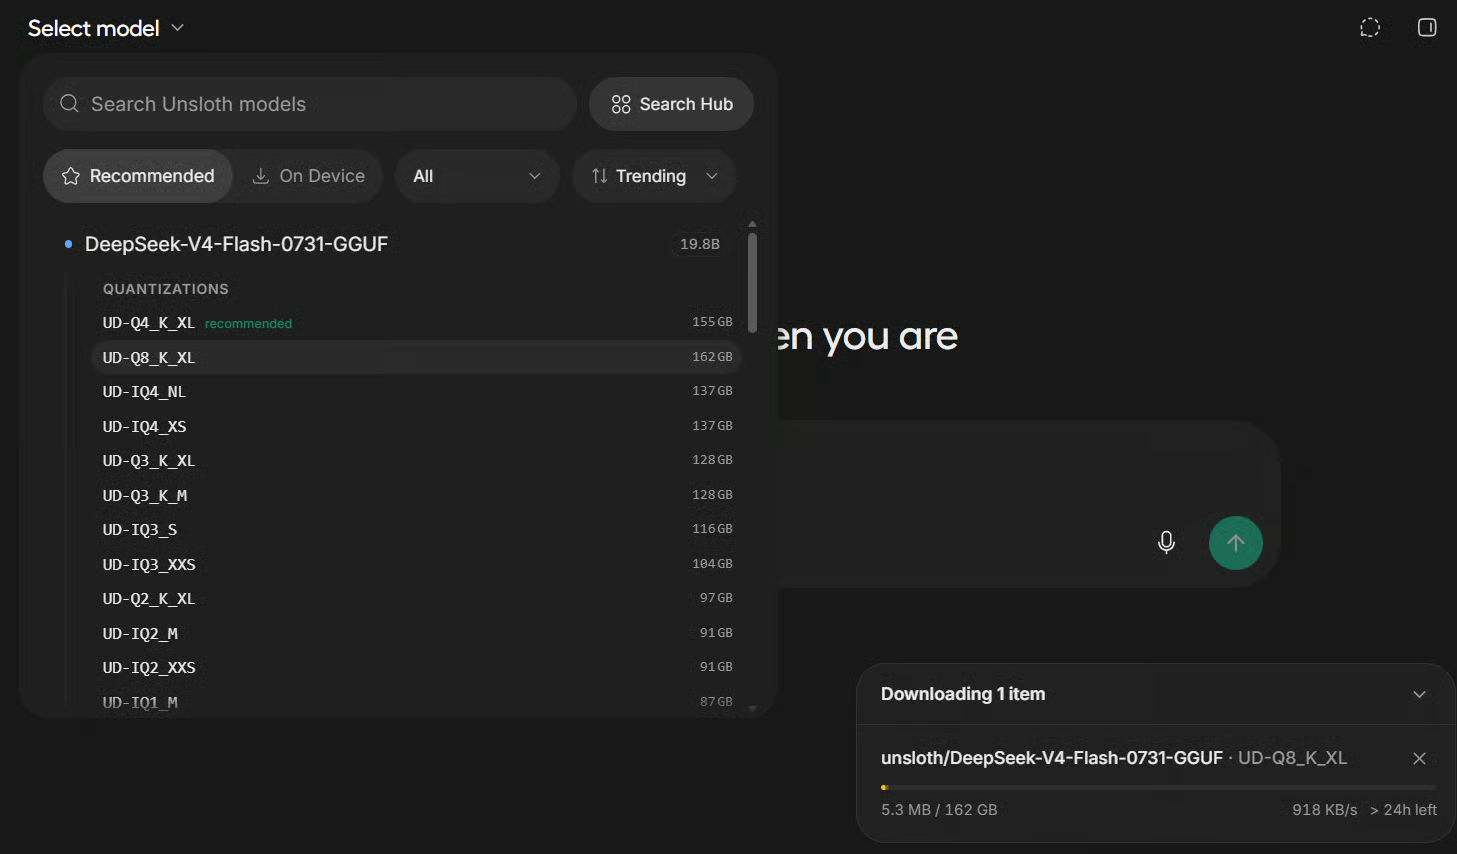
Мы используем Q8, потому что три A100 обеспечивают достаточно суммарной VRAM. Это сохраняет качество ближе к исходной модели, тогда как более низкие квантизации полезны, когда память оборудования ограничена.
После завершения загрузки Unsloth Studio автоматически начнёт загружать модель в память GPU. Это может занять несколько минут из-за большого размера модели Q8.
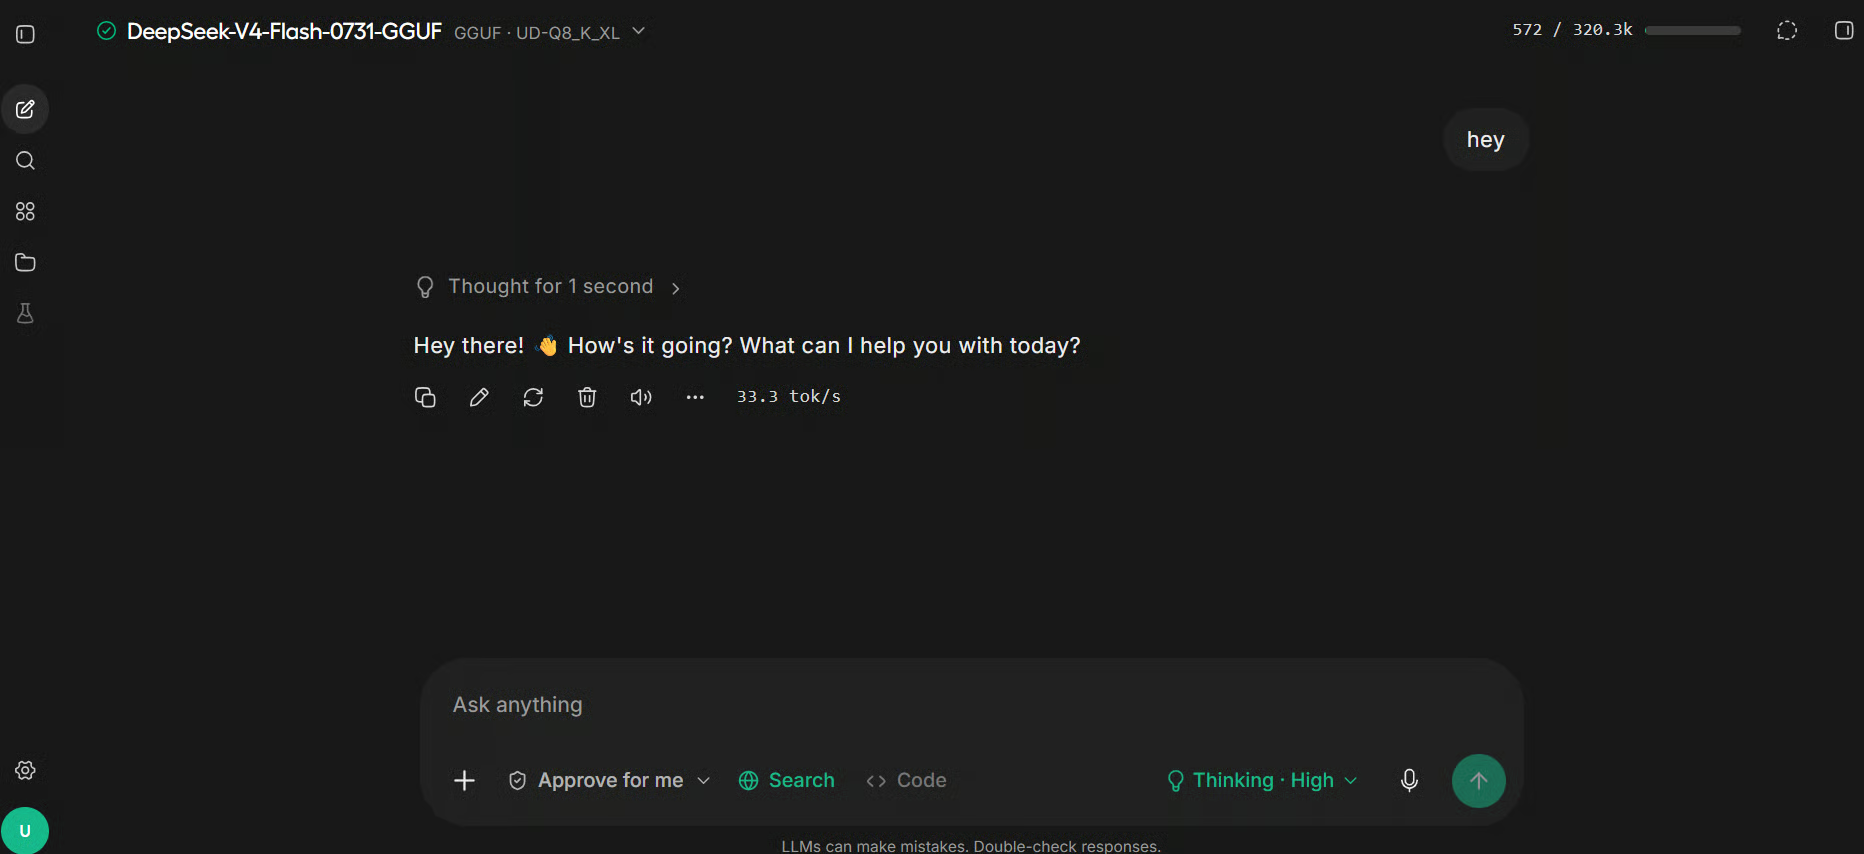
После загрузки используйте страницу Chat, чтобы проверить модель на нескольких простых запросах.
В наших тестах скорость генерации достигала примерно 33 токенов в секунду без спекулятивного декодирования, что является разумным результатом для модели такого размера.
Вы также можете включить веб-поиск Studio и попросить модель найти актуальную информацию, например последние цены на золото и серебро. Это полезный способ убедиться, что модель умеет вызывать внешние инструменты, а не полагается только на внутренние знания.
В Терминале 2 проверьте, как модель распределена по GPU:
nvidia-smi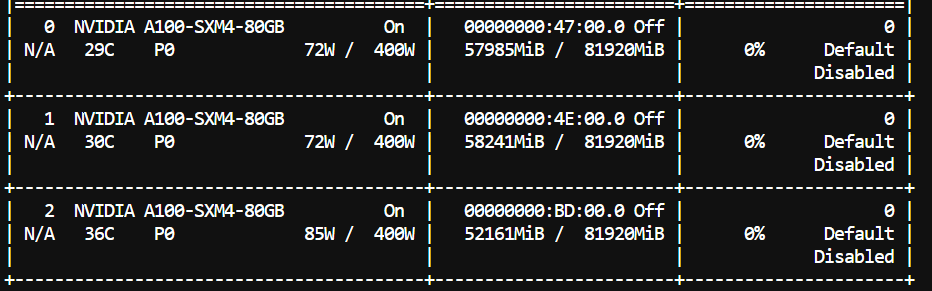
Вы должны увидеть значительное использование памяти на всех трёх GPU.
В нашем тесте каждый GPU был заполнен примерно на 70%. Однако это не обязательно означает, что полная модель Q8 поместится без проблем лишь на двух 80-гигабайтных GPU, поскольку дополнительная VRAM всё ещё нужна для окна контекста, KV-кэша и буферов инференса.
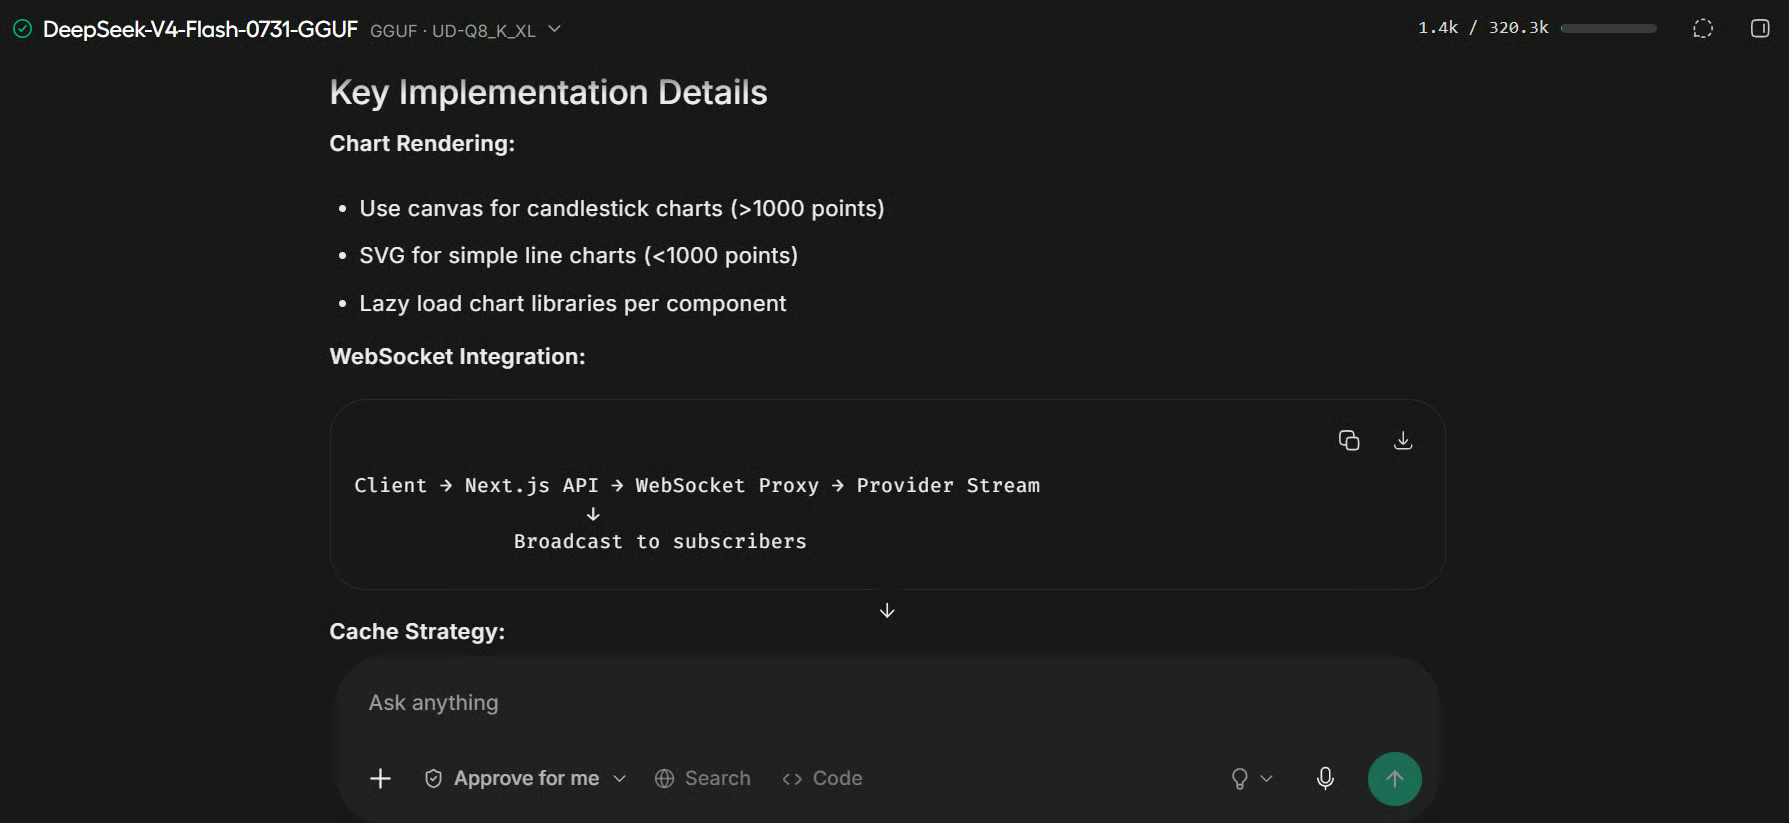
Наконец, протестируйте модель с планировочным промптом для приложения, которое мы будем собирать:
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
Модель возвращает структурированный план разработки, охватывающий архитектуру приложения, компоненты, потоки данных, библиотеки графиков, финансовые вычисления и дизайн интерфейса.
Теперь, когда модель работает в Unsloth Studio, мы можем подключить её к OpenCode и использовать в качестве локального кодирующего агента.
В Терминале 3 задайте URL Studio:
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
Создайте новую директорию проекта:
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
Запустите OpenCode через Unsloth Studio:
unsloth start opencodeПри первом запуске будет запрошено разрешение на установку OpenCode. Введите «y».
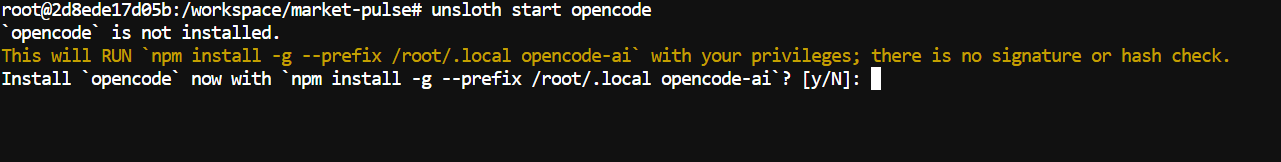
После завершения установки OpenCode запустится с уже настроенной локально работающей моделью DeepSeek-V4-Flash-0731.
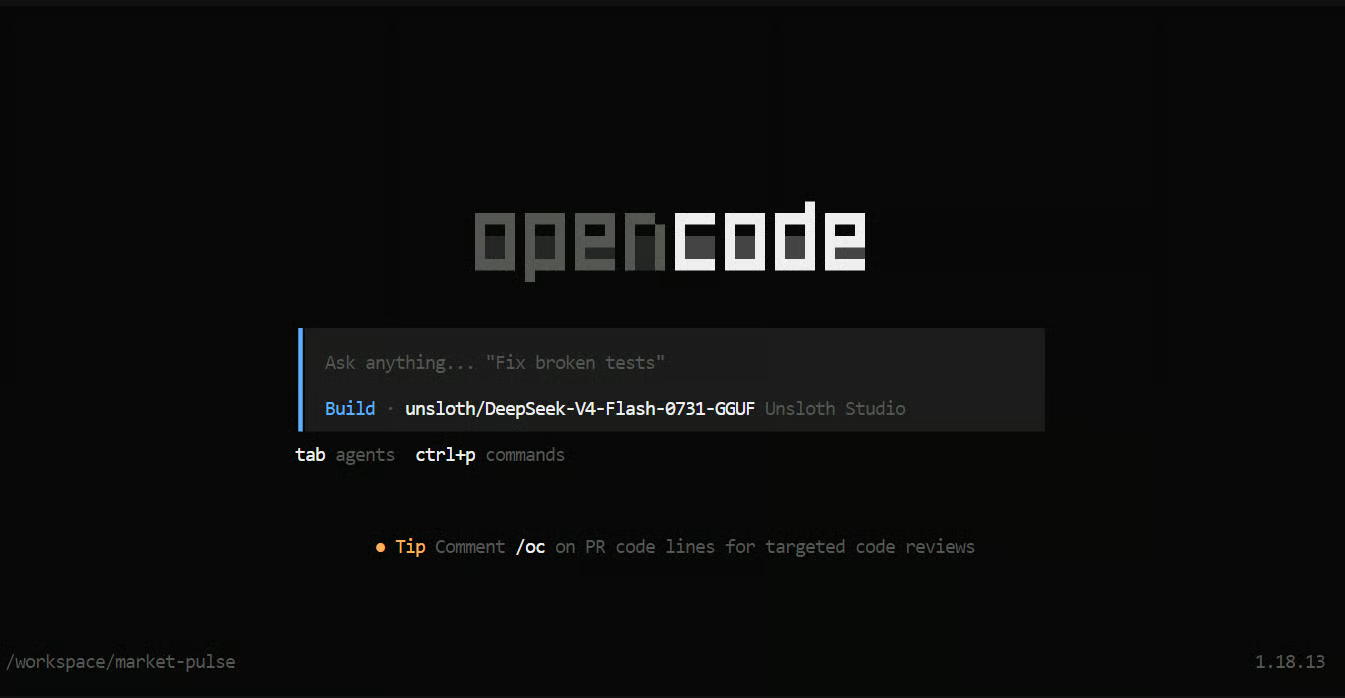
Вставьте следующий двухстрочный промпт в OpenCode:
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
Через несколько секунд кодирующий агент должен создать подробный список задач и начать пошаговую работу над проектом.
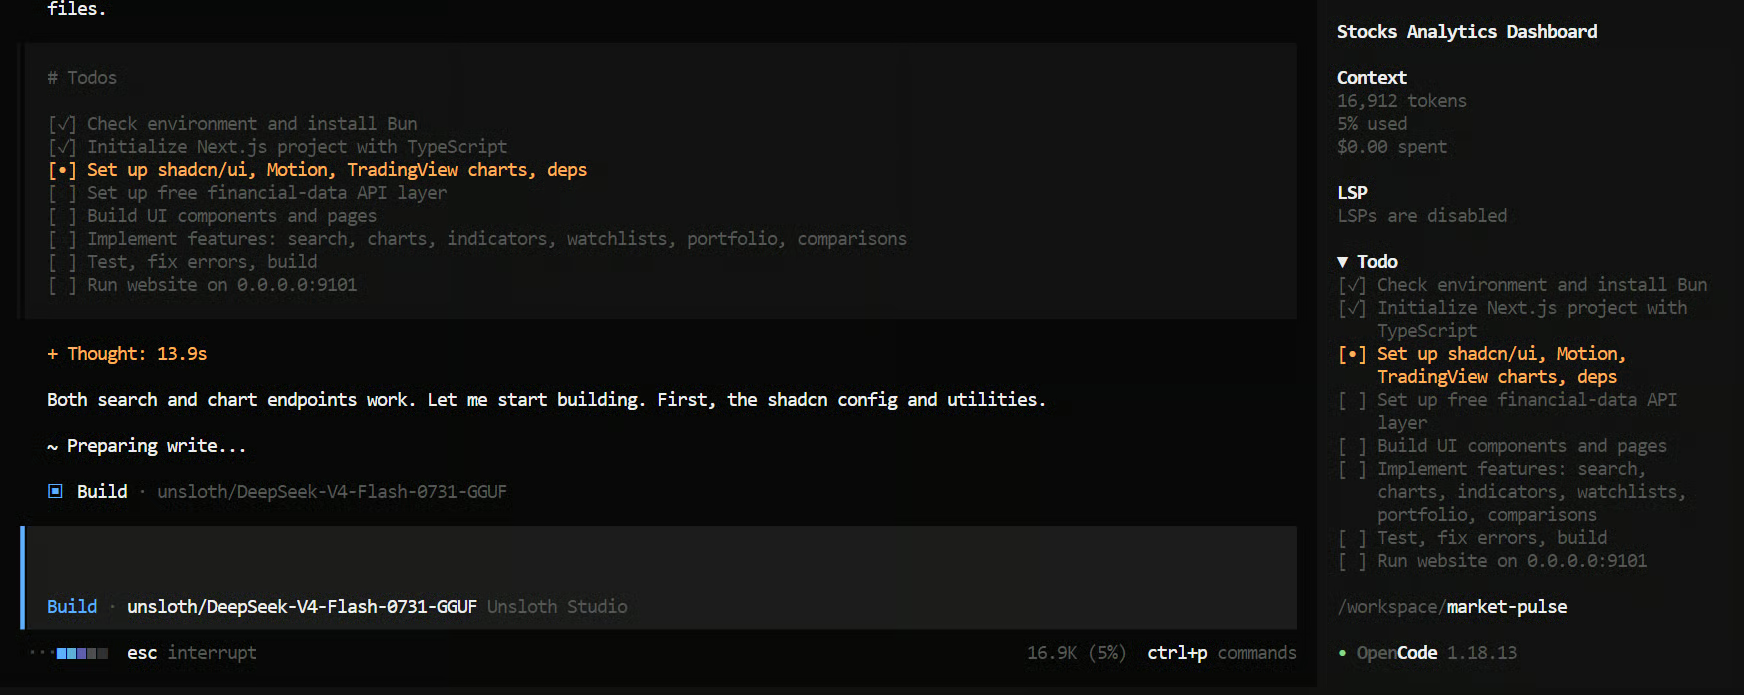
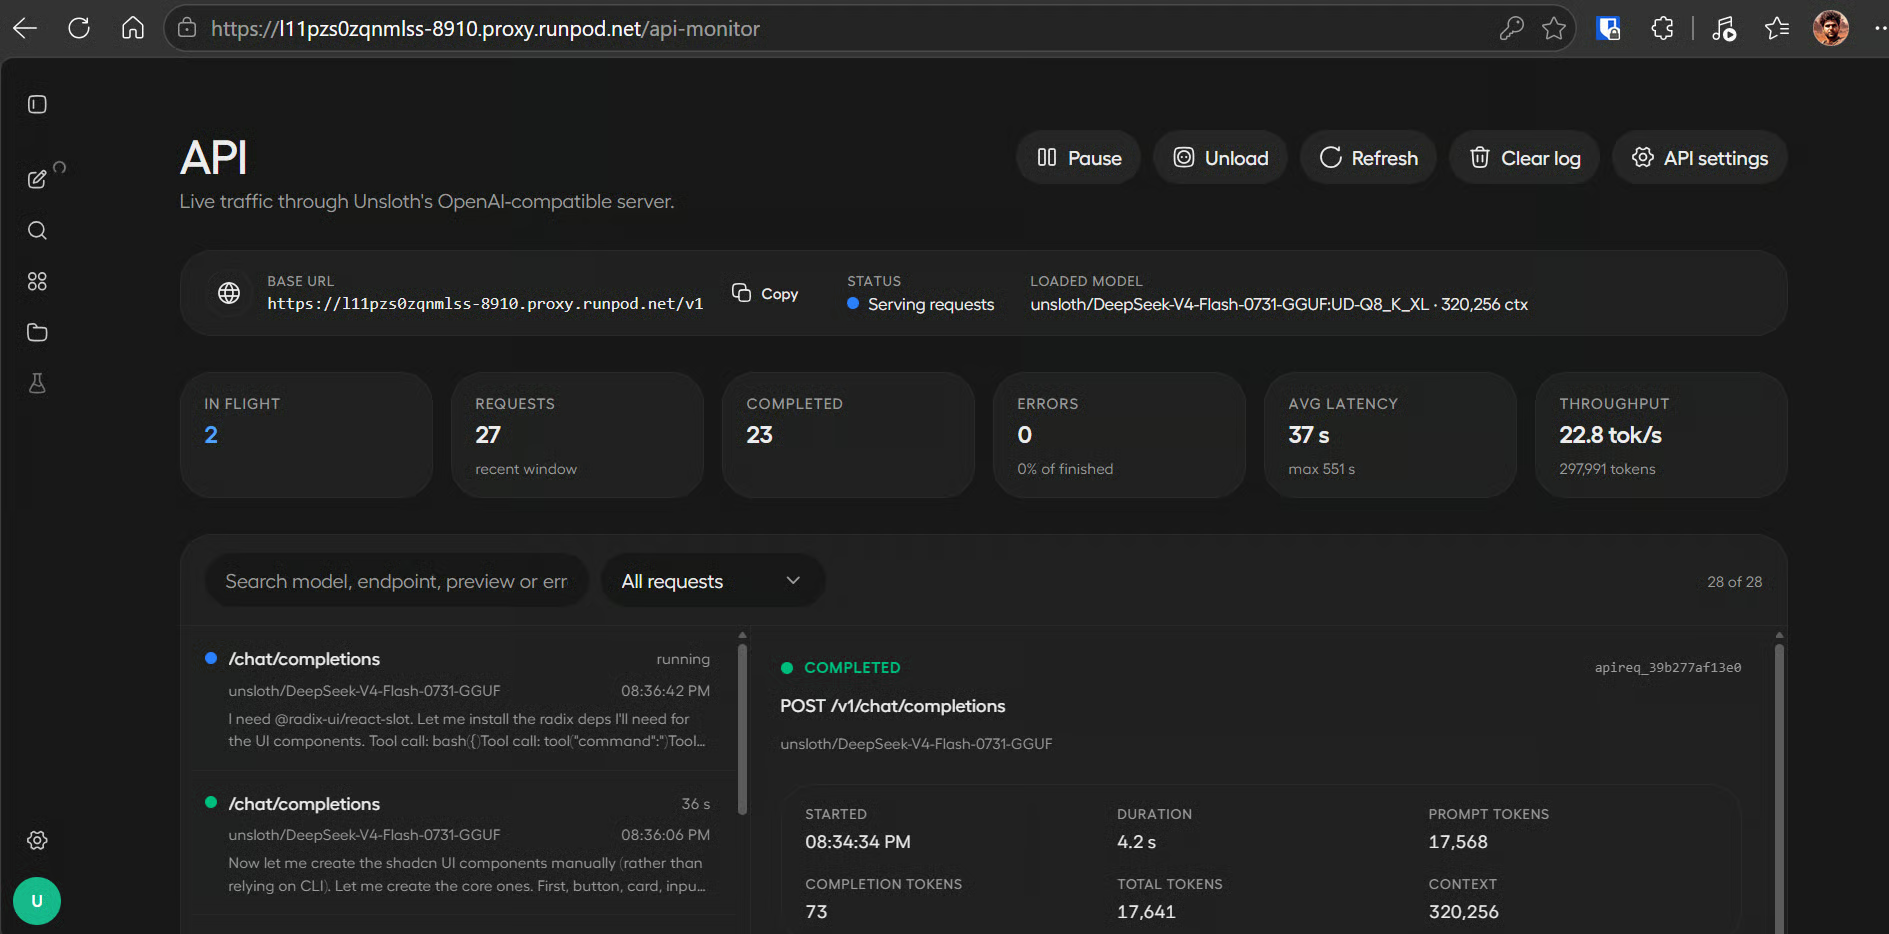
Полная сборка заняла около 20 минут в нашем тесте. Пока она выполняется, вы можете вернуться в Unsloth Studio и открыть страницу мониторинга API в Settings, чтобы отслеживать использование модели и скорость генерации.
Мы наблюдали среднюю скорость около 22,6 токена в секунду в процессе кодирования. По мере роста контекста диалога и проекта скорость может снижаться.
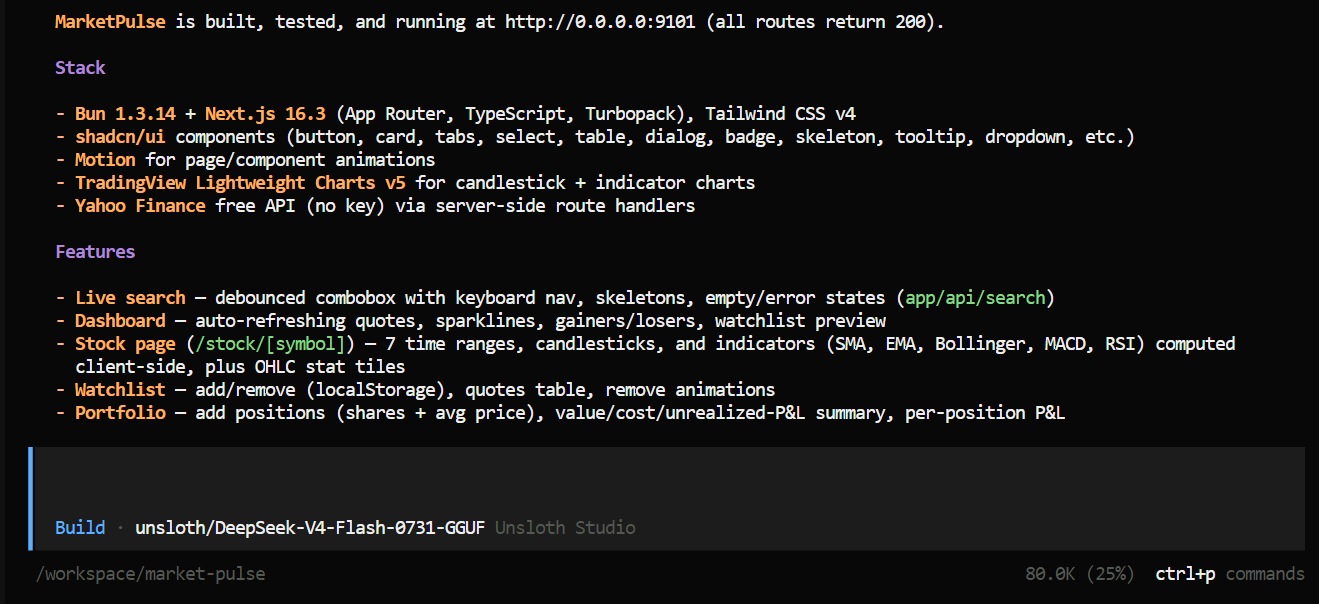
После завершения задач OpenCode должен предоставить сводку созданных файлов, функций и команд. Также он должен запустить готовый сайт на порту 9101.
Вернитесь на страницу RunPod Connect и откройте HTTP Service для порта 9101.
Результат оказался на удивление качественным. Сайт выглядел аккуратно, с анимациями, и напоминал профессиональную торговую панель. Модель завершила веб-приложение по одному промпту, включая интерфейс, представления данных, графики и навигацию.
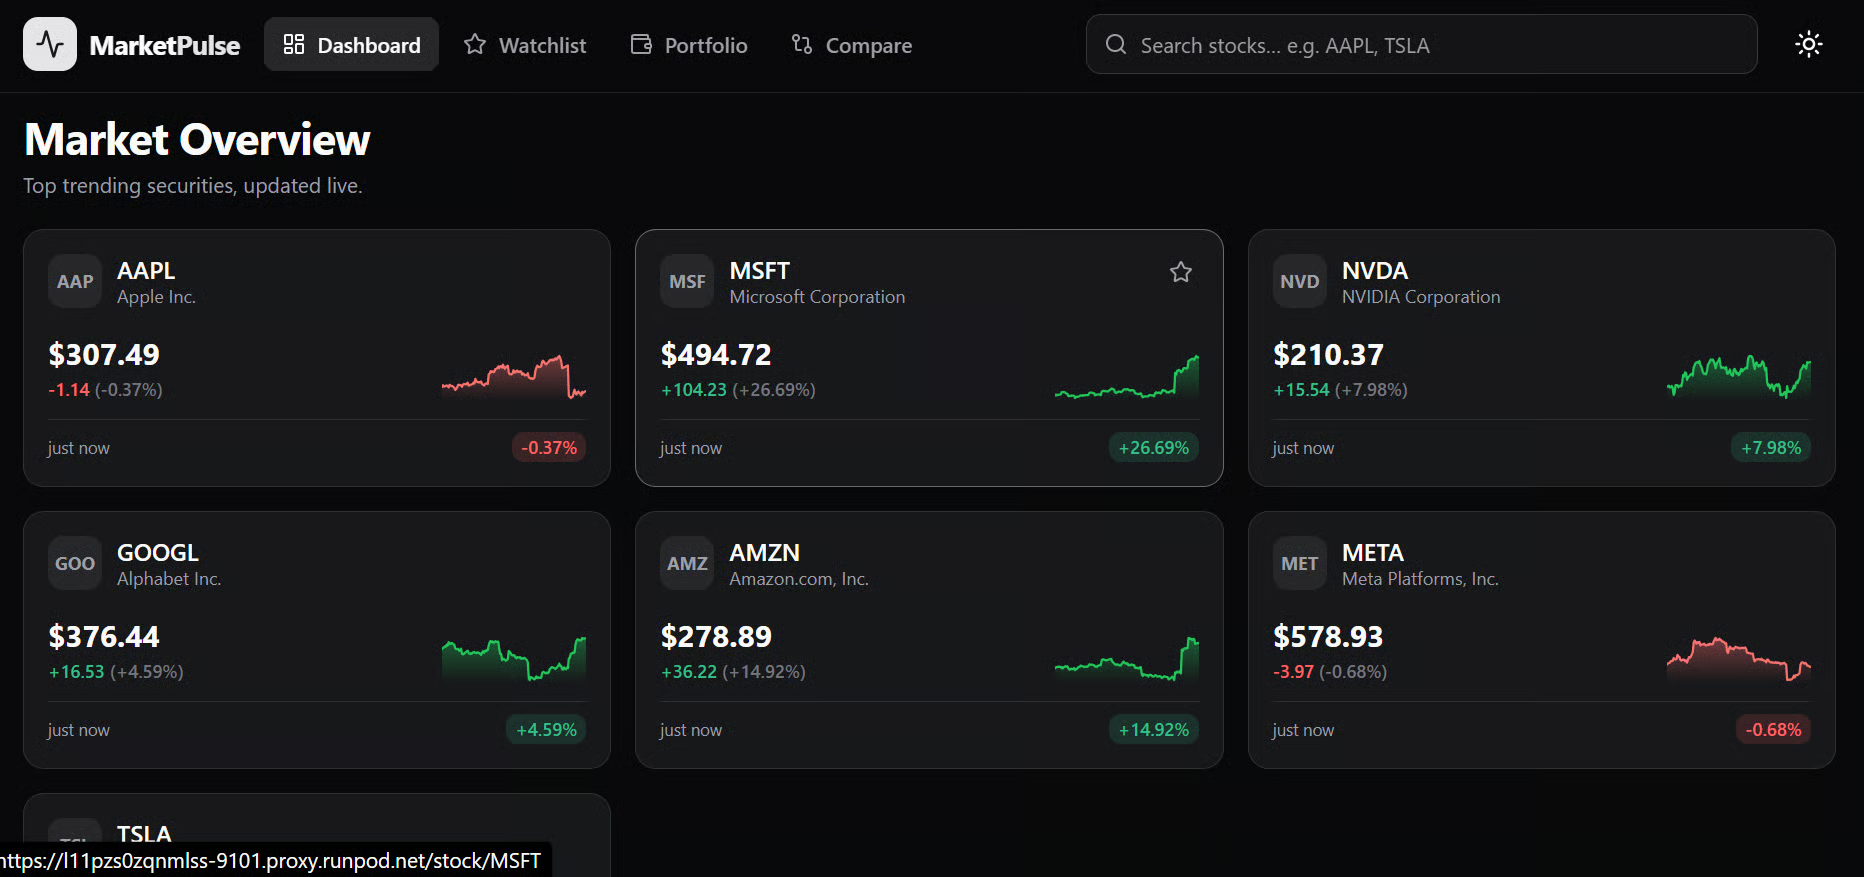
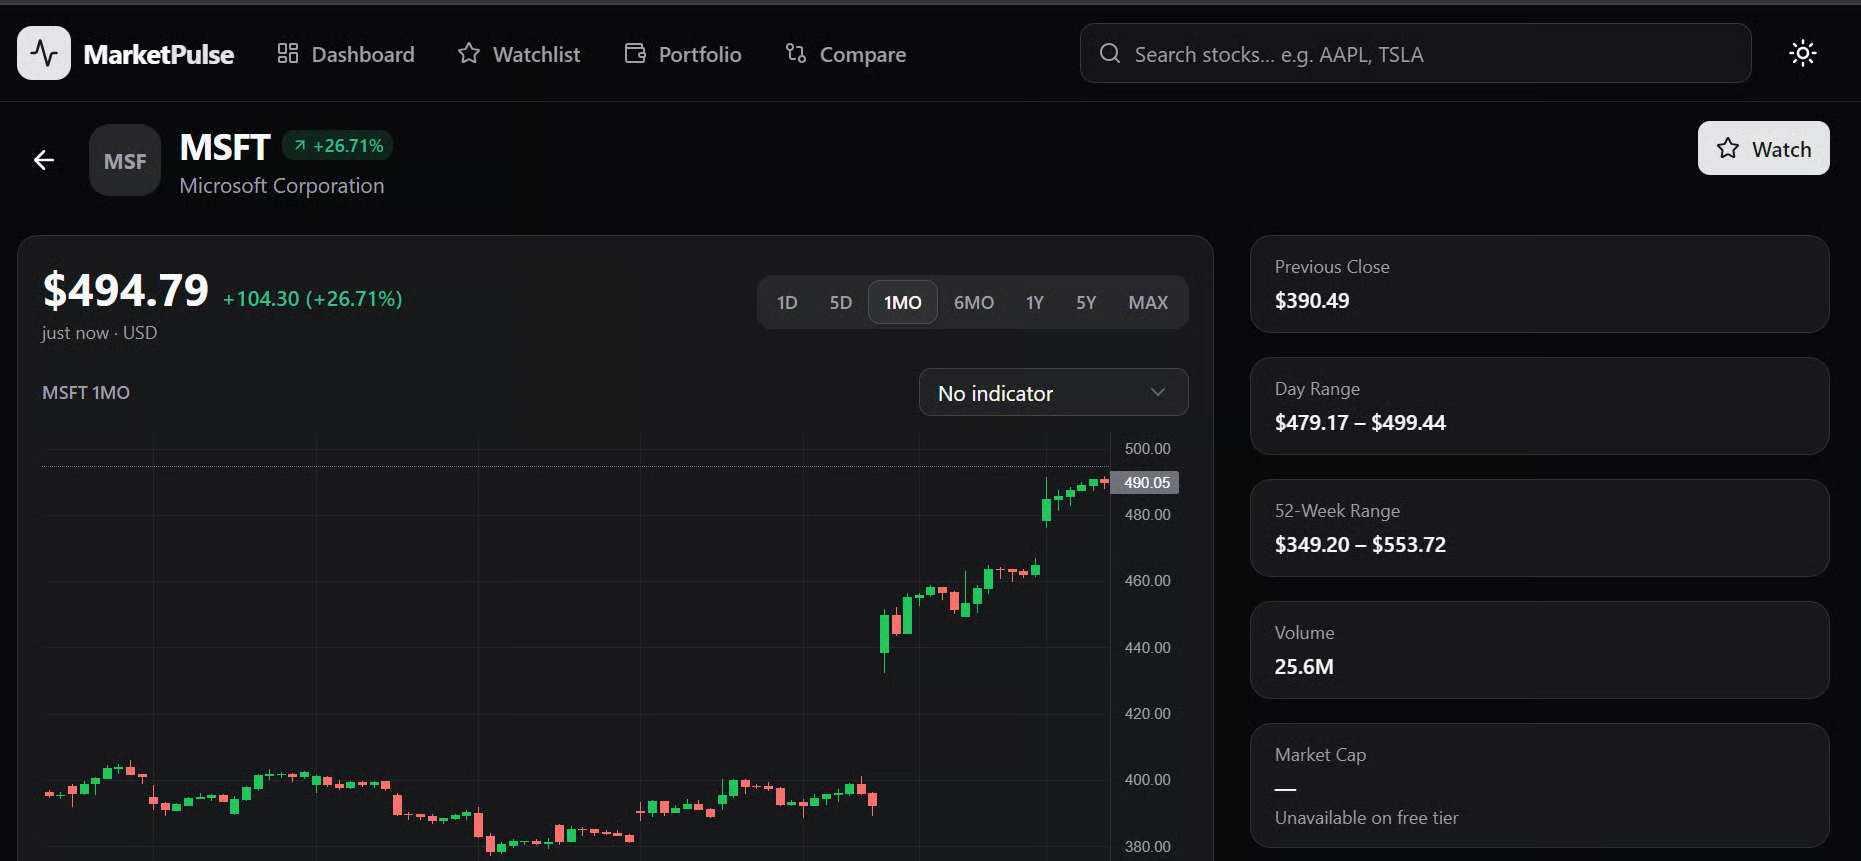
Вы можете выбирать отдельные тикеры акций, чтобы просматривать свечные графики, исторические показатели, индикаторы и дополнительную информацию о компании.
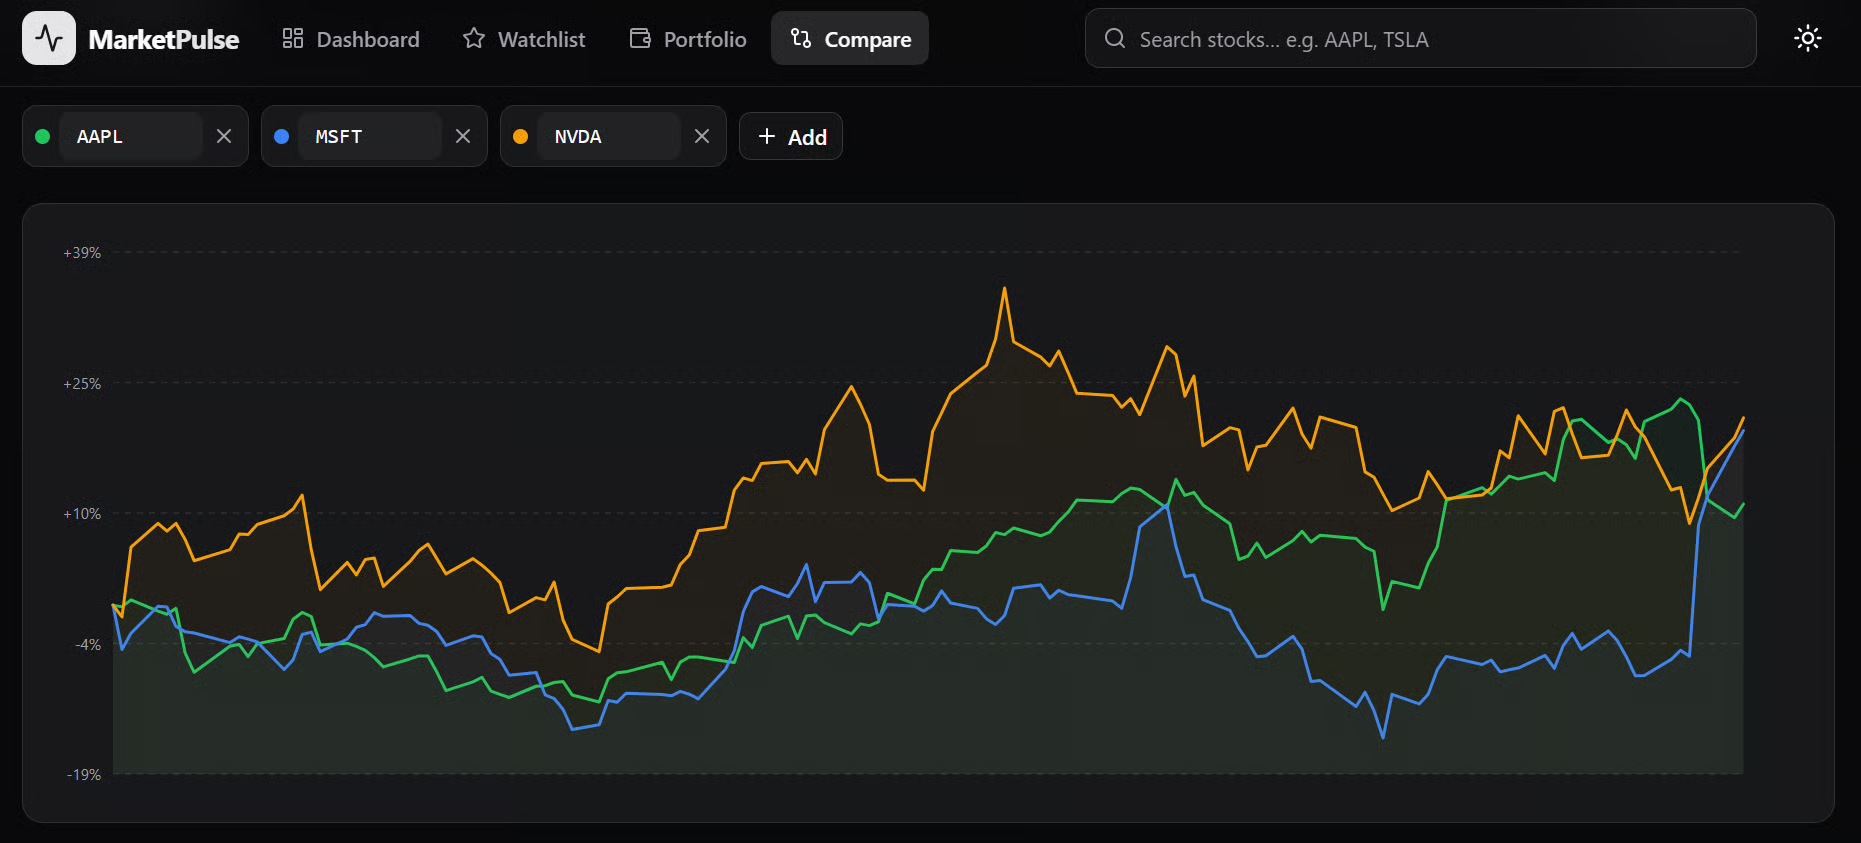
Вкладка Compare также позволяет сравнивать несколько акций и видеть, какие показывали лучшую динамику за выбранный период.
Я был искренне удивлён, что более компактная локальная модель смогла собрать весь сайт по одному промпту.
После тестирования приложения все ключевые функции работали как задумано, включая котировки в реальном времени, исторические рыночные данные, графики, индикаторы и инструменты сравнения.
Поразительно, как быстро совершенствуются локальные модели и насколько они уже способны выполнять сложные, сквозные задачи разработки.
Для меня DeepSeek-V4-Flash-0731 — лучшая локальная модель из тех, что я пока тестировал.
Она показала себя лучше, чем Inkling, 2-битная квантизация GLM-5.2 и Qwen3.6-27B, которая ранее была моей любимой. Это основано на моём собственном опыте, а не на формальном бенчмарке, но теперь это моя предпочтительная локальная модель.
Для большинства практических задач я всё же начал бы с официального API DeepSeek, так как он крайне доступный по цене.
V4 Flash в настоящее время стоит $0,14 за миллион некэшированных входных токенов, $0,0028 за миллион кэшированных входных токенов и $0,28 за миллион выходных токенов. При таком тарифе один миллиард кэшированных входных токенов обойдётся примерно в $2,80 без учёта выходных данных.
Прежде чем остановиться на Unsloth Studio, я пытался запускать модель через llama.cpp. Предварительно собранный установщик не предоставлял подходящего свежего CUDA-бинарника для моего окружения, и хотя я собрал последнюю версию из исходников, столкнулся с дальнейшими проблемами при включении спекулятивного декодирования DSpark.
В итоге Unsloth Studio обеспечила самую простую установку и сняла большую часть ручной конфигурации. Она хорошо работала с OpenCode, хотя сборка полного приложения заняла около 20 минут.
Лучшие курсы DataCamp
Course
Course
Track