Kursus
Pengembangan Kode dengan Bantuan AI untuk Developer
1 Hr 30 Min
9.9K
Lebih kecil dan lebih cepat kini tidak lagi otomatis berarti kurang mampu. Menurut evaluasi yang dipublikasikan DeepSeek, DeepSeek-V4-Flash-0731 menggunakan jejak parameter teraktivasi yang jauh lebih kecil dibandingkan DeepSeek-V4-Pro sambil memberikan kinerja agen yang mendekati frontier: skornya 82,7 pada Terminal Bench 2.1, dibandingkan dengan 81,0 untuk GLM-5.2 dan 85,0 untuk Opus 4.8, sementara 25,2 pada Agents’ Last Exam mendekati 25,7 milik Opus 4.8.
Karena bobot model tersedia secara terbuka, secara teori Anda dapat menjalankannya di perangkat keras sendiri selama memiliki RAM atau VRAM gabungan yang cukup, sehingga inferensi dan data proyek tetap berada di bawah kendali Anda.
Dalam panduan ini, kita akan mengonfigurasi lingkungan RunPod dengan tiga GPU, memasang dan meluncurkan Unsloth Studio, mengunduh dan memuat versi Q8 dari DeepSeek-V4-Flash-0731 ke seluruh GPU, menguji model melalui Studio, menghubungkan server inferensi lokal ke OpenCode, dan menggunakan agen pemrograman untuk membangun serta meluncurkan situs web analitik saham interaktif.
DeepSeek-V4-Flash-0731 adalah rilis resmi yang menggantikan pratinjau sebelumnya, dengan peningkatan besar dalam kemampuan pemrograman, penggunaan alat, dan tugas agen otonom. Arsitektur Mixture-of-Experts-nya hanya mengaktifkan sebagian model untuk setiap token. Ini membantu tetap efisien sembari tetap memberikan performa kuat.
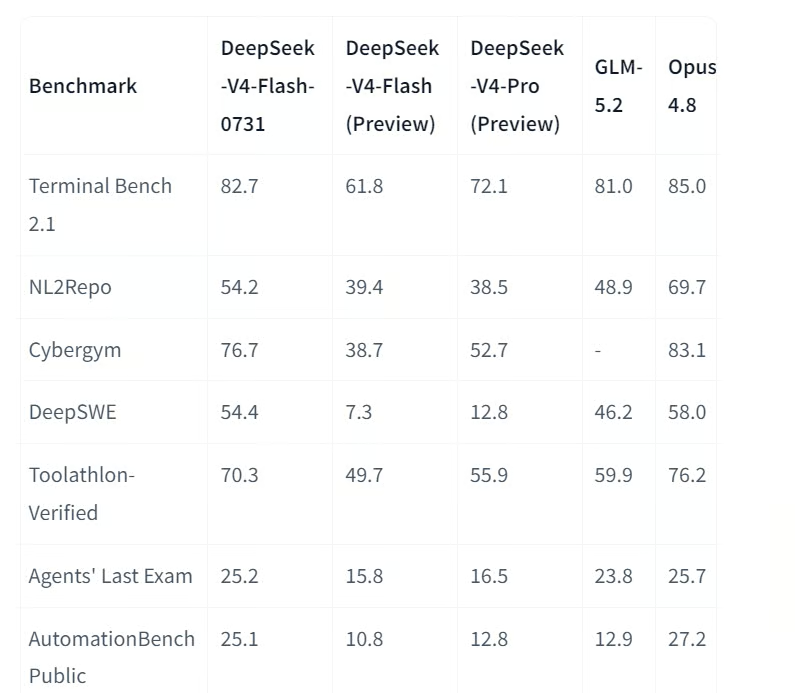
Sumber: deepseek-ai/DeepSeek-V4-Flash-0731 · Hugging Face
DeepSeek melaporkan bahwa model meningkat dari 61,8 menjadi 82,7 pada Terminal Bench 2.1 dan dari 7,3 menjadi 54,4 pada DeepSWE. Model ini juga melampaui DeepSeek-V4-Pro Preview yang lebih besar pada beberapa tolok ukur agen.
Model ini mendukung jendela konteks hingga satu juta token. Ini membuatnya cocok untuk basis kode besar, dokumen panjang, dan alur kerja kompleks yang memerlukan konteks substansial. Pengguna juga dapat memilih antara upaya penalaran rendah, tinggi, dan maksimum, tergantung pada berapa banyak waktu yang harus dihabiskan model untuk menyelesaikan tugas.
DeepSeek-V4-Flash-0731 juga menyertakan DSpark speculative decoding. DSpark membuat draf beberapa token sebelum model utama memverifikasinya, yang menurut DeepSeek dapat meningkatkan kecepatan generasi sebesar 60% hingga 85% saat digunakan dengan mesin inferensi yang kompatibel.
Kita akan mulai dengan membuat lingkungan RunPod dengan memori GPU dan penyimpanan yang cukup untuk menjalankan versi Q8 dari DeepSeek-V4-Flash-0731 serta menampung Unsloth Studio dan situs web yang dihasilkan OpenCode.
Konfigurasikan Pod dengan:
/workspace sebagai path mount volume persistenHF_TOKEN8910 dan 9101 dibuka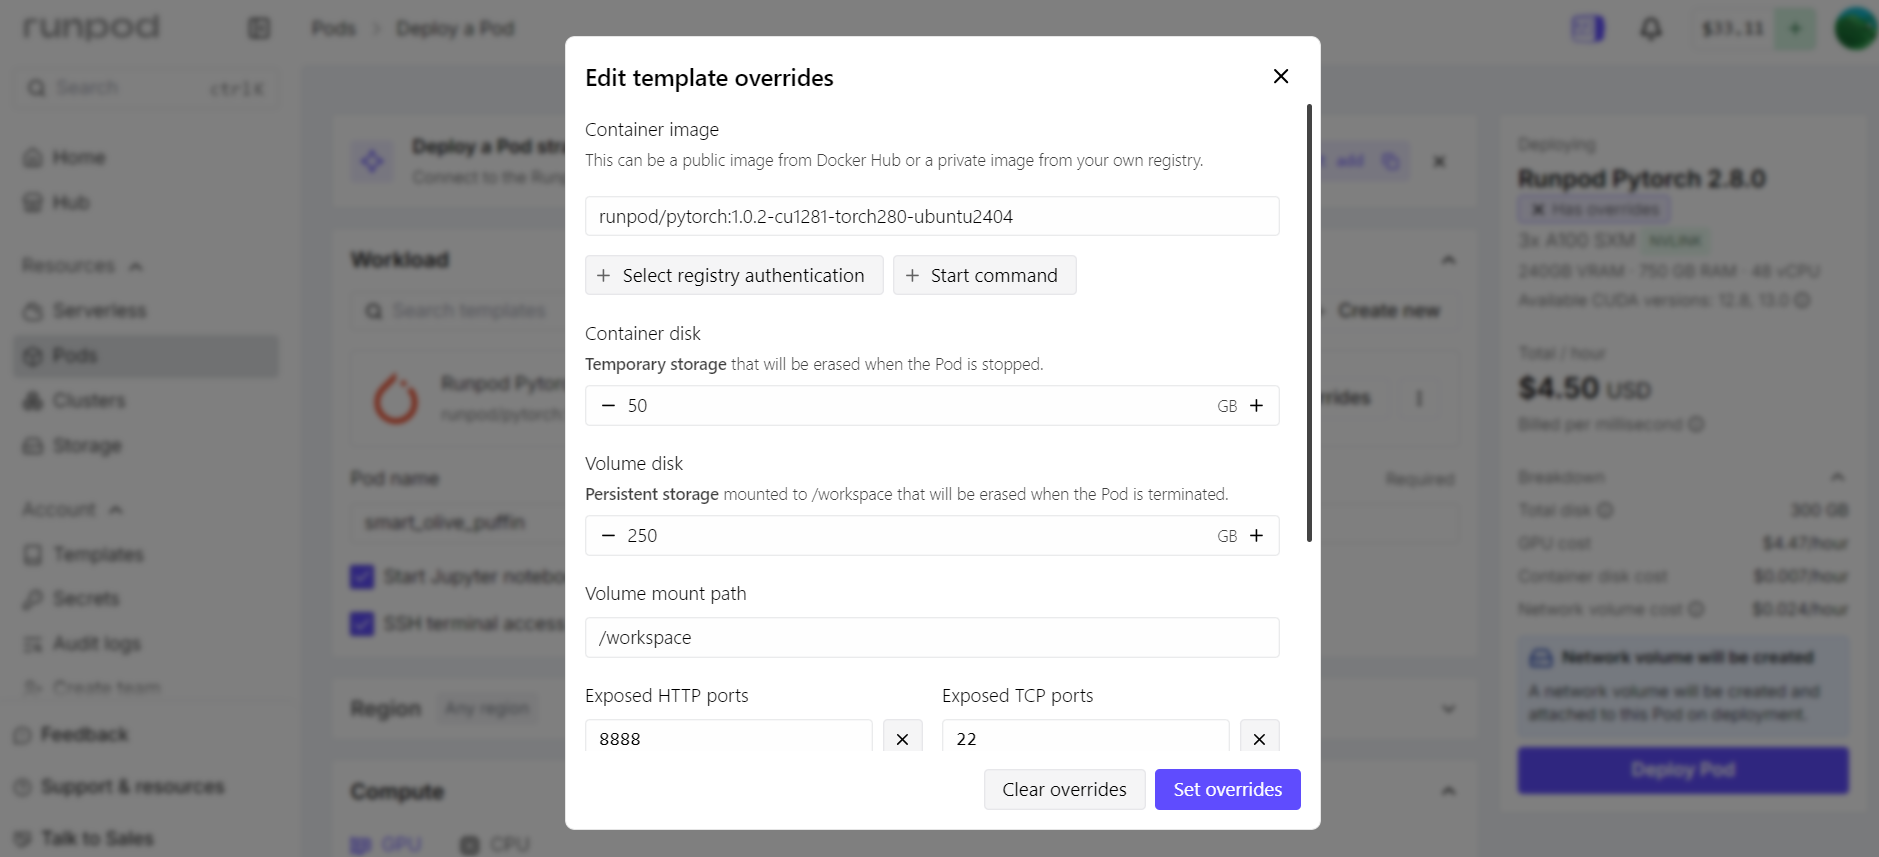
Port 8910 akan digunakan untuk Unsloth Studio dan API inferensi lokalnya. Port 9101 akan menampung situs web interaktif yang dibuat oleh OpenCode.
RunPod mengekspos layanan ini melalui proksi HTTP-nya, jadi kedua aplikasi harus mendengarkan pada 0.0.0.0 alih-alih hanya 127.0.0.1.
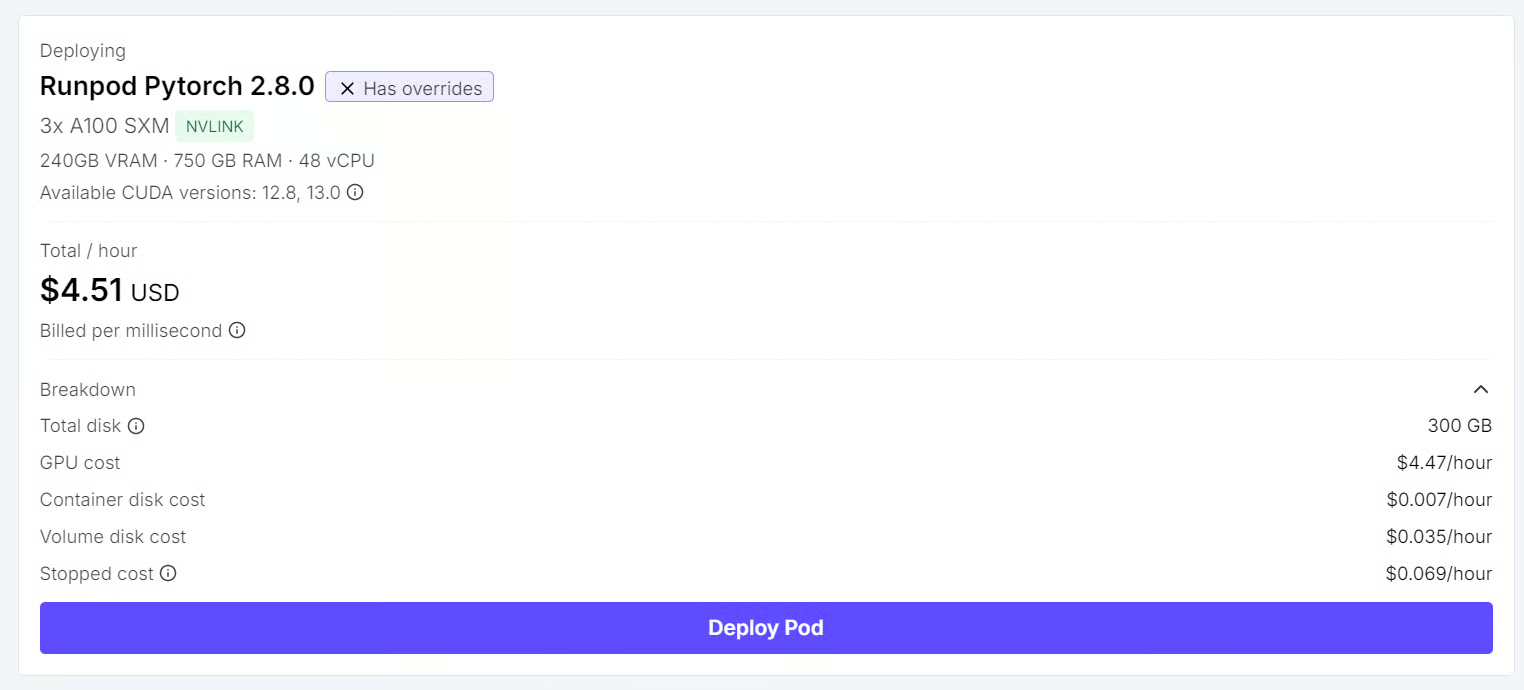
Setelah mendeploy Pod, buka tab Connect, luncurkan JupyterLab, dan buat tiga sesi terminal:
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
Memisahkan tugas di terminal berbeda memudahkan pemantauan GPU, pemecahan masalah model, dan menjalankan agen pemrograman secara bersamaan.
Berikutnya, kita akan memasang Unsloth Studio, mengonfigurasi cache Hugging Face persisten, dan meluncurkan antarmuka pada port 8910.
Di Terminal 1, pastikan ketiga GPU tersedia:
nvidia-smiAnda seharusnya melihat ketiga GPU A100 terdaftar pada server Linux.
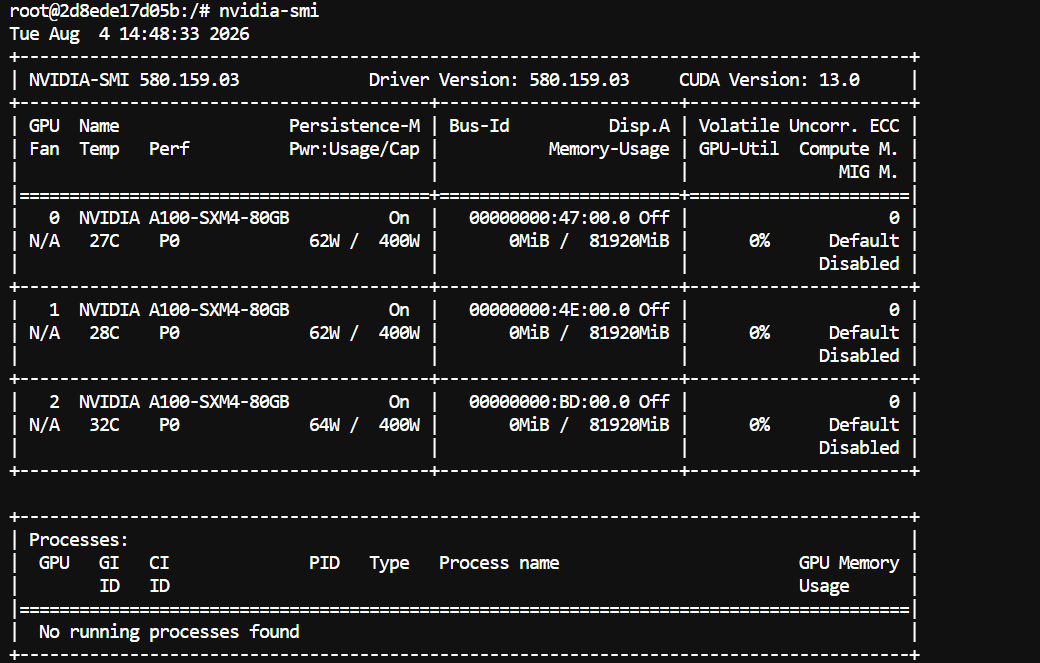
Buat cache Hugging Face persisten di dalam /workspace agar model yang diunduh tetap tersedia pada volume RunPod:
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
Selanjutnya, pasang paket sistem yang diperlukan dan Unsloth Studio:
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh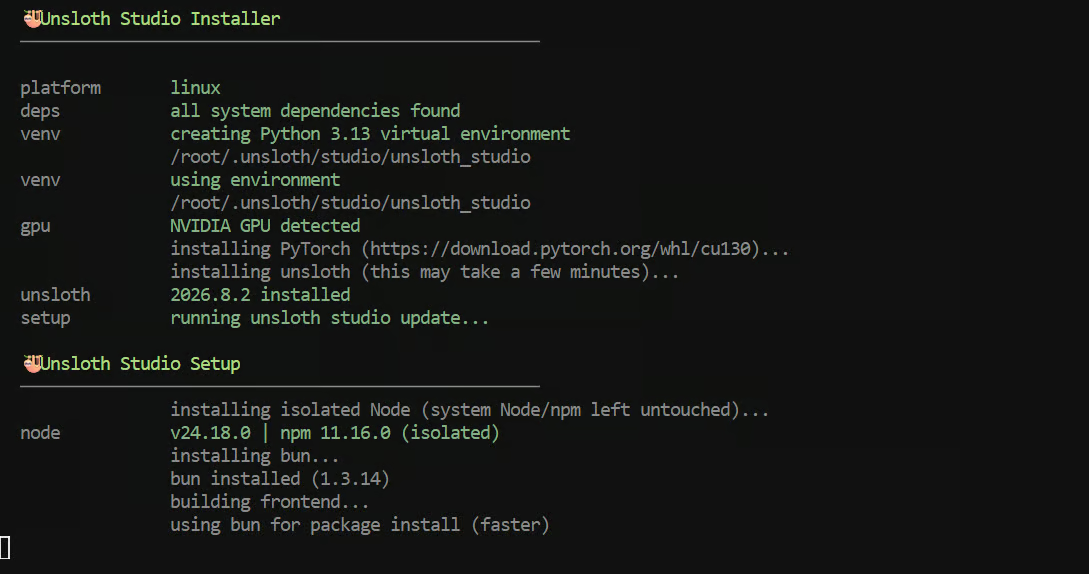
Penginstal mengonfigurasi antarmuka Studio, lingkungan Python, dependensi, dan komponen inferensi lokal.
Instalasi pertama kali dapat memakan waktu beberapa menit.
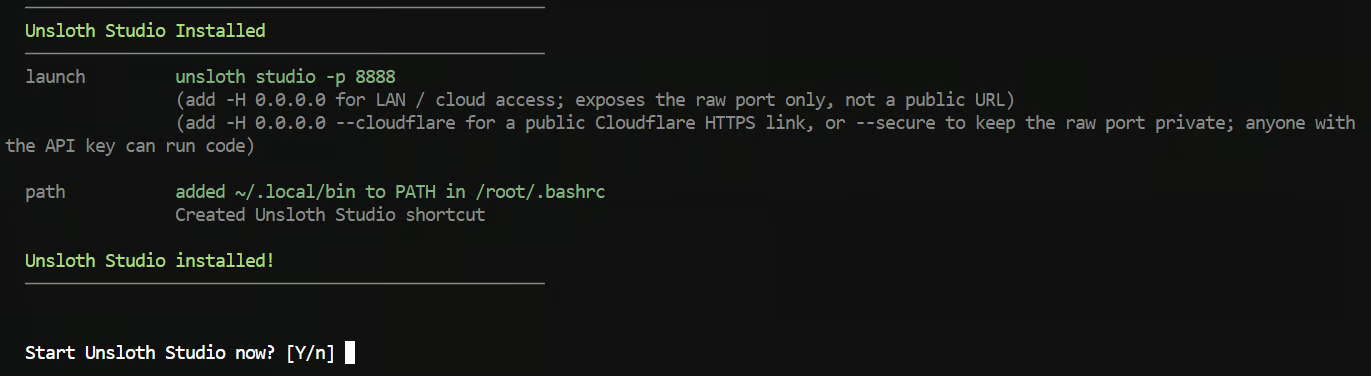
Saat penginstal menanyakan apakah Anda ingin langsung menjalankan Unsloth Studio, masukkan “n”.
Kita akan meluncurkannya secara manual agar menggunakan port 8910 dan mendengarkan pada alamat jaringan yang benar.
Mulai ulang shell agar perintah baru tersedia:
exec bash
cd /workspace
Sebelum meluncurkan Studio, setel ulang kata sandi bawaan:
unsloth studio reset-passwordSalin kata sandi sementara yang ditampilkan saat penyiapan, karena Anda mungkin membutuhkannya untuk menyelesaikan penyetelan ulang.
Sekarang luncurkan Unsloth Studio:
unsloth studio \
  -H 0.0.0.0 \
  -p 8910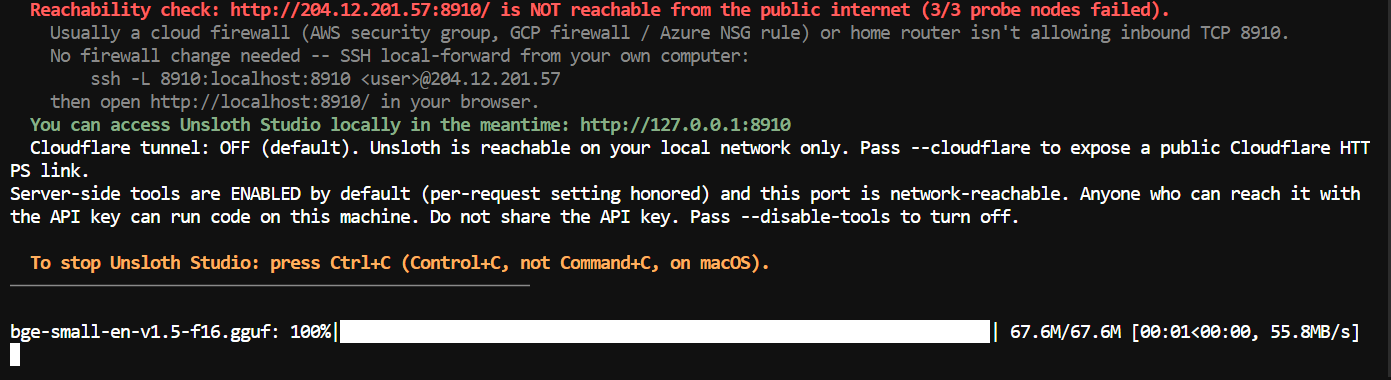
Studio sekarang seharusnya melaporkan bahwa ia berjalan pada port 8910. Biarkan Terminal 1 tetap terbuka saat menggunakan Unsloth Studio dan OpenCode.
Kembali ke halaman Connect RunPod dan buka HTTP Service untuk port 8910.
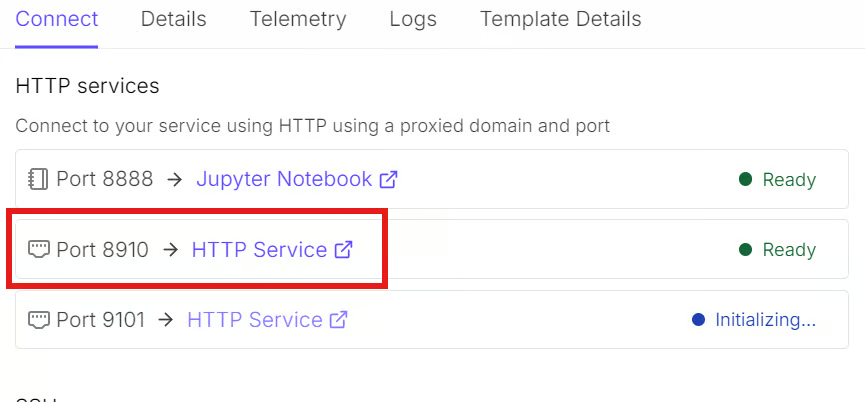
Gunakan kata sandi sementara yang dihasilkan sebelumnya untuk menyelesaikan penyetelan ulang, lalu masuk dengan kata sandi baru yang Anda buat.
Selesaikan atau lewati langkah onboarding dan buka halaman Chat.
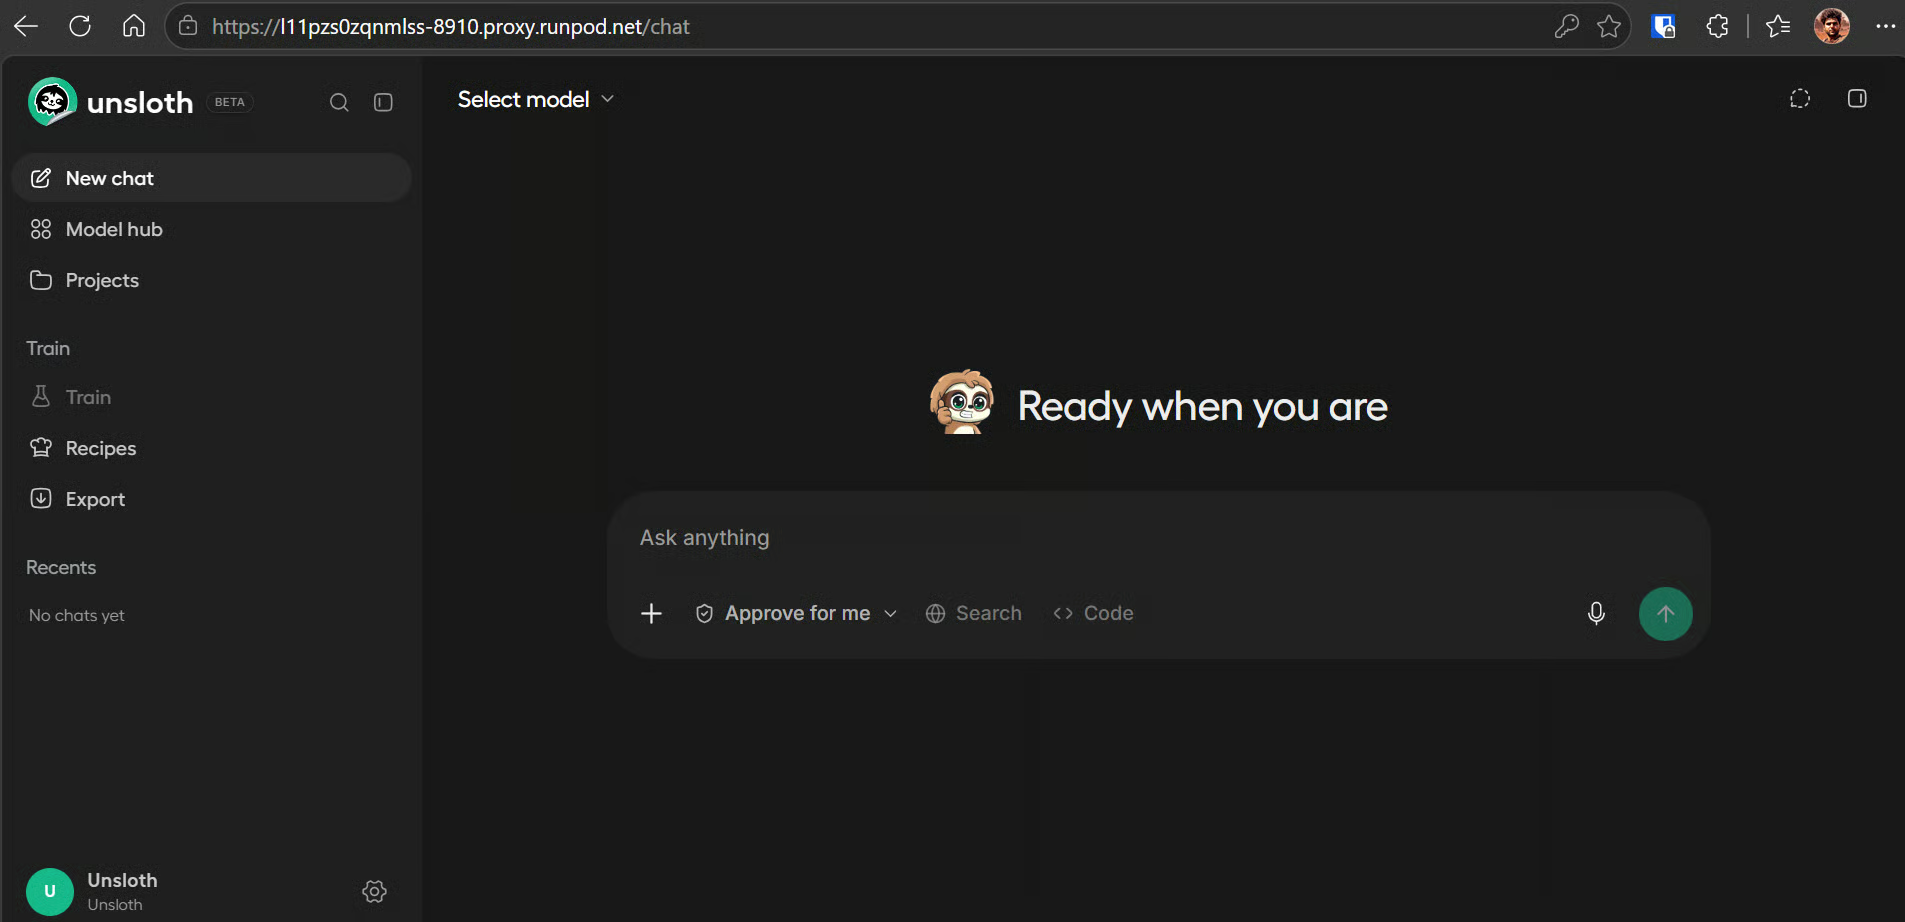
Setelah Unsloth Studio berjalan, kita dapat mengunduh model Q8, memuatnya ke tiga GPU, dan menguji kemampuan chat serta penggunaan alatnya.
Buka pemilih model di pojok kiri atas dan cari unsloth/DeepSeek-V4-Flash-0731-GGUF lalu pilih kuantisasi Q8 UD-Q8_K_XL.
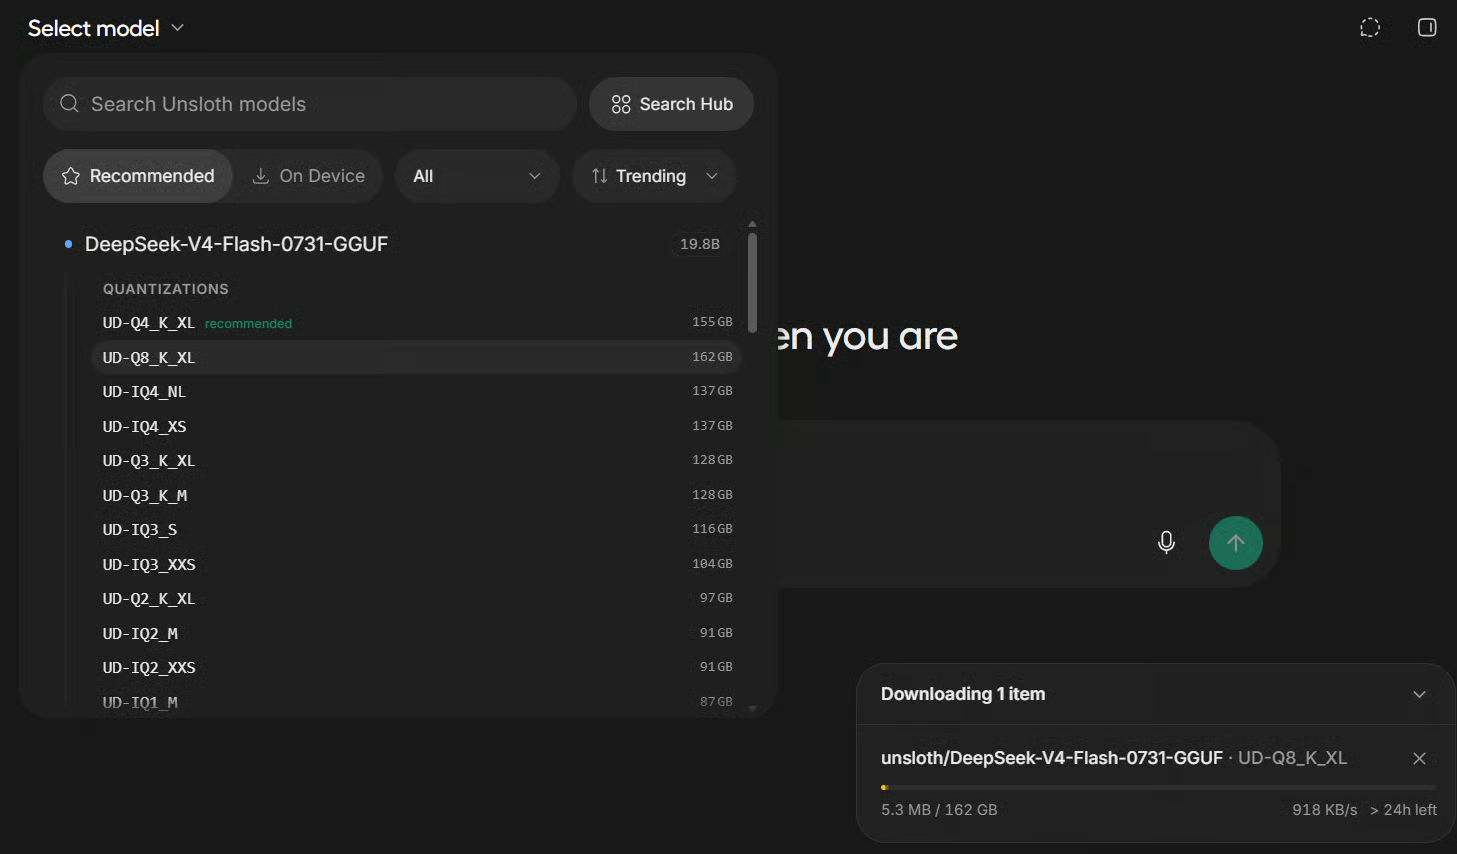
Kita menggunakan Q8 karena tiga GPU A100 menyediakan VRAM gabungan yang cukup. Ini mempertahankan kualitas yang lebih mendekati model asli, sementara kuantisasi yang lebih rendah lebih berguna saat memori perangkat keras terbatas.
Setelah unduhan selesai, Unsloth Studio akan otomatis mulai memuat model ke memori GPU. Ini bisa memakan waktu beberapa menit karena model Q8 sangat besar.
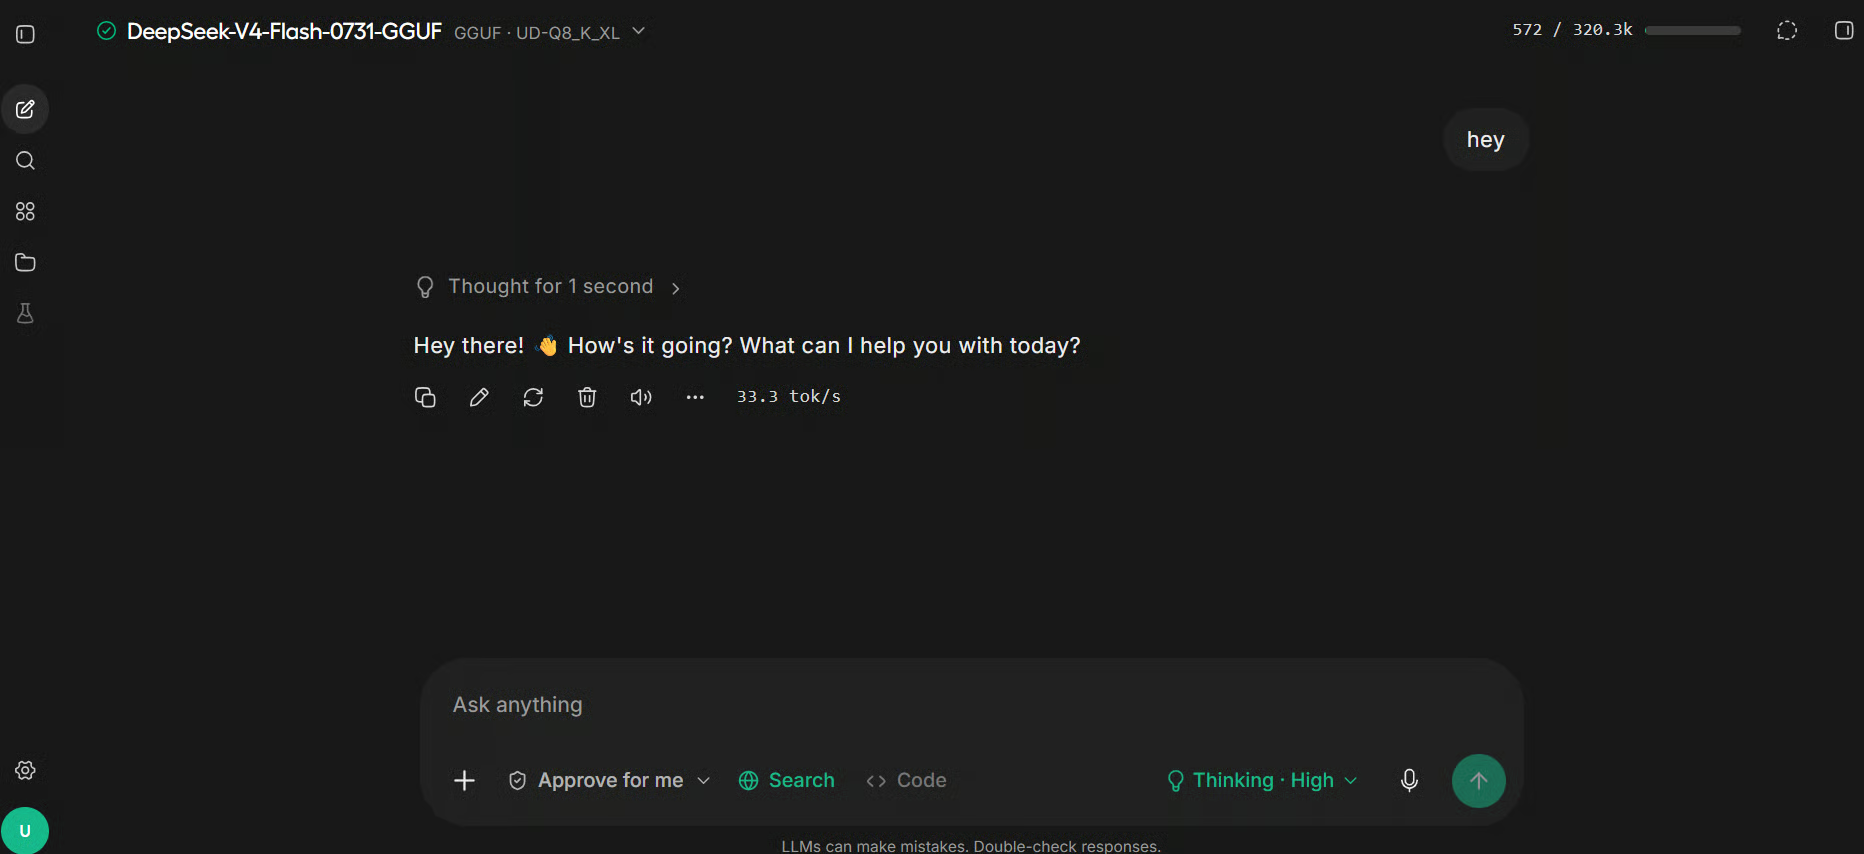
Setelah pemuatan, gunakan halaman Chat untuk menguji model dengan beberapa prompt sederhana.
Dalam pengujian kami, kecepatan generasi mencapai sekitar 33 token per detik tanpa speculative decoding, yang merupakan hasil wajar untuk model sebesar ini.
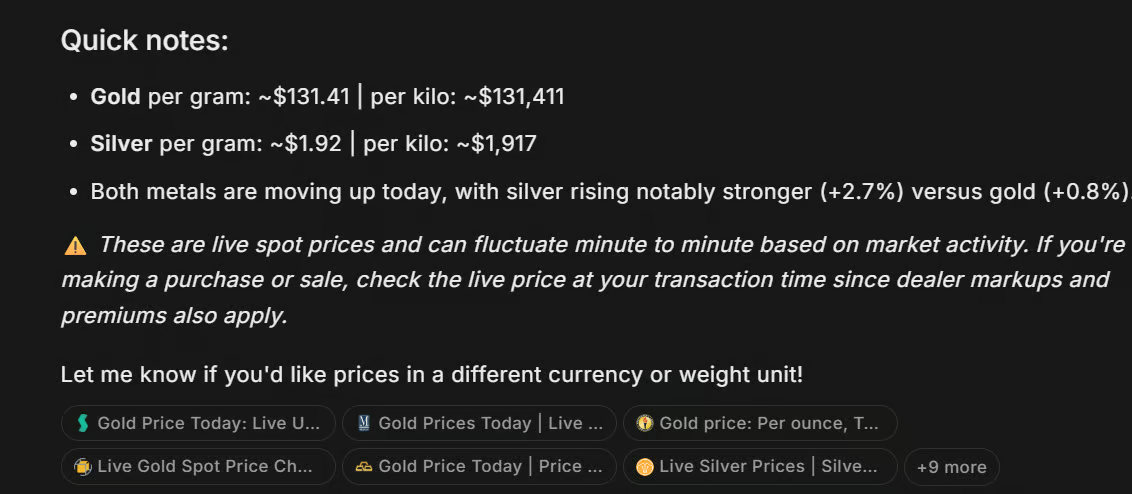
Anda juga dapat mengaktifkan alat penelusuran web Studio dan meminta model mencari informasi terkini, seperti harga emas dan perak terbaru. Ini cara yang berguna untuk memastikan model dapat memanggil alat eksternal alih-alih hanya mengandalkan pengetahuan internalnya.
Di Terminal 2, periksa bagaimana model terdistribusi ke seluruh GPU:
nvidia-smi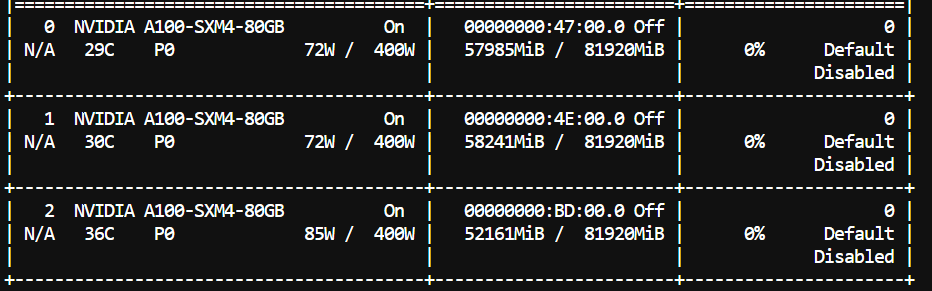
Anda seharusnya melihat penggunaan memori yang besar pada ketiga GPU.
Dalam pengujian kami, setiap GPU terisi sekitar 70%. Namun, ini tidak serta-merta berarti seluruh model Q8 akan muat dengan nyaman hanya pada dua GPU 80GB, karena VRAM tambahan tetap dibutuhkan untuk jendela konteks, KV cache, dan buffer inferensi.
Terakhir, uji model dengan prompt perencanaan untuk aplikasi yang akan kita bangun:
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
Model mengembalikan rencana pengembangan terstruktur yang mencakup arsitektur aplikasi, komponen, alur data, pustaka charting, perhitungan finansial, dan desain antarmuka.
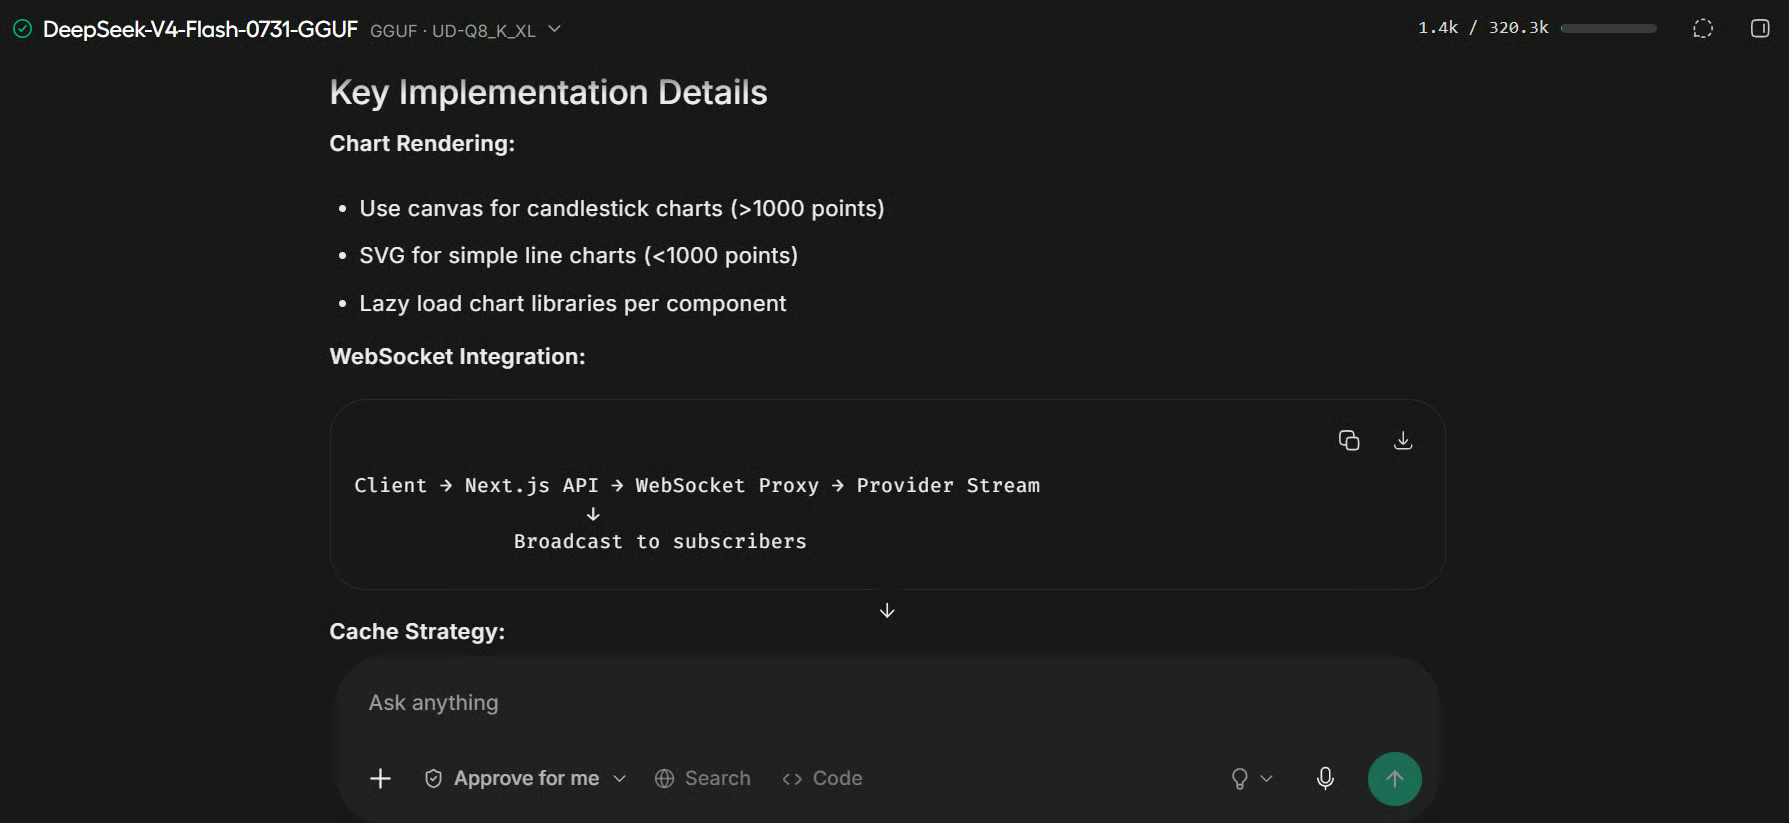
Sekarang model berjalan di Unsloth Studio, kita dapat menghubungkannya ke OpenCode dan menggunakannya sebagai agen pemrograman lokal.
Di Terminal 3, setel URL Studio:
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
Buat direktori proyek baru:
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
Mulai OpenCode melalui Unsloth Studio:
unsloth start opencodeSaat pertama kali menjalankan perintah ini, Anda akan diminta izin untuk memasang OpenCode. Masukkan “y”.
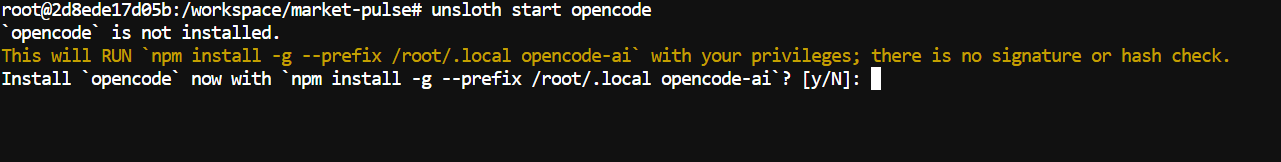
Setelah instalasi selesai, OpenCode akan diluncurkan dengan model DeepSeek-V4-Flash-0731 yang berjalan lokal dan telah dikonfigurasi.
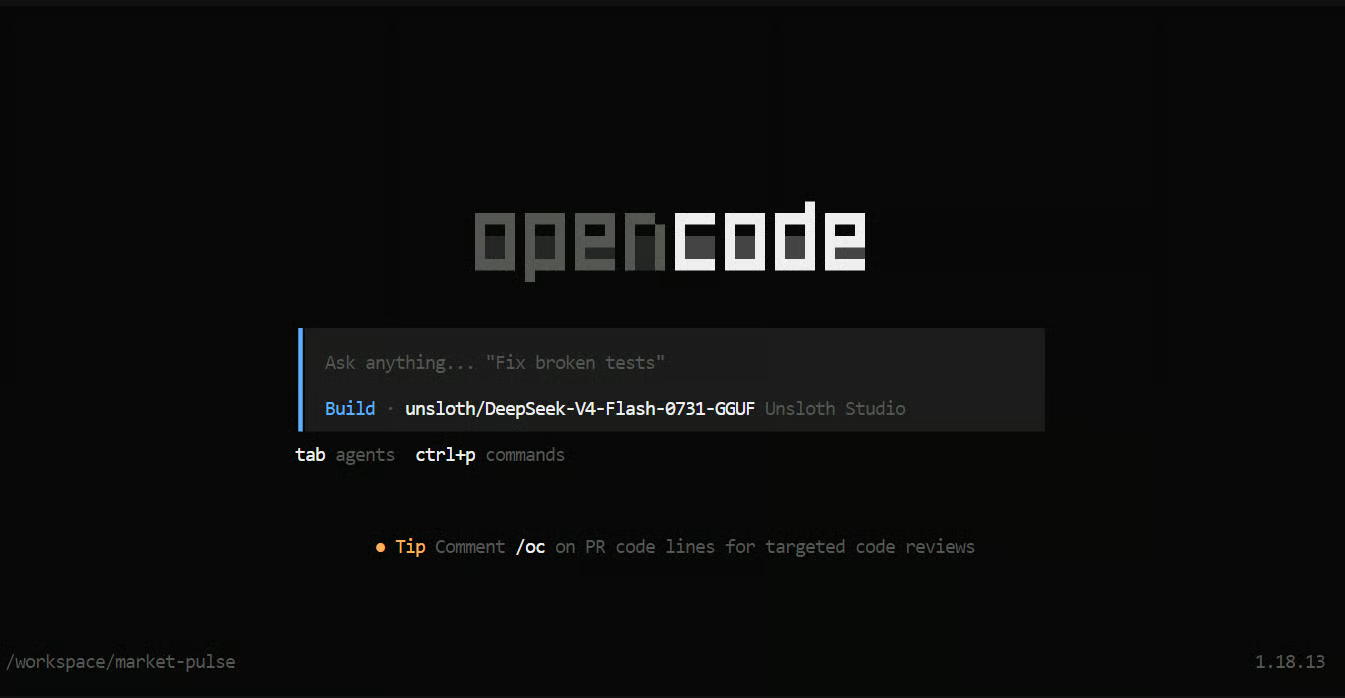
Tempel prompt dua baris berikut ke OpenCode:
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
Dalam beberapa detik, agen pemrograman akan membuat daftar tugas terperinci dan mulai mengerjakan proyek langkah demi langkah.
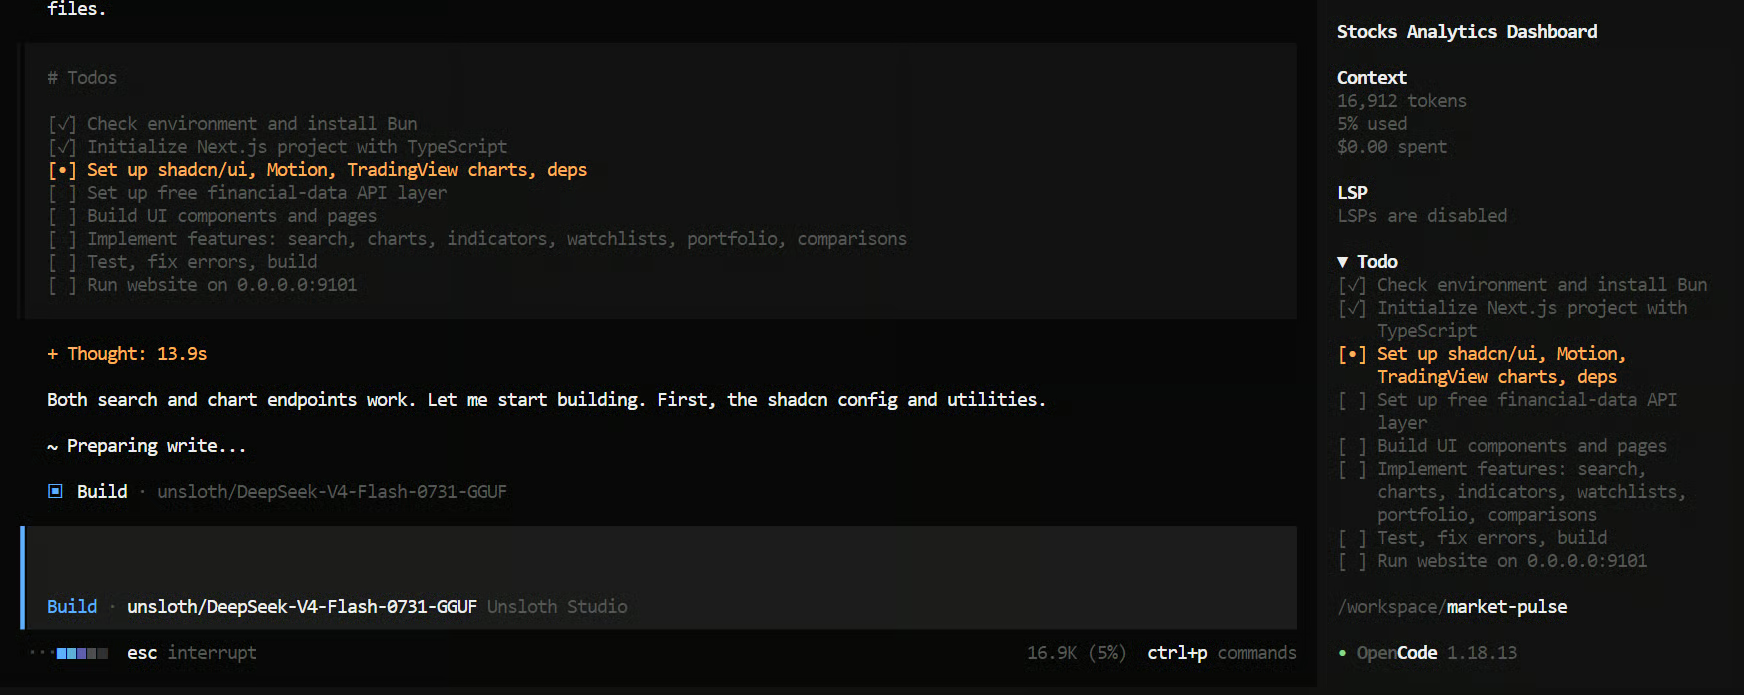
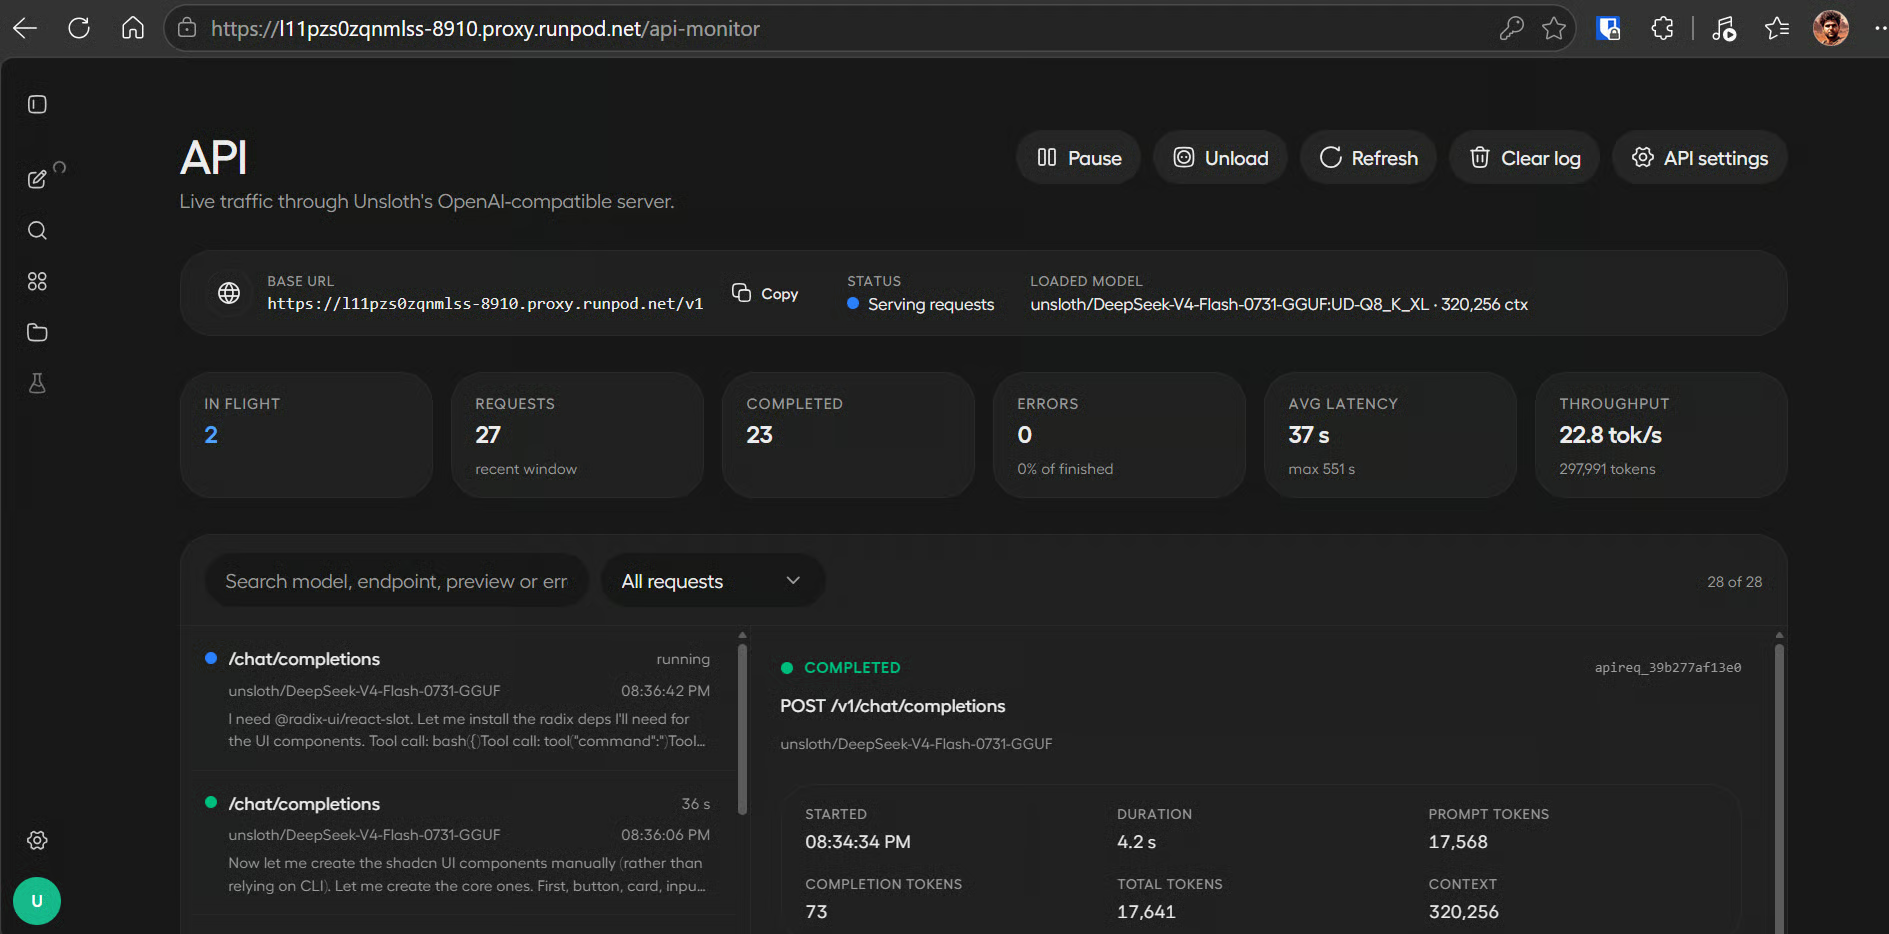
Pembangunan penuh memakan waktu sekitar 20 menit dalam pengujian kami. Saat berjalan, Anda dapat kembali ke Unsloth Studio dan membuka halaman pemantauan API di Settings untuk melacak penggunaan model dan kecepatan generasi.
Kami mengamati rata-rata sekitar 22,6 token per detik selama alur kerja pemrograman. Kecepatan dapat menurun seiring percakapan dan konteks proyek bertambah.
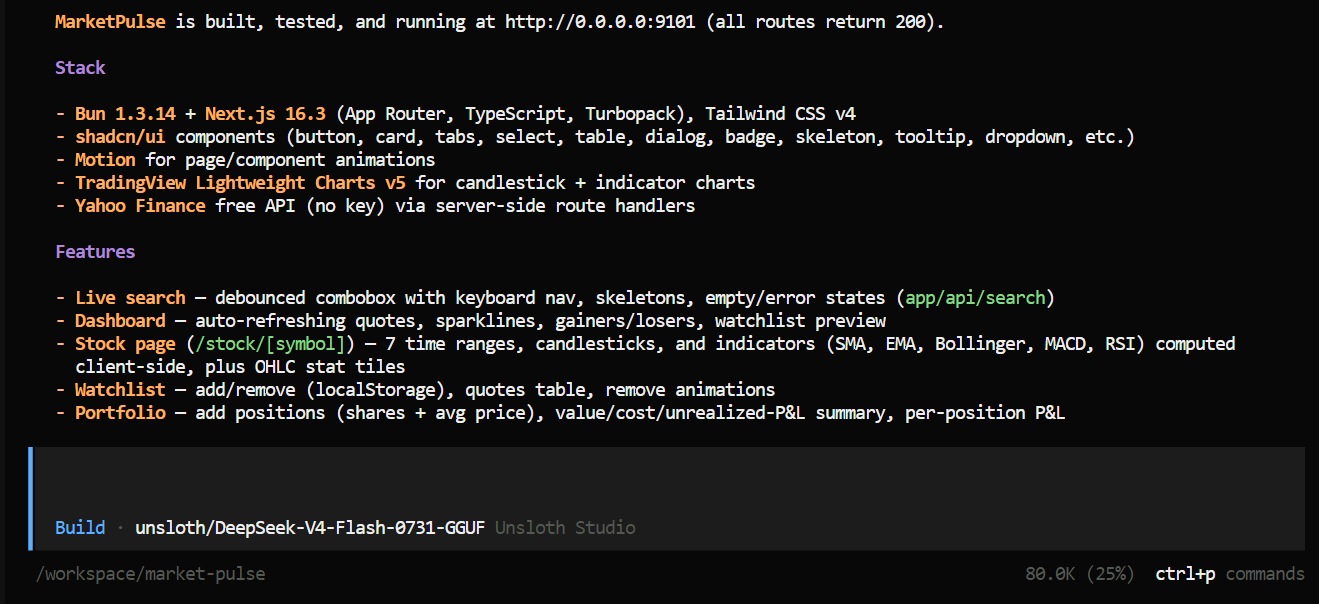
Setelah menyelesaikan tugas, OpenCode akan memberikan ringkasan berkas, fitur, dan perintah yang dibuat. OpenCode juga akan menjalankan situs web jadi pada port 9101.
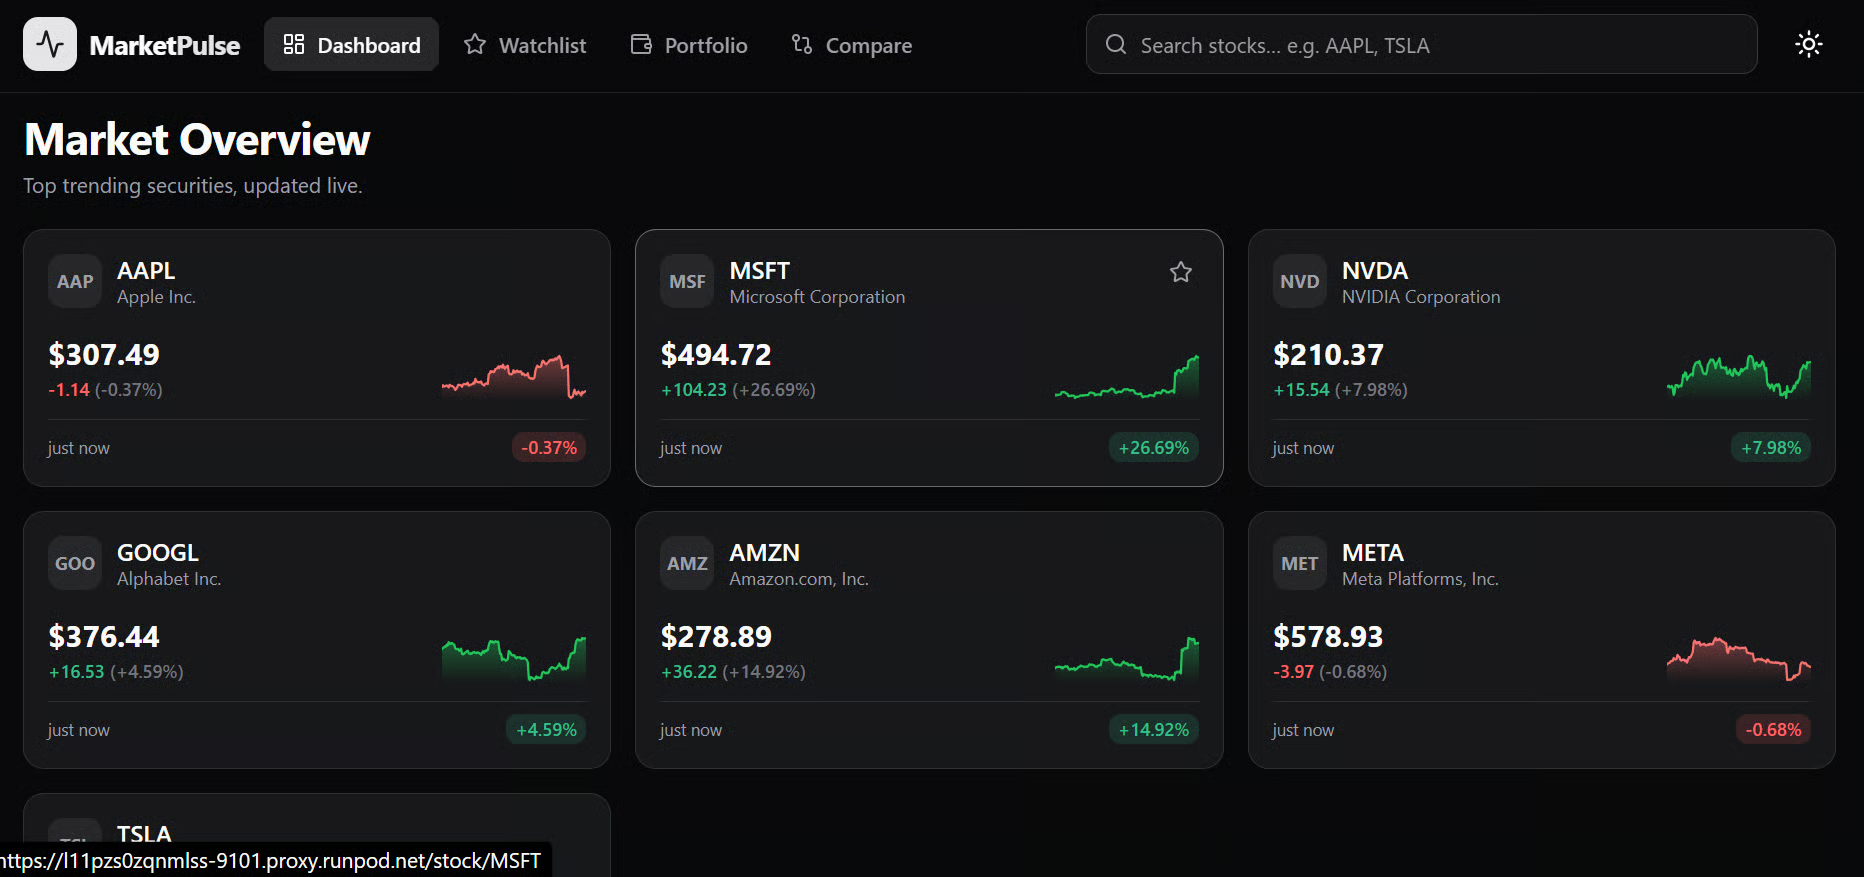
Kembali ke halaman Connect RunPod dan buka HTTP Service untuk port 9101.
Hasilnya mengejutkan cukup rapi. Situs web terlihat bersih, animatif, dan mirip dasbor trading profesional. Model menyelesaikan aplikasi web dalam satu prompt, termasuk antarmuka, tampilan data, grafik, dan navigasi.
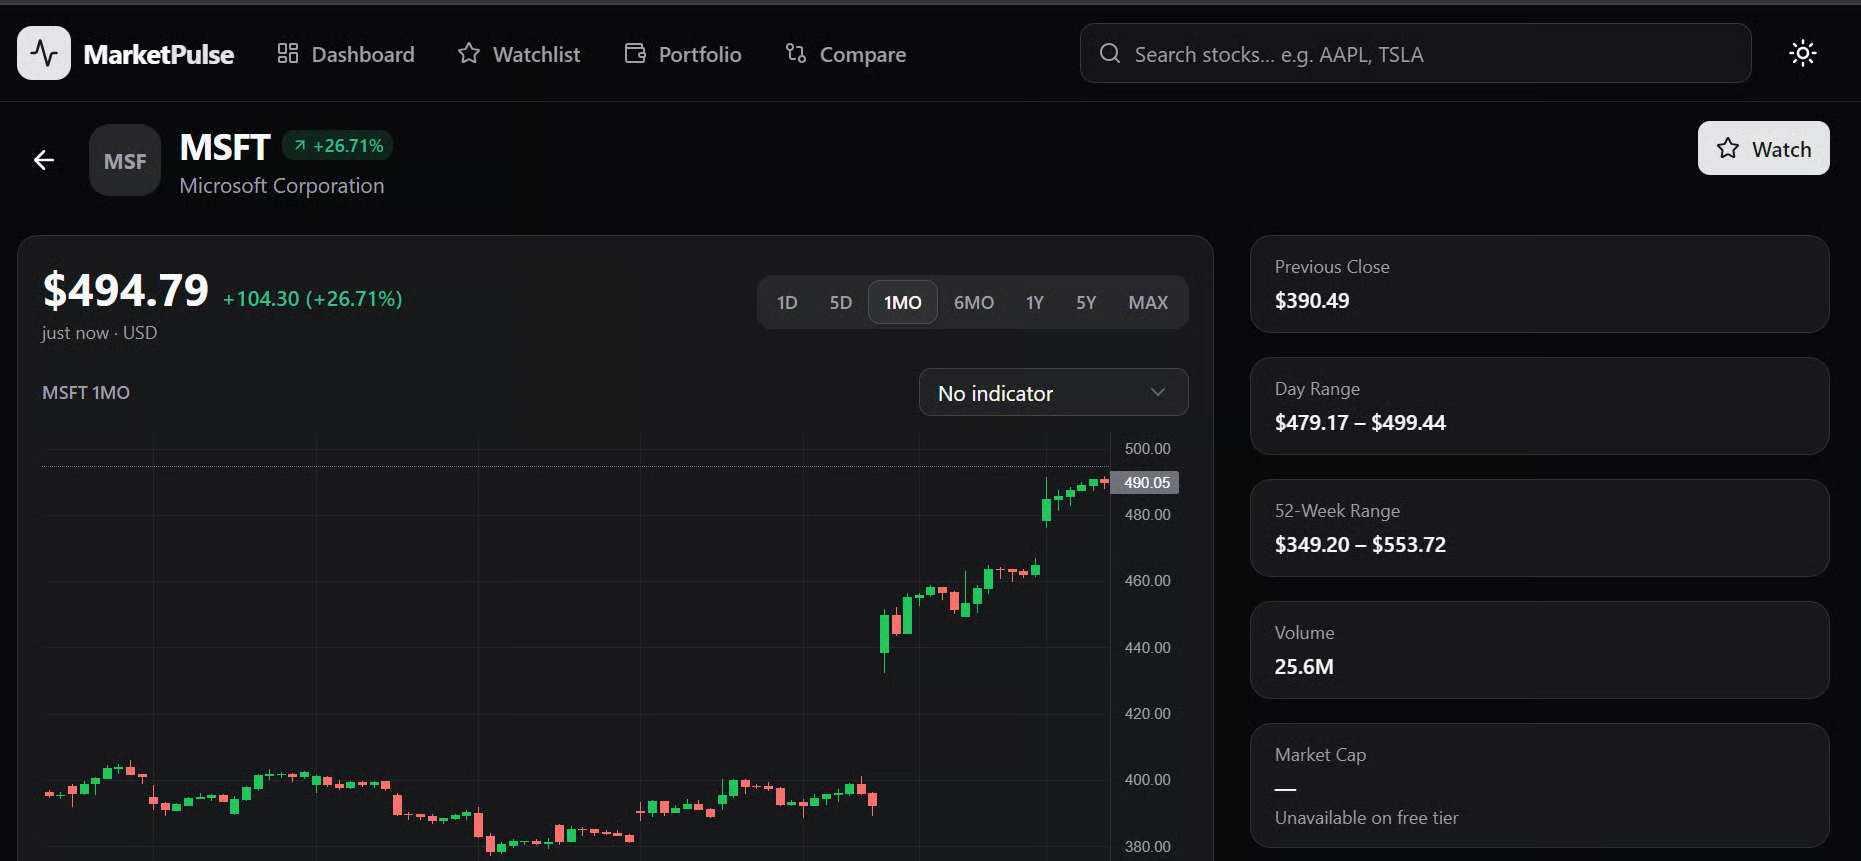
Anda dapat memilih ticker saham individual untuk melihat grafik candlestick, performa historis, indikator, dan informasi perusahaan tambahan.
Tab Compare juga memungkinkan Anda membandingkan beberapa saham dan melihat mana yang berkinerja lebih baik selama periode yang dipilih.
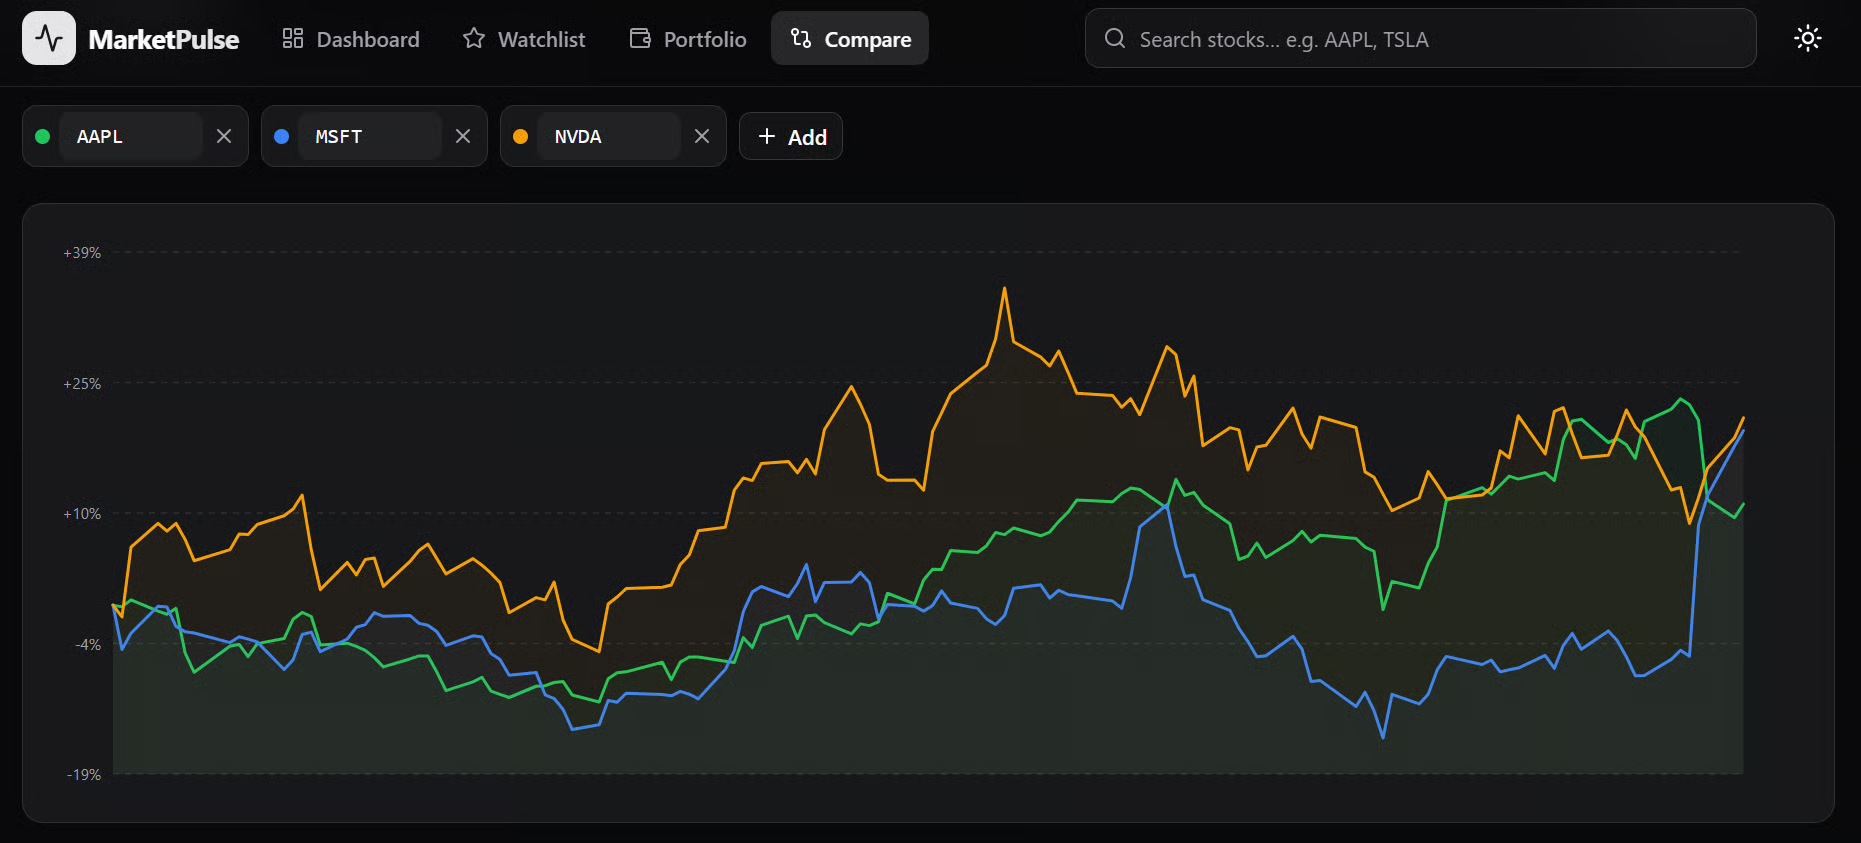
Saya benar-benar terkejut bahwa model lokal yang lebih kecil dapat membangun seluruh situs web dari satu prompt.
Setelah menguji aplikasi, setiap fitur utama berfungsi sebagaimana mestinya, termasuk harga saham live, data pasar historis, grafik, indikator, dan alat perbandingan.
Luar biasa melihat betapa cepatnya model lokal berkembang dan betapa mampu mereka menyelesaikan tugas pengembangan kompleks end-to-end.
Bagi saya, DeepSeek-V4-Flash-0731 adalah model lokal terbaik yang pernah saya uji sejauh ini.
Performanya lebih baik daripada Inkling, kuantisasi GLM-5.2 2-bit, dan Qwen3.6-27B, yang sebelumnya menjadi favorit saya. Ini berdasarkan pengalaman pribadi saya, bukan tolok ukur formal, tetapi sekarang menjadi model lokal pilihan saya.
Untuk sebagian besar beban kerja praktis, saya tetap akan mulai dengan API resmi DeepSeek karena harganya sangat terjangkau.
V4 Flash saat ini berharga $0,14 per satu juta token masukan yang tidak di-cache, $0,0028 per satu juta token masukan yang di-cache, dan $0,28 per satu juta token keluaran. Dengan tarif tersebut, satu miliar token masukan yang di-cache akan berharga sekitar $2,80 sebelum biaya keluaran.
Sebelum memilih Unsloth Studio, saya mencoba menjalankan model melalui llama.cpp. Penginstal bawaan tidak menyediakan biner CUDA terbaru yang cocok untuk lingkungan saya, dan meskipun saya mengompilasi versi terbaru dari sumber, saya menghadapi masalah lebih lanjut saat mengaktifkan DSpark speculative decoding.
Pada akhirnya, Unsloth Studio memberikan penyiapan paling sederhana dan menghilangkan sebagian besar konfigurasi manual. Studio bekerja dengan baik dengan OpenCode, meskipun membangun aplikasi lengkap memakan waktu sekitar 20 menit.
Kursus Teratas DataCamp
Kursus
Kursus
Program
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt