course
AI-assisterad kodning för utvecklare
1 tim 30 min
9.9K
Mindre och snabbare betyder inte längre automatiskt mindre kapabel. Enligt DeepSeeks publicerade utvärderingar använder DeepSeek-V4-Flash-0731 en betydligt mindre mängd aktiverade parametrar än DeepSeek-V4-Pro samtidigt som den levererar agentprestanda nära branschens framkant: den får 82,7 på Terminal Bench 2.1, jämfört med 81,0 för GLM-5.2 och 85,0 för Opus 4.8, medan dess 25,2 på Agents’ Last Exam ligger nära Opus 4.8:s 25,7.
Eftersom vikterna är öppet tillgängliga kan du i teorin köra modellen på din egen hårdvara när du har tillräckligt med kombinerat RAM eller VRAM, så att inferens och projektdata förblir under din kontroll.
I den här guiden konfigurerar vi en RunPod‑miljö med tre GPU:er, installerar och startar Unsloth Studio, laddar ner och laddar Q8‑versionen av DeepSeek-V4-Flash-0731 över GPU:erna, testar modellen via Studio, kopplar den lokala inferensservern till OpenCode och använder kodningsagenten för att bygga och lansera en interaktiv webbplats för aktieanalys.
DeepSeek-V4-Flash-0731 är den officiella utgåvan som ersätter den tidigare förhandsvisningen, med stora förbättringar inom kodning, verktygsanvändning och autonoma agentuppgifter. Dess Mixture‑of‑Experts‑arkitektur aktiverar bara en del av modellen för varje token. Detta hjälper den att förbli mer effektiv samtidigt som den levererar stark prestanda.
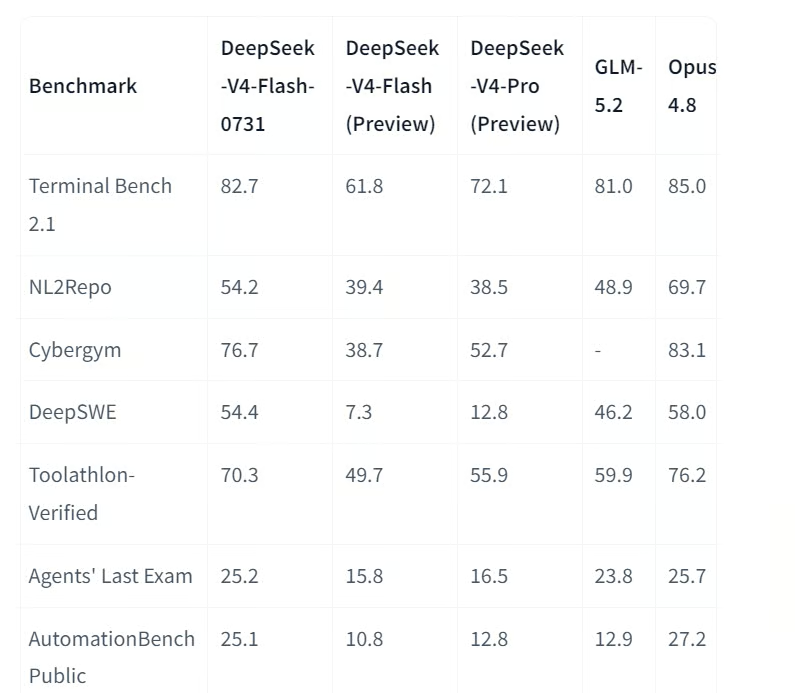
Källa: deepseek-ai/DeepSeek-V4-Flash-0731 · Hugging Face
DeepSeek rapporterar att modellen förbättrades från 61,8 till 82,7 på Terminal Bench 2.1 och från 7,3 till 54,4 på DeepSWE. Den överträffade också den större DeepSeek-V4-Pro Preview på flera agentbenchmark.
Modellen stöder context windows på upp till en miljon token. Detta gör den lämplig för stora kodbaser, långa dokument och komplexa arbetsflöden som kräver omfattande kontext. Användare kan också välja mellan låg, hög och maximal resonemangsinsats, beroende på hur mycket tid modellen ska lägga på att lösa en uppgift.
DeepSeek-V4-Flash-0731 inkluderar även DSpark spekulativ avkodning. DSpark skissar flera token innan huvudmodellen verifierar dem, vilket enligt DeepSeek kan förbättra genereringshastigheten med 60–85% när det används med en kompatibel inferensmotor.
Vi börjar med att skapa en RunPod‑miljö med tillräckligt med GPU‑minne och lagring för att köra Q8‑versionen av DeepSeek-V4-Flash-0731 och vara värd för både Unsloth Studio och webbplatsen som genereras av OpenCode.
Konfigurera podden med:
/workspace som monteringsväg för den beständiga volymenHF_TOKEN8910 och 9101 exponerade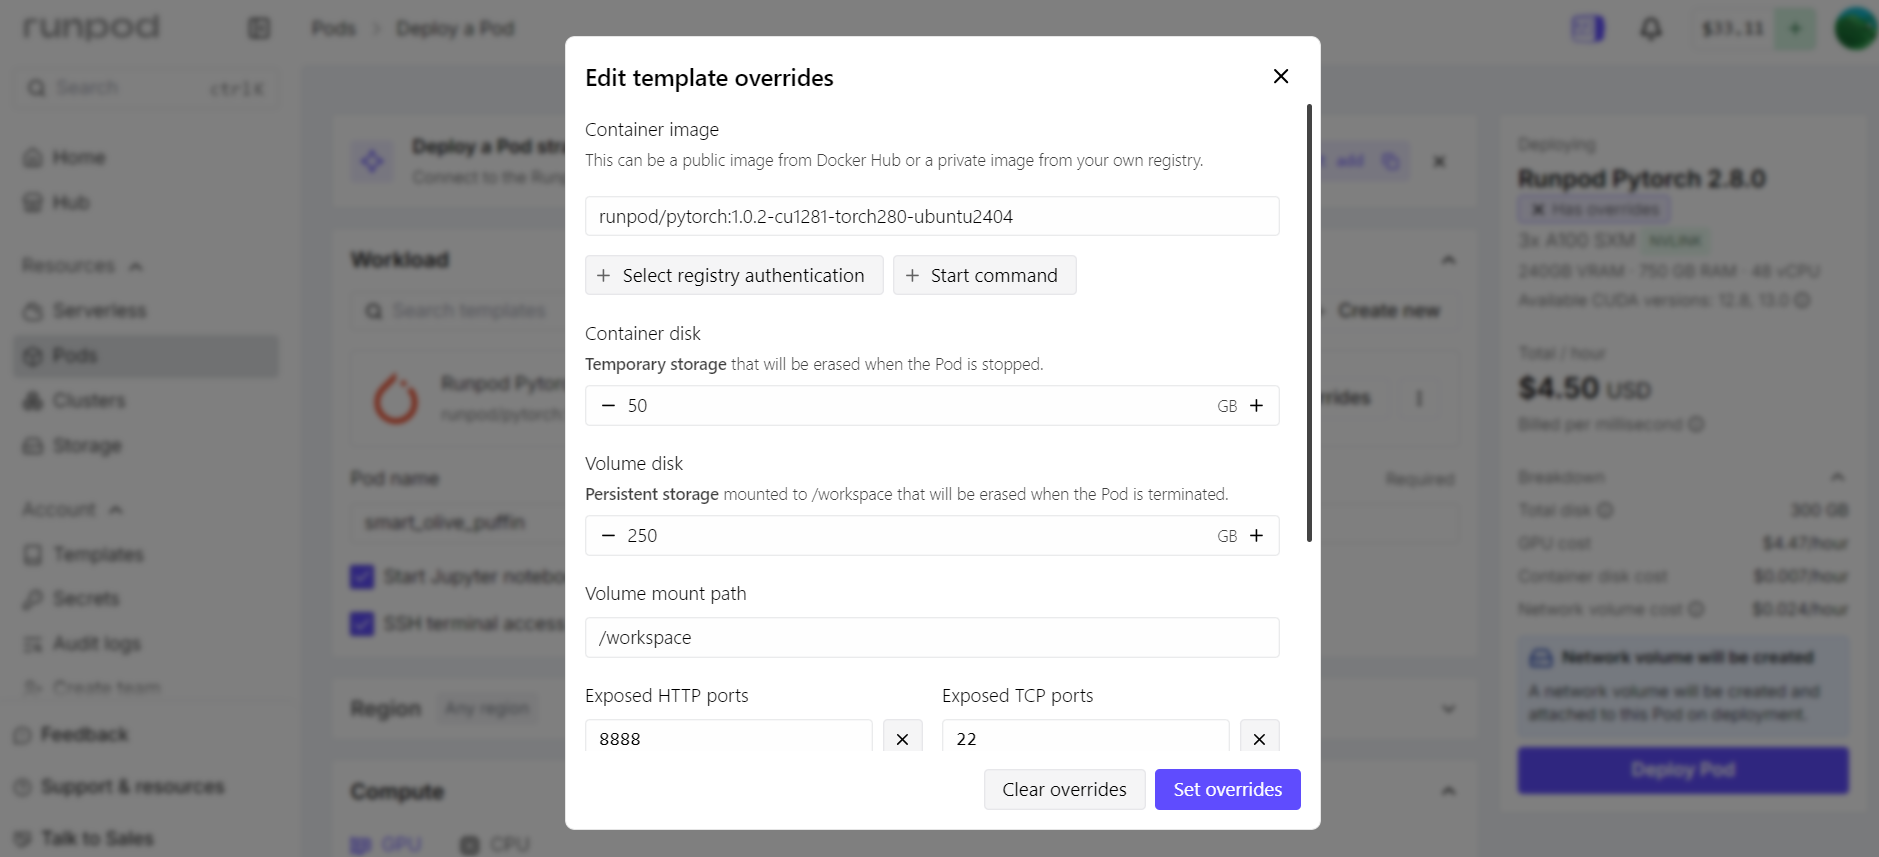
Port 8910 kommer att användas för Unsloth Studio och dess lokala inferens‑API. Port 9101 kommer att vara värd för den interaktiva webbplats som skapas av OpenCode.
RunPod exponerar dessa tjänster via sin HTTP‑proxy, så båda applikationerna måste lyssna på 0.0.0.0 i stället för bara 127.0.0.1.
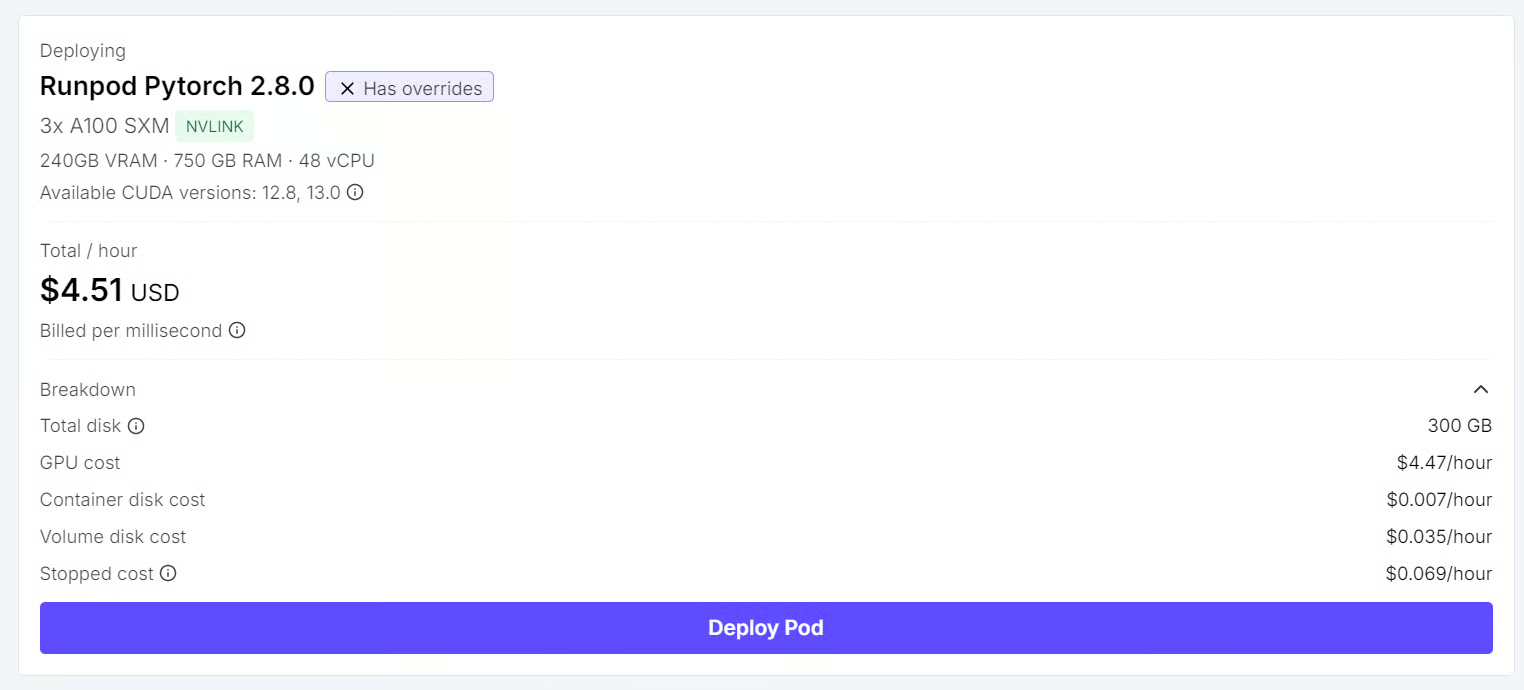
Efter att ha driftsatt podden, öppna fliken Connect, starta JupyterLab och skapa tre terminalsessioner:
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
Att hålla uppgifterna i separata terminaler gör det enklare att övervaka GPU:erna, felsöka modellen och köra kodningsagenten samtidigt.
Därefter installerar vi Unsloth Studio, konfigurerar en beständig Hugging Face‑cache och startar gränssnittet på port 8910.
I Terminal 1, bekräfta att alla tre GPU:er är tillgängliga:
nvidia-smiDu bör se alla tre A100‑GPU:er listade på Linux‑servern.
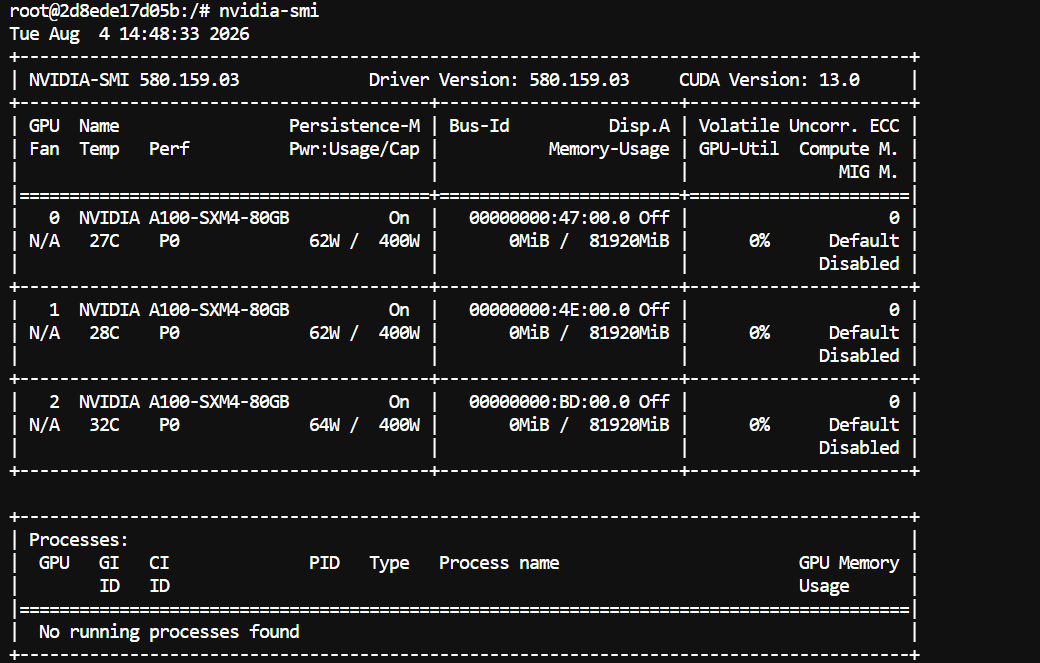
Skapa en beständig Hugging Face‑cache i /workspace så att nedladdade modeller förblir tillgängliga på RunPod‑volymen:
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
Installera sedan nödvändiga systempaket och Unsloth Studio:
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh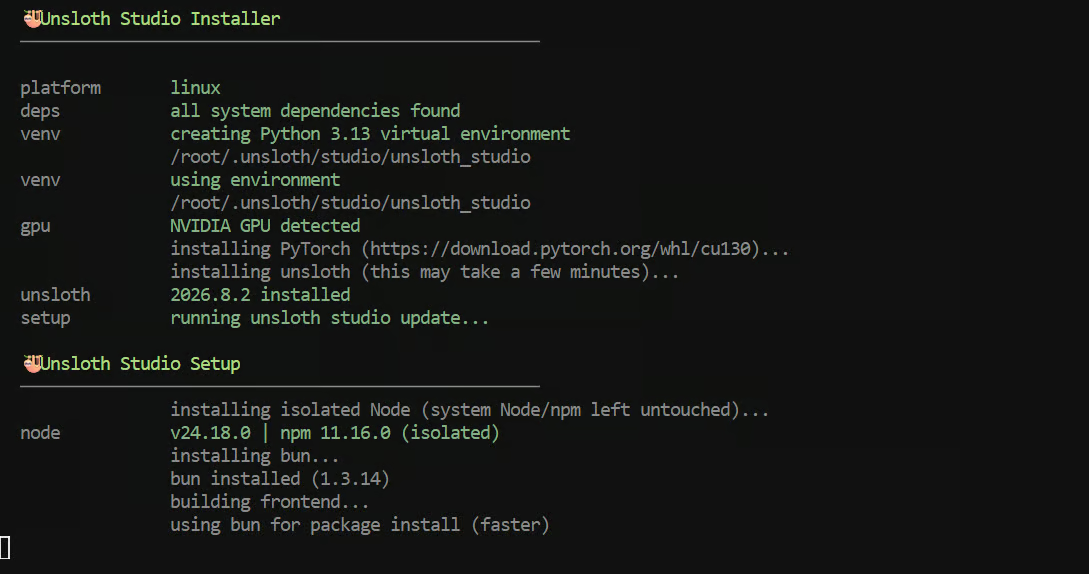
Installationsprogrammet konfigurerar Studio‑gränssnittet, Python‑miljön, beroenden och lokala inferenskomponenter.
Den första installationen kan ta flera minuter.
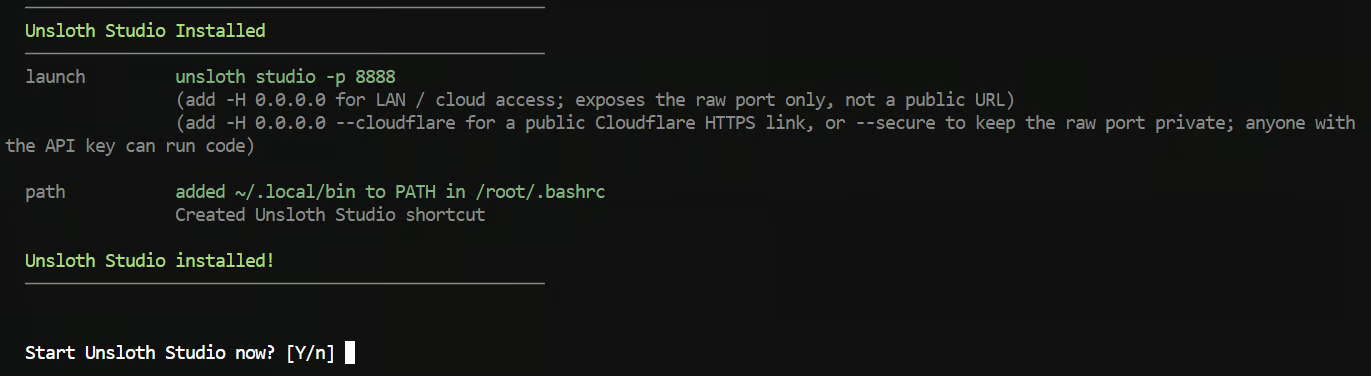
När installationsprogrammet frågar om du vill starta Unsloth Studio direkt, skriv ”n”.
Vi kommer att starta det manuellt så att det använder port 8910 och lyssnar på rätt nätverksadress.
Starta om skalet så att de nya kommandona är tillgängliga:
exec bash
cd /workspace
Innan vi startar Studio, återställ standardlösenordet:
unsloth studio reset-passwordKopiera det temporära lösenord som visades under installationen, eftersom du kan behöva det för att slutföra återställningen.
Starta nu Unsloth Studio:
unsloth studio \
  -H 0.0.0.0 \
  -p 8910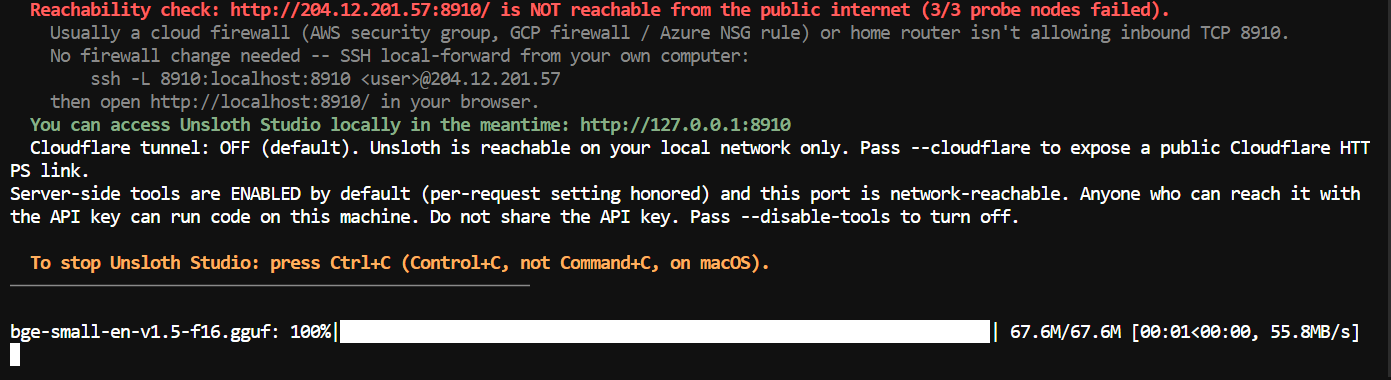
Studio bör nu rapportera att det körs på port 8910. Håll Terminal 1 öppen medan du använder Unsloth Studio och OpenCode.
Gå tillbaka till RunPods Connect‑sida och öppna HTTP‑tjänsten för port 8910.
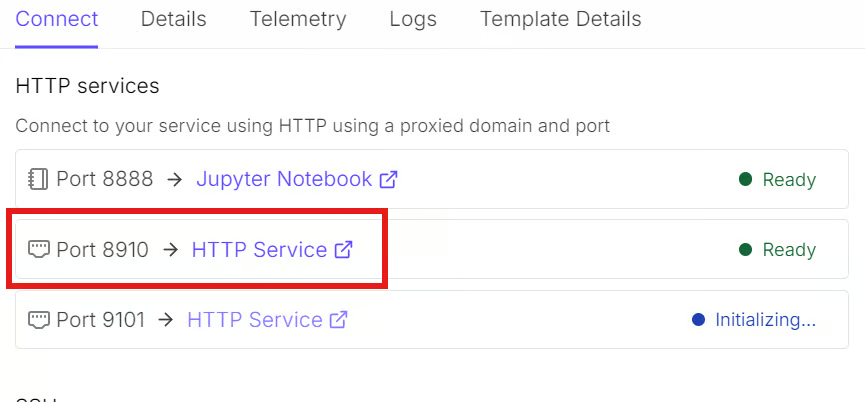
Använd det temporära lösenordet som genererades tidigare för att slutföra återställningen, logga sedan in med det nya lösenord du skapade.
Slutför eller hoppa över onboarding‑stegen och öppna Chat‑sidan.
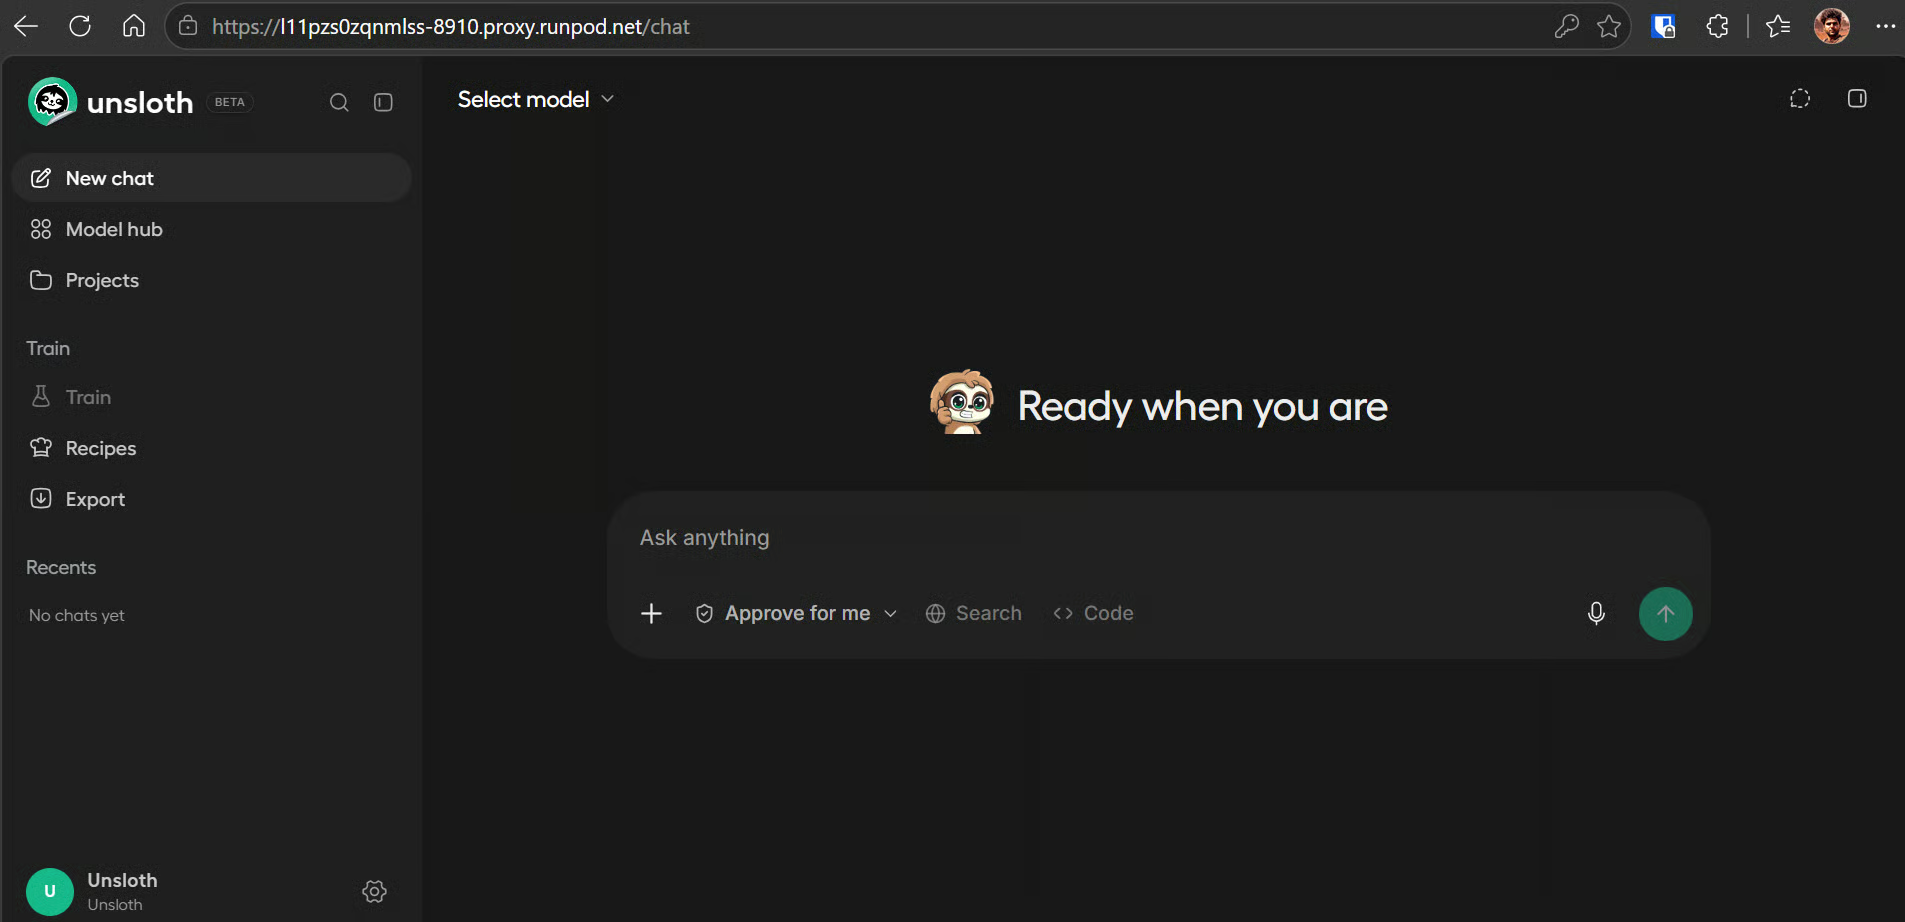
Nu när Unsloth Studio körs kan vi ladda ner Q8‑modellen, ladda den över de tre GPU:erna och testa dess chatt- och verktygsfunktioner.
Öppna modellväljaren i det övre vänstra hörnet och sök efter unsloth/DeepSeek-V4-Flash-0731-GGUF och välj sedan Q8‑kvantiseringen UD-Q8_K_XL.
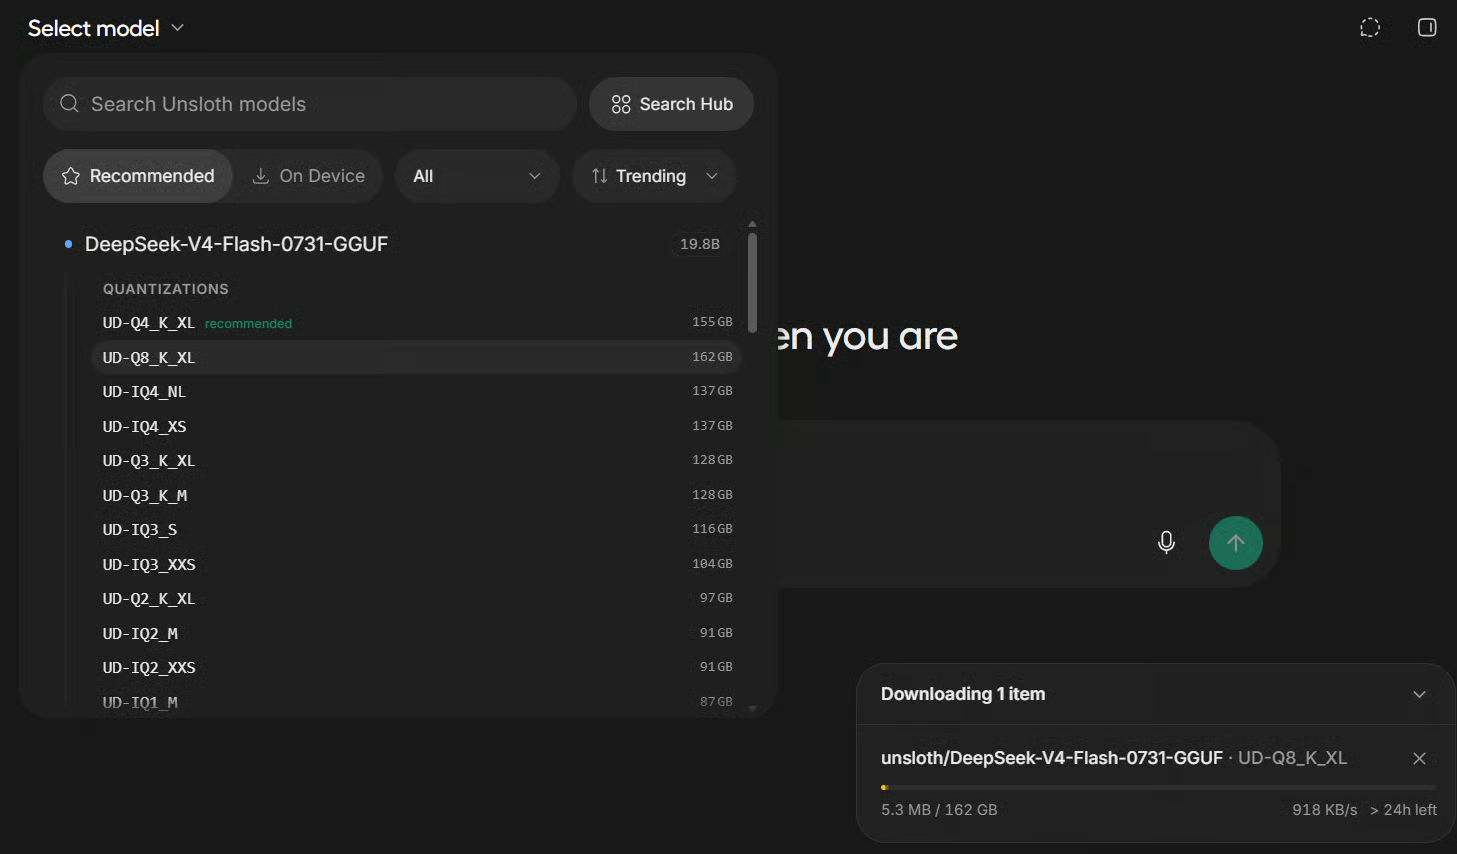
Vi använder Q8 eftersom de tre A100‑GPU:erna ger tillräckligt med kombinerat VRAM. Den bevarar kvaliteten närmare originalmodellen, medan lägre kvantiseringar är mer användbara när hårdvaruminne är begränsat.
När nedladdningen är klar börjar Unsloth Studio automatiskt ladda modellen i GPU‑minnet. Detta kan ta flera minuter eftersom Q8‑modellen är mycket stor.
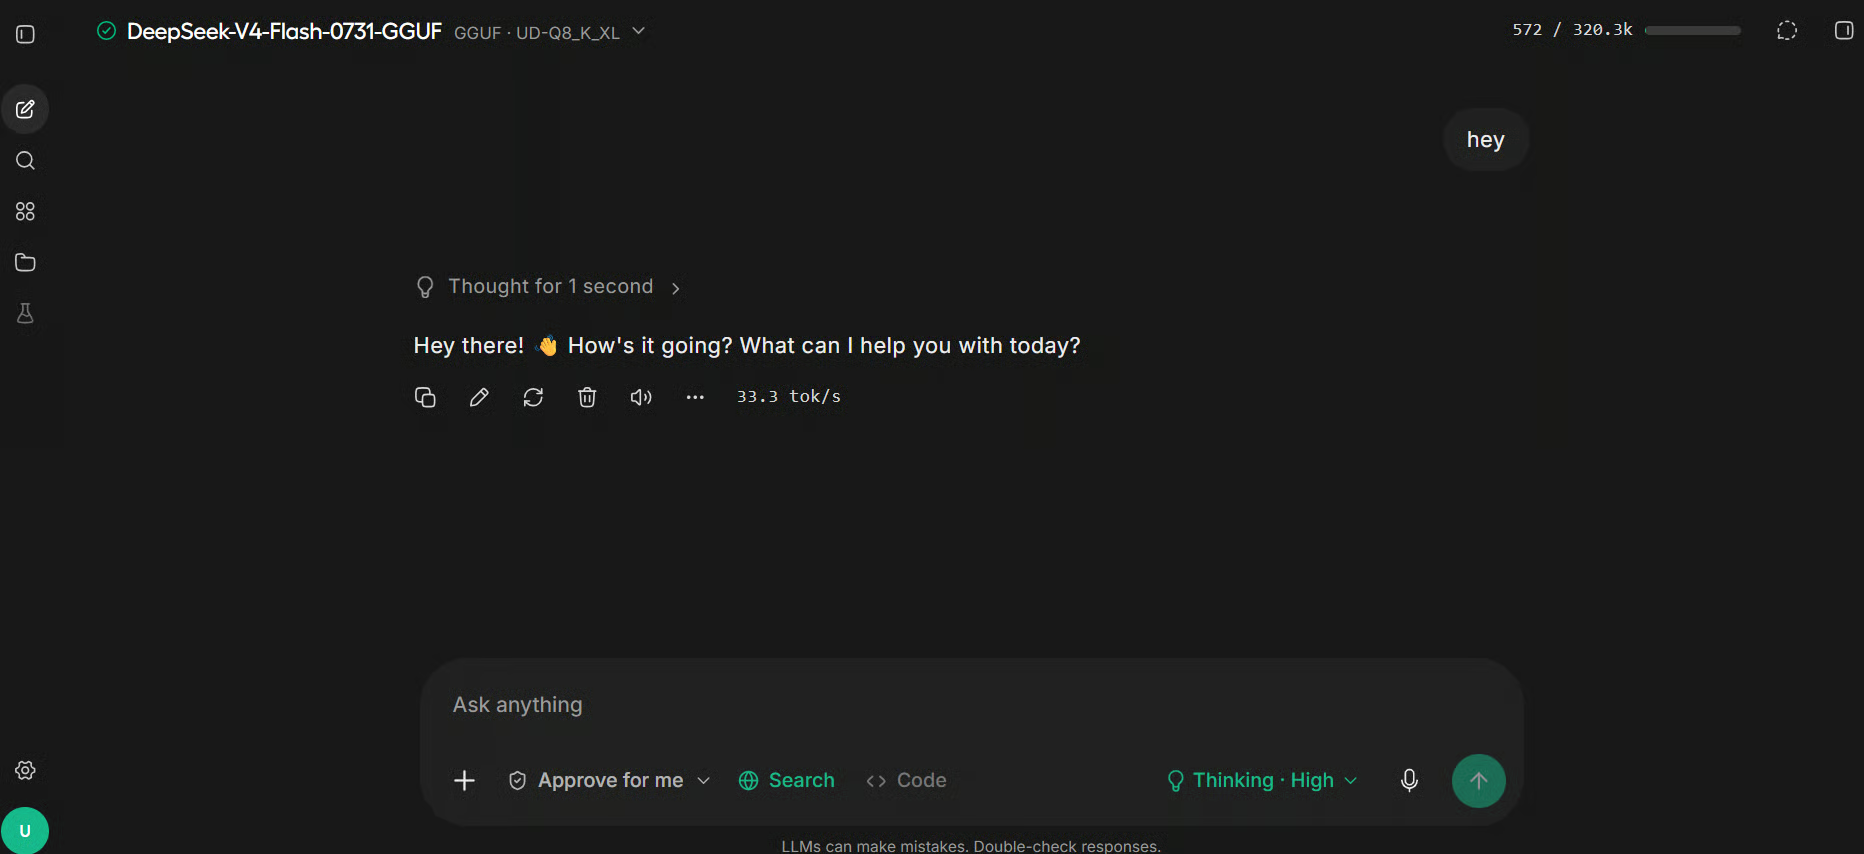
Efter inläsningen, använd sidan Chat för att testa modellen med några enkla uppmaningar.
I våra tester nådde genereringen cirka 33 token per sekund utan spekulativ avkodning, vilket är ett rimligt resultat för en modell i den här storleken.
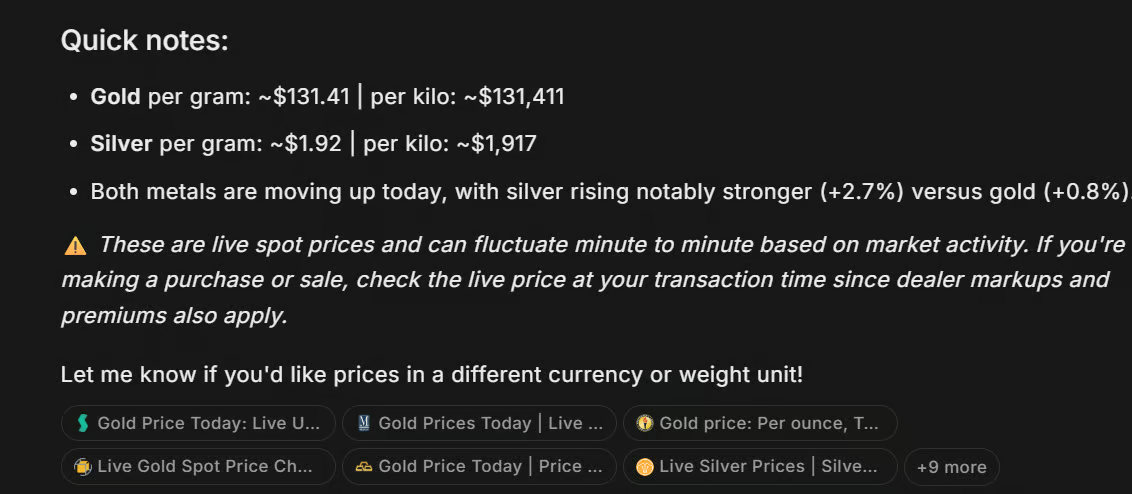
Du kan också aktivera Studios webbsökningsverktyg och be modellen slå upp aktuell information, såsom de senaste priserna på guld och silver. Detta är ett bra sätt att bekräfta att modellen kan anropa externa verktyg i stället för att enbart förlita sig på sin interna kunskap.
I Terminal 2, kontrollera hur modellen är fördelad över GPU:erna:
nvidia-smi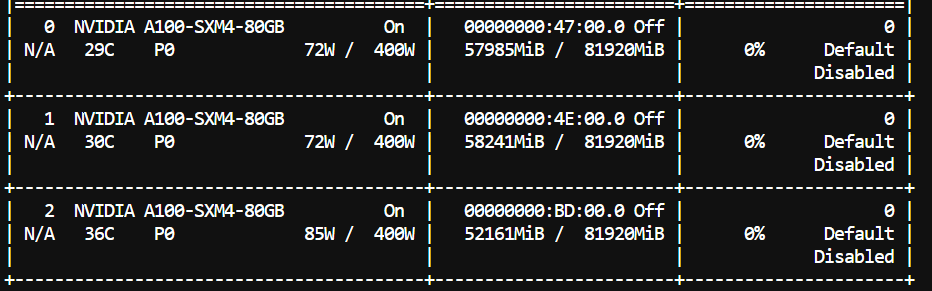
Du bör se avsevärd minnesanvändning på alla tre GPU:erna.
I vårt test var varje GPU omkring 70% full. Detta betyder dock inte nödvändigtvis att hela Q8‑modellen får plats bekvämt på bara två 80GB‑GPU:er, eftersom ytterligare VRAM fortfarande krävs för context window, KV‑cache och inferensbuffertar.
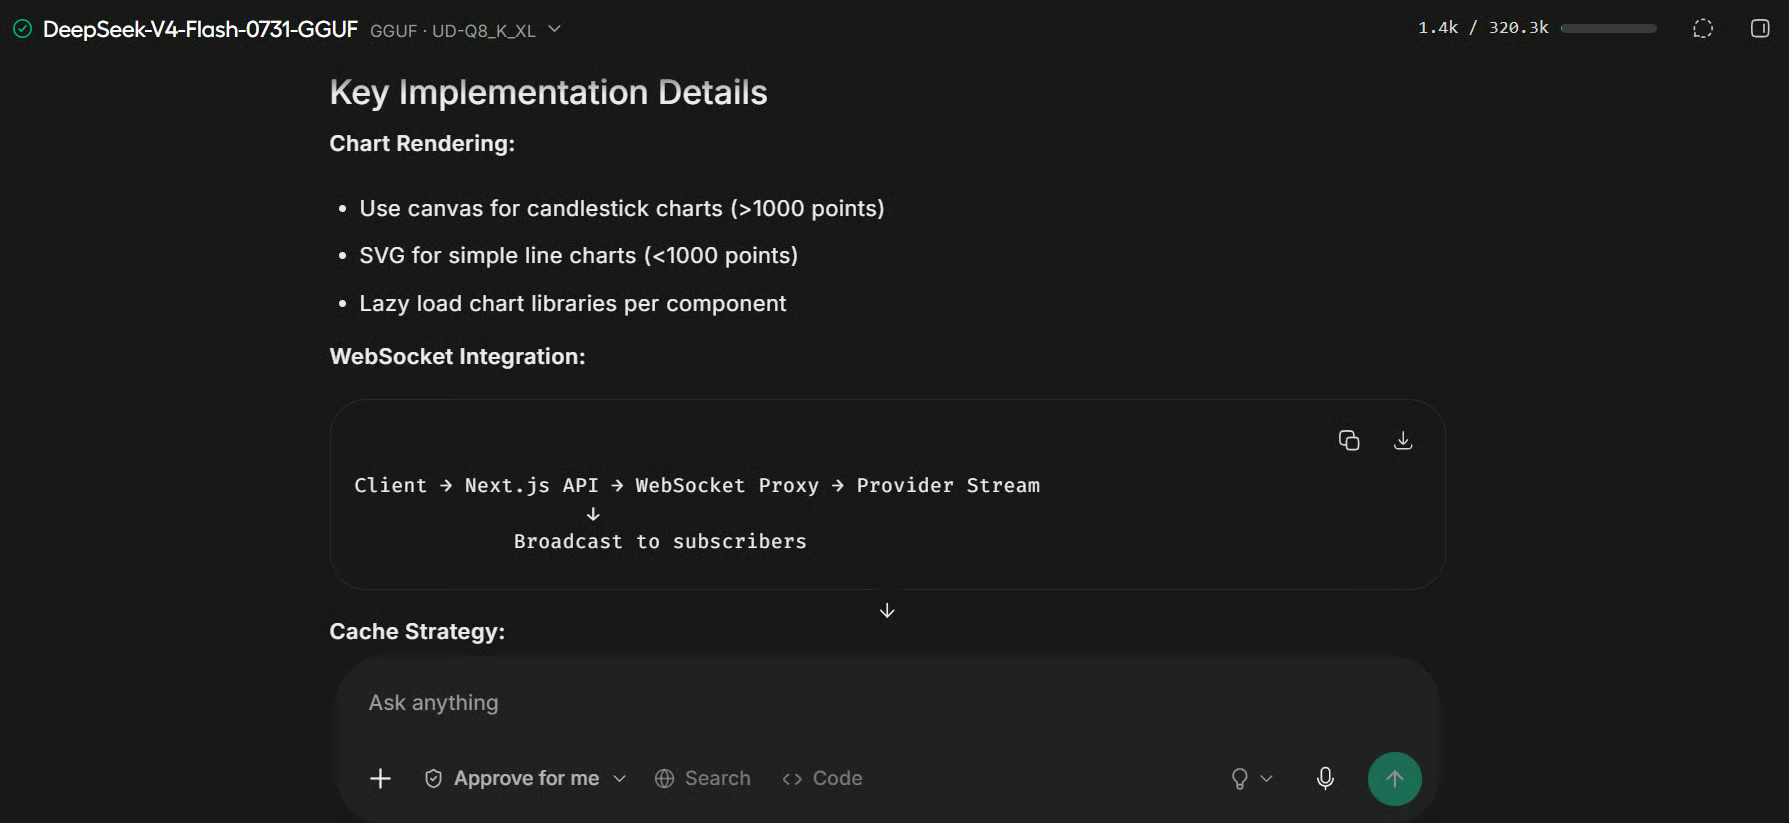
Testa slutligen modellen med planeringsprompten för applikationen vi ska bygga:
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
Modellen returnerar en strukturerad utvecklingsplan som täcker applikationsarkitektur, komponenter, dataflöde, diagrambibliotek, finansiella beräkningar och gränssnittsdesign.
Nu när modellen körs i Unsloth Studio kan vi koppla den till OpenCode och använda den som en lokal kodningsagent.
I Terminal 3, ställ in Studio‑URL:en:
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
Skapa en ny projektmapp:
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
Starta OpenCode via Unsloth Studio:
unsloth start opencodeFörsta gången du kör det här kommandot kommer det att be om tillstånd att installera OpenCode. Skriv ”y”.
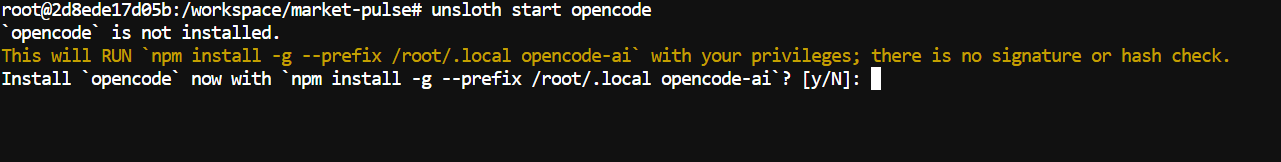
När installationen är klar startar OpenCode med den lokalt körande modellen DeepSeek-V4-Flash-0731 redan konfigurerad.
Klistra in följande två‑raders prompt i OpenCode:
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
Inom några sekunder bör kodningsagenten skapa en detaljerad uppgiftslista och börja arbeta sig igenom projektet steg för steg.
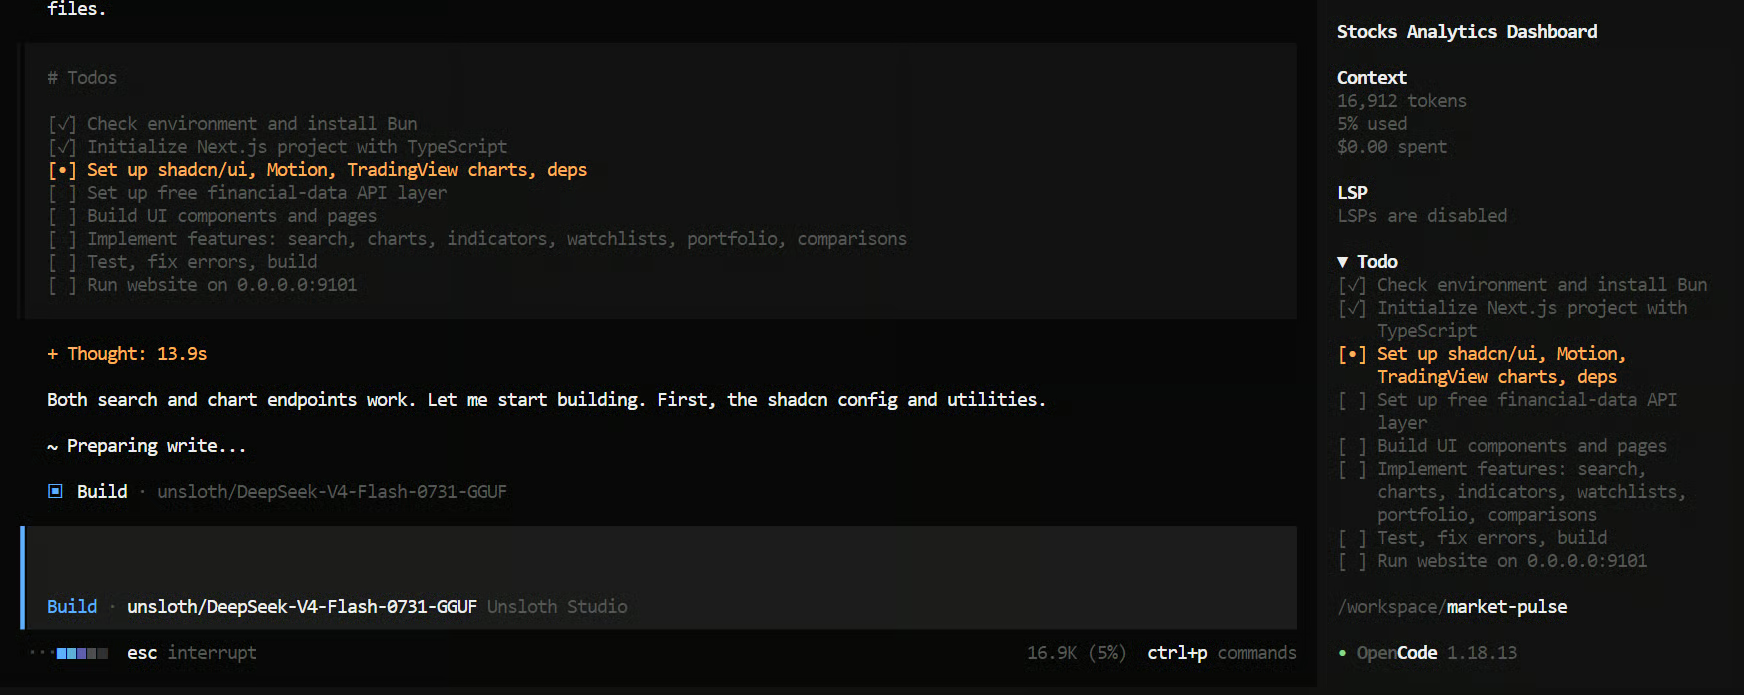
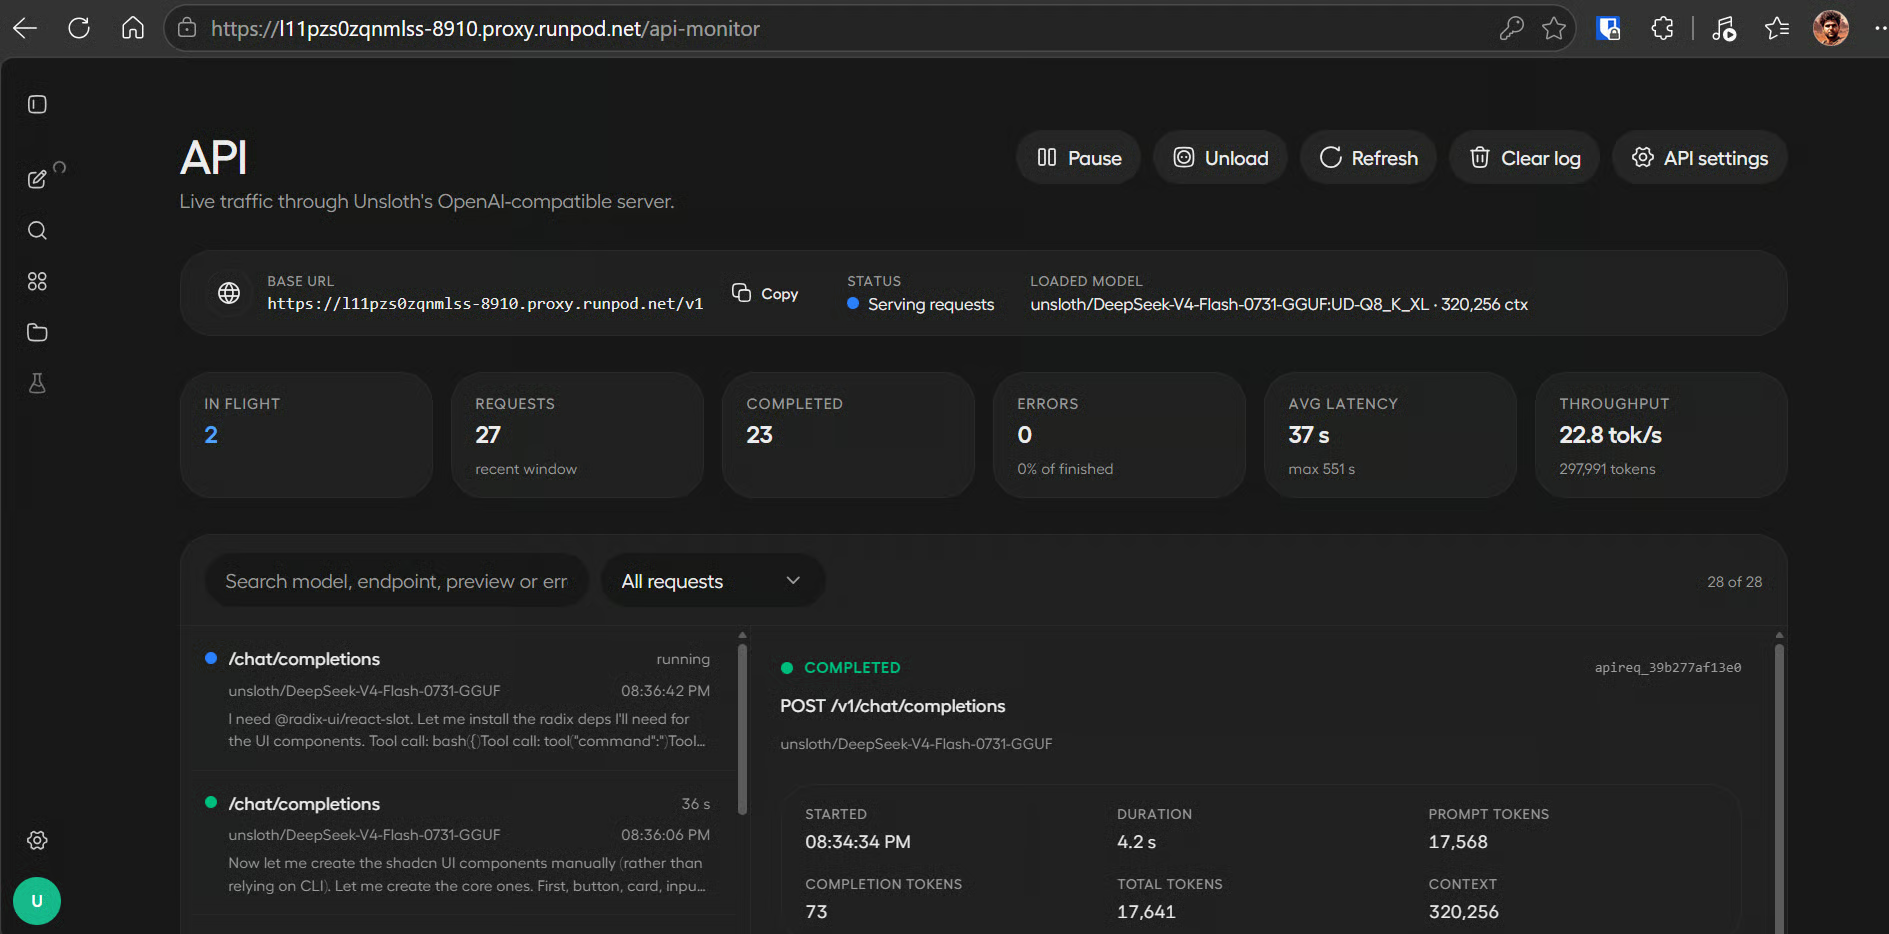
Hela bygget tog omkring 20 minuter i vårt test. Medan det körs kan du gå tillbaka till Unsloth Studio och öppna API‑övervakningssidan i Settings för att spåra modellens användning och genereringshastighet.
Vi observerade ett genomsnitt på cirka 22,6 token per sekund under kodningsarbetsflödet. Hastigheten kan minska när konversationen och projektkontexten växer.
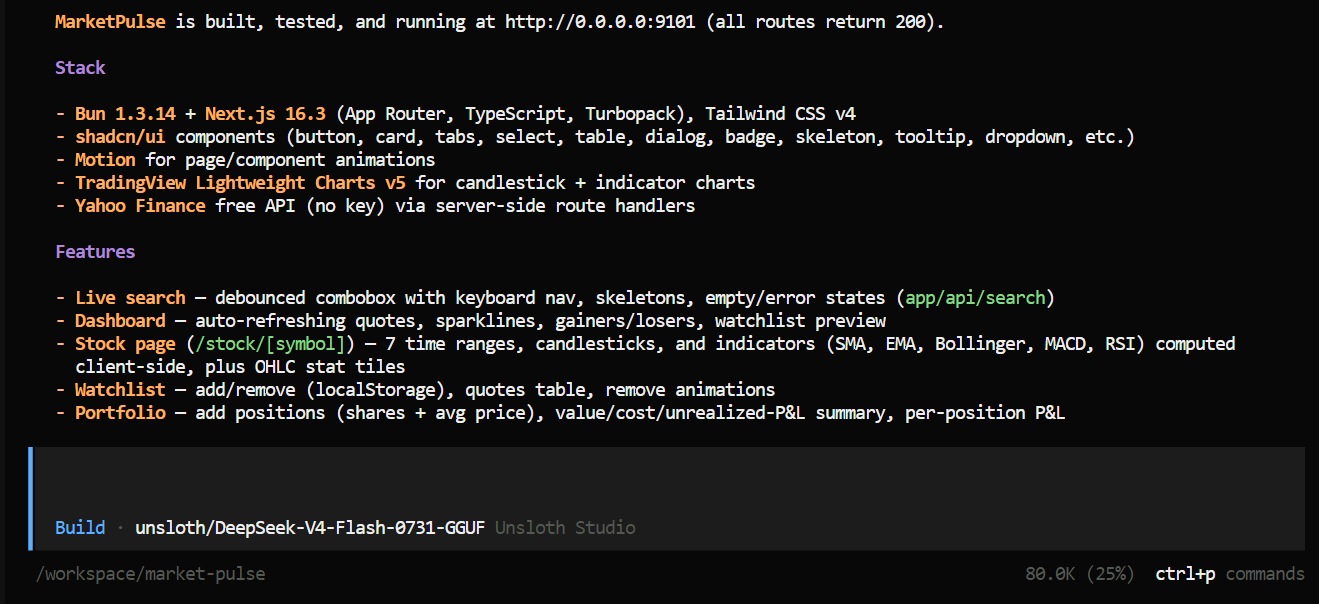
Efter att ha slutfört uppgifterna bör OpenCode ge en sammanfattning av de filer, funktioner och kommandon som skapats. Det bör också starta den färdiga webbplatsen på port 9101.
Gå tillbaka till RunPods Connect‑sida och öppna HTTP‑tjänsten för port 9101.
Resultatet var förvånansvärt polerat. Webbplatsen såg ren ut, hade animationer och liknade en professionell handelsdashboard. Modellen färdigställde webbapplikationen med en enda prompt, inklusive gränssnitt, datavyer, diagram och navigering.
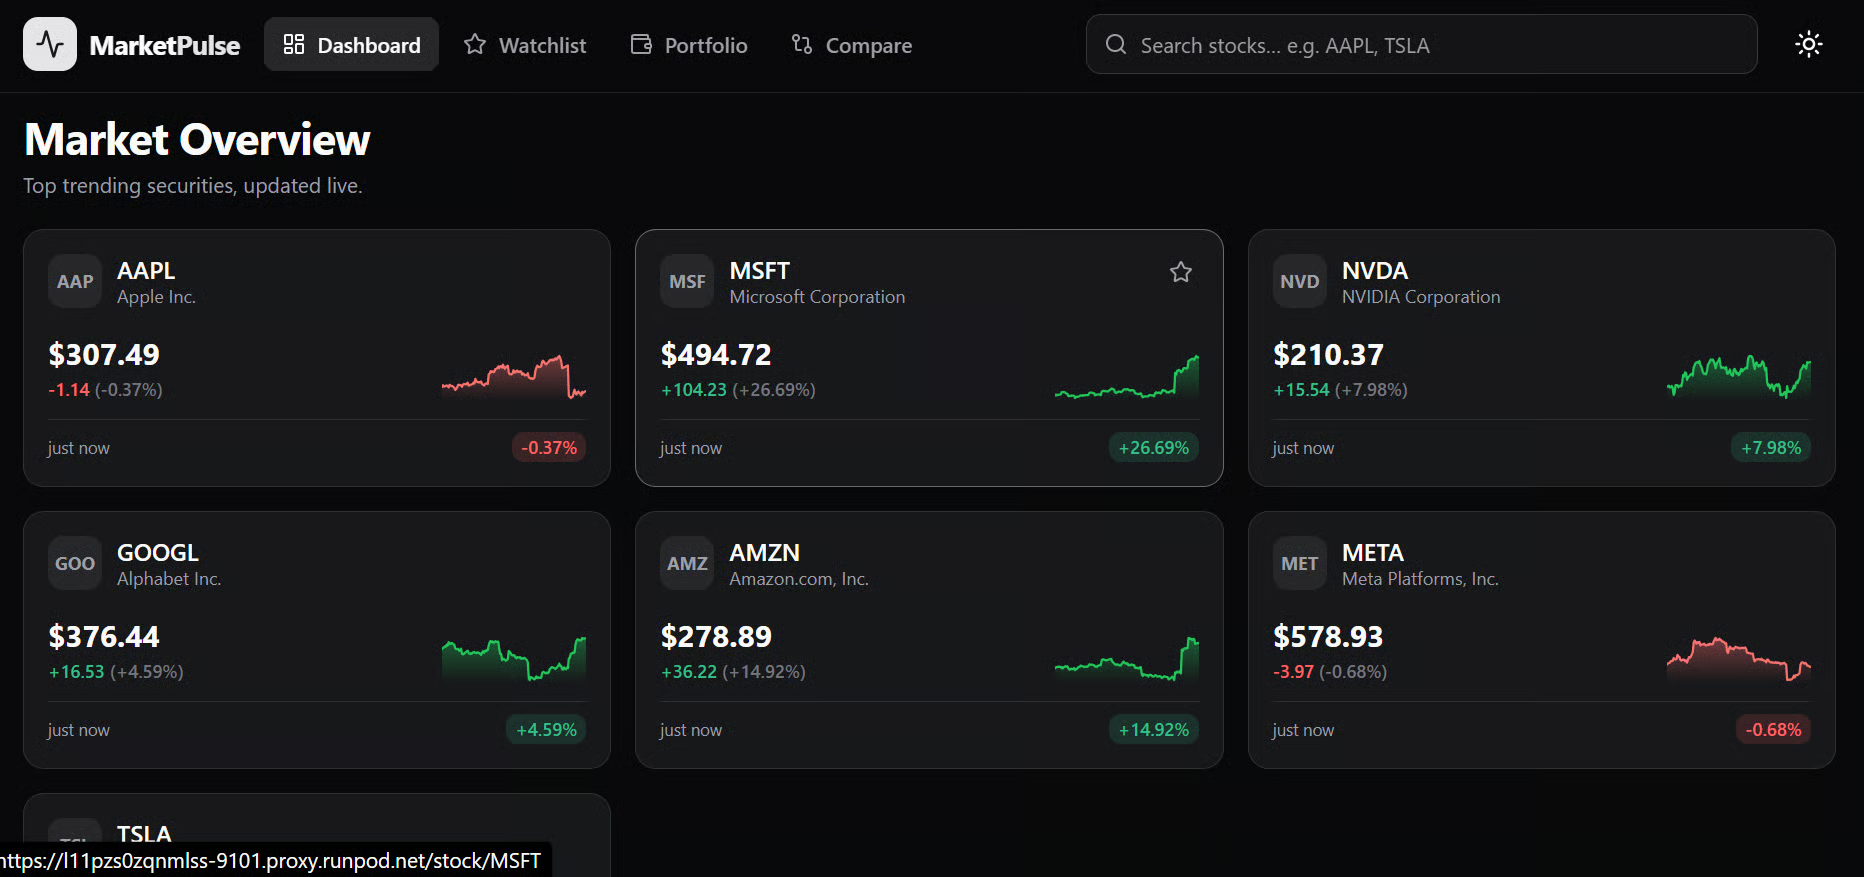
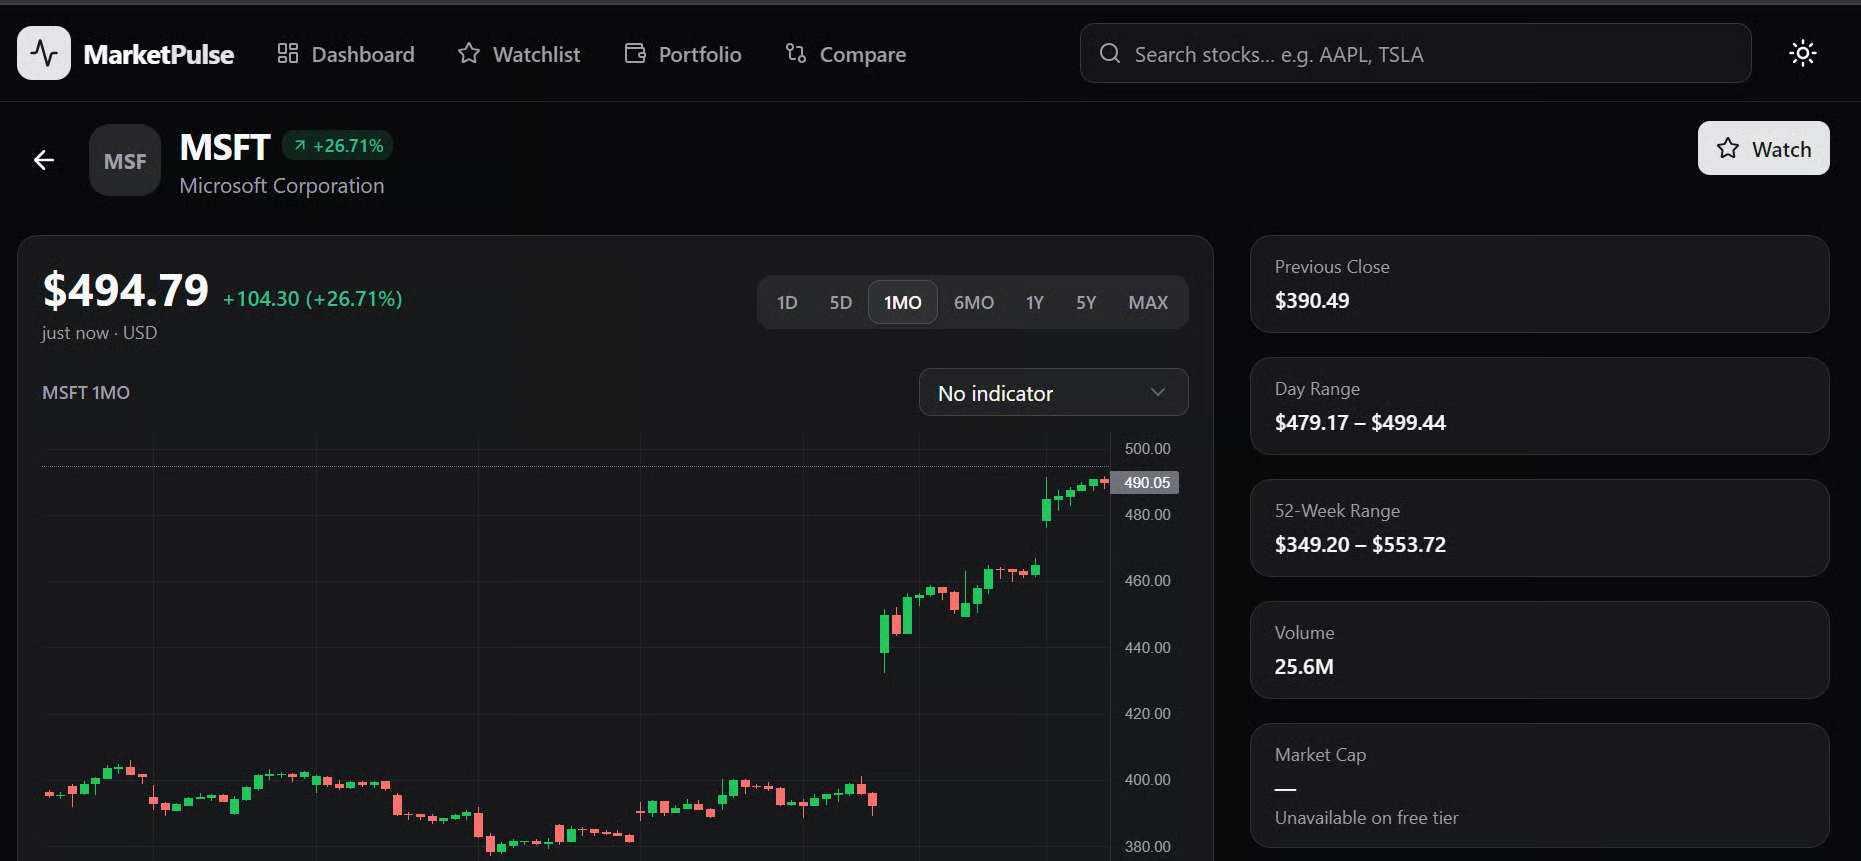
Du kan välja enskilda aktietickers för att visa ljusstakediagram, historisk utveckling, indikatorer och ytterligare företagsinformation.
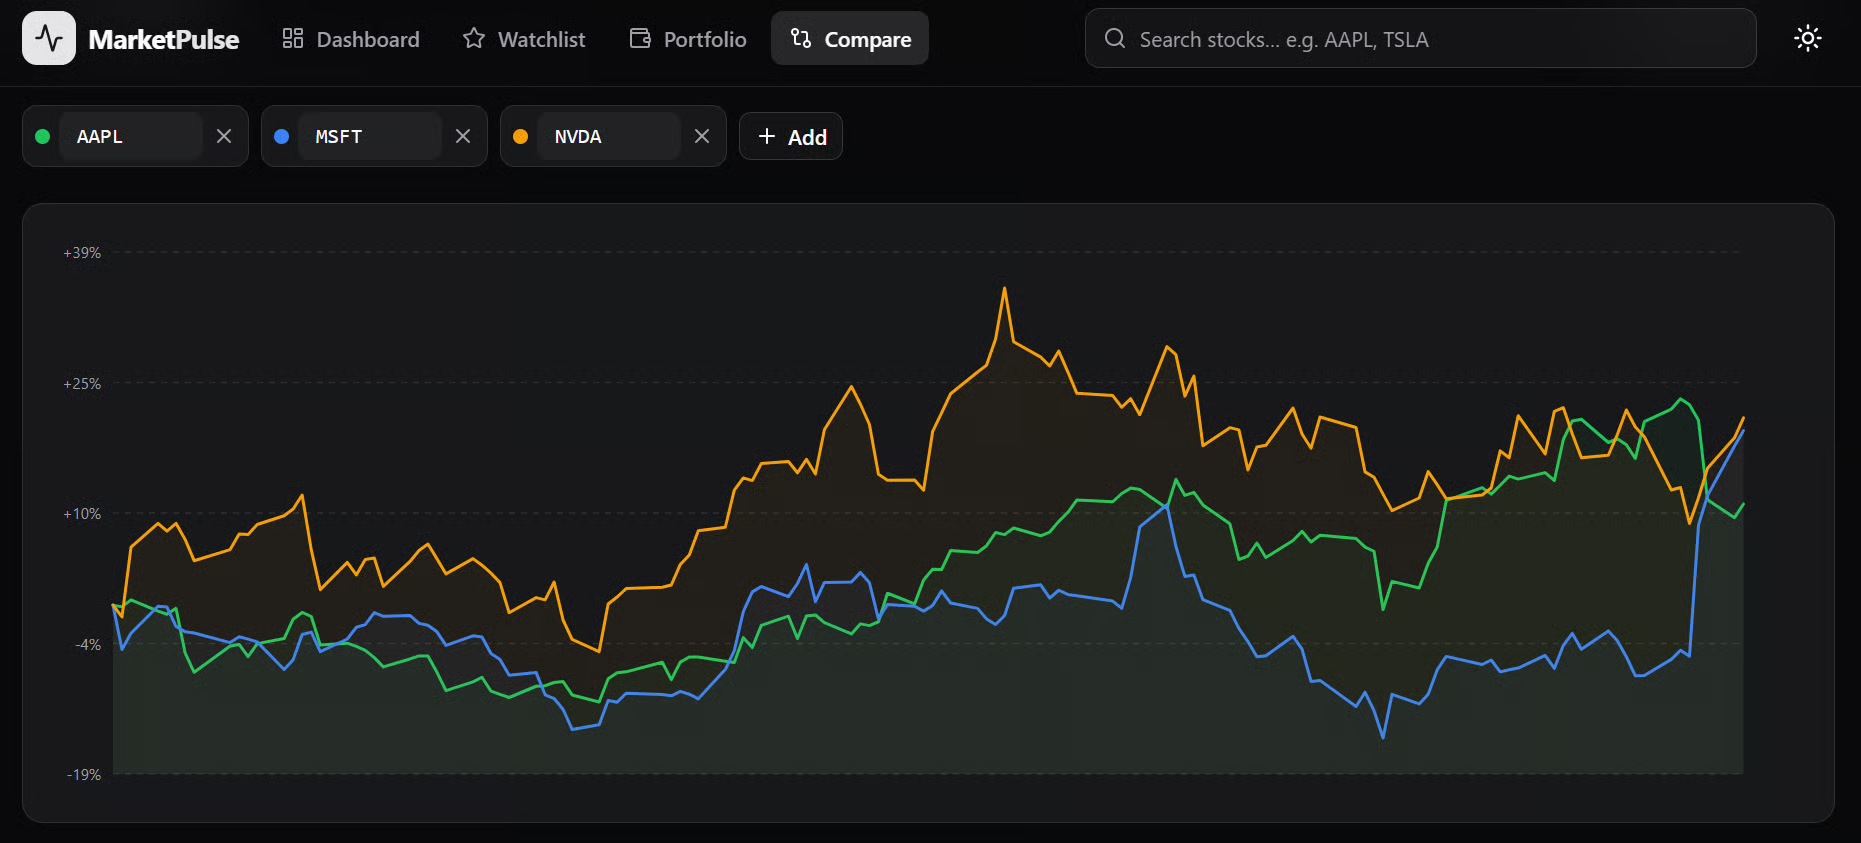
Fliken Compare låter dig också jämföra flera aktier och se vilka som gått bäst under vald period.
Jag blev ärligt talat förvånad över att en mindre lokal modell kunde bygga hela webbplatsen från en enda prompt.
Efter att ha testat applikationen fungerade varje större funktion som avsett, inklusive live‑aktiepriser, historisk marknadsdata, diagram, indikatorer och jämförelseverktyg.
Det är anmärkningsvärt hur snabbt lokala modeller förbättras och hur kapabla de har blivit på att slutföra komplexa utvecklingsuppgifter från början till slut.
För mig är DeepSeek-V4-Flash-0731 den bästa lokala modellen jag har testat hittills.
Den presterade bättre än Inkling, 2‑bitskvantiseringen av GLM-5.2 och Qwen3.6‑27B, som tidigare hade varit min favorit. Detta baseras på mina egna erfarenheter snarare än ett formellt benchmark, men det är nu min föredragna lokala modell.
För de flesta praktiska arbetsbelastningar skulle jag ändå börja med det officiella DeepSeek‑API:et eftersom det är extremt prisvärt.
V4 Flash kostar för närvarande 0,14 USD per miljon ocachade indata‑token, 0,0028 USD per miljon cachade indata‑token och 0,28 USD per miljon utdata‑token. I den takten skulle en miljard cachade indata‑token kosta cirka 2,80 USD före utdataavgifter.
Innan jag landade på Unsloth Studio försökte jag köra modellen via llama.cpp. Det förbyggda installationsprogrammet tillhandahöll inte en lämplig, ny CUDA‑binär för min miljö, och även om jag kompilerade den senaste versionen från källkod stötte jag på ytterligare problem när jag aktiverade DSpark spekulativ avkodning.
Unsloth Studio gav till slut den enklaste installationen och tog bort det mesta av den manuella konfigurationen. Det fungerade bra med OpenCode, även om det tog omkring 20 minuter att bygga hela applikationen.
Toppkurser på DataCamp
course
course
track