course
डेवलपर्स के लिए AI-असिस्टेड कोडिंग
1 घंटा 30 मिनट
9.9K
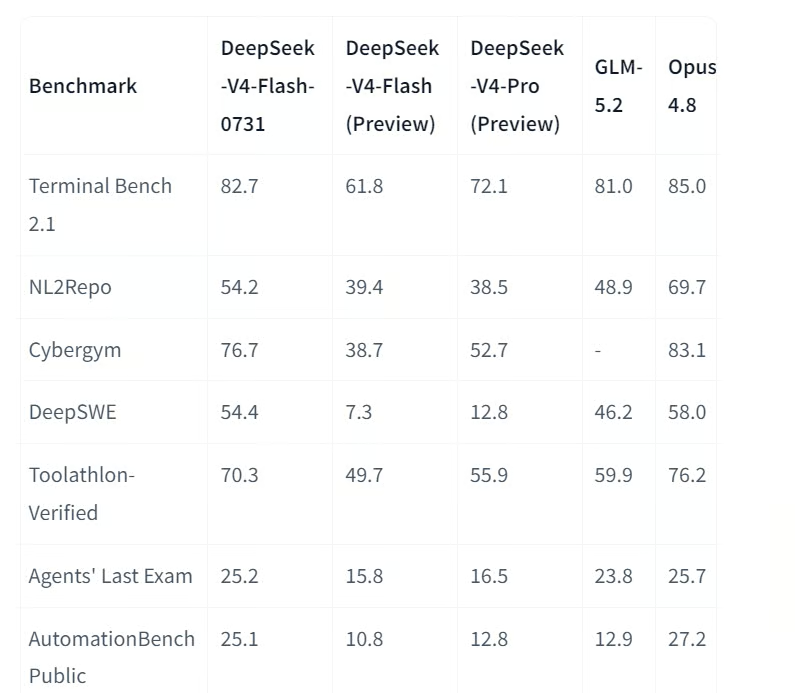
छोटा और तेज होना अब अपने आप कम सक्षम होना नहीं है। DeepSeek के प्रकाशित मूल्यांकन के अनुसार, DeepSeek-V4-Flash-0731 DeepSeek-V4-Pro की तुलना में बहुत छोटा एक्टिवेटेड पैरामीटर फुटप्रिंट इस्तेमाल करता है, फिर भी लगभग फ्रंटियर-स्तरीय एजेंटिक परफॉर्मेंस देता है: यह Terminal Bench 2.1 पर 82.7 स्कोर करता है, जबकि GLM-5.2 के लिए 81.0 और Opus 4.8 के लिए 85.0 हैं, और इसका 25.2 Agents’ Last Exam स्कोर Opus 4.8 के 25.7 के क़रीब है।
क्योंकि वेट्स खुले तौर पर उपलब्ध हैं, सैद्धांतिक रूप से आप पर्याप्त संयुक्त RAM या VRAM होने पर अपने हार्डवेयर पर मॉडल चला सकते हैं, जिससे इन्फरेंस और प्रोजेक्ट डेटा पर आपका नियंत्रण बना रहता है।
इस गाइड में, हम तीन-GPU RunPod वातावरण कॉन्फ़िगर करेंगे, Unsloth Studio को इंस्टॉल और लॉन्च करेंगे, DeepSeek-V4-Flash-0731 के Q8 संस्करण को GPUs पर डाउनलोड और लोड करेंगे, Studio के माध्यम से मॉडल का परीक्षण करेंगे, लोकल इन्फरेंस सर्वर को OpenCode से जोड़ेंगे, और कोडिंग एजेंट का उपयोग करके एक इंटरैक्टिव स्टॉक एनालिटिक्स वेबसाइट बनाएँगे और लॉन्च करेंगे।
DeepSeek-V4-Flash-0731 आधिकारिक रिलीज़ है जो पहले के प्रीव्यू को प्रतिस्थापित करती है, जिसमें कोडिंग, टूल उपयोग और स्वायत्त एजेंट कार्यों में बड़े सुधार हैं। इसकी Mixture-of-Experts आर्किटेक्चर प्रत्येक टोकन के लिए केवल मॉडल का एक हिस्सा सक्रिय करती है। इससे यह अधिक कुशल बना रहता है, जबकि मज़बूत परफॉर्मेंस भी देता है।
स्रोत: deepseek-ai/DeepSeek-V4-Flash-0731 · Hugging Face
DeepSeek रिपोर्ट करता है कि मॉडल Terminal Bench 2.1 पर 61.8 से 82.7 और DeepSWE पर 7.3 से 54.4 तक बेहतर हुआ। इसने कई एजेंट बेंचमार्क पर बड़े DeepSeek-V4-Pro Preview से बेहतर प्रदर्शन भी किया।
मॉडल एक मिलियन टोकन तक के कॉन्टेक्स्ट विंडो का समर्थन करता है। यह बड़े कोडबेस, लंबे दस्तावेज़ों और जटिल वर्कफ़्लो के लिए उपयुक्त है जिन्हें बड़े कॉन्टेक्स्ट की आवश्यकता होती है। उपयोगकर्ता यह भी चुन सकते हैं कि मॉडल किसी कार्य को हल करने में कितना समय लगाए — कम, उच्च, या अधिकतम रीजनिंग प्रयास।
DeepSeek-V4-Flash-0731 में DSpark speculative decoding भी शामिल है। DSpark मुख्य मॉडल द्वारा सत्यापन से पहले कई टोकन ड्राफ्ट करता है, जो DeepSeek के अनुसार, संगत इन्फरेंस इंजन के साथ उपयोग करने पर जनरेशन गति को 60% से 85% तक सुधार सकता है।
हम एक RunPod वातावरण बनाकर शुरू करेंगे, जिसमें DeepSeek-V4-Flash-0731 के Q8 संस्करण को चलाने और Unsloth Studio तथा OpenCode द्वारा जनरेट वेबसाइट दोनों को होस्ट करने के लिए पर्याप्त GPU मेमोरी और स्टोरेज हो।
Pod को इस प्रकार कॉन्फ़िगर करें:
/workspace को persistent volume माउंट पाथ के रूप मेंHF_TOKEN के रूप में8910 और 9101 एक्सपोज़्ड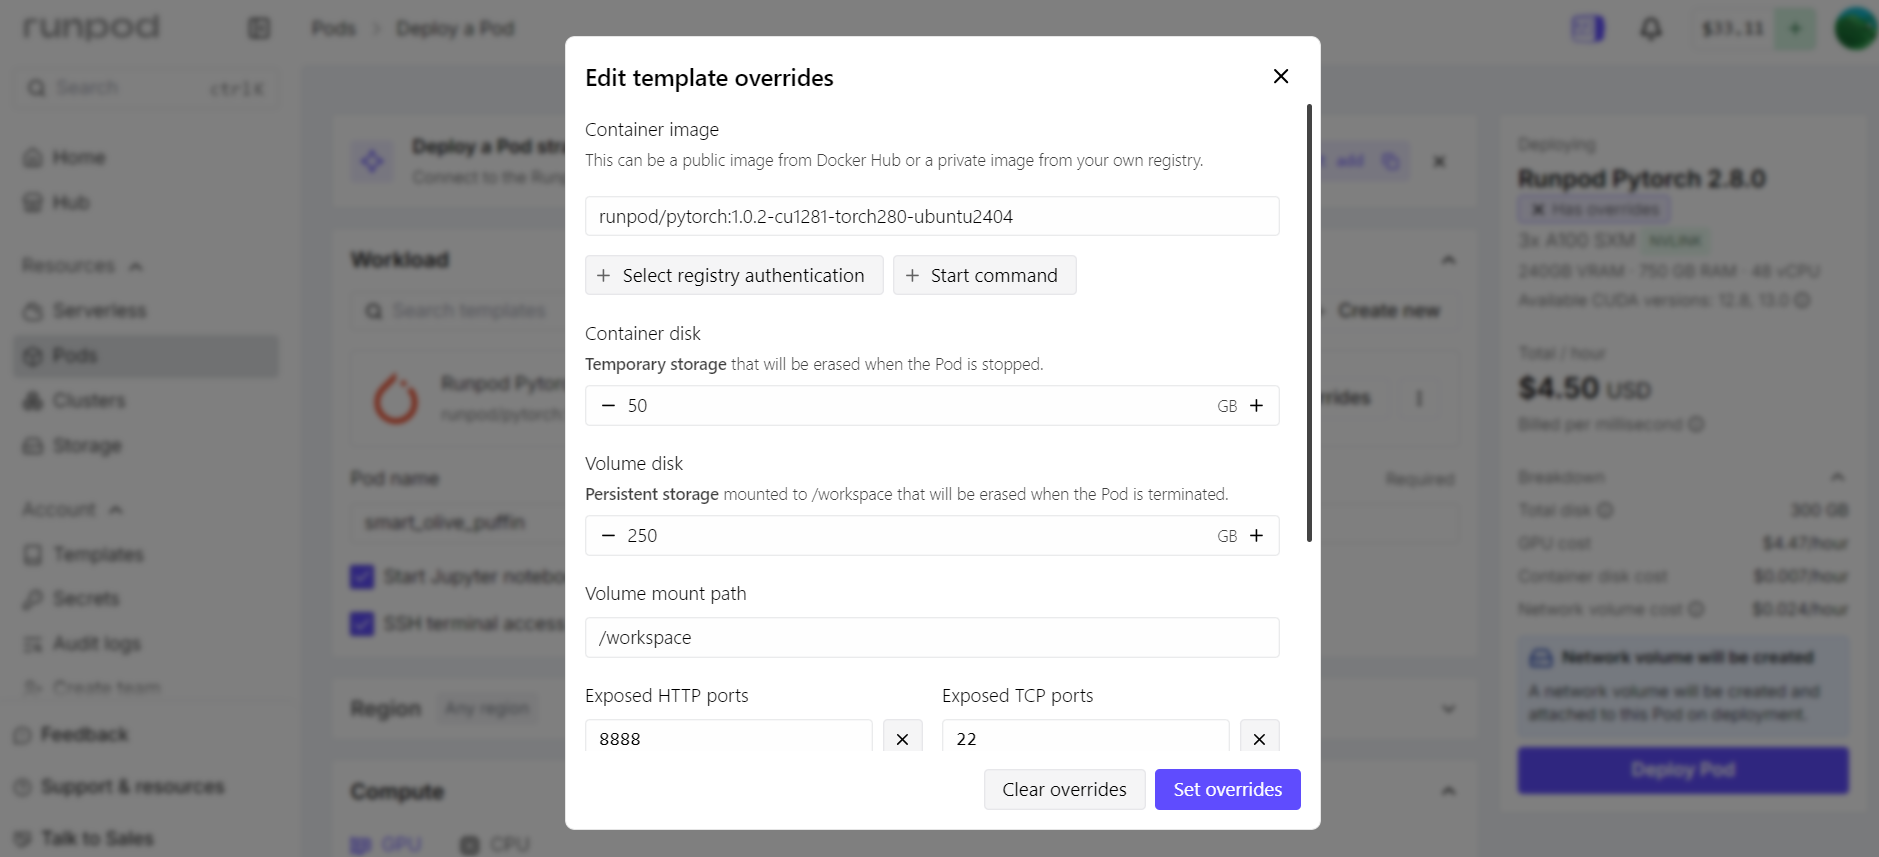
पोर्ट 8910 Unsloth Studio और इसकी लोकल इन्फरेंस API के लिए उपयोग होगा। पोर्ट 9101 OpenCode द्वारा बनाई गई इंटरैक्टिव वेबसाइट को होस्ट करेगा।
RunPod अपने HTTP प्रॉक्सी के माध्यम से इन सेवाओं को एक्सपोज़ करता है, इसलिए दोनों एप्लिकेशन को केवल 127.0.0.1 के बजाय 0.0.0.0 पर सुनना चाहिए।
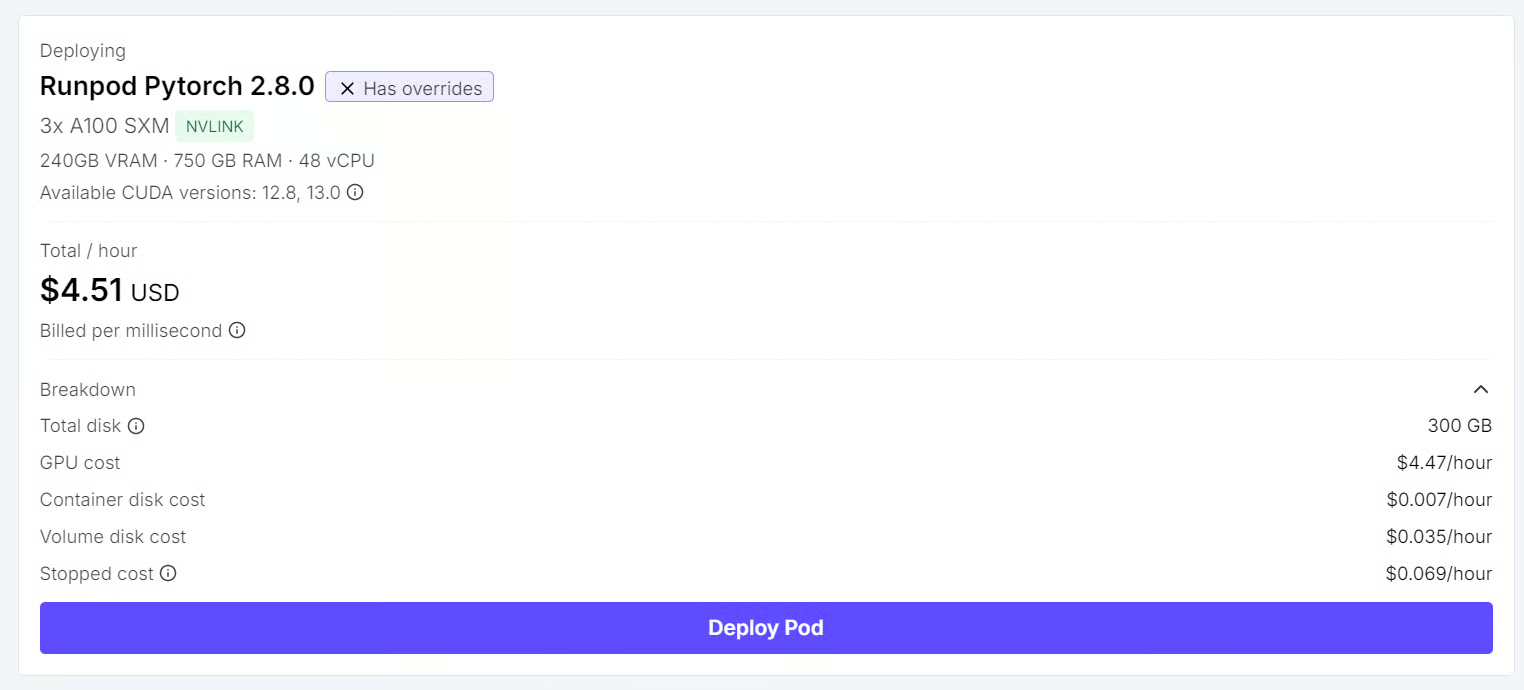
Pod डिप्लॉय करने के बाद, Connect टैब खोलें, JupyterLab लॉन्च करें, और तीन टर्मिनल सेशन बनाएँ:
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
कार्यों को अलग-अलग टर्मिनल में रखने से GPUs की मॉनिटरिंग, मॉडल की ट्रबलशूटिंग और कोडिंग एजेंट को एक साथ चलाना आसान होता है।
अगला, हम Unsloth Studio इंस्टॉल करेंगे, एक persistent Hugging Face कैश कॉन्फ़िगर करेंगे, और इंटरफ़ेस को पोर्ट 8910 पर लॉन्च करेंगे।
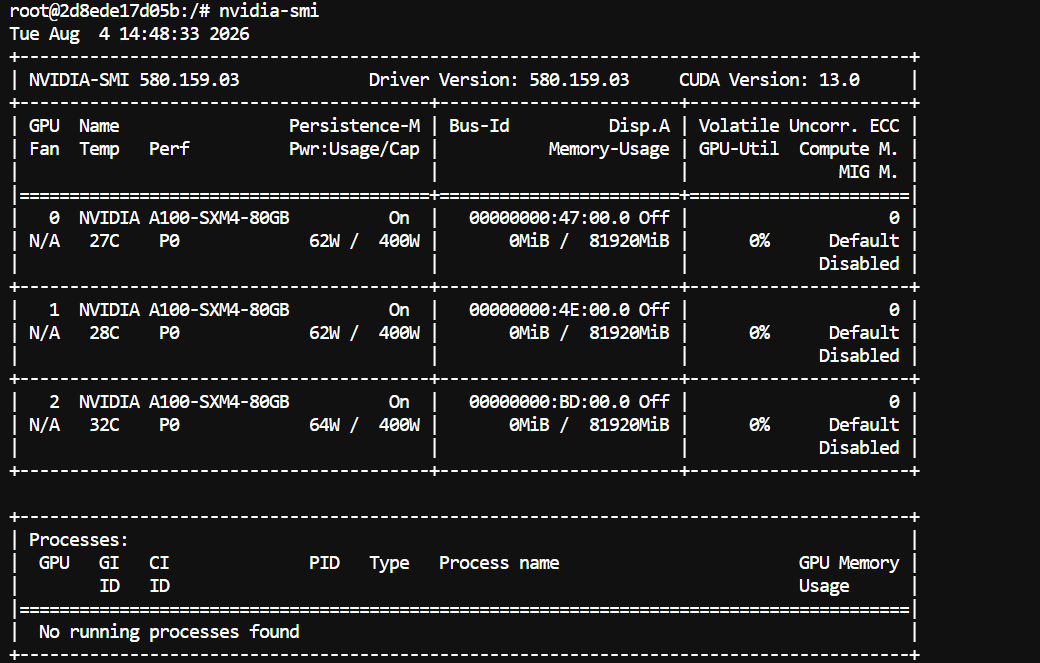
टर्मिनल 1 में, सुनिश्चित करें कि सभी तीन GPUs उपलब्ध हैं:
nvidia-smiआपको Linux सर्वर पर सभी तीन A100 GPUs सूचीबद्ध दिखने चाहिए।
डाउनलोड किए गए मॉडल RunPod वॉल्यूम पर उपलब्ध बने रहें, इसके लिए /workspace के अंदर एक persistent Hugging Face कैश बनाएँ:
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
इसके बाद, आवश्यक सिस्टम पैकेज और Unsloth Studio इंस्टॉल करें:
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh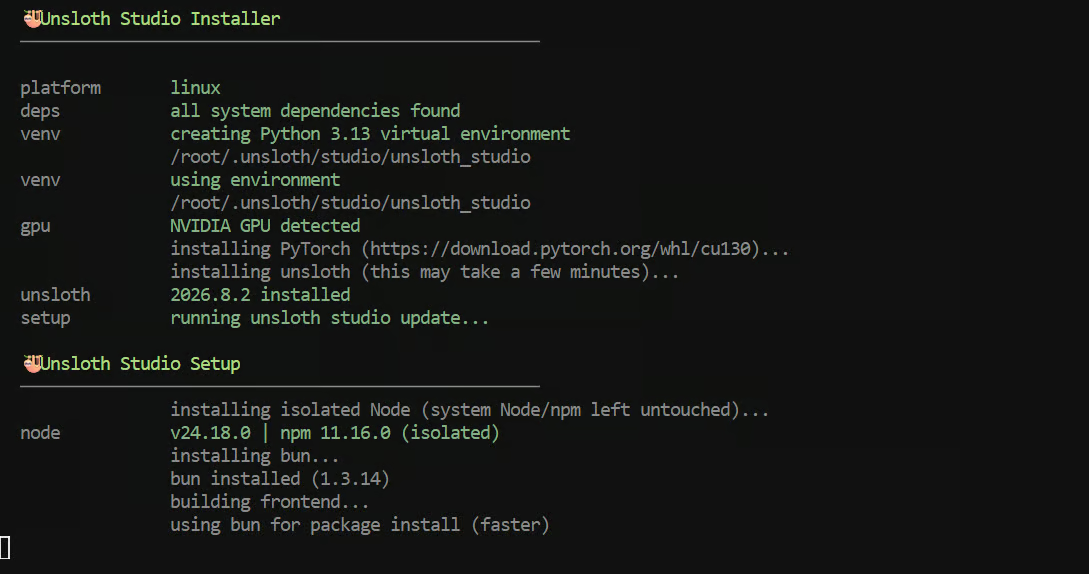
इंस्टॉलर Studio इंटरफ़ेस, Python वातावरण, डिपेंडेंसीज़ और लोकल इन्फरेंस घटकों को कॉन्फ़िगर करता है।
पहली इंस्टॉलेशन में कई मिनट लग सकते हैं।
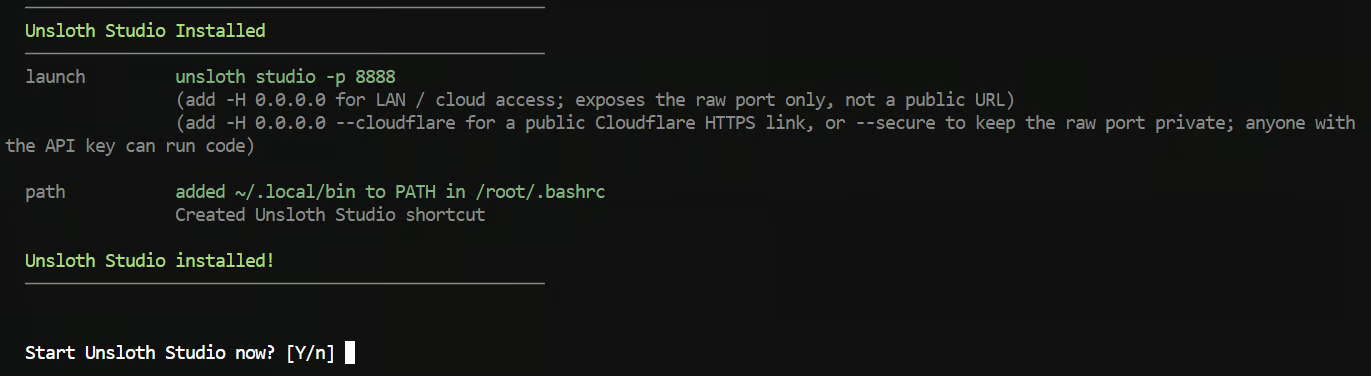
जब इंस्टॉलर पूछे कि क्या आप तुरंत Unsloth Studio शुरू करना चाहते हैं, तो “n” दर्ज करें।
हम इसे मैन्युअली लॉन्च करेंगे ताकि यह पोर्ट 8910 का उपयोग करे और सही नेटवर्क पते पर सुने।
नए कमांड उपलब्ध कराने के लिए शेल को रीस्टार्ट करें:
exec bash
cd /workspace
Studio लॉन्च करने से पहले, डिफ़ॉल्ट पासवर्ड रीसेट करें:
unsloth studio reset-passwordसेटअप के दौरान दिखाया गया अस्थायी पासवर्ड कॉपी कर लें, क्योंकि रीसेट पूरा करने के लिए इसकी आवश्यकता हो सकती है।
अब Unsloth Studio लॉन्च करें:
unsloth studio \
  -H 0.0.0.0 \
  -p 8910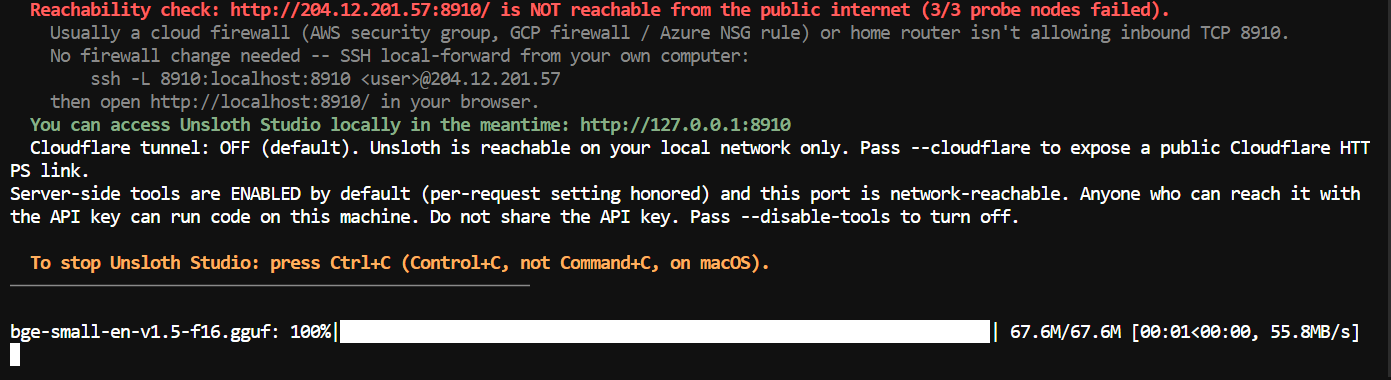
अब Studio को रिपोर्ट करना चाहिए कि यह पोर्ट 8910 पर चल रहा है। Unsloth Studio और OpenCode का उपयोग करते समय टर्मिनल 1 खुला रखें।
RunPod के Connect पेज पर लौटें और पोर्ट 8910 के लिए HTTP Service खोलें।
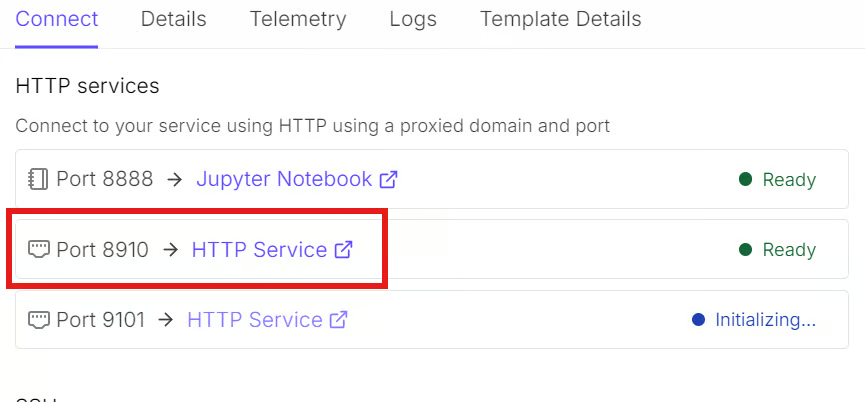
रीसेट पूरा करने के लिए पहले जनरेट किया गया अस्थायी पासवर्ड उपयोग करें, फिर बनाए गए नए पासवर्ड से साइन इन करें।
ऑनबोर्डिंग चरण पूरे करें या छोड़ दें और Chat पेज खोलें।
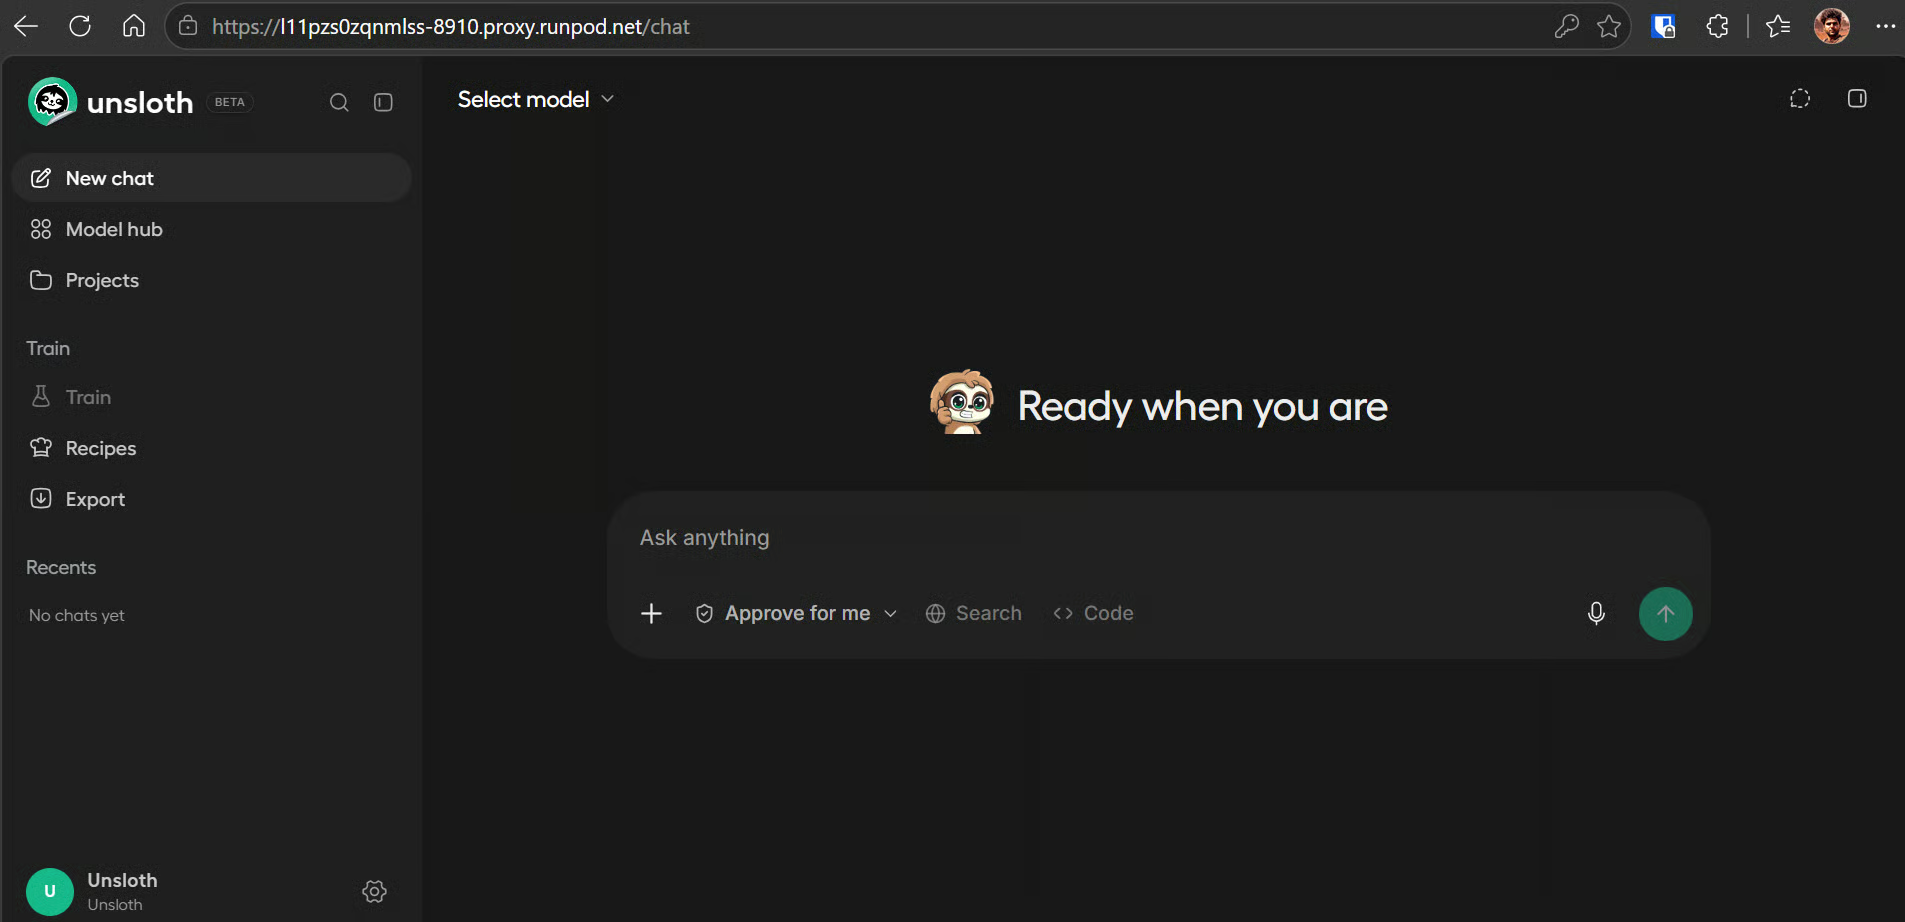
अब जबकि Unsloth Studio चल रहा है, हम Q8 मॉडल डाउनलोड कर सकते हैं, उसे तीनों GPUs पर लोड कर सकते हैं, और इसके चैट व टूल-उपयोग क्षमताओं का परीक्षण कर सकते हैं।
ऊपर-बाएँ कोने में मॉडल सेलेक्टर खोलें और unsloth/DeepSeek-V4-Flash-0731-GGUF खोजें और फिर Q8 क्वांटाइज़ेशन UD-Q8_K_XL चुनें।
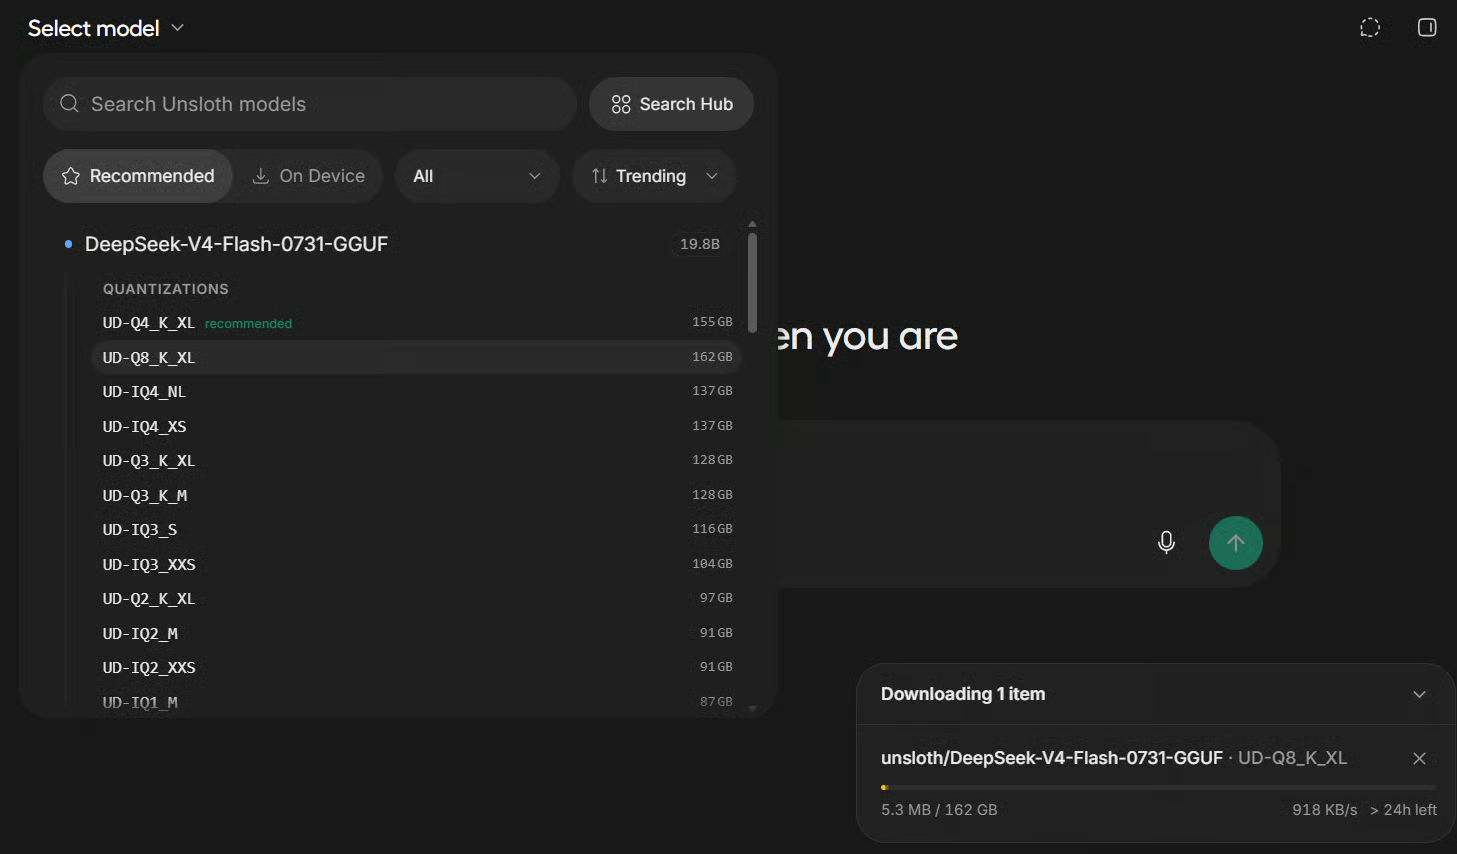
हम Q8 का उपयोग कर रहे हैं क्योंकि तीन A100 GPUs पर्याप्त संयुक्त VRAM प्रदान करते हैं। यह मूल मॉडल के अधिक नज़दीकी गुणवत्ता संरक्षित रखता है, जबकि कम क्वांटाइज़ेशन हार्डवेयर मेमोरी सीमित होने पर अधिक उपयोगी होते हैं।
डाउनलोड पूरा होने पर, Unsloth Studio स्वचालित रूप से मॉडल को GPU मेमोरी में लोड करना शुरू कर देगा। Q8 मॉडल बहुत बड़ा होने के कारण इसमें कई मिनट लग सकते हैं।
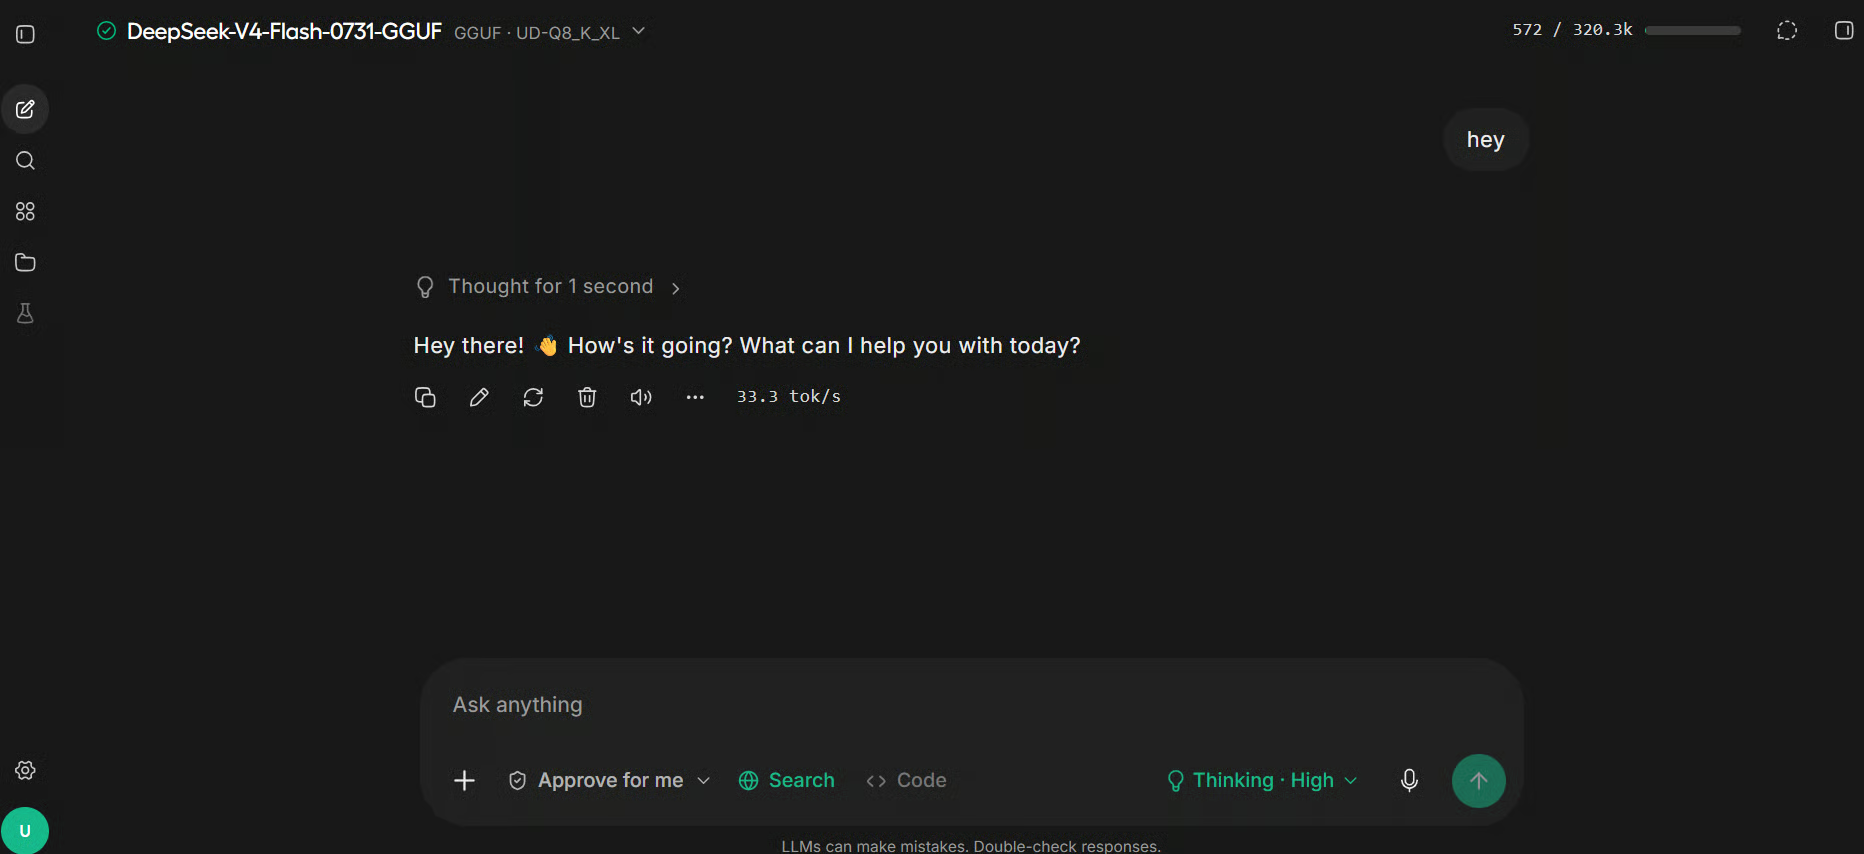
लोड होने के बाद, मॉडल को कुछ सरल प्रॉम्प्ट्स के साथ परखने के लिए Chat पेज का उपयोग करें।
हमारे परीक्षण में, जनरेशन लगभग 33 टोकन प्रति सेकंड (speculative decoding के बिना) तक पहुँची, जो इस आकार के मॉडल के लिए वाजिब परिणाम है।
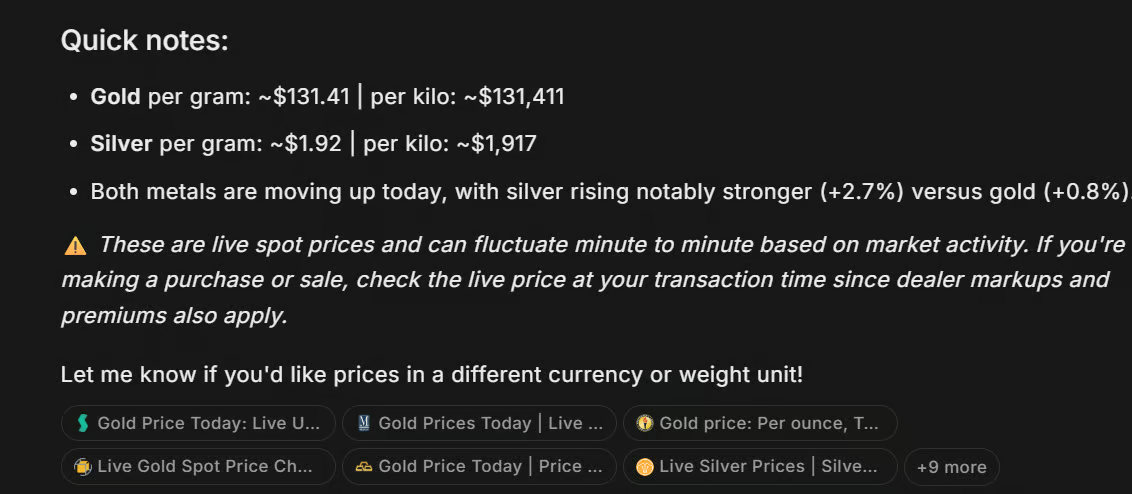
आप Studio के वेब-सर्च टूल को सक्षम कर सकते हैं और मॉडल से वर्तमान जानकारी देखने के लिए कह सकते हैं, जैसे नवीनतम सोने और चांदी के दाम। यह पुष्टि करने का उपयोगी तरीका है कि मॉडल केवल अपनी आंतरिक जानकारी पर निर्भर रहने के बजाय बाहरी टूल भी कॉल कर सकता है।
टर्मिनल 2 में, देखें कि मॉडल GPUs के बीच कैसे वितरित है:
nvidia-smi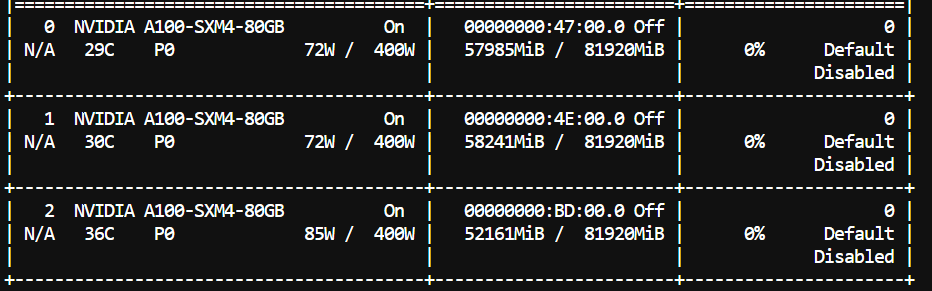
आपको सभी तीन GPUs पर पर्याप्त मेमोरी उपयोग दिखना चाहिए।
हमारे परीक्षण में, प्रत्येक GPU लगभग 70% भरा था। हालांकि, इसका अर्थ यह नहीं कि पूरा Q8 मॉडल केवल दो 80GB GPUs पर आराम से फिट हो जाएगा, क्योंकि कॉन्टेक्स्ट विंडो, KV कैश और इन्फरेंस बफ़र्स के लिए अतिरिक्त VRAM की अभी भी आवश्यकता होती है।
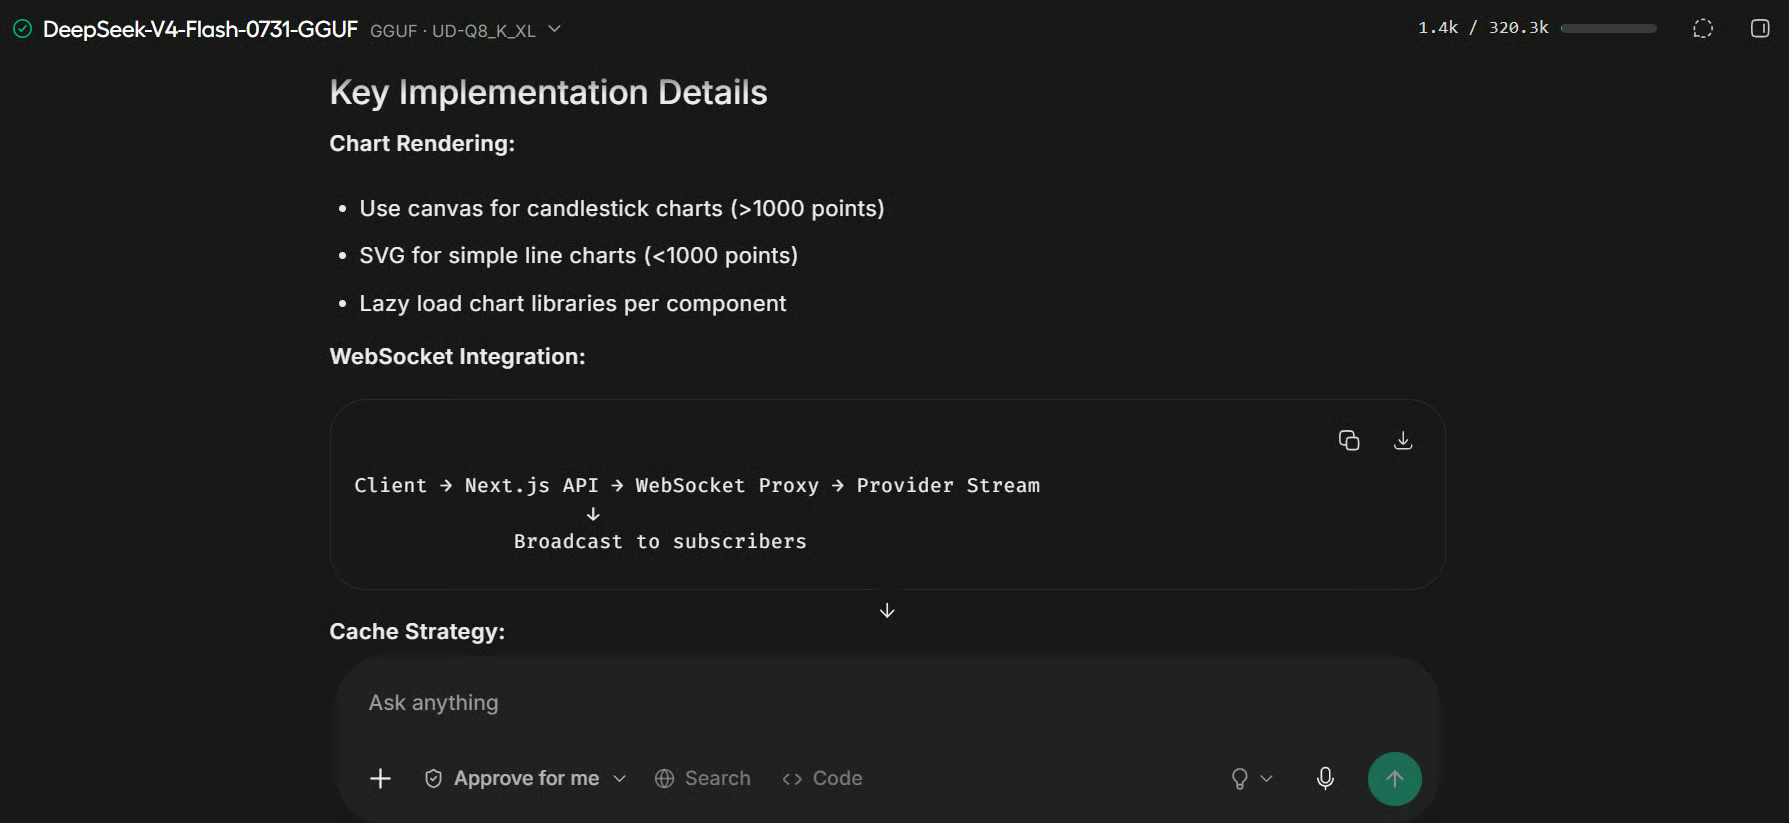
अंत में, उस एप्लिकेशन के लिए प्लानिंग प्रॉम्प्ट से मॉडल का परीक्षण करें जिसे हम बनाने वाले हैं:
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
मॉडल एप्लिकेशन आर्किटेक्चर, कंपोनेंट्स, डेटा फ़्लो, चार्टिंग लाइब्रेरियाँ, वित्तीय गणनाएँ और इंटरफ़ेस डिज़ाइन को कवर करने वाला संरचित विकास प्लान लौटाता है।
अब जबकि मॉडल Unsloth Studio में चल रहा है, हम इसे OpenCode से जोड़ सकते हैं और इसे लोकल कोडिंग एजेंट के रूप में उपयोग कर सकते हैं।
टर्मिनल 3 में, Studio URL सेट करें:
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
एक नया प्रोजेक्ट डायरेक्टरी बनाएँ:
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
Unsloth Studio के माध्यम से OpenCode शुरू करें:
unsloth start opencodeपहली बार यह कमांड चलाने पर, OpenCode इंस्टॉल करने की अनुमति मांगेगा। “y” दर्ज करें।
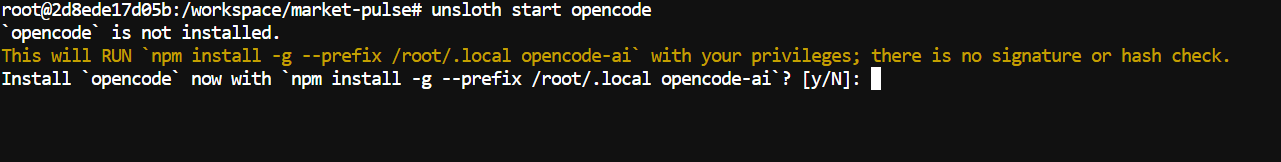
इंस्टॉल पूरा होने के बाद, OpenCode लोकली चल रहे DeepSeek-V4-Flash-0731 मॉडल के साथ पहले से कॉन्फ़िगर होकर लॉन्च होगा।
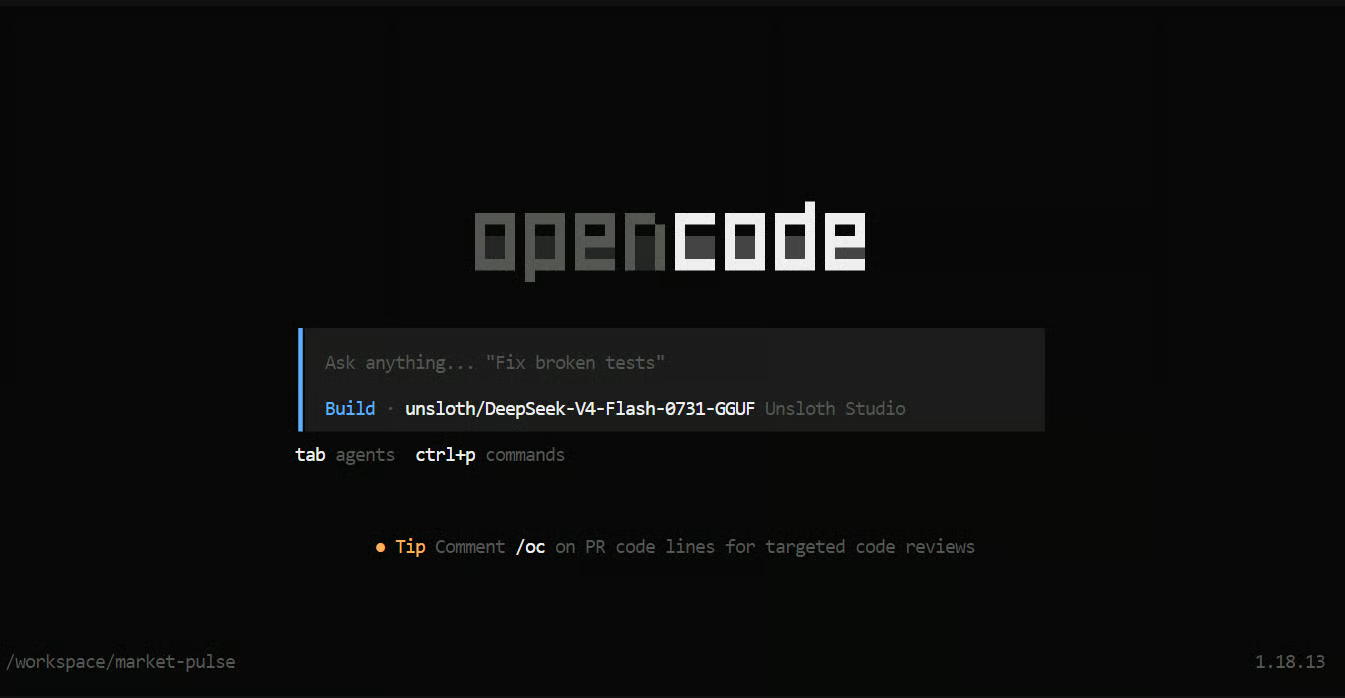
निम्न दो-लाइन प्रॉम्प्ट OpenCode में पेस्ट करें:
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
कुछ ही सेकंड में, कोडिंग एजेंट एक विस्तृत टास्क सूची बनाएगा और चरण-दर-चरण प्रोजेक्ट पर काम शुरू कर देगा।
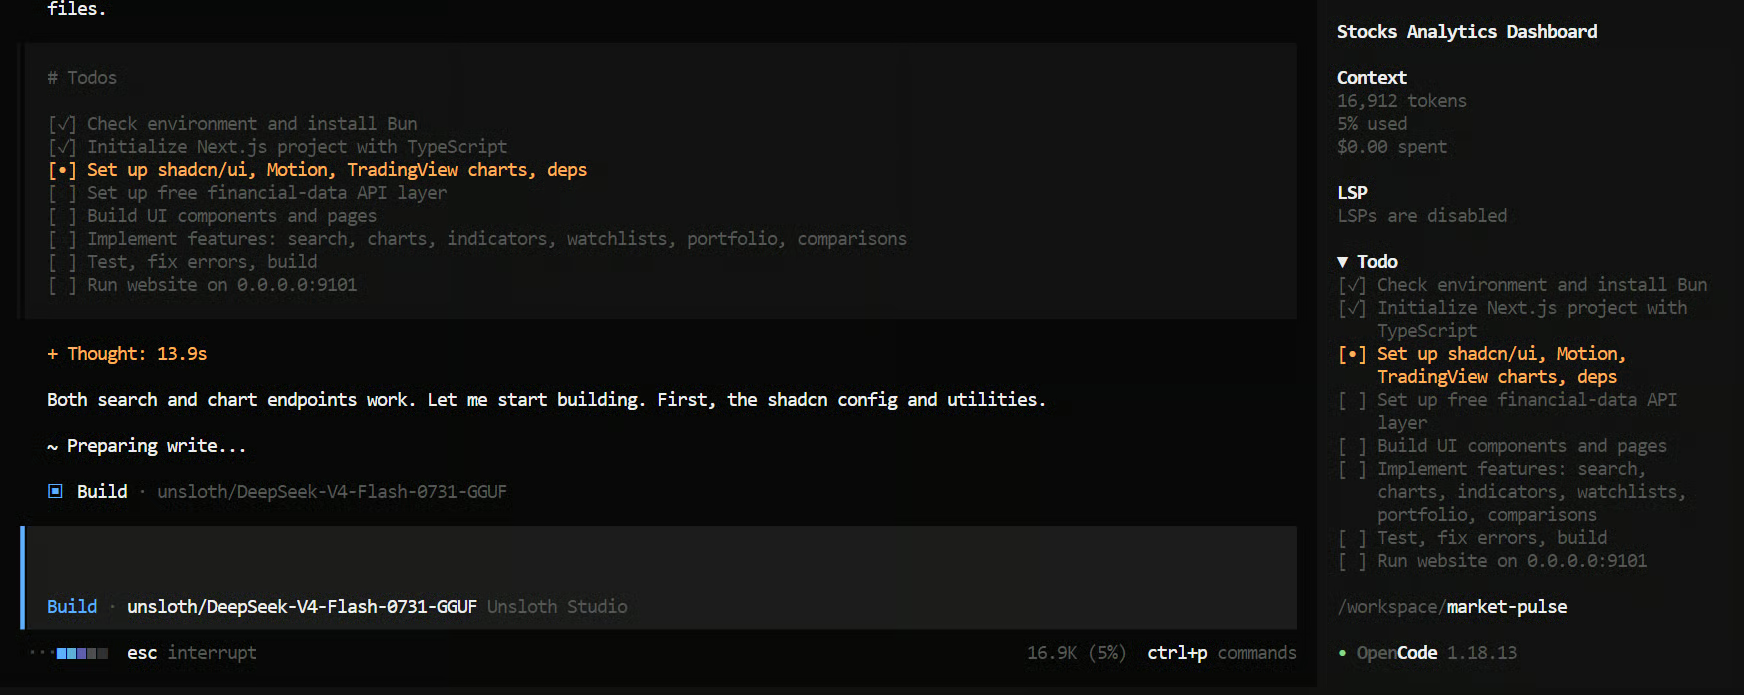
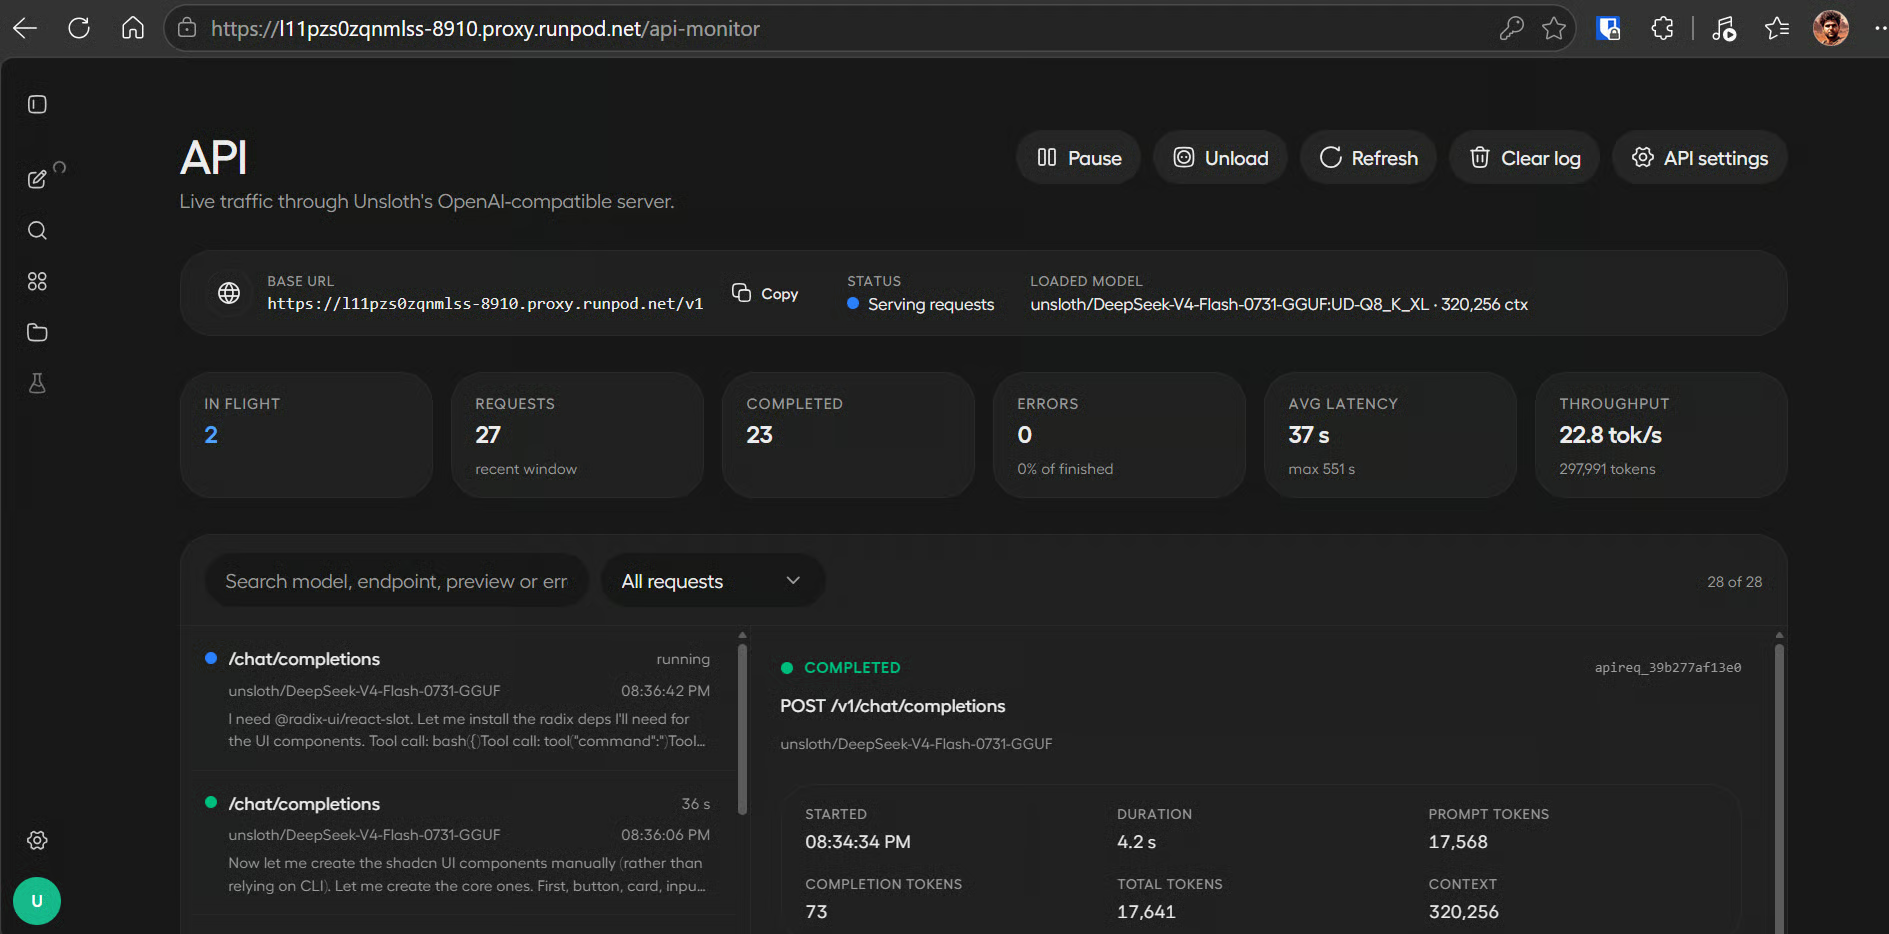
हमारे परीक्षण में पूरा बिल्ड लगभग 20 मिनट लगा। जब यह चल रहा हो, तो आप Unsloth Studio पर लौटकर Settings में API मॉनिटरिंग पेज खोलकर मॉडल उपयोग और जनरेशन स्पीड को ट्रैक कर सकते हैं।
हमने कोडिंग वर्कफ़्लो के दौरान औसतन लगभग 22.6 टोकन प्रति सेकंड का अवलोकन किया। बातचीत और प्रोजेक्ट कॉन्टेक्स्ट बढ़ने पर गति घट सकती है।
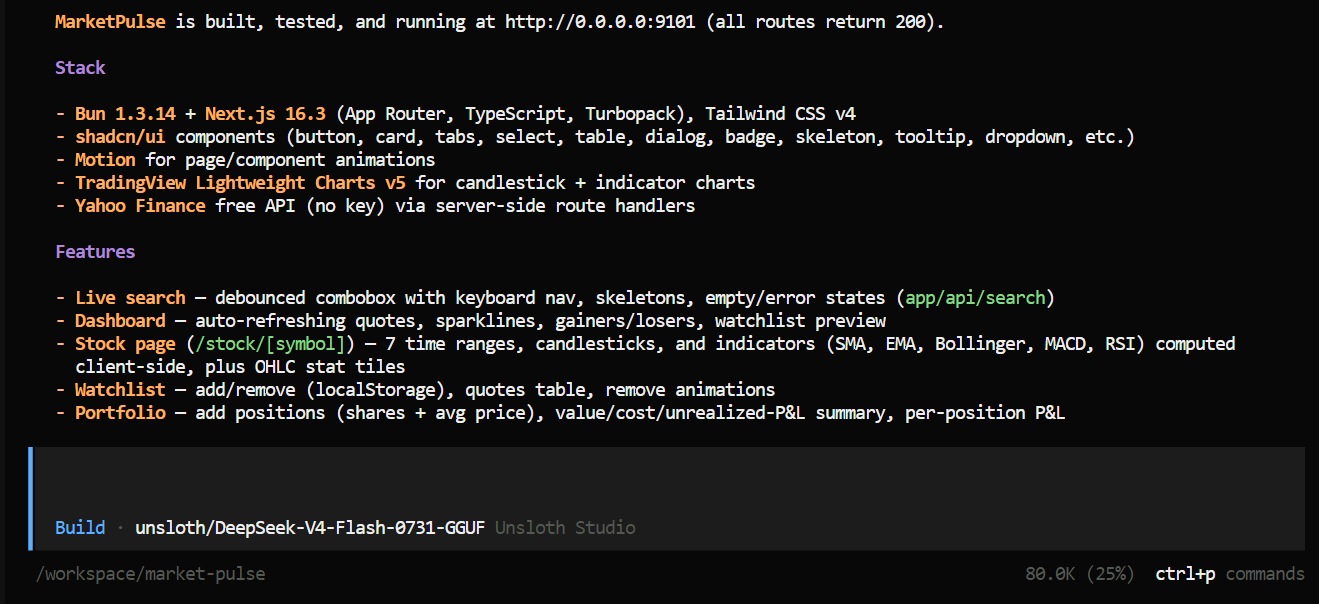
कार्यों को पूरा करने के बाद, OpenCode बनाए गए फ़ाइलों, फीचर्स और कमांड्स का सारांश प्रदान करेगा। यह पोर्ट 9101 पर तैयार वेबसाइट भी शुरू कर देगा।
RunPod के Connect पेज पर लौटें और पोर्ट 9101 के लिए HTTP Service खोलें।
परिणाम आश्चर्यजनक रूप से परिष्कृत था। वेबसाइट साफ़-सुथरी, एनिमेटेड और एक प्रोफ़ेशनल ट्रेडिंग डैशबोर्ड जैसी दिखी। मॉडल ने एक ही प्रॉम्प्ट में इंटरफ़ेस, डेटा व्यूज़, चार्ट और नेविगेशन सहित वेब एप्लिकेशन पूरा कर दिया।
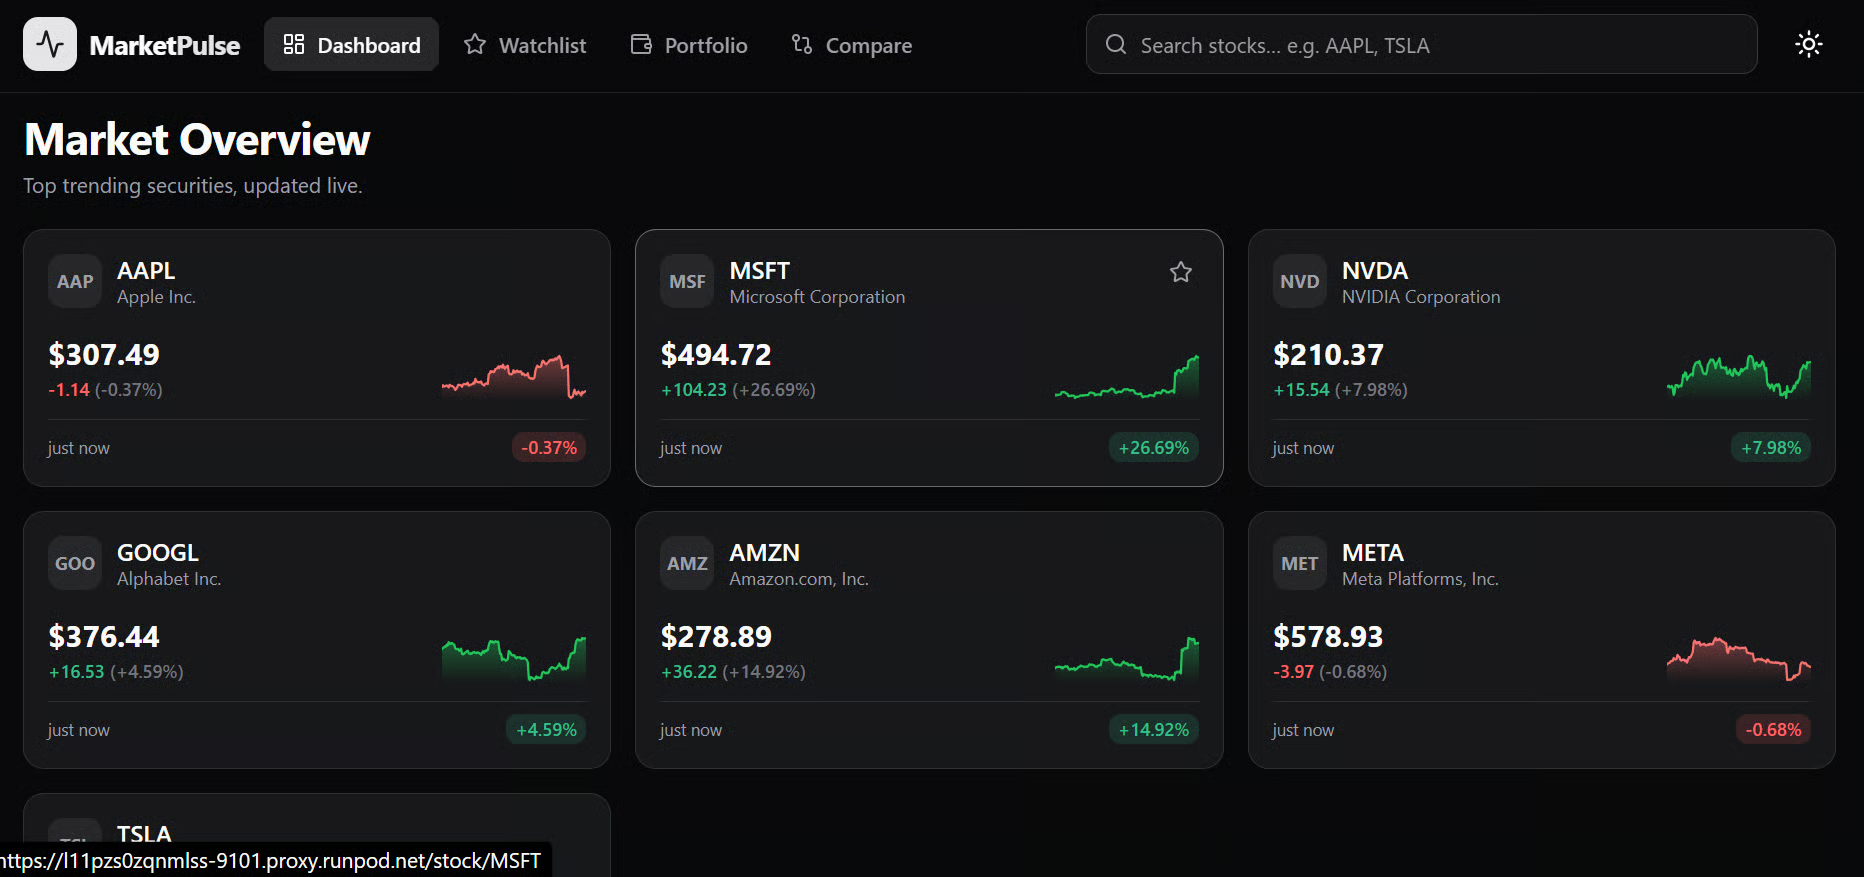
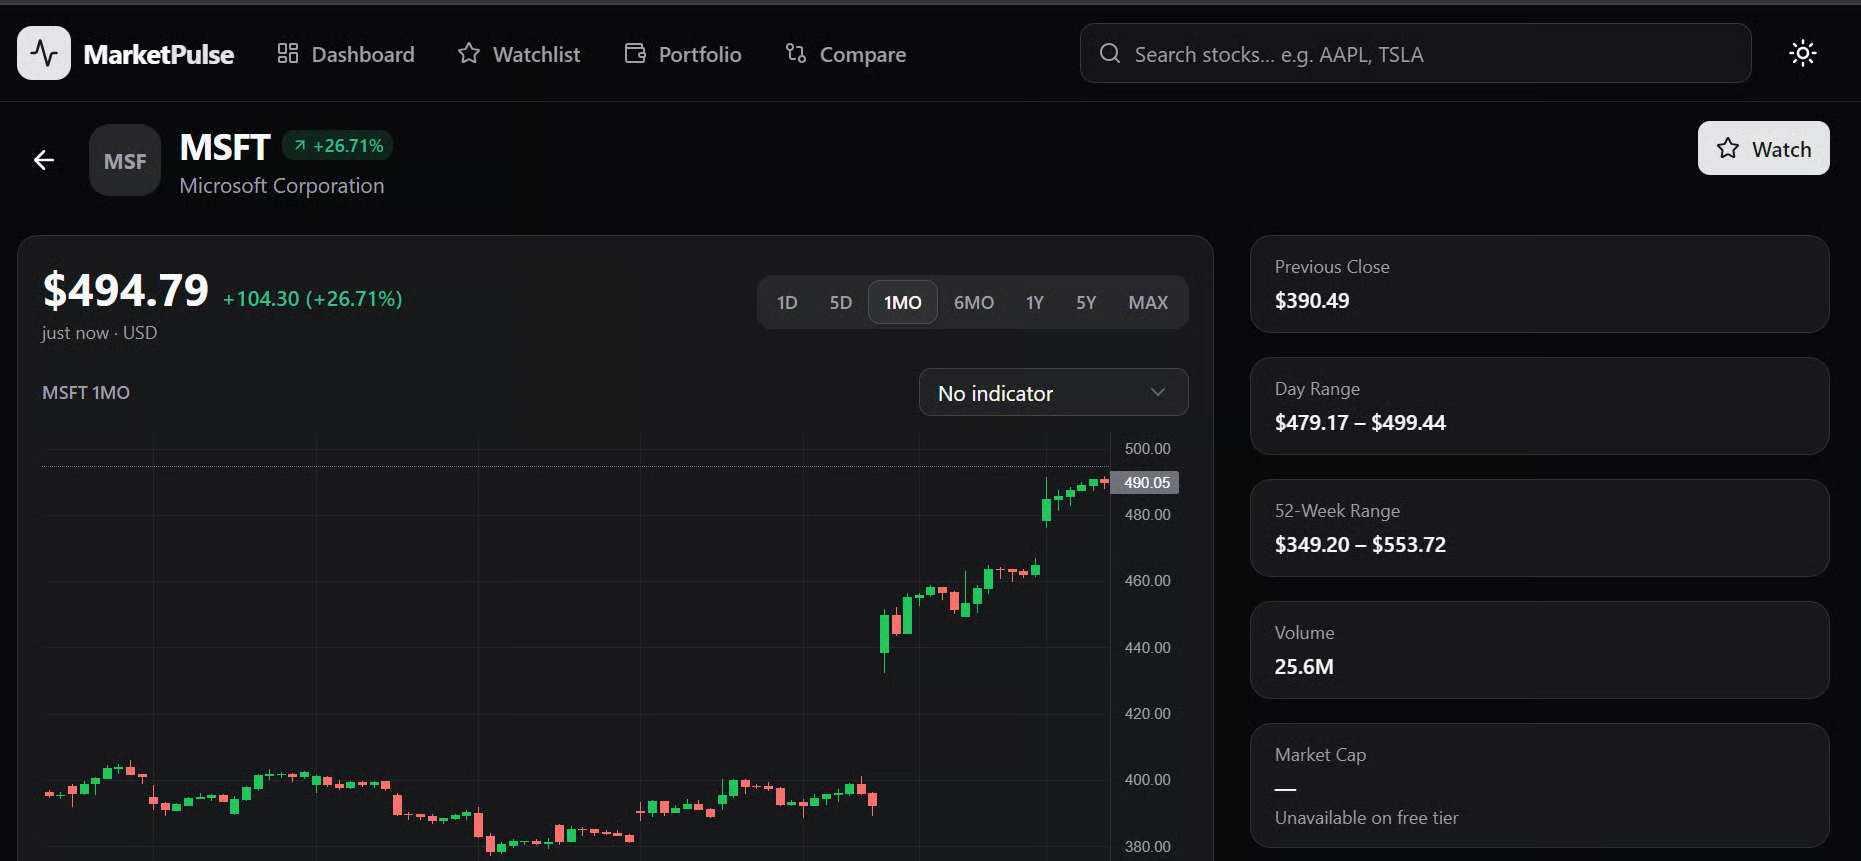
आप व्यक्तिगत स्टॉक टिकर चुनकर कैंडलस्टिक चार्ट, ऐतिहासिक प्रदर्शन, इंडिकेटर्स और अतिरिक्त कंपनी जानकारी देख सकते हैं।
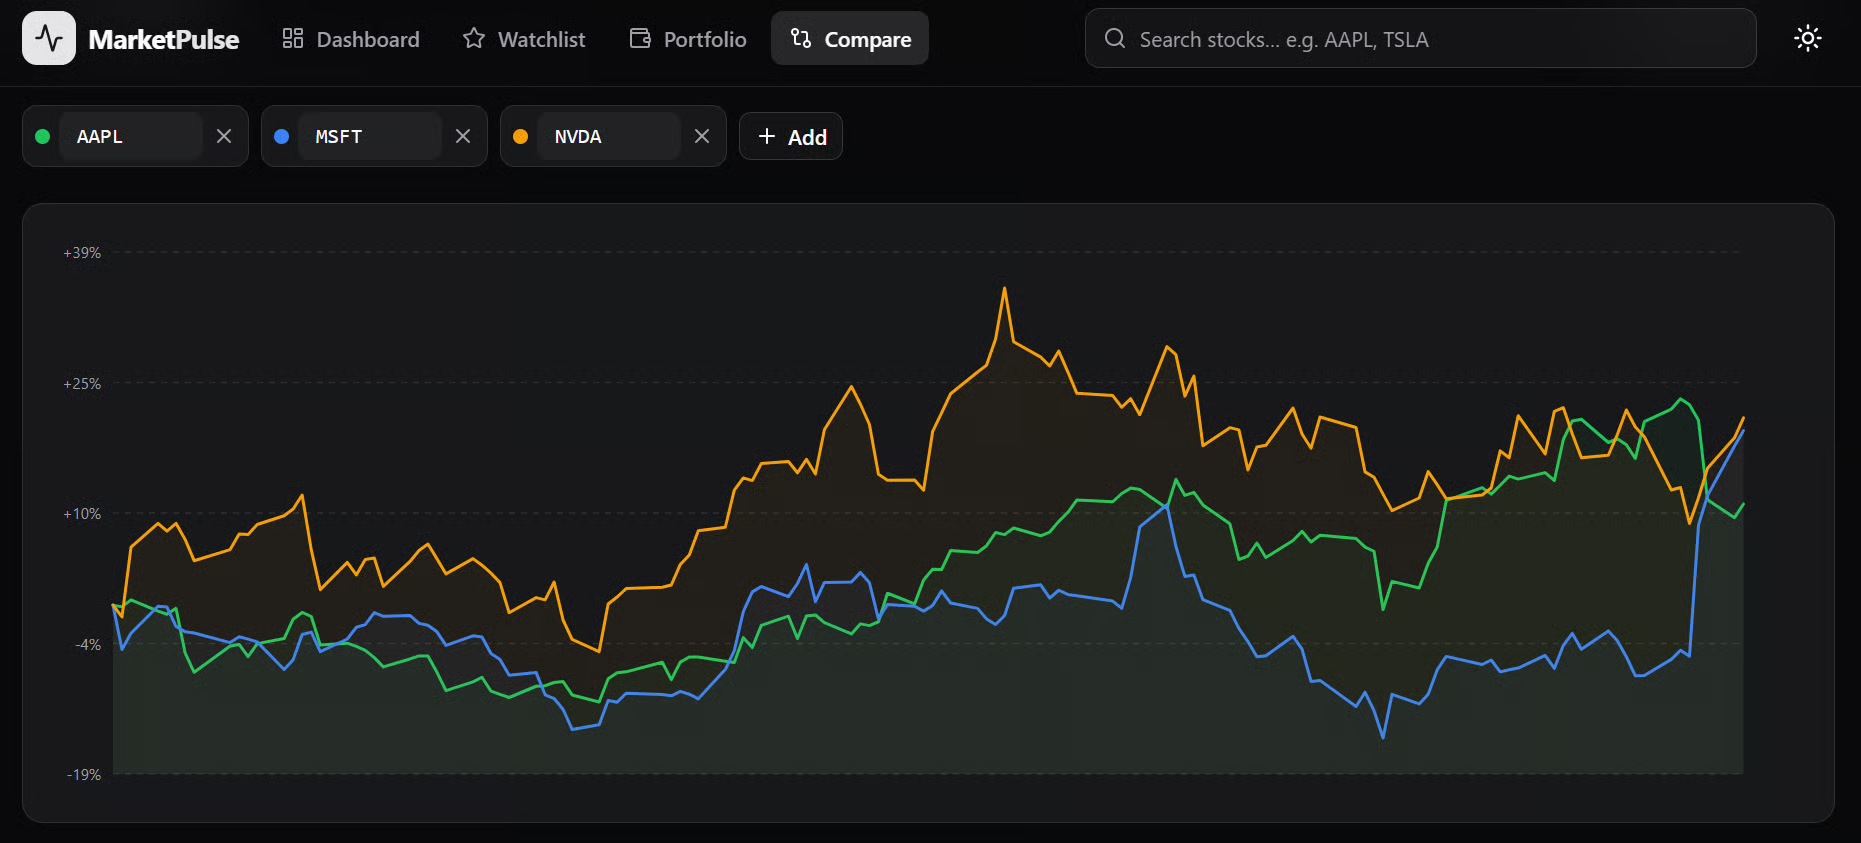
Compare टैब आपको कई स्टॉक्स की तुलना करने और चयनित अवधि में किसने बेहतर प्रदर्शन किया, यह देखने देता है।
मुझे सचमुच आश्चर्य हुआ कि एक छोटा लोकल मॉडल एक ही प्रॉम्प्ट से पूरी वेबसाइट बना सका।
एप्लिकेशन का परीक्षण करने के बाद, हर प्रमुख फीचर अपेक्षा के अनुसार काम कर रहा था, जिनमें लाइव स्टॉक दाम, ऐतिहासिक मार्केट डेटा, चार्ट, इंडिकेटर्स और तुलना टूल शामिल हैं।
यह उल्लेखनीय है कि लोकल मॉडल कितनी तेज़ी से सुधर रहे हैं और जटिल, एंड-टू-एंड डेवलपमेंट कार्यों को पूरा करने में कितने सक्षम हो गए हैं।
मेरे लिए, DeepSeek-V4-Flash-0731 अब तक का सबसे अच्छा लोकल मॉडल है जिसे मैंने टेस्ट किया है।
इसने Inkling, 2-बिट GLM-5.2 क्वांटाइज़ेशन और Qwen3.6-27B से बेहतर प्रदर्शन किया, जो पहले मेरा पसंदीदा था। यह मेरे स्वयं के अनुभव पर आधारित है, औपचारिक बेंचमार्क पर नहीं, लेकिन अब यह मेरा पसंदीदा लोकल मॉडल है।
अधिकांश व्यावहारिक वर्कलोड के लिए, मैं अभी भी आधिकारिक DeepSeek API से शुरू करूँगा क्योंकि यह अत्यंत किफायती है।
V4 Flash की वर्तमान लागत प्रति मिलियन uncached इनपुट टोकन $0.14, प्रति मिलियन cached इनपुट टोकन $0.0028, और प्रति मिलियन आउटपुट टोकन $0.28 है। इस दर पर, एक बिलियन cached इनपुट टोकन की लागत आउटपुट चार्ज से पहले लगभग $2.80 होगी।
Unsloth Studio चुनने से पहले, मैंने मॉडल को llama.cpp के माध्यम से चलाने की कोशिश की। प्रीबिल्ट इंस्टॉलर ने मेरे वातावरण के लिए उपयुक्त हालिया CUDA बाइनरी उपलब्ध नहीं कराई, और यद्यपि मैंने सोर्स से नवीनतम संस्करण कंपाइल किया, DSpark speculative decoding सक्षम करने पर और समस्याएँ आईं।
आखिरकार, Unsloth Studio ने सबसे सरल सेटअप प्रदान किया और अधिकांश मैन्युअल कॉन्फ़िगरेशन हटा दिए। यह OpenCode के साथ अच्छी तरह काम किया, हालाँकि पूरी एप्लिकेशन बनाने में लगभग 20 मिनट लगे।
शीर्ष DataCamp पाठ्यक्रम
course
course
Track