Courses
開発者のための AI 支援コーディング
1時間30分
9.9K
小型・高速=非力、とは限らなくなってきました。DeepSeek が公開した評価によると、DeepSeek-V4-Flash-0731 は、DeepSeek-V4-Pro よりもはるかに少ない有効パラメータで動作しつつ、最先端に近いエージェント性能を発揮します。具体的には Terminal Bench 2.1 で 82.7 を記録し、GLM-5.2 は 81.0、Opus 4.8 は 85.0。また Agents’ Last Exam は 25.2 で、Opus 4.8 の 25.7 に近いスコアです。
重みが公開されているため、理論上は十分な RAM もしくは VRAM を用意できれば自前のハードウェアでモデルを実行可能で、推論やプロジェクトデータを自分で管理できます。
本ガイドでは、3 基の GPU を備えた RunPod 環境を構成し、Unsloth Studio をインストール・起動し、DeepSeek-V4-Flash-0731 の Q8 版を GPU 跨ぎで読み込み、Studio からモデルをテストし、ローカル推論サーバーを OpenCode に接続し、コーディングエージェントでインタラクティブな株式分析サイトを構築・起動します。
DeepSeek-V4-Flash-0731 は、先行プレビューを置き換える正式リリースで、コーディング、ツール利用、自律エージェントタスクが大幅に改善されています。Mixture-of-Experts アーキテクチャにより、トークンごとにモデルの一部のみを起動するため、高効率を保ちつつ高い性能を発揮します。
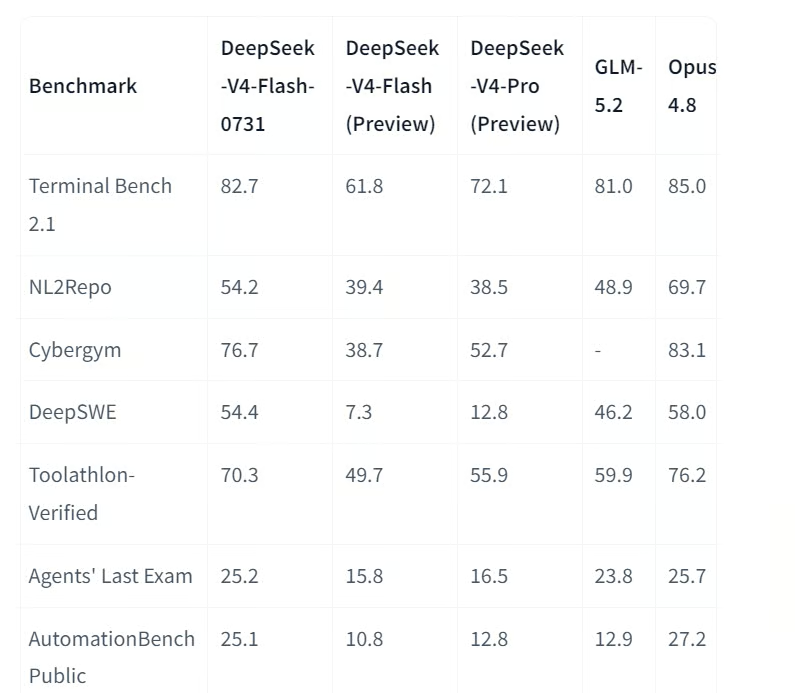
出典: deepseek-ai/DeepSeek-V4-Flash-0731 ・ Hugging Face
DeepSeek の報告では、Terminal Bench 2.1 が 61.8 から 82.7、DeepSWE が 7.3 から 54.4 に改善しました。さらに、いくつかのエージェント系ベンチマークでは、より大きな DeepSeek-V4-Pro Preview を上回りました。
最大 100 万トークンのコンテキストウィンドウに対応しており、大規模なコードベースや長文ドキュメント、豊富なコンテキストを要する複雑なワークフローに適しています。課題に費やす推論時間に応じて、低・高・最大の推論努力を選択できます。
また DSpark 予測デコードにも対応。DSpark は本体モデルの検証前に複数トークンを下書きし、対応する推論エンジンと組み合わせると生成速度が 60%〜85% 向上する可能性があるとしています。
まず、DeepSeek-V4-Flash-0731 の Q8 版を実行し、Unsloth Studio と OpenCode が生成する Web サイトをホストできるだけの GPU メモリとストレージを備えた RunPod 環境を作成します。
Pod の設定:
/workspace を永続ボリュームのマウントパスに指定HF_TOKEN として追加8910 と 9101 を公開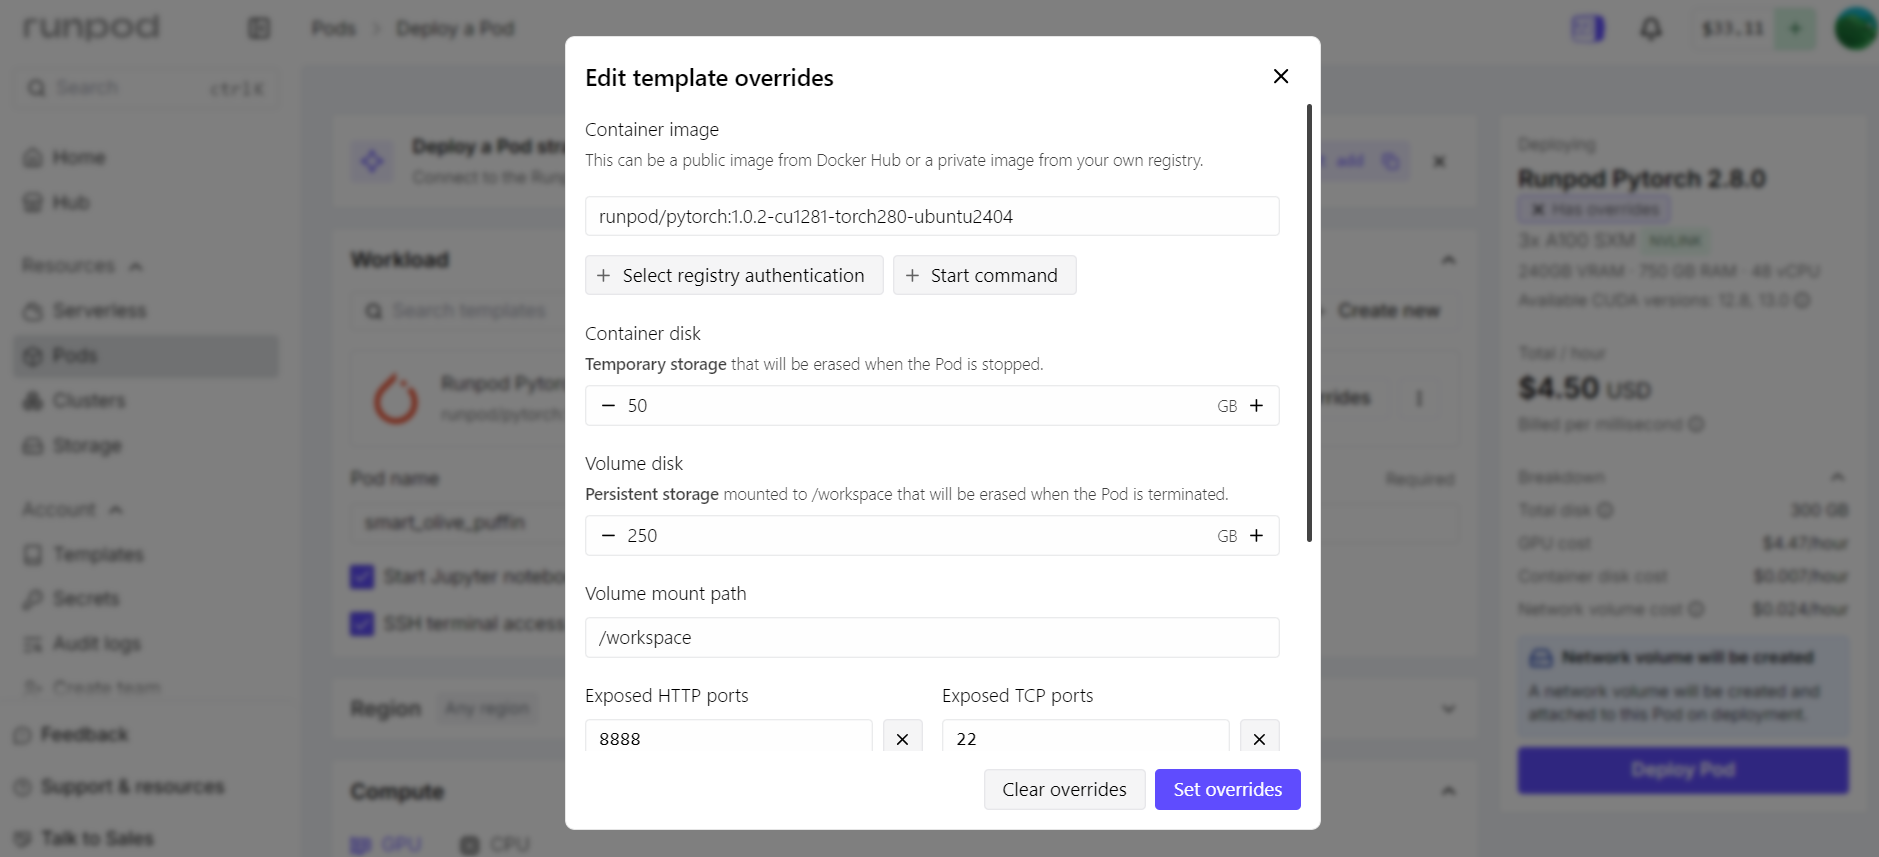
ポート 8910 は Unsloth Studio とそのローカル推論 API 用、ポート 9101 は OpenCode が作成するインタラクティブな Web サイト用です。
RunPod は HTTP プロキシ経由でこれらのサービスを公開するため、どちらのアプリケーションも 127.0.0.1 ではなく 0.0.0.0 で待ち受ける必要があります。
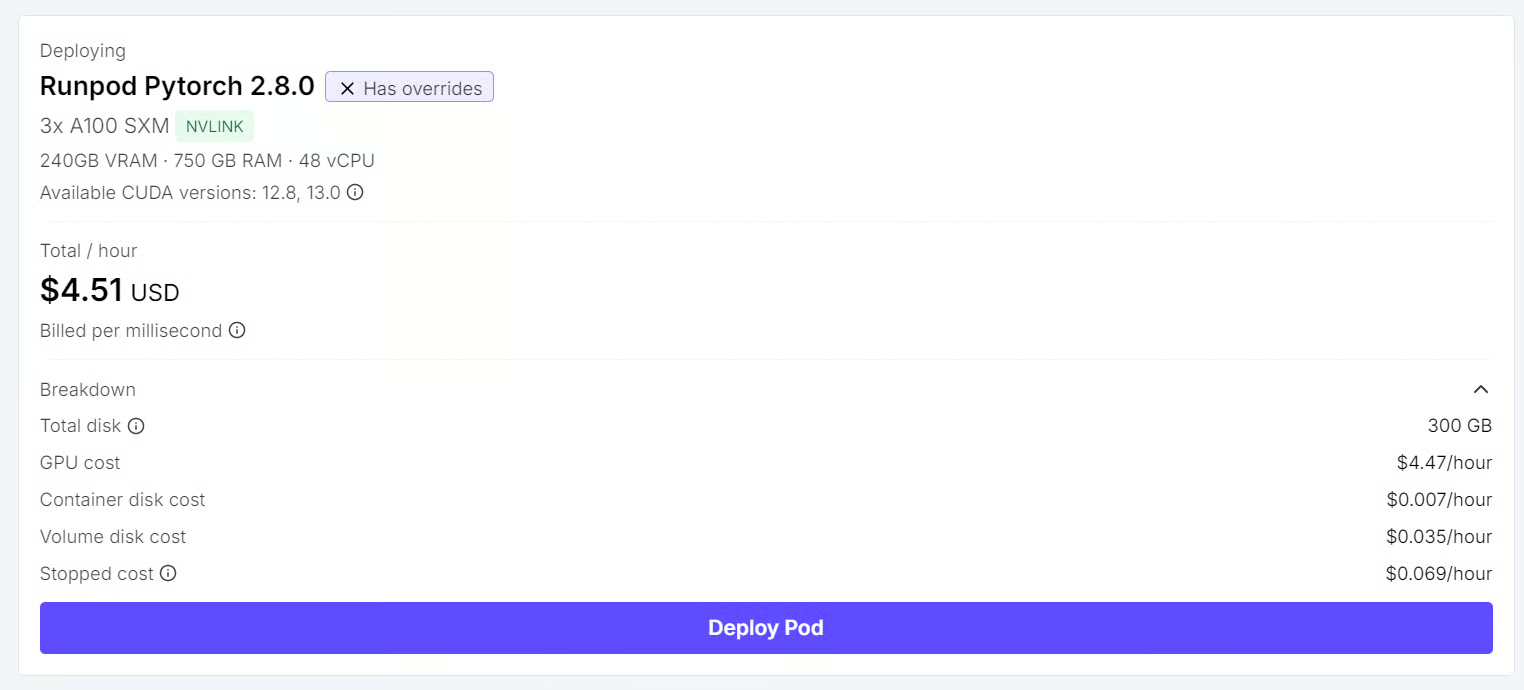
Pod をデプロイしたら、Connect タブを開き、JupyterLab を起動し、ターミナルを 3 つ用意します:
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
タスクを分けると、GPU の監視、モデルのトラブルシューティング、コーディングエージェントの実行を同時に進めやすくなります。
次に、Unsloth Studio をインストールし、永続的な Hugging Face キャッシュを設定し、ポート 8910 でインターフェースを起動します。
まず Terminal 1 で、3 基の GPU が認識されているか確認します:
nvidia-smiLinux サーバー上に A100 が 3 基表示されるはずです。
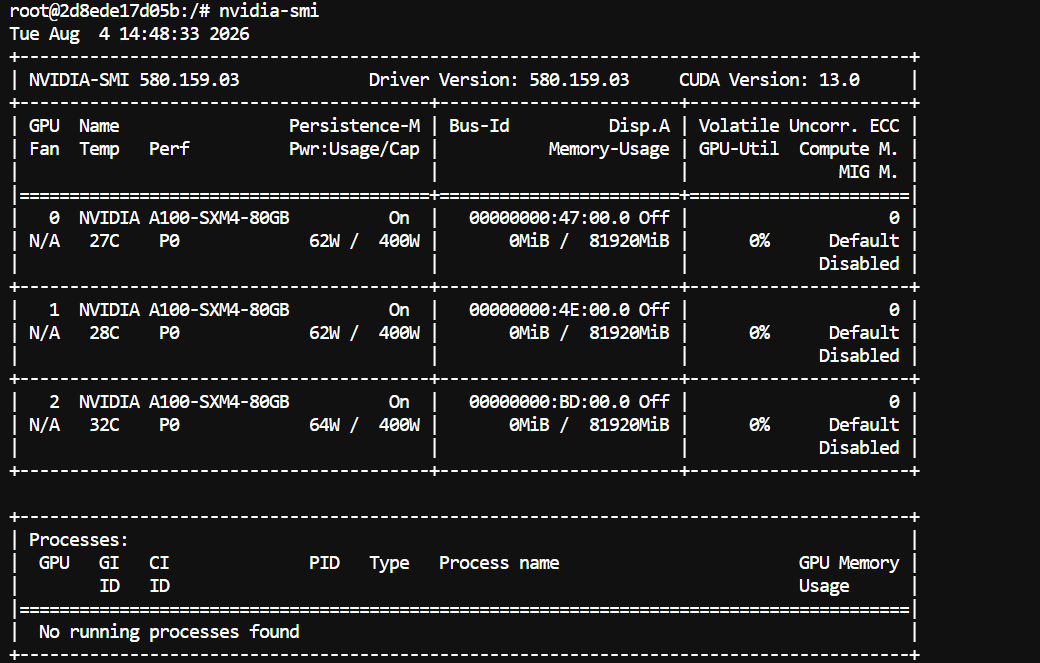
/workspace 配下に永続的な Hugging Face キャッシュを作成し、ダウンロードしたモデルを RunPod のボリュームに保持します:
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
続いて、必要なシステムパッケージと Unsloth Studio をインストールします:
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh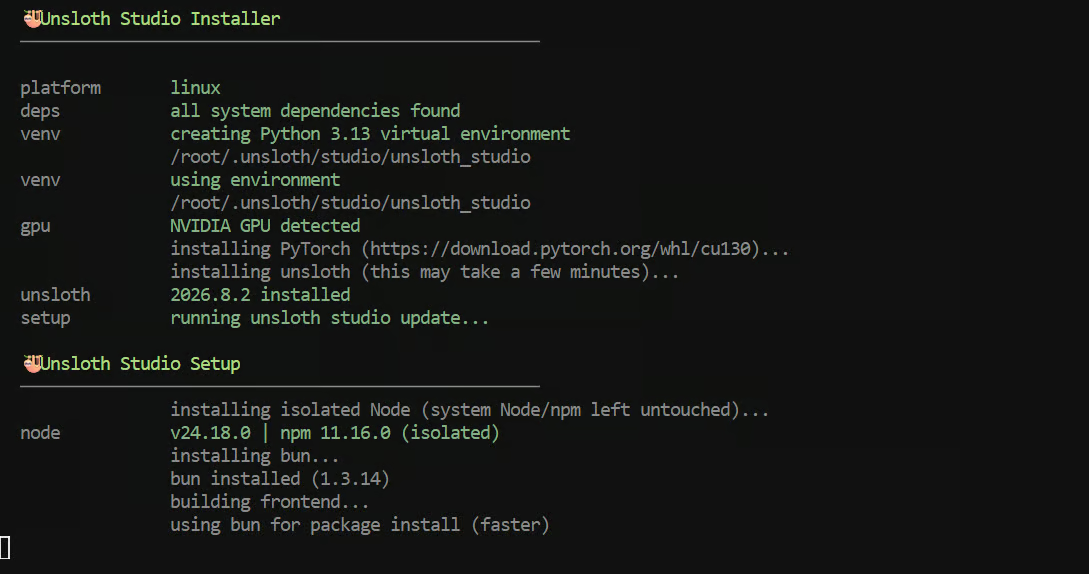
インストーラーは Studio の UI、Python 環境、依存関係、ローカル推論コンポーネントを設定します。
初回のインストールは数分かかる場合があります。
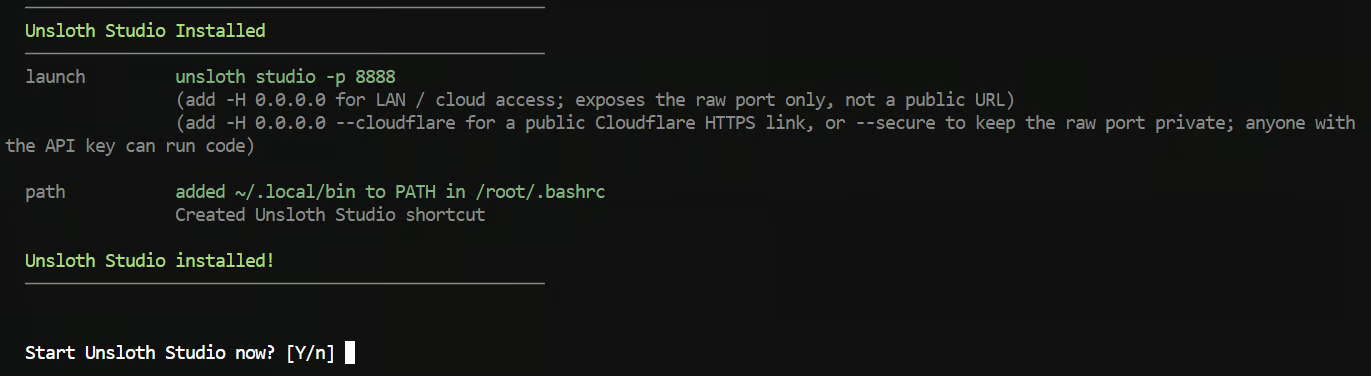
インストーラーが Unsloth Studio を今すぐ起動するか尋ねたら、“n” を入力してください。
手動で起動し、ポート 8910 と正しいネットワークアドレスで待ち受けるようにします。
新しいコマンドを使えるようにシェルを再起動します:
exec bash
cd /workspace
起動前に、既定のパスワードをリセットします:
unsloth studio reset-passwordセットアップ時に表示された一時パスワードを控えておき、リセットの完了に使用してください。
Unsloth Studio を起動します:
unsloth studio \
  -H 0.0.0.0 \
  -p 8910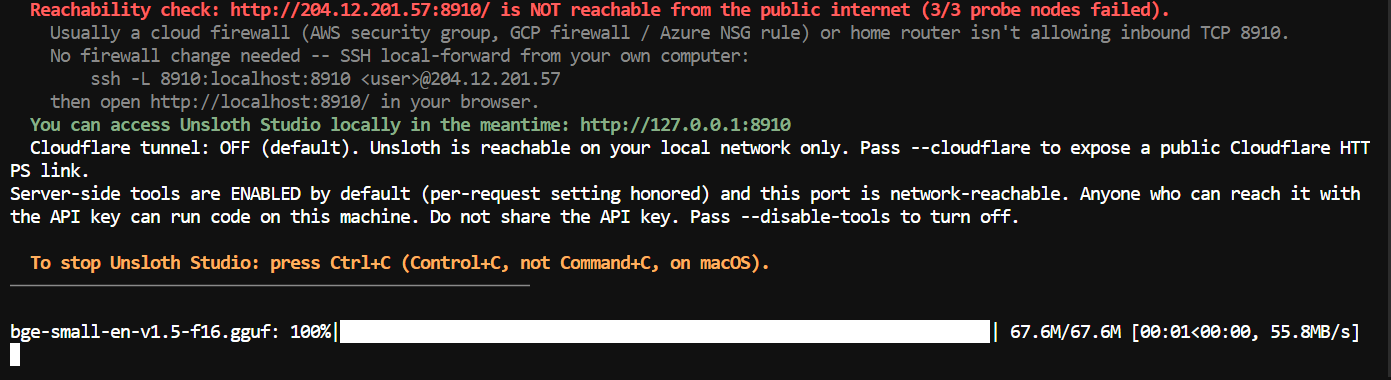
Studio がポート 8910 で動作していると表示されるはずです。Unsloth Studio と OpenCode を利用している間は、Terminal 1 を開いたままにしてください。
RunPod の Connect ページに戻り、ポート 8910 の HTTP Service を開きます。
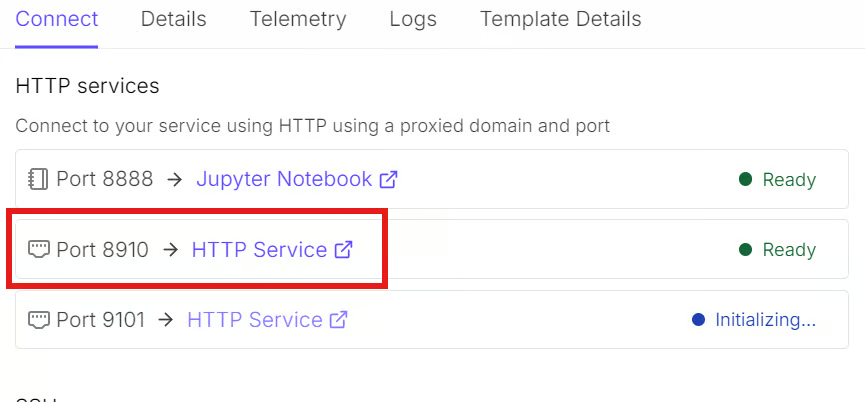
先ほど生成した一時パスワードでリセットを完了し、新しく設定したパスワードでサインインしてください。
オンボーディングは完了するかスキップし、Chat ページを開きます。
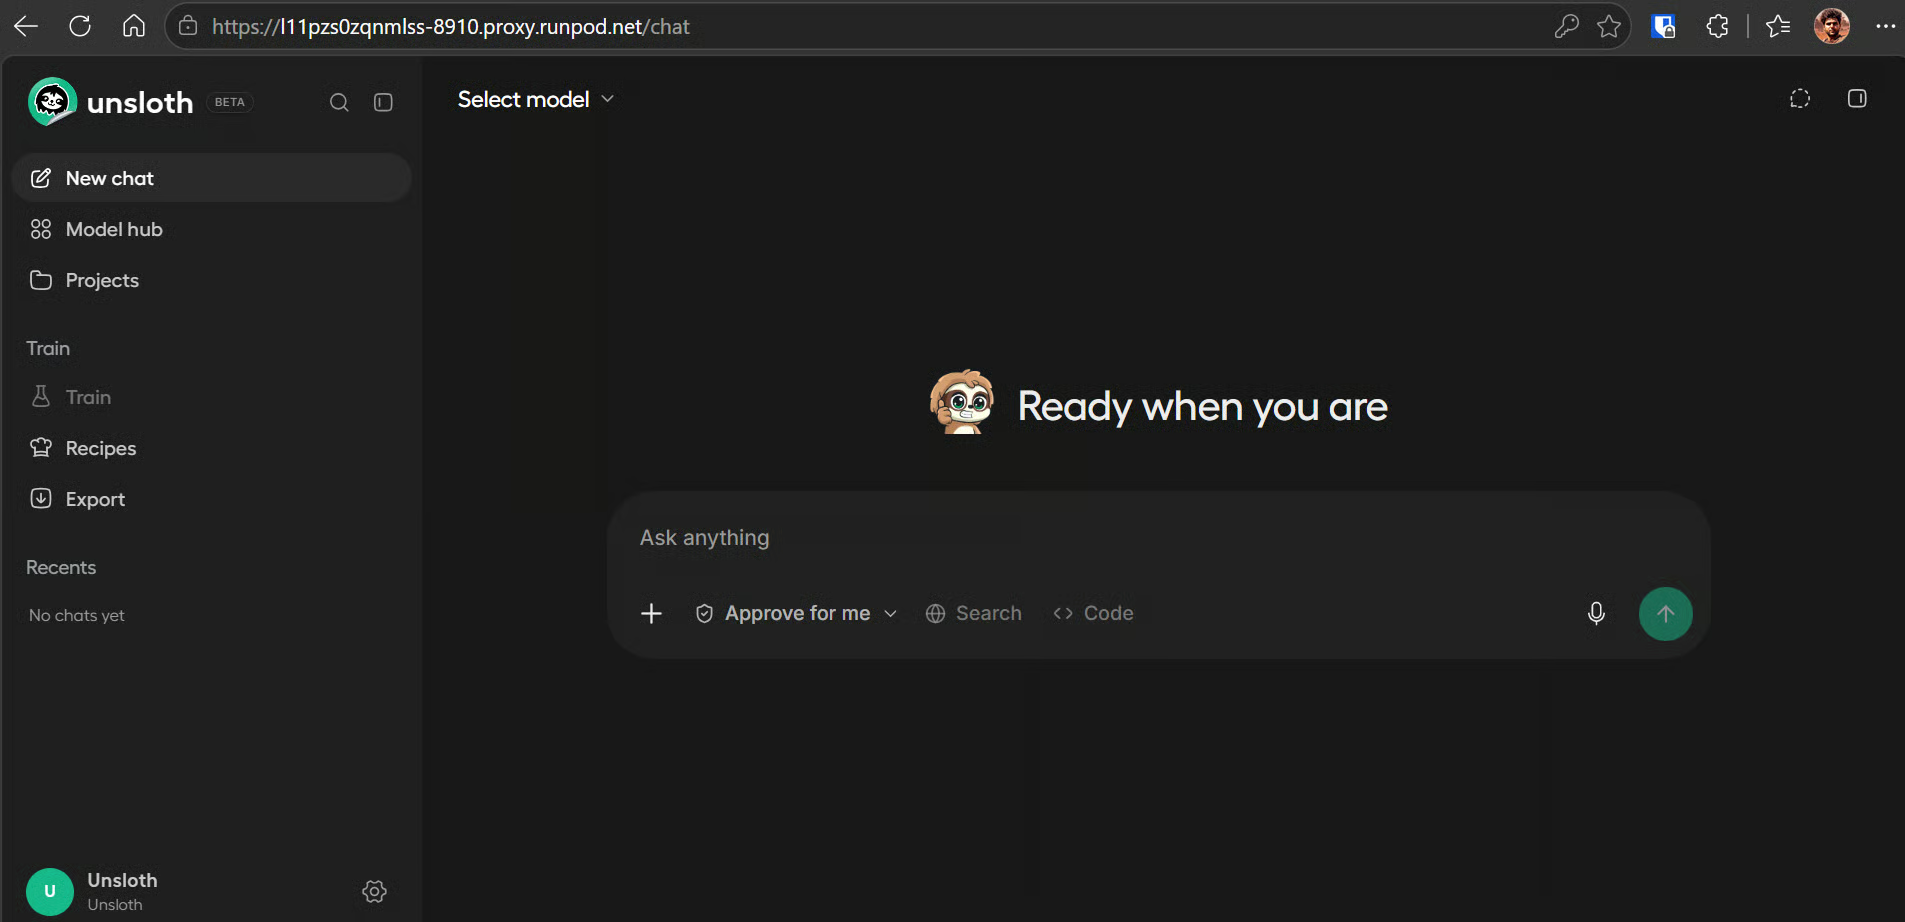
Unsloth Studio が起動したら、Q8 モデルをダウンロードし、3 基の GPU に跨って読み込み、チャットやツール利用をテストします。
左上のモデルセレクタを開き、unsloth/DeepSeek-V4-Flash-0731-GGUF を検索し、Q8 量子化の UD-Q8_K_XL を選択します。
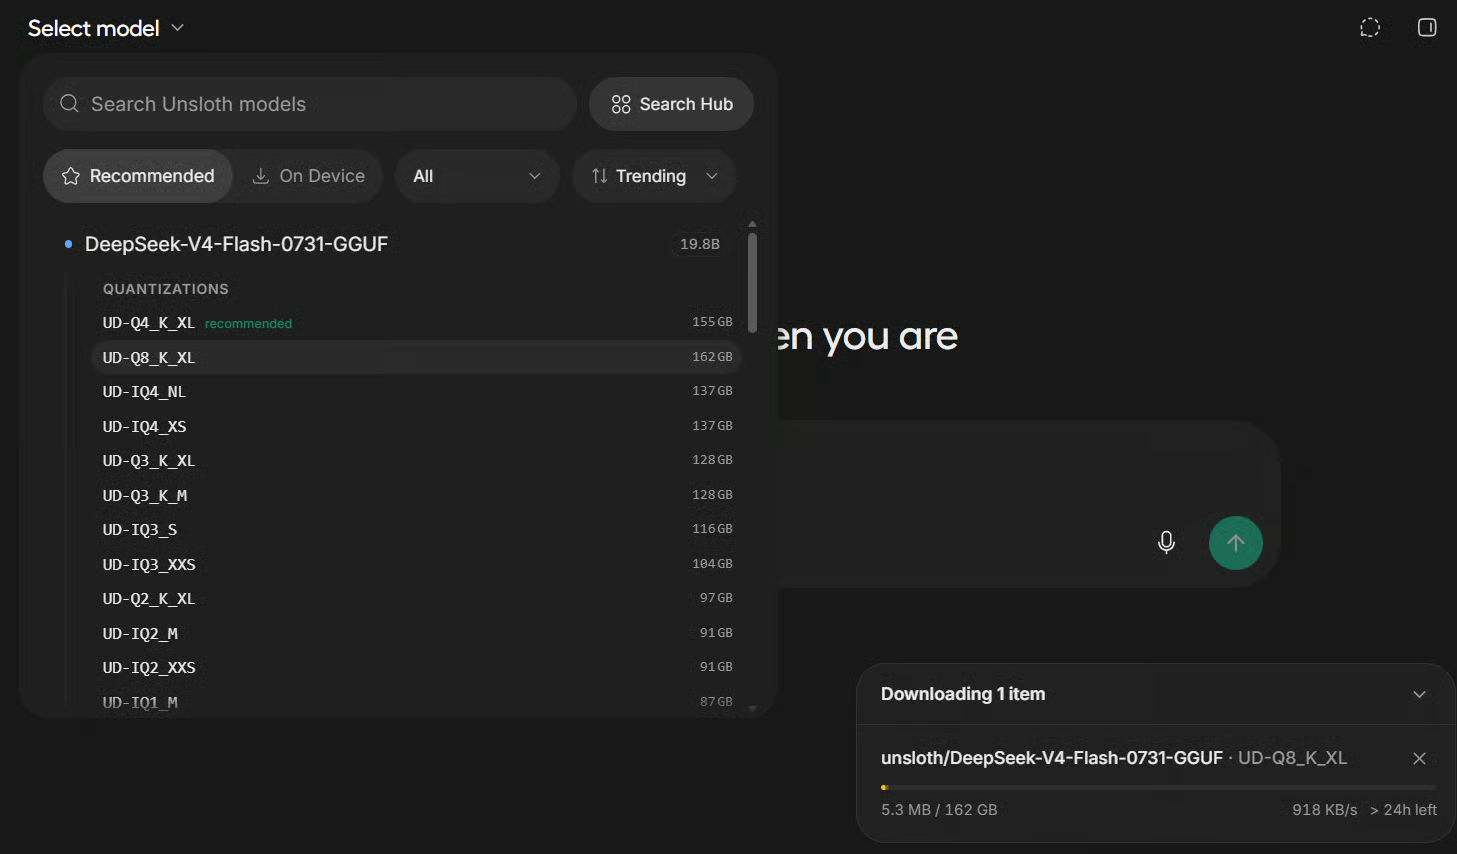
A100×3 基の合計 VRAM で十分に動作するため Q8 を使用します。Q8 は元モデルに近い品質を保ちますが、メモリが限られる環境では低ビット量子化の方が有用です。
ダウンロードが終わると、Unsloth Studio が自動でモデルを GPU メモリに読み込み始めます。Q8 モデルは非常に大きいため、数分かかる場合があります。
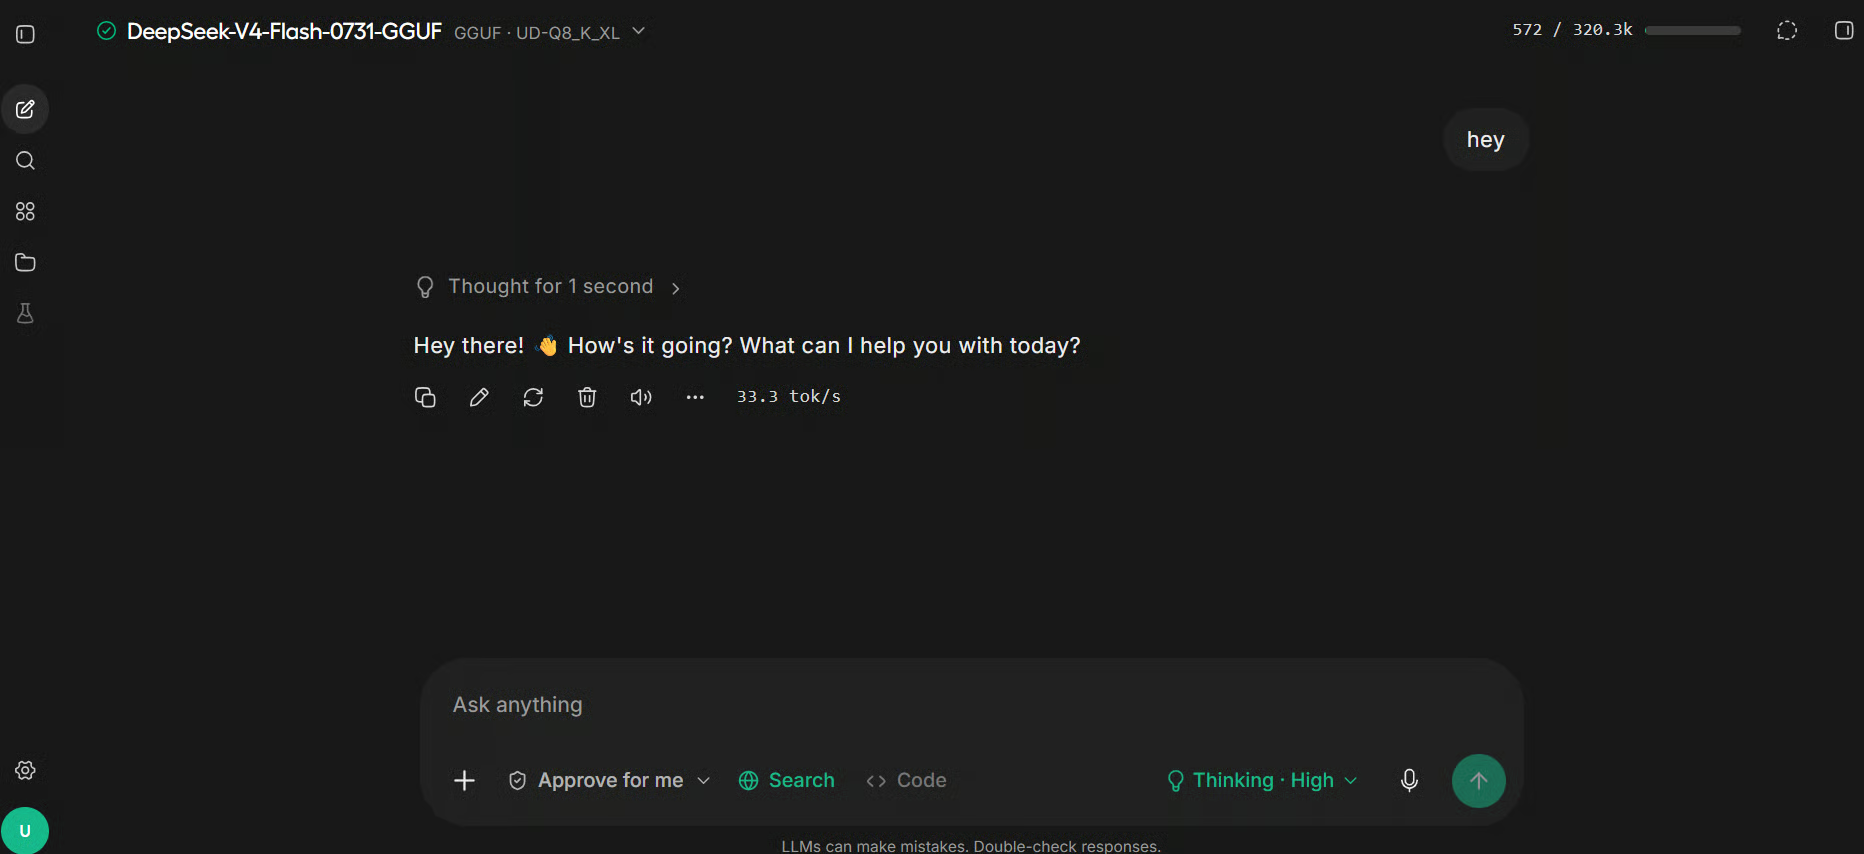
読み込み後、Chat ページで簡単なプロンプトをいくつか試してみてください。
検証では、予測デコードなしで約 1 秒あたり 33 トークン の生成速度に達し、この規模のモデルとして妥当な結果でした。
Studio のウェブ検索ツールを有効にし、金・銀の直近価格など最新情報の検索をモデルに依頼することもできます。内部知識だけに頼らず外部ツールを呼び出せるかを確認するのに有効です。
次に、Terminal 2 で GPU への分散状況を確認します:
nvidia-smi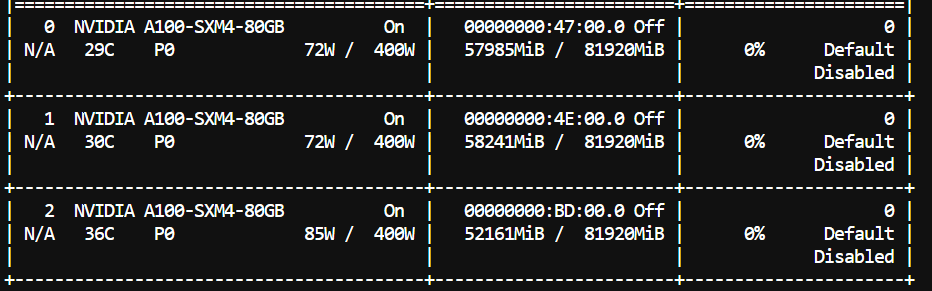
3 基すべての GPU で大きなメモリ使用量が確認できるはずです。
今回のテストでは、各 GPU が約 70% 使用されていました。ただし、これは Q8 モデル全体が 80GB×2 基に余裕で収まることを意味するわけではありません。コンテキストウィンドウ、KV キャッシュ、推論用バッファにも追加の VRAM が必要です。
最後に、これから構築するアプリ用のプランニングプロンプトでモデルをテストします:
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
アプリのアーキテクチャ、コンポーネント、データフロー、チャートライブラリ、金融計算、UI デザインを網羅する構造化された開発計画が返ってきます。
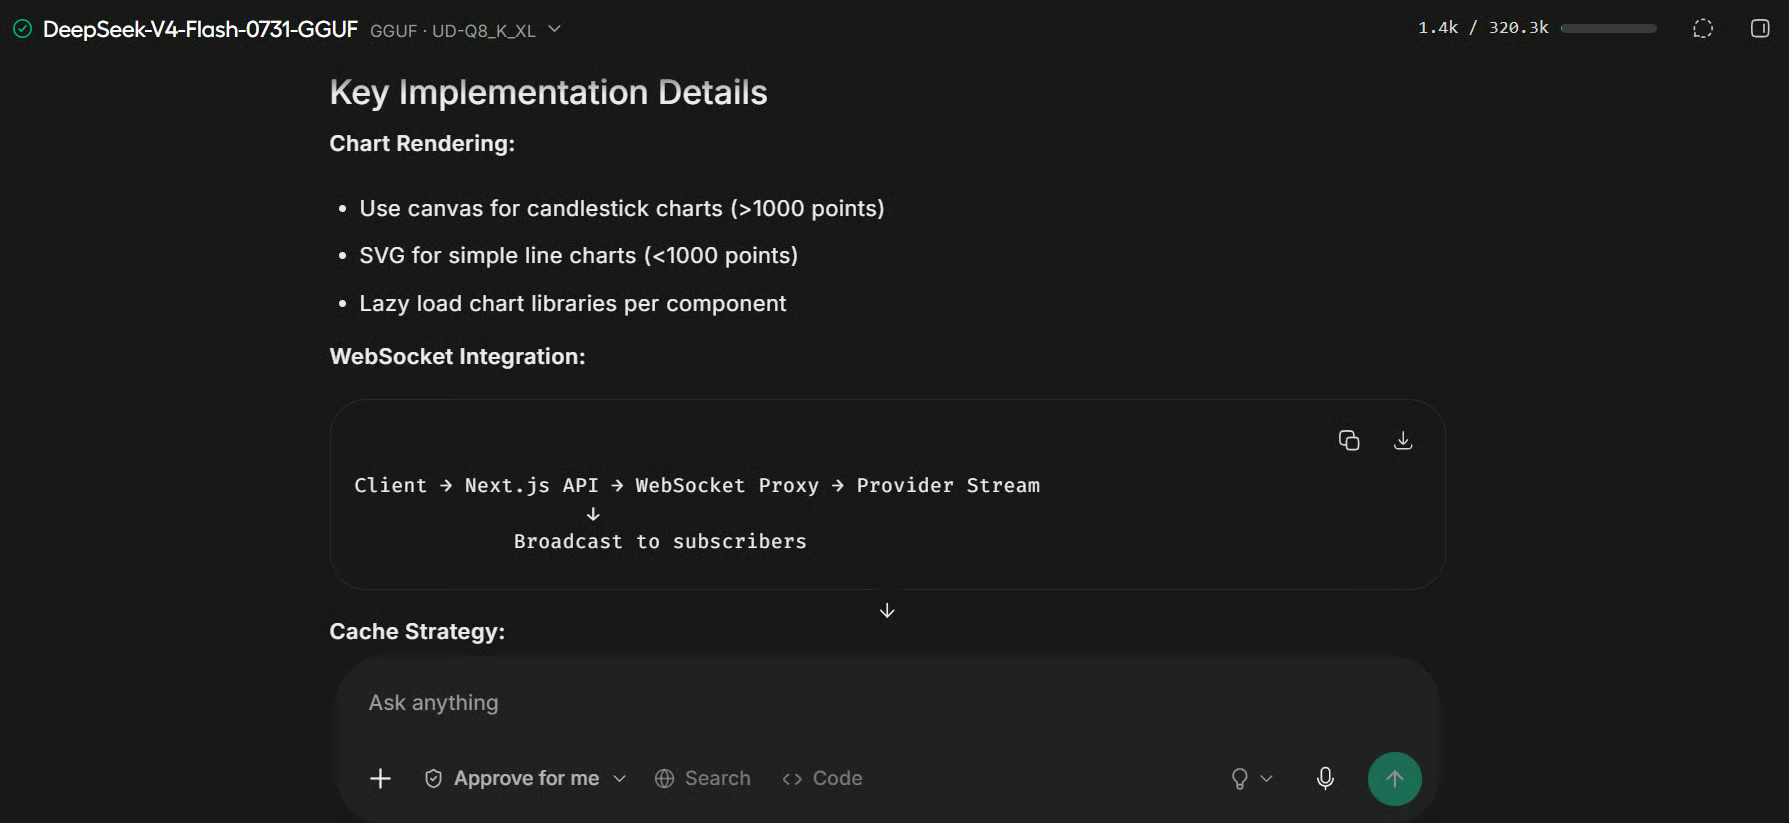
モデルが Unsloth Studio 上で動作したら、OpenCode に接続してローカルのコーディングエージェントとして使用します。
まず Terminal 3 で Studio の URL を設定します:
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
新規プロジェクト用ディレクトリを作成します:
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
Unsloth Studio 経由で OpenCode を起動します:
unsloth start opencode初回実行時は OpenCode のインストール許可を求められます。“y” を入力してください。
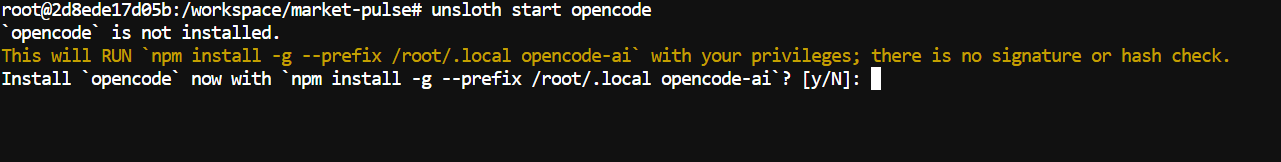
インストールが完了すると、OpenCode はローカルで動作中の DeepSeek-V4-Flash-0731 をあらかじめ設定した状態で起動します。
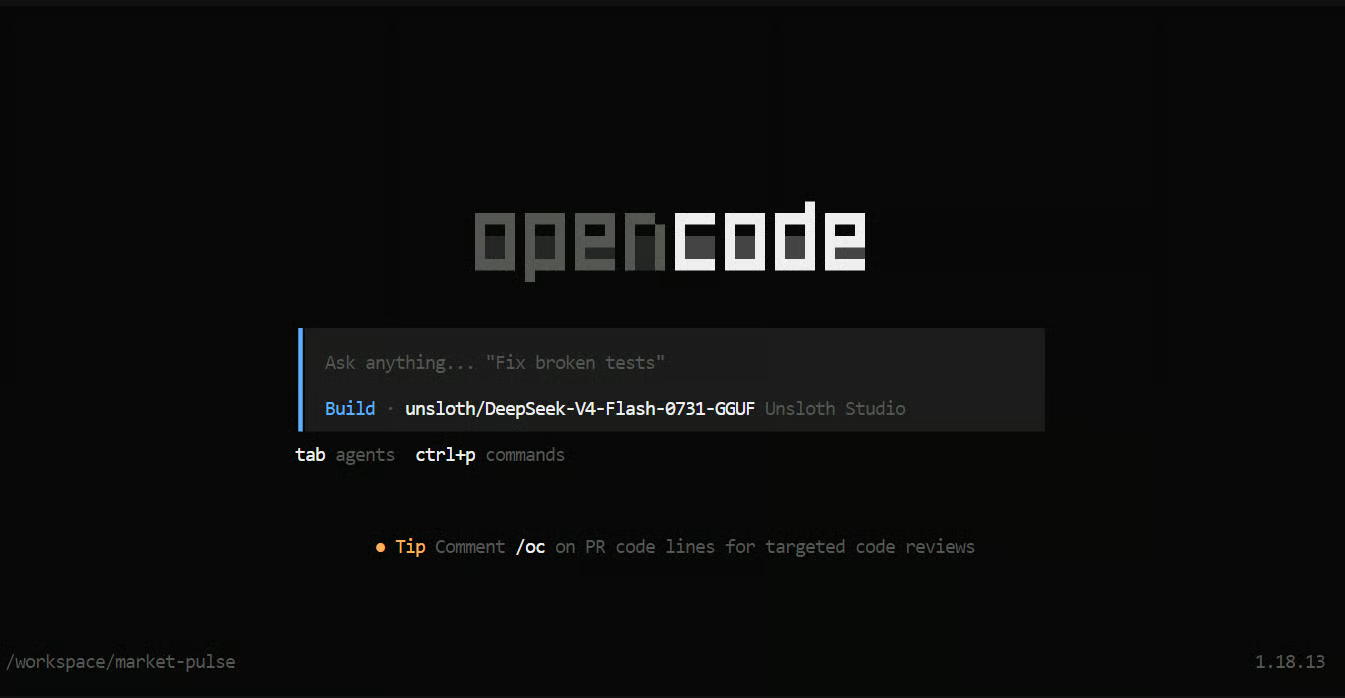
以下の 2 行のプロンプトを OpenCode に貼り付けます:
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
数秒で、コーディングエージェントが詳細なタスクリストを作成し、プロジェクトを段階的に進め始めるはずです。
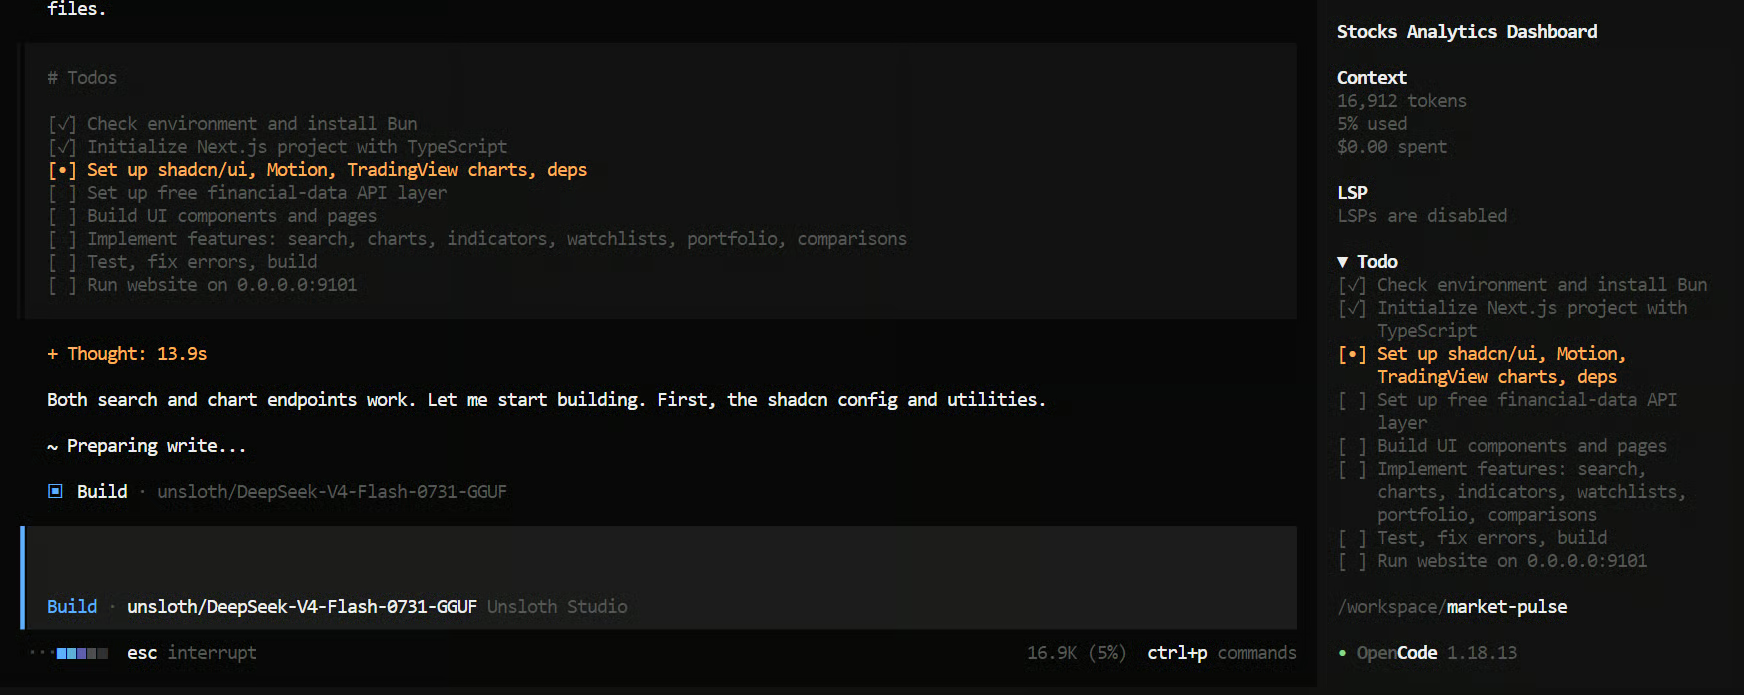
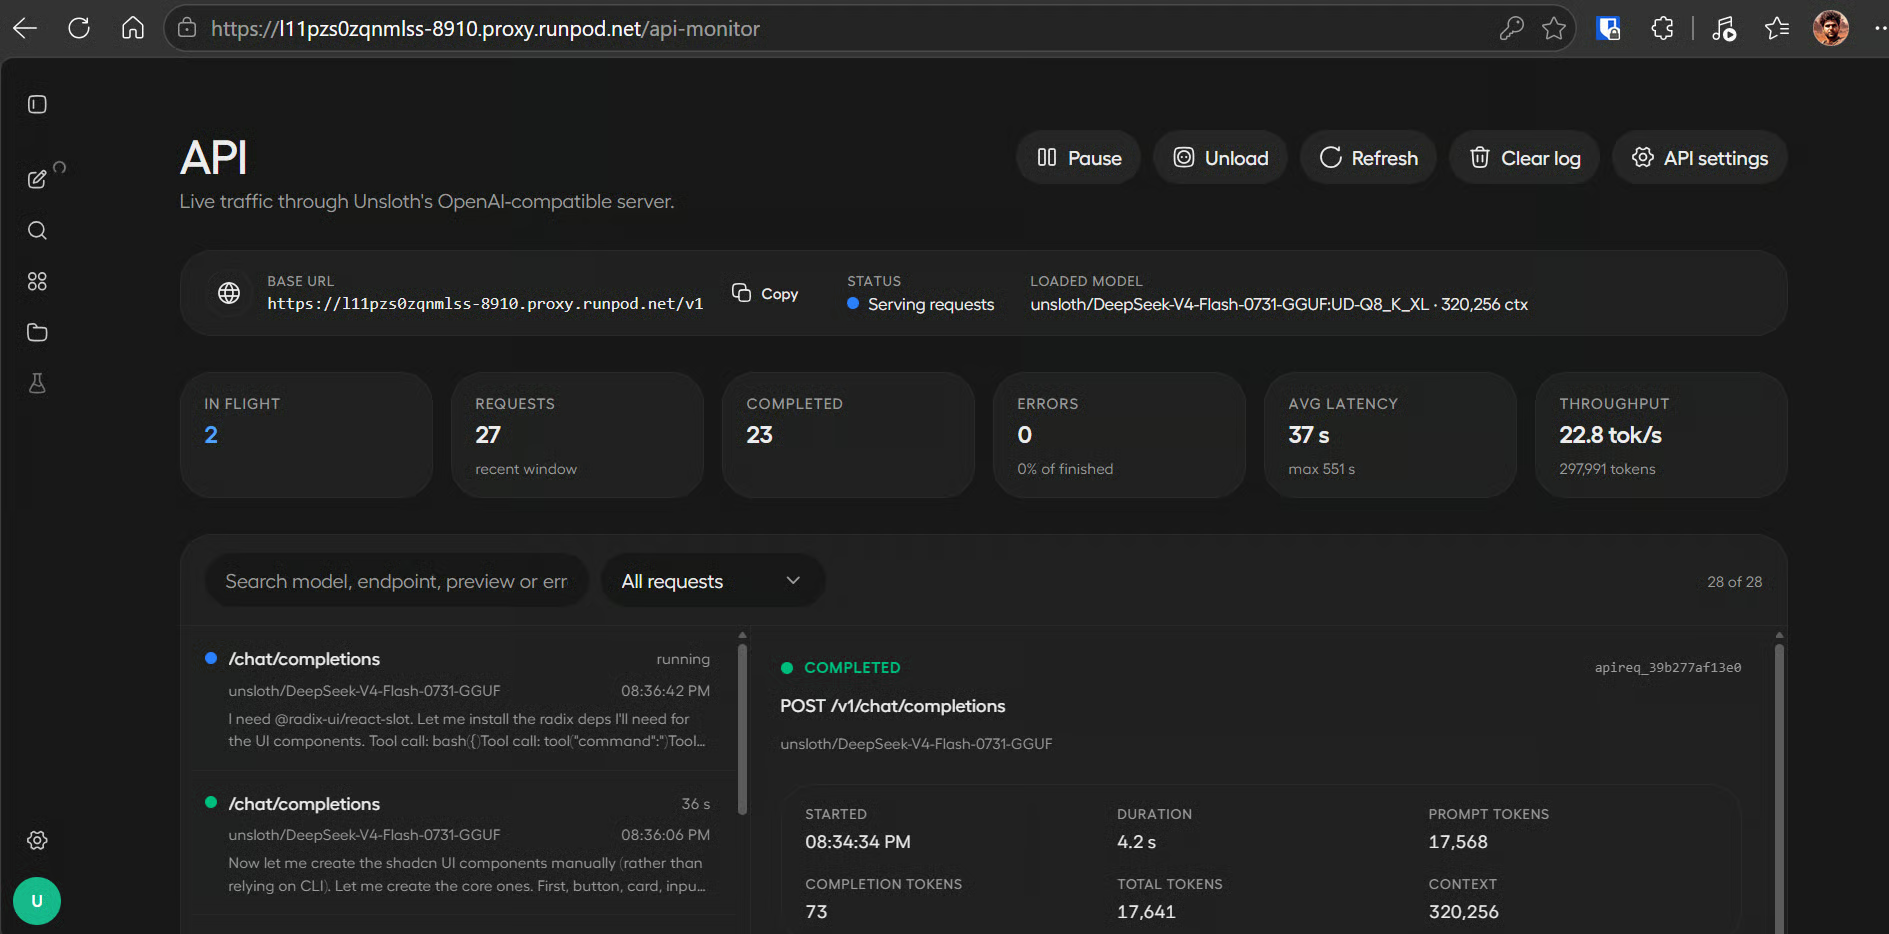
フルビルドはテスト環境で約 20 分かかりました。実行中は Unsloth Studio に戻り、Settings の API 監視ページでモデルの使用状況や生成速度を確認できます。
コーディングワークフロー中の平均速度は約 22.6 トークン/秒 でした。会話やプロジェクトのコンテキストが増えると低下する場合があります。
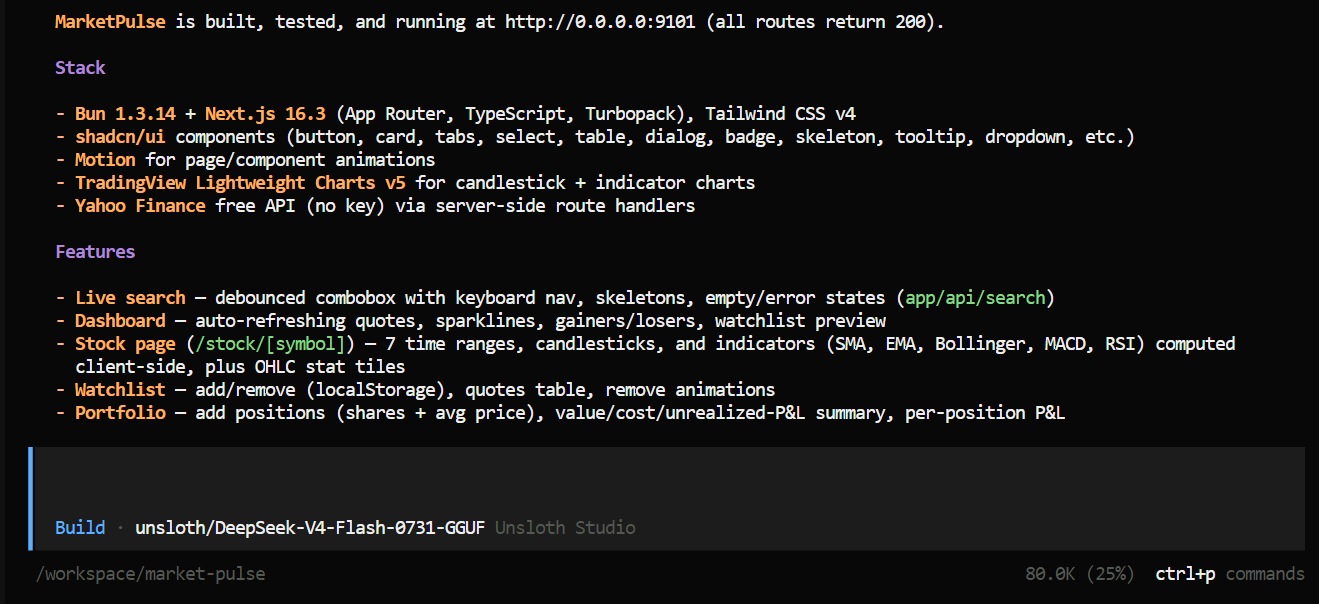
タスク完了後、OpenCode は作成したファイル・機能・コマンドの概要を提示し、完成した Web サイトをポート 9101 で起動します。
RunPod の Connect ページに戻り、ポート 9101 の HTTP Service を開きます。
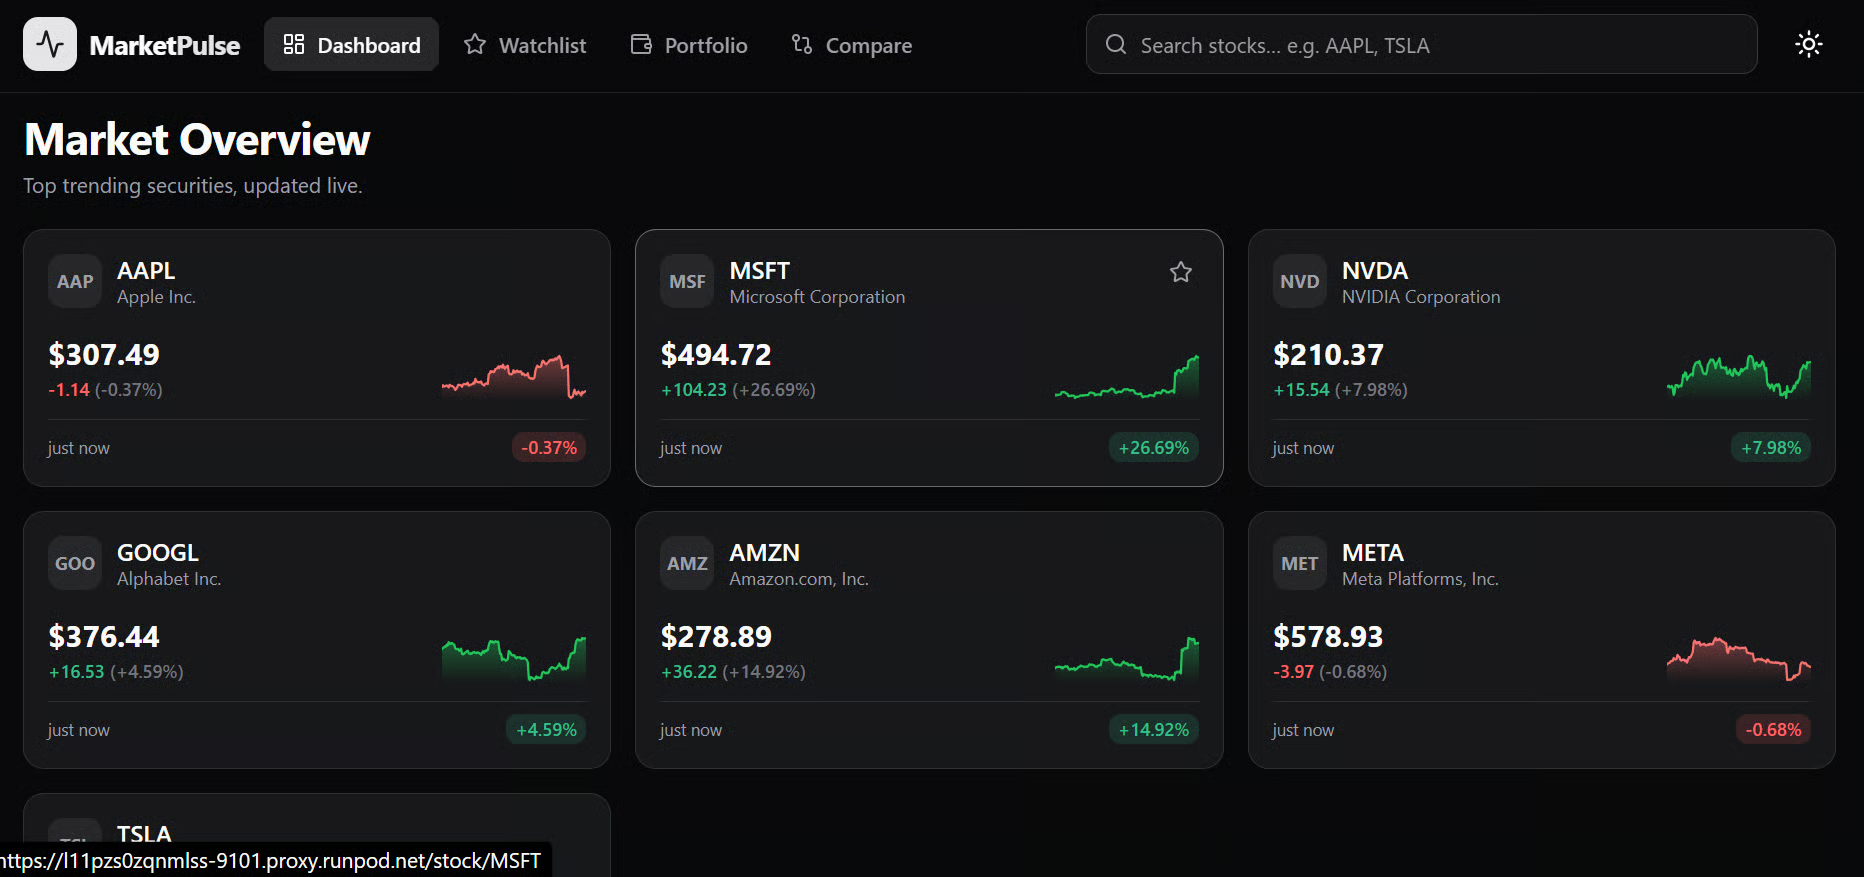
結果は想像以上に洗練されていました。サイトはクリーンでアニメーションもあり、プロフェッショナルなトレーディングダッシュボードのような見た目でした。UI、データビュー、チャート、ナビゲーションまで、単一のプロンプトで Web アプリ全体を完成させています。
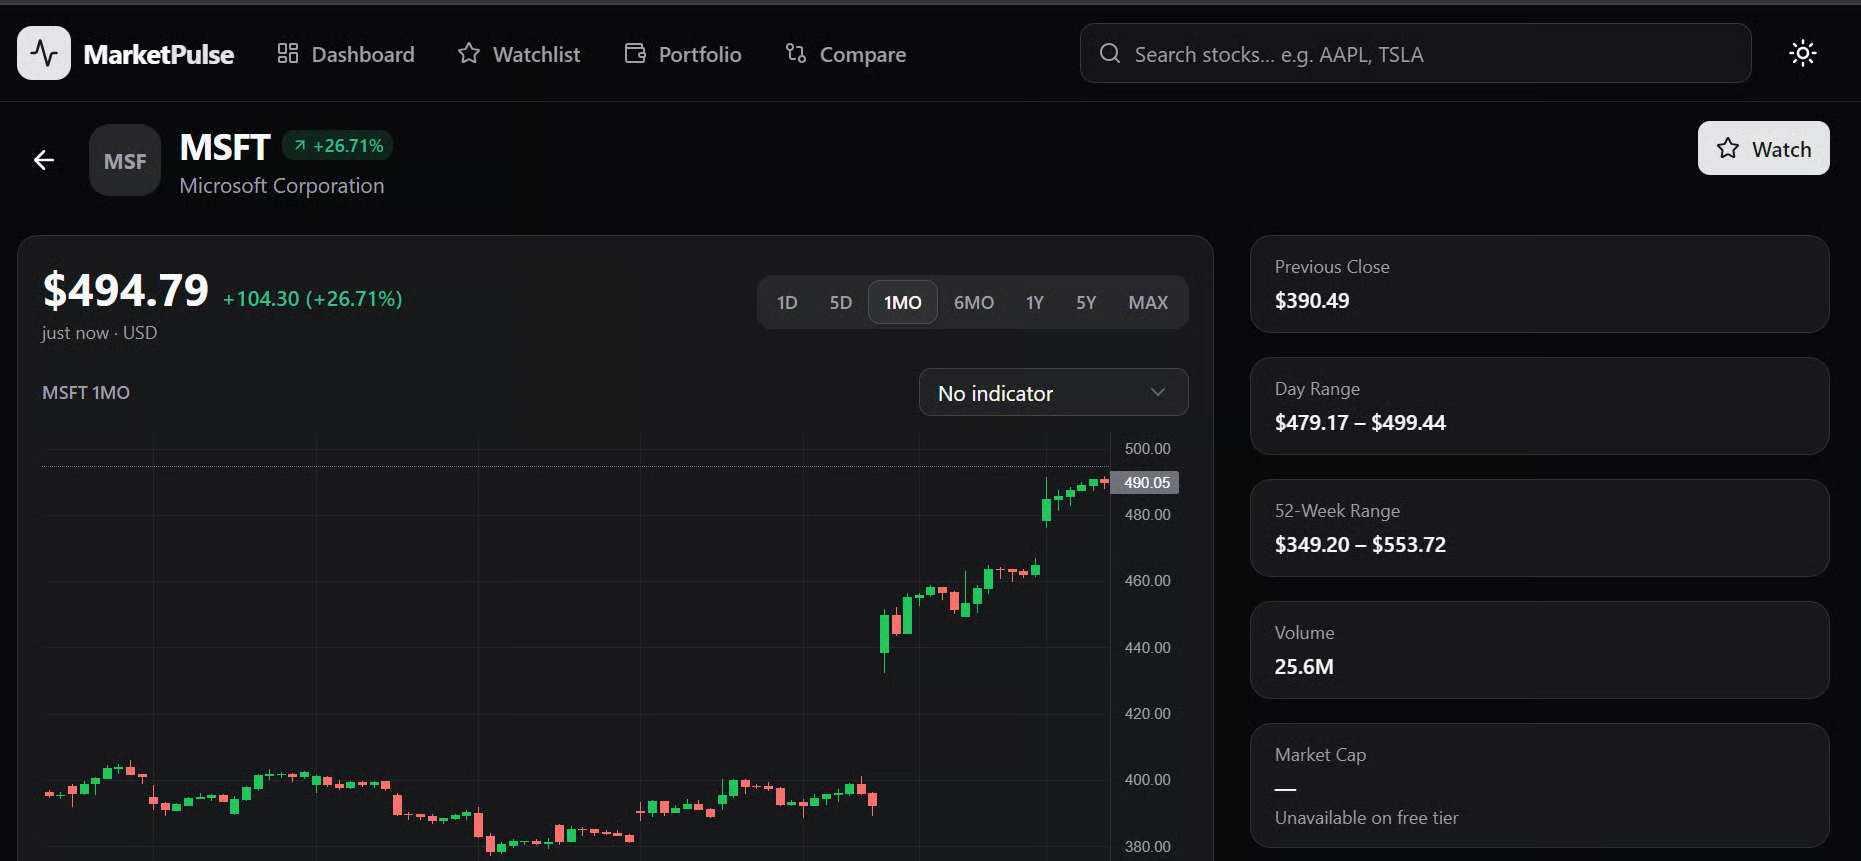
個別のティッカーを選ぶと、ローソク足チャート、過去のパフォーマンス、各種指標、企業情報などを確認できます。
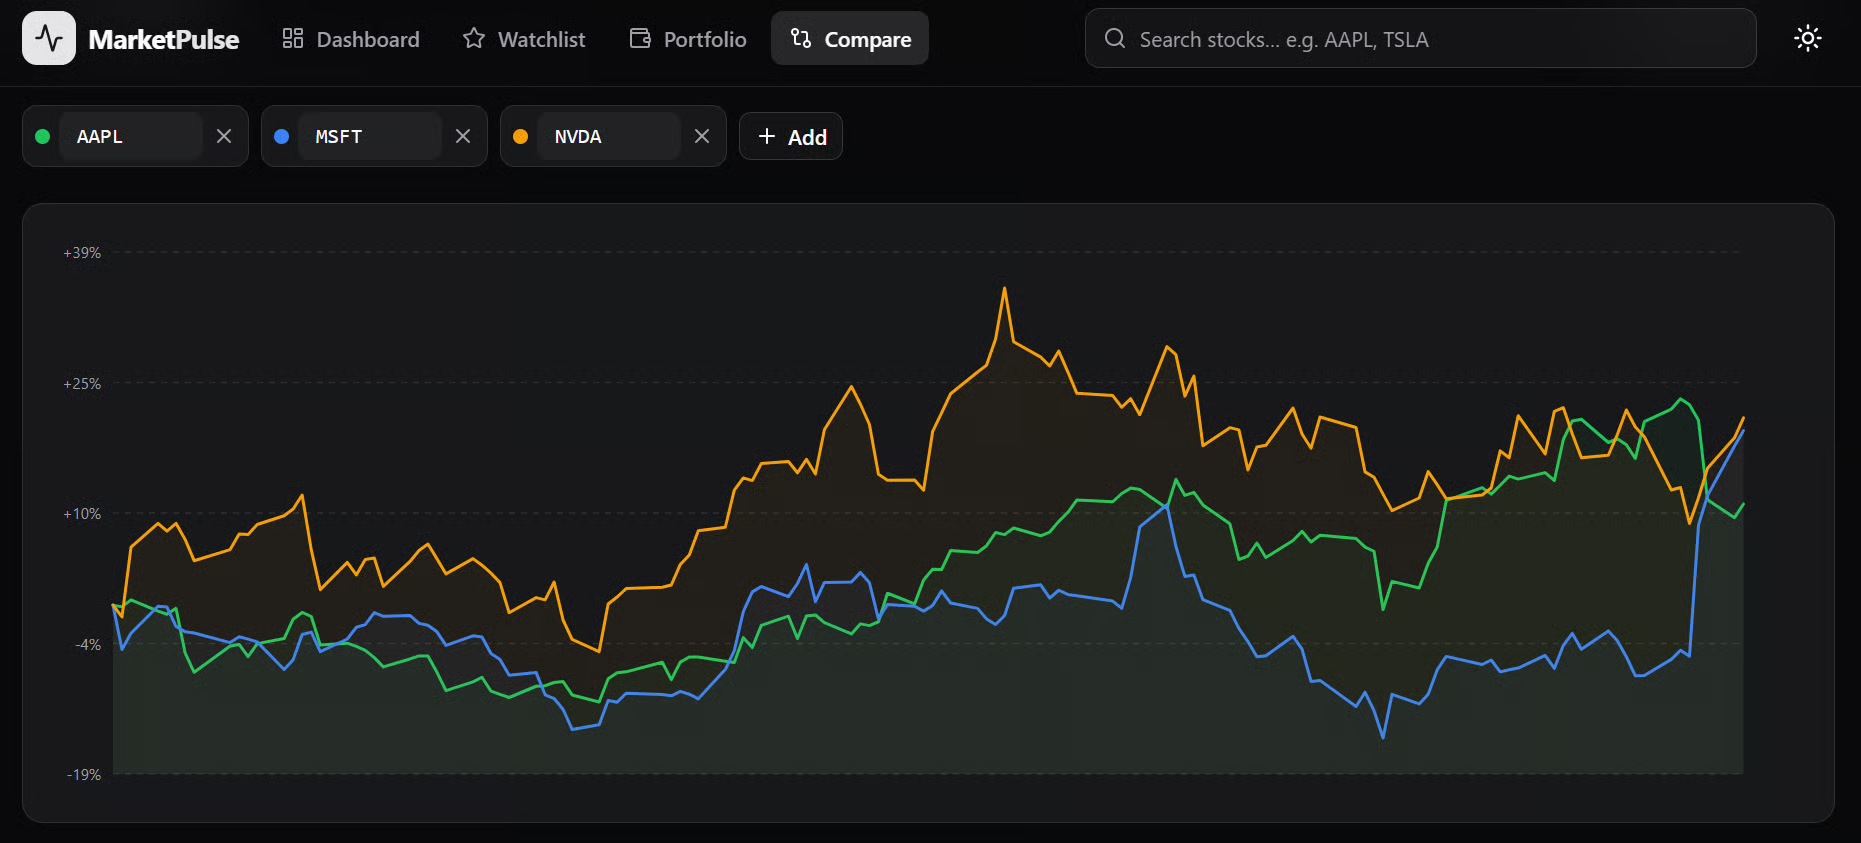
Compare タブでは、複数銘柄を比較し、指定期間でどちらが優れていたかを確認できます。
単一のプロンプトで、より小さなローカルモデルがサイト全体を構築できたのは正直驚きでした。
動作確認の結果、リアルタイム株価、過去の市場データ、チャート、指標、比較ツールなど、主要機能はすべて意図どおりに動作しました。
ローカルモデルの進化は目覚ましく、複雑なエンドツーエンドの開発タスクをこなせるレベルに到達していると感じます。
私にとって、DeepSeek-V4-Flash-0731 はこれまで試した中で最良のローカルモデルです。
Inkling、2-bit の GLM-5.2 量子化、以前お気に入りだった Qwen3.6-27B よりも良好な結果でした。これは正式なベンチマークではなく私見に基づくものですが、現時点で最優先のローカルモデルです。
ただし多くの実務では、非常に低コストな公式 DeepSeek API から始めるのが無難だと考えます。
V4 Flash の現在の料金は、未キャッシュ入力が 100 万トークンあたり $0.14、キャッシュ済み入力が 100 万トークンあたり $0.0028、出力が 100 万トークンあたり $0.28 です。このレートでは、出力料金を除き、キャッシュ済み入力 10 億トークンで約 $2.80 となります。
Unsloth Studio に落ち着く前に、llama.cpp での実行も試しました。プリビルトのインストーラーでは環境に適した最新の CUDA バイナリが得られず、ソースから最新をビルドしても DSpark 予測デコードの有効化で問題が発生しました。
最終的に Unsloth Studio が最も手軽で、手作業の設定をほぼ不要にしてくれました。OpenCode との連携も良好で、アプリ全体のビルドには約 20 分を要しました。
DataCamp の人気コース
Courses
Courses
Tracks