
Leerpad
Data-engineer in Python
40 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleApache Spark en Apache Flink zijn twee open-source dataverwerkingsframeworks die veel worden gebruikt voor big data en analytics. Hoewel beide krachtige tools zijn met robuuste verwerkingsmogelijkheden, verschillen ze in architectuur en kernfunctionaliteit.
We bekijken de belangrijkste kenmerken van Spark en Flink, met focus op verwerkingsmodellen, data-abstraheringen, toestandsbeheer (state management) en prestaties. Ook bespreken we hoe elk framework batch- en realtimeverwerking aanpakt. Door hun verschillen en overeenkomsten te begrijpen, kun je het juiste framework voor jouw behoeften kiezen.
We weten allemaal dat het datavolume exponentieel groeit. Organisaties die big data willen benutten, lopen al snel tegen schaalbaarheids- en efficiëntieproblemen aan.
Dataverwerkingsframeworks bieden hier uitkomst, omdat ze een reeks aan dataoperaties ondersteunen, waaronder ingestie, transformatie en opslag, zelfs bij terabytes aan data. Ze bieden een breed scala aan tools en API’s, wat je flexibiliteit geeft voor taken van basale operaties tot en met machinelearningmodellen. Daarnaast abstraheren dataverwerkingsframeworks veel complexiteit weg, wat ontwikkeling en debuggen van datapijplijnen eenvoudiger maakt.
Grofweg werken dataverwerkingsframeworks door de werklast over meerdere nodes in een cluster te verdelen. Sommige frameworks zijn speciaal bedoeld voor realtime data, zodat je data kunt analyseren zodra die binnenkomt. Andere zijn geoptimaliseerd voor batchverwerking, wat handig is voor terugblikkende analyses.
Apache Spark is een open-source, gedistribueerd computingframework dat is ontworpen om grote hoeveelheden data efficiënt en snel te verwerken. Het gebruikt een in-memory programmeermodel, wat betekent dat data in het hoofdgeheugen van clusternodes kan worden opgeslagen. Dit versnelt de verwerking aanzienlijk vergeleken met tools die meer afhankelijk zijn van schijftoegang. De gebruiksvriendelijke interface laat je complexe dataoperaties uitvoeren via een set API’s in meerdere talen, zoals Python en R, twee van de belangrijkste talen voor data science.
Apache Spark kan bewerkingen veerkrachtig uitvoeren, wat wil zeggen dat het storingen op clusternodes kan opvangen en automatisch kan herstellen. Deze krachtige eigenschap is te danken aan het onderdeel Resilient Distributed Dataset (RDD), een gedistribueerde verzameling van basiseenheden die datarijen bevatten.
Daarnaast maakt het uitvoeringsmodel van Spark, de Directed Acyclic Graph (DAG), het mogelijk om de parallelle uitvoering van taken te optimaliseren. Hiermee kan Spark taken over verschillende nodes in hetzelfde cluster distribueren en zo alle beschikbare resources benutten.
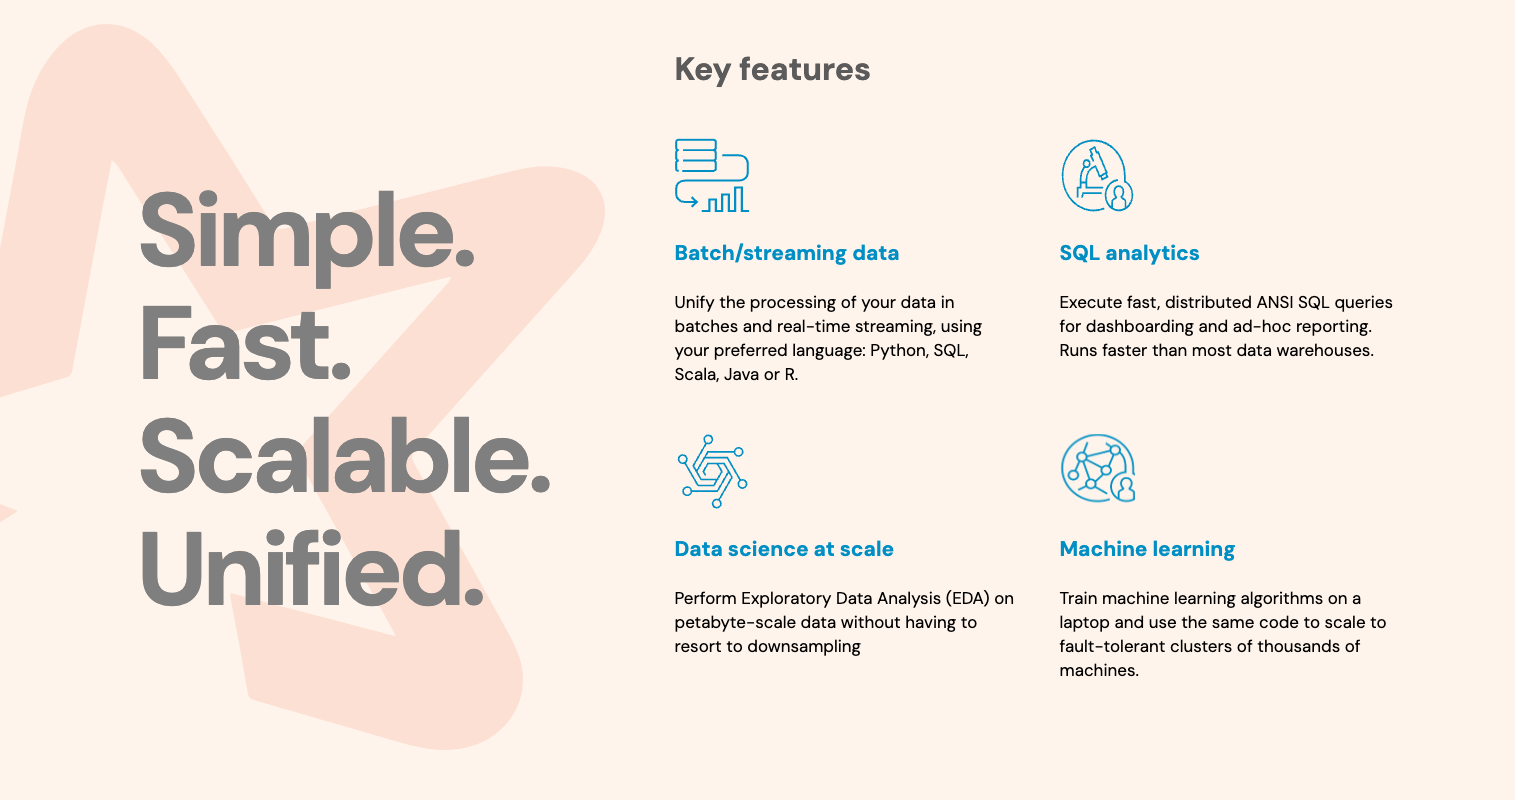 Belangrijkste kenmerken van Apache Spark. Bron
Apache Flink is een open-source dataverwerkingssysteem dat uitblinkt wanneer je realtime data wilt analyseren en grote datasets wilt verwerken met lage latentie en hoge performance. Met dezelfde infrastructuur kan Apache Flink ook batchdata verwerken, wat een groot voordeel is als je complexe datapijplijnen wilt bouwen en draaien die realtime data op gedistribueerde systemen verwerken. Het biedt een set API’s in meerdere talen, waaronder Python en R, en gespecialiseerde bibliotheken om eventverwerkingspijplijnen voor machine learning te bouwen.
Apache Flink beschouwt je data als continue stromen van events, wat nuttig is voor toepassingen waarbij data voortdurend wordt ontvangen en verwerkt. Dit stroomgeoriënteerde programmeermodel is een sleutelfunctie die leidt tot lage latentie bij het reageren op events. Daarnaast kun je met Flink-bewerkingen complexe en sterk aangepaste dataverwerkingspijplijnen bouwen.
Flink beheert state efficiënt in realtime dataverwerkingstoepassingen. Dit betekent dat je de status van je applicaties kunt bijhouden en bijwerken zodra data binnenkomt, met fouttolerantie.
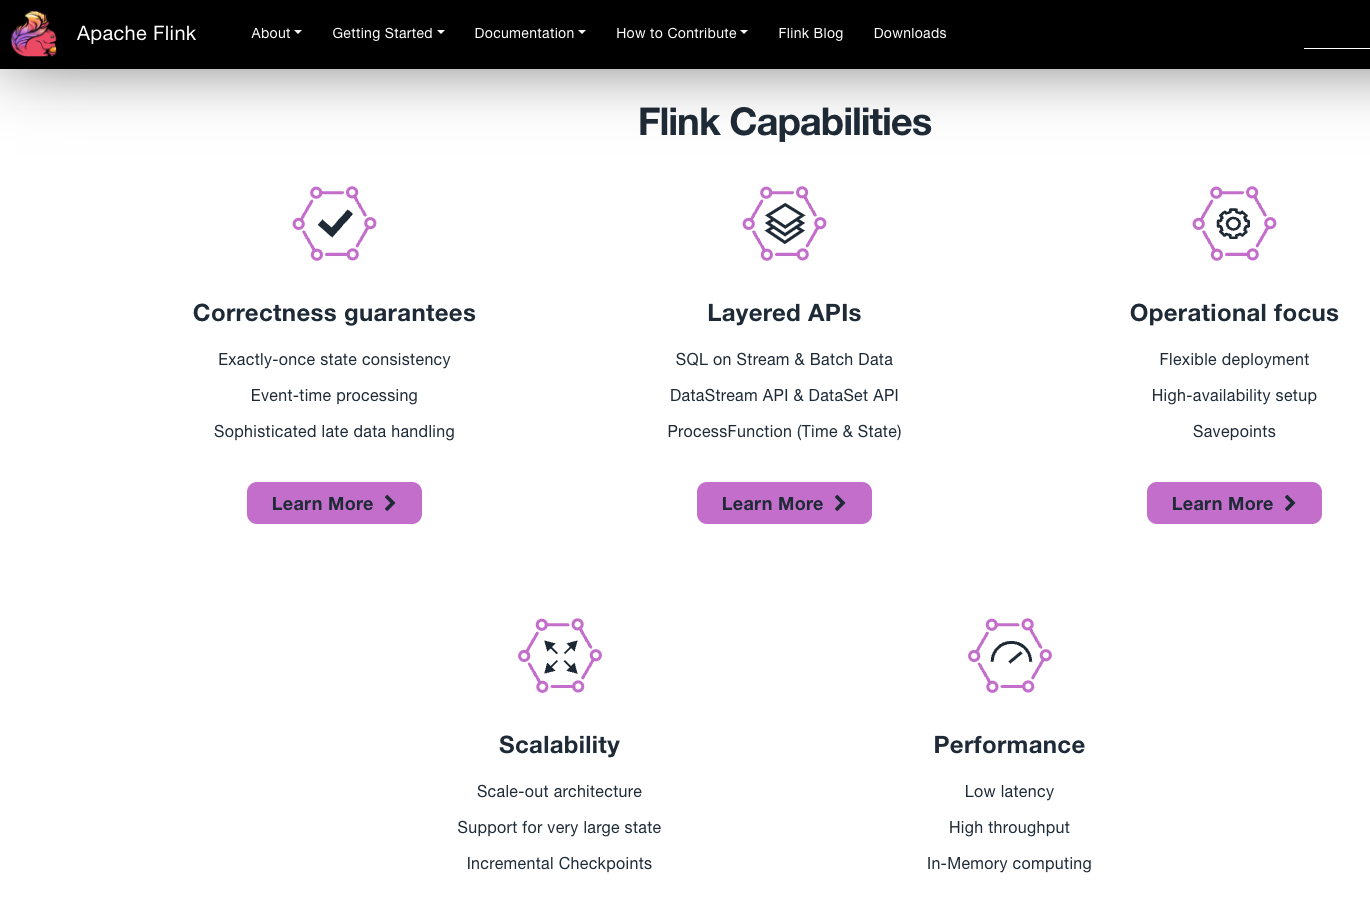 Belangrijkste kenmerken van Flink. Bron
Het benutten van de juiste features van een geschikt dataverwerkingsframework kan de prestaties en efficiëntie van je datapijplijn verbeteren. Onder de vele functies die Spark en Flink bieden, zijn er een paar kernpunten die je moet afwegen bij de keuze tussen deze tools:
Hoewel Spark en Flink duidelijke onderscheidende kenmerken hebben, delen ze meerdere belangrijke eigenschappen. Beide zijn ontworpen om grootschalige dataverwerkingstaken met lage latentie aan te kunnen. Ze bieden allebei een set API’s in meerdere talen, waaronder Python, Scala, Java en R, en ze zijn geïntegreerd in een breder bigdata-ecosysteem. Daarnaast implementeren Spark en Flink prestatieoptimalisaties.
Laten we elk van deze overeenkomsten bekijken:
Apache Flink en Apache Spark zijn ontworpen om grote hoeveelheden data te verwerken in een cluster van computers. Hierdoor kun je je applicatie horizontaal schalen om enorme datasets aan te kunnen door resources dynamisch toe te wijzen en terug te geven over meerdere nodes met lage latentie. Beide frameworks kunnen zowel batch- als streamingverwerking aan.
Zowel Spark als Flink bieden high-level API’s en abstracties in meerdere talen, waaronder Scala, Python en Java, waarmee je pijplijnen in je voorkeurstaal kunt schrijven en draaien. Deze API’s maken de frameworks gebruiksvriendelijk bij het ontwikkelen van dataverwerkingstoepassingen. Bovendien bevat Flink bibliotheken voor machine learning (FlinkML), complex event processing (FlinkCEP) en grafverwerking (Gelly). Spark biedt ook bibliotheken voor machine learning (MLlib), grafverwerking (GraphX) en realtime dataverwerking (GraphX).
Zowel Apache Spark als Apache Flink zijn geïntegreerd met een uitgebreid ecosysteem van bigdatatools, waaronder Hadoop Distributed File System, Apache Kafka en cloudopslagsystemen zoals Amazon S3.
Beide frameworks hebben implementaties voor prestatieoptimalisatie die de efficiëntie van dataverwerking maximaliseren. Dit stelt je in staat complexe taken uit te voeren door gebruik te maken van parallelle uitvoering, taakplanning en queryoptimalisatie in Spark en Flink. Spark gebruikt de Catalyst-optimizer, terwijl Flink een kostengedreven optimizer voor batchverwerking heeft.
Apache Spark en Apache Flink vertonen veel overeenkomsten als je kijkt naar hun basismogelijkheden en benaderingen van dataverwerking. Toch verschillen ze aanzienlijk in hun sterke punten en focus van hun verwerkingsmodellen, de volwassenheid van hun ecosystemen en taalondersteuning, en hun benadering van optimalisatie en state management.
Apache Flink richt zich vooral op realtime dataverwerking. Dit framework is gebouwd op een streaming-runtime en kan ook batchverwerking aan. Apache Spark daarentegen is oorspronkelijk ontworpen voor batchverwerking, waardoor het geschikter is voor terugblikkende analyse van grote datasets. Door een microbatch-benadering te implementeren kan Spark ook streamingdata verwerken, maar met hogere latenties dan Flink.
Zoals genoemd bieden beide frameworks API’s in meerdere programmeertalen. De ondersteuning voor Python in Flink is echter minder volwassen, wat een beperking kan zijn als je met een data-science-gericht team werkt.
Hoewel beide frameworks goed integreren met bigdatatools, heeft Apache Spark een groter en volwassener ecosysteem, met een breed scala aan connectors, bibliotheken en tools. Apache Flink breidt het aanbod aan tools en extensies uit, maar kan nog steeds als minder volwassen worden beschouwd.
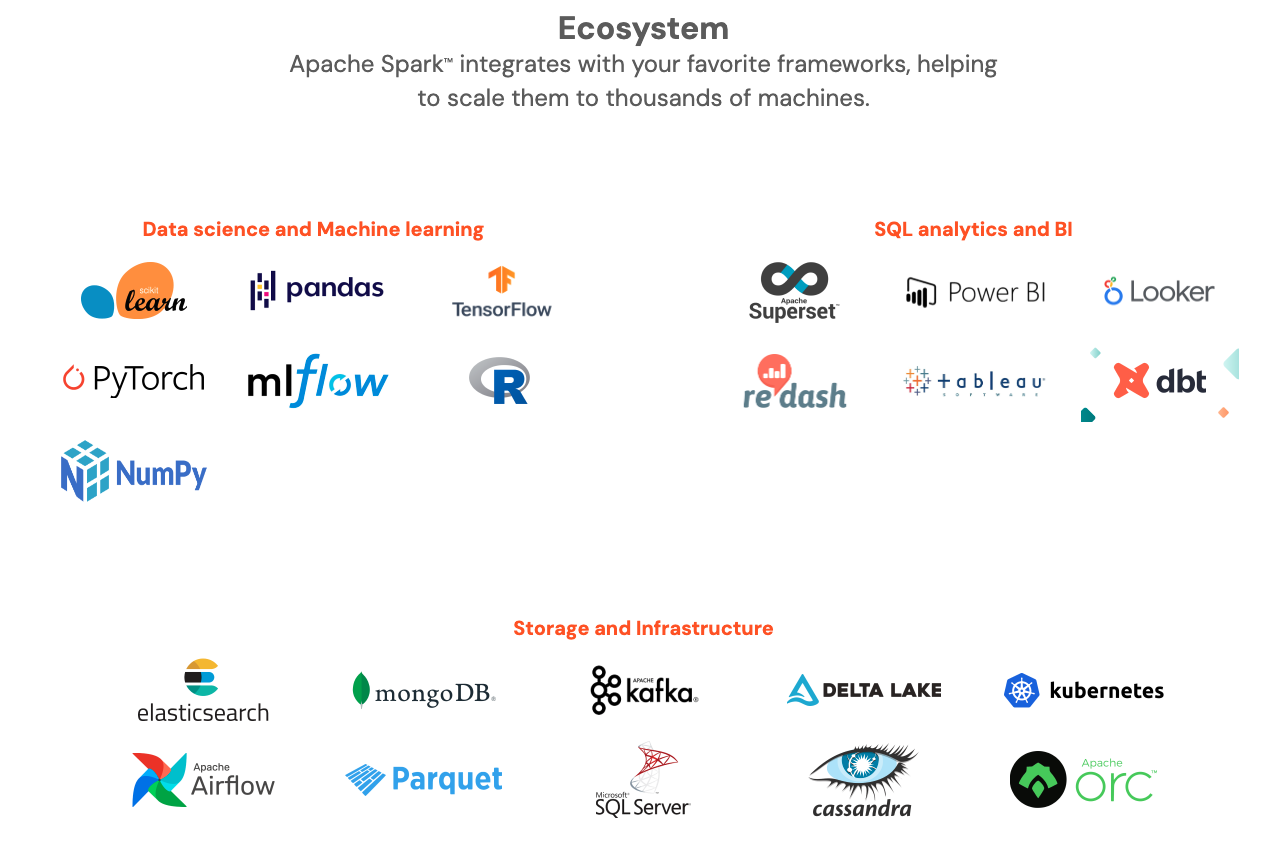
Apache Spark-ecosysteem. Bron
Apache Flink laat je werken met geavanceerder en flexibeler toestandsbeheer, wat een voordeel is als je pijplijnen bouwt die de status in realtime moeten bijhouden en bijwerken, zoals event-time- en processing-time-vensters of vensters voor complexe eventpatronen. Spark ondersteunt basisfunctionaliteit voor windowing die goed werkt bij batch- en microbatchverwerking.
Apache Flink en Apache Spark tonen veel overeenkomsten, maar verschillen ook wezenlijk in hun verwerkingsaanpak en de daarbij horende latentie, prestaties en state management. Daarnaast verschillen ze iets in ecosysteemvolwassenheid en taalondersteuning. Welke je kiest, hangt vooral af van de specifieke eisen van je project. Toch zijn er kenmerken waarin Spark of Flink uitblinkt ten opzichte van de ander:
Spark is oorspronkelijk ontworpen voor batchverwerking, maar ondersteunt nu ook streamingdata via de Spark Streaming-module. Flink is daarentegen specifiek ontwikkeld voor streamingdata, maar ondersteunt inmiddels ook batchverwerking.
Spark gebruikt Resilient Distributed Datasets en datapartitionering om parallelle verwerking te versnellen en het resourcegebruik te optimaliseren. Flink maakt gebruik van operator chaining en pipeline-executie, wat de efficiëntie van parallelle verwerking en resourcemanagement vergroot. Over het algemeen wordt Flink als sneller beschouwd en biedt het betere prestaties bij realtime toepassingen.
Spark biedt basisfuncties voor windowing die vooral geschikt zijn voor tijdgebaseerde implementaties, passend binnen vaste of schuivende tijdvensters voor zowel batch- als streamingverwerking. Flink heeft geavanceerdere mogelijkheden, waaronder vensters op basis van event-time en processing-time, sessievensters en aangepaste windowfuncties. De windowingmogelijkheden van Flink zijn beduidend veelzijdiger en efficiënter, waardoor het de voorkeur heeft bij complexe eisen.
Spark gebruikt de Catalyst-optimizer, die uitblinkt in het optimaliseren van datatransformaties en -queries, en integreert de Tungsten-executionengine om de prestaties te verbeteren. Flink heeft een kostengedreven optimizer die specifiek is ontworpen voor batchverwerkingstaken, die beschikbare resources en data-eigenschappen evalueert om de meest efficiënte aanpak te kiezen. Daarnaast verbeteren pipeline-gebaseerde uitvoering en low-latency scheduling in Flink de verwerkingssnelheid aanzienlijk. De keuze tussen Spark en Flink voor optimalisatie hangt af van de use-case, omdat beide duidelijke voordelen bieden.
Spark bereikt fouttolerantie via Resilient Distributed Datasets (RDD’s), onveranderlijke gepartitioneerde datastructuren die snelle reconstructie bij storingen mogelijk maken. Flink gebruikt daarentegen een gedistribueerde snapshotaanpak, waarbij de status van de applicatie op specifieke checkpoints wordt vastgelegd. Dit maakt snel herstel mogelijk met minimale prestatie-impact. Hoewel beide frameworks effectieve fouttolerantie bieden, resulteert Flinks methode doorgaans in snellere hersteltijden en minder verstoring van lopende processen, wat het de voorkeur geeft in scenario’s waar minimale downtime cruciaal is.
Spark ondersteunt meerdere programmeertalen, waaronder Scala, Java, Python en R, en is daardoor aantrekkelijk voor zowel ontwikkelaars als data scientists dankzij de uitgebreide samenwerkingsmogelijkheden en een compleet API-aanbod. Flink ondersteunt Java, Scala en Python met intuïtieve en gebruiksvriendelijke API’s, maar de Python-mogelijkheden zijn beperkter, wat de adoptie in data-scienceteams kan hinderen. Sparks superieure Python-ondersteuning maakt het aantrekkelijker voor datagerichte teams waar Python dominant is.
Spark heeft een compleet en volwassen ecosysteem en integreert naadloos met een breed scala aan bigdatatools zoals Hadoop, Hive en Pig. Deze uitgebreide compatibiliteit maakt Spark tot een sterke keuze voor complexe dataomgevingen met diverse toolsets. Flink heeft een beperktere reeks integraties met andere bigdatatools, al blinkt het uit in de integratie met Apache Kafka. Door de meer complete en volwassen integraties biedt Spark over het algemeen een sterker ecosysteem.
Hieronder vind je een tabel met de belangrijkste verschillen tussen Spark en Flink:
| Categorieën | Spark | Flink | Winnaar |
|---|---|---|---|
| Dataverwerking | Batch-georiënteerd model | Realtime-georiënteerd model | Afhankelijk |
| Prestaties | RDD’s en datapartitionering | Operator chaining en pipeline-executie | Flink |
| Windowing | Tijdgebaseerde functionaliteiten | Event-time, sessie en aangepaste functies | Flink |
| Optimalisatie | Catalyst-optimizer | Kostengedreven optimizer | Afhankelijk |
| Fouttolerantie | Gerealiseerd met RDD’s | Gedistribueerde snapshots | Flink |
| Taal- en API-ondersteuning | Uitgebreide ondersteuning | Meerdere talen, Python minder geavanceerd | Spark |
| Ecosysteem | Volledige integratie met bigdatatools | Integratie met enkele tools, blinkt uit met Kafka | Spark |
De keuze voor het meest geschikte dataverwerkingsframework kan de prestaties van je datapijplijn verbeteren. Van alle frameworks springen Apache Spark en Apache Flink eruit als twee krachtige en veelzijdige tools, elk met hun eigen sterke punten en capaciteiten.
Spark is uitstekend geschikt voor batchverwerking en biedt een scala aan tools, API’s en volledige integratie met andere bigdatatechnologieën. Als je wilt leren hoe je Spark vanuit Python gebruikt, bekijk dan onze cursus Introduction to PySpark en onze tutorial Getting Started with Pyspark. Flink blinkt uit in realtime en streamingdataverwerking dankzij efficiënt state management, windowingfunctionaliteiten en prestaties met lage latentie.
Uiteindelijk hangt de keuze tussen deze twee frameworks af van de specifieke eisen en behoeften van je project. Om deze tools goed te begrijpen, kun je het beste verder lezen en oefenen met de volgende bronnen.
Leren met DataCamp
Leerpad
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

