Cursus
Inzicht in Machine Learning
2 uur
311.9K
Deze blogpost introduceert het concept ‘transfer learning’ en hoe het wordt gebruikt in machinelearningtoepassingen. Transfer learning is geen machinelearningmodel of -techniek; het is eerder een ‘ontwerpbenadering’ binnen machine learning. Een andere ‘ontwerpbenadering’ is bijvoorbeeld active learning.
In een volgende blogpost lees je hoe je active learning in combinatie met transfer learning kunt inzetten om bestaande (en nieuwe) data optimaal te benutten. In brede zin geldt: machinelearning-toepassingen die externe informatie gebruiken om prestaties of generalisatievermogen te verbeteren, maken gebruik van transfer learning.
Het idee achter transfer learning is dat je kennis die is geleerd op taken waarvoor veel gelabelde data beschikbaar is, gebruikt in situaties waarin slechts weinig gelabelde data beschikbaar is. Gelabelde data maken is duur, dus bestaande datasets optimaal benutten is cruciaal.
In een traditioneel machinelearningmodel is het primaire doel te generaliseren naar onzichtbare data op basis van patronen die in de trainingsdata zijn geleerd. Met transfer learning probeer je dat generalisatieproces een vliegende start te geven door te beginnen met patronen die voor een andere taak zijn geleerd. In wezen start je het leerproces niet vanaf een (vaak willekeurig geïnitialiseerd) leeg vel, maar vanaf patronen die zijn geleerd om een andere taak op te lossen.
Overdracht van kennis en patronen is mogelijk in uiteenlopende domeinen. In deze post illustreren we transfer learning aan de hand van verschillende voorbeelden uit die domeinen. Het doel is om data scientists te stimuleren te experimenteren met transfer learning in hun machinelearningprojecten en hen bewust te maken van de voor- en nadelen.
Er zijn drie redenen waarom ik vind dat een goed begrip van transfer learning een cruciale vaardigheid is voor een data scientist:
 |
 |
Transfer learning vereist, zoals de naam al aangeeft, de mogelijkheid om kennis van het ene domein naar het andere over te dragen. Je kunt transfer learning op hoog niveau interpreteren: NLP-modelarchitecturen kun je hergebruiken voor sequentievoorspellingsproblemen, omdat veel NLP-problemen in wezen tot die categorie te herleiden zijn. Je kunt transfer learning ook op laag niveau interpreteren, waarbij je daadwerkelijk parameters uit het ene model in een ander model hergebruikt (skip-gram, continuous bag-of-words, enz.). De voorwaarden voor transfer learning zijn enerzijds probleemspecifiek en anderzijds modelspecifiek. De volgende twee secties bespreken respectievelijk een hoog- en laagniveaubenadering van transfer learning. Hoewel je deze concepten in de literatuur vaak onder andere namen tegenkomt, blijft het overkoepelende concept van transfer learning aanwezig.
Bij multi-task learning train je een model gelijktijdig op verschillende taken. Meestal worden deep-learningmodellen gebruikt omdat die zich flexibel laten aanpassen.
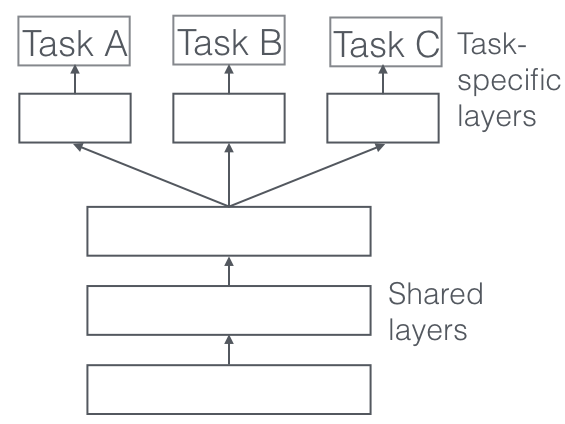
De netwerkarchitectuur wordt zo aangepast dat de eerste lagen over verschillende taken worden gedeeld, gevolgd door verschillende taakspecifieke lagen en uitgangen per taak. Het idee is dat een netwerk beter generaliseert als het op verschillende taken wordt getraind waarvoor vergelijkbare ‘kennis’ of ‘verwerking’ nodig is.
Een voorbeeld in NLP is een model waarvan het einddoel entiteitsherkenning is. In plaats van het model uitsluitend op entiteitsherkenning te trainen, laat je het ook part-of-speech-classificatie en volgende-woord-voorspelling doen, ... Zo profiteert het model van de structuur die uit die taken en datasets wordt geleerd. Ik raad deze blog van Sebastian Ruder en deze blog sterk aan, die beide multi-task learning behandelen.
Een groot voordeel van een deep-learningmodel is dat feature-extractie ‘automatisch’ is. Op basis van gelabelde data en backpropagation bepaalt het netwerk welke features nuttig zijn voor een taak. Het netwerk ‘bedenkt’ welk deel van de input belangrijk is om bijvoorbeeld een afbeelding te classificeren. Daardoor wordt het handmatig definiëren van features geabstraheerd. Deep-learningnetwerken kun je hergebruiken voor andere problemen, omdat de soorten features die ze extraheren vaak ook voor andere problemen nuttig zijn. In een featuriser gebruik je in feite de eerste lagen van het netwerk om de nuttige feature te bepalen, maar je gebruikt de uiteindelijke output van het netwerk niet, omdat die te taakspecifiek is.
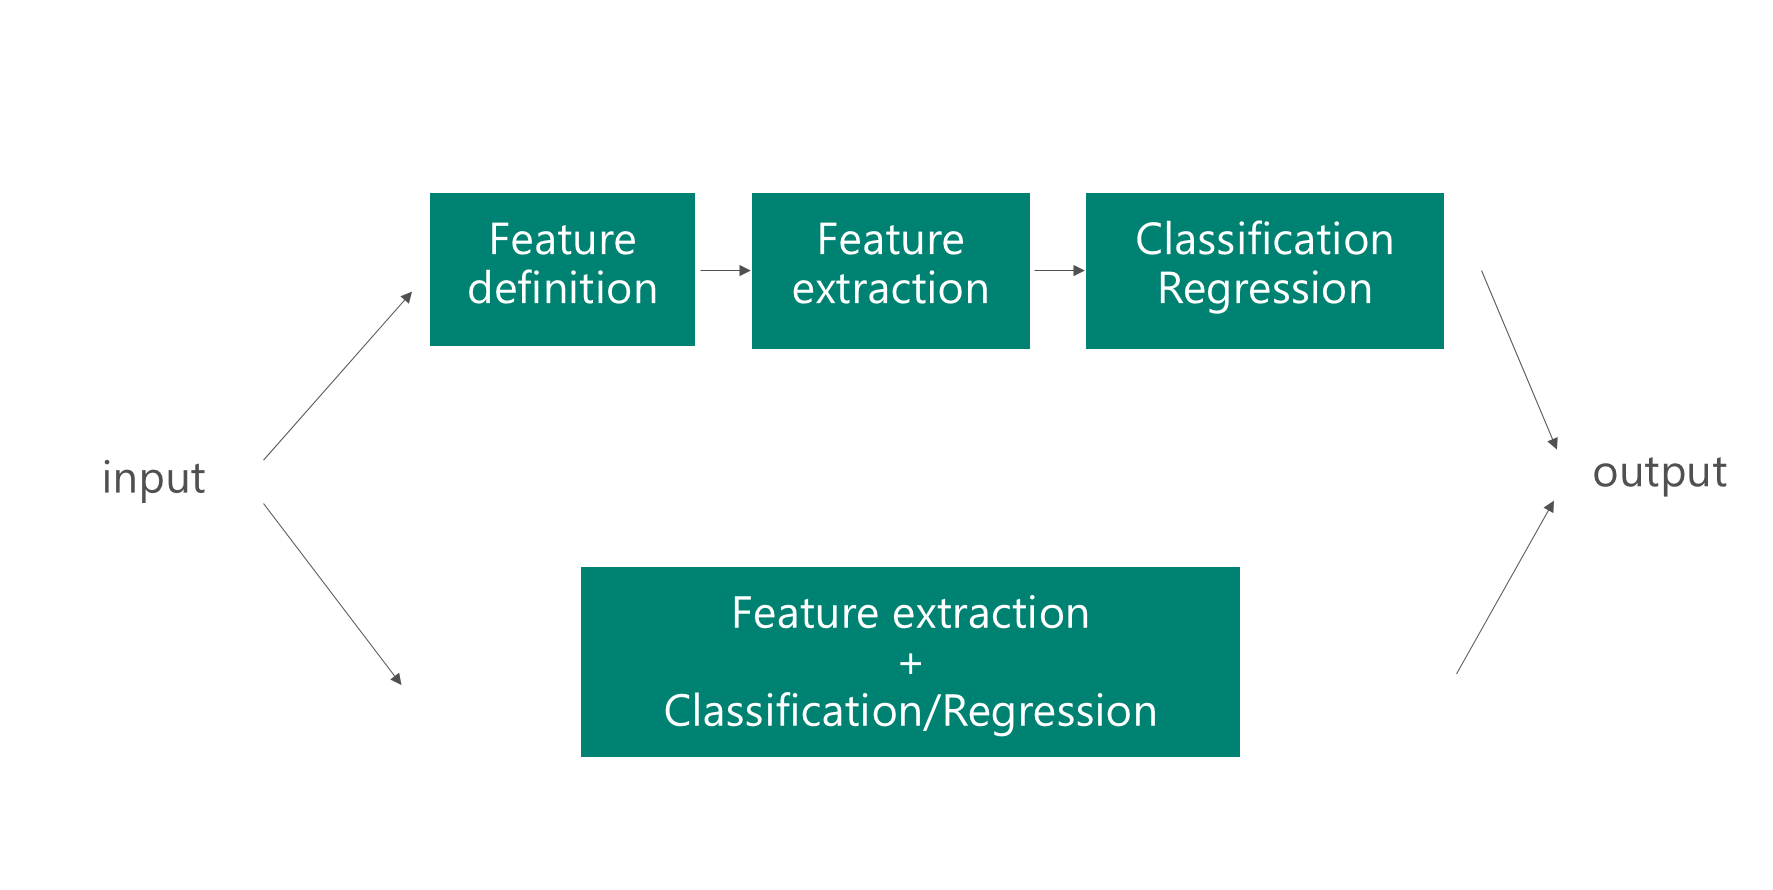
Gezien deep-learningsystemen goed zijn in feature-extractie, hoe kun je bestaande netwerken hergebruiken om feature-extractie voor andere taken te doen? Je kunt een datasample door het netwerk voeren en een van de tussenlagen als output nemen. Zo’n tussenlaag kun je interpreteren als een vaste, bewerkte representatie van ruwe data. Het concept van een featuriser wordt vaak gebruikt in de context van computervisie. Afbeeldingen worden dan door een voorgetraind netwerk gehaald (bijvoorbeeld VGG of AlexNet) en een andere ML-methode wordt gebruikt op de nieuwe datarepresentatie. Een tussenlaag extraheren als representatie van de afbeelding vermindert de oorspronkelijke datasize aanzienlijk, waardoor traditionele ML-technieken beter toepasbaar worden (bijvoorbeeld logistieke regressie of SVM’s werken beter met een kleine representatie, zoals dimensie 128, vergeleken met de oorspronkelijke, bijvoorbeeld 128x128=16384 dimensies).
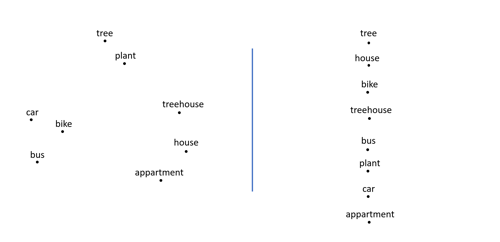
Een van mijn eerdere blogposts besprak hoe veel NLP-pijplijnen tegenwoordig word embeddings gebruiken. Deze embeddings zijn een informatievere manier om woorden te representeren dan one-hot-encodings. Ze worden veel gebruikt en er bestaan verschillende varianten. Die varianten verschillen doorgaans in het corpus waarop ze zijn getraind, zoals Wikipedia, nieuwsartikelen, enz., en in de embeddingmodellen. Het is belangrijk om de achtergrond van deze modellen en corpora te begrijpen om te weten of transfer learning met word embeddings zinvol is. Mensen zouden het gebruik van word embeddings doorgaans geen transfer learning noemen, maar ik ben het daar niet mee eens, gezien de gelijkenis met transfer learning in computervisie. In wezen betekent het gebruik van word embeddings dat je een featuriser of het embeddingnetwerk gebruikt om woorden naar vectoren om te zetten.
Hoewel word2vec al 4 jaar oud is, blijft het een zeer invloedrijke embedding-aanpak. Recente benaderingen zoals FastText hebben embeddings beschikbaar gemaakt in veel talen. Embeddings uit word2vec of FastText zijn een flinke stap vooruit vergeleken met bag-of-words-benaderingen. Toch wordt hun nut meestal bepaald door het probleemdomein.
Stel dat je een nieuwsaanbevelingsdienst bouwt voor sales. Salesmensen willen nieuws ontvangen over bedrijven die mogelijk geïnteresseerd zijn in het product dat ze verkopen. De woordenschat in nieuwsartikelen is doorgaans vrij algemeen, wat betekent dat die vaak wordt gedekt door de meeste embeddings (afhankelijk van het trainingscorpus). Bovendien heb je, als je de salesmensen de artikelen die ze lezen een paar weken laat verzamelen, meteen een grote gelabelde corpus in handen. Door word embeddings te hergebruiken, kan het zijn dat de aanbevelingsengine aanzienlijk beter presteert.
Stel daarentegen dat je topicclassificatie moet uitvoeren op juridische contracten. Niet zomaar juridische contracten, maar Franse contracten in de context van het mededingingsrecht. Zulke datasets zijn meestal niet gelabeld, of er zijn slechts beperkt gelabelde documenten beschikbaar. De volgende sectie beschrijft waarom transfer learning out of the box in dit geval maar beperkt werkt:
Ik raad je sterk aan deze uitstekende blogpost te lezen over de huidige stand van zaken rond word embeddings. Rekening houden met de problemen en oplossingen in die post is cruciaal om robuuste NLP-systemen en embeddings te bouwen met beperkte hoeveelheden data.
Gensim, spaCy en FastText zijn drie uitstekende frameworks waarmee je snel word embeddings in je ML-toepassing kunt gebruiken. Bovendien ondersteunen ze het trainen van eigen embeddings. Bekijk deze gensim-, deze spaCy- of deze FastText-tutorial om meer te leren!
Deep-learningmethoden hebben tot grote successen in computervisie geleid. In plaats van handmatig probleemspecifieke features te definiëren, zoals Histogram of Oriented Gradients (HoG) of histogramfeatures, kun je met deep learning modellen trainen die ruwe afbeeldingen als input nemen. De oorspronkelijke complexiteit van featuredefinitie is verschoven naar de complexiteit van het definiëren van de netwerkarchitectuur. Hoewel architecturen vaak worden hergebruikt, is er geen enkele standaardstrategie voor het samenstellen van architecturen. Deep-learningtechnieken zijn doorgaans ontwikkeld en toegepast in onderzoekssettings op enorme datasets (zoals ImageNet of MS COCO). Om de prestaties op zulke grote datasets te verhogen, zijn steeds diepere en complexere architecturen bedacht. Die resulteren in modellen met miljoenen parameters die (meestal) niet schaalbaar zijn naar kleine afbeeldingsdatasets. Een architectuur zoals ResNet of VGG trainen op een dataset met minder dan 5.000 afbeeldingen leidt simpelweg tot aanzienlijk overfitten. De recente deep-learningtrend heeft veel vooruitgang gebracht, maar data scientists met kleine datasets leken in de kou te blijven staan.
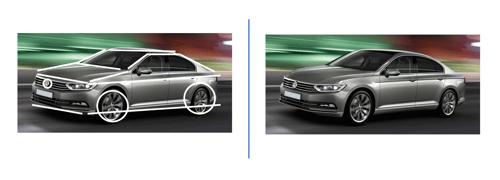
Deep-learningnetwerken leren hiërarchische featurerepresentaties (zie deze blogpost van Distill). Dit betekent dat de lagere lagen lage-niveaufuncties leren, zoals randen, terwijl hogere lagen hogere, maar minder interpreteerbare concepten leren, zoals vormen. Dat idee van hiërarchische representaties treedt ook op wanneer het netwerk op verschillende datasets wordt getraind, wat erop wijst dat ze in verschillende domeinen herbruikbaar zijn.
Er worden twee benaderingen gebruikt bij transfer learning voor computervisie.
De API van Keras laat je voorgetrainde netwerken laden en meerdere lagen tijdens het trainen vastzetten. In de volgende sectie bespreek ik opnieuw twee use-cases: één waarin transfer learning nuttig is, en één waarin dat niet zo is.
Stel dat je in natuurbehoud werkt en de verschillende dieren wilt classificeren die in een livecamerafeed verschijnen. Zeker als je soorten probeert te monitoren die met uitsterven worden bedreigd, is het mogelijk dat je niet veel gelabelde data kunt verzamelen. Aangezien voorgetrainde netwerken vaak zijn getraind op een breed domein aan concepten (variërend van voedsel tot dieren en objecten), is het gebruiken van zo’n netwerk als featuriser of als initialisator zeker een optie.
Stel daarentegen dat je radiografische afbeeldingen voor oncologen moet analyseren. Dit zijn niet de typische kat-hond-plaatjes: het zijn outputs van scans die bij patiënten zijn uitgevoerd. Deze beelden, hoewel naar RGB geconverteerd, zijn meestal in grijsschakeringen om de scanresultaten te tonen. Hoewel een voorgetraind netwerk vormen en randen in RGB-afbeeldingen kan detecteren, zal het daar waarschijnlijk moeite mee hebben in radiografische beelden, omdat die niet in de trainingsdata van het voorgetrainde model voorkomen. Bovendien is de hoeveelheid gelabelde data in medische scenario’s meestal laag. Er bestaan verschillende technieken om (mogelijk overvloedige) ongelabelde data te benutten, maar die vergen doorgaans meer werk en fine-tuning. Meestal proberen deze technieken de gewichten van het classificatienetwerk voor te trainen door elke laag iteratief te trainen om de afbeeldingen te reconstrueren (met convolutionele en deconvolutionele lagen). Een combinatie van deze technieken en een voorgetraind netwerk wordt vaak gebruikt om de convergentie te verbeteren.
Beide bovengenoemde methoden in computervisie steunen op een belangrijke aanname: patronen die in de oorspronkelijke dataset zijn geëxtraheerd, zijn bruikbaar in de context van de nieuwe dataset. Die bruikbaarheid is lastig te kwantificeren, maar het is een belangrijke aanname om rekening mee te houden. Seismische, hyperspectrale of zelfs medische beeldvorming vertonen beperkte gelijkenis met de afbeeldingen in ImageNet. Bepalen welk verkeersbord op een afbeelding staat, steunt daarentegen op vrij vergelijkbare patronen. Het probleemdomein begrijpen is cruciaal voor succesvolle computervisie. Door de achtergrond te kennen van de modellen (datasets, technieken, enz.) die in transfer learning worden gebruikt, voorkom je tijdverlies tijdens het experimenteren en kun je je richten op het finetunen van modellen die het verschil kunnen maken.
Machine learning-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

