Ga naar hoofdinhoud
Data-engineering

Wat zijn datacontracten? Een beginnersgids met voorbeelden

Schaalbaarheid bereiken in gedistribueerde datasystemen en fouten verminderen.
Mike Shakhomirov's photo
Mike Shakhomirov
Bijgewerkt · 11 min lezen

Verken met AI

ChatGPTClaudePerplexity

Maak je gratis account aan

Oefen en volg je voortgang.

Ga Verder Met Google
Door verder te gaan accepteer je onze Gebruiksvoorwaarden, ons Privacybeleid en dat je gegevens worden opgeslagen in de VS.

Datacontracten vormen de ruggengraat van datakwaliteit en schaalbaarheid voor gedistribueerde data-oplossingen. Ze specificeren het formaat, schema en de protocollen die de uitwisseling tussen database-entiteiten regelen. Deze formele afspraken elimineren onduidelijkheden en niet-gedocumenteerde aannames over de data.

In dit artikel verduidelijk ik het concept van datacontracten door zowel fundamentele als geavanceerde technieken aan te reiken voor een effectieve implementatie.

Datacontracten begrijpen

Eén datacontract geeft de precieze parameters aan voor data-uitwisseling tussen twee modellen. Deze formele afspraken zorgen ervoor dat er geen onduidelijkheid is over dataformaten en schema’s.

Definities en validatie van datacontracten zijn cruciaal voor effectieve samenwerking tussen teams.

Kort gezegd is een datacontract een formele overeenkomst tussen het proces dat de oorspronkelijke staat van onze data wijzigt (producers) en bestemmingen (consumers). Het lijkt sterk op hoe zakelijke contracten werken. Ze vertegenwoordigen verplichtingen tussen leveranciers en afnemers van een bedrijfsproduct. Datacontracten doen hetzelfde met dataprodukten, zoals tabellen, views, datamodellen, enz.

Het doel is om verstoringen stroomafwaarts in datapijplijnen te beperken en datatransformaties stabiel en betrouwbaar te maken.

De hoofdcomponenten van een datacontract zijn schema (kolommen en formaten), het onderdeel semantische laag (metingen, berekeningen en beperkingen), service level agreements (SLA’s) en datagovernance.

De voordelen van datacontracten zijn onder meer:
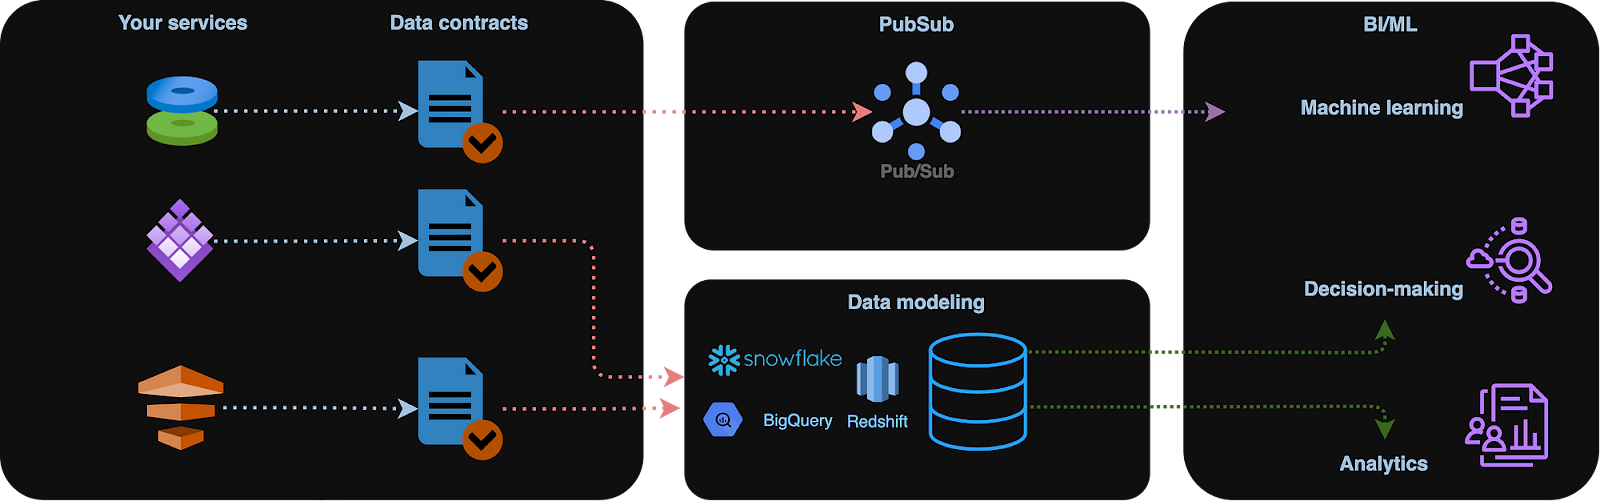
  • Automatisering van datakwaliteit en checks wanneer nieuwe data-uitvoer wordt gecreëerd of bijgewerkt.
  • Efficiënt schalen mogelijk maken, vooral voor gedistribueerde data-architectuur, bijvoorbeeld data mesh.
  • De datadevelopment-levenscyclus verbeteren met focus op tools voor contractvalidatie.
  • Samenwerking stimuleren via feedback tussen dataproducers en -consumers.

Afbeelding die uitlegt hoe datacontracten werken.

Datacontracten. Afbeelding door de auteur.

Voorbeeld van een datacontract met dbt

In een datacontract definiëren schema’s attribuutnamen, datatypen en of attributen verplicht zijn. Ze kunnen ook het formaat, de lengte en toelaatbare waardebereiken voor kolommen specificeren.

Laten we een dbt-modelschema bekijken dat als volgt is gedefinieerd in een YAML-bestand. Ons tabelschema staat onder columns gedefinieerd:

models:
 - name: dim_orders
   config:
     materialized: table
     contract:
       enforced: true
   columns:
     - name: order_id
       data_type: int
       constraints:
         - type: not_null
     - name: order_type
       data_type: string

Stel nu dat we ons dim_orders-model als volgt definiëren:

select
 'abc123' as order_id,
 'Some order type' as order_type

Met een contract als enforced: true in onze modeldefinitie wordt de volgende fout getriggerd als we proberen dim_orders te materialiseren tot een tabel in ons dataplatfom:

20:53:45  Compilation Error in model dim_customers (models/dim_orders.sql)
20:53:45    This model has an enforced contract that failed.
20:53:45    Please ensure the name, data_type, and number of columns in your contract match the columns in your model's definition.
20:53:45
20:53:45    | column_name | definition_type | contract_type | mismatch_reason    |
20:53:45    | ----------- | --------------- | ------------- | ------------------ |
20:53:45    | order_id    | TEXT            | INT           | data type mismatch |
20:53:45
20:53:45
20:53:45    > in macro assert_columns_equivalent (macros/materializations/models/table/columns_spec_ddl.sql)

Hetzelfde zou zijn gebeurd met extra kolommen, SLA-checks en ontbrekende metadata, als we ervoor hadden gekozen die te definiëren.

Een geavanceerder dbt-voorbeeld zou afgedwongen modelconstraints bevatten:

# models/schema.yaml
models:
 - name: orders
  
   # required
   config:
     contract:
       enforced: true
  
   # model-level constraints
   constraints:
     - type: primary_key
       columns: [id]
     - type: FOREIGN_KEY # multi_column
       columns: [order_type, SECOND_COLUMN, ...]
       expression: "OTHER_MODEL_SCHEMA.OTHER_MODEL_NAME (OTHER_MODEL_FIRST_COLUMN, OTHER_MODEL_SECOND_COLUMN, ...)"
     - type: check
       columns: [FIRST_COLUMN, SECOND_COLUMN, ...]
       expression: "FIRST_COLUMN != SECOND_COLUMN"
       name: HUMAN_FRIENDLY_NAME
     - type: ...
  
   columns:
     - name: FIRST_COLUMN
       data_type: DATA_TYPE
      
       # column-level constraints
       constraints:
         - type: not_null
         - type: unique
         - type: foreign_key
           expression: OTHER_MODEL_SCHEMA.OTHER_MODEL_NAME (OTHER_MODEL_COLUMN)
         - type: …

Een schemadefinitie bieden als een set regels en beperkingen die op de kolommen van een dataset worden toegepast, levert zeer belangrijke informatie op voor het verwerken en analyseren van data.

Schema’s veranderen vaak in de tijd.

Dit is een veelvoorkomend scenario. Stel dat onze brontabel een extra gecontracteerde kolom toevoegt:

select
 'abc123' as order_id,
 'Some order type' as order_type,
 'USD' as currency

Het is essentieel om schemaveranderingen te overwegen bij incrementele updates, omdat anders de output van het stroomafwaartse incrementele model het contract zou ongeldig maken. 

Dit kun je oplossen door on_schema_change: append toe te voegen aan de dbt-incrementele strategie.

Schemavalidaties kunnen expliciet of impliciet zijn.

Sommige big data-bestandsformaten, zoals AVRO en Parquet, ondersteunen standaard onboard schema en impliciete schemadefinities, waardoor extra externe validatie niet nodig is.

Daarentegen vereisen schema-loze bestandsformaten zoals JSON externe schemavalidatie. Sommige Python-bibliotheken, zoals pydantic of een eenvoudige @dataclass, kunnen dit uitvoeren:

from pydantic import BaseModel
class ConnectionDataRecord(BaseModel):
   user: str
   ts: int
record = ConnectionDataRecord(user="user1", ts=123456789)

Als we de regels breken en waarden toekennen die niet aan onze criteria voldoen, wordt er een uitzondering opgegooid. Zo wordt er bijvoorbeeld een exception gegenereerd als we proberen ConnectionDataRecord('', 1) aan te roepen.

Semantische datacontracten

Semantische datavalidaties zorgen ervoor dat data logisch consistent is en aansluit op de bedrijfslogica.

Semantische validaties moeten expliciet worden afgedwongen.

In tegenstelling tot schemachecks zijn semantische datacontracten namelijk afhankelijk van bedrijfslogica en moeten ze extern worden geïmplementeerd.

Semantiek voelt in veel use-cases als een uitbreiding op schema-gevalideerde contracten. Vaak hangt het af van bedrijfsregels en vertegenwoordigt het een set rijcondities waaraan ons datamodel moet voldoen. 

Een voorbeeld van een semantisch contract kan het volgende zijn:

  • Metric-afwijking: ten opzichte van het voortschrijdend gemiddelde of een andere drempel. We kunnen bijvoorbeeld leven met het aantal actieve gebruikers van gisteren dat onder 75% van het 7-daags voortschrijdend gemiddelde zakt, maar 0% tolereren we niet.
  • Bedrijfslogica: Transactiemonitoring-alerts en fraudepreventiescores. In dit scenario moet de uitbetaling 0 zijn.
  • Data lineage: Dit beschrijft hoe data-entiteiten evolueren. Zo kan transaction_completed_at niet plaatsvinden vóór created_at.
  • Referentiële integriteit: Entiteitsrelaties zijn belangrijk en kunnen ook worden beschreven met semantische contracten. Bekijk de onderstaande dbt-code. Die legt uit dat elke refund_id van een refund terugverwijst naar een geldige transaction.id.
- name: refunds
   enabled: true
   description: An incremental table
 columns:
     - name: refund_id
       tests:
         - relationships:
             tags: ['relationship']
             to: ref('transactions')
             field: id

Het is aan de eindgebruiker om het alarmeringsniveau voor semantische contracten in te stellen, en dit wordt vaak geïmplementeerd met aangepaste datakwaliteitstests.

Verschillende bedrijfslogische regels verwijzen vaak naar dataintegriteit. Onlogische datasituaties kunnen ontstaan door fouten in database- en serverconfiguraties of door het per ongeluk injecteren van testdata in de productieomgeving. Dataintegriteitschecks zijn bedoeld om data te valideren aan de hand van die bedrijfsregels, zodat waarden die niet kloppen of onlogisch zijn, worden opgespoord.

Database-entiteiten houden altijd verband met elkaar. Dit heet een entiteitsrelatie en wordt vaak weergegeven met een entity relationship diagram (ERD). Onvoldoende referentiële integriteit kan leiden tot problemen zoals ontbrekende of onvolledige data. Datacontracten moeten deze potentiële valkuilen adresseren om dataintegriteit en nauwkeurigheid te waarborgen.

Een veelvoorkomende relatie is bijvoorbeeld een één-op-veel-associatie tussen customers en orders waarbij één klant meerdere orders kan hebben. In zo’n scenario is een order alleen geldig als die een geldige customer_id bevat binnen de customers-dataset.

Dit type beperking, een referential integrity constraint, zorgt ervoor dat de relatie tussen entiteiten correct wordt onderhouden.

Service Level Agreements (SLA’s) in datacontracten

SLA’s zijn een extra niveau van datakwaliteitschecks die je met datacontracten kunt implementeren.

SLA’s verwijzen naar datafreshness.

Omdat datamodellen regelmatig met nieuwe data worden bijgewerkt, kunnen SLA’s checks bevatten voor het laatste tijdstip waarop nieuwe data beschikbaar moet zijn of de maximaal toelaatbare vertraging. In dbt kun je dit bijvoorbeeld realiseren met freshness-tests:

- name: orders
   enabled: true
   description: A source table declaration
   tests:
     - dbt_utils.recency: # https://github.com/dbt-labs/dbt-utils#recency-source
         tags: ['freshness']
         datepart: day
         field: timestamp
         interval: 1

Stel dat we een rapport over de feiten van gisteren willen genereren; dan willen we zeker weten dat die data er is. Het zou immers vreemd zijn om een paar dagen of langer geen nieuwe orders te zien.

In het onderstaande voorbeeld kunnen we onze dataset testen op onverwachte ordervertragingen met de testconfig in dbt. Hiermee kun je de test selecteren en refereren met die specifieke naam.

version: 2
models:
 - name: orders
   columns:
     - name: status
       tests:
         - accepted_values:
             name: unexpected_order_status_today
             values: ['placed', 'shipped', 'completed', 'returned']
             config:
               where: "order_date = current_date"

Door een aangepaste naam te definiëren, heb je volledige controle over hoe de test wordt weergegeven in logberichten en metadata-artifacts.

Evenzo wordt in realtime datapijplijnen data doorgaans niet ouder verwacht te zijn dan enkele uren. SLA’s zijn cruciaal voor stream-processing-applicaties waarbij data realtime wordt verwerkt met minuten- of zelfs secondenlatentie.

In streaming-apps willen we de maximaal toelaatbare vertraging voor laat binnenkomende events controleren en metrics zoals Mean Time Between Failures (MTBF) en Mean Time to Recovery (MTTR). Dit implementeren houdt in dat incidenten zorgvuldig worden bijgehouden en relevante data wordt geëxtraheerd uit applicatiemonitoring- en incidentmanagementtools zoals PagerDuty, Datadog en Grafana.

Datagovernance-contracten

Het correct omgaan met Persoonlijk Identificeerbare Informatie (PII) is integraal onderdeel van het datatransformatieproces. Voor veel bedrijven is het cruciaal dat deze datasets minimaal GDPR-conform zijn en voldoen aan privacyregels zoals HIPAA of PCI DSS.

Datagovernance-contracten zorgen ervoor dat adequate pseudonimisering of datamasking-beleid aanwezig is. 

Bekijk de onderstaande dbt-code. Contracten die als tests worden afgedwongen, vereisen dat een user_email een SHA256-hash (gemaskeerd) is:

models:
 - name: customer_data
   columns:
       - name: user_email
         tests:
           - dbt_expectations.expect_column_values_to_not_match_regex:
               regex: "^(?!.*\b@\b).* # Ensure identifiers do not contain emails
               flags: i # Case-insensitive matching

Aan de andere kant willen we wellicht patroonmatching afdwingen voor andere tabellen. In het onderstaande voorbeeld moet het veld transaction_reference voldoen aan het patroon [“TRX-%”, “%-2023”]:

models:
 - name: transaction_data
   columns:
       - name: transaction_reference
         tests:
           - dbt_expectations.expect_column_values_to_match_like_pattern_list:
               like_pattern_list: ["TRX-%", "%-2023"]
               match_on: any

Datagovernance-contracten kunnen ook nuttig zijn wanneer ze kolommen met gevoelige data, metadata (data-eigenaren, enz.) en gebruikersrollen bevatten die gemachtigd zijn om toegang te krijgen tot een dataprodukt.

We kunnen bijvoorbeeld met het meta-veld in dbt aangeven wie de eigenaar van ons datamodel is en in welke fase van de modelontwikkelingslevenscyclus het zich bevindt:

# models/schema.yaml
version: 2
models:
 - name: users
   meta:
     owner: "@data_mike"
     model_maturity: in dev
     contains_pii: true
   columns:
     - name: email
       meta:
       contains_pii: true

Met het meta-veld kun je metadata instellen voor een resource, die vervolgens wordt opgenomen in het door dbt gegenereerde bestand manifest.json en kan worden bekeken in de automatisch gegenereerde documentatie. 

We kunnen pakketten zoals dbt-checkpoint gebruiken om dit tijdens de pull request te scannen en te verzekeren dat onze verplichte metavelden aanwezig zijn. De hook faalt als een model (uit een manifest of YAML-bestanden) de opgegeven metakeys niet heeft.

De meta-keys van het model moeten in het YAML-bestand of het manifest staan.

Implementatiepatronen voor datacontracten

Contractvalidatie kan worden uitgevoerd in streamingdatapijplijnen (per rij) vóórdat data wordt ingeladen en erna — aan de bron (bron-datamodellaag).

Als we data “as is” inladen, fungeert het validatieproces als een transformatieslag die contractregels afdwingt en ongeldige data wegfiltert, bijvoorbeeld naar een aparte databaseview of tabel waar de data verder onderzocht kan worden.

Validatiechecks kunnen achteraf worden toegepast wanneer data direct in een ruwe data lake wordt geladen.

Het primaire voordeel van realtime validatie van datacontracten is het vermogen om ongeldige records te filteren voordat ze hun eindbestemming bereiken — een data lake of een datawarehouse. Deze aanpak is gangbaar in eventgedreven of realtime dataverwerking, zoals Change Data Capture (CDC)-events. Bij dit type validatie worden bepaalde aspecten van het contract geverifieerd terwijl de data door de pijplijn stroomt.

Tools voor datacontracten

De datacommunity erkent geleidelijk de potentiële voordelen van datacontracten, een voortdurend evoluerend domein binnen data engineering. Er bestaan veel tools op dit gebied, sommige nog in een vroeg stadium. dbt kun je beschouwen als een universeel framework voor datacontracten.

Vergelijkbare contracten kunnen worden geïmplementeerd met Google’s Dataform aan de bron (bron-datamodellaag), dus wanneer de data succesvol in ons datawarehouse is geladen. Daarvoor willen we eenvoudige rijcondities gebruiken. 

Bekijk dit voorbeeld hieronder. Het past bepaalde rijcondities toe op onze tabel:

-- my_table.sqlx
config {
 type: "table",
 assertions: {
   nonNull: ["user_id", "customer_id", "email"]
 }
}
SELECT …

Hieronder staat nog een voorbeeld van het implementeren van datacontracten, wat je kunt bereiken met Soda.io, een gespecialiseerde datakwaliteitsframework:

# Checks for basic validations
checks for dim_customer:
 - row_count between 10 and 1000
 - missing_count(birth_date) = 0
 - invalid_percent(phone) < 1 %:
     valid format: phone number
 - invalid_count(number_cars_owned) = 0:
     valid min: 1
     valid max: 6
 - duplicate_count(phone) = 0

Door de alarminstellingen aan te passen, kun je een check configureren om een waarschuwing te geven in plaats van de validatie te laten falen. Een Soda-scan voert de in een overeenkomst gespecificeerde checks uit, controleert het YAML-bestand of inline binnen een programmatische aanroep, en geeft voor elke check een resultaat terug: pass, fail of error.

Uit mijn ervaring blijkt dat de introductie van datacontracten bij veel bedrijven gefragmenteerd blijft, afhankelijk van factoren zoals ontwerp-patronen van datapijplijnen (batch of realtime), keuzes voor dataserialisatie en de systemen die worden gebruikt voor opslag en verwerking.

De implementatie van datacontracten hangt af van bedrijfsvereisten en -logica.

Great Expectations, een Python-bibliotheek, kan worden gebruikt om semantische datacontracten te implementeren. Je kunt deze installeren met pip: pip install great_expectations. 

Na het uitvoeren van great_expectations init kunnen we doorgaan met datavalidatie:

Using v3 (Batch Request) API
 ___              _     ___                  _        _   _
/ __|_ _ ___ __ _| |_  | __|_ ___ __  ___ __| |_ __ _| |_(_)___ _ _  ___
| (_ | '_/ -_) _ |  _| | _|\ \ / '_ \/ -_) _|  _/ _ |  _| / _ \ ' \(_-<
\___|_| \___\__,_|\__| |___/_\_\ .__/\___\__|\__\__,_|\__|_\___/_||_/__/
                               |_|
            ~ Always know what to expect from your data ~
Let's create a new Data Context to hold your project configuration.
Great Expectations will create a new directory with the following structure:
   great_expectations
   |-- great_expectations.yml
   |-- expectations
   |-- checkpoints
   |-- plugins
   |-- .gitignore
   |-- uncommitted
       |-- config_variables.yml
       |-- data_docs
       |-- validations
OK to proceed? [Y/n]:

Bekijk het onderstaande codefragment. Dat legt uit hoe je een definitie van een datacheck maakt voor de kolom price:

"expectation_type": "expect_column_values_to_match_regex",
"kwargs": {
 "column": "price",
 "mostly": 1.0,
 "regex": "^\\$([0-9],)*[0-9]+\\.[0-9]{2}$"
},

Best practices voor datacontracten

Er is hier geen eenduidig goed of fout, want uit mijn ervaring blijkt dat een succesvolle implementatie van datacontracten sterk leunt op bedrijfsvereisten. Volg deze belangrijke best practices om datacontracten effectief te laten werken:

  • Schaalbaarheid: Ik raad aan mechanismen toe te voegen voor uitbreidbaarheid (bijv. on_schema_change: append) en versiebeheer, zodat je de voorwaarden van een datacontract kunt aanpassen zonder bestaande pijplijnintegraties te verstoren. Ontwerp datacontracten met oog voor toekomstige veranderingen en schaalbaarheid. Zo kan het contract meebewegen met veranderende behoeften en groei.
  • Duidelijke regels: Gebruik eenvoudige en bondige taal in het datacontract om misverstanden en verkeerde interpretaties te voorkomen. Het contract moet zo geschreven en benoemd zijn dat het toegankelijk en begrijpelijk is voor alle betrokken partijen, ongeacht hun technische expertise.
  • Samenwerking: Een gezamenlijke inspanning zorgt voor een volledige en evenwichtige kijk op de vereisten, waarbij verschillende perspectieven en behoeften worden meegenomen. Betrek bij het opstellen van datacontracten diverse stakeholders, waaronder dataproducers, data engineers, data scientists en vertegenwoordigers van business, IT, juridische en compliance-afdelingen.
  • Metadata: Voorzie datacontracten van grondige documentatie en metadata. Uitgebreide documentatie helpt bij de soepele toepassing en het onderhoud van het contract. Dit moet onder meer gedetailleerde beschrijvingen, velddefinities, validatieregels en andere relevante informatie bevatten die een helder begrip en effectieve implementatie ondersteunt.
  • Regelmatige reviews: Voortdurende evaluatie helpt de relevantie en effectiviteit van het contract in de tijd te behouden. Implementeer een gestructureerde aanpak voor monitoring en updates van datacontracten. Regelmatige reviews zorgen ervoor dat het contract actueel blijft, aansluit op veranderende bedrijfsbehoeften en voldoet aan nieuwe of gewijzigde regelgeving.

Conclusie

Onlangs is er een verschuiving richting gedistribueerd databezit, waarbij domeinteams verantwoordelijk zijn voor hun dataprodukten. Deze verandering dwong organisaties om verwachtingen rond datakwaliteit te herdefiniëren, vastgelegd in datacontracten.

Semantische datavalidaties zorgen ervoor dat data logisch consistent is en past bij de bedrijfslogica. Ze helpen datapijplijnen te controleren op uitschieters in data, waarden, lineage en referentiële integriteit. Onvoldoende referentiële integriteit kan leiden tot ontbrekende of onvolledige data, daarom is dit ook belangrijk. 

Datagovernance-contracten kunnen ook in CI/CD-pijplijnen worden geïmplementeerd en zijn zeer nuttig wanneer ze kolommen met gevoelige data, metadata (data-eigenaren, enz.) en gebruikersrollen aangeven die toegang hebben tot een dataprodukt. 

De metadata van een model, samen met andere verplichte metavelden die door de ontwikkelaar zijn gedefinieerd, helpt bij het monitoren van het resourcegebruik en de prestaties van het model. 

Service Level Agreements (SLA’s) binnen datacontracten beschrijven specifieke verplichtingen met betrekking tot datafreshness, volledigheid en herstel na storingen.

Datacontracten zijn essentieel voor moderne datamodelleringstechnieken en helpen ervoor te zorgen dat het dataplatfom minder foutgevoelig is en goed schaalt. Het oplossen van datakwaliteitsproblemen kan kostbaar zijn. Voor ondernemingen wordt het maximaliseren van de return on investment (ROI) uit data steeds belangrijker door gebruik te maken van bestaande datakwaliteitstools die validatie van datacontracten ondersteunen.

FAQs

Hoe verschillen datacontracten van datavalidatie en datatesten?

Datacontracten zijn formele afspraken die het formaat, schema en de uitwisselingsprotocollen van dataproducers en -consumers specificeren. Ze leggen duidelijke verwachtingen en verantwoordelijkheden vast voor datakwaliteit. Datavalidatie en -testen daarentegen zijn processen die controleren of de data aan deze verwachtingen voldoet. Validatie zorgt ervoor dat de data aan het gedefinieerde contract voldoet, terwijl testen de nauwkeurigheid en betrouwbaarheid van de data beoordeelt.

Kunnen datacontracten worden gebruikt in realtime streamingdatapijplijnen?

Ja, datacontracten kunnen worden geïmplementeerd in realtime streamingdatapijplijnen. Ze helpen ongeldige data te filteren voordat deze de bestemming bereikt, zodat alleen data die voldoet aan vooraf gedefinieerde regels en formaten wordt verwerkt. Deze aanpak is nuttig in eventgedreven of realtime verwerking, waar dataintegriteit en tijdigheid cruciaal zijn.

Hoe ga je om met versiebeheer in datacontracten wanneer schema’s vaak veranderen?

Versiebeheer in datacontracten houdt in dat je achterwaartse compatibiliteit behoudt en schema-evolutie bijhoudt. Een aanpak is om versieschema’s te gebruiken, waarbij elke contractversie is gekoppeld aan een specifieke schemaversie. Tools zoals on_schema_change: append in dbt kunnen helpen schemaveranderingen te beheren zonder bestaande integraties te verstoren, waardoor geleidelijke overgangen en updates mogelijk zijn.

Welke rol spelen datacontracten in een data mesh-architectuur?

In een data-mesh-architectuur is databezit verdeeld over domeinteams; datacontracten waarborgen consistente datakwaliteit en interoperabiliteit tussen domeinen. Ze formaliseren de verwachtingen tussen dataproducers en -consumers, helpen teams te aligneren op datastandaarden en verkleinen het risico op datakwaliteitsproblemen wanneer data tussen domeinen stroomt.

Hoe kunnen datacontracten helpen te voldoen aan privacyregels zoals GDPR of HIPAA?

Datacontracten kunnen datagovernance-beleid afdwingen, waaronder privacyregelgeving zoals GDPR of HIPAA. Ze kunnen regels definiëren voor datamasking, pseudonimisering en toegangscontroles, zodat gevoelige data op de juiste manier wordt behandeld. Door deze regels in het contract op te nemen, kunnen organisaties compliance-checks automatiseren en het risico op privacy-incidenten verkleinen.


Mike Shakhomirov's photo
Author
Mike Shakhomirov
LinkedIn

Gepassioneerd en digitaal georiënteerd, ik gedij op de uitdagingen van digitale marketing.

Voordat ik naar het VK verhuisde, heb ik meer dan tien jaar ervaring opgedaan in sales, risicobeheer bij corporate banking en digitale marketing. Daarbij ontwikkelde ik expertise in risicomanagement, wiskundige modellering, statistische analyse, bedrijfskunde en marketing.

Na het afronden van mijn MBA in Newcastle wil ik nu graag een carrière nastreven in data‑gedreven marketing, informatica of AI, met de mogelijkheid om door te stromen naar een PhD. Deze vakgebieden bieden de praktische toepassing van wetenschap, voortdurende professionele ontwikkeling, innovatie en de kans om bij te dragen aan een dynamische sector.

Onderwerpen
Data-engineering

Leer meer over data engineering met deze cursussen!

Cursus

Data Engineering begrijpen

2 uur
378.2K
Ontdek hoe data engineers de basis leggen die data science mogelijk maakt. Geen codering nodig!
Bekijk detailsStart Cursus

Maak je gratis account aan

Oefen en volg je voortgang.

Ga Verder Met Google
Door verder te gaan accepteer je onze Gebruiksvoorwaarden, ons Privacybeleid en dat je gegevens worden opgeslagen in de VS.
Meer bekijken
Gerelateerd

blog

AI vanaf nul leren in 2026: een complete gids van de experts

Ontdek alles wat je moet weten om in 2026 AI te leren, van tips om te beginnen tot handige resources en inzichten van industrie-experts.
Adel Nehme's photo

Adel Nehme

15 min

Meer bekijken

