Kurs
Veri sözleşmeleri, dağıtık veri çözümlerinde veri kalitesi ve ölçeklenebilirliğin bel kemiğidir. Veritabanı varlıkları arasındaki alışverişi yöneten biçim, şema ve protokolleri tanımlarlar. Bu resmi anlaşmalar, veriye ilişkin belirsizlikleri ve belgelendirilmemiş varsayımları ortadan kaldırır.
Bu yazıda, veri sözleşmelerinin kavramını netleştirmek için hem temel hem de ileri seviye teknikler sunarak bunların etkili şekilde uygulanmasını kolaylaştıracağım.
Veri Sözleşmelerini Anlamak
Tek bir veri sözleşmesi, iki model arasındaki veri alışverişine ilişkin kesin parametreleri belirler. Bu resmi anlaşmalar, veri biçimi ve şemalar konusunda hiçbir belirsizlik kalmamasını sağlar.
Veri sözleşmesi tanımları ve doğrulaması, ekipler arası etkili iş birliği için kritik öneme sahiptir.
Özetle, bir veri sözleşmesi, verinin orijinal durumunu değiştiren süreç (üreticiler) ile hedefler (tüketiciler) arasındaki resmi bir anlaşmadır. İş sözleşmelerinin işleyişine çok benzer. Nasıl ki iş ürününün tedarikçileri ve tüketicileri arasında yükümlülükleri temsil ediyorlarsa, veri sözleşmeleri de tablo, görünüm, veri modeli vb. veri ürünleri için aynı şeyi yapar.
Amaç, veri hattında aşağı akıştaki kesintileri azaltmak ve veri dönüşümlerini istikrarlı ve güvenilir kılmaktır.
Bir veri sözleşmesinin ana bileşenleri, şema (sütunlar ve biçimler), anlamsal katman bölümü (metrikler, hesaplamalar ve kısıtlar), hizmet düzeyi anlaşmaları (SLA’lar) ve veri yönetişimidir.
Veri sözleşmelerinin faydaları şunları içerir:
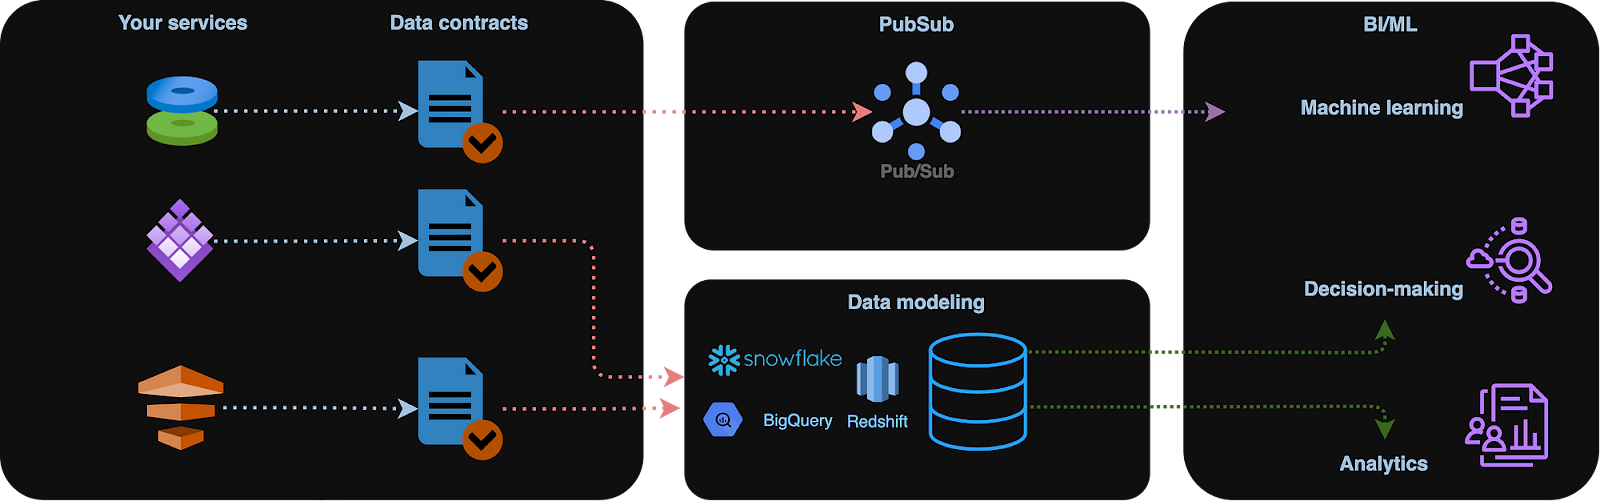
- Veri kalitesi otomasyonu ve yeni veri çıktıları oluşturulduğunda veya güncellendiğinde kontroller.
- Özellikle dağıtık veri mimarisi, ör. data mesh, için verimli ölçeklemeyi mümkün kılma.
- Sözleşme doğrulaması için araçlar geliştirmeye odaklanarak veri geliştirme yaşam döngüsünü iyileştirme.
- Veri üreticileri ve tüketicileri arasında geri bildirim yoluyla iş birliğini teşvik etme.

Veri sözleşmeleri. Görsel: yazar.
dbt ile veri sözleşmesi örneği
Bir veri sözleşmesinde şemalar, öznitelik adlarını, veri türlerini ve özniteliklerin zorunlu olup olmadığını tanımlar. Ayrıca sütunlar için biçim, uzunluk ve kabul edilebilir değer aralıklarını da belirtebilirler.
Bir dbt model şemasının bir YAML dosyasında aşağıdaki gibi tanımlandığını düşünelim. Tablo şemamız columns altında tanımlıdır:
models:
- name: dim_orders
config:
materialized: table
contract:
enforced: true
columns:
- name: order_id
data_type: int
constraints:
- type: not_null
- name: order_type
data_type: string
Şimdi dim_orders modelimizi şöyle tanımladığımızı hayal edelim:
select
'abc123' as order_id,
'Some order type' as order_type
Model tanımımızda contract için enforced: true ayarı olması, dim_orders’ı veri platformumuzda bir tabloya materyalize etmeye çalışırsak aşağıdaki hatayı tetikleyecektir:
20:53:45 Compilation Error in model dim_customers (models/dim_orders.sql)
20:53:45 This model has an enforced contract that failed.
20:53:45 Please ensure the name, data_type, and number of columns in your contract match the columns in your model's definition.
20:53:45
20:53:45 | column_name | definition_type | contract_type | mismatch_reason |
20:53:45 | ----------- | --------------- | ------------- | ------------------ |
20:53:45 | order_id | TEXT | INT | data type mismatch |
20:53:45
20:53:45
20:53:45 > in macro assert_columns_equivalent (macros/materializations/models/table/columns_spec_ddl.sql)
Aynı durum, tanımlamayı tercih etmiş olsaydık, fazladan sütunlar, SLA kontrolleri ve eksik meta veriler için de geçerli olurdu.
Daha gelişmiş bir dbt örneği, zorunlu model kısıtları içerir:
# models/schema.yaml
models:
- name: orders
# required
config:
contract:
enforced: true
# model-level constraints
constraints:
- type: primary_key
columns: [id]
- type: FOREIGN_KEY # multi_column
columns: [order_type, SECOND_COLUMN, ...]
expression: "OTHER_MODEL_SCHEMA.OTHER_MODEL_NAME (OTHER_MODEL_FIRST_COLUMN, OTHER_MODEL_SECOND_COLUMN, ...)"
- type: check
columns: [FIRST_COLUMN, SECOND_COLUMN, ...]
expression: "FIRST_COLUMN != SECOND_COLUMN"
name: HUMAN_FRIENDLY_NAME
- type: ...
columns:
- name: FIRST_COLUMN
data_type: DATA_TYPE
# column-level constraints
constraints:
- type: not_null
- type: unique
- type: foreign_key
expression: OTHER_MODEL_SCHEMA.OTHER_MODEL_NAME (OTHER_MODEL_COLUMN)
- type: …
Bir şema tanımını, bir veri kümesinin sütunlarına uygulanan bir dizi kural ve kısıt olarak sunmak, veriyi işlemek ve analiz etmek için çok önemli bilgiler sağlar.
Şemalar zaman içinde değişme eğilimindedir.
Bu yaygın bir senaryodur. Kaynak tablomuzun sözleşmeli fazladan bir sütun eklediğini hayal edelim:
select
'abc123' as order_id,
'Some order type' as order_type,
'USD' as currency
Artımlı güncellemeler gerçekleştirirken şema değişikliklerini dikkate almak çok önemlidir; aksi takdirde aşağı akıştaki artımlı modelin çıktısı sözleşmeyi geçersiz kılacaktır.
Bu, dbt artımlı stratejisine on_schema_change: append eklenerek çözülebilir.
Şema doğrulamaları açık veya örtük olabilir.
AVRO ve Parquet gibi bazı büyük veri dosya biçimleri, varsayılan olarak yerleşik şemayı ve örtük şema tanımlarını destekler; bu nedenle ilave harici doğrulamaya gerek yoktur.
Buna karşılık, JSON gibi şemasız veri dosya biçimleri harici şema doğrulaması gerektirir. pydantic veya basit bir @dataclass gibi bazı Python kütüphaneleri, bunu gerçekleştirebilir:
from pydantic import BaseModel
class ConnectionDataRecord(BaseModel):
user: str
ts: int
record = ConnectionDataRecord(user="user1", ts=123456789)
Kuralları ihlal eder ve ölçütlerimizle eşleşmeyen değerler atarsak bir istisna fırlatılır. Örneğin, ConnectionDataRecord('', 1) çağrısını yapmaya çalışırsak istisna oluşur.
Anlamsal Veri Sözleşmeleri
Anlamsal veri doğrulamaları, verinin mantıksal olarak tutarlı olmasını ve iş mantığıyla uyumlu kalmasını sağlar.
Anlamsal doğrulamalar açıkça zorunlu kılınmalıdır.
Gerçekten de şema kontrollerinin aksine, anlamsal veri sözleşmeleri iş mantığına dayanır ve harici olarak uygulanmalıdır.
Birçok kullanım senaryosunda anlambilim, şema ile doğrulanmış sözleşmelerin bir uzantısı gibi görünür. Çoğu zaman iş kurallarına bağlıdır ve veri modelimizin uyması gereken bir dizi satır koşulunu temsil eder.
Bir anlamsal sözleşme örneği şu şekilde olabilir:
- Metrik sapması: hareketli ortalamadan veya diğer eşiklerden. Örneğin, dünkü aktif kullanıcı sayısının 7 günlük hareketli ortalamanın %75’inin altına inmesi tolere edilebilirken %0 kabul edilemez.
- İş mantığı: İşlem izleme uyarı bayrakları ve sahtekarlık önleme puanları. Bu senaryoda ödeme 0 olmalıdır.
- Veri soy ağacı (lineage): Bu, veri varlıklarının nasıl evrildiğini açıklar. Örneğin,
transaction_completed_at,created_at’ten önce gerçekleşemez. - Bağlamsal bütünlük (referential integrity): Varlık ilişkileri önemlidir ve anlamsal sözleşmelerle de tanımlanabilir. Aşağıdaki dbt kodunu düşünün. Her iadenin
refund_id’sinin geçerli birtransaction.id’ye karşılık geldiğini açıklar.
- name: refunds
enabled: true
description: An incremental table
columns:
- name: refund_id
tests:
- relationships:
tags: ['relationship']
to: ref('transactions')
field: id
Uyarı düzeyini anlamsal sözleşmelerde ayarlamak son kullanıcıya bağlıdır ve bu çoğunlukla özel veri kalitesi testleriyle uygulanır.
Çeşitli iş mantığı kuralları sıklıkla veri bütünlüğüne atıfta bulunur. Mantıkdışı veri senaryoları, veritabanı ve sunucu yapılandırmalarındaki hatalardan veya test verilerinin üretim ortamına istemeden enjekte edilmesinden kaynaklanabilir. Veri bütünlüğü kontrolleri, veriyi bu iş kurallarına göre doğrulamak için tasarlanmıştır; doğru görünmeyen veya mantıksız olan değerlerin belirlenmesine yardımcı olur.
Veritabanı varlıkları her zaman birbirleriyle ilişkilidir. Buna varlık ilişkisi denir ve sıklıkla varlık ilişki diyagramı (ERD) ile gösterilir. Yetersiz bağlamsal bütünlük, eksik veya tamamlanmamış veri gibi sorunlara yol açabilir. Veri sözleşmeleri, veri bütünlüğü ve doğruluğunu sağlamak için bu potansiyel tuzakları ele almalıdır.
Örneğin yaygın bir ilişki, bir müşterinin birden fazla orders kaydına sahip olabildiği customers ve orders arasındaki bire-çok ilişkisidir. Bu tür bir senaryoda bir sipariş, yalnızca customers veri kümesi içinde geçerli bir customer_id içeriyorsa geçerli kabul edilir.
Bu tür bir kısıt, bir bağlamsal bütünlük kısıtı olup varlıklar arasındaki ilişkinin doğru şekilde korunmasını sağlar.
Veri Sözleşmelerinde Hizmet Düzeyi Anlaşmaları (SLA)
SLA’lar, veri sözleşmeleri kullanılarak uygulanabilen ek bir veri kalitesi kontrol katmanıdır.
SLA’lar veri tazeliğine atıfta bulunur.
Veri modelleri düzenli olarak yeni verilerle güncellendiğinden, SLA’lar yeni verinin en geç hangi zamanda hazır olması bekleneceğine veya azami kabul edilebilir gecikmeye ilişkin kontrolleri içerebilir. Örneğin dbt’de bu, freshness testleri ile sağlanabilir:
- name: orders
enabled: true
description: A source table declaration
tests:
- dbt_utils.recency: # https://github.com/dbt-labs/dbt-utils#recency-source
tags: ['freshness']
datepart: day
field: timestamp
interval: 1
Dünün verilerine ilişkin bir rapor üretmek istediğimizi varsayalım; bunu yapmak için verinin mevcut olduğundan emin olmak isteriz. Nitekim birkaç gün veya daha uzun süre yeni siparişler görmemek tuhaf olurdu.
Aşağıdaki örnekte, dbt’deki test yapılandırmasını kullanarak beklenmedik sipariş gecikmeleri için veri kümemizi test edebiliriz. Bu, testi belirli bir adla seçmenize ve referans vermenize olanak tanır.
version: 2
models:
- name: orders
columns:
- name: status
tests:
- accepted_values:
name: unexpected_order_status_today
values: ['placed', 'shipped', 'completed', 'returned']
config:
where: "order_date = current_date"
Özel bir ad tanımlayarak testin günlük mesajlarında ve meta veri çıktılarında nasıl görüneceği üzerinde tam kontrol elde edersiniz.
Benzer şekilde gerçek zamanlı veri hatlarında, verinin genellikle birkaç saatten daha eski olmaması beklenir. SLA’lar, verinin dakika veya hatta saniye düzeyinde gecikmeyle işlendiği akış işleme uygulamaları için hayati öneme sahiptir.
Akış uygulamalarında, geç gelen olaylar için azami kabul edilebilir gecikmeyi ve Arızalar Arası Ortalama Süre (MTBF) ile Ortalama Kurtarma Süresi (MTTR) gibi metrikleri kontrol etmek isteriz. Bunun uygulanması, olayların titizlikle izlenmesini ve PagerDuty, Datadog ve Grafana gibi uygulama izleme ve olay yönetimi araçlarından ilgili verilerin çıkarılmasını gerektirir.
Veri Yönetişimi Sözleşmeleri
Kişisel Olarak Tanımlanabilir Bilgilerin (PII) doğru şekilde ele alınması, veri dönüşüm sürecinin ayrılmaz bir parçasıdır. Birçok şirket için bu veri kümelerinin en azından GDPR uyumlu ve HIPAA veya PCI DSS gibi veri gizliliği düzenlemelerine uygun olması kritik önemdedir.
Veri yönetişimi sözleşmeleri, uygun psödönimleştirme veya veri maskeleme politikalarının yürürlükte olmasını sağlar.
Aşağıdaki dbt kodunu düşünün. tests olarak zorunlu kılınan sözleşmeler, user_email’in SHA256 karması (maskelenmiş) olmasını gerektirir:
models:
- name: customer_data
columns:
- name: user_email
tests:
- dbt_expectations.expect_column_values_to_not_match_regex:
regex: "^(?!.*\b@\b).* # Ensure identifiers do not contain emails
flags: i # Case-insensitive matching
Öte yandan, diğer tablolar için desen eşleşmesini zorunlu kılmak isteyebiliriz. Örneğin, aşağıdaki örnekte transaction_reference alanı [“TRX-%”, “%-2023”] desenini izlemelidir:
models:
- name: transaction_data
columns:
- name: transaction_reference
tests:
- dbt_expectations.expect_column_values_to_match_like_pattern_list:
like_pattern_list: ["TRX-%", "%-2023"]
match_on: any
Veri yönetişimi sözleşmeleri, hassas veriler içeren sütunları, meta verileri (veri sahipleri vb.) ve bir veri ürününe erişme yetkisi olan kullanıcı rollerini içerdiklerinde de faydalı olabilir.
Örneğin, dbt’de meta alanını kullanarak veri modelimizin sahibini ve model geliştirme yaşam döngüsü aşamasını belirtebiliriz:
# models/schema.yaml
version: 2
models:
- name: users
meta:
owner: "@data_mike"
model_maturity: in dev
contains_pii: true
columns:
- name: email
meta:
contains_pii: true
meta alanı, bir kaynak için meta veriler ayarlamanıza olanak tanır; bu veriler dbt tarafından oluşturulan manifest.json dosyasına derlenir ve otomatik oluşturulan dokümantasyonda görüntülenebilir.
Zorunlu meta alanlarımızın mevcut olduğundan emin olmak için, çekme isteği sırasında bunu taramak amacıyla dbt-checkpoint gibi paketleri kullanabiliriz. Kanca, herhangi bir model (manifestten veya YAML dosyalarından) belirtilen meta anahtarlarına sahip değilse başarısız olur.
Modelin meta anahtarları YAML dosyasında veya manifestte bulunmalıdır.
Veri Sözleşmesi Uygulama Kalıpları
Sözleşme doğrulaması, veri yutulmadan önce (satır başına) akış veri hatlarında ve sonrasında — kaynakta (kaynak veri modeli katmanı) — gerçekleştirilebilir.
Veriyi “olduğu gibi” içe aldığımızda, doğrulama süreci bir dönüşüm adımı gibi davranır; sözleşme kurallarını uygular ve geçersiz verileri eler; örneğin, verilerin daha fazla incelenebileceği özel bir veritabanı görünümüne veya tabloya.
Doğrulama kontrolleri, veri doğrudan ham bir veri gölüne alındıktan sonra da sonradan uygulanabilir.
Gerçek zamanlı veri sözleşmesi doğrulamasının birincil avantajı, geçersiz kayıtları nihai varış noktalarına — veri gölüne veya veri ambarına — ulaşmadan önce filtreleyebilmesidir. Bu yaklaşım, Değişiklik Verisi Yakalama (CDC) olayları gibi olay güdümlü veya gerçek zamanlı veri işlemede yaygındır. Bu tür doğrulamada, sözleşmenin belirli yönleri, veri boru hattından akarken doğrulanır.
Veri Sözleşmesi Araçları
Veri topluluğu, sürekli gelişen bir veri mühendisliği alanı olan veri sözleşmelerinin potansiyel faydalarını kademeli olarak fark ediyor. Bu alanda birçoğu hâlâ erken aşamada olan pek çok araç mevcut. dbt, veri sözleşmeleri için evrensel bir çerçeve olarak değerlendirilebilir.
Benzer sözleşmeler, kaynaktan (kaynak veri modeli katmanı) Google’ın Dataform aracı kullanılarak, yani veri veri ambarımıza başarıyla alındığında uygulanabilir. Bunun için basit satır koşullarını kullanmak isteriz.
Aşağıdaki örneği düşünün. Tablomuz için belirli satır koşullarını uygular:
-- my_table.sqlx
config {
type: "table",
assertions: {
nonNull: ["user_id", "customer_id", "email"]
}
}
SELECT …
Aşağıda, niş bir veri kalitesi çerçevesi olan Soda.io kullanılarak gerçekleştirilebilecek bir başka veri sözleşmesi uygulama örneği bulunmaktadır:
# Checks for basic validations
checks for dim_customer:
- row_count between 10 and 1000
- missing_count(birth_date) = 0
- invalid_percent(phone) < 1 %:
valid format: phone number
- invalid_count(number_cars_owned) = 0:
valid min: 1
valid max: 6
- duplicate_count(phone) = 0
Uyarı ayarlarını değiştirerek, bir kontrolün doğrulamanın başarısız olması yerine uyarı vermesini yapılandırabilirsiniz. Bir Soda taraması, bir anlaşmada belirtilen kontrolleri çalıştırır; YAML dosyasını veya programatik bir çağrı içindeki satır içi tanımlamaları kontrol eder ve her kontrol için bir sonuç döndürür: başarı, başarısız veya hata.
Deneyimlerime göre, birçok şirkette veri sözleşmelerinin devreye alınması, veri hattı tasarım kalıpları (toplu veya gerçek zamanlı), veri serileştirme tercihleri ve depolama/işleme için kullanılan sistemler gibi faktörlere bağlı olarak parçalı kalmaktadır.
Veri sözleşmesi uygulaması, iş gereksinimlerine ve mantığına bağlıdır.
Great Expectations adlı bir Python kütüphanesi, anlamsal düzeyde veri sözleşmeleri uygulamak için kullanılabilir. pip install great_expectations ile kurulabilir.
great_expectations init komutunu çalıştırdıktan sonra veri doğrulamaya devam edebiliriz:
Using v3 (Batch Request) API
___ _ ___ _ _ _
/ __|_ _ ___ __ _| |_ | __|_ ___ __ ___ __| |_ __ _| |_(_)___ _ _ ___
| (_ | '_/ -_) _ | _| | _|\ \ / '_ \/ -_) _| _/ _ | _| / _ \ ' \(_-<
\___|_| \___\__,_|\__| |___/_\_\ .__/\___\__|\__\__,_|\__|_\___/_||_/__/
|_|
~ Always know what to expect from your data ~
Let's create a new Data Context to hold your project configuration.
Great Expectations will create a new directory with the following structure:
great_expectations
|-- great_expectations.yml
|-- expectations
|-- checkpoints
|-- plugins
|-- .gitignore
|-- uncommitted
|-- config_variables.yml
|-- data_docs
|-- validations
OK to proceed? [Y/n]:
Aşağıdaki kod parçasını düşünün. price sütunu için bir veri kontrol tanımının nasıl oluşturulacağını açıklar:
"expectation_type": "expect_column_values_to_match_regex",
"kwargs": {
"column": "price",
"mostly": 1.0,
"regex": "^\\$([0-9],)*[0-9]+\\.[0-9]{2}$"
},
Veri Sözleşmesi En İyi Uygulamaları
Burada doğru veya yanlış tek bir cevap yok; deneyimime göre başarılı bir veri sözleşmesi uygulaması büyük ölçüde iş gereksinimlerine bağlıdır. Veri sözleşmelerinin etkili çalışması için şu temel en iyi uygulamaları izleyin:
- Ölçeklenebilirlik: Genişletilebilirlik mekanizmaları (ör.
on_schema_change: append) ve versiyonlama eklemenizi öneririm; bu sayede veri sözleşmesi koşulları mevcut boru hattı entegrasyonlarını bozmadan değiştirilebilir. Veri sözleşmelerini gelecekteki değişiklikler ve ölçeklenebilirlik göz önünde bulundurularak tasarlayın. Bu yaklaşım, sözleşmenin gelişen ihtiyaçlara ve büyümeye uyum sağlamasını güvence altına alır. - Açık kurallar: Veri sözleşmesinde yanlış anlaşılmaları ve yanlış yorumlamaları önlemek için net ve öz bir dil kullanmanızı öneririm. Sözleşme, teknik uzmanlık düzeyi ne olursa olsun tüm tarafların erişebileceği ve anlayabileceği şekilde yazılmalı ve adlandırılmalıdır.
- İş birliği: Ortak çaba, gereksinimlerin kapsamlı ve çok yönlü anlaşılmasını sağlar; çeşitli bakış açılarını ve ihtiyaçları karşılar. Veri sözleşmeleri oluştururken veri üreticileri, veri mühendisleri, veri bilimcilerinin yanı sıra iş, BT, hukuk ve uyum birimlerinden temsilcileri içeren farklı paydaşları sürece dahil edin.
- Meta veriler: Veri sözleşmelerini kapsamlı dokümantasyon ve meta verilerle desteklemenizi öneririm. Kapsamlı dokümantasyon, sözleşmenin sorunsuz uygulanmasına ve bakımına yardımcı olur. Buna ayrıntılı açıklamalar, alan tanımları, doğrulama kuralları ve net bir anlayış ile etkili sözleşme uygulamasını destekleyen diğer ilgili bilgiler dahil olmalıdır.
- Düzenli gözden geçirmeler: Süregelen inceleme, sözleşmenin zaman içinde güncelliğini ve etkinliğini korumasına yardımcı olur. İzleme ve veri sözleşmesi güncellemeleri için yapılandırılmış bir yaklaşım uygulayın. Düzenli gözden geçirmeler, sözleşmenin güncel kalmasını, gelişen iş gereksinimleriyle uyumlu olmasını ve yeni veya değişen düzenlemelere uymasını sağlar.
Sonuç
Son dönemde, alan ekiplerinin kendi veri ürünlerinden sorumlu olduğu dağıtık veri sahipliğine doğru bir kayma oldu. Bu değişim, kuruluşları veri kalitesi beklentilerini veri sözleşmeleriyle resmileştirerek yeniden tanımlamaya zorladı.
Anlamsal veri doğrulamaları, verinin mantıksal olarak tutarlı olmasını ve iş mantığıyla uyumlu kalmasını sağlar. Veri, değer, soy ağacı ve bağlamsal bütünlükteki aykırı durumlar için veri hatlarını kontrol etmeye yardımcı olur. Yetersiz bağlamsal bütünlük, eksik veya tamamlanmamış veriye yol açabileceğinden bu da önemlidir.
Veri yönetişimi sözleşmeleri, CI/CD hatlarında da uygulanabilir ve hassas veriler içeren sütunları, meta verileri (veri sahipleri vb.) ve bir veri ürününe erişmeye yetkili kullanıcı rollerini belirtmeleri halinde son derece faydalı hale gelir.
Bir modelin meta verileri ve geliştiricinin tanımladığı diğer zorunlu meta alanlar, modelin kaynak kullanımı ve performansının izlenmesine yardımcı olur.
Veri sözleşmeleri içindeki Hizmet Düzeyi Anlaşmaları (SLA’lar), veri tazeliği, tamlık ve arıza kurtarma ile ilgili belirli taahhütleri ortaya koyar.
Veri sözleşmeleri, modern veri modelleme tekniklerinin ayrılmaz bir parçasıdır ve veri platformunun hataya yatkın olmamasına ve iyi ölçeklenmesine yardımcı olur. Veri kalitesi sorunlarını çözmek pahalı olabilir. Kurumsal düzeyde şirketler için, veri sözleşmesi doğrulamasını destekleyen mevcut veri kalitesi araçlarından yararlanarak yatırım getirisini (ROI) en üst düzeye çıkarmak giderek daha önemli hale gelmektedir.
SSS
Veri sözleşmeleri, veri doğrulama ve veri testinden nasıl farklıdır?
Veri sözleşmeleri, veri üreticileri ve tüketicilerinin biçim, şema ve alışveriş protokollerini belirleyen resmi anlaşmalardır. Veri kalitesi için net beklentiler ve sorumluluklar oluştururlar. Öte yandan veri doğrulama ve test etme, verinin bu beklentileri karşılayıp karşılamadığını kontrol eden süreçlerdir. Doğrulama, verinin tanımlı sözleşmeye uyduğunu güvence altına alırken test etme, verinin doğruluğunu ve güvenilirliğini değerlendirir.
Veri sözleşmeleri gerçek zamanlı akış veri hatlarında kullanılabilir mi?
Evet, veri sözleşmeleri gerçek zamanlı akış veri hatlarında uygulanabilir. Verinin hedefine ulaşmadan önce geçersiz verileri filtrelemeye yardımcı olarak yalnızca önceden tanımlanmış kural ve biçimlere uyan verinin işlenmesini sağlarlar. Bu yaklaşım, veri bütünlüğü ve zamanlamanın kritik olduğu olay güdümlü veya gerçek zamanlı işlemede faydalıdır.
Şema değişiklikleri sık olduğunda veri sözleşmelerinde sürümleme nasıl yönetilir?
Veri sözleşmelerinde sürümlemeyi yönetmek, geriye dönük uyumluluğu korumayı ve şema evrimini takip etmeyi içerir. Bir yaklaşım, her sözleşme sürümünün belirli bir şema sürümüyle ilişkilendirildiği sürümlü şemalar kullanmaktır. dbt’deki on_schema_change: append gibi araçlar, mevcut entegrasyonları kesintiye uğratmadan şema değişikliklerini yönetmeye yardımcı olur; kademeli geçişlere ve güncellemelere olanak tanır.
Veri sözleşmeleri, data mesh mimarisinde ne rol oynar?
Bir data mesh mimarisinde veri sahipliği alan ekiplerine dağıtılmıştır; veri sözleşmeleri ise alanlar arasında tutarlı veri kalitesi ve birlikte çalışabilirlik sağlar. Üreticiler ve tüketiciler arasındaki beklentileri resmileştirerek ekipleri veri standartlarında hizalar ve veriler farklı alanlar arasında akarken veri kalitesi sorunları riskini azaltır.
Veri sözleşmeleri, GDPR veya HIPAA gibi gizlilik düzenlemelerine uyuma nasıl yardımcı olur?
Veri sözleşmeleri, GDPR veya HIPAA gibi gizlilik düzenlemeleri dahil veri yönetişimi politikalarını zorunlu kılabilir. Veri maskeleme, psödönimleştirme ve erişim kontrollerine ilişkin kuralları tanımlayarak hassas verilerin uygun şekilde ele alınmasını sağlarlar. Bu kuralları sözleşmeye yerleştirerek, kuruluşlar uyumluluk kontrollerini otomatikleştirebilir ve gizlilik ihlali riskini azaltabilir.
Tutkulu ve dijital odaklı biri olarak, dijital pazarlamanın sunduğu zorluklarla çalışmaktan keyif alıyorum.
Birleşik Krallık’a taşınmadan önce satış, kurumsal bankacılık riski ve dijital pazarlama alanlarında on yılı aşkın deneyim edindim; risk yönetimi, matematiksel modelleme, istatistiksel analiz, işletme ve pazarlama konularında uzmanlık geliştirdim.
Newcastle’daki MBA eğitimimi tamamladıktan sonra, veri odaklı pazarlama, bilgisayar bilimi veya yapay zekâ alanlarında kariyer yapmaya ve ileride doktora seviyesine yükselmeye istekliyim. Bu alanlar, bilimin pratik uygulamasını, sürekli mesleki gelişimi, yeniliği ve dinamik bir sektöre katkı sunma fırsatını barındırıyor.


