Weiter zum Inhalt

Was sind Data Contracts? Ein Einsteigerleitfaden mit Beispielen

Skalierbarkeit in verteilten Datensystemen erreichen und Fehler reduzieren.
Aktualisiert 18. Sept. 2026  · 11 Min. lesen

Mit KI erkunden

ChatGPTClaudePerplexity

Data Contracts sind das Rückgrat für Datenqualität und Skalierung in verteilten Datenlösungen. Sie legen Format, Schema und Protokolle fest, die den Austausch zwischen Datenbank-Entitäten regeln. Diese formalen Vereinbarungen beseitigen Unklarheiten und nicht dokumentierte Annahmen über Daten.

In diesem Artikel mache ich das Konzept von Data Contracts greifbar und zeige grundlegende wie fortgeschrittene Techniken für eine erfolgreiche Umsetzung.

Data Contracts verstehen

Ein einzelner Data Contract definiert die genauen Parameter für den Datenaustausch zwischen zwei Modellen. Diese formalen Absprachen stellen sicher, dass es keine Unklarheiten zu Datenformaten und Schemas gibt.

Definition und Validierung von Data Contracts sind entscheidend für eine effektive bereichsübergreifende Zusammenarbeit.

Kurz gesagt ist ein Data Contract eine formale Vereinbarung zwischen dem Prozess, der den Ursprungszustand unserer Daten verändert (Producer), und den Zielsystemen (Consumer). Das ist vergleichbar mit Geschäftskontrakten, die Verpflichtungen zwischen Anbietern und Abnehmern eines Produkts festhalten. Data Contracts leisten das Gleiche für Datenprodukte, also Tabellen, Views, Datenmodelle usw.

Ziel ist es, Störungen in nachgelagerten Datenpipelines zu minimieren und Datentransformationen stabil und verlässlich zu machen.

Die Hauptbestandteile eines Data Contracts sind das Schema (Spalten und Formate), der Teil der semantischen Schicht (Kennzahlen, Berechnungen und Einschränkungen), Service Level Agreements (SLAs) und Data Governance.

Die Vorteile von Data Contracts umfassen:
  • Automatisierung und Checks zur Datenqualität, wenn neue Datenausgaben erstellt oder aktualisiert werden.
  • Effiziente Skalierung, insbesondere bei verteilter Datenarchitektur wie z. B. Data Mesh.
  • Verbesserung des Entwicklungszyklus von Daten mit Fokus auf Tools zur Vertragsvalidierung.
  • Förderung der Zusammenarbeit durch Feedback zwischen Datenproduzenten und -konsumenten.

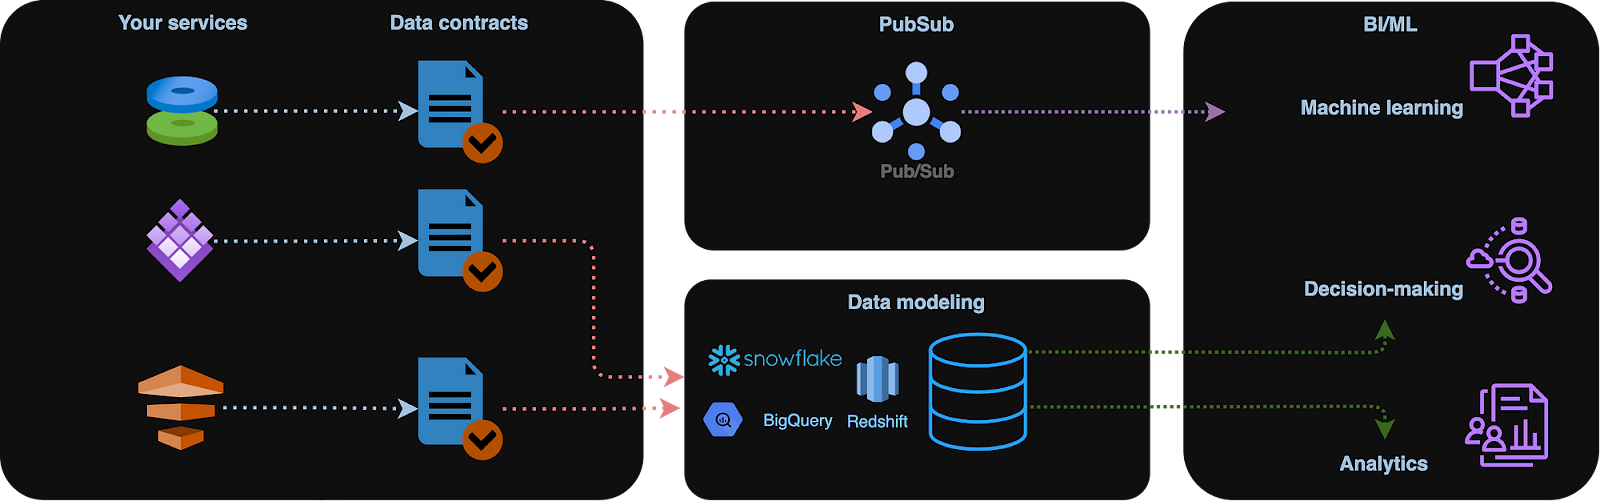
Image explaining how data contracts work.

Data Contracts. Bild: Autorin/Autor.

Beispiel für einen Data Contract mit dbt

In einem Data Contract legen Schemas Attributnamen, Datentypen und Pflichtfelder fest. Außerdem können sie Format, Länge und zulässige Wertebereiche für Spalten definieren.

Schauen wir uns ein dbt-Modellschema an, das in einer YAML-Datei wie folgt definiert ist. Unser Tabellenschema steht unter columns:

models:
 - name: dim_orders
   config:
     materialized: table
     contract:
       enforced: true
   columns:
     - name: order_id
       data_type: int
       constraints:
         - type: not_null
     - name: order_type
       data_type: string

Nehmen wir an, wir definieren unser dim_orders-Modell so:

select
 'abc123' as order_id,
 'Some order type' as order_type

Wenn in unserer Modell-Definition der contract mit enforced: true aktiv ist, wird beim Materialisieren von dim_orders als Tabelle auf unserer Datenplattform der folgende Fehler ausgelöst:

20:53:45  Compilation Error in model dim_customers (models/dim_orders.sql)
20:53:45    This model has an enforced contract that failed.
20:53:45    Please ensure the name, data_type, and number of columns in your contract match the columns in your model's definition.
20:53:45
20:53:45    | column_name | definition_type | contract_type | mismatch_reason    |
20:53:45    | ----------- | --------------- | ------------- | ------------------ |
20:53:45    | order_id    | TEXT            | INT           | data type mismatch |
20:53:45
20:53:45
20:53:45    > in macro assert_columns_equivalent (macros/materializations/models/table/columns_spec_ddl.sql)

Dasselbe würde bei zusätzlichen Spalten, SLA-Checks oder fehlenden Metadaten passieren, falls wir diese definiert hätten.

Ein fortgeschritteneres dbt-Beispiel enthält durchgesetzte Modellconstraints:

# models/schema.yaml
models:
 - name: orders
  
   # required
   config:
     contract:
       enforced: true
  
   # model-level constraints
   constraints:
     - type: primary_key
       columns: [id]
     - type: FOREIGN_KEY # multi_column
       columns: [order_type, SECOND_COLUMN, ...]
       expression: "OTHER_MODEL_SCHEMA.OTHER_MODEL_NAME (OTHER_MODEL_FIRST_COLUMN, OTHER_MODEL_SECOND_COLUMN, ...)"
     - type: check
       columns: [FIRST_COLUMN, SECOND_COLUMN, ...]
       expression: "FIRST_COLUMN != SECOND_COLUMN"
       name: HUMAN_FRIENDLY_NAME
     - type: ...
  
   columns:
     - name: FIRST_COLUMN
       data_type: DATA_TYPE
      
       # column-level constraints
       constraints:
         - type: not_null
         - type: unique
         - type: foreign_key
           expression: OTHER_MODEL_SCHEMA.OTHER_MODEL_NAME (OTHER_MODEL_COLUMN)
         - type: …

Ein Schema als Satz von Regeln und Constraints für die Spalten eines Datasets zu definieren, liefert essenzielle Informationen für Verarbeitung und Analyse.

Schemas ändern sich im Laufe der Zeit.

Das ist ein gängiges Szenario. Nehmen wir an, unsere Quelltabelle bekommt eine zusätzliche vertraglich festgelegte Spalte:

select
 'abc123' as order_id,
 'Some order type' as order_type,
 'USD' as currency

Bei inkrementellen Updates müssen Schemaänderungen berücksichtigt werden, sonst verletzt die Ausgabe des nachgelagerten inkrementellen Modells den Vertrag. 

Das lässt sich lösen, indem wir der dbt-Inkrementalstrategie on_schema_change: append hinzufügen.

Schemavalidierungen können explizit oder implizit sein.

Einige Big-Data-Dateiformate wie AVRO und Parquet unterstützen eingebettete Schemas und damit implizite Schemadefinitionen standardmäßig. Zusätzliche externe Validierung ist dann nicht nötig.

Im Gegensatz dazu benötigen schemalose Formate wie JSON eine externe Schemavalidierung. Manche Python-Bibliotheken wie pydantic oder ein einfaches @dataclass können das übernehmen:

from pydantic import BaseModel
class ConnectionDataRecord(BaseModel):
   user: str
   ts: int
record = ConnectionDataRecord(user="user1", ts=123456789)

Wenn wir gegen die Regeln verstoßen und Werte zuweisen, die nicht den Kriterien entsprechen, wird eine Exception ausgelöst. Beispielsweise tritt sie auf, wenn wir ConnectionDataRecord('', 1) aufrufen.

Werde Dateningenieur

Baue Python-Kenntnisse auf, um ein professioneller Dateningenieur zu werden.
Jetzt Kostenlos Loslegen

Semantische Data Contracts

Semantische Datenvalidierungen stellen sicher, dass Daten logisch konsistent sind und zur Business-Logik passen.

Semantische Validierungen müssen explizit durchgesetzt werden.

Im Gegensatz zu Schema-Checks beruhen semantische Data Contracts auf Business-Logik und werden extern implementiert.

In vielen Anwendungsfällen wirken Semantiken wie eine Erweiterung schema-validierter Verträge. Oft hängen sie von Geschäftsregeln ab und bilden eine Menge von Zeilenbedingungen ab, die unser Datenmodell erfüllen muss. 

Ein Beispiel für einen semantischen Vertrag kann Folgendes sein:

  • Metrikabweichung: von gleitendem Mittelwert oder einem anderen Schwellenwert. Beispielsweise können wir akzeptieren, dass die Zahl aktiver Nutzer gestern auf unter 75% des 7-Tage-Mittels fällt, aber 0% sind inakzeptabel.
  • Business-Logik: Alerts aus dem Transaktionsmonitoring und Fraud-Preventionscores. In diesem Fall muss der Auszahlungsbetrag 0 sein.
  • Data Lineage: Beschreibt die Entwicklung von Datenentitäten. Zum Beispiel darf transaction_completed_at nicht vor created_at liegen.
  • Referentielle Integrität: Beziehungen zwischen Entitäten sind wichtig und lassen sich ebenfalls über semantische Verträge abbilden. Betrachte den folgenden dbt-Code: Er stellt sicher, dass jede refund_id einer gültigen transaction.id zugeordnet ist.
- name: refunds
   enabled: true
   description: An incremental table
 columns:
     - name: refund_id
       tests:
         - relationships:
             tags: ['relationship']
             to: ref('transactions')
             field: id

Es liegt an dir, die Alarmstufe für semantische Verträge festzulegen. Häufig geschieht das über individuelle Data-Quality-Tests.

Verschiedene Geschäftsregeln zielen oft auf die Datenintegrität ab. Unlogische Datenszenarien können durch Fehler in Datenbank- und Serverkonfigurationen oder durch das versehentliche Einspeisen von Testdaten in die Produktion entstehen. Integritätsprüfungen validieren Daten gegen diese Geschäftsregeln und helfen, Werte zu erkennen, die nicht plausibel sind.

Datenbankentitäten stehen immer in Beziehung. Das nennt sich Entity-Relationship und wird oft im Entity-Relationship-Diagramm (ERD) dargestellt. Unzureichende referentielle Integrität kann zu fehlenden oder unvollständigen Daten führen. Data Contracts müssen diese Fallstricke adressieren, um Integrität und Genauigkeit sicherzustellen.

Ein häufiges Beispiel ist die 1:n-Beziehung zwischen customers und orders: Ein Kunde kann mehrere orders haben. In so einem Fall ist eine Bestellung nur gültig, wenn sie eine gültige customer_id im customers-Dataset enthält.

Dieser Constraint, eine Referenzintegritätsbedingung, stellt sicher, dass Beziehungen zwischen Entitäten korrekt abgebildet sind.

Service Level Agreements (SLAs) in Data Contracts

SLAs sind eine zusätzliche Ebene von Datenqualitätschecks, die sich über Data Contracts umsetzen lassen.

SLAs beziehen sich auf Datenaktualität.

Da Datenmodelle regelmäßig mit neuen Daten aktualisiert werden, können SLAs Checks für den spätesten Zeitpunkt enthalten, zu dem neue Daten erwartet werden, oder die maximal zulässige Verzögerung. In dbt lässt sich das zum Beispiel über Freshness-Tests erreichen:

- name: orders
   enabled: true
   description: A source table declaration
   tests:
     - dbt_utils.recency: # https://github.com/dbt-labs/dbt-utils#recency-source
         tags: ['freshness']
         datepart: day
         field: timestamp
         interval: 1

Angenommen, wir wollen einen Bericht zu den gestrigen Fakten erstellen. Dann müssen wir sicherstellen, dass diese Daten existieren. Es wäre ungewöhnlich, mehrere Tage lang keine neuen Bestellungen zu sehen.

Im Beispiel unten testen wir unser Dataset auf unerwartete Verzögerungen bei Bestellungen über die Testkonfiguration in dbt. So kannst du den Test mit einem spezifischen Namen auswählen und referenzieren.

version: 2
models:
 - name: orders
   columns:
     - name: status
       tests:
         - accepted_values:
             name: unexpected_order_status_today
             values: ['placed', 'shipped', 'completed', 'returned']
             config:
               where: "order_date = current_date"

Mit einem eigenen Namen steuerst du vollständig, wie der Test in Logmeldungen und Metadaten-Artefakten erscheint.

Ähnlich gilt in Echtzeitpipelines, dass Daten in der Regel nur wenige Stunden alt sein dürfen. SLAs sind besonders wichtig für Stream-Processing-Anwendungen, in denen Daten nahezu in Echtzeit mit Minuten- oder sogar Sekundenlatenz verarbeitet werden.

In Streaming-Apps wollen wir die maximal zulässige Verspätung spät eintreffender Events sowie Metriken wie Mean Time Between Failures (MTBF) und Mean Time to Recovery (MTTR) prüfen. Die Umsetzung erfordert eine sorgfältige Incident-Erfassung und das Auslesen relevanter Daten aus Monitoring- und Incident-Management-Tools wie PagerDuty, Datadog und Grafana.

Data-Governance-Verträge

Der korrekte Umgang mit personenbezogenen Daten (PII) ist integraler Bestandteil der Datentransformation. Für viele Unternehmen ist es entscheidend, dass diese Datasets mindestens DSGVO-konform sind und Datenschutzvorgaben wie HIPAA oder PCI DSS einhalten.

Data-Governance-Verträge stellen sicher, dass angemessene Richtlinien zur Pseudonymisierung oder Datenmaskierung bestehen. 

Sieh dir den folgenden dbt-Code an. Als tests durchgesetzte Verträge verlangen, dass user_email ein SHA256-Hash (maskiert) ist:

models:
 - name: customer_data
   columns:
       - name: user_email
         tests:
           - dbt_expectations.expect_column_values_to_not_match_regex:
               regex: "^(?!.*\b@\b).* # Ensure identifiers do not contain emails
               flags: i # Case-insensitive matching

Andererseits wollen wir für andere Tabellen vielleicht Pattern Matching erzwingen. Im Beispiel unten muss das Feld transaction_reference dem Muster [“TRX-%”, “%-2023”] folgen:

models:
 - name: transaction_data
   columns:
       - name: transaction_reference
         tests:
           - dbt_expectations.expect_column_values_to_match_like_pattern_list:
               like_pattern_list: ["TRX-%", "%-2023"]
               match_on: any

Data-Governance-Verträge sind auch hilfreich, wenn sie Spalten mit sensiblen Daten, Metadaten (Datenverantwortliche usw.) und Nutzerrollen enthalten, die Zugriff auf ein Datenprodukt haben.

Zum Beispiel können wir mit dem meta-Feld in dbt die Eigentümerschaft und die Entwicklungsphase unseres Datenmodells angeben:

# models/schema.yaml
version: 2
models:
 - name: users
   meta:
     owner: "@data_mike"
     model_maturity: in dev
     contains_pii: true
   columns:
     - name: email
       meta:
       contains_pii: true

Das meta-Feld erlaubt es, Metadaten für eine Ressource zu setzen. Diese werden in die von dbt erzeugte manifest.json kompiliert und sind in der automatisch generierten Dokumentation sichtbar. 

Wir können Pakete wie dbt-checkpoint nutzen, um dies während des Pull-Requests zu prüfen und sicherzustellen, dass Pflichtfelder in den Metadaten vorhanden sind. Der Hook schlägt fehl, wenn ein Modell (aus Manifest oder YAML-Dateien) die geforderten Meta-Keys nicht hat.

Die meta-Keys des Modells müssen in der YAML-Datei oder im Manifest stehen.

Muster für die Implementierung von Data Contracts

Vertragsvalidierung kann in Streaming-Datenpipelines (pro Zeile) vor der Aufnahme und danach — an der Quelle (Schicht des Quelldatenmodells) — erfolgen.

Wenn wir Daten „as is“ aufnehmen, wirkt die Validierung wie ein Transformationsschritt: Vertragsregeln werden durchgesetzt und ungültige Daten herausgefiltert, z. B. in eine dedizierte View oder Tabelle zur weiteren Untersuchung.

Validierungschecks können auch nachträglich angewendet werden, wenn Daten direkt in einen Raw Data Lake geladen werden.

Der Hauptvorteil der Validierung von Data Contracts in Echtzeit ist die Möglichkeit, ungültige Datensätze zu filtern, bevor sie ihr Ziel erreichen — einen Data Lake oder ein Data Warehouse. Dieser Ansatz ist verbreitet in ereignisgetriebener oder Echtzeitverarbeitung wie bei Change Data Capture (CDC). Dabei werden bestimmte Aspekte des Vertrags geprüft, während die Daten durch die Pipeline fließen.

Tools für Data Contracts

Die Data-Community erkennt zunehmend das Potenzial von Data Contracts, einem sich rasant entwickelnden Bereich des Data Engineerings. Es gibt bereits viele Tools, einige davon noch in den Anfängen. dbt kann als universelles Framework für Data Contracts gelten.

Ähnliche Verträge lassen sich mit Googles Dataform auf der Quellschicht (Quelldatenmodell) umsetzen, also wenn die Daten erfolgreich in unser Data Warehouse geladen wurden. Dafür eignen sich einfache Zeilenbedingungen. 

Betrachte dieses Beispiel. Es wendet bestimmte Zeilenbedingungen auf unsere Tabelle an:

-- my_table.sqlx
config {
 type: "table",
 assertions: {
   nonNull: ["user_id", "customer_id", "email"]
 }
}
SELECT …

Unten folgt ein weiteres Beispiel für die Umsetzung von Data Contracts mit Soda.io, einem spezialisierten Data-Quality-Framework:

# Checks for basic validations
checks for dim_customer:
 - row_count between 10 and 1000
 - missing_count(birth_date) = 0
 - invalid_percent(phone) < 1 %:
     valid format: phone number
 - invalid_count(number_cars_owned) = 0:
     valid min: 1
     valid max: 6
 - duplicate_count(phone) = 0

Über die Alert-Einstellungen kannst du festlegen, dass ein Check eine Warnung statt eines Fehlers ausgibt. Ein Soda-Scan führt die im Vertrag definierten Checks aus, prüft die YAML-Datei oder Inline-Aufrufe im Code und liefert für jeden Check ein Ergebnis: pass, fail oder error.

Nach meiner Erfahrung ist die Einführung von Data Contracts in vielen Unternehmen noch fragmentiert. Das hängt u. a. von Pipeline-Designmustern (Batch oder Echtzeit), der Datenspeicherung und -serialisierung sowie den verwendeten Systemen zur Speicherung und Verarbeitung ab.

Die Umsetzung von Data Contracts richtet sich nach Geschäftsanforderungen und -logik.

Great Expectations, eine Python-Bibliothek, kann für semantische Data Contracts eingesetzt werden. Installation via pip: pip install great_expectations. 

Nach great_expectations init geht es weiter mit der Datenvalidierung:

Using v3 (Batch Request) API
 ___              _     ___                  _        _   _
/ __|_ _ ___ __ _| |_  | __|_ ___ __  ___ __| |_ __ _| |_(_)___ _ _  ___
| (_ | '_/ -_) _ |  _| | _|\ \ / '_ \/ -_) _|  _/ _ |  _| / _ \ ' \(_-<
\___|_| \___\__,_|\__| |___/_\_\ .__/\___\__|\__\__,_|\__|_\___/_||_/__/
                               |_|
            ~ Always know what to expect from your data ~
Let's create a new Data Context to hold your project configuration.
Great Expectations will create a new directory with the following structure:
   great_expectations
   |-- great_expectations.yml
   |-- expectations
   |-- checkpoints
   |-- plugins
   |-- .gitignore
   |-- uncommitted
       |-- config_variables.yml
       |-- data_docs
       |-- validations
OK to proceed? [Y/n]:

Das folgende Snippet zeigt, wie du eine Datenprüfung für die Spalte price definierst:

"expectation_type": "expect_column_values_to_match_regex",
"kwargs": {
 "column": "price",
 "mostly": 1.0,
 "regex": "^\\$([0-9],)*[0-9]+\\.[0-9]{2}$"
},

Best Practices für Data Contracts

Es gibt kein Patentrezept, denn der Erfolg hängt stark von den Geschäftsanforderungen ab. Damit Data Contracts wirksam sind, befolge diese zentralen Empfehlungen:

  • Skalierbarkeit: Implementiere Mechanismen für Erweiterbarkeit (z. B. on_schema_change: append) und Versionierung, um Vertragskonditionen anpassen zu können, ohne bestehende Integrationen zu stören. Denke Data Contracts von Anfang an zukunftsfähig und skalierbar. So passen sie sich wandelnden Anforderungen und Wachstum an.
  • Klare Regeln: Formuliere einfach und präzise, um Missverständnisse zu vermeiden. Der Vertrag sollte so geschrieben und benannt sein, dass alle Beteiligten ihn verstehen — unabhängig vom technischen Hintergrund.
  • Zusammenarbeit: Eine gemeinsame Erarbeitung sorgt für ein ganzheitliches Verständnis der Anforderungen. Beziehe beim Erstellen von Data Contracts Producer, Data Engineers, Data Scientists sowie Fachbereiche, IT, Legal und Compliance ein.
  • Metadaten: Stelle ausführliche Dokumentation und Metadaten bereit. Detaillierte Beschreibungen, Felddefinitionen, Validierungsregeln und weitere Hinweise unterstützen Anwendung und Wartung des Vertrags.
  • Regelmäßige Reviews: Ein strukturierter Prozess für Monitoring und Updates hält den Vertrag aktuell, richtet ihn an neuen Geschäftsanforderungen aus und berücksichtigt geänderte Regularien.

Fazit

Zuletzt hat sich die Verantwortung für Daten stärker in die Fachdomänen verlagert: Domain-Teams verantworten ihre Datenprodukte. Dadurch mussten Organisationen Erwartungen an Datenqualität neu definieren — formalisiert über Data Contracts.

Semantische Validierungen stellen sicher, dass Daten logisch konsistent sind und zur Business-Logik passen. Sie helfen, Pipelines auf Ausreißer bei Werten, Lineage und referenzieller Integrität zu prüfen. Unzureichende Referenzintegrität führt leicht zu fehlenden oder unvollständigen Daten und ist daher besonders relevant. 

Data-Governance-Verträge lassen sich auch in CI/CD-Pipelines einbinden und sind sehr hilfreich, wenn sie sensible Spalten, Metadaten (Datenverantwortliche usw.) und Nutzerrollen mit Zugriffsrechten auf ein Datenprodukt kenntlich machen. 

Die Metadaten eines Modells — zusammen mit weiteren vom Entwickler vorgegebenen Pflichtfeldern — unterstützen das Monitoring von Ressourcenverbrauch und Performance. 

Service Level Agreements (SLAs) innerhalb von Data Contracts definieren konkrete Zusagen zu Datenaktualität, Vollständigkeit und Fehlerbehebung.

Data Contracts sind ein Kernbaustein moderner Datenmodellierung und helfen, eine fehlertolerante und skalierbare Datenplattform aufzubauen. Die Behebung von Datenqualitätsproblemen kann teuer werden. Gerade für Enterprise-Unternehmen wird es immer wichtiger, den Return on Investment (ROI) aus Daten zu maximieren, indem bestehende Tools zur Vertragsvalidierung gezielt eingesetzt werden.

Werde Dateningenieur

Beweise deine Fähigkeiten als einsatzbereiter Datentechniker.

FAQs

Worin unterscheiden sich Data Contracts von Datenvalidierung und Datentests?

Data Contracts sind formale Vereinbarungen, die Format, Schema und Austauschprotokolle zwischen Datenproduzenten und -konsumenten festlegen. Sie definieren klare Erwartungen und Zuständigkeiten für Datenqualität. Datenvalidierung und -tests hingegen prüfen, ob die Daten diese Erwartungen erfüllen. Validierung stellt die Einhaltung des Vertrags sicher, Tests bewerten Genauigkeit und Zuverlässigkeit der Daten.

Können Data Contracts in Echtzeit-Streaming-Pipelines verwendet werden?

Ja, Data Contracts können in Echtzeit-Streaming-Pipelines eingesetzt werden. Sie helfen, ungültige Daten auszufiltern, bevor sie ihr Ziel erreichen, sodass nur Daten weiterverarbeitet werden, die vordefinierten Regeln und Formaten entsprechen. Das ist besonders nützlich in ereignisgetriebener oder Echtzeitverarbeitung, wo Datenintegrität und Aktualität kritisch sind.

Wie gehst du mit Versionierung bei häufigen Schemaänderungen in Data Contracts um?

Versionierung bei Data Contracts bedeutet, Abwärtskompatibilität zu wahren und Schemaevolution nachzuverfolgen. Eine Möglichkeit sind versionierte Schemas, bei denen jede Vertragsversion einem spezifischen Schemastand zugeordnet ist. Tools wie on_schema_change: append in dbt helfen, Schemaänderungen zu managen, ohne bestehende Integrationen zu stören, und erlauben schrittweise Übergänge und Updates.

Welche Rolle spielen Data Contracts in einer Data-Mesh-Architektur?

In einer Data-Mesh-Architektur liegt die Datenverantwortung bei den Domänenteams. Data Contracts sichern konsistente Datenqualität und Interoperabilität zwischen Domänen. Sie formalisieren Erwartungen zwischen Produzenten und Konsumenten, harmonisieren Datenstandards und reduzieren das Risiko von Qualitätsproblemen entlang der Domänengrenzen.

Wie helfen Data Contracts bei der Einhaltung von Datenschutzvorgaben wie DSGVO oder HIPAA?

Data Contracts können Data-Governance-Richtlinien durchsetzen, einschließlich Datenschutzvorgaben wie DSGVO oder HIPAA. Sie können Regeln für Datenmaskierung, Pseudonymisierung und Zugriffskontrollen definieren und so den Umgang mit sensiblen Daten absichern. Durch die Einbettung dieser Regeln in den Vertrag lassen sich Compliance-Checks automatisieren und Datenschutzrisiken reduzieren.


Mike Shakhomirov's photo
Author
Mike Shakhomirov
LinkedIn

Ich bin leidenschaftlich und digital fokussiert und freue mich auf die Herausforderungen des digitalen Marketings.

Bevor ich nach Großbritannien ging, sammelte ich mehr als zehn Jahre Erfahrung im Vertrieb, im Risikobereich des Firmenkundengeschäfts und im digitalen Marketing, wo ich Fachkenntnisse in den Bereichen Risikomanagement, mathematische Modellierung, statistische Analyse, Betriebswirtschaft und Marketing erwarb.

Nach meinem MBA-Abschluss in Newcastle möchte ich nun eine Karriere in den Bereichen datengesteuertes Marketing, Informatik oder KI anstreben, mit der Möglichkeit, einen Doktortitel zu erlangen. Diese Bereiche bieten die praktische Anwendung der Wissenschaft, ständige berufliche Weiterentwicklung, Innovation und die Möglichkeit, einen Beitrag zu einer dynamischen Branche zu leisten.

Themen
Datentechnik

Vertiefe dein Wissen im Data Engineering mit diesen Kursen!

Kurs

Grundlagen von Data Engineering

2 Std.
373.2K
Hier lernst du, wie Data Engineers die Grundlagen für Data Science schaffen – ganz ohne Programmieren.
Details anzeigenRight Arrow
Kurs Starten
Mehr anzeigenRight Arrow
Verwandt

Blog

Lehrer/innen und Schüler/innen erhalten das Premium DataCamp kostenlos für ihre gesamte akademische Laufbahn

Keine Hacks, keine Tricks. Schüler/innen und Lehrer/innen, lest weiter, um zu erfahren, wie ihr die Datenerziehung, die euch zusteht, kostenlos bekommen könnt.
Nathaniel Taylor-Leach's photo

Nathaniel Taylor-Leach

4 Min.

Blog

Die 20 besten Snowflake-Interview-Fragen für alle Niveaus

Bist du gerade auf der Suche nach einem Job, der Snowflake nutzt? Bereite dich mit diesen 20 besten Snowflake-Interview-Fragen vor, damit du den Job bekommst!
Nisha Arya Ahmed's photo

Nisha Arya Ahmed

15 Min.

Blog

2022-2023 DataCamp Classrooms Jahresbericht

Zu Beginn des neuen Schuljahres ist DataCamp Classrooms motivierter denn je, das Lernen mit Daten zu demokratisieren. In den letzten 12 Monaten sind über 7.650 neue Klassenzimmer hinzugekommen.
Nathaniel Taylor-Leach's photo

Nathaniel Taylor-Leach

8 Min.

Tutorial

Python JSON-Daten: Ein Leitfaden mit Beispielen

Lerne, wie man mit JSON in Python arbeitet, einschließlich Serialisierung, Deserialisierung, Formatierung, Leistungsoptimierung, Umgang mit APIs und Verständnis der Einschränkungen und Alternativen von JSON.
Moez Ali's photo

Moez Ali

6 Min.

Tutorial

Ein Leitfaden zu Python-Hashmaps

Finde heraus, was Hashmaps sind und wie sie in Python mit Hilfe von Wörterbüchern umgesetzt werden.
Javier Canales Luna's photo

Javier Canales Luna

11 Min.

Tutorial

Python Datenstrukturen Tutorial

Mach dich mit Python-Datenstrukturen vertraut: Lerne mehr über Datentypen und primitive sowie nicht-primitive Datenstrukturen wie Strings, Listen, Stapel usw.
Sejal Jaiswal's photo

Sejal Jaiswal

24 Min.

Mehr AnzeigenMehr Anzeigen

