Accéder au contenu principal

Qu'est-ce qu'un data contract ? Guide débutant avec exemples

Atteindre la scalabilité dans des systèmes distribués et réduire les erreurs.
Actualisé 18 sept. 2026  · 11 min lire

Explorer avec l’IA

ChatGPTClaudePerplexity

Les data contracts sont l'ossature de la qualité et de la scalabilité des données pour les solutions distribuées. Ils précisent le format, le schéma et les protocoles qui encadrent les échanges entre entités de base de données. Ces accords formels éliminent les ambiguïtés et les hypothèses non documentées sur les données.

Dans cet article, je clarifie la notion de data contract en proposant à la fois des techniques fondamentales et avancées pour faciliter leur mise en œuvre efficace.

Comprendre les data contracts

Un data contract définit précisément les paramètres d'échange de données entre deux modèles. Ces accords formels garantissent l'absence d'ambiguïté quant au format et aux schémas des données.

La définition et la validation des data contracts sont essentielles pour une collaboration efficace entre équipes.

En bref, un data contract est un accord formel entre le processus qui modifie l'état initial de nos données (producteurs) et les destinations (consommateurs). C'est très proche du fonctionnement des contrats commerciaux : ils formalisent des engagements entre fournisseurs et clients d'un produit. Les data contracts font la même chose avec les produits de données, c'est-à-dire les tables, vues, modèles de données, etc.

L'objectif est de réduire les perturbations en aval des pipelines de données et de rendre les transformations stables et fiables.

Les principaux composants d'un data contract sont le schéma (colonnes et formats), la partie couche sémantique (mesures, calculs et restrictions), les accords de niveau de service (SLA) et la gouvernance des données.

Les avantages des data contracts incluent :
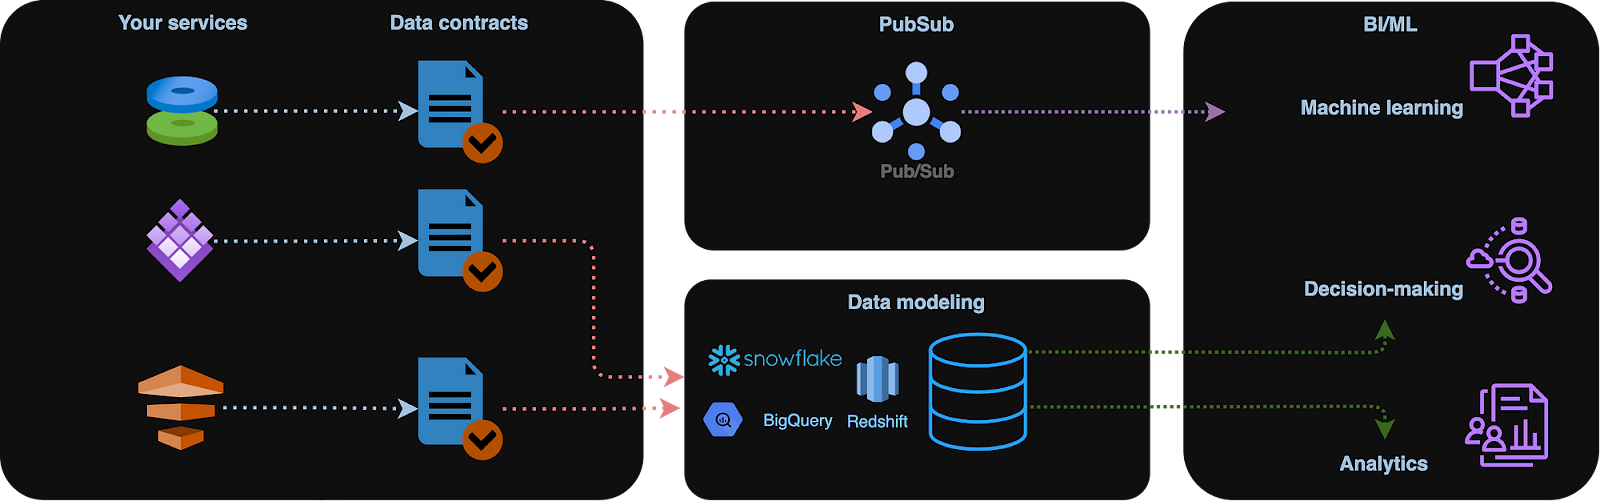
  • Automatisation et contrôles de qualité des données lors de la création ou de la mise à jour de nouveaux jeux de données.
  • Scalabilité efficace, en particulier pour les architectures distribuées, par exemple le data mesh.
  • Amélioration du cycle de développement des données, avec un accent sur les outils de validation des contrats.
  • Renforcement de la collaboration via les retours entre producteurs et consommateurs de données.

Image expliquant le fonctionnement des data contracts.

Data contracts. Image de l'auteur.

Exemple de data contract avec dbt

Dans un data contract, les schémas définissent les noms d'attributs, les types de données et le caractère obligatoire des attributs. Ils peuvent aussi préciser le format, la longueur et les plages de valeurs acceptables pour les colonnes.

Considérons un schéma de modèle dbt défini comme suit dans un fichier YAML. Le schéma de notre table est défini dans columns :

models:
 - name: dim_orders
   config:
     materialized: table
     contract:
       enforced: true
   columns:
     - name: order_id
       data_type: int
       constraints:
         - type: not_null
     - name: order_type
       data_type: string

Imaginons maintenant que nous définissions notre modèle dim_orders ainsi :

select
 'abc123' as order_id,
 'Some order type' as order_type

Le fait d'avoir contract avec enforced: true dans la définition du modèle déclenchera l'erreur suivante si nous essayons de matérialiser dim_orders en table sur notre plateforme de données :

20:53:45  Compilation Error in model dim_customers (models/dim_orders.sql)
20:53:45    This model has an enforced contract that failed.
20:53:45    Please ensure the name, data_type, and number of columns in your contract match the columns in your model's definition.
20:53:45
20:53:45    | column_name | definition_type | contract_type | mismatch_reason    |
20:53:45    | ----------- | --------------- | ------------- | ------------------ |
20:53:45    | order_id    | TEXT            | INT           | data type mismatch |
20:53:45
20:53:45
20:53:45    > in macro assert_columns_equivalent (macros/materializations/models/table/columns_spec_ddl.sql)

Il en serait de même avec des colonnes supplémentaires, des contrôles SLA ou des métadonnées manquantes, si nous avions choisi de les définir.

Un exemple dbt plus avancé inclurait des contraintes de modèle appliquées :

# models/schema.yaml
models:
 - name: orders
  
   # required
   config:
     contract:
       enforced: true
  
   # model-level constraints
   constraints:
     - type: primary_key
       columns: [id]
     - type: FOREIGN_KEY # multi_column
       columns: [order_type, SECOND_COLUMN, ...]
       expression: "OTHER_MODEL_SCHEMA.OTHER_MODEL_NAME (OTHER_MODEL_FIRST_COLUMN, OTHER_MODEL_SECOND_COLUMN, ...)"
     - type: check
       columns: [FIRST_COLUMN, SECOND_COLUMN, ...]
       expression: "FIRST_COLUMN != SECOND_COLUMN"
       name: HUMAN_FRIENDLY_NAME
     - type: ...
  
   columns:
     - name: FIRST_COLUMN
       data_type: DATA_TYPE
      
       # column-level constraints
       constraints:
         - type: not_null
         - type: unique
         - type: foreign_key
           expression: OTHER_MODEL_SCHEMA.OTHER_MODEL_NAME (OTHER_MODEL_COLUMN)
         - type: …

Fournir une définition de schéma comme ensemble de règles et de contraintes appliquées aux colonnes d'un jeu de données apporte des informations clés pour le traitement et l'analyse.

Les schémas évoluent avec le temps.

C'est un cas fréquent. Imaginons que notre table source ajoute une colonne contractuelle supplémentaire :

select
 'abc123' as order_id,
 'Some order type' as order_type,
 'USD' as currency

Il est essentiel de tenir compte des changements de schéma lors des mises à jour incrémentales, sinon la sortie du modèle incrémental en aval invalidera le contrat. 

On peut résoudre cela en ajoutant on_schema_change: append à la stratégie incrémentale dbt.

Les validations de schéma peuvent être explicites ou implicites.

Certains formats de fichiers big data, comme AVRO et Parquet, intègrent nativement des définitions de schéma et des validations implicites ; il n'est donc pas nécessaire d'ajouter une validation externe.

À l'inverse, les formats sans schéma comme JSON nécessitent une validation externe. Des bibliothèques Python comme pydantic ou un simple @dataclass, peuvent l'assurer :

from pydantic import BaseModel
class ConnectionDataRecord(BaseModel):
   user: str
   ts: int
record = ConnectionDataRecord(user="user1", ts=123456789)

Si nous enfreignons les règles en attribuant des valeurs qui ne correspondent pas aux critères, une exception sera levée. Par exemple, l'appel à ConnectionDataRecord('', 1) déclenchera une erreur.

Devenez ingénieur en données

Développez vos compétences en Python pour devenir un ingénieur de données professionnel.
Commencez Gratuitement

Data contracts sémantiques

Les validations sémantiques garantissent que les données sont logiquement cohérentes et alignées sur la logique métier.

Les validations sémantiques doivent être appliquées explicitement.

En effet, contrairement aux contrôles de schéma, les data contracts sémantiques reposent sur la logique métier et doivent être implémentés en externe.

Dans de nombreux cas d'usage, la sémantique prolonge les contrats validés par schéma. Elle dépend souvent des règles métier et se traduit par un ensemble de conditions de lignes auxquelles notre modèle doit se conformer. 

Exemples de contrats sémantiques :

  • Écart de métrique : par rapport à la moyenne mobile ou à un autre seuil. Nous pouvons tolérer que le nombre d'utilisateurs actifs hier descende sous 75 % de la moyenne mobile sur 7 jours, mais pas 0 %.
  • Logique métier : indicateurs d'alerte de surveillance des transactions et scores de prévention de la fraude. Dans ce cas, le paiement doit être égal à 0.
  • Linéage des données : décrit l'évolution des entités. Par exemple, transaction_completed_at ne peut pas précéder created_at.
  • Intégrité référentielle : les relations entre entités sont importantes et peuvent aussi être décrites via des contrats sémantiques. Voyez le code dbt ci-dessous : chaque refund_id d'un remboursement renvoie à un transaction.id valide.
- name: refunds
   enabled: true
   description: An incremental table
 columns:
     - name: refund_id
       tests:
         - relationships:
             tags: ['relationship']
             to: ref('transactions')
             field: id

C'est à l'utilisateur final de définir le niveau d'alerte sur les contrats sémantiques, souvent via des tests de qualité de données personnalisés.

De nombreuses règles métiers renvoient à l'intégrité des données. Des situations illogiques peuvent provenir d'erreurs de configuration de bases de données et de serveurs ou de l'injection involontaire de données de test en production. Les contrôles d'intégrité visent à valider les données au regard de ces règles, afin d'identifier les valeurs anormales ou incohérentes.

Les entités d'une base de données sont toujours liées entre elles. On parle de relation d'entités, souvent représentée par un diagramme ERD (entity relationship diagram). Une intégrité référentielle insuffisante peut mener à des données manquantes ou incomplètes. Les data contracts doivent couvrir ces écueils potentiels pour garantir l'intégrité et l'exactitude des données.

Par exemple, une relation courante est l'association un-à-plusieurs entre customers et orders où un client peut avoir plusieurs orders. Dans ce cas, une commande n'est valide que si elle contient un customer_id valide présent dans le jeu de données customers.

Ce type de contrainte, une contrainte d'intégrité référentielle, garantit l'exactitude de la relation entre entités.

Accords de niveau de service (SLA) dans les data contracts

Les SLA ajoutent un niveau supplémentaire de contrôles qualité pouvant être mis en place via des data contracts.

Les SLA portent sur la fraîcheur des données.

Comme les modèles sont régulièrement mis à jour, les SLA peuvent inclure des contrôles sur l'heure limite à laquelle les nouvelles données doivent être disponibles ou le délai maximal toléré. Dans dbt, cela peut se faire via des tests de fraîcheur :

- name: orders
   enabled: true
   description: A source table declaration
   tests:
     - dbt_utils.recency: # https://github.com/dbt-labs/dbt-utils#recency-source
         tags: ['freshness']
         datepart: day
         field: timestamp
         interval: 1

Supposons que nous voulions produire un rapport sur les faits d'hier ; nous devons nous assurer que les données existent. Il serait en effet surprenant de ne pas voir de nouvelles commandes pendant plusieurs jours.

Dans l'exemple ci-dessous, nous testons notre jeu de données pour détecter des statuts de commande inattendus aujourd'hui via une configuration de test dbt. Cela vous permet de sélectionner et référencer le test par ce nom spécifique.

version: 2
models:
 - name: orders
   columns:
     - name: status
       tests:
         - accepted_values:
             name: unexpected_order_status_today
             values: ['placed', 'shipped', 'completed', 'returned']
             config:
               where: "order_date = current_date"

En définissant un nom personnalisé, vous contrôlez entièrement l'affichage du test dans les journaux et les artefacts de métadonnées.

De même, dans des pipelines temps réel, on s'attend généralement à des données âgées de quelques heures au plus. Les SLA sont cruciaux pour les applications de traitement en flux, où les données sont traitées en temps réel avec une latence de quelques minutes, voire secondes.

Dans les applications de streaming, nous voulons contrôler le retard maximal des événements arrivant tard et suivre des métriques comme le MTBF (Mean Time Between Failures) et le MTTR (Mean Time To Recovery). Leur mise en œuvre suppose un suivi rigoureux des incidents et l'extraction de données pertinentes d'outils de supervision et de gestion d'incidents tels que PagerDuty, Datadog et Grafana.

Contrats de gouvernance des données

Le bon traitement des données personnelles (PII) est indissociable des transformations de données. Pour de nombreuses entreprises, il est crucial que ces jeux de données soient au minimum conformes au RGPD et respectent des réglementations comme HIPAA ou PCI DSS.

Les contrats de gouvernance des données garantissent la mise en place de politiques adéquates de pseudonymisation ou de masquage des données. 

Considérez le code dbt ci-dessous. Des contrats appliqués sous forme de tests imposent que user_email soit un hachage SHA256 (masqué) :

models:
 - name: customer_data
   columns:
       - name: user_email
         tests:
           - dbt_expectations.expect_column_values_to_not_match_regex:
               regex: "^(?!.*\b@\b).* # Ensure identifiers do not contain emails
               flags: i # Case-insensitive matching

À l'inverse, nous pouvons souhaiter imposer une correspondance de motif pour d'autres tables. Par exemple, ci-dessous, le champ transaction_reference doit suivre le motif [“TRX-%”, “%-2023”] :

models:
 - name: transaction_data
   columns:
       - name: transaction_reference
         tests:
           - dbt_expectations.expect_column_values_to_match_like_pattern_list:
               like_pattern_list: ["TRX-%", "%-2023"]
               match_on: any

Les contrats de gouvernance des données sont également utiles lorsqu'ils précisent des colonnes sensibles, des métadonnées (propriétaires de données, etc.) et les rôles autorisés à accéder à un produit de données.

Par exemple, nous pouvons indiquer le propriétaire de notre modèle et l'étape de son cycle de vie via le champ meta dans dbt :

# models/schema.yaml
version: 2
models:
 - name: users
   meta:
     owner: "@data_mike"
     model_maturity: in dev
     contains_pii: true
   columns:
     - name: email
       meta:
       contains_pii: true

Le champ meta vous permet de définir des métadonnées pour une ressource, qui seront compilées dans le fichier manifest.json généré par dbt et visibles dans la documentation automatiquement produite. 

Nous pouvons utiliser des paquets comme dbt-checkpoint pour analyser ce fichier lors d'une pull request et vérifier la présence des métadonnées obligatoires. Le hook échoue si un modèle (du manifeste ou des fichiers YAML) n'a pas les clés meta spécifiées.

Les clés meta d'un modèle doivent figurer dans le fichier YAML ou le manifeste.

Schémas d'implémentation des data contracts

La validation des contrats peut être effectuée dans des pipelines de streaming (par ligne) avant l'ingestion et après — à la source (couche de modèle source).

Lorsque nous ingérons les données « en l'état », la validation agit comme une étape de transformation, applique les règles du contrat et filtre les données invalides, par exemple vers une vue ou une table dédiée pour investigation.

Les contrôles peuvent aussi être appliqués a posteriori lorsque les données sont ingérées directement dans un data lake brut.

L'avantage principal d'une validation en temps réel est de filtrer les enregistrements invalides avant qu'ils n'atteignent leur destination finale — data lake ou entrepôt. Cette approche est courante dans les traitements orientés événements ou temps réel, comme les événements de Change Data Capture (CDC). Dans ce type de validation, certains aspects du contrat sont vérifiés à mesure que les données circulent dans le pipeline.

Outils pour data contracts

La communauté data reconnaît progressivement les atouts des data contracts, un domaine d'ingénierie des données en constante évolution. De nombreux outils existent, certains encore émergents. dbt peut être considéré comme un cadre universel pour les data contracts.

Des contrats similaires peuvent être mis en place avec Dataform de Google à la source (couche de modèle source), c'est-à-dire une fois les données ingérées dans l'entrepôt. Nous utiliserons pour cela de simples conditions de ligne. 

Considérez l'exemple ci-dessous. Il applique des conditions de ligne à notre table :

-- my_table.sqlx
config {
 type: "table",
 assertions: {
   nonNull: ["user_id", "customer_id", "email"]
 }
}
SELECT …

Voici un autre exemple d'implémentation réalisable avec Soda.io, un framework spécialisé dans la qualité des données :

# Checks for basic validations
checks for dim_customer:
 - row_count between 10 and 1000
 - missing_count(birth_date) = 0
 - invalid_percent(phone) < 1 %:
     valid format: phone number
 - invalid_count(number_cars_owned) = 0:
     valid min: 1
     valid max: 6
 - duplicate_count(phone) = 0

En ajustant les paramètres d'alerte, vous pouvez configurer un contrôle pour qu'il émette un avertissement au lieu d'un échec. Un scan Soda exécute les contrôles spécifiés dans un accord, lit le fichier YAML ou les instructions inline, puis renvoie un résultat pour chaque contrôle : succès, échec ou erreur.

D'après mon expérience, l'adoption des data contracts reste souvent fragmentée, selon les schémas de conception de pipelines (batch ou temps réel), les choix de sérialisation et les systèmes de stockage et de traitement.

La mise en œuvre des data contracts dépend des exigences et de la logique métier.

Great Expectations, une bibliothèque Python, peut être utilisée pour implémenter des contrats au niveau sémantique. Installation via pip : pip install great_expectations. 

Après great_expectations init, nous pouvons procéder à la validation :

Using v3 (Batch Request) API
 ___              _     ___                  _        _   _
/ __|_ _ ___ __ _| |_  | __|_ ___ __  ___ __| |_ __ _| |_(_)___ _ _  ___
| (_ | '_/ -_) _ |  _| | _|\ \ / '_ \/ -_) _|  _/ _ |  _| / _ \ ' \(_-<
\___|_| \___\__,_|\__| |___/_\_\ .__/\___\__|\__\__,_|\__|_\___/_||_/__/
                               |_|
            ~ Always know what to expect from your data ~
Let's create a new Data Context to hold your project configuration.
Great Expectations will create a new directory with the following structure:
   great_expectations
   |-- great_expectations.yml
   |-- expectations
   |-- checkpoints
   |-- plugins
   |-- .gitignore
   |-- uncommitted
       |-- config_variables.yml
       |-- data_docs
       |-- validations
OK to proceed? [Y/n]:

Voyez l'extrait ci-dessous. Il explique comment créer une définition de contrôle pour la colonne price :

"expectation_type": "expect_column_values_to_match_regex",
"kwargs": {
 "column": "price",
 "mostly": 1.0,
 "regex": "^\\$([0-9],)*[0-9]+\\.[0-9]{2}$"
},

Bonnes pratiques pour les data contracts

Il n'y a pas de réponse unique car, d'expérience, la réussite d'un data contract dépend fortement du contexte métier. Pour les rendre efficaces, suivez ces bonnes pratiques clés :

  • Scalabilité : prévoyez des mécanismes d'extensibilité (par ex. on_schema_change: append) et de versionnage, permettant d'ajuster les termes sans perturber les intégrations existantes. Concevez les data contracts en anticipant les évolutions et la montée en charge. Cette approche garantit leur capacité d'adaptation.
  • Règles claires : utilisez un langage simple et précis pour éviter malentendus et interprétations. Le contrat doit être rédigé et nommé de façon accessible à toutes les parties prenantes, quel que soit leur niveau technique.
  • Collaboration : impliquez des parties prenantes variées (producteurs de données, data engineers, data scientists, métiers, IT, juridique, conformité) pour couvrir tous les angles et besoins.
  • Métadonnées : accompagnez les contrats d'une documentation et de métadonnées complètes. Décrivez champs, définitions, règles de validation et toute information utile pour une compréhension claire et une mise en œuvre fluide.
  • Revues régulières : mettez en place un dispositif de suivi et de mises à jour. Des revues périodiques assurent l'alignement continu avec les besoins métiers et la conformité aux nouvelles réglementations.

Conclusion

On observe récemment un passage à une propriété des données distribuée, où des équipes métier gèrent leurs produits de données. Ce changement a poussé les organisations à redéfinir leurs attentes en matière de qualité, formalisées via des data contracts.

Les validations sémantiques garantissent la cohérence logique des données avec la logique métier. Elles aident à vérifier les pipelines pour détecter les valeurs aberrantes, les incohérences de valeur, de lignéage et d'intégrité référentielle. Une intégrité référentielle insuffisante peut entraîner des données manquantes ou incomplètes, d'où son importance. 

La gouvernance des données peut aussi être intégrée dans des pipelines CI/CD et devient très utile lorsqu'elle précise les colonnes sensibles, les métadonnées (propriétaires, etc.) et les rôles autorisés à accéder à un produit de données. 

Les métadonnées d'un modèle, ainsi que tout autre champ meta obligatoire défini par le développeur, facilitent le suivi de la consommation de ressources et des performances du modèle. 

Les accords de niveau de service (SLA) au sein des data contracts définissent des engagements spécifiques liés à la fraîcheur, l'exhaustivité et la reprise après incident.

Les data contracts sont essentiels aux techniques de modélisation modernes et contribuent à rendre la plateforme de données robuste et scalable. Résoudre des problèmes de qualité peut coûter cher. Pour les entreprises, maximiser le retour sur investissement (ROI) des données devient crucial en tirant parti des outils existants de qualité qui prennent en charge la validation des contrats.

Devenez ingénieur en données

Faites la preuve de vos compétences en tant qu'ingénieur en données prêt à l'emploi.

FAQs

Quelle est la différence entre data contracts, validation des données et tests de données ?

Les data contracts sont des accords formels qui spécifient le format, le schéma et les protocoles d'échange entre producteurs et consommateurs de données. Ils fixent des attentes claires et des responsabilités en matière de qualité. La validation et les tests de données, eux, vérifient que les données respectent ces attentes : la validation s'assure de la conformité au contrat défini, tandis que les tests évaluent l'exactitude et la fiabilité des données.

Peut-on utiliser des data contracts dans des pipelines de streaming temps réel ?

Oui, les data contracts peuvent être utilisés dans des pipelines de streaming temps réel. Ils aident à filtrer les données invalides avant qu'elles n'atteignent leur destination, garantissant que seules les données conformes aux règles et formats prédéfinis sont traitées. Cette approche est particulièrement utile dans des contextes orientés événements ou temps réel, où l'intégrité et la fraîcheur des données sont critiques.

Comment gérer le versionnage des data contracts lorsque les schémas évoluent souvent ?

Gérer le versionnage des data contracts implique de maintenir la compatibilité ascendante et de suivre l'évolution des schémas. Une approche consiste à utiliser des schémas versionnés, où chaque version du contrat est associée à une version de schéma. Des outils comme on_schema_change: append dans dbt permettent de gérer les changements de schéma sans perturber les intégrations existantes, facilitant des transitions progressives.

Quel est le rôle des data contracts dans une architecture data mesh ?

Dans une architecture data mesh, la propriété des données est répartie entre des équipes de domaine ; les data contracts garantissent une qualité et une interopérabilité cohérentes entre domaines. Ils formalisent les attentes entre producteurs et consommateurs, alignent les équipes sur des standards communs et réduisent les risques de problèmes qualité au fil des flux inter-domaines.

Comment les data contracts aident-ils à se conformer aux réglementations de confidentialité comme le RGPD ou HIPAA ?

Les data contracts peuvent faire respecter des politiques de gouvernance, y compris les réglementations de confidentialité comme le RGPD ou HIPAA. Ils définissent des règles de masquage, de pseudonymisation et de contrôles d'accès, garantissant un traitement adéquat des données sensibles. En intégrant ces règles au contrat, les organisations automatisent des contrôles de conformité et réduisent les risques de violations.


Mike Shakhomirov's photo
Author
Mike Shakhomirov
LinkedIn

Passionnée et axée sur le numérique, je m'épanouis dans les défis du marketing numérique.

Avant de m'installer au Royaume-Uni, j'ai acquis plus de dix ans d'expérience dans les domaines de la vente, du risque bancaire et du marketing numérique, en développant une expertise en gestion des risques, en modélisation mathématique, en analyse statistique, en administration des affaires et en marketing.

Après avoir terminé mon MBA à Newcastle, j'ai maintenant envie de poursuivre une carrière dans le marketing basé sur les données, l'informatique ou l'IA, avec la possibilité de progresser vers un doctorat. Ces domaines offrent l'application pratique de la science, le développement professionnel continu, l'innovation et la possibilité de contribuer à un secteur dynamique.

Sujets
Ingénierie des données

Approfondissez le data engineering avec ces cours !

Cours

Présentation de l’ingénierie des données

2 h
373.2K
Découvrez comment les ingénieurs de données posent les bases qui rendent possible la science des données. Vous n'aurez pas à coder !
Afficher les détailsRight Arrow
Commencer Le Cours
Voir plusRight Arrow