Vai al contenuto principale
Data Engineering

Cosa sono i data contract? Guida per principianti con esempi

Raggiungere scalabilità nei sistemi dati distribuiti e ridurre gli errori.
Mike Shakhomirov's photo
Mike Shakhomirov
Aggiornato · 11 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

Crea il tuo account gratuito

Pratica and corso your progress.

Continua Con Google
Continuando, accetti i nostri Termini di utilizzo, la nostra Informativa sulla privacy e che i tuoi dati siano conservati negli Stati Uniti.

I data contract sono la spina dorsale della qualità e della scalabilità dei dati nelle soluzioni distribuite. Specificano il formato, lo schema e i protocolli che regolano lo scambio tra entità del database. Questi accordi formali eliminano ambiguità e assunzioni non documentate sui dati.

In questo articolo chiarirò il concetto di data contract offrendo sia tecniche di base sia avanzate per facilitarne un'implementazione efficace.

Capire i data contract

Un singolo data contract delinea i parametri precisi per lo scambio dati tra due modelli. Questi accordi formali assicurano che non ci siano ambiguità riguardo a formati e schemi dei dati.

La definizione e la validazione dei data contract sono fondamentali per una collaborazione efficace tra team.

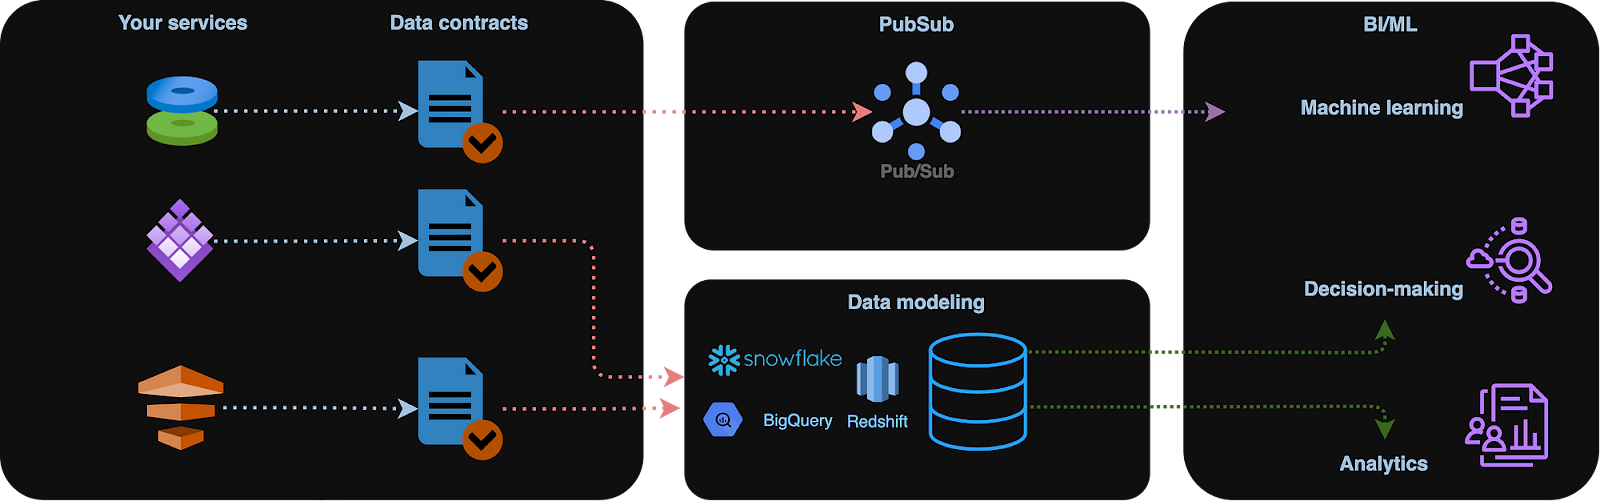
In poche parole, un data contract è un accordo formale tra il processo che modifica lo stato originale dei nostri dati (producer) e le destinazioni (consumer). È molto simile al funzionamento dei contratti commerciali: rappresentano obblighi tra fornitori e consumatori di un prodotto. I data contract fanno lo stesso con i data product, cioè tabelle, viste, modelli di dati, ecc.

L'obiettivo è ridurre le interruzioni a valle delle pipeline e rendere le trasformazioni dati stabili e affidabili.

I componenti principali di un data contract sono lo schema (colonne e formati), la parte di semantic layer (misure, calcoli e restrizioni), i service level agreement (SLA) e la data governance.

I vantaggi dei data contract includono:
  • Automazione e verifiche della qualità dei dati quando si creano o si aggiornano nuovi output.
  • Abilitare uno scaling efficiente, soprattutto per architetture dati distribuite, ad esempio il data mesh.
  • Migliorare il ciclo di sviluppo dei dati, con un focus sulla creazione di strumenti per la validazione dei contratti.
  • Favorire la collaborazione attraverso feedback tra producer e consumer di dati.

Immagine che spiega come funzionano i data contract.

Data contract. Immagine dell'autore.

Esempio di data contract con dbt

In un data contract, gli schemi definiscono i nomi degli attributi, i tipi di dato e se gli attributi sono obbligatori. Possono anche specificare formato, lunghezza e intervalli di valori accettabili per le colonne.

Consideriamo uno schema di modello dbt definito così in un file YAML. Lo schema della nostra tabella è definito sotto columns:

models:
 - name: dim_orders
   config:
     materialized: table
     contract:
       enforced: true
   columns:
     - name: order_id
       data_type: int
       constraints:
         - type: not_null
     - name: order_type
       data_type: string

Ora immaginiamo di definire il nostro modello dim_orders così:

select
 'abc123' as order_id,
 'Some order type' as order_type

Avere un contract con enforced: true nella definizione del modello genererà il seguente errore se proviamo a materializzare dim_orders in una tabella nella nostra piattaforma dati:

20:53:45  Compilation Error in model dim_customers (models/dim_orders.sql)
20:53:45    This model has an enforced contract that failed.
20:53:45    Please ensure the name, data_type, and number of columns in your contract match the columns in your model's definition.
20:53:45
20:53:45    | column_name | definition_type | contract_type | mismatch_reason    |
20:53:45    | ----------- | --------------- | ------------- | ------------------ |
20:53:45    | order_id    | TEXT            | INT           | data type mismatch |
20:53:45
20:53:45
20:53:45    > in macro assert_columns_equivalent (macros/materializations/models/table/columns_spec_ddl.sql)

Lo stesso accadrebbe con colonne extra, controlli SLA e metadati mancanti, qualora scegliessimo di definirli.

Un esempio dbt più avanzato includerebbe vincoli di modello applicati:

# models/schema.yaml
models:
 - name: orders
  
   # required
   config:
     contract:
       enforced: true
  
   # model-level constraints
   constraints:
     - type: primary_key
       columns: [id]
     - type: FOREIGN_KEY # multi_column
       columns: [order_type, SECOND_COLUMN, ...]
       expression: "OTHER_MODEL_SCHEMA.OTHER_MODEL_NAME (OTHER_MODEL_FIRST_COLUMN, OTHER_MODEL_SECOND_COLUMN, ...)"
     - type: check
       columns: [FIRST_COLUMN, SECOND_COLUMN, ...]
       expression: "FIRST_COLUMN != SECOND_COLUMN"
       name: HUMAN_FRIENDLY_NAME
     - type: ...
  
   columns:
     - name: FIRST_COLUMN
       data_type: DATA_TYPE
      
       # column-level constraints
       constraints:
         - type: not_null
         - type: unique
         - type: foreign_key
           expression: OTHER_MODEL_SCHEMA.OTHER_MODEL_NAME (OTHER_MODEL_COLUMN)
         - type: …

Fornire una definizione di schema come insieme di regole e vincoli applicati alle colonne di un dataset offre informazioni molto importanti per l'elaborazione e l'analisi dei dati.

Gli schemi tendono a cambiare nel tempo.

È uno scenario comune. Immaginiamo che alla nostra tabella sorgente venga aggiunta una colonna contrattualizzata extra:

select
 'abc123' as order_id,
 'Some order type' as order_type,
 'USD' as currency

È essenziale considerare i cambiamenti di schema durante gli aggiornamenti incrementali perché, altrimenti, l'output del modello incrementale a valle invaliderebbe il contratto. 

Questo si può risolvere aggiungendo on_schema_change: append alla strategia incrementale di dbt.

Le validazioni di schema possono essere esplicite o implicite.

Alcuni formati file big data, come AVRO e Parquet, supportano di default uno schema a bordo e definizioni implicite, quindi non servono validazioni esterne aggiuntive.

Al contrario, formati file senza schema come JSON richiedono una validazione esterna. Alcune librerie Python, come pydantic o un semplice @dataclass, possono occuparsene:

from pydantic import BaseModel
class ConnectionDataRecord(BaseModel):
   user: str
   ts: int
record = ConnectionDataRecord(user="user1", ts=123456789)

Se infrangiamo le regole assegnando valori che non rispettano i criteri, verrà sollevata un'eccezione. Ad esempio, l'eccezione verrà generata se proviamo a chiamare ConnectionDataRecord('', 1).

Data contract semantici

Le validazioni semantiche garantiscono che i dati siano logicamente coerenti e allineati alla logica di business.

Le validazioni semantiche devono essere applicate esplicitamente.

Infatti, a differenza dei controlli di schema, i data contract semantici si basano sulla logica di business e vanno implementati esternamente.

In molti casi d'uso, la semantica appare come un'estensione dei contratti validati dallo schema. Spesso dipende da regole di business e rappresenta un insieme di condizioni di riga a cui il nostro modello dati deve conformarsi. 

Un esempio di contratto semantico può essere il seguente:

  • Deviazione metrica: dalla media mobile o da un'altra soglia. Possiamo tollerare che il numero di utenti attivi di ieri scenda sotto il 75% della media mobile a 7 giorni, ma non accetteremo lo 0%.
  • Logica di business: flag di allerta nel monitoraggio delle transazioni e punteggi di prevenzione frodi. In questo scenario, il payout deve essere 0.
  • Data lineage: descrive come si evolvono le entità dati. Per esempio, transaction_completed_at non può avvenire prima di created_at.
  • Integrità referenziale: le relazioni tra entità sono importanti e possono essere descritte anche con contratti semantici. Considera il codice dbt sotto: spiega che ogni refund_id di un rimborso punta a un transaction.id valido.
- name: refunds
   enabled: true
   description: An incremental table
 columns:
     - name: refund_id
       tests:
         - relationships:
             tags: ['relationship']
             to: ref('transactions')
             field: id

Spetta all'utente finale impostare il livello di allerta sui contratti semantici, spesso implementato con test di qualità dati personalizzati.

Varie regole di logica di business fanno spesso riferimento all'integrità dei dati. Scenari di dati illogici possono emergere da errori di configurazione di database e server o dall'iniezione involontaria di dati di test in produzione. I controlli di integrità servono a validare i dati rispetto a tali regole, aiutando a identificare valori anomali o illogici.

Le entità del database sono sempre correlate tra loro. Questo si chiama relazione tra entità ed è spesso rappresentata da un entity relationship diagram (ERD). Un'inadeguata integrità referenziale può portare a problemi come dati mancanti o incompleti. I data contract devono affrontare questi potenziali rischi per garantire integrità e accuratezza dei dati.

Per esempio, una relazione comune è l'associazione uno-a-molti tra customers e orders, dove un singolo cliente può avere più orders. In tale scenario, un ordine è valido solo se contiene un customer_id valido all'interno del dataset customers.

Questo tipo di vincolo, un vincolo di integrità referenziale, assicura che la relazione tra entità sia mantenuta correttamente.

Service Level Agreement (SLA) nei data contract

Gli SLA sono un livello extra di controlli di qualità dati che si possono implementare tramite data contract.

Gli SLA si riferiscono alla freschezza dei dati.

Poiché i modelli dati vengono aggiornati regolarmente con nuovi dati, gli SLA possono includere controlli sull'orario limite entro il quale si prevede la disponibilità dei nuovi dati o sul ritardo massimo consentito. In dbt, ad esempio, si può ottenere con i test di freschezza:

- name: orders
   enabled: true
   description: A source table declaration
   tests:
     - dbt_utils.recency: # https://github.com/dbt-labs/dbt-utils#recency-source
         tags: ['freshness']
         datepart: day
         field: timestamp
         interval: 1

Supponiamo di voler generare un report sui dati di ieri; per farlo vogliamo assicurarci che i dati esistano. Sarebbe infatti strano non vedere i nuovi ordini per alcuni giorni o più.

Nell'esempio seguente possiamo testare il nostro dataset per ritardi imprevisti degli ordini usando la configurazione dei test in dbt. Questo ti permette di selezionare e referenziare il test usando quel nome specifico.

version: 2
models:
 - name: orders
   columns:
     - name: status
       tests:
         - accepted_values:
             name: unexpected_order_status_today
             values: ['placed', 'shipped', 'completed', 'returned']
             config:
               where: "order_date = current_date"

Definendo un nome personalizzato, hai il pieno controllo su come il test viene mostrato nei log e negli artefatti di metadati.

Allo stesso modo, nelle pipeline in tempo reale, i dati in genere non dovrebbero essere più vecchi di poche ore. Gli SLA sono cruciali per le applicazioni di stream processing, dove i dati vengono elaborati in tempo reale con latenze di minuti o addirittura secondi.

Nelle app di streaming vogliamo verificare il ritardo massimo consentito per eventi in arrivo in ritardo e metriche come Mean Time Between Failures (MTBF) e Mean Time to Recovery (MTTR). Implementarlo implica tracciare meticolosamente gli incidenti ed estrarre i dati rilevanti da strumenti di monitoring e incident management come PagerDuty, Datadog e Grafana.

Data governance contract

La gestione corretta delle informazioni personali identificabili (PII) è parte integrante del processo di trasformazione dei dati. Per molte aziende è fondamentale che questi dataset siano almeno conformi al GDPR e rispettino normative sulla privacy come HIPAA o PCI DSS.

I data governance contract garantiscono che siano in atto adeguate politiche di pseudonimizzazione o di data masking. 

Considera il codice dbt qui sotto. I contratti applicati come tests richiedono che user_email sia un hash SHA256 (mascherato):

models:
 - name: customer_data
   columns:
       - name: user_email
         tests:
           - dbt_expectations.expect_column_values_to_not_match_regex:
               regex: "^(?!.*\b@\b).* # Ensure identifiers do not contain emails
               flags: i # Case-insensitive matching

D'altra parte, potremmo voler imporre il pattern matching per altre tabelle. Per esempio, nell'esempio seguente, il campo transaction_reference deve seguire il pattern [“TRX-%”, “%-2023”]:

models:
 - name: transaction_data
   columns:
       - name: transaction_reference
         tests:
           - dbt_expectations.expect_column_values_to_match_like_pattern_list:
               like_pattern_list: ["TRX-%", "%-2023"]
               match_on: any

I data governance contract possono essere utili anche quando includono colonne con dati sensibili, metadati (proprietari dei dati, ecc.) e ruoli utente autorizzati ad accedere a un data product.

Per esempio, possiamo indicare l'owner del nostro modello e lo stadio del ciclo di vita dello sviluppo usando il campo meta in dbt:

# models/schema.yaml
version: 2
models:
 - name: users
   meta:
     owner: "@data_mike"
     model_maturity: in dev
     contains_pii: true
   columns:
     - name: email
       meta:
       contains_pii: true

Il campo meta ti consente di impostare metadati per una risorsa, che vengono poi compilati nel file manifest.json generato da dbt e possono essere visualizzati nella documentazione generata automaticamente. 

Possiamo usare pacchetti come dbt-checkpoint per scansionarlo durante la pull request e assicurarci che i campi meta obbligatori siano presenti. L'hook fallisce se un qualsiasi modello (dal manifest o dai file YAML) non ha le chiavi meta specificate.

Le chiavi meta del modello devono essere nel file YAML o nel manifest.

Pattern di implementazione dei data contract

La validazione dei contratti può essere eseguita nelle pipeline di streaming (per riga) prima dell'ingestione dei dati e dopo — alla sorgente (layer del modello dati sorgente).

Quando ingestiamo i dati "as is", il processo di validazione agisce come uno step di trasformazione, applicando le regole del contratto e filtrando i dati non validi, ad esempio in una vista o tabella dedicata dove i dati possono essere analizzati ulteriormente.

I controlli di validazione possono essere applicati post-facto quando i dati vengono ingestiti direttamente in un data lake grezzo.

Il principale vantaggio della validazione dei data contract in tempo reale è la capacità di filtrare i record non validi prima che raggiungano la destinazione finale — un data lake o un data warehouse. Questo approccio è comune nei processi event-driven o real-time, come gli eventi di Change Data Capture (CDC). In questo tipo di validazione, alcuni aspetti del contratto vengono verificati mentre i dati scorrono nella pipeline.

Strumenti per i data contract

La community dei dati sta gradualmente riconoscendo i potenziali benefici dei data contract, un'area dell'ingegneria dei dati in continua evoluzione. Esistono molti strumenti in questo spazio, alcuni ancora nelle fasi iniziali. dbt può essere considerato un framework universale per i data contract.

Contratti simili possono essere implementati usando Dataform di Google alla sorgente (layer del modello dati sorgente), cioè quando i dati sono stati ingestiti con successo nel nostro data warehouse. In questo caso useremmo semplici condizioni di riga. 

Considera l'esempio qui sotto. Applica alcune condizioni di riga alla nostra tabella:

-- my_table.sqlx
config {
 type: "table",
 assertions: {
   nonNull: ["user_id", "customer_id", "email"]
 }
}
SELECT …

Qui sotto c'è un altro esempio di implementazione di data contract, ottenibile con Soda.io, un framework di qualità dei dati di nicchia:

# Checks for basic validations
checks for dim_customer:
 - row_count between 10 and 1000
 - missing_count(birth_date) = 0
 - invalid_percent(phone) < 1 %:
     valid format: phone number
 - invalid_count(number_cars_owned) = 0:
     valid min: 1
     valid max: 6
 - duplicate_count(phone) = 0

Regolando le impostazioni di allerta puoi configurare un controllo perché emetta un avviso invece di fallire la validazione. Una scansione Soda esegue i controlli specificati in un accordo, controlla il file YAML o inline all'interno di un'invocazione programmatica e restituisce per ciascun controllo un risultato: pass, fail o error.

Per esperienza, l'introduzione dei data contract in molte aziende resta frammentata, a seconda di fattori come i pattern di progettazione delle pipeline (batch o real-time), le scelte di serializzazione dei dati e i sistemi usati per storage ed elaborazione.

L'implementazione dei data contract dipende dai requisiti e dalla logica di business.

Great Expectations, una libreria Python, può essere usata per implementare data contract a livello semantico. Si installa con pip: pip install great_expectations. 

Dopo aver eseguito great_expectations init, possiamo procedere con la validazione dei dati:

Using v3 (Batch Request) API
 ___              _     ___                  _        _   _
/ __|_ _ ___ __ _| |_  | __|_ ___ __  ___ __| |_ __ _| |_(_)___ _ _  ___
| (_ | '_/ -_) _ |  _| | _|\ \ / '_ \/ -_) _|  _/ _ |  _| / _ \ ' \(_-<
\___|_| \___\__,_|\__| |___/_\_\ .__/\___\__|\__\__,_|\__|_\___/_||_/__/
                               |_|
            ~ Always know what to expect from your data ~
Let's create a new Data Context to hold your project configuration.
Great Expectations will create a new directory with the following structure:
   great_expectations
   |-- great_expectations.yml
   |-- expectations
   |-- checkpoints
   |-- plugins
   |-- .gitignore
   |-- uncommitted
       |-- config_variables.yml
       |-- data_docs
       |-- validations
OK to proceed? [Y/n]:

Considera lo snippet di codice qui sotto. Spiega come creare una definizione di controllo per la colonna price:

"expectation_type": "expect_column_values_to_match_regex",
"kwargs": {
 "column": "price",
 "mostly": 1.0,
 "regex": "^\\$([0-9],)*[0-9]+\\.[0-9]{2}$"
},

Best practice per i data contract

Non esiste una risposta giusta o sbagliata perché, per esperienza, un'implementazione di successo dei data contract dipende molto dai requisiti di business. Per farli funzionare in modo efficace, segui queste best practice chiave:

  • Scalabilità: consiglio di aggiungere meccanismi di estensibilità (ad es. on_schema_change: append) e versionamento, che consentano di modificare i termini del contratto senza interrompere le integrazioni esistenti. Progetta i data contract pensando a cambiamenti futuri e scalabilità. Questo approccio assicura che il contratto possa adattarsi a esigenze ed evoluzioni.
  • Regole chiare: usa un linguaggio semplice e conciso nel data contract per evitare fraintendimenti. Il contratto dovrebbe essere scritto e nominato in modo accessibile e comprensibile a tutte le parti coinvolte, a prescindere dal loro livello tecnico.
  • Collaborazione: lo sforzo collaborativo garantisce una comprensione completa dei requisiti, coprendo prospettive e bisogni diversi. Quando crei data contract, coinvolgi stakeholder eterogenei, inclusi data producer, data engineer, data scientist e rappresentanti di business, IT, legale e compliance.
  • Metadati: fornisci ai data contract documentazione e metadati accurati. Una documentazione completa facilita l'applicazione e la manutenzione del contratto. Dovrebbe includere descrizioni dettagliate, definizioni dei campi, regole di validazione e altre informazioni rilevanti per supportare una chiara comprensione e un'implementazione efficace.
  • Revisioni regolari: un riesame continuo aiuta a mantenere rilevanza ed efficacia del contratto nel tempo. Implementa un approccio strutturato per il monitoraggio e gli aggiornamenti dei data contract. Revisioni regolari assicurano che il contratto resti aggiornato, allineato ai requisiti di business in evoluzione e conforme a nuove o mutate normative.

Conclusione

Di recente si è verificato un passaggio verso una proprietà distribuita dei dati, dove i team di dominio sono responsabili dei propri data product. Questo cambiamento ha costretto le organizzazioni a ridefinire le aspettative sulla qualità, formalizzate tramite i data contract.

Le validazioni semantiche assicurano che i dati siano logicamente coerenti e allineati alla logica di business. Aiutano a controllare le pipeline per eventuali outlier in termini di dati, valori, lineage e integrità referenziale. Un'integrità referenziale inadeguata può portare a dati mancanti o incompleti, per questo è importante. 

I data governance contract possono essere implementati anche nelle pipeline CI/CD e risultano molto utili quando indicano colonne con dati sensibili, metadati (proprietari dei dati, ecc.) e ruoli utente autorizzati ad accedere a un data product. 

I metadati di un modello, insieme a eventuali altri campi meta obbligatori definiti dallo sviluppatore, aiutano a monitorare l'uso delle risorse e le prestazioni del modello. 

I Service Level Agreement (SLA) all'interno dei data contract definiscono impegni specifici relativi a freschezza, completezza e ripristino in caso di errore.

I data contract sono fondamentali per le tecniche moderne di modellazione dei dati e aiutano a garantire che la piattaforma sia resiliente agli errori e si scali bene. Risolvere problemi di qualità può essere costoso. Per le aziende enterprise, massimizzare il ritorno sull'investimento (ROI) dai dati diventa sempre più importante sfruttando gli strumenti di qualità esistenti che supportano la validazione dei data contract.

FAQ

In cosa differiscono i data contract dalla validazione e dal testing dei dati?

I data contract sono accordi formali che specificano formato, schema e protocolli di scambio tra producer e consumer di dati. Stabiliscono aspettative e responsabilità chiare sulla qualità dei dati. La validazione e il testing dei dati, invece, sono processi che verificano se i dati rispettano tali aspettative. La validazione assicura la conformità al contratto definito, mentre il testing valuta accuratezza e affidabilità dei dati.

I data contract possono essere usati nelle pipeline di streaming in tempo reale?

Sì, i data contract possono essere utilizzati nelle pipeline di streaming in tempo reale. Aiutano a filtrare i dati non validi prima che raggiungano la destinazione, assicurando che vengano elaborati solo dati conformi a regole e formati predefiniti. Questo approccio è utile nei processi event-driven o real-time, dove integrità e tempestività dei dati sono critiche.

Come gestisci il versioning nei data contract quando gli schemi cambiano spesso?

Gestire il versioning nei data contract significa mantenere la compatibilità all'indietro e tracciare l'evoluzione degli schemi. Un approccio è usare schemi versionati, dove ogni versione del contratto è associata a una specifica versione di schema. Strumenti come on_schema_change: append in dbt aiutano a gestire i cambiamenti di schema senza interrompere le integrazioni esistenti, consentendo transizioni e aggiornamenti graduali.

Che ruolo hanno i data contract in un'architettura data mesh?

In un'architettura data mesh, la proprietà dei dati è distribuita tra i team di dominio; i data contract assicurano qualità e interoperabilità coerenti tra domini. Formalizzano le aspettative tra producer e consumer, aiutando ad allineare i team sugli standard dei dati e riducendo il rischio di problemi di qualità quando i dati fluiscono tra domini diversi.

Come possono i data contract aiutare a rispettare normative sulla privacy come GDPR o HIPAA?

I data contract possono far rispettare politiche di data governance, incluse normative sulla privacy come GDPR o HIPAA. Possono definire regole per data masking, pseudonimizzazione e controlli di accesso, assicurando che i dati sensibili siano gestiti correttamente. Integrando tali regole nel contratto, le organizzazioni possono automatizzare i controlli di conformità e ridurre il rischio di violazioni della privacy.


Mike Shakhomirov's photo
Author
Mike Shakhomirov
LinkedIn

Appassionato e con una forte attenzione al digitale, do il meglio di me nelle sfide del digital marketing.

Prima di trasferirmi nel Regno Unito, ho maturato oltre dieci anni di esperienza in vendite, rischio nel corporate banking e digital marketing, sviluppando competenze in risk management, modellazione matematica, analisi statistica, amministrazione aziendale e marketing.

Dopo aver completato il mio MBA a Newcastle, ora sono desideroso di intraprendere una carriera nel marketing data-driven, nell'informatica o nell'AI, con la possibilità di progredire fino a un dottorato. Questi ambiti offrono l'applicazione pratica della scienza, sviluppo professionale continuo, innovazione e l'opportunità di contribuire a un settore dinamico.

Argomenti
Data Engineering

Scopri di più sull'ingegneria dei dati con questi corsi!

Corso

Capire il Data Engineering

2 ore
378K
Scopri come i data engineer pongono le basi per rendere possibile la data science, senza necessità di programmare.
Vedi i dettagliInizia Il Corso

Crea il tuo account gratuito

Pratica and corso your progress.

Continua Con Google
Continuando, accetti i nostri Termini di utilizzo, la nostra Informativa sulla privacy e che i tuoi dati siano conservati negli Stati Uniti.
Mostra altro
Correlato

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

Mostra altro

