
Gemini 3.1 Pro antwoordde correct [Red Square]. Het model identificeerde beide regels onafhankelijk: kleuren schakelen om (Red ↔ Blue) en vormen cyclen (Square → Circle → Triangle → Square). Daarna liep het stap voor stap door de logica heen en liet zien hoe Blue Triangle Red wordt (kleurtoggle) en Square (volgende in de vormcyclus), precies het soort compositioneel redeneren waar deze test op mikt.
Test 2: De vermomde reeks
Deze test controleert hypothese-eliminatie over meerdere lagen. We geven het model twee reeksen en vragen het te identificeren wat de eerste reeks is (partitiegetallen uit de OEIS) en de twee transformaties te bepalen die zijn toegepast om de tweede te produceren.
Here are two sequences. The second was derived from the first in two separate steps.
Identify the named mathematical sequence that Sequence A belongs to, and work out
both transformations that were applied to produce Sequence B.
Sequence A: 1, 1, 2, 3, 5, 7, 11, 15, 22, 30, 42, 56, 77
Sequence B: 2, 3, 5, 8, 3, 9, 8, 1, 7, 9, 8, 7
Explain your reasoning step by step.Gemini 3.1 Pro identificeerde Reeks A correct als partitiegetallen (A000041) en legde uit wat partitiegetallen in de getaltheorie voorstellen. Vervolgens werkte het systematisch beide transformaties uit: eerst somde het opeenvolgende paren op om een tussensequentie te genereren, daarna berekende het de digitale wortel van elk resultaat. Het model verifieerde elke stap ten opzichte van Reeks B en toonde zo de volledige redeneerketen van de oorspronkelijke reeks naar de uiteindelijke output.
Test 3: Het kapotte kloknetwerk
Deze test richt zich op het controleren van consistentie van constraints. Zes klokken zijn verbonden in een netwerk, elk met een vaste offset van 20 minuten. Eén klok is kapot. Het model moet beide paden door het netwerk volgen en de tegenstrijdigheid vinden.
Dit was de prompt die ik gebruikte:
Six clocks (A, B, C, D, E, and F) are connected in a network. Each clock applies
a fixed offset to the time it receives. A is the root and shows 12:00. You observe:
- B receives from A and shows 12:20
- C receives from A and shows 11:40
- D receives from B and shows 12:40
- E receives from C and shows 11:00
- F receives from both D and E and shows 13:00
There is exactly one broken clock in the network. Based on the pattern of offsets,
identify which clock is broken, and give two possible answers for what it should
actually show (one for each path through the network).
Explain your reasoning step by step.Gemini 3.1 Pro identificeerde F correct als de kapotte klok en leidde twee mogelijke waarden af: 13:00 via het pad van D en 10:00 via het pad van E. Het model behandelde het rechterpad als een constante offset van +20 minuten en het linkerpad als een rekenkundige reeks van −20, −40 en vervolgens −60 minuten.
Hands-on met Gemini 3.1 Pro
Naast abstracte redeneertests wilde ik zien hoe het model praktische taken aanpakt die de nieuwe functies laten zien.
Geanimeerde SVG-generatie
Google maakte bij de lancering veel werk van visuele output op basis van code, dus ik testte dit direct met een eenvoudige opdracht en zonder template.
Dit was de prompt die ik gebruikte:
Create an animated SVG loading spinner with three bouncing dots. Make it smooth,
professional, and suitable for embedding on a website. Output only the SVG code.Gemini 3.1 Pro gaf schone SVG-code terug met CSS-animaties. De output was een werkende loader met drie stippen met versprongen springtiming, precies wat gevraagd werd. Hij renderde in één keer correct in de browser, zonder aanpassingen. De bestandsgrootte was piepklein en omdat het vectorgebaseerde code is, schaalt het perfect naar elk formaat.
Dit is zo’n functie die in een persbericht gimmicky klinkt, maar in de praktijk heel bruikbaar is. Lichtgewicht, insluitbare, oneindig schaalbare geanimeerde graphics vanuit een tekstprompt zijn een solide tool voor frontend-prototyping of snelle visuele assets.
Hoe krijg ik toegang tot Gemini 3.1 Pro?
Gemini 3.1 Pro is momenteel in preview. Google heeft aangegeven dat het snel algemeen beschikbaar wordt, nadat feedback is verwerkt en verdere verbeteringen voor agentische workflows zijn doorgevoerd.
Dit zijn de belangrijkste toegangsopties:
Gemini CLI
De Gemini CLI is een open-source terminalagent die het model directe toegang geeft tot je lokale omgeving. Installeer met de volgende code:
npm install -g @google/gemini-cli
# Or run directly: npx @google/gemini-cliDe CLI gebruikt een ReAct-loop, wat betekent dat het code kan schrijven, uitvoeren, fouten lezen, issues oplossen en zelfstandig itereren. Met de verbeterde terminal-codingprestaties van 3.1 Pro is deze loop merkbaar betrouwbaarder. De gratis laag geeft je 60 requests per minuut en 1.000 requests per dag.
Gemini API
De Gemini API geeft developers directe programmatische toegang tot Gemini 3.1 Pro.
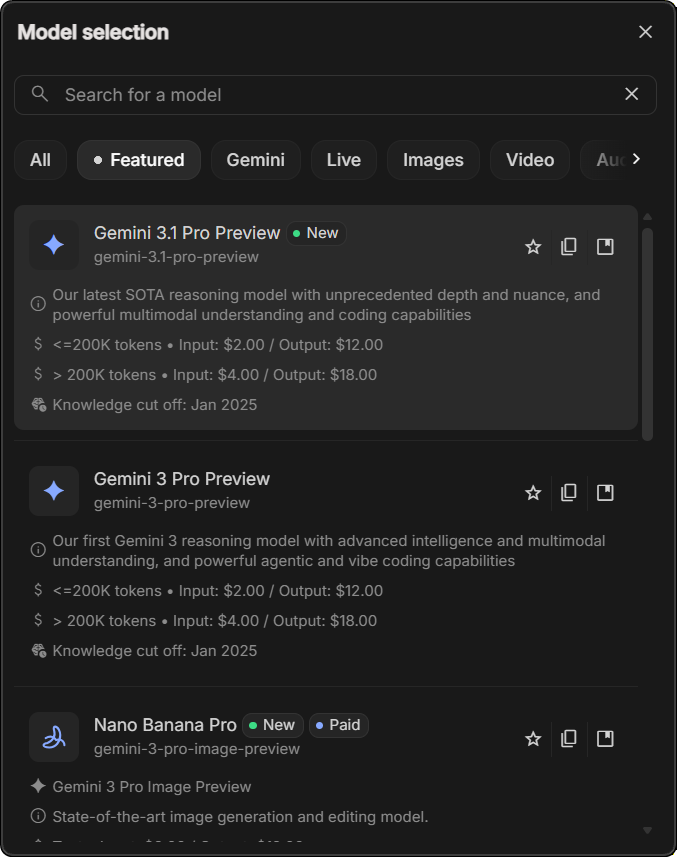
Het model-ID dat je wilt gebruiken is: gemini-3.1-pro-preview
Hier is wat Python-code om je op weg te helpen:
from google import genai
client = genai.Client()
response = client.models.generate_content(
model="gemini-3.1-pro-preview",
contents="Your prompt here"
)
print(response.text)De prijzen zijn hetzelfde als Gemini 3 Pro Preview.
|
Contextgrootte |
Input (per 1M tokens) |
Output (per 1M tokens) |
|
≤200K tokens |
$2.00 |
$12.00 |
|
>200K tokens |
$4.00 |
$18.00 |
De thinking_level-parameter accepteert low, medium, high of max. Ondersteunde tools zijn onder meer Google Zoeken, URL-context, code-executie en bestandszoekopdrachten. Ik kom hieronder in de vergelijkingssectie terug op de details van het contextvenster.
NotebookLM
NotebookLM draait nu op Gemini 3.1 Pro voor Google AI Pro- en Ultra-abonnees. NotebookLM reageert alleen op basis van documenten die je uploadt, waardoor het een erg nuttige researchtool is wanneer je wilt dat het model bij specifieke materialen blijft.
Toegang voor consumenten
Google is begonnen met het uitrollen van Gemini 3.1 Pro in zijn consumenten- en developerproducten, maar heeft geen eenvoudige “plan X = model Y”-mapping gepubliceerd. In de praktijk kom je 3.1 Pro tegen in de Gemini-app en API naarmate de uitrol vordert, waarbij AI Ultra de breedste toegang biedt.
|
Abonnement |
Maandprijs (VS) |
Wat je krijgt met betrekking tot Gemini |
|
Gratis |
$0 |
Gemini 3 Flash in de Gemini-app, beperkte functies |
|
Google AI Pro |
$19.99 |
Hogere limieten en toegang tot Gemini Pro-modellen in de Gemini-app |
|
Google AI Ultra |
$249.99 (vaak afgeprijsd tot $124.99 voor de eerste 3 maanden) |
Hoogste limieten, Deep Think-modus en toegang tot Google’s nieuwste AI-functies in producten |
Gemini 3.1 Pro vs. Claude-modellen
De releases van februari 2026 van Google en Anthropic zorgen voor een interessante reeks afwegingen. Dit zijn geen situaties waarin één model duidelijk wint. De juiste keuze hangt sterk af van wat je bouwt.
Het prijsverschil is het benoemen waard. Gemini 3.1 Pro is veel goedkoper in zowel input als output dan Claude Opus 4.6. Als je veel API-calls draait, is dat geen klein verschil.
Kies Gemini 3.1 Pro wanneer:
- Abstract redeneren en wetenschappelijke analyse prioriteit hebben
- Je robuuste, native multimodale ondersteuning voor video en audio in hetzelfde model nodig hebt
- Je het volledige 1M-contextvenster in stabiele, niet-bètavorm wilt
- Kosten efficiëntie belangrijk is, vooral op schaal
Kies Claude Opus 4.6 wanneer:
- Je de volledige 128K outputtokens nodig hebt (Gemini heeft een limiet van 64K)
- Multi-agentorkestratie centraal staat in je workflow (Agent Teams is een echt onderscheidend vermogen)
- Computergebruik via GUI belangrijk is
- Je kennisintensief werk doet waarbij diepe onderzoekskwaliteit telt
Kies Claude Sonnet 4.6 wanneer:
- Kenniswerk, documentanalyse of financiële analyse de hoofdtaken zijn
- Je bijna-vlaggenschipprestaties wilt tegen een lagere prijs
- Je al Anthropic-tools gebruikt en Sonnet je standaard is
Use-cases voor Gemini 3.1 Pro
Op basis van de benchmarks en hands-on tests zijn dit de gebieden waar Gemini 3.1 Pro bijzonder geschikt voor is:
- Wetenschappelijk onderzoek en analyse: Sterke GPQA Diamond-prestaties plus een 1M-contextvenster maken het praktisch voor literatuuronderzoek, hypothesevorming en synthese over meerdere papers tegelijk.
- Autonome onderzoeksagents: Verbeterde agent-benchmarks vertalen zich naar echte meerstapstaken zoals informatie verzamelen uit meerdere bronnen, feiten verifiëren en gestructureerde rapporten produceren met minimale supervisie.
- Codebase-analyse en refactoring: Een groot contextvenster plus verbeterd redeneren helpt bij taken zoals architectonische inconsistenties tussen modules identificeren of bugs door meerdere bestanden heen traceren.
- Multimodale contentanalyse: Native video- en audio-ondersteuning maakt het mogelijk om opgenomen meetings te analyseren, inzichten uit collegevideo’s te halen of podcasts te verwerken zonder preprocessing.
- Kostengevoelige productie-implementaties: Met ongeveer de helft van de kosten van Claude Opus 4.6 is het logisch voor inference op grote schaal waarbij redeneerkwaliteit telt maar het budget beperkt is.
- Prototyping en visuele assets: Geanimeerde output op basis van code genereert loading spinners, geanimeerde grafieken of interactieve dashboards vanuit tekstprompts die je direct kunt insluiten.
Tot slot
Gemini 3.1 Pro laat goed zien waar deze modellen naartoe gaan. Minder focus op nieuwe invoertypes, meer focus op beter redeneren, betrouwbaardere agents en langere contexten. Ook al is het “maar” een .1-release, de benchmarkverbeteringen en de link met Deep Think laten het aanvoelen als een grotere stap voorwaarts in hoe deze systemen denken.
Voor teams die echte producten bouwen, is er geen enkel “beste” model. Gemini 3.1 Pro werkt goed voor wetenschappelijk redeneren, onderzoeksagents en het analyseren van grote codebases, zeker als je prijs en videosteun meeneemt. Claude is nog steeds beter voor kenniswerk en computers bedienen via het scherm, en GPT-5.3-Codex wint nog op sommige codetests.
De interessante vraag is wat er gebeurt als het de preview verlaat. Google zegt te werken aan agent-verbeteringen vóór de volledige release. Als die samen met de huidige redeneerupgrades verschepen, wordt de kloof tussen onderzoeksmodellen zoals Deep Think en alledaagse modellen kleiner. Voor nu is dit een goed moment om verschillende modellen te proberen en systemen te bouwen die benutten waar elk model het beste in is.
Om te starten met Google’s AI-tools, bekijk onze Introductie tot Google Gemini-cursus. Voor werken met de API in Python behandelt onze Werken met de Gemini API-tutorial de essentie.
Ik ben een data-engineer en communitybouwer die werkt aan datapijplijnen, cloud en AI-tools, en tegelijkertijd praktische, impactvolle tutorials schrijft voor DataCamp en beginnende developers.
Gemini 3.1 FAQs
Is Gemini 3.1 Pro gratis te gebruiken?
Je kunt het gratis testen via Google AI Studio met dagquota. Voor productiegebruik heb je een betaald abonnement nodig. Google AI Pro kost $19,99/maand en Google AI Ultra $249,99/maand (vaak afgeprijsd tot $124,99 voor de eerste 3 maanden). De gratis Gemini-app gebruikt standaard Gemini 3 Flash, niet 3.1 Pro.
Wat is het verschil tussen Gemini 3.1 Pro en Deep Think?
Deep Think is de versie uit het onderzoekslab: trager, duurder, maar scoort hoger op redeneerbenchmarks. Gemini 3.1 Pro neemt diezelfde intelligentie-upgrades en maakt ze snel en betaalbaar genoeg voor dagelijks gebruik. Zie het als de production-ready versie van dezelfde kerntechnologie.
Begrijpt het daadwerkelijk video, of extraheert het alleen frames?
Gemini 3.1 Pro is een native multimodaal model dat video als input kan nemen naast tekst, afbeeldingen en audio. In de praktijk kun je een opname uploaden en vragen stellen over zowel wat er gezegd wordt als wat er op het scherm te zien is. Concurrerende modellen zijn nog beperkter in hoe breed ze videobegrip aan eindgebruikers aanbieden.
Hoe verhoudt het 1M-contextvenster zich tot dat van Claude?
Zoals ik in de vergelijkingssectie noemde, is Gemini’s 1M-venster stabiel en production-ready, terwijl dat van Claude momenteel in bèta is. De maximale output per request is 64K tokens.
Wanneer verlaat het de preview?
Google heeft geen datum genoemd, maar zegt te werken aan agent-verbeteringen vóór de GA-release. Op basis van eerdere patronen duren previewperiodes meestal een paar maanden.


De AI-race in februari 2026 was uitzonderlijk intens. Nadat Anthropic binnen twee weken Claude Opus 4.6 en Claude Sonnet 4.6 uitbracht, kwam Google met een tegenzet: Gemini 3.1 Pro.
Volgens Google is dit een belangrijke release, vooral omdat Gemini 3.1 Pro zijn redeneerprestatie meer dan verdubbelde ten opzichte van Gemini 3 Pro, gemeten met de ARC-AGI-2-benchmark, waarop het een geverifieerde score van 77,1% behaalde.
ARC-AGI-2 is belangrijk omdat het nieuwe patroonherkenning test in plaats van geparafraseerde kennis. Het is zó ontworpen dat modellen in de traditionele zin niet simpelweg kunnen trainen naar een hoge score. Een verdubbeling op deze test is dus betekenisvoller dan een verdubbeling op bijvoorbeeld MMLU. We gaan later dieper in op het belang van dit resultaat en testen het zelfs zelf.
Wil je meer weten over het AI-ecosysteem van Google? Bekijk dan onze gidsen over Gemini 3.5 Flash, Gemini Omni, Gemini Spark, NotebookLM, en Nano Banana 2, en ook onze Antigravity CLI-tutorial. Zorg er óók voor dat je onze gids bekijkt over de sterkste concurrenten van Gemini, OpenAI’s GPT-5.5, en Claude Opus 4.8.
We houden onze lezers op de hoogte van het laatste AI-nieuws via The Median, onze gratis vrijdagse nieuwsbrief die de belangrijkste verhalen van de week uiteenzet. Abonneer je en blijf scherp in een paar minuten per week:
Wat is Gemini 3.1 Pro?
Gemini 3.1 Pro is Google’s nieuwste vlaggenschipmodel, gelanceerd als preview op 19 februari 2026. Het is de eerste keer dat Google een “.1”-versietoename gebruikt (alle eerdere tussentijdse updates gebruikten “.5”), wat duidt op een gerichte intelligentie-upgrade in plaats van een brede functiewijziging. Dat is logisch, want Gemini 3 was al een omvangrijke release met een nieuwe multimodale architectuur.
In Google’s aankondiging staat dat de intelligentie achter Deep Thinks recente wetenschappelijke doorbraken, waaronder het weerleggen van een decenniaoude wiskundige hypothese, nu is gedestilleerd in 3.1 Pro voor dagelijks gebruik.
Deep Think was technisch gezien al beschikbaar, maar alleen met een Ultra-abonnement. Google wil je doen geloven dat het doel altijd is geweest om dit redeneervermogen op schaal naar alledaags gebruik te brengen, maar pas met deze release van Gemini 3.1 lijkt het erop dat ze dat eindelijk waarmaken. Misschien ontdekte Google dat het Ultra-abonnement van $249/maand meer was dan mensen wilden betalen.
Wat is er nieuw in Gemini 3.1 Pro?
Dit zijn de belangrijkste verbeteringen in deze release:
Veel sterker redeneervermogen
Zoals ik in de intro aangaf, is de grote verandering te zien bij abstract en meerstaps redeneren. De prestatie van Gemini 3.1 op ARC-AGI-2 is in ongeveer drie maanden meer dan verdubbeld ten opzichte van Gemini 3 Pro.
Naast de ARC-AGI-2-verbeteringen behaalde het model de hoogste score ooit op GPQA Diamond, een benchmark op masterniveau voor wetenschap.
Gemini 3.1 Pro past standaard “dynamisch denken” toe: het gebruikt automatisch chain-of-thought-redeneren op basis van taakcomplexiteit.
De API introduceerde een nieuwe
thinking_level-parameter met vier instellingen:low,medium(nieuw in 3.1),highenmax, zodat developers een middenweg hebben tussen snelheid en diepte.Veel betere agent-prestaties
Een duidelijk patroon in deze release is hoeveel de benchmarks voor agentisch gedrag zijn verbeterd. Het model scoort nu veel hoger op autonoom webonderzoek, lange meerstapstaken en terminal-coderen dan zijn voorganger.
Voor iedereen die workflows bouwt waarin het model met minimale supervisie opereert (debuggen, webonderzoek, dataverzameling), zijn deze verbeteringen in de praktijk relevant.
Agent-prestaties zijn in sommige categorieën ongeveer verdubbeld ten opzichte van Gemini 3 Pro, en het model loopt nu voor op GPT-5.2 en Claude op de meeste van deze benchmarks.
Geanimeerde output op basis van code
Dit viel me op. Google benadrukte dat Gemini 3.1 Pro geanimeerde SVG’s en interactieve dashboards volledig via code-output kan genereren. Omdat dit wiskundige definities zijn in plaats van gerenderde afbeeldingen, schalen ze zonder kwaliteitsverlies en zijn ze veel kleiner dan videobestanden.
De voorbeelden uit de lancering zijn indrukwekkend: een portfolio-website gegenereerd vanuit de thema’s van Wuthering Heights, een live luchtvaartdashboard dat ISS-telemetrie binnenhaalt, en een 3D-starenzwerm met handtracking en een generatieve audioscore.
Het gaat om code-output, niet om afbeeldingen, wat betekent dat ze bewerkbaar, insluitbaar en lichtgewicht zijn.
Eindelijk geen afkapping van output meer
Minder spectaculair, maar waarschijnlijk direct relevanter voor iedereen die Gemini 3 Pro in productie gebruikte. Een terugkerende klacht bij het vorige model was dat het lange antwoorden halverwege afkapte.
Gebruikersrapporten na de lancering geven aan dat 3.1 Pro dit oplost. Iemand meldde een enorme output in één run te hebben gegenereerd zonder afkapping.
JetBrains bevestigde ook werkelijke kwaliteitsverbeteringen met het nieuwe model en merkte op dat het “betrouwbaardere resultaten” oplevert met “minder outputtokens” nodig. Die efficiëntiewinst, gecombineerd met geen afkapping, maakt echt verschil voor langvormige generatie.
Gemini 3.1 Pro-benchmarks
Google laat zien dat Gemini 3.1 Pro op 13 van 16 van enkele van de belangrijkste benchmarktests leidt, waaronder die voor abstract redeneren, agenttaken en wetenschap op masterniveau. (Gemini 3 Pro liep op een aantal van deze benchmarks al voor.)
Zo verhoudt het nieuwste model zich tot de andere grote releases van februari 2026.
Zoals je ziet, en zoals ik eerder al zei, is het resultaat voor abstract redeneren het meest opvallend. Gemini 3.1 Pro loopt duidelijk uit op Opus 4.6, dat op zijn beurt weer duidelijk vóór GPT-5.2 eindigt. Dit is een echte verschuiving ten opzichte van waar de toonaangevende modellen een jaar geleden stonden.
Waar Claude nog een voorsprong heeft
Ik wil hier open over zijn, want het is makkelijk om mee te gaan in de grote cijfers. Claude-modellen lopen echt voor in een paar belangrijke gebieden:
Het eerlijke beeld: Gemini 3.1 Pro is op dit moment het beste model voor abstract redeneren, wetenschappelijke kennis en multimodale breedte. Claude-modellen blijven voorop lopen bij kenniswerk, tool-orkestratie en software bedienen via een grafische interface.
Gemini 3.1 Pro testen
Om te zien hoe deze verbeteringen zich vertalen naar redeneren in de echte wereld, heb ik drie tests uitgevoerd die verschillende aspecten van abstract denken onderzoeken:
Test 1: Een symboolvolgordepuzzel
Om te zien hoe Gemini 3.1 Pro met ARC-AGI-2-achtig redeneren omgaat, gebruikten we een eenvoudige puzzel voor regelafleiding. Het model moet zowel een kleurregel als een vormregel afleiden op basis van voorbeelden, zonder dat de regels expliciet worden verteld.
Dit was mijn prompt: