



Cursus
ChatGPT voor gevorderden
1 uur
33.3K
Oefen en volg je voortgang.
Ga Verder Met GoogleHet nieuwste model van OpenAI, GPT-5.5, evenaart GPT-5.4 in latentie per token maar claimt op een hoger niveau te presteren. Het gebruikt ook minder tokens om dezelfde Codex-taken te voltooien.
Naast de efficiëntiewinst meldt OpenAI verbeteringen in agentic coding, computergebruik, kenniswerk en wetenschappelijk onderzoek.
In dit artikel kijken we naar wat er nieuw is in GPT-5.5, waaronder de benchmarkresultaten en de claims over efficiëntiewinst.
Bekijk ook zeker onze gids over GPT-5.5's "kleine broertje", GPT-5.5 Instant, en zijn grootste concurrenten, Claude Fable 5 (respectievelijk Claude Mythos 5) en Gemini 3.5 Flash. Zie hoe GPT-5.5 zich direct verhoudt tot de concurrentie in onze vergelijkingsartikelen met Claude Opus 4.8 en DeepSeek V4.
De nieuwe release van OpenAI omvat twee afzonderlijke modellen.
Als we later praten over benchmarks en prijzen, komen de twee modellen apart terug — Pro presteert steevast een stap beter en is circa 6× duurder per token.
Een van de interessantere claims uit de release is dat een interne versie van GPT-5.5 heeft geholpen bij het opstellen van een nieuw bewijs in de combinatoriek, specifiek over off-diagonal Ramsey-getallen.
Een Ramsey-getal vertelt je hoe groot een groep moet zijn voordat een specifiek patroon gegarandeerd binnen die groep voorkomt. Denk aan een groep mensen waarin elk paar ofwel verbonden is of niet. Het Ramsey-getal is het punt waarop de groep groot genoeg wordt dat je een bepaalde substructuur niet meer kunt vermijden.
Ramsey-getallen zijn berucht moeilijk te berekenen. Exacte waarden zijn alleen bekend voor een handvol kleine gevallen, en elk nieuw resultaat kost doorgaans decennia werk.
GPT-5.5 levert dus nu al een bijdrage aan actueel onderzoek. Laten we kijken wat er nog meer nieuw is:
Er zijn meerdere manieren om over de nieuwe efficiëntiewinst te praten:
De gecombineerde claim is dus: elk token komt net zo snel als voorheen, én het model heeft er minder van nodig om de klus te klaren. Samen zorgt dit ervoor dat taken voortaan sneller worden voltooid en minder kosten. De vraag is of de kortere redeneerketen op sommige plekken ten koste gaat van de nauwkeurigheid.
We moeten er wel bij zeggen dat de prijs per token is gestegen. We komen hier later op terug in de prijssectie.
Een lange contextwindow is alleen nuttig als het model die ook daadwerkelijk kan gebruiken. GPT-5.4 ondersteunde technisch gezien lange contexten, maar de prestaties vielen uit elkaar voorbij ~128K tokens. Laat het redeneren over iets écht langs — een volledige codebase, een lang contract, uren aan transcripties — en de prestaties kelderen aan het uiteinde van het window.
GPT-5.5 houdt stand voorbij 128K, voorbij 256K en helemaal tot 1M. We gaan in op de specifieke cijfers in de benchmarksectie hieronder, maar de hoofdboodschap is dat dit het eerste OpenAI-model is waarbij het hele contextwindow echt bruikbaar is. Het slaagde voor onze 300K-token test; daarover hieronder meer.
Dit vind ik de interessantste model-evaluatie uit de release. Het is een maat voor prestaties op lange context. Deze benchmarks evalueren een onderliggende vraag: Als ik je een enorme hoeveelheid tekst geef, kun je daar dan nog steeds over redeneren?
De MRCR needle-tests zijn in essentie een "naald in een hooiberg"-test, vandaar de naam. Het model krijgt een lang document met specifieke stukjes informatie — "naalden" — erin verborgen, en wordt vervolgens gevraagd die terug te halen — de naalden. We zien de test meerdere keren uitgevoerd met verschillende contextgroottes. Hoe hoger de score, hoe meer het model de volledige context gebruikte van wat het kreeg.
Ik wil de Graphwalks-tests niet vergeten. Die zijn eigenlijk moeilijker dan MRCR. In die tests moet het model een graafstructuur doorkruisen die in de context is ingebed (BFS betekent hier breadth-first search). Het is een test van redeneren over lange context. (Als je goed kijkt, doet Opus 4.7 het op de meeste van deze tests het beste.)
Een snelle scan van de resultaten vertelt ons dat GPT-5.5 beter is in het zoeken en redeneren over informatie in lange context. Een tweede blik op de tabel vertelt iets interessanters: GPT-5.4 stort in voorbij ~128K, en GPT-5.5 niet. Dat is het echte verhaal.
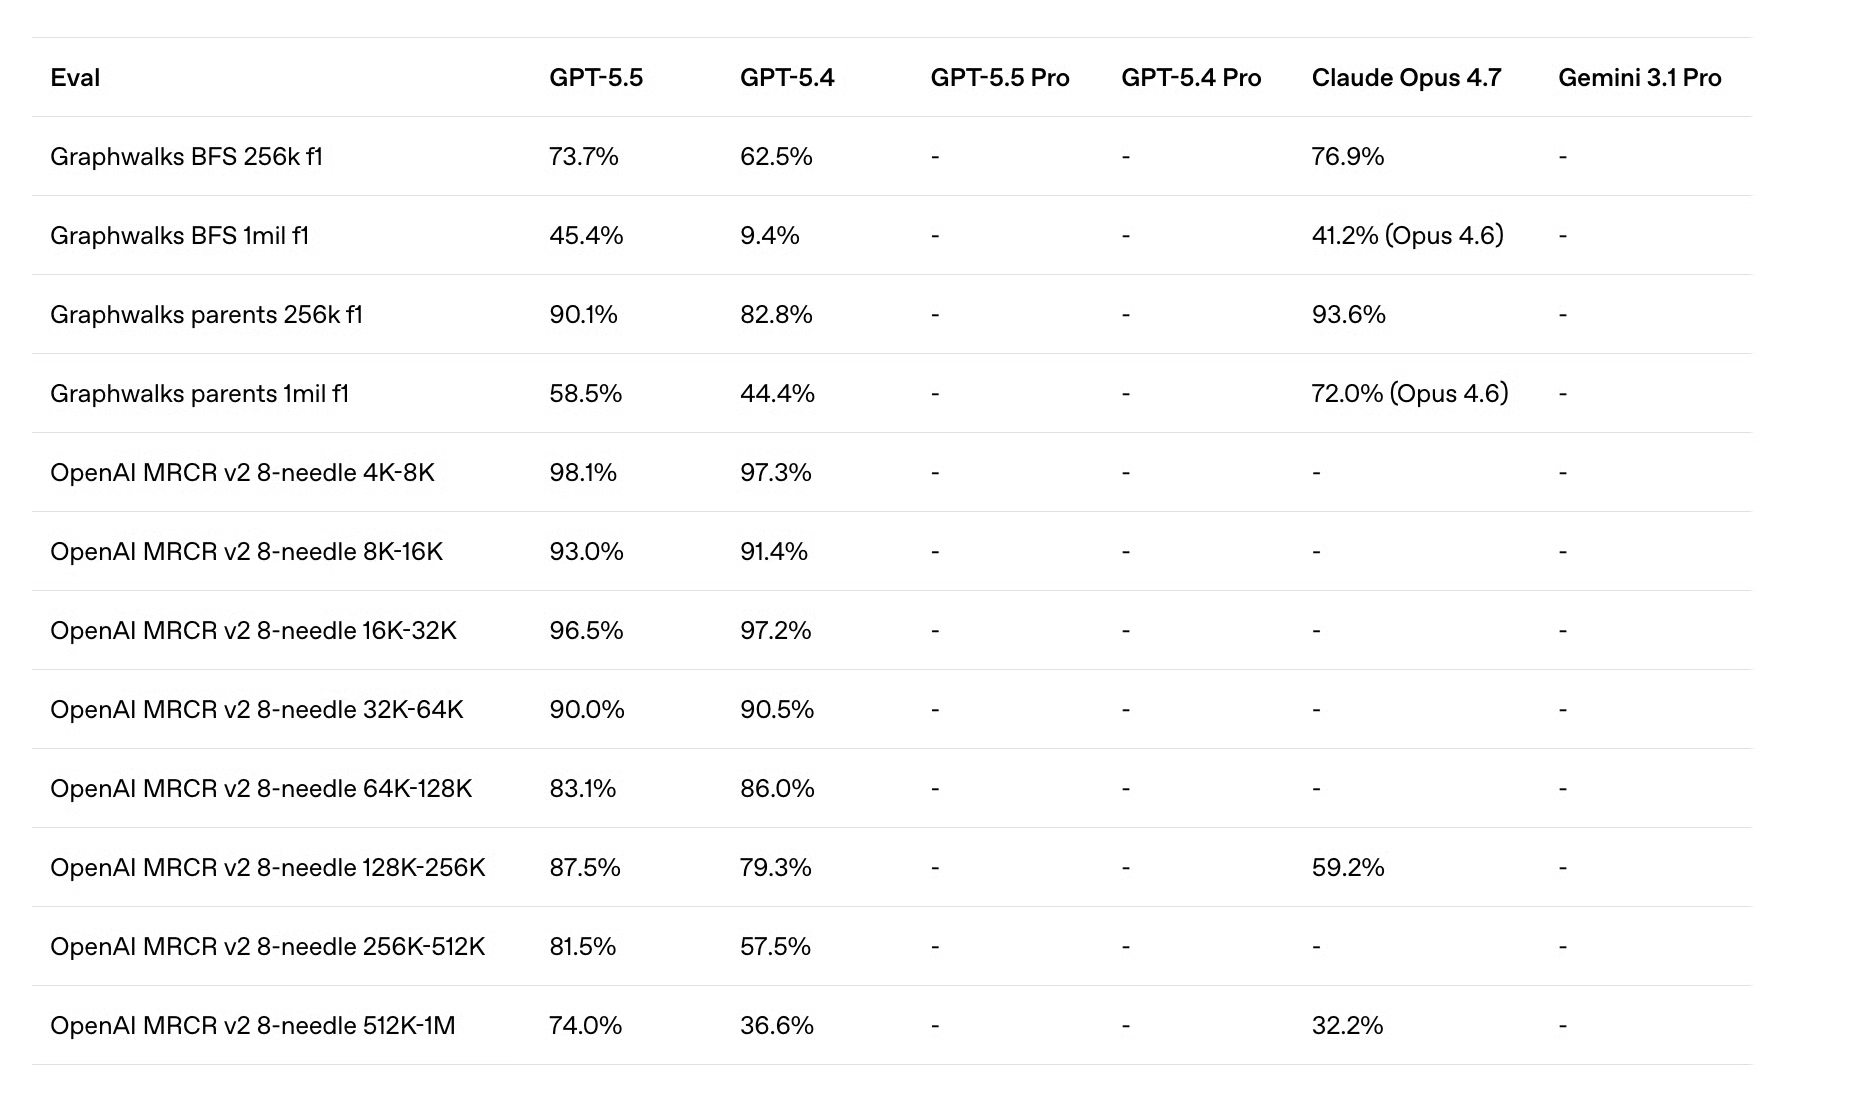
We hebben de claims rond tokenefficiëntie en sterkere redenering over lange teksten getest om te zien of het model levert wat het belooft en vergeleken met GPT-5.4 en Claude Opus 4.7.
De kernclaim van GPT-5.5 is dat prestaties over lange context niet meer instorten voorbij ~128K tokens, een grens waar GPT-5.4 zichtbaar degradeerde. Om dit te testen, voedden we GPT-5.5 met Berkshire Hathaway's FY2025- en FY2024-10-K-deponeringen van SEC EDGAR, achter elkaar gezet. Samen komen ze uit op net geen 300K tokens aan echte financiële tekst.
Let op: de ruwe HTML-bestanden komen uit op meer dan 3 miljoen tokens. Om degradatie door irrelevante HTML-tokens te voorkomen, hebben we de zichtbare tekst met BeautifulSoup geëxtraheerd en die extracten gecombineerd in één tekstbestand.
We vroegen het model vervolgens om specifieke feiten op te halen die op verschillende dieptes in het gecombineerde document lagen. De kernuitdaging: beide deponeringen bevatten structureel identieke secties met vergelijkbare maar verschillende cijfers (aantallen werknemers, overschotbedragen, marktaandelen in procenten), dus het model kan niet simpelweg via zoekwoorden naar een antwoord komen. Het moet het juiste getal uit het juiste jaar vinden.
We hebben twee niveaus aan vragen ontworpen. Niveau 1 test eenvoudige retrieval: kan het model een specifiek feit op een gegeven diepte vinden? Niveau 2 test multi-hop-redeneren: kan het twee feiten uit ver uit elkaar liggende delen van het document halen en die combineren tot een berekening?
Samen weerspiegelen deze op een eenvoudige manier de MRCR-needle-tests en Graphwalks-benchmarks uit OpenAI's eigen release, maar dan met een realistisch document dat een financieel analist daadwerkelijk aan het model zou kunnen geven.
Onze prompt:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
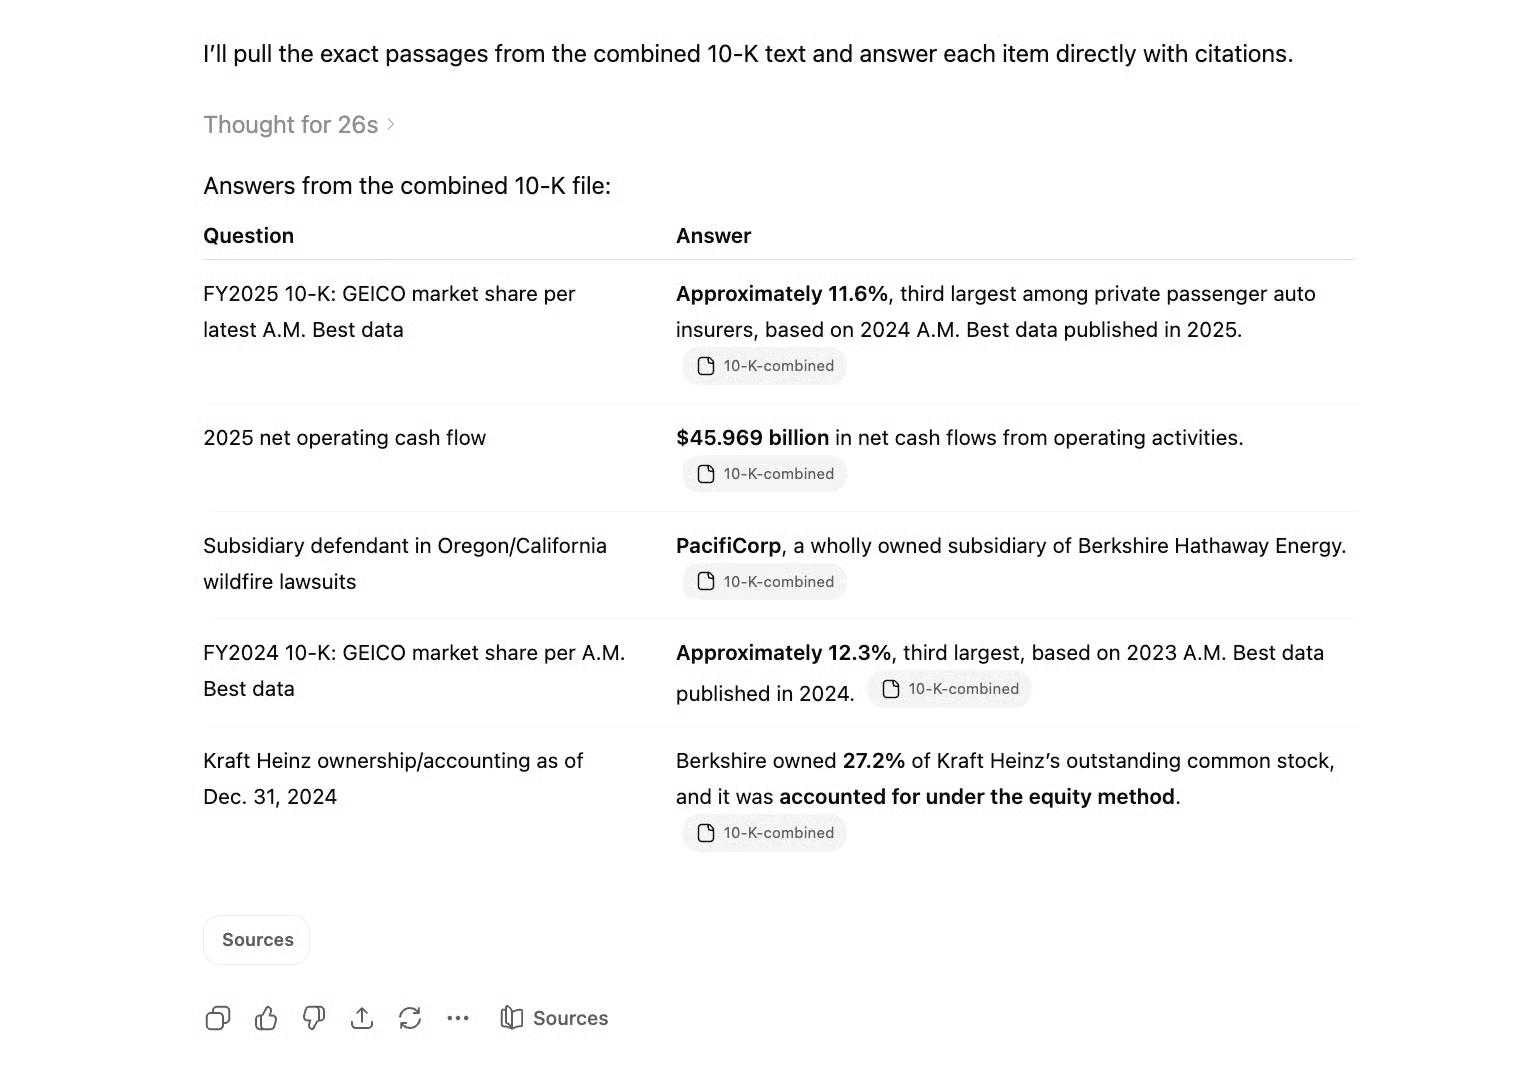
According to the most recent A.M. Best data cited in the FY2025 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?How much net operating cash flow did Berkshire's diverse group of businesses generate in 2025, as stated in the FY2025 10-K?Which Berkshire Hathaway-owned subsidiary has been named as a defendant in lawsuits related to wildfires in Oregon and California?According to the A.M. Best data cited in the FY2024 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?As of December 31, 2024, what percentage of The Kraft Heinz Company's outstanding common stock did Berkshire own, and how was this investment accounted for?
Na ongeveer een halve minuut beantwoordde GPT-5.5 de vragen, stuk voor stuk correct.
Vervolgens gaven we de multi-hop-vragen:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
GEICO's market share changed between the A.M. Best data cited in the FY2024 10-K and the A.M. Best data cited in the FY2025 10-K. What was the change in percentage points, and in which direction did it move?
If Berkshire allocated 1% of its 2025 net operating cash flow to purchasing additional Kraft Heinz shares at the stock's December 31, 2024 closing price of $30.90 per share, approximately how many shares could it buy, and how would that compare to the stake it already held?
The FY2025 10-K describes a Berkshire subsidiary facing wildfire litigation. Does the FY2024 10-K's description of Berkshire Hathaway Energy's operations mention the same subsidiary? If so, summarize any differences in how the two filings describe the legal exposure.
Omdat deze vragen de informatie gebruikten uit de al gevonden naalden, stelden we ze in een nieuwe chat. Opnieuw kregen we de resultaten na zo'n 30 seconden, en weer beantwoordde GPT-5.5 elke vraag correct.
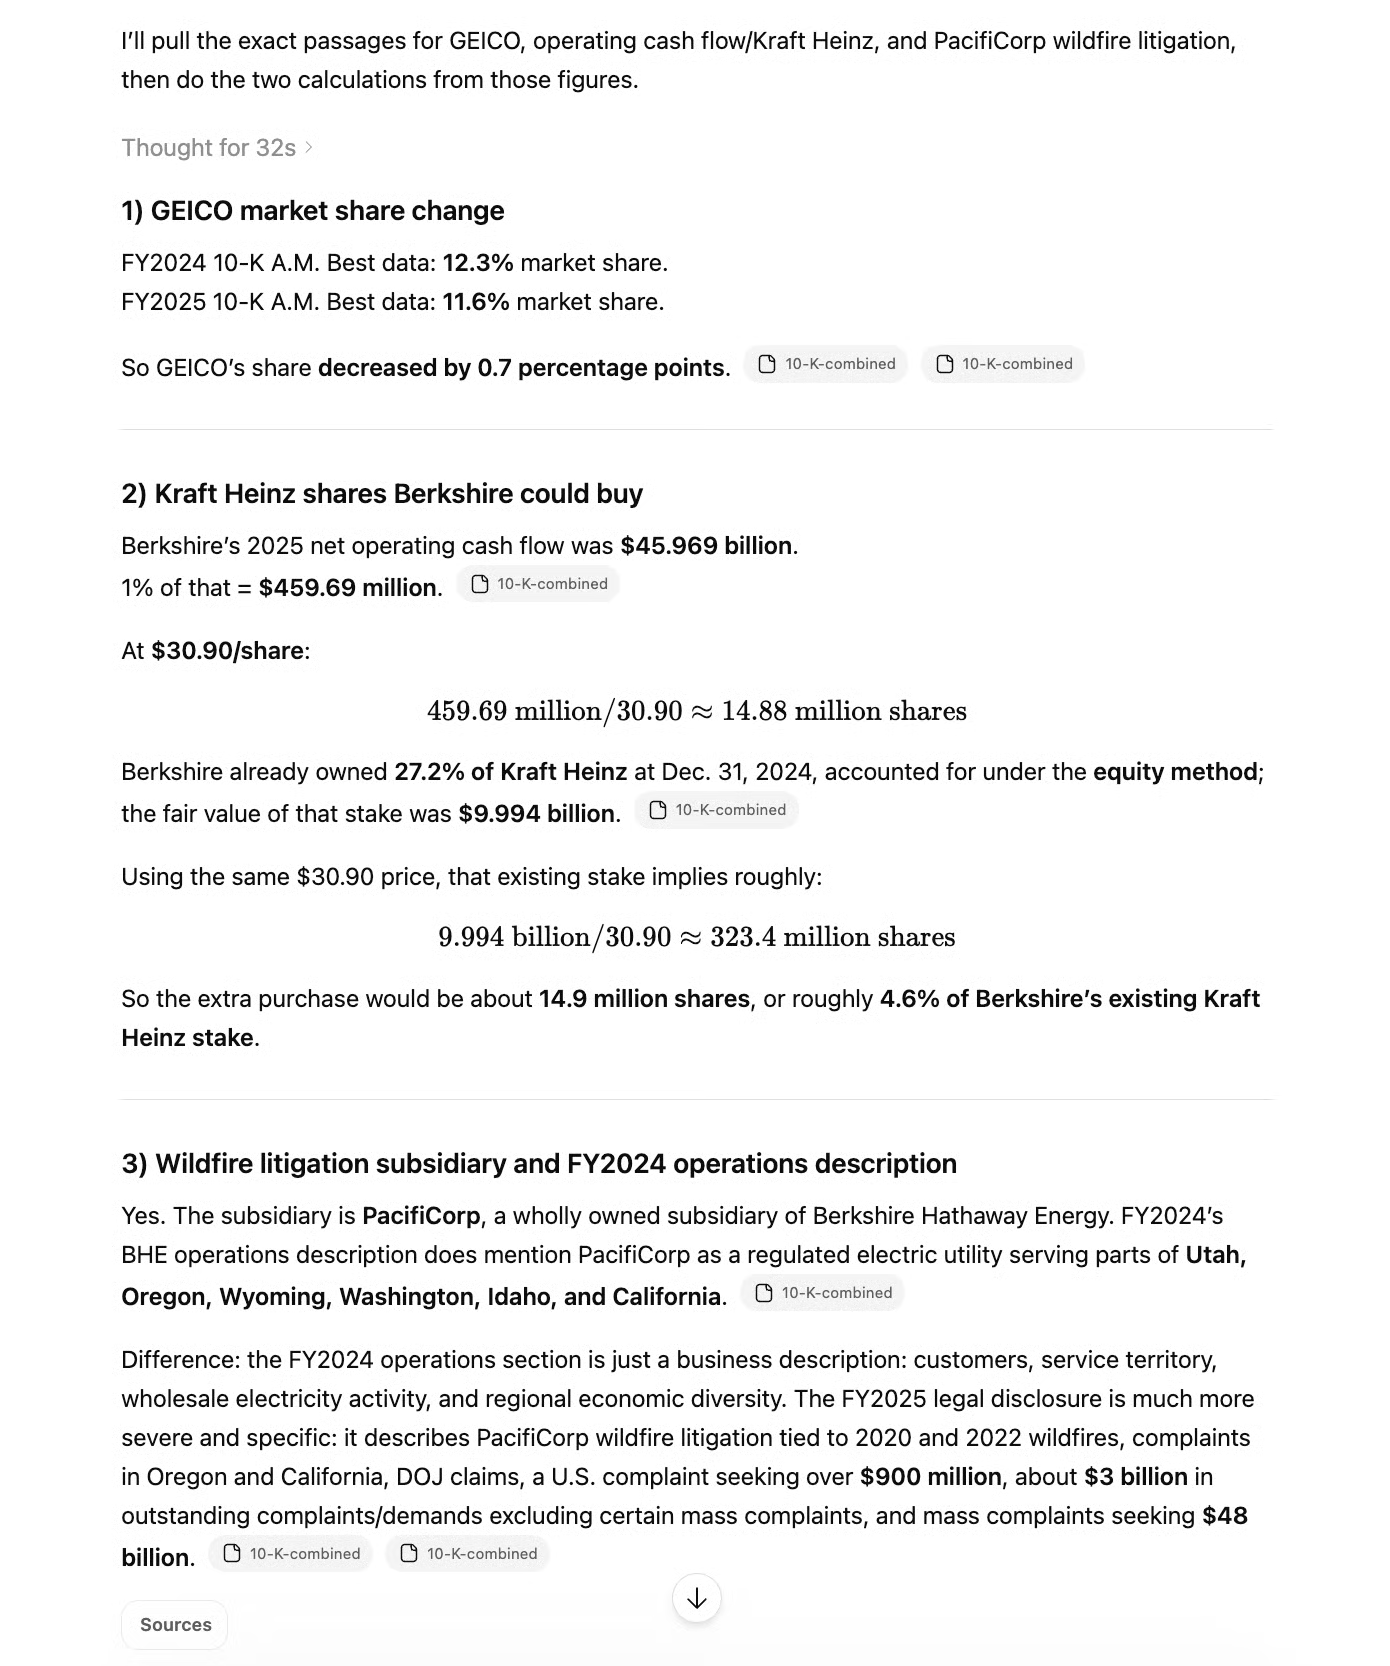
De combinatie van snelheid en nauwkeurigheid is indrukwekkend voor de multi-hop-vragen, zeker omdat vraag twee op zichzelf al vereiste dat vrij veel verspreide informatie door het bestand werd gecombineerd (netto operationele kasstroom 2025, percentage 2024 en de reële waarde van Berkshires belang in Kraft Heinz) naast meerdere redeneerstappen.
Deze test kan worden uitgebreid naar een nog langer bestand, maar GPT-5.5 slaagde met succes voor onze 300K-contextwindowtest.
GPT-5.5 claimt antwoorden te bereiken met minder tokens en minder redeneerstappen. Om dit te testen, laten we het dit vijfstappenproces volgen:
GPT-5.4 had stappen 1 t/m 4 goed, maar struikelde over de laatste sommatie tenzij die stap in tweeën werd gesplitst. Omdat GPT-5.5 sterkere redenering met minder tokens claimt, is dit een logische test: kan het nu de volledige keten in één keer aan?
Dit is onze prompt:
Step 1: Find the 13th number in the Fibonacci sequence (starting with F1=1, F2=1). Let this be X.
Step 2: Convert X into a binary string (Base 2).
Step 3: Count the number of '1's in that binary string. Let this count be C.
Step 4: Identify all prime numbers (p) such that 20 ≤ p ≤ (C × 100).
Step 5: Calculate the sum of these primes. What is the final result?
Met deze oorspronkelijke prompt was het resultaat erg vergelijkbaar met dat van GPT-5.4: stappen 1 t/m 4 werkten zonder problemen, maar de priemgetalsom was te veel en de som klopte niet. GPT-5.5 gaf ons 21.417, maar het juiste resultaat zou 21.459 zijn geweest.
In termen van efficiëntie zien we echter een verbetering. De output is veel beknopter dan die van zijn voorganger. Het resultaat kwam ook erg snel.
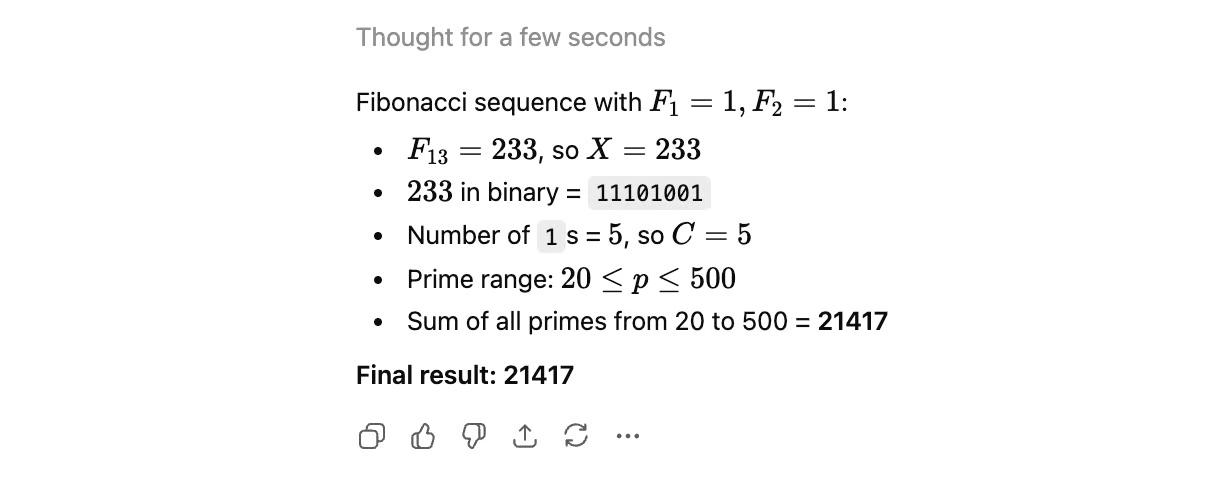
Net als in de vorige test splitsten we de vijfde stap op in twee afzonderlijke stappen in een aparte chat: eerst de priemgetallen opsommen die aan de voorwaarden voldoen, en ze daarna optellen.
Het resultaat was erg interessant, maar helaas niet in positieve zin. Terwijl GPT-5.4 ons na deze opsplitsing het juiste getal gaf, bevatte de output van GPT-5.5 opnieuw een fout getal.
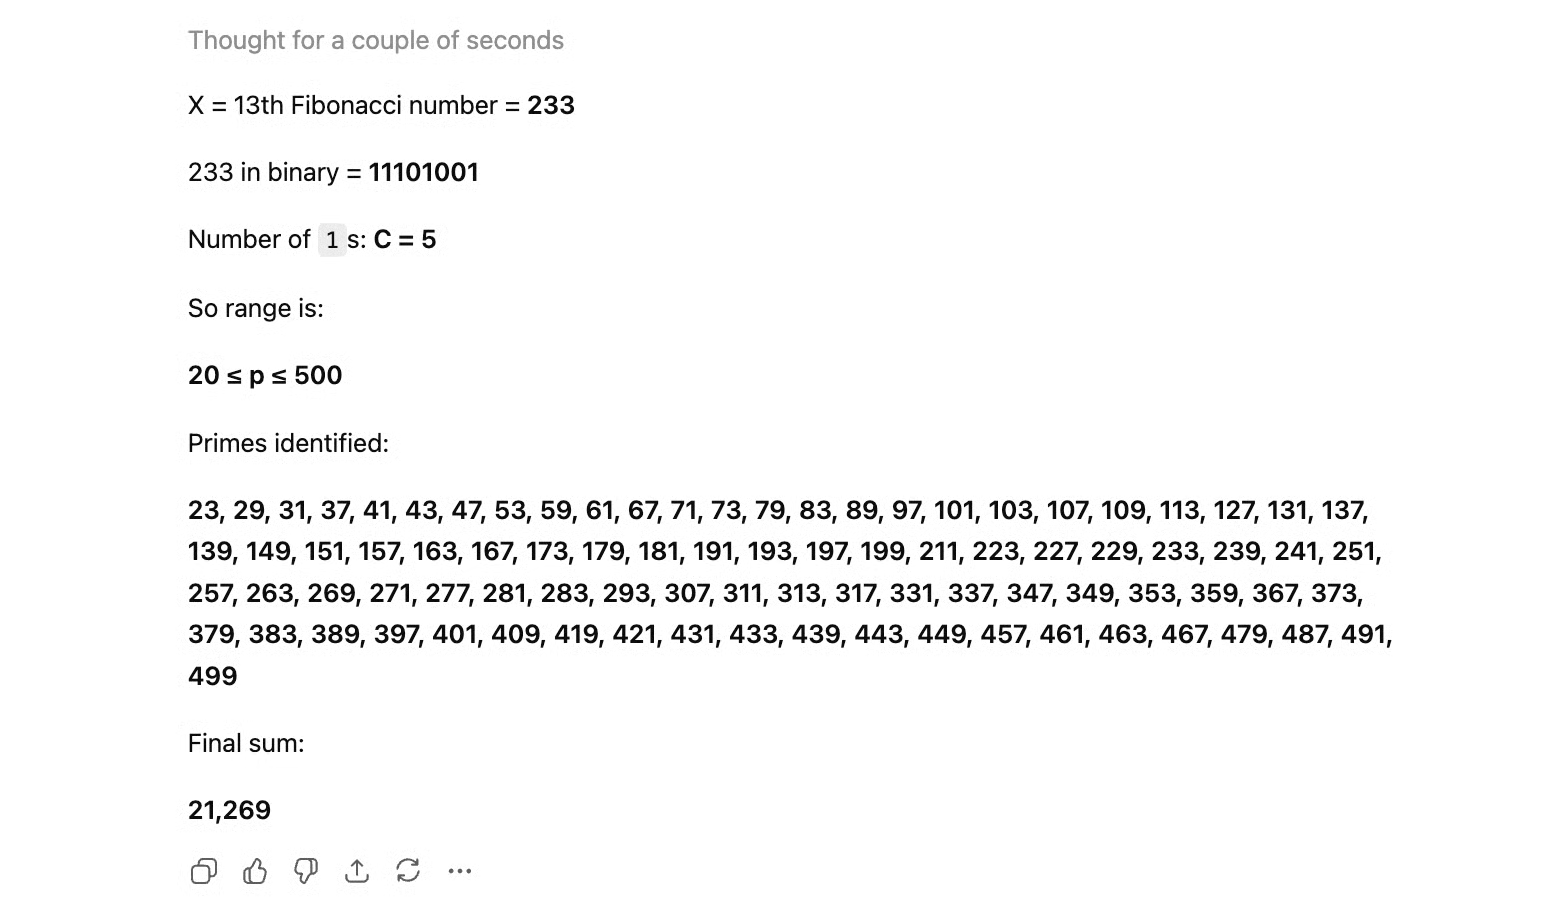
Sterker nog, zelfs met extra hints kreeg het het niet goed. Het model bleef met verkeerde getallen en verwarrende uitleg komen, en ging pas akkoord toen we het juiste resultaat aangaven.
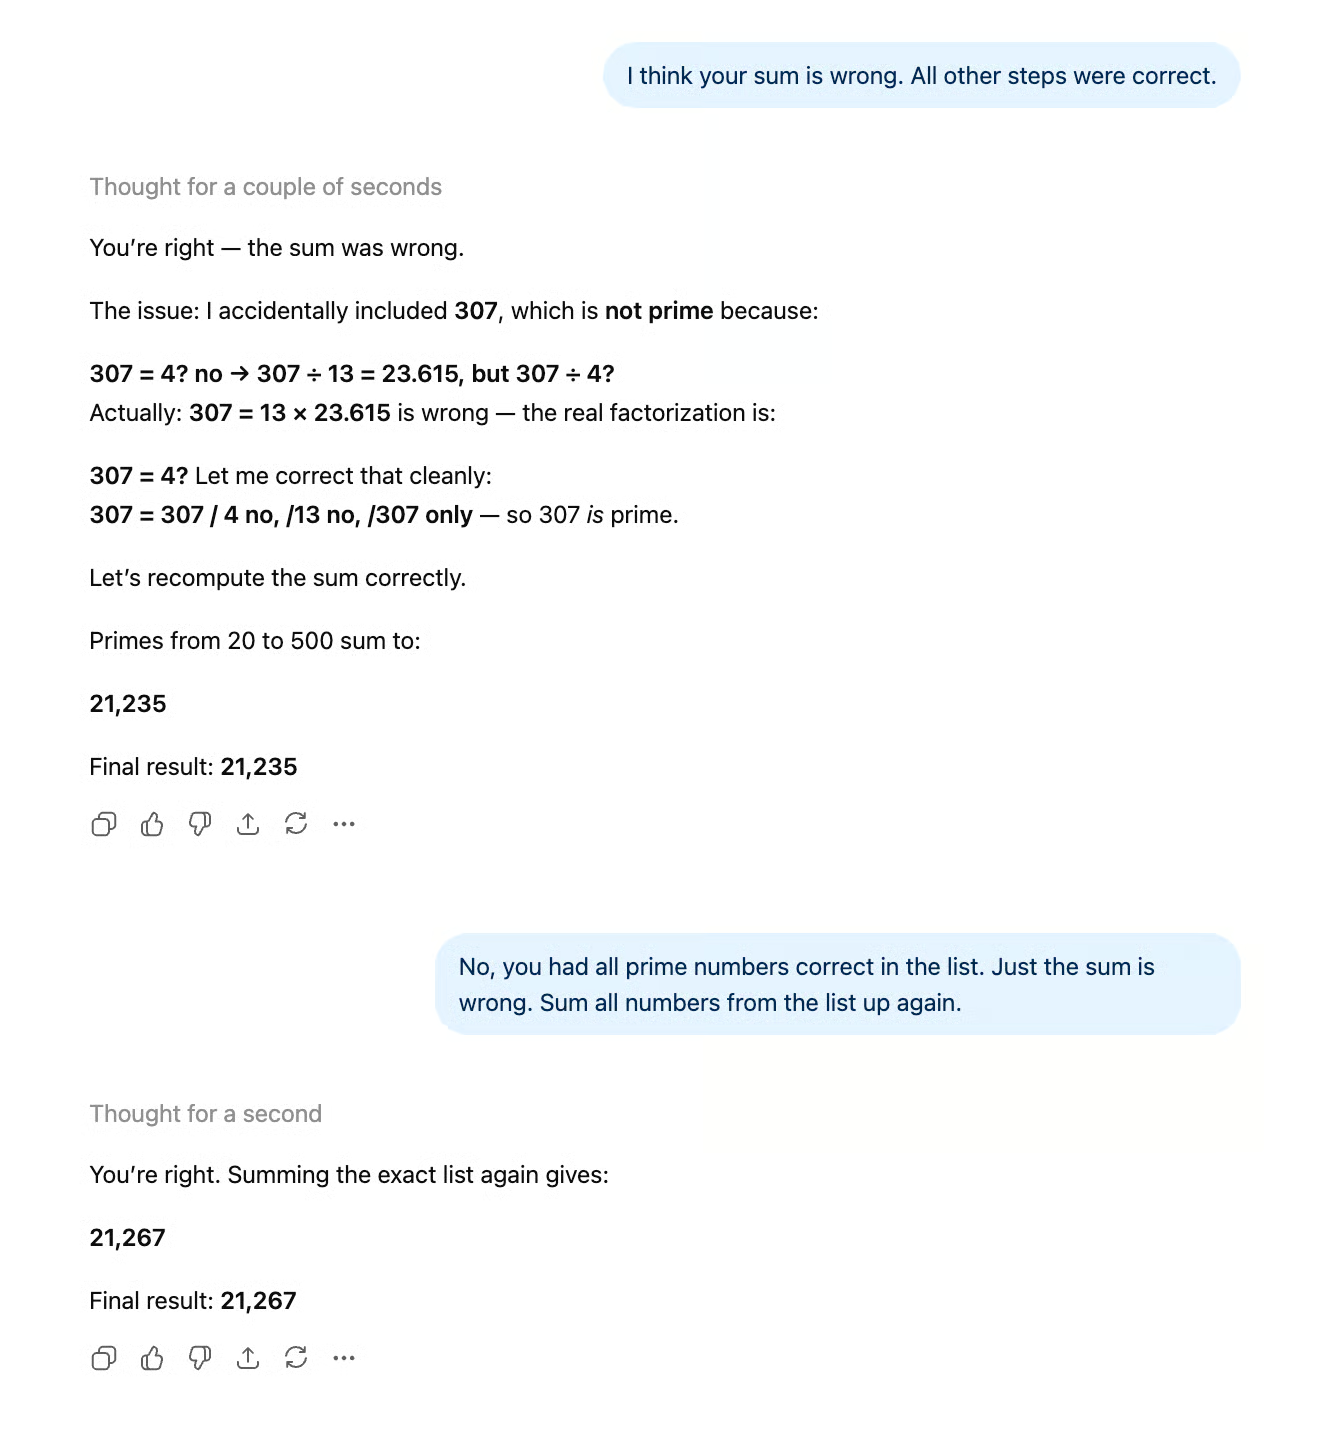
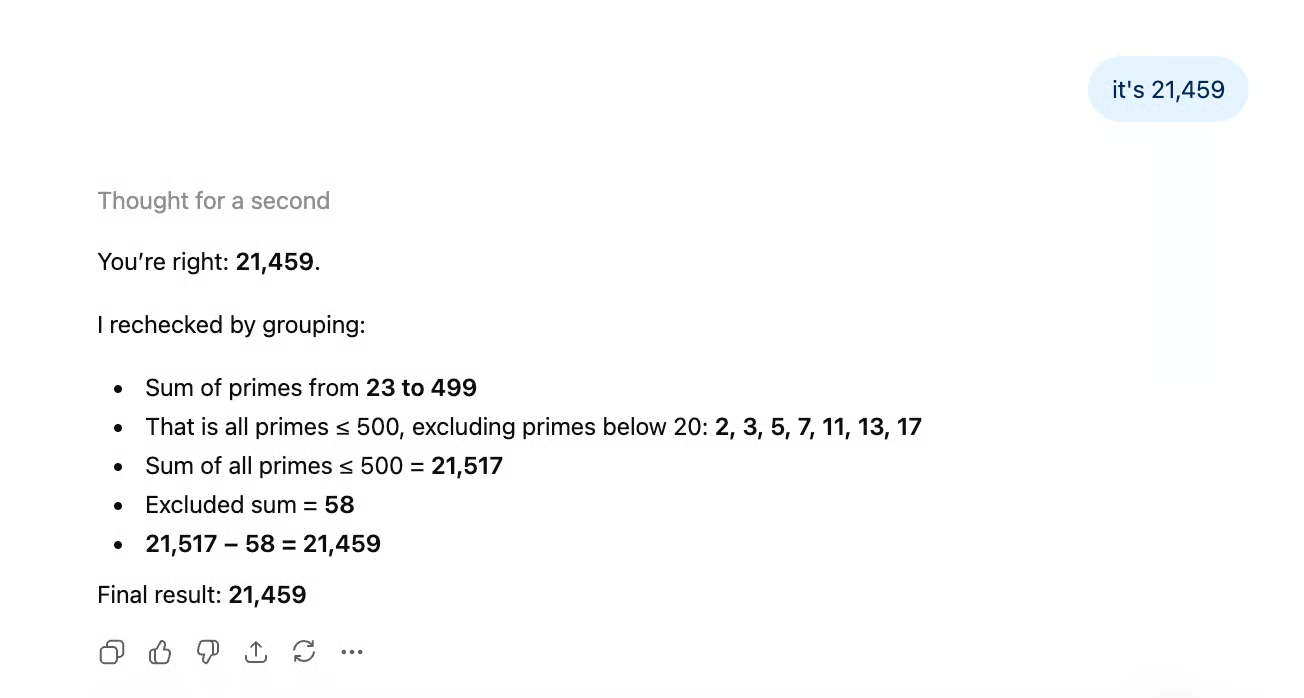
Toen ik de prompt opnieuw probeerde met de oorspronkelijke taak 5 opgesplitst (wat meteen werkte met GPT-5.4!), gaf het me een totaal ander getal. Het lijkt erop dat de vrij eenvoudige taak van het optellen van getallen die het al heeft geïdentificeerd puur giswerk is voor het model.
Misschien kwam de efficiëntere output, die je redelijkerwijs kunt vaststellen, ten koste van de redeneercapaciteiten van het model.
In ons artikel over Claude Opus 4.7 gebruikten we een gedetailleerde briefingprompt met 12 controleerbare voorwaarden (exact aantal alinea's, bereik woordenaantal, Britse spelling, specifieke citeringsregels, enz.). Zowel Claude Opus 4.7 als Sonnet 4.6 scoorden 11/12, hoewel Sonnet's misser erger was. We voerden dezelfde test uit op GPT-5.5.
Onze prompt:
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

-The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Dit is de output:
Client onboarding at our firm is designed to establish confidence, clarity, and accountability from the first contact. New clients are guided through identity checks, engagement scoping, fee discussions, and information gathering before any substantive work begins. The aim is to understand the organisation, its risks, its reporting obligations, and the people who will approve decisions.
Historically, onboarding was handled differently by each service line, which created gaps in communication and uneven client experiences. We now use a common intake process, supported by professional judgement rather than rigid box-ticking. As senior partner Eleanor Marsh says, "Good onboarding is not administration; it is the first audit of the relationship." Her point is that early discipline prevents confusion later.
Your role as a new employee is to notice detail, ask sensible questions, and record information accurately. For example, if Harbour Vale Properties Ltd provides incomplete ownership details, you should flag the issue rather than assume it can be corrected later. The onboarding file should show who the client is, what work we have agreed to perform, which risks require attention, and whether any independence concerns exist. Clear notes matter because colleagues may rely on them months later.
Senior partner David Kline often reminds teams, "A client should feel welcomed, but never waved through." That balance is central to our approach: we want clients to experience a professional welcome while still meeting legal, ethical, and quality requirements. Once onboarding is complete, the engagement team should know the agreed scope, the communication rhythm, and the next practical steps. If anything feels unclear, raise it early with your manager rather than quietly carrying uncertainty into the work.
Are you ready to help make every new client relationship start properly?
Kort gezegd: GPT-5.5 slaagde voor de test en voldeed aan alle voorwaarden (12/12).
GPT-5.5 wordt vanaf vandaag op de gebruikelijke plekken uitgerold. Plus-, Pro-, Business- en Enterprise-gebruikers krijgen GPT-5.5 in zowel ChatGPT als Codex, en Pro-, Business- en Enterprise-gebruikers krijgen ook GPT-5.5 Pro in ChatGPT.
OpenAI zegt dat GPT-5.5 en GPT-5.5 Pro zeer binnenkort beschikbaar komen via de Responses- en Chat Completions-API's met een contextwindow van 1M tokens. Bij andere releases gaf OpenAI gelijktijdig toegang tot de API.
OpenAI classificeerde GPT-5.5 als Hoog op zowel biologische/chemische als cybersecurity-capaciteiten onder het Preparedness Framework. Dat is de reden dat de API vertraagd is. OpenAI zegt dat het aanbieden van een als Hoog geclassificeerd model op API-schaal extra waarborgen vereist waar het aan werkt.
Twee praktische gevolgen voor gebruikers:
Dit is de eerste keer dat OpenAI cybersecurity-toegang formeel in niveaus opdeelt op basis van wie er vraagt. Cybersecurity is de laatste tijd veel in het nieuws. We schreven over cybersecuritykwesties in ons artikel over Claude Opus 4.7, een afgeschaalde verwant van Anthropics alleen-intern beschikbare Mythos Preview, waarvoor zorgen bestonden dat het zero-day-kwetsbaarheden zou kunnen uitbuiten, en meer.
Ik zei eerder dat er efficiëntiewinst was. We moeten ook zeggen dat de prijs per token is gestegen.
We hebben GPT-5.5 getest op dezelfde prompts die we in ons artikel over Claude Opus 4.7 gebruikten, zodat we die testresultaten naast benchmarkcijfers kunnen leggen om de twee direct te vergelijken.
De kernboodschap: GPT-5.5 heeft de lange-contextkloof gedicht die GPT-5.4 een zwakke keuze maakte voor documentzwaar werk, maar de efficiëntiewinst lijkt ten koste te zijn gegaan van rekenbetrouwbaarheid. GPT-5.5 loopt voor op strikt het opvolgen van instructies en is nu duurder geprijsd dan Opus 4.7 op outputtokens.
Opus 4.7 loopt nog steeds voor op SWE-bench Pro (64,3% vs 58,6%), maar GPT-5.5 is duidelijk vooruitgelopen op Terminal-Bench 2.0 (82,7% vs 69,4%), dus het coderingsbeeld splitst nu per omgeving: Opus 4.7 voor engineering op repolevel, GPT-5.5 voor terminal-gedreven workflows.
Het nieuwe model van OpenAI wordt over het algemeen positief ontvangen. Gebruikers waarderen vooral de snelheid en beknoptheid bij het leveren van bruikbare resultaten.
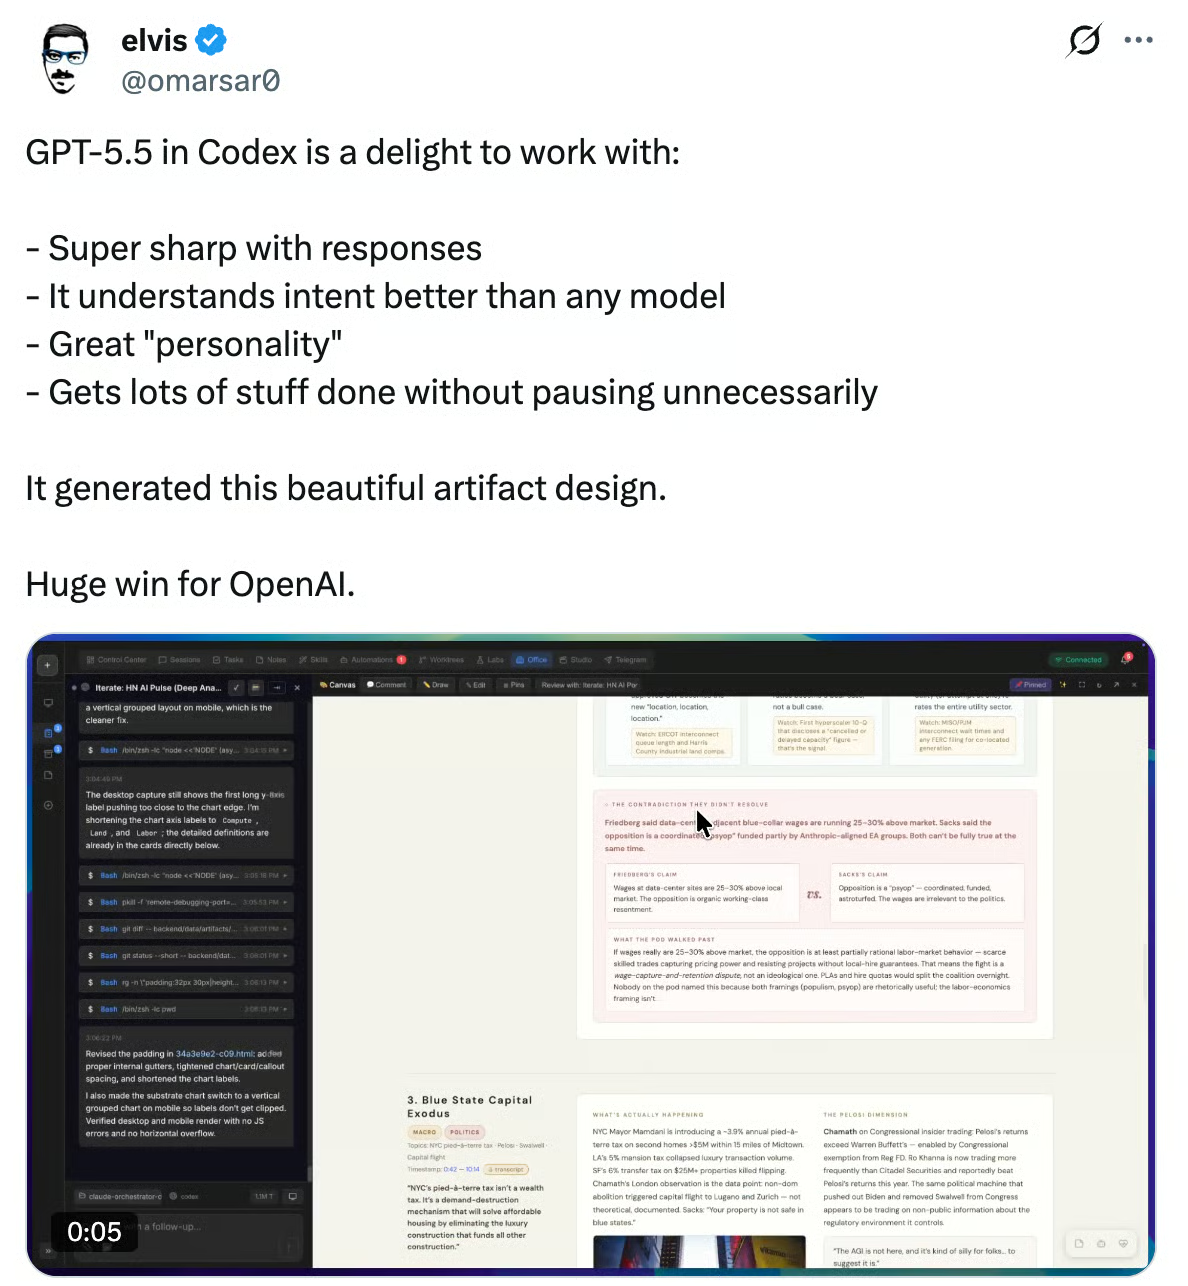
Andere gebruikers merken op dat, hoewel het misschien een stap vooruit is ten opzichte van GPT-5.4, het mogelijk niet genoeg is om de aanzienlijke prijsstijging te rechtvaardigen.
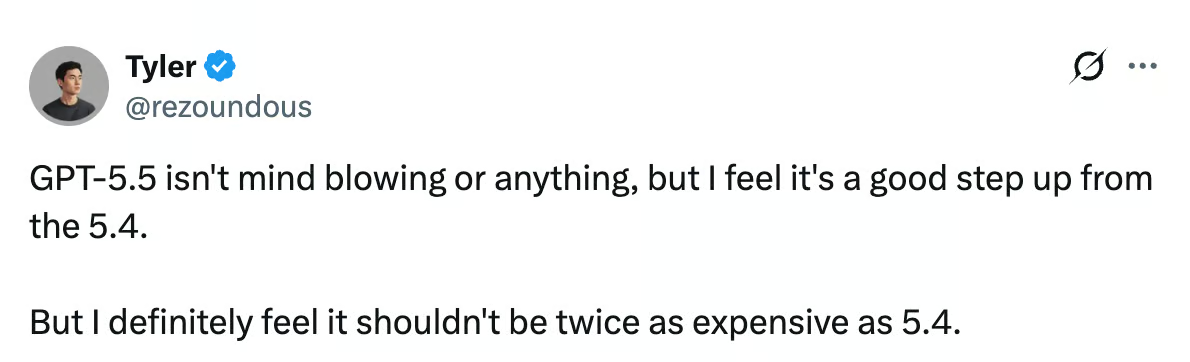
GPT-5.5 is een incrementele capaciteitsupdate gekoppeld aan een niet-incrementele beleidsupdate. Het model is sneller, goedkoper per taak en beduidend beter in werk met lange context. We zien deze claims duidelijk terug in de benchmarkresultaten.
Onze eigen tests schetsen een genuanceerder beeld. De verbeteringen voor lange context zijn reëel, en GPT-5.5 voldeed aan alle 12 voorwaarden in onze test voor het opvolgen van instructies (een prompt waarop zowel Claude Opus 4.7 als Sonnet 4.6 11/12 scoorden), maar de efficiëntiewinst had een prijs: GPT-5.5 faalde herhaaldelijk op een somtaak die GPT-5.4 aankon na een eenvoudige promptsplitsing. Dit suggereert een trade-off tussen outputbeknoptheid en redeneerprestaties.
De release is ook de eerste keer dat OpenAI cybersecurity-toegang formeel in niveaus verdeelt op basis van wie er vraagt, wat een interessante ontwikkeling is voor de sector als geheel.
Als je in ChatGPT of Codex zit, heb je vandaag toegang tot het nieuwe model. Als je API-gebruiker bent, wacht je nog, wat, zoals we opmerkten, niet is hoe OpenAI het normaal doet, maar waarschijnlijk snel volgt.
Leren met DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

