
Cursus
Generatieve AI-concepten
2 uur
121.3K
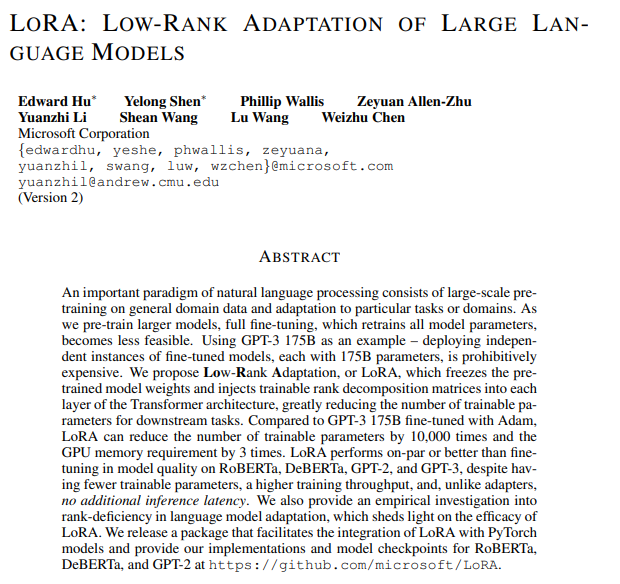
LoRA: Low-Rank Adaptation van Large Language Models
Het vakgebied van machine learning en natural language processing (NLP) heeft een opmerkelijke sprong voorwaarts gemaakt met de opkomst van Large Language Models (LLM’s) zoals GPT, LLaMa, Claude 2, enzovoort. Deze modellen laten uitzonderlijke capaciteiten zien in uiteenlopende toepassingen, van tekstgeneratie tot taalbegrip.
De praktische inzet en het fine-tunen van deze modellen brengt echter flinke uitdagingen met zich mee, vooral door hun omvang en complexiteit.
Daar komt Low-Rank Adaptation (LoRA) om de hoek kijken: een effectieve oplossing voor deze uitdagingen.
Het doel van deze tutorial is om zowel theoretisch als praktisch te begrijpen wat LoRA is en hoe je ervan kunt profiteren.
LoRA ontstond begin 2021, na de release van GPT-3. Microsoft werkte samen met OpenAI en stond voor de uitdaging om grote modellen zoals GPT-3 commercieel haalbaar te maken.
Ze ontdekten dat one-shot prompting op zichzelf niet voldoende was om optimale prestaties in productie te behalen, zeker niet bij complexe taken zoals het vertalen van natuurlijke taal naar code. Dit leidde tot een verkenning van fine-tuningmethoden die zowel kosteneffectief als efficiënt waren.
De uitvinding van LoRA komt voort uit de behoefte om grote taalmodellen snel, efficiënt en betaalbaar te fine-tunen, zodat domeinspecificiteit, efficiënt wisselen tussen taken of gebruikerswisselingen tijdens runtime mogelijk worden.
De LoRA-onderzoekspublicatie verscheen in oktober 2021 en is geschreven door een team onderzoekers van Microsoft.
Laten we eerst het probleem begrijpen, vóórdat we bespreken wat LoRA is en hoe het dit oplost.
Grote taalmodellen zoals GPT-4, Claude 2, LLaMA 70b, enz. zijn geweldig, maar ook erg generiek en groot. Om deze modellen geschikt te maken voor specifieke domeinen zoals de zorg of het bankwezen, of voor specifieke taken zoals het omzetten van tekst naar code, hebben we fine-tuning nodig.
Fine-tuning is het trainen van een voorgetraind model op een specifieke, kleinere dataset om de prestaties voor een bepaalde taak of domein te specialiseren. Naarmate modellen groter worden (bijvoorbeeld: GPT-3 heeft 175 miljard parameters), wordt volledig fine-tunen, waarbij alle modelparameters opnieuw worden getraind, minder haalbaar door tijd, kosten en middelen.
LoRA is een techniek die wordt gebruikt om grote modellen te fine-tunen.
Op hoofdlijnen werkt LoRA als volgt:
Het laat het oorspronkelijke model ongemoeid en voegt kleine, aanpasbare componenten toe aan elke laag van het model. Hierdoor daalt het aantal trainbare parameters aanzienlijk en neemt de benodigde GPU-geheugenruimte voor het trainingsproces af — ook dit is een grote uitdaging bij het fine-tunen of trainen van grote modellen.
Bijvoorbeeld: volledig fine-tunen van GPT-3 vereist het trainen van 175 miljard parameters. Met LoRA wordt het aantal trainbare parameters voor GPT-3 met ongeveer een factor 10.000 verlaagd en de GPU-geheugenvereisten met een factor drie.
Kortom, LoRA lost deze problemen op:
Voordat we de details van LoRA ingaan, eerst het concept van lagere-rang-matrices.
Lagere-rang-matrices komen uit de lineaire algebra. Simpel gezegd is de rang van een matrix een maat voor de "informatiewaarde" of de "dimensionaliteit" van de data die de matrix vertegenwoordigt. Laten we dit opsplitsen:
Voorbeeld:
Neem een 3 x 3-matrix:
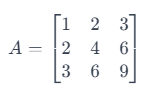
Hier is de tweede rij simpelweg de eerste rij maal 2, en de derde rij de eerste rij maal 3. Dat betekent dat de rijen niet lineair onafhankelijk zijn. De rang van deze matrix is 1 (omdat alleen de eerste rij onafhankelijk is), wat lager is dan de maximaal mogelijke rang voor een 3x3-matrix, namelijk 3. Dit is dus een lagere-rang-matrix.
Lagere-rang-matrices zijn belangrijk in verschillende toepassingen zoals datacompressie, waar het verlagen van de rang helpt om data te comprimeren met behoud van zo veel mogelijk informatie.
De rang in een matrix geldt evenzeer voor rijen als voor kolommen. Het cruciale punt is dat de rang hetzelfde is, of je nu op basis van rijen of kolommen rekent. Dat komt door een fundamentele eigenschap uit de lineaire algebra, bekend als de rang-nulliteitstelling.
Eenvoudig gezegd stelt die stelling dat de dimensies van de rijruimte (de ruimte die door de rijen wordt opgespannen) en de kolomruimte (de ruimte die door de kolommen wordt opgespannen) gelijk zijn. Deze gedeelde dimensie noemen we de rang van de matrix.
Dus in het bovenstaande voorbeeld van de 3 x 3-matrix is de rang 1, wat betekent dat er slechts één lineair onafhankelijke rij en één lineair onafhankelijke kolom is.
Heel eenvoudig gezegd benut LoRA het concept van lagere-rang-matrices om het trainen van modellen extreem efficiënt en snel te maken.
Grote modellen hebben enorm veel parameters. GPT-3 heeft bijvoorbeeld 175 miljard parameters. Die parameters zijn gewoon getallen die in matrices zijn opgeslagen. Dat vergt veel opslag.
Volledig fine-tunen betekent dat álle parameters worden getraind, en dat vereist een buitengewone hoeveelheid rekenmiddelen, wat voor een model van GPT-omvang makkelijk miljoenen kan kosten.
In tegenstelling tot traditioneel fine-tunen, waarbij het hele model wordt aangepast, richt LoRA zich op het aanpassen van een kleinere subset van parameters (lagere-rang-matrices), waardoor de reken- en geheugenkosten dalen.
LoRA is gebaseerd op het inzicht dat grote modellen van nature een laag-dimensionele structuur hebben. Door lagere-rang-matrices te benutten, past LoRA deze modellen effectief aan. Het idee is dat betekenisvolle modelveranderingen met minder parameters kunnen worden weergegeven, waardoor het aanpassingsproces efficiënter wordt.
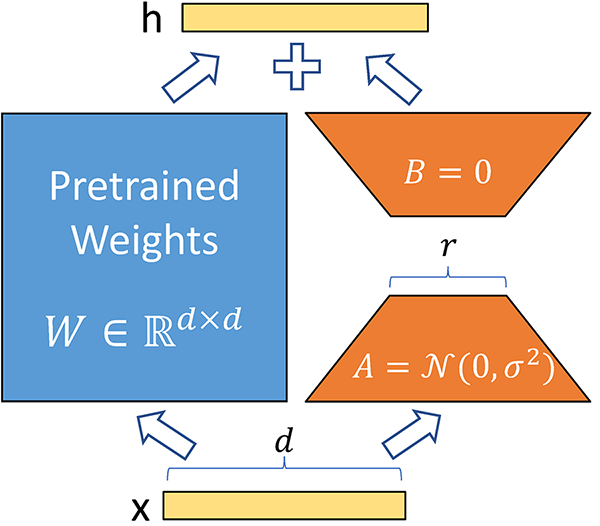
Bron: Fine-Tuning LLMs: LoRA or Full-Parameter? An in-depth Analysis with Llama 2
Eerst ontbinden we de grote gewichtsmatrices in kleinere matrices met behulp van de lagere-rang-techniek, zoals hierboven uitgelegd. Dit vermindert het aantal trainbare parameters drastisch. Voor een model als GPT-3 wordt het aantal trainbare parameters 10.000 keer kleiner. In plaats van 175 miljard parameters train je met LoRA nog maar 17,5 miljoen.
We veranderen geen parameters van het voorgetrainde model. We trainen alleen de lagere-rang-matrices, wat relatief zeer snel gaat door het kleine aantal parameters.
De gewichten zijn additief. Voor inferentie tellen we de gewichten van de lagere-rang-matrices simpelweg op bij de voorgetrainde gewichten, zonder extra latentie. De lagere-rang-matrices zijn ook erg klein, waardoor je ze makkelijk kunt laden en ontladen voor verschillende taken en verschillende gebruikers.
Het gebruik van LoRA bij fine-tuning heeft meerdere voordelen:
LoRA vermindert de rekenlast, waardoor modellen sneller kunnen worden aangepast. Doordat minder parameters trainbaar zijn, wordt fine-tunen van grote modellen op minder krachtige hardware haalbaar.
Ondanks het lagere aantal parameters behoudt LoRA de kwaliteit en inferentiesnelheid van het oorspronkelijke model.
LoRA verkleint de grootte van modelcheckpoints drastisch. Bij GPT-3 daalde de checkpoint-grootte bijvoorbeeld van 1 TB naar slechts 25 MB.
LoRA introduceert geen extra latentie tijdens inferentie. De lagere-rang-matrices worden tijdens training gebruikt maar bij inferentie samengevoegd met de originele parameters, zodat er geen vertraging optreedt. Dit maakt snel wisselen van modellen tijdens runtime mogelijk zonder extra inferentielatentie.
LoRA is toepasbaar op elk model dat matrixvermenigvuldiging gebruikt (zoals een supportvectormachine) en is daarmee breed inzetbaar. In feite wordt LoRA veel gebruikt in Stable Diffusion-modellen om stijl over te nemen in grote beeldmodellen.
De LoRA-techniek is ook wijdverbreid in beeldmodellen zoals Stable Diffusion.
Het idee is vrijwel hetzelfde als bij taalmodellen. In plaats van grote modellen zoals Stable Diffusion volledig te fine-tunen, trainen we alleen lagere-rang-matrices op kleine datasets.
Bij taalmodellen draait het om domeinspecificiteit. Bij beeldmodellen is de meest voor de hand liggende usecase het aannemen van een stijl of een consistent personage bij het genereren van afbeeldingen.
Deze lagere-rang-matrices staan bekend als adapters; ze zijn erg klein en er zijn er duizenden online te vinden die je kunt downloaden en boven op je basis-Stable Diffusion-model kunt plaatsen om stijl-specifieke afbeeldingen te genereren.
Enkele veelvoorkomende toepassingen van LoRA voor Stable Diffusion-modellen zijn:
Je kunt meerdere LoRA’s combineren om uitvoer te krijgen die meerdere specialisaties weerspiegelt.
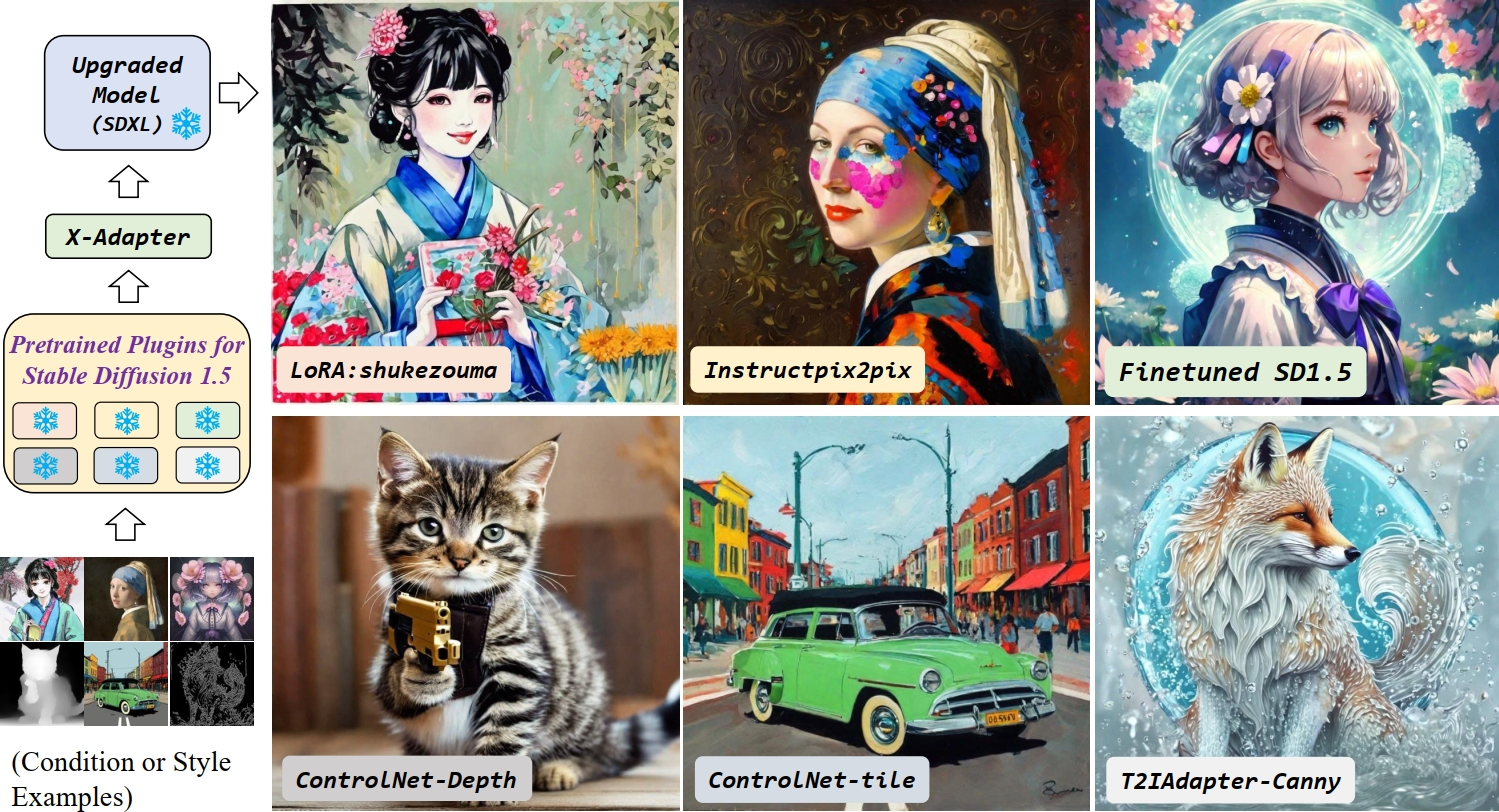
Verschillende adapters voor Stable Diffusion-modellen (Beeldbron)
Wil je leren hoe je Stable Diffusion XL succesvol kunt fine-tunen op persoonlijke foto’s? Lees dan de blog Fine-tuning Stable Diffusion XL met DreamBooth en LoRA op Datacamp.
Prefix-tuning is een lichte methode waarbij continue vectoren, "prefixen", worden geoptimaliseerd en toegevoegd aan de input van elke Transformer-laag. Het model wordt getraind in een prefix-stripped manier, waarbij de focus alleen op deze vectoren ligt.
LoRA en prefix-tuning kunnen worden gecombineerd binnen het PEFT-framework (Parameter Efficient Fine-Tuning):
Om LoRA te implementeren, kun je de Loralib-bibliotheek van Microsoft gebruiken. Installeer de bibliotheek met:
pip install loralib
De manier waarop je je neurale netwerk normaal traint, verandert nauwelijks door de inzet van LoRA.
# ===== Before =====
# layer = nn.Linear(in_features, out_features)

# ===== After ======
import loralib as lora
# Add a pair of low-rank adaptation matrices with rank r=16
layer = lora.Linear(in_features, out_features, r=16)
Voor de trainingslus begint, hoef je alleen dit toe te voegen:
import loralib as lora

model = YourNeuralNetwork()

# This sets requires_grad to False for all parameters
lora.mark_only_lora_as_trainable(model)

# Training loop
for batch in dataloader:
   ...
Bij het opslaan van een checkpoint kun je een state_dic genereren die alleen LoRA-parameters bevat.
# ===== Before =====
# torch.save(model.state_dict(), checkpoint_path)

# ===== After =====
torch.save(lora.lora_state_dict(model), checkpoint_path)
Begrijp je neurale netwerken nog niet goed genoeg? Geen zorgen. Bekijk de blog How to Train a LLM with PyTorch om het trainen van grote taalmodellen met PyTorch onder de knie te krijgen, van de eerste setup tot de uiteindelijke implementatie.
Credits: Het codevoorbeeld is overgenomen uit de Microsoft/LoRA GitHub.
LoRA is een onmisbare techniek om de grote uitdagingen aan te pakken die voortkomen uit de omvang en complexiteit van grote modellen.
Door lagere-rang-matrices te benutten, biedt LoRA een efficiëntere en kosteneffectievere aanpak voor modeladaptatie. Het aantal trainbare parameters en de GPU-geheugenbehoefte daalt aanzienlijk, wat zorgt voor snellere training en efficiënter geheugengebruik.
De toepassing van LoRA reikt verder dan taalmodellen en bewijst ook zijn nut in beeldmodellen zoals Stable Diffusion, waar het stijlspecialisatie en consistente personages in beeldgeneratie mogelijk maakt.
Ben je nieuwsgierig en wil je meer leren over wat je met deze technologieën kunt bouwen? Bekijk dan onze gids 5 Projects You Can Build with Generative AI Models voor meer informatie.
Begin vandaag nog met je AI-reis!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

