
Leerpad
Associate AI Engineer voor ontwikkelaars
26 Hr
Ik noemde al dat je verwachtingen bij het model moeten passen. Dat geldt zeker in Jev’s geval, en heeft vooral te maken met zijn modelklasse, aangeduid als System One-modellen.
Een System One-model retourneert getypte beslissingen in plaats van tekst. Je stuurt een blok state plus een set vragen, elk met een antwoordruimte die jij definieert, en het model retourneert één antwoord per vraag met waarschijnlijkheden. Er wordt niets token-voor-token geproduceerd, dus er is geen string om te parsen en geen misvormde JSON om te repareren. TypeSafe muntte deze term met verwijzing naar Daniel Kahnemans beroemde tweedeling:
Omdat de antwoordruimte een schema is dat jouw code verklaart, kan een System One-model per ontwerp nooit een categorie teruggeven die je niet hebt gedefinieerd. Het kan dus nooit off-schema zijn. Dat gezegd hebbende: het kan nog steeds fout zijn, en we behandelen later een paar lastige gevallen.
TypeSafe kwam op 15 september 2026 uit stealth met Jev in early access, met 70 tot 500 ms responses en $0,042 per miljoen inputtokens, met output gratis. Op hun eigen benchmark met vier workflows komt Jev uit op ongeveer 68% nauwkeurigheid—ruwweg middenmoot-LLM—tegen een fractie van de kosten.
Voor meer informatie over features en benchmarkprestaties raad ik onze Jev-gids aan.
Schrijf de geldige antwoorden op vóór je de call doet. Als je ze kunt opsommen, heb je een probleem in Jev-vorm:
Kies een LLM als de output proza of code is, als de antwoordruimte open is, of als de taak meerdere redeneringsstappen vereist. Jev is ook het verkeerde gereedschap voor alles wat numeriek is—waarom, daar kom ik later op terug.
Voordat je code schrijft, maak een TypeSafe-account aan en open de Playground. Hier kun je tekst plakken als state, vragen toevoegen en de volledige antwoordobjecten zien zonder iets te installeren. Het is de snelste manier om te begrijpen wat elk vraagtype teruggeeft (en om te ontdekken of je vraag slecht geformuleerd is).
Ik gebruik één supportticket als state voor alle drie voorbeelden:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
Elk vraagtype neemt instructions mee: de vraag in gewone taal die je beantwoord wilt hebben. Wat ertussen verandert is criteria en wat er terugkomt.
Een Choice kiest één optie uit een set die jij definieert.
Je geeft criteria door als een dictionary-object dat elke optie mapt naar een beschrijving, van 1 tot 255 stuks, en het antwoord komt terug met:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
Om de code-output te zien die je ook via de API zou ontvangen, klik je op de knop </> rechtsboven en klik je op Run om Jev de vraag te laten beantwoorden.
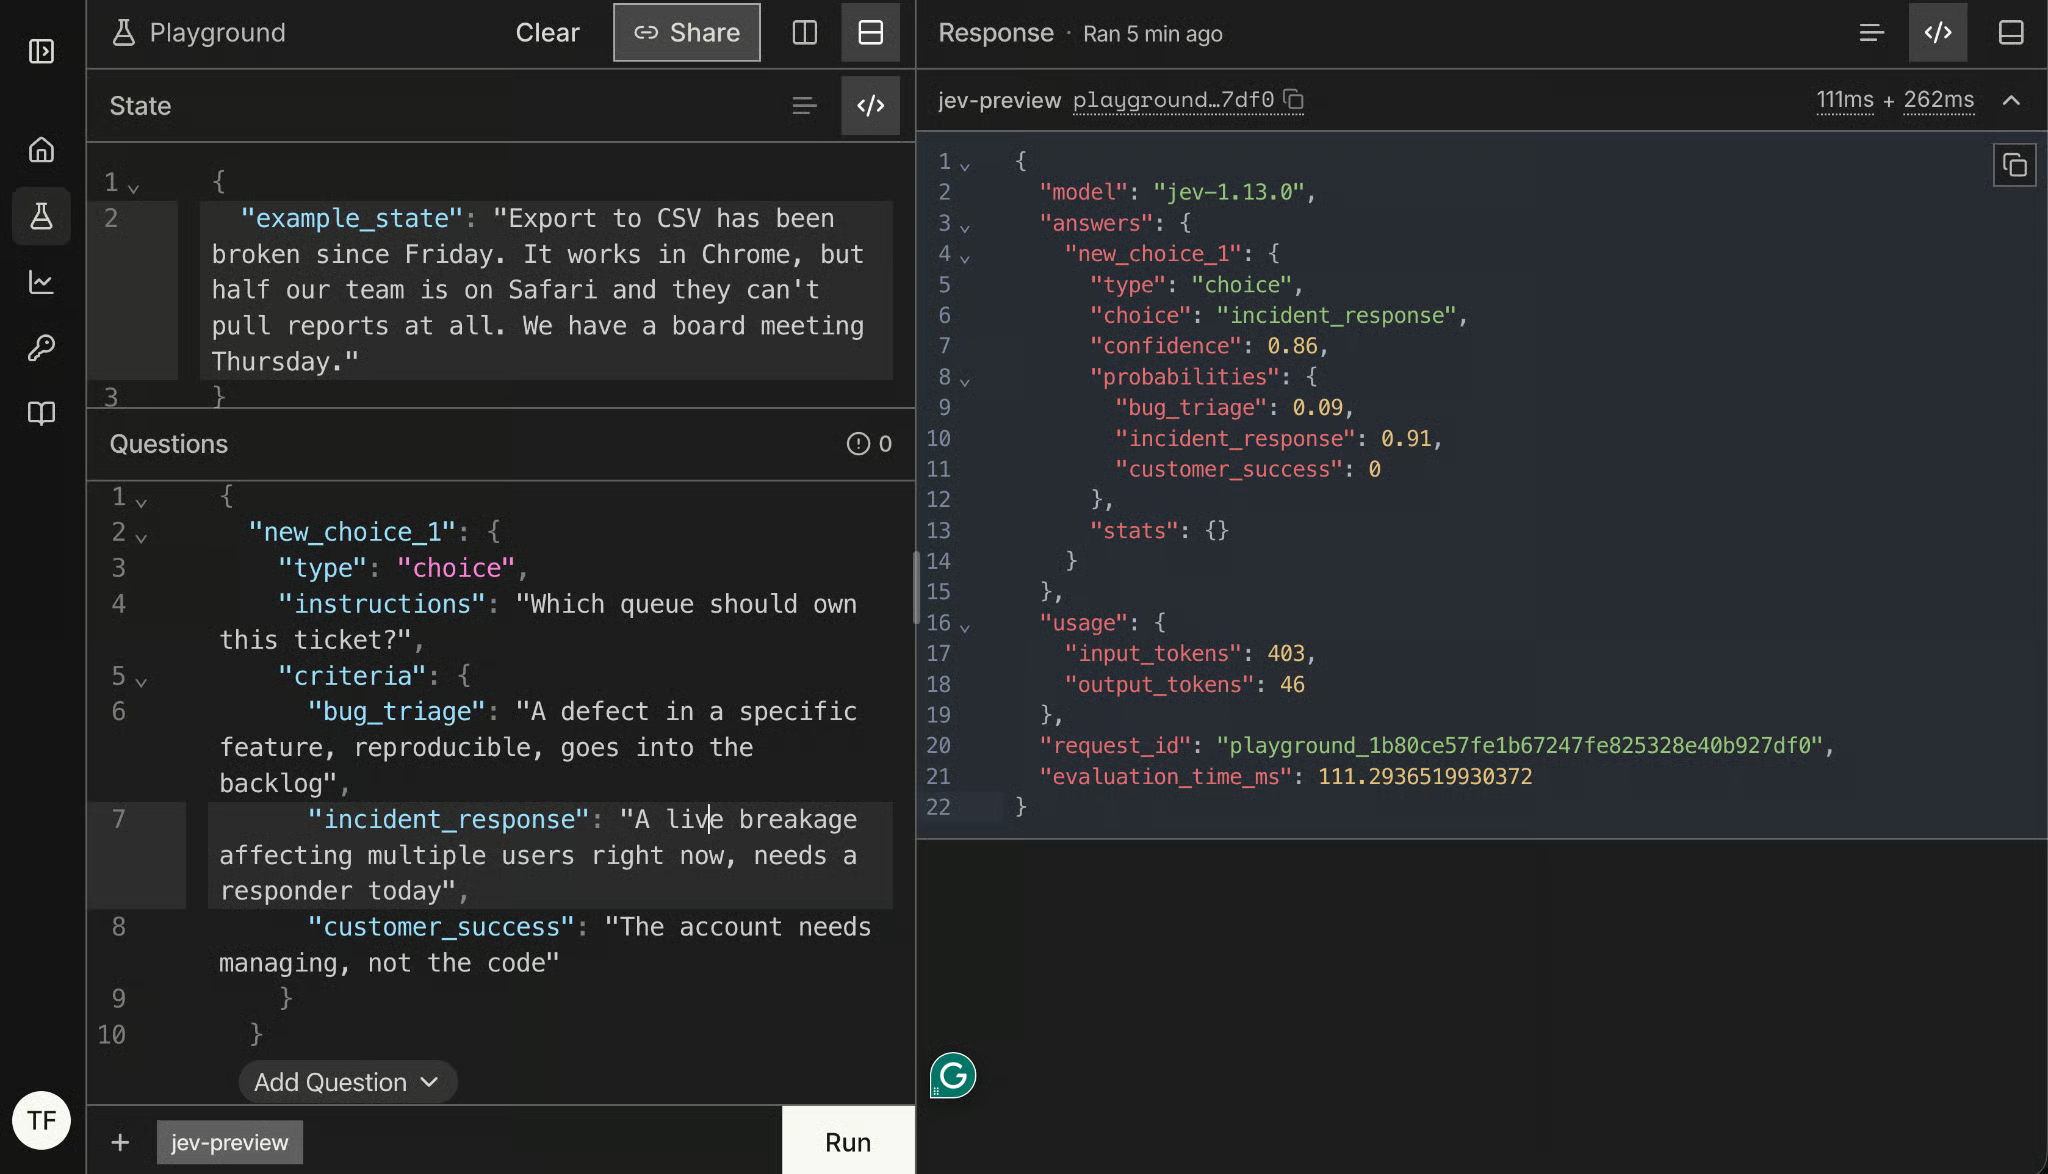
In dit geval is incident_response de choice met een waarschijnlijkheid van 91%. Jev’s confidence voor de keuze is 86%.
De volledige verdeling is het deel dat je aandacht verdient.
choice vertelt je alleen welke optie gewonnen heeft.
probabilities vertelt je met hoeveel.
Dat zijn verschillende brokken informatie als je op het punt staat een ticket automatisch te routeren. Een 0,41/0,38/0,21-verdeling en de 0,91/0,09/0 die we kregen, kunnen allebei dezelfde choice teruggeven.
Een Score beoordeelt de state langs geordende niveaus. Je geeft criteria door als een array van 2 tot 10 niveau-beschrijvingen, laagste eerst, en het antwoord bevat een score, een legend die elke positie koppelt aan jouw beschrijving, een waarschijnlijkheid per niveau en confidence.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}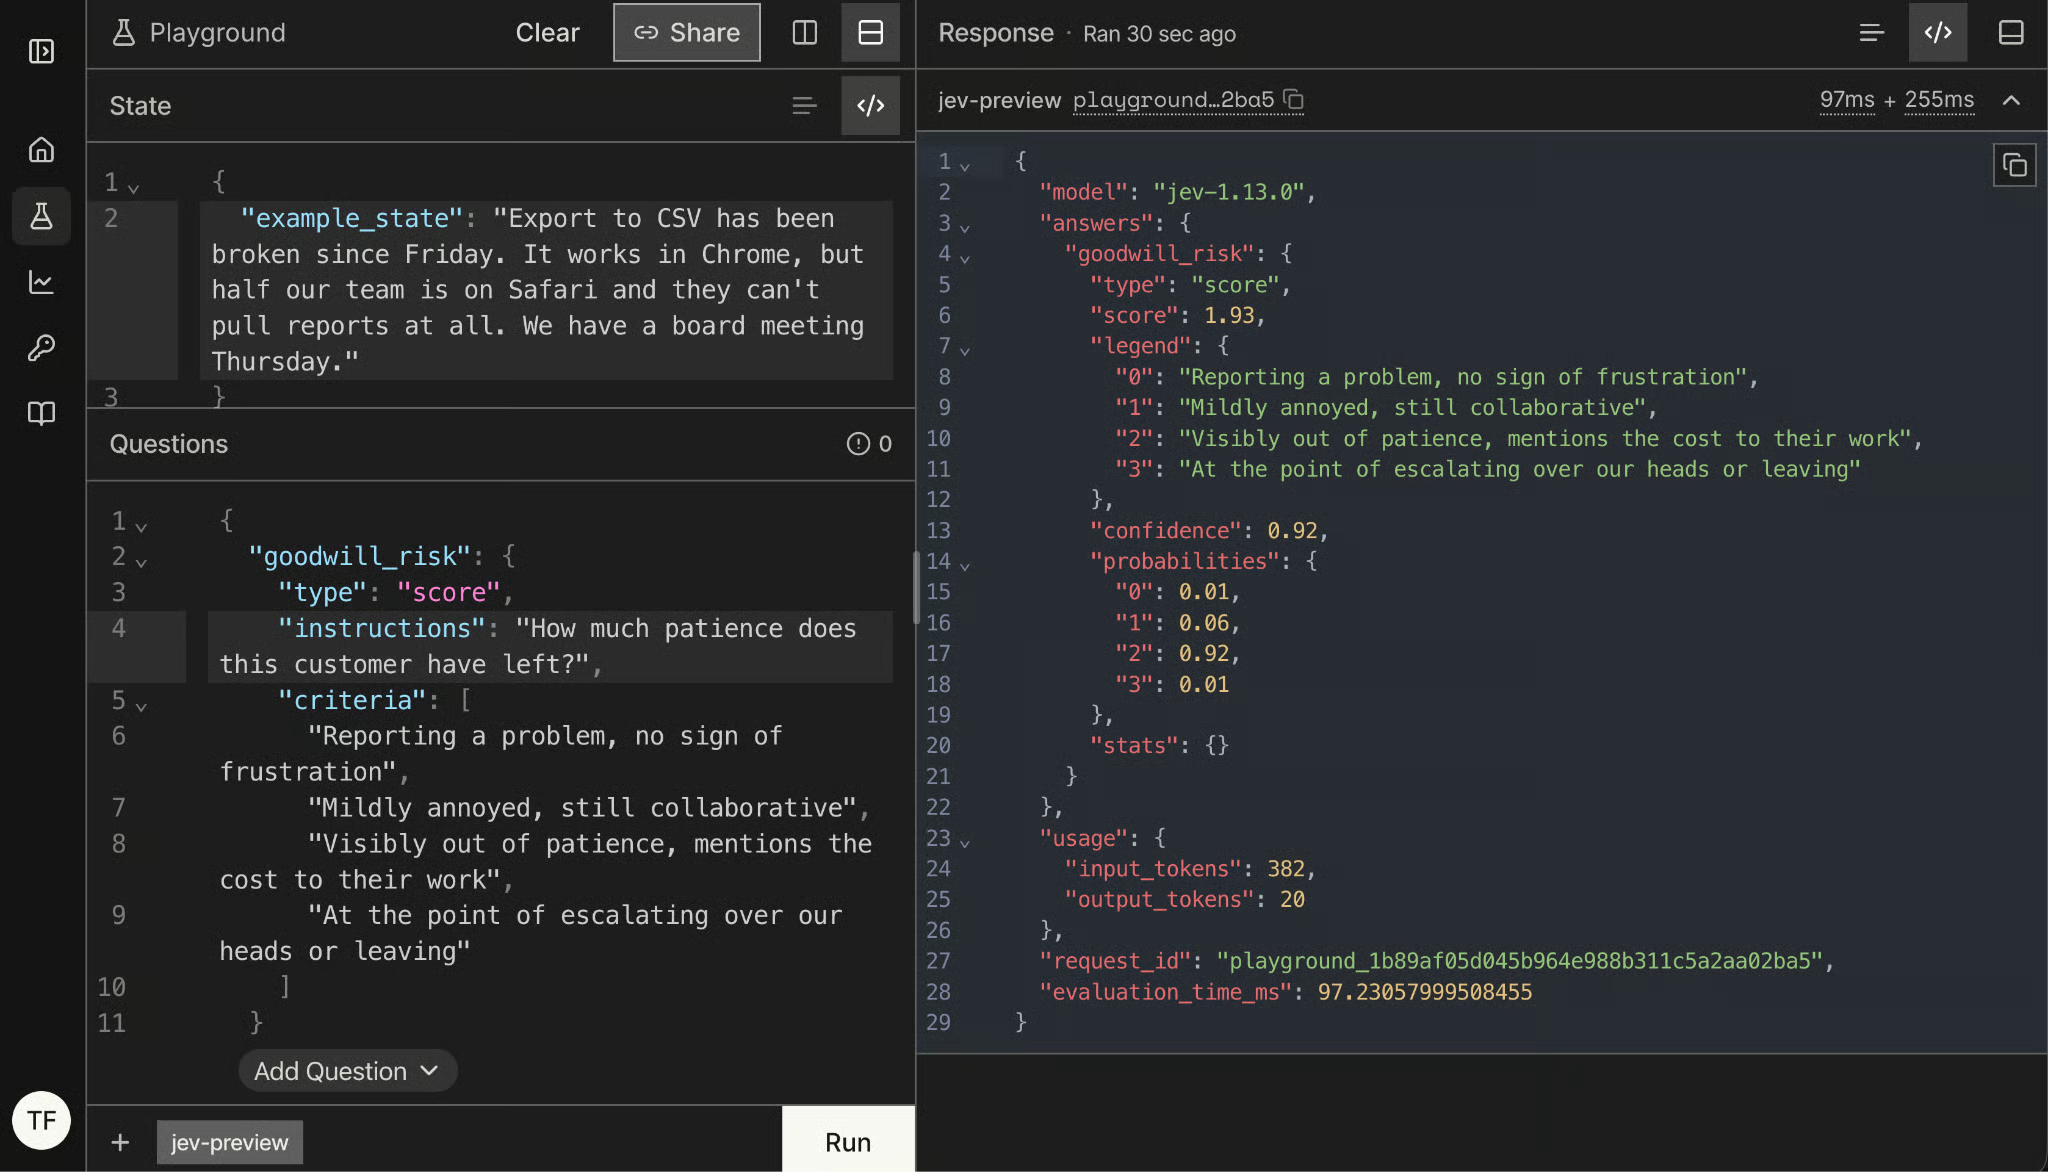
De score kan tussen je niveaus landen, en precies daarvoor is de legend. Een score van 1,93 betekent hier dat het model verdeeld is tussen “mild geërgerd” en “zichtbaar door het geduld heen”, met een sterke neiging naar het laatste—een terechte lezing van een ticket dat beleefd blijft maar een deadline noemt die het gaat missen.
Lees opnieuw de spreiding van probabilities in plaats van alleen het getal: geconcentreerde waarschijnlijkheid op één niveau betekent een beslissend antwoord; uitgesmeerd over drie betekent dat je een gemiddelde kreeg in plaats van een oordeel.
Een Noul is het type voor binaire vragen, en de naam is bedacht door TypeSafe. criteria is hier optioneel, al kun je beschrijven wat true en false betekenen—de moeite waard wanneer “ja” op twee manieren te lezen valt.
Formuleer de vraag zo dat een hoge waarde “ja” betekent. De documentatie van TypeSafe is hier expliciet over, en een Noul waarbij true naar “nee” mapt, presteert aantoonbaar slechter.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}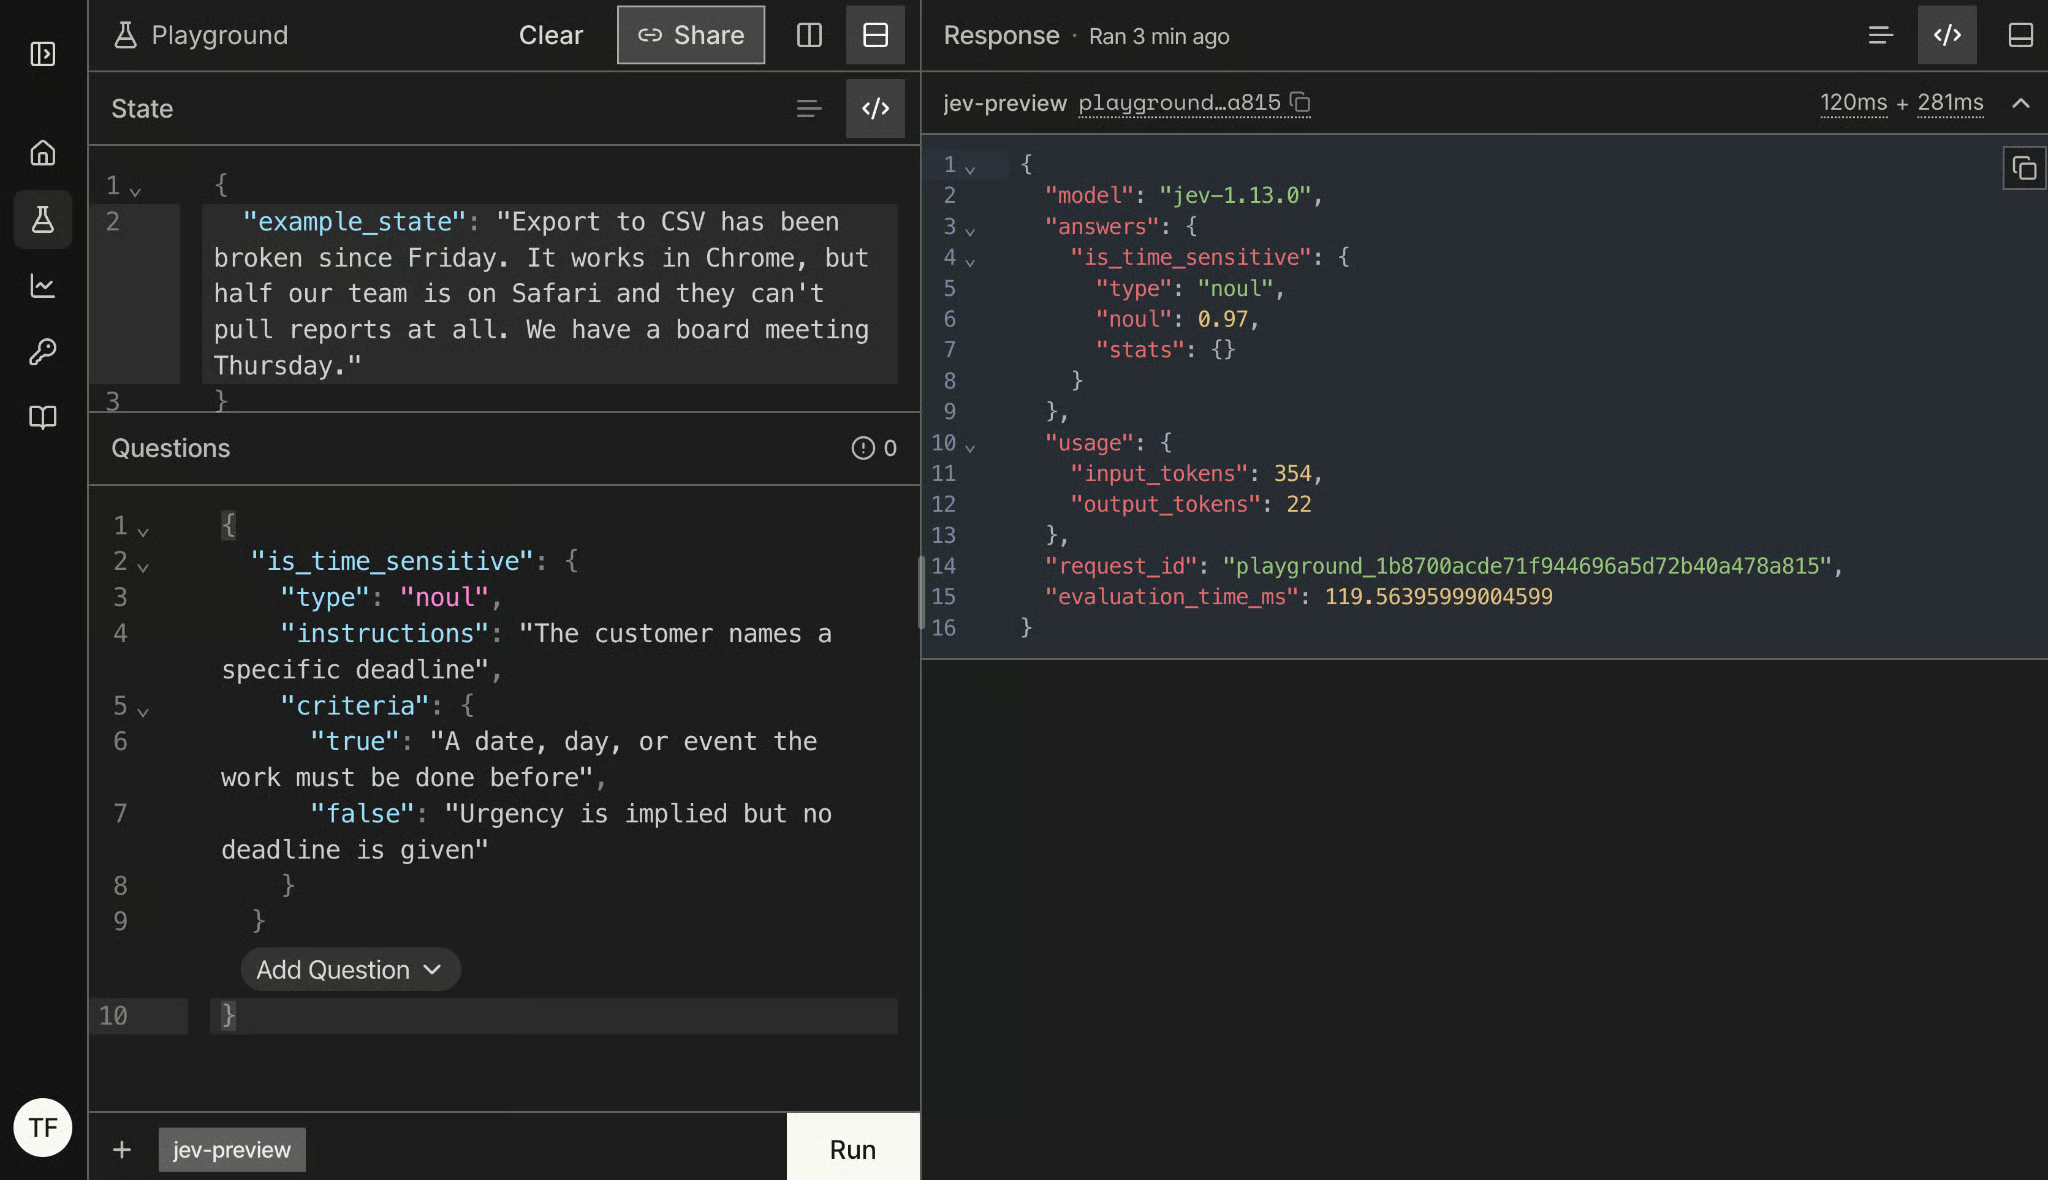
Omdat in de state een bestuursvergadering op donderdag wordt genoemd, was de hoge noul-waarde van 0,97 te verwachten.
Choice en Score geven confidence terug naast hun waarschijnlijkheden. Een Noul niet, en dat brengt mensen in de war, dus het is de moeite waard precies te zijn over waarom.
Confidence en waarschijnlijkheid zijn aparte assen. Bij een Choice zeggen probabilities hoe het model zijn geloof over jouw opties verdeelt, en confidence zegt hoe stevig het dat antwoord vasthoudt—daarom kan een Choice een 0,85 topoptie met een confidence van 0,78 teruggeven. Een Noul heeft slechts twee uitkomsten, dus de enkele waarschijnlijkheid drát beide: 0,97 is een vast “ja”, 0,03 is een vast “nee”, en 0,52 is het model dat zegt geen idee te hebben.
Dat betekent dat de afstand tot 0,5 je signaal voor beslistheid is, niet een apart veld. Het betekent ook dat je een drempel niet van een Noul naar een Choice kunt overzetten; ik kom daarop terug in de sectie over karteligheid, want dat bijt harder dan het klinkt.
Om mee te doen heb je alleen Python 3.10+ en een TypeSafe early-access key nodig.
Installeer de SDK:
pip install typesafe-sdkOf met uv:
uv add typesafe-sdkMaak vervolgens een sleutel aan in de TypeSafe-console en exporteer die. De client leest TYPESAFE_API_KEY uit de omgeving, zodat je hem nooit in code hoeft door te geven:
export TYPESAFE_API_KEY="your-key"De volgende imports geven je alles uit de playground:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul en Score zijn dezelfde vraagtypen waar je zojuist doorheen klikte, maar dan als Python-objecten.
TypeSafeClient is de synchrone client, en er is een AsyncTypeSafeClient met dezelfde interface als je Jev vanuit een async service aanroept. Beide werken als contextmanagers, wat ik zou gebruiken voor alles langer dan een script:
with TypeSafeClient() as client:
...Als je niets opgeeft, roept de client jev-latest aan, dat meebeweegt zodra TypeSafe een nieuwe versie uitbrengt—dat gebruiken we door de hele tutorial. Voor alles waar je al een drempel op hebt afgesteld, pin je in plaats daarvan de versie:
client = TypeSafeClient(model="jev-1.13.0")De response vertelt je in beide gevallen welk model daadwerkelijk antwoordde, en verderop staat een sectie over waarom je dat moet loggen.
Om een API-call naar Jev te doen, definieer je een response-item met TypeSafeClient en de functie system_one(), die je vraagcontext als state-parameter neemt en de questions in hetzelfde formaat als in de playground.
We kunnen één call maken die al onze 3 playgroundvragen beantwoordt, omdat ze dezelfde state delen:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
Antwoorden komen terug onder dezelfde namen die je voor elke vraag hebt gekozen—het detail dat het geheel prettig maakt om mee te werken:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97Als je eerste call faalt met een TypeError over output_buffer_limit: dat is een versie-mismatch in de compressie-backend van de SDK, niet jouw code. De SDK levert zijn eigen HTTP-client, httpx2, die responses decomprimeert via zstandard en brotli, en een oudere kopie van een van beide mist het argument waarmee hij wordt aangeroepen. pip install -U typesafe-sdk httpx2 zstandard brotli loste het bij mij op.
Twee dingen in die output zijn het stilstaan waard.
Ten eerste, response.model gaf jev-1.13.0 terug, niet jev-latest. Je vroeg om de bewegende alias en Jev vertelde welke versie daadwerkelijk antwoordde—de enige reden waarom het loggen van dat veld goedkoop genoeg is om de moeite waard te zijn.
Ten tweede, de antwoordobjecten zijn getypt per vraagtype, dus .choice, .score en .noul zijn echte attributen en je editor kent ze. Er staat nergens een JSON-string in deze code, niets om te parsen, en geen branch voor de call die misvormd terugkwam. Als je liever groepeert, stelt de SDK ook response.choices, response.scores en response.nouls beschikbaar, op dezelfde manier ge-keyed.
Kijk ook naar response.usage:
print(response.usage.input_tokens, response.usage.output_tokens)524
78Outputtokens zijn enkelcijferig en gratis. Je betaalt voor de state en de vragen, dus je kunt de kosten volledig sturen door te beslissen hoeveel context je meestuurt. Dat is belangrijker dan het lijkt en komt terug in de karteligheidssectie: een opgeblazen state kost je tegelijk geld en nauwkeurigheid.
Dit is een van de usecases waarvoor Jev is gebouwd. Er komt een supportticket binnen, en iets moet beslissen naar welke wachtrij het gaat, of een mens er eerst naar moet kijken, en hoe snel. Elk daarvan is een oordeel met een antwoordruimte die je vóór aankomst kunt uitschrijven.
De ontwerpregel om vooraf te noemen: Jev beslist wat is, jouw code beslist wat er gebeurt. Jev routeert nooit iets. Het retourneert getallen, en de routing leeft in een gewone functie die je kunt lezen, testen en wijzigen zonder het model aan te raken.
Vragen in één verzoek worden parallel geëvalueerd, dus een zesde vraag kost je de tokens waarin hij is geschreven en bijna geen extra latency. Dat verandert hoe je vraagt. Met een LLM batch je zorgvuldig om round-trips te besparen, maar hier vraag je alles wat je misschien wilt weten over een bepaalde context, inclusief vragen die je waarschijnlijk negeert.
Laten we onze eerdere vragen uitbreiden met drie extra Nouls die belangrijke informatie geven over hoe we het ticket afhandelen:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
Zes vragen, allemaal beantwoord in één call en één rekening. is_automated is de speculatieve: die is bijna altijd false op echte tickets, en toch de moeite waard om te stellen, want die ene keer dat hij true is, bespaar je iemand het openen van een mailer-daemon-bounce.
Twee gewoontes die ik hier zou oppikken.
Houd de vraagenset als moduleconstante in plaats van hem inline op te bouwen, want dit is het ding dat je samen met je drempels versieert.
En noem vragen naar wat ze meten, niet naar wat je met het antwoord gaat doen, want is_time_sensitive overleeft een beleidswijziging en route_to_incident niet.
Formuleer vragen positief: we hadden is_automated ook iets als needs_no_reply kunnen noemen, maar volgens TypeSafe presteren positief geformuleerde vragen beter.
Nu het deel dat Jev niet doet. Elk antwoord komt aan met een confidence-waarde of een waarschijnlijkheid, en dat tweede getal is wat je in staat stelt drie paden te bouwen in plaats van twee:
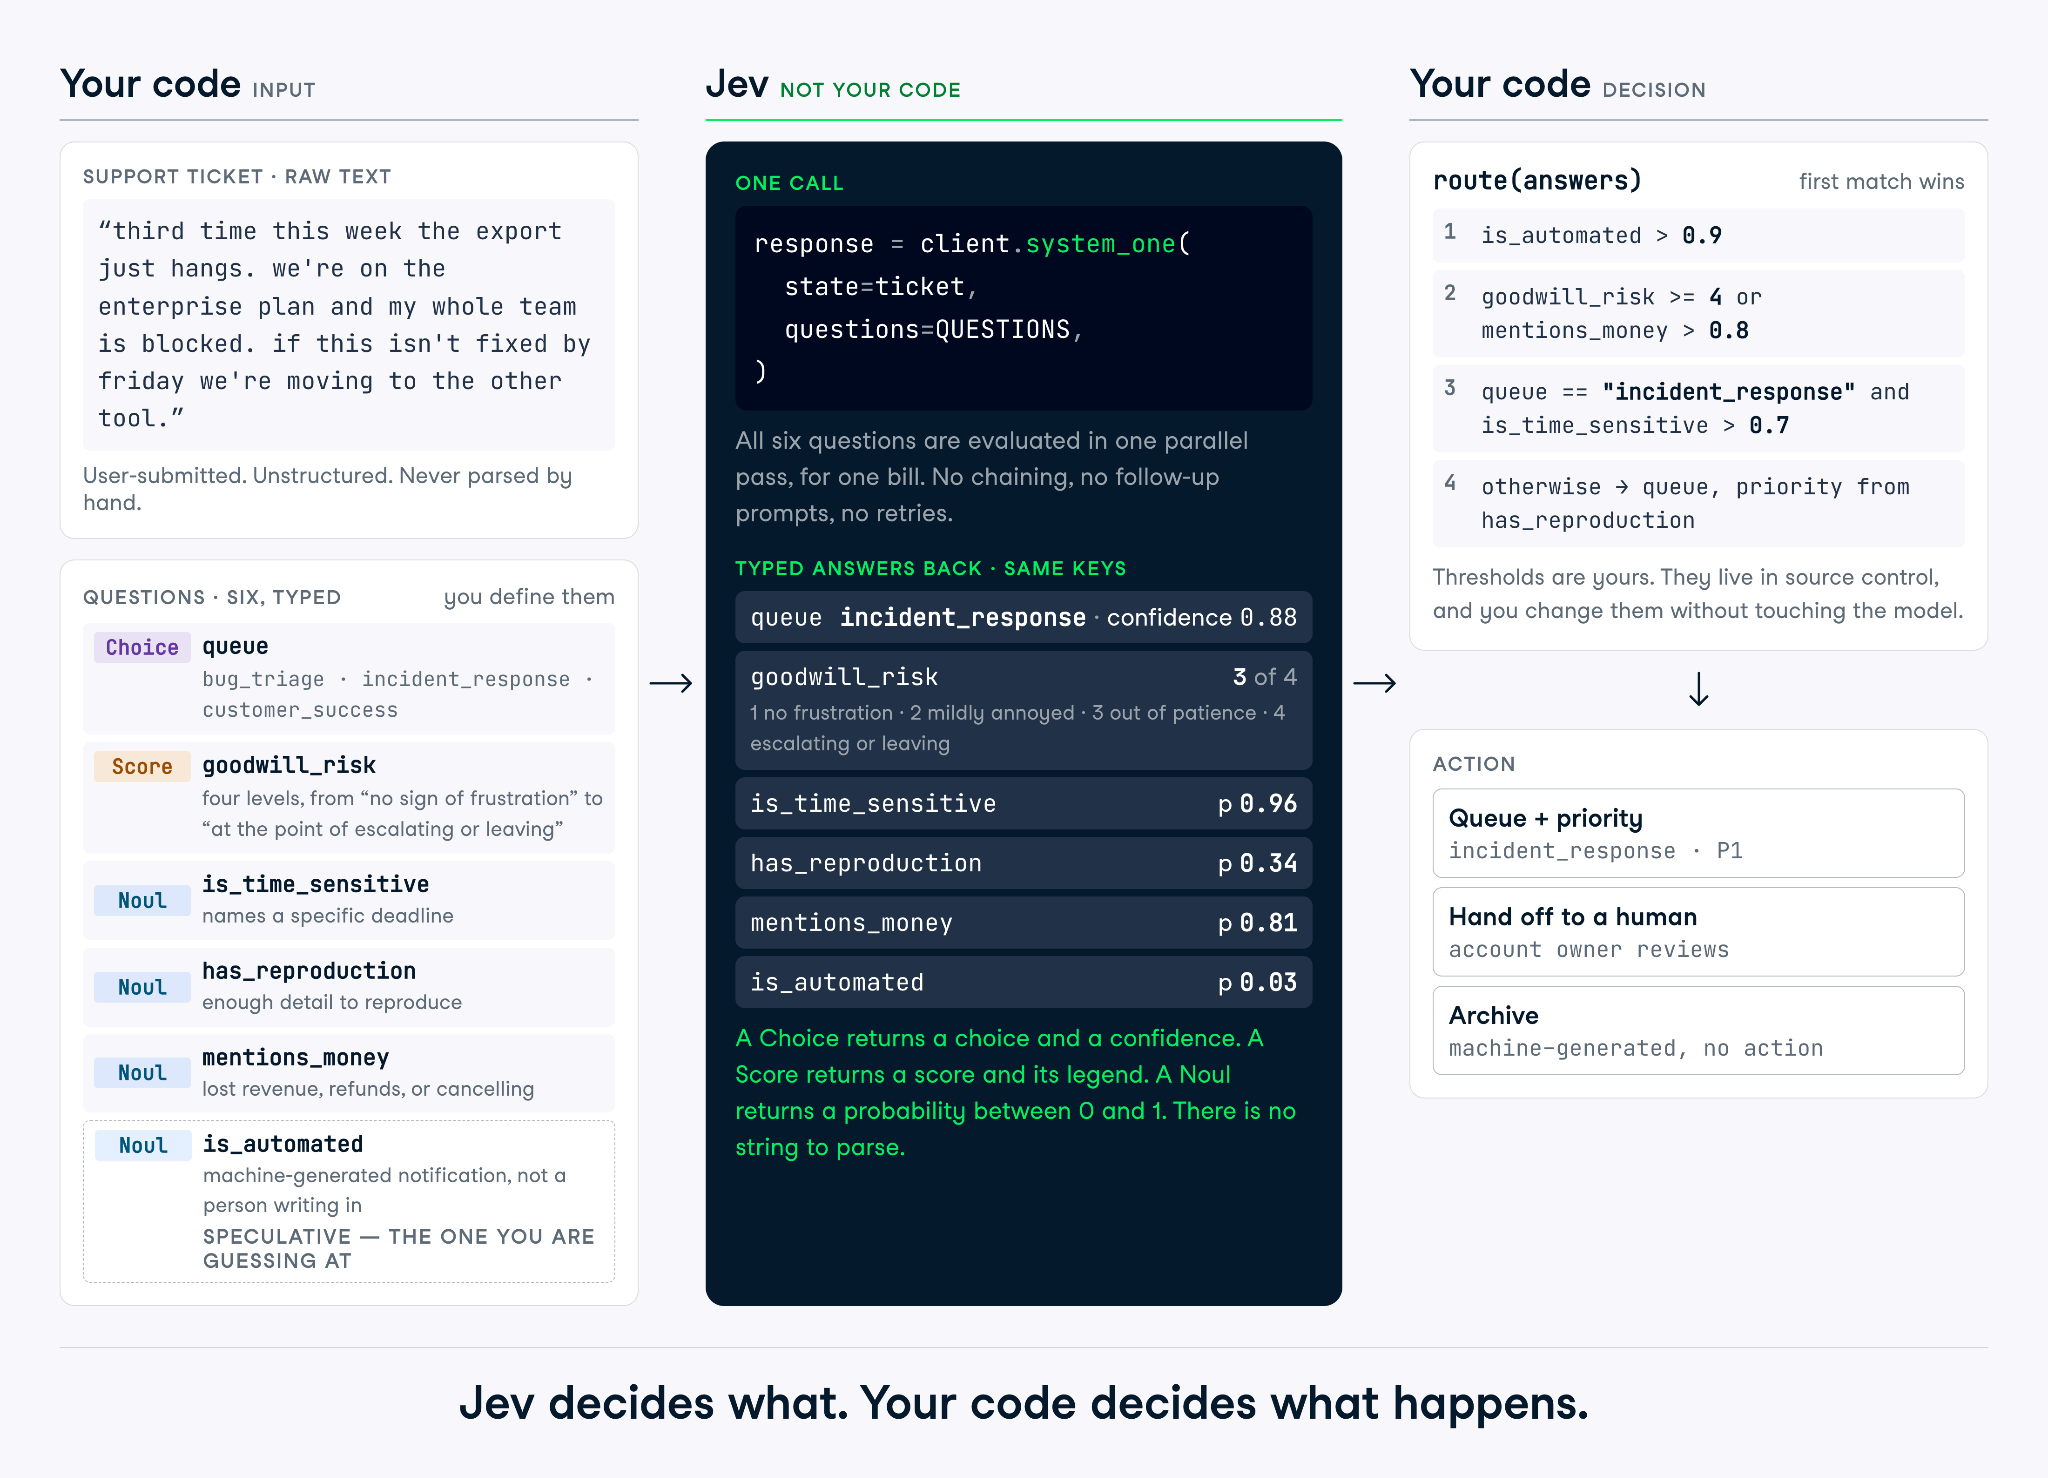
Laten we dat omzetten naar een paar regels voor ticketrouting:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
Lees wat die functie doet. Het model leverde zes oordelen, en het beleid besloot dat één daarvan, mentions_money gekruist met een gefrustreerde klant, zwaarder weegt dan de wachtrij die Jev koos. Die override is een zakelijke beslissing, hoort in code, en je kunt hem op een vrijdagmiddag veranderen zonder een model opnieuw te testen.
has_reproduction wordt nooit gebruikt. Ik liet het er expres in staan, want zo ziet het fan-outpatroon er in de praktijk uit: je vraagt meer dan het huidige beleid verbruikt, logt alles, en als iemand vraagt of bug_triage-tickets zonder repro-stappen langer duren om te sluiten, heb je al zes weken aan antwoord.
De drempels hierboven zijn slechts voorbeelden. De juiste bepalen is een kwestie van kalibreren, en aan het eind staat een sectie over hoe je ze instelt met data in plaats van gevoel.
Je kunt het volledige script vinden in deze bijbehorende GitHub-repo. Toen ik het Python-script draaide met ons scenario, was het oordeel om het ticket vandaag naar het incident response-team te routeren.
python routing.py('incident_response', 'today')TypeSafe publiceert een karteligheidspagina per modelversie met bekende faalmodi. Ik wou dat meer labs dit deden. Lees hem vóór je iets bouwt, en opnieuw wanneer je upgrade, want de lijst is versiegebonden en de randen verschuiven.
Hier zijn de vijf die mij de meeste tijd hadden gekost.
Je kunt een drempel niet overzetten tussen vraagtypen. Het eigen voorbeeld van TypeSafe vraagt “Vraagt de klant om een terugbetaling?” op beide manieren op hetzelfde ticket: de Noul retourneert 0,22, de ja/nee-Choice geeft 0,01 voor ja, met 0,97 confidence. Dezelfde vraag, twee getallen, twee ordes van grootte uit elkaar.
Negaties werken ook niet samen. Een Noul en zijn tegenovergestelde kwamen terug op 0,72 en 0,47, wat optelt tot 1,19.
De reden is dat de twee typen iets anders vragen. Een Choice is relatief en beslist welke optie wint, terwijl elke Noul absoluut is en voor allemaal laag kan zijn. Stel drempels per vraag af, in de vorm waarin je gaat shippen, en neem nooit aan dat P(yes) en 1 - P(no) hetzelfde getal zijn.
Scoreniveaus zijn geordend, niet gelijkmatig gespreid. Een 1,6 vertelt je dat het model tussen je tweede en derde niveau zit en naar de derde helt; dat is alles.
Wat je niet kunt doen, is er een echte grootheid uit interpoleren. Als je niveaus “onder een uur”, “een paar uur” en “een dag” zijn, betekent 1,5 niet vijf uur. Gebruik de score om een drempel te testen en houd elk werkelijk getal in code.
Jev behandelt de state als data, maar is niet gehard tegen door de state geschreven “code” die het stuurt. Een geïnjecteerde instructie, misleidende framing of tekst die voor zijn eigen classificatie pleit, kan het antwoord beïnvloeden, en TypeSafe zegt hier verbetering te verwachten. Als het aanvalsoppervlak nieuw voor je is, behandelen we de algemene case in onze prompt injection-gids.
Dat doet er het meest toe waar de state door gebruikers aangeleverd is, wat voor een ticketrouter altijd zo is. Schrijf criteria zo precies dat de eigen claims van het ticket niet de uitkomst bepalen, en test met vijandige inputs voordat je iets automatisch routeert.
Tellen is onbetrouwbaar en wordt slechter naarmate het te tellen groeit, omdat het model de vorm van een antwoord herkent in plaats van te turven. Datums worden als tekst gelezen, dus ordening, afstand en vensters gaan mis. Numerieke encoderingen presteren slechter dan hun semantische equivalenten, dus vraag naar “rood” in plaats van #FF0000.
De fix is in alle drie gevallen dezelfde: splits het werk.
Als je een telling nodig hebt, itereer dan in code en stel één Noul per item:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)Drie kleinere die dezelfde oorzaak delen. Jev beantwoordt de vraag die je schreef, niet die je bedoelde, dus scope-woorden en negaties worden letterlijk gelezen. Dubbele negaties en vragen over een eigenschap van een eigenschap kosten nauwkeurigheid. En een grote state, opgevuld met irrelevante details, kost zowel nauwkeurigheid als geld, omdat ongerelateerde materie afleidt.
De aanwijzing voor de eerste: als je naar een fout antwoord kijkt en jezelf erop betrapt uit te leggen wat je eigenlijk bedoelde, dan is die uitleg de ontbrekende helft van je instructie.
Gebaseerd op wat we al geleerd hebben, hier een paar best practices om het meeste uit Jev te halen.
Schrijf de conditie in plaats van de intentie. Als je bij het beoordelen van een fout antwoord uitlegt wat je bedoelde, hoort die uitleg in de instructions. Concreet:
jev-latest beweegt mee. Pin de versie zodra een drempel van modelgedrag afhangt:
client = TypeSafeClient(model="jev-1.13.0")Log response.model naast de volledige antwoorden bij elke call, niet alleen de waarde waarop je handelde. Wanneer een drempel zich raar gaat gedragen, is die log de enige manier om een modelwijziging te onderscheiden van drift in je tickets.
Tot slot: drempels zijn geen gegeven, maar het resultaat van experimenten.
Jev is een smal gereedschap, en dat is precies de bedoeling. Het beantwoordt vragen waarvan je de antwoorden kunt opsommen, goedkoop genoeg dat je ermee stopt om ze te rantsoeneren, en geeft de beslissing terug aan je code.
Waar ik tegenin zou gaan, is de framing “kan niet hallucineren”. In enge zin klopt het dat het model niet off-schema kan antwoorden, maar dat zegt niets over of het antwoord juist is. Een Choice retourneert altijd een geldige wachtrij. Het kan nog steeds de verkeerde wachtrij zijn met 0,9 confidence, en getypte output maakt die fout stiller.
Om het voor je eigen werk te testen, raad ik aan één beslissing te zoeken die je code nu neemt met een breekbare regel of een trage LLM-call, en probeer de geldige antwoorden op te schrijven. Als dat lukt, is het Jev-vormig. Als het niet lukt, gaat geen enkele vraag-engineering dat veranderen.
Wil je beginnen met het bouwen van systemen die AI gebruiken? Dan raad ik je sterk aan om je in te schrijven voor ons Associate AI Engineer for Developers-carrièreroute. Je leert werken met de OpenAI API, MCP, LangChain en veel meer.
Leer AI Engineering met DataCamp!
Leerpad
Cursus
Cursus