
Cursus
Fijn-afstemmen met Llama 3
2 uur
4.1K
Qwen3.5 Small is een praktisch model voor lichtgewicht fijnstemmen, omdat het is ontworpen voor prototyping, taakgerichte aanpassing en researchworkflows. Gecombineerd met QLoRA kunnen we het fijnstemmen bovenop een bevroren 4-bit gequantiseerd basismodel, waardoor het proces veel geheugenefficiënter wordt en toegankelijker op beperkte hardware.
In deze tutorial richten we de omgeving in, laden we het model en de AG News-dataset, evalueren we het basismodel en stemmen we vervolgens Qwen3.5 Small fijn voor nieuwsclassificatie. We sluiten af met een vergelijking van de resultaten vóór en na het trainen, en slaan daarna de LoRA-adapter op en publiceren die op Hugging Face voor hergebruik.
Ik raad je aan om de Hugging Face Fundamentals skill track te volgen als je nog niet bekend bent met hoe het werkt.
Voordat we in de code duiken, is het handig om het model te begrijpen waarmee we werken. Qwen3.5 is een familie van foundation-modellen, en de "Small"-serie verwijst naar hun lichtgewicht line-up, specifiek modellen onder de 10 miljard parameters. Voor deze tutorial gebruiken we de 0.8B-versie.
Ondanks dat het slechts 800 miljoen parameters heeft, is Qwen3.5-0.8B zeer capabel en extreem efficiënt. In 4-bit precisie geladen heeft het minder dan 2 GB VRAM nodig. Dit maakt het een uitstekende match voor consumentlaptops, gratis cloudomgevingen zoals Kaggle en lichte edge-deployments.
Daarnaast ondersteunt de Qwen3.5-architectuur een enorme contextwindow van 262K en native multimodaliteit. Hoewel we ons in deze gids strikt richten op tekstclassificatie, kunnen de basisconcepten die we behandelen later eenvoudig worden uitgebreid naar visietaken. Het model heeft ook een hybride redeneermodus, maar die laten we uitgeschakeld om de inferentiesnelheid te maximaliseren voor onze eenvoudige labeltaak.
Al met al is Qwen3.5-0.8B een zeer praktische optie voor prototyping. Het biedt een snelle, goedkope manier om fijnstemmingsworkflows te testen en levert toch sterke downstream-resultaten.
In deze tutorial gebruiken we een Kaggle-notebook als onze trainingsomgeving. Kaggle geeft ons toegang tot GPU's, wat het een handige plek maakt om ons model te trainen, fijn te stemmen en te evalueren. Start vóór het draaien van het notebook een nieuw Kaggle-notebook, open de Session-instellingen en kies GPU P100 als accelerator.
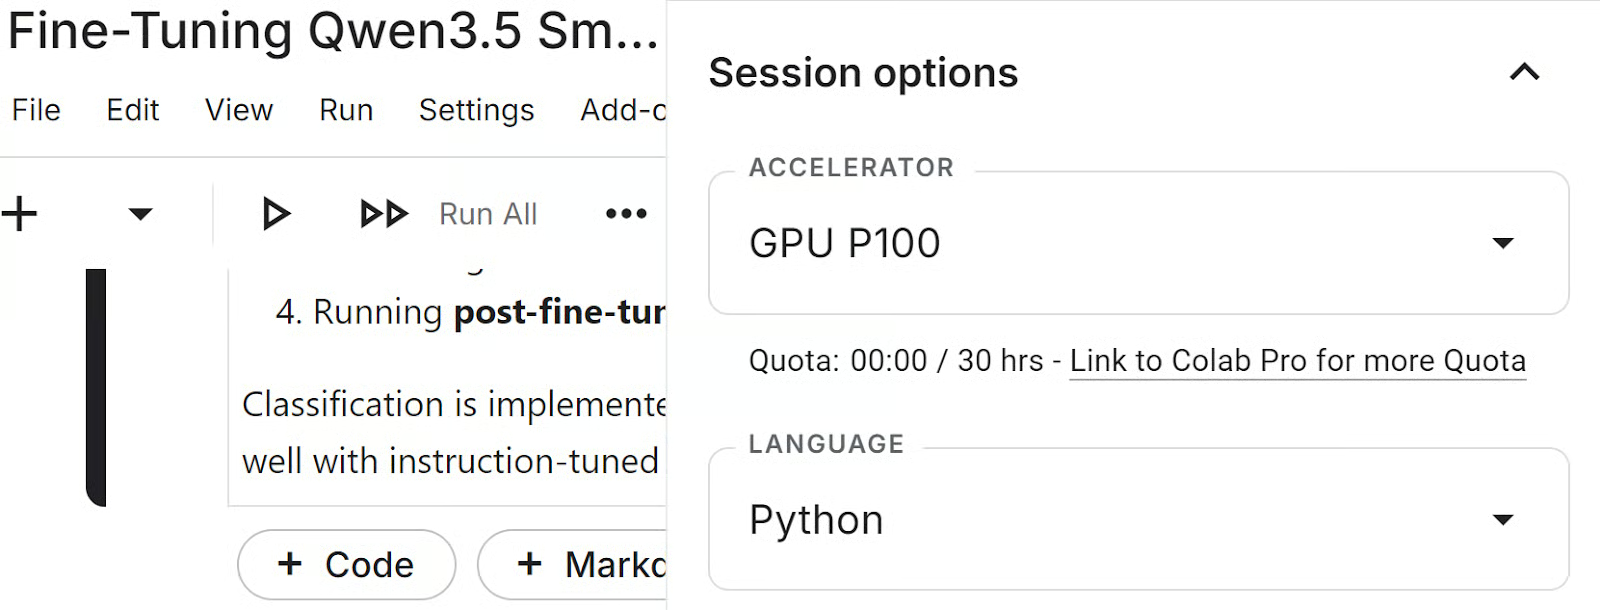
Vervolgens richten we de omgeving in, voegen we een Hugging Face-token toe aan Kaggle en importeren we de Python-bibliotheken die in de hele tutorial worden gebruikt.
Maak vóór het draaien van het notebook een Hugging Face-toegangstoken aan via je accountinstellingen. Ga naar Settings, open Access Tokens en genereer een nieuw token. Als je de fijngetunede LoRA-adapter aan het einde van de tutorial naar de Hugging Face Hub wilt publiceren, zorg er dan voor dat het token schrijfrechten heeft.
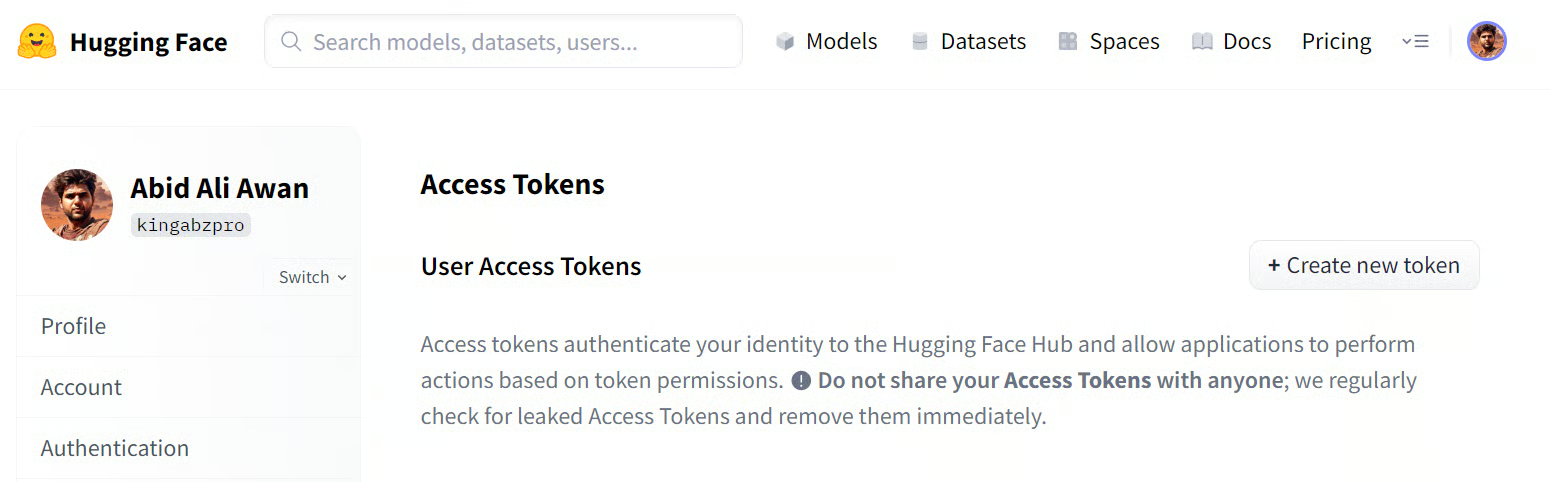
Open na het genereren van het token je Kaggle-notebook en voeg het toe als een secret. Ga in de notebook-editor naar Add-ons, vervolgens Secrets, en maak een nieuwe secret met de naam HUGGINGFACE_TOKEN aan. Plak daar je tokenwaarde zodat het notebook er veilig toegang toe heeft zonder het in de code bloot te leggen.
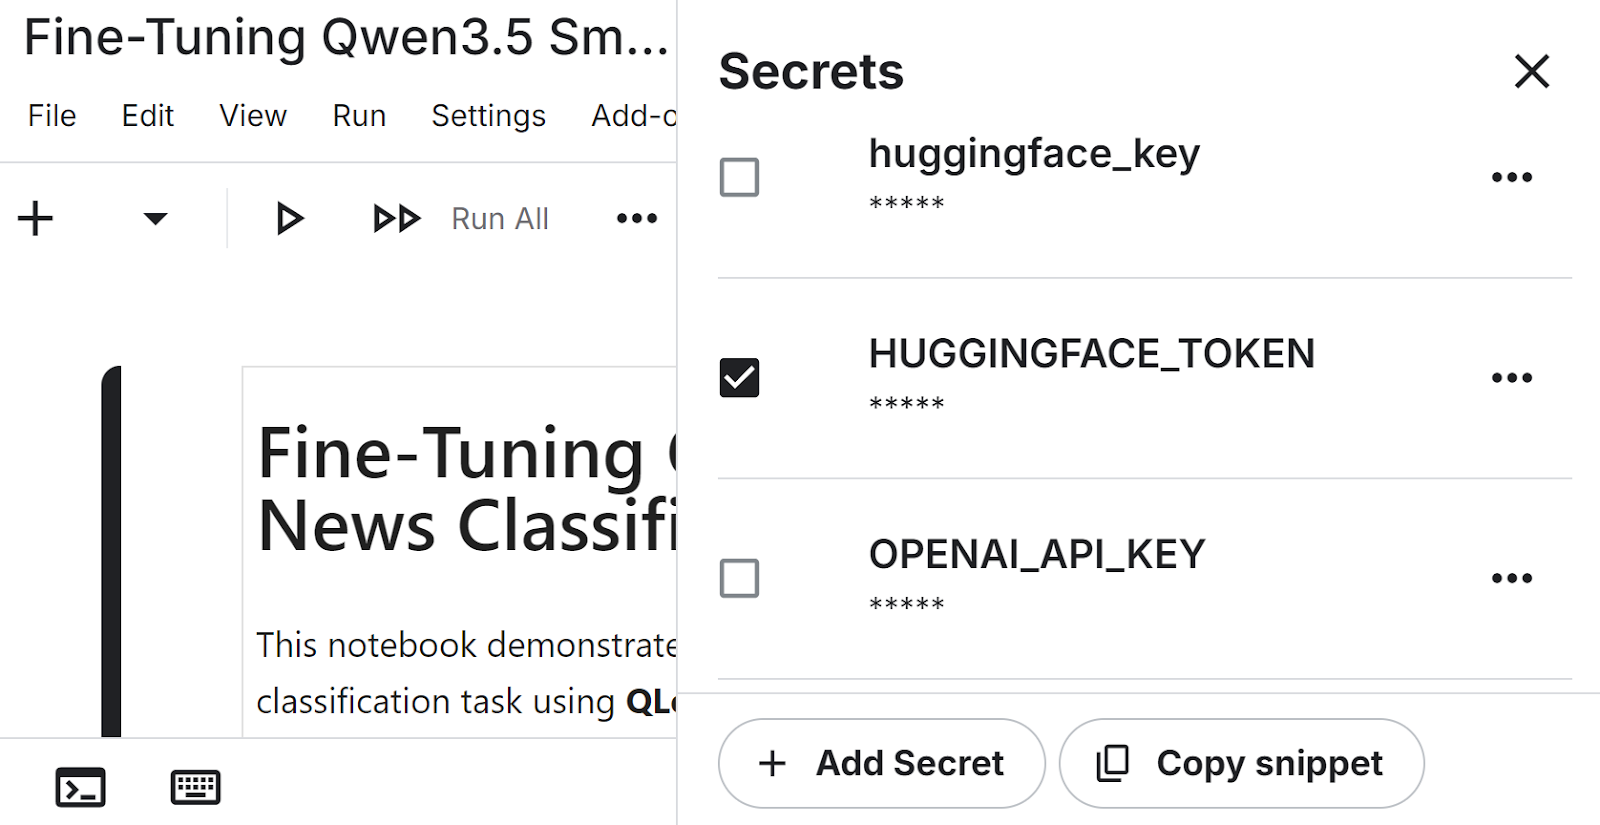
Nu kunnen we de belangrijkste bibliotheken installeren die we voor deze workflow nodig hebben. Deze pakketten dekken het laden van het model, quantization, parameter-efficiënt fijnstemmen, datahandeling en evaluatie.
!pip install -q -U transformers accelerate
!pip install -q peft trl bitsandbytes datasets scikit-learnVervolgens laden we het Hugging Face-token uit Kaggle secrets en gebruiken we dit om te authenticeren. Zo krijgt het notebook toegang tot het model en kunnen we later de getrainde adapter pushen.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient

user_secrets = UserSecretsClient()
login(token=user_secrets.get_secret("HUGGINGFACE_TOKEN"))Tot slot importeren we de Python-bibliotheken die in de hele tutorial worden gebruikt voor het laden van het model, trainen, het verwerken van de dataset en evaluatie.
import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
from peft import LoraConfig, get_peft_model
from trl import SFTTrainer, SFTConfig
from transformers import TrainingArguments
from sklearn.metrics import accuracy_score, f1_score
from tqdm.notebook import tqdmNu de omgeving klaar is, kunnen we het basismodel laden en de dataset voorbereiden voor fijnstemmen.
In deze sectie laden we Qwen3.5-0.8B in 4-bit precisie om het trainen geheugenefficiënter te maken, zetten we de tokenizer op en laden we een kleine subset van de AG News-dataset voor training en evaluatie.
We beginnen met het laden van Qwen3.5-0.8B met 4-bit quantization met BitsAndBytes. Dit verlaagt het geheugengebruik en maakt het model praktischer om mee te werken in een Kaggle-notebookomgeving.
model_id = "Qwen/Qwen3.5-0.8B"

bnb_config = BitsAndBytesConfig(
  load_in_4bit=True,
  bnb_4bit_quant_type="nf4",
  bnb_4bit_compute_dtype=torch.bfloat16
)

model = AutoModelForCausalLM.from_pretrained(
  model_id,
  quantization_config=bnb_config,
  device_map="auto",
  dtype=torch.bfloat16
)Vervolgens laden we de tokenizer voor hetzelfde model. We stellen de padding-token ook in op de end-of-sequence-token zodat het model tijdens training en generatie correct met gepadde input kan omgaan.
tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.pad_token = tokenizer.eos_token

model.config.pad_token_id = tokenizer.eos_token_id
model.generation_config.pad_token_id = tokenizer.eos_token_idTot slot laden we de AG News-dataset en maken we kleinere training- en test-splits voor deze tutorial. Met een subset blijft de workflow sneller, terwijl we toch genoeg data hebben om het effect van fijnstemmen te evalueren.
dataset = load_dataset("ag_news")

train_dataset = dataset["train"].select(range(2500))
test_dataset = dataset["test"].select(range(200))Voordat we gaan fijnstemmen, moeten we definiëren hoe het model de taak ziet en meten hoe goed het in oorspronkelijke vorm presteert.
In deze sectie maken we een instructiestijlprompt voor nieuwsclassificatie, extraheren we voorspellingen uit de modeloutput, draaien we een voorbeeldinference en evalueren we het basismodel op de testset vóór het trainen.
We beginnen met het definiëren van de labelnamen en bouwen een prompt die het model vraagt een nieuwsartikel te classificeren. De prompt is zo geschreven dat het model alleen het numerieke label teruggeeft, wat de output makkelijker maakt om te parsen tijdens de evaluatie.
labels = ['World','Sports','Business','Sci/Tech']

def build_prompt(text):

    return f"""
Classify the news article.

Article:
{text}

Return ONLY the number of the correct label.

0 = World
1 = Sports
2 = Business
3 = Sci/Tech

Answer:
"""Vervolgens maken we een kleine helperfunctie om het voorspelde label uit de gegenereerde tekst te halen. Deze functie verwijdert eventuele extra redeneertokens en geeft het uiteindelijke klasselabel terug als een integer.
import re

def extract_label(text):

   text = re.sub(r"<think>.*?</think>", "", text, flags=re.DOTALL)
   matches = re.findall(r"[0-3]", text)

   if matches:
       return int(matches[-1])

return -1Voordat we het model op de volledige testset evalueren, proberen we het eerst op één voorbeeld. Dit helpt ons het artikel te inspecteren, het juiste label te controleren en te zien wat het model voorspelt vóór het fijnstemmen.
sample = train_dataset[10]

sample_text = sample["text"]
sample_label = sample["label"]

print("Ground truth label:", sample_label)
print("Sample text:")
print(sample_text[:300])
De output laat zien dat het ware label 2 is, wat overeenkomt met Business.
Ground truth label: 2
Sample text:
Oil and Economy Cloud Stocks' Outlook  NEW YORK (Reuters) - Soaring crude prices plus worries  about the economy
and the outlook for earnings are expected to  hang over the stock market next week during the depth of the  summer doldrums.
Vervolgens formatteren we de prompt, geven die door aan het model en genereren we een voorspelling.
prompt = build_prompt(sample_text)

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")

with torch.inference_mode():
    outputs = model.generate(
        **inputs,
        max_new_tokens=5,
        do_sample=False,
        pad_token_id=tokenizer.eos_token_id
    )

prediction = tokenizer.decode(outputs[0], skip_special_tokens=True)

print("Model prediction (before training):")
print(extract_label(prediction))
Het model voorspelt ook 2, dus het classificeert dit voorbeeld correct. Dit geeft ons een snelle check dat de promptopmaak en de predictiepijplijn werken zoals verwacht.
Model prediction (before training):
2Nu evalueren we het basismodel op de testset om een baseline vast te stellen. Dit geeft ons een referentiepunt om de prestaties vóór en na het fijnstemmen te vergelijken.
def evaluate_model(dataset):

    preds = []
    refs = []

    model.eval()

    for example in tqdm(dataset):

        text = example["text"]
        label = example["label"]

        prompt = build_prompt(text)

        inputs = tokenizer(prompt, return_tensors="pt", truncation=True)
        inputs = {k: v.to("cuda") for k, v in inputs.items()}

        with torch.inference_mode():

            outputs = model.generate(
                **inputs,
                max_new_tokens=5,
                do_sample=False,
                pad_token_id=tokenizer.eos_token_id
            )

        prediction = tokenizer.decode(outputs[0], skip_special_tokens=True)

        pred_label = extract_label(prediction)

        preds.append(pred_label)
        refs.append(label)

    acc = accuracy_score(refs, preds)
    f1 = f1_score(refs, preds, average="weighted")

    print("Accuracy:", acc)
    print("F1:", f1)


print('Pre-fine-tuning evaluation')
evaluate_model(test_dataset)
De output meldt een accuracy van 0.52 en een gewogen F1-score van 0.4589. Deze baselineresultaten laten zien dat het model de taak al enigszins kan uitvoeren, terwijl er nog duidelijke ruimte voor verbetering is via fijnstemmen.
Pre-fine-tuning evaluation
Accuracy: 0.52
F1: 0.45889163289429247Nu we een baseline hebben, kunnen we het model fijnstemmen op de nieuwsclassificatietaak. In deze sectie formatteren we de trainingsdata, configureren we de LoRA-adapters, definiëren we de trainingsinstellingen, trainen we het model en slaan we de uiteindelijke adapter op voor later gebruik.
Eerst formatteren we elk trainingsvoorbeeld zodat het dezelfde promptstructuur volgt als tijdens inference. We voegen het juiste label toe aan het einde van de prompt zodat het model tijdens het fijnstemmen leert het juiste antwoord te genereren.
def format_train(example):
    prompt = build_prompt(example['text'])
    answer = str(example['label'])
    return {'text': prompt + ' ' + answer}

train_dataset = train_dataset.map(format_train)Vervolgens definiëren we de LoRA-configuratie. Dit vertelt het model welke lagen moeten worden aangepast tijdens het fijnstemmen, zodat we een kleine set extra parameters trainen in plaats van het volledige model bij te werken.
lora_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0,
    bias='none',
    task_type='CAUSAL_LM',
    target_modules=[
        'q_proj','k_proj','v_proj','o_proj',
        'gate_proj','up_proj','down_proj'
    ]
)Daarna stellen we de trainingsargumenten in voor supervised fine-tuning. Deze instellingen bepalen hoeveel voorbeelden tegelijk worden verwerkt, hoe gradients worden geaccumuleerd, hoe lang de training duurt en waar de uitvoerbestanden worden opgeslagen.
training_args = SFTConfig(
    output_dir="./qwen35-lora",
    per_device_train_batch_size=8,
    gradient_accumulation_steps=2,
    learning_rate=2e-4,
    num_train_epochs=1,
    logging_steps=10,
    bf16=True,
    dataset_text_field="text",
    packing=False,
)Nu initialiseren we de trainer met het model, de dataset, de LoRA-configuratie, de trainingsinstellingen en de tokenizer. Vervolgens starten we het fijnstemmen van het model op de geformatteerde AG News-trainingsset.
trainer = SFTTrainer(
    model=model,
    train_dataset=train_dataset,
    peft_config=lora_config,
    args=training_args,
    processing_class=tokenizer
)
trainer.train()
Output:
TrainOutput(global_step=157, training_loss=1.9094241804378047, metrics={'train_runtime': 616.477, 'train_samples_per_second': 4.055, 'train_steps_per_second': 0.255, 'total_flos': 1041693973114368.0, 'train_loss': 1.9094241804378047})Na het trainen slaan we de LoRA-adapter en tokenizer op. Zo kunnen we de fijngetunede adapter later opnieuw laden voor evaluatie, delen of publiceren op Hugging Face.
trainer.model.save_pretrained("qwen35-small-news-class")
tokenizer.save_pretrained("qwen35-small-news-class")Na het trainen laden we het basismodel opnieuw en koppelen we de opgeslagen LoRA-adapter. Zo kunnen we de evaluatie draaien met de fijngetunede gewichten en de resultaten vergelijken met de eerdere baseline.
We laden eerst het Qwen3.5-basismodel opnieuw en koppelen daarna de fijngetunede LoRA-adapter die is opgeslagen in de Kaggle-werkdirectory. Vervolgens zetten we het model in evaluatiemodus en bekijken we de samenvatting van de trainbare parameters.
from transformers import AutoModelForCausalLM
base_model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype=torch.bfloat16
)


from peft import PeftModel

model = PeftModel.from_pretrained(
    base_model,
    "/kaggle/working/qwen35-small-news-class"
)

model.eval()
model.print_trainable_parameters()
De output laat zien dat er in deze fase geen trainbare parameters zijn, omdat de training is voltooid en we nu de opgeslagen adapter gebruiken voor inferentie en evaluatie.
trainable params: 0 || all params: 758,782,784 || trainable%: 0.0000Vervolgens draaien we dezelfde evaluatiefunctie opnieuw op de testset. Zo kunnen we meten hoeveel het model is verbeterd na het fijnstemmen.
print('Post-fine-tuning evaluation')
evaluate_model(test_dataset)
De output meldt een accuracy van 0.865 en een gewogen F1-score van 0.8661. In vergelijking met de baselineresultaten is dit een sterke verbetering na het fijnstemmen.
Post-fine-tuning evaluation
Accuracy: 0.865
F1: 0.8660926258753361We kunnen nu de prestaties van het model vóór en na het fijnstemmen vergelijken. Zowel accuracy als F1-score verbeteren aanzienlijk, wat laat zien dat QLoRA-fijnstemmen het model goed helpt aanpassen aan de nieuwsclassificatietaak.
|
Metriek |
Vóór training |
Na training |
|
Accuracy |
0.52 |
0.865 |
|
F1-score |
0.4589 |
0.866 |
Zoals we zien, verbetert het fijnstemmen van Qwen3.5 Small met QLoRA de classificatieprestaties aanzienlijk.
Zodra de evaluatie voltooid is, kunnen we de fijngetunede adapter en tokenizer uploaden naar Hugging Face. Dit maakt het makkelijker om het model te hergebruiken, te delen en te laden in toekomstige projecten zonder het volledige trainingsproces te herhalen.
model.push_to_hub("kingabzpro/qwen35-small-news-class")
tokenizer.push_to_hub("kingabzpro/qwen35-small-news-class")
Na het uploaden is het model beschikbaar op:
Model:
https://huggingface.co/kingabzpro/qwen35-small-news-class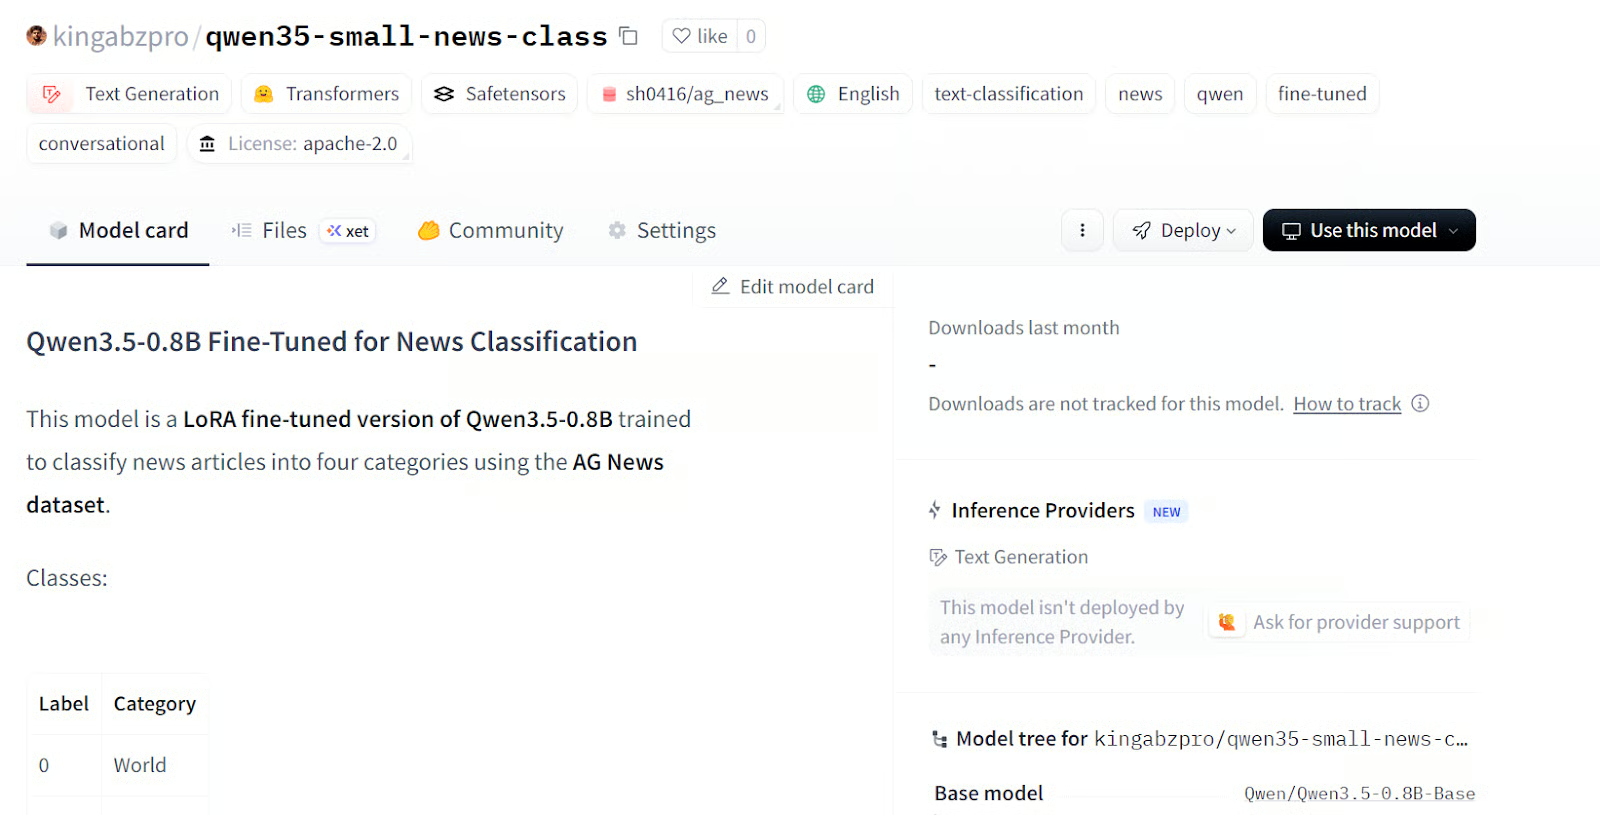
Bron: kingabzpro/qwen35-small-news-class
Het Kaggle-notebook bij deze tutorial is ook beschikbaar. Ik raad aan het alleen te gebruiken als je problemen tegenkomt bij het reproduceren van de stappen hierboven. Je kunt het notebook ook klonen en op je eigen systeem draaien, maar vergeet niet de Hugging Face-gebruikersnaam en het token aan te passen aan je eigen account.
In deze tutorial hebben we Qwen3.5-0.8B fijngetuned met QLoRA voor nieuwsclassificatie en een sterk resultaat behaald met een zeer lichte setup. Na slechts één epoch op een kleine subset aan data ging de accuracy van 0.52 naar 0.865, en de gewogen F1 ging van 0.4589 naar 0.8661.
Voor een model dat zó klein is, is dat eerlijk gezegd het meest verrassende: we hebben geen enorm model, enorme dataset of lange training nodig om sterke downstream-resultaten te krijgen.
Wat dit nog nuttiger maakt, is hoe praktisch de setup is. Qwen beschrijft het 0.8B-model als een goede match voor prototyping en taakgericht fijnstemmen, en QLoRA houdt het geheugenverbruik laag door adapters te trainen bovenop een bevroren 4-bit basismodel. Dat betekent dat dit niet alleen een cloud-notebookworkflow is. Het is ook realistisch om te testen op kleinere consumenten- en laptop-GPU's.
Nog een reden waarom ik dit model interessant vind, is dat de Qwen3.5-familie zowel tekst- als visiefijnstemmen ondersteunt. Dus hoewel we het hier voor tekstclassificatie hebben gebruikt, kan hetzelfde idee ook worden uitgebreid naar beeldclassificatie, image-to-text en text-to-text taken. Dat maakt zo'n klein model een heel praktische optie wanneer je snel ideeën wilt testen, goedkoop wilt fijnstemmen en de deployment licht wilt houden.
Ik raad je ook aan om onze andere resources te bekijken, waaronder onze gids voor Qwen3.5 en onze tutorial over hoe je Qwen3.5 lokaal draait op één GPU.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

