
Cursus
Werken met de OpenAI API
3 uur
179.5K
Het nieuwe GPT-afbeeldingsmodel is beschermd, wat betekent dat extra verificaties vereist zijn om het te kunnen gebruiken. In deze sectie leggen we uit hoe je de API instelt. Als je al een API-sleutel hebt, kun je de eerste stap overslaan.
De eerste stap is het genereren van een API-sleutel. We kunnen er een aanmaken door in te loggen op hun platform en naar de pagina met API-sleutels te gaan. Klik vervolgens op de knop "Create new secret key".
Zodra de sleutel is gegenereerd, maak je een bestand met de naam .env en kopieer je deze met het volgende formaat:
OPENAI_API_KEY=<paste_your_api_key_here>Een groot verschil met de andere OpenAI-modellen is dat je voor het gebruik van de GPT image API je organisatie moet verifiëren. De reden hiervoor is dat GPT-Image-1 realistische en gedetailleerde afbeeldingen kan genereren, wat zorgen oproept over mogelijk misbruik, zoals het maken van deepfakes of ongepaste content. Door organisaties te verifiëren kan OpenAI het gebruik beter monitoren en de veiligheidsrichtlijnen handhaven.
Je kunt je organisatie verifiëren, ook als je geen bedrijf hebt. Houd er echter rekening mee dat dit proces vereist dat je je overheids-ID opgeeft en een gezichtsverificatie voltooit.
Om de verificatie uit te voeren, ga je naar het tabblad Algemeen in het OpenAI API-platform en klik je op de knop onder de sectie "Verifications".
Het proces wordt uitgevoerd door een derde partij en bestaat uit:
Het proces duurt slechts een paar minuten om te voltooien en daarna ongeveer 15 minuten om te worden verwerkt.
Voor deze tutorial installeren we de volgende Python-pakketten:
openai: Het officiële OpenAI-pakket waarmee we met hun API kunnen communiceren.dotenv: Een Python-pakket dat het eenvoudig maakt om de API-sleutel veilig te laden uit het hierboven aangemaakte .env-bestand.We kunnen deze installeren met het commando:
pip install openai dotenvLaten we kijken hoe we een afbeelding kunnen genereren met gpt-image-1. Maak een nieuw Python-bestand, bijvoorbeeld generate_image.py, in dezelfde map als het .env-bestand.
Importeer vervolgens de benodigde pakketten:
# Import the packages
from openai import OpenAI
from dotenv import load_dotenv
import os
import base64
import time
Let op dat os en base64 ingebouwde Python-pakketten zijn en niet geïnstalleerd hoeven te worden.
Daarna laden we de API-sleutel en initialiseren we de OpenAI-client:
# Load the API key
load_dotenv()
api_key = os.getenv("OPENAI_API_KEY")
# Initialize the OpenAI client
client = OpenAI(api_key=api_key)
Vervolgens vragen we de gebruiker om een tekstprompt in te voeren met de ingebouwde functie input() en sturen we een aanvraag voor afbeeldingsgeneratie naar de API:
# Ask the user to input a prompt in the terminal
print("What do you want to generate?")
prompt = input("> ")
print("Generating image...")
# Send the prompt to the API
img = client.images.generate(
  model="gpt-image-1",
  prompt=prompt,
  background="auto",
  n=1,
  quality="high",
  size="1024x1024",
  output_format="png",
  moderation="auto",
)
Tot slot slaan we de gegenereerde afbeelding op in een bestand:
# Save the image into a file
image_bytes = base64.b64decode(img.data[0].b64_json)
with open(f"output_{int(time.time())}.png", "wb") as f:
  f.write(image_bytes)
Het volledige script is hier te vinden. Voer dit script uit met het commando:
python generate_image.pyHier is een voorbeeld met de output:
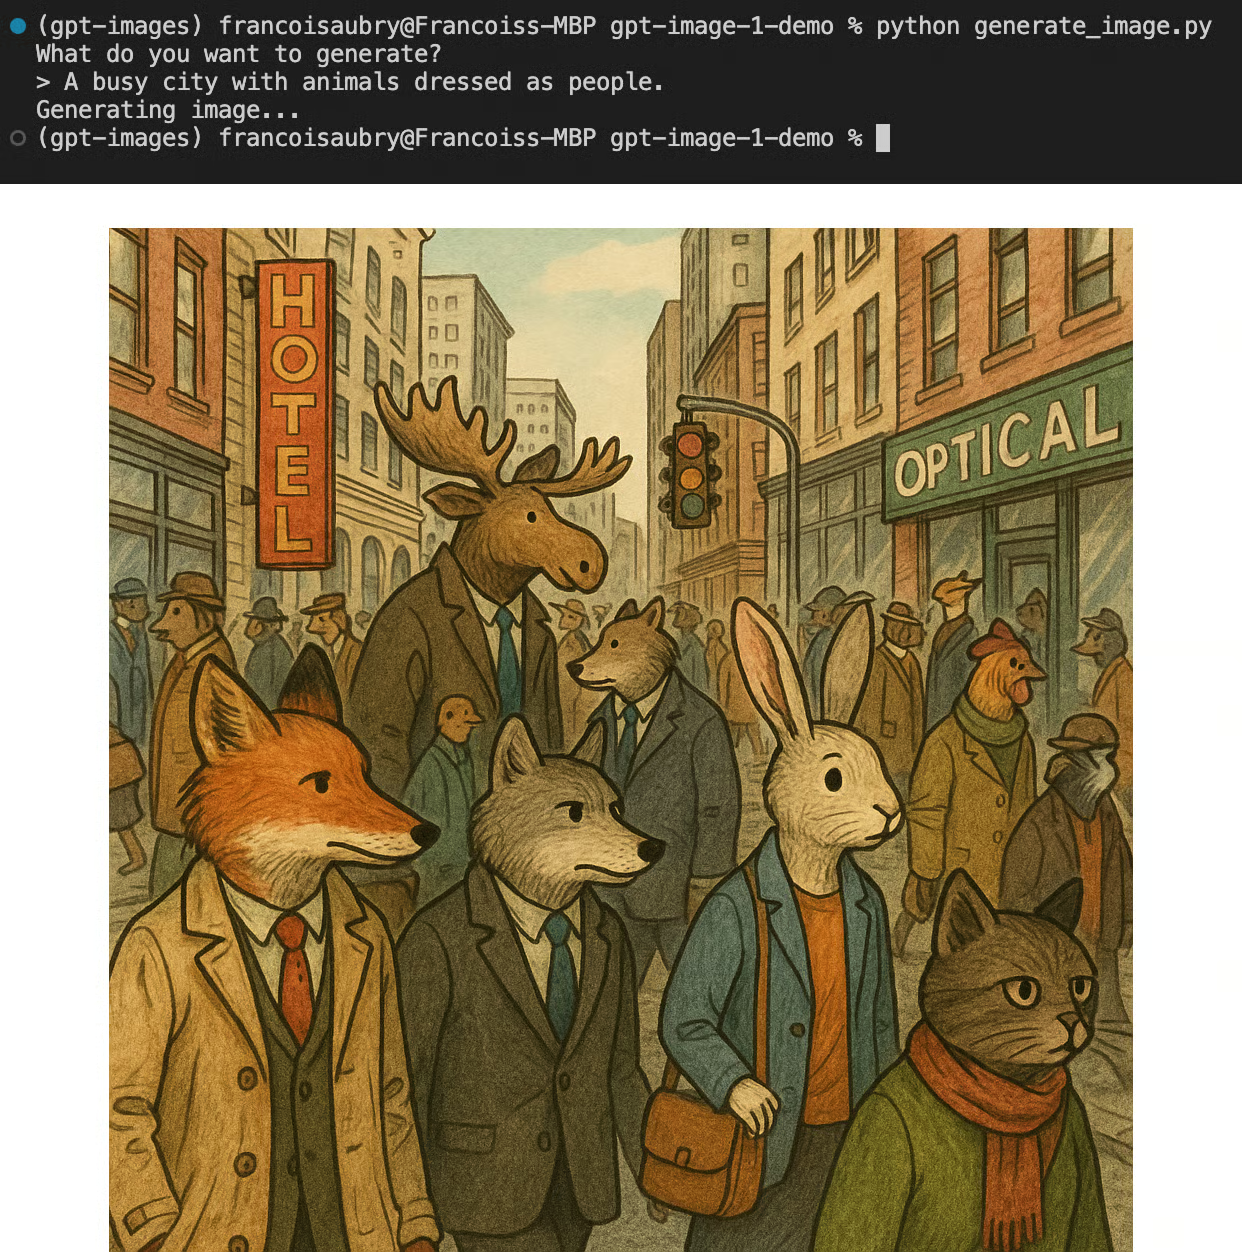
In deze sectie beschrijven we de meest relevante parameters van het gpt-image-1-model:
prompt: De tekstuele instructie die beschrijft welke afbeelding we door het model willen laten genereren.background: Het type achtergrond voor de afbeelding. Dit moet een van "transparent", "opaque" of "auto" zijn. De standaardwaarde is "auto", waarbij het model op basis van de inhoud bepaalt wat het beste achtergrondtype is. Let op: JPEG-afbeeldingen ondersteunen geen transparante achtergronden.n: Het aantal afbeeldingen dat gegenereerd moet worden. Moet een getal van 1 tot 10 zijn.quality: De kwaliteit van de gegenereerde afbeelding. Dit moet een van "high", "medium" of "low" zijn, waarbij de standaard "high" is.size: De grootte van de afbeelding in pixels. Dit moet een van "1024x1024" (vierkant), "1536x1024" (liggend), "1024x1536" (staand) zijn.output_format: Het afbeeldingsformaat. Dit moet een van "png", "jpeg" of "webp" zijn. Standaard is "png".moderation: Het niveau van contentmoderatie. Moet ofwel "low" zijn voor een minder restrictief filter of "auto", wat de standaard is.We hebben de belangrijkste parameters voor het gpt-image-1-model behandeld. Voor meer details en een volledige lijst met parameters, bekijk de officiële API-documentatie.
Hier is een vergelijking naast elkaar van afbeeldingen die met dezelfde prompt zijn gegenereerd, maar met verschillende kwaliteiten:
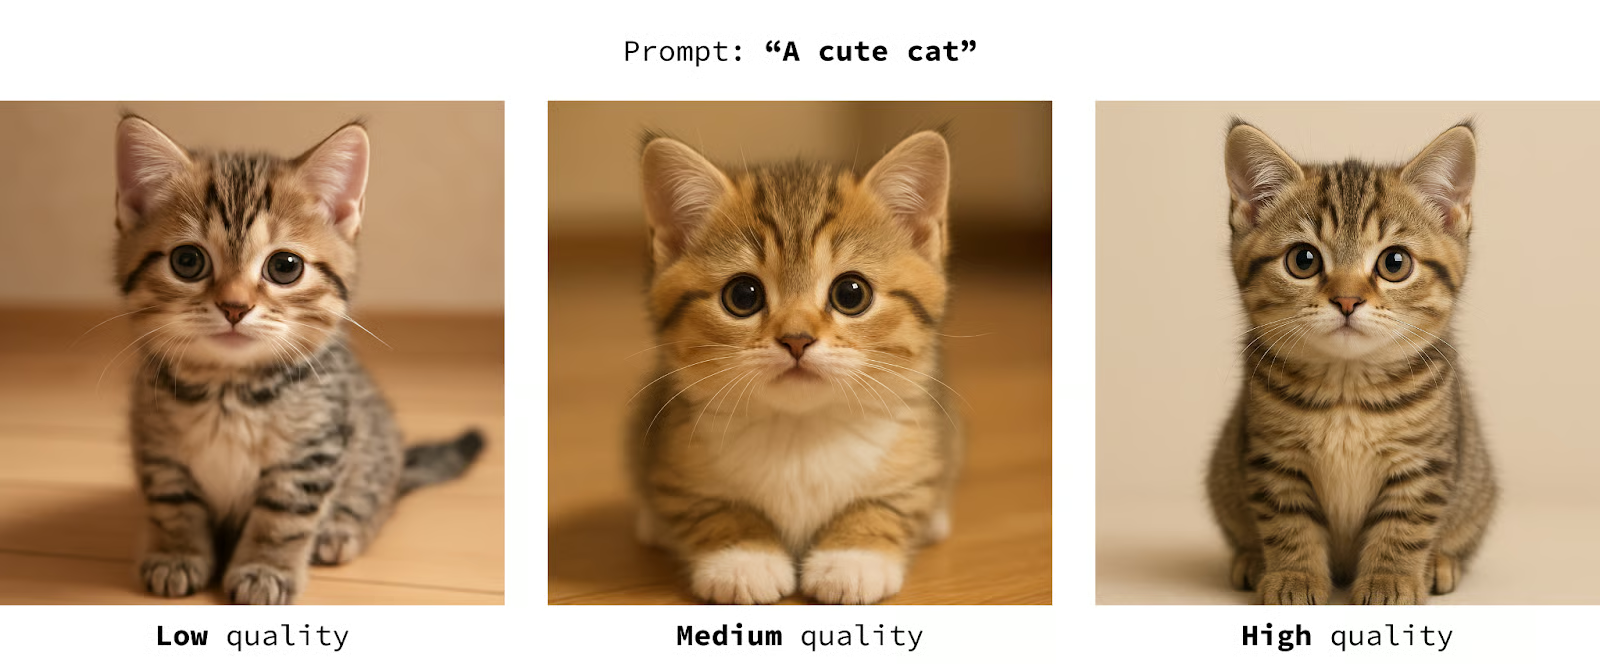
We zien dat de eerste kat (met de laagste kwaliteit) enkele artefacten rond de ogen heeft, en dat de afbeelding aanzienlijk realistischer wordt naarmate de kwaliteit toeneemt.
Hier is nog een voorbeeld met een cartoonachtige output:
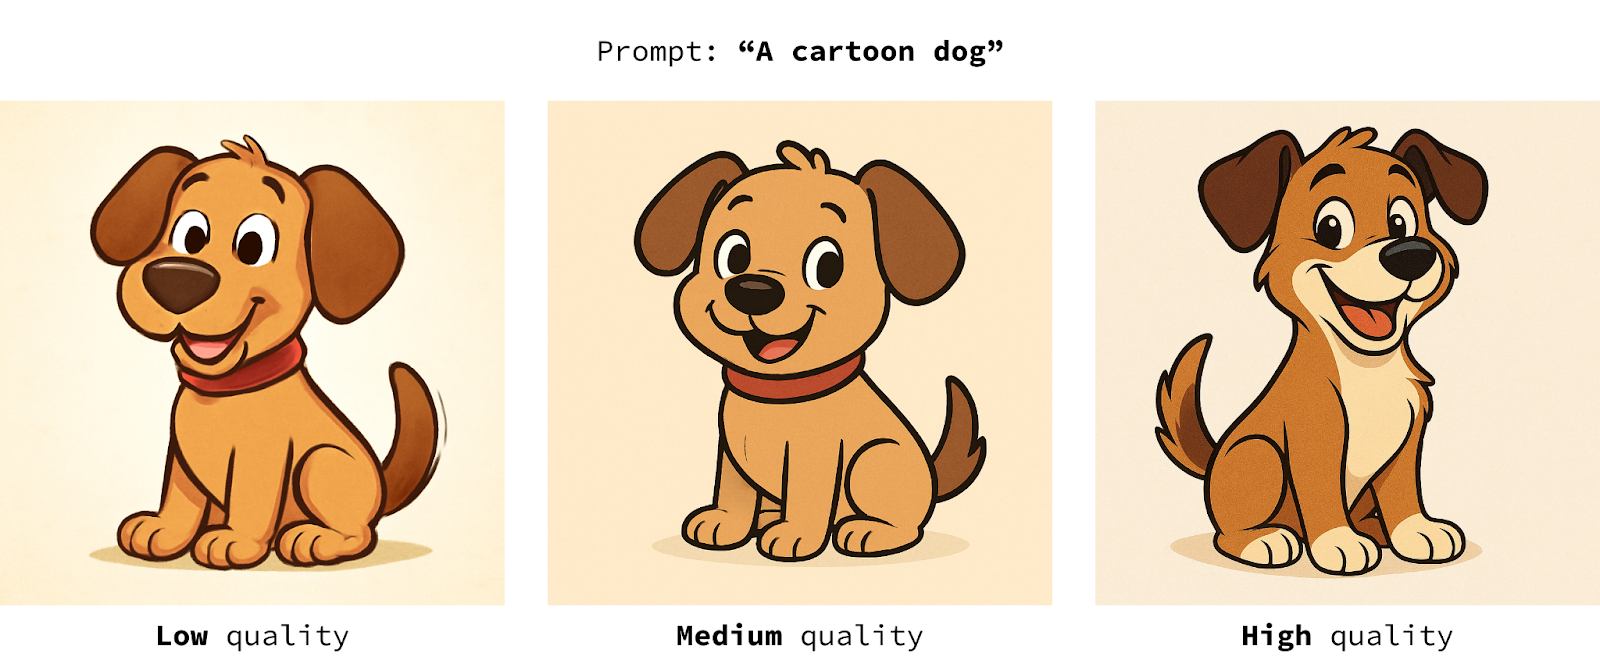
In dit geval merken we ook dat hoe hoger de kwaliteit, hoe verzorgder de afbeelding is. Naar mijn mening is dit echter minder relevant voor content die niet realistisch hoeft te zijn.
Onthoud dat hoe hoger de kwaliteit, hoe hoger de kosten en de rekentijd. Het is dus een goed idee om per usecase een goede balans te vinden. Ik raad aan om de parameters van laag naar hoog te proberen om te zien wat de minimale waarde is die acceptabele resultaten geeft voor elke usecase.
In mijn experimenten merkte ik dat het model deze parameter vaak negeerde. Hier zijn voorbeelden naast elkaar waarin ik de background-parameters en de transparantie-instructies in de prompt varieerde:
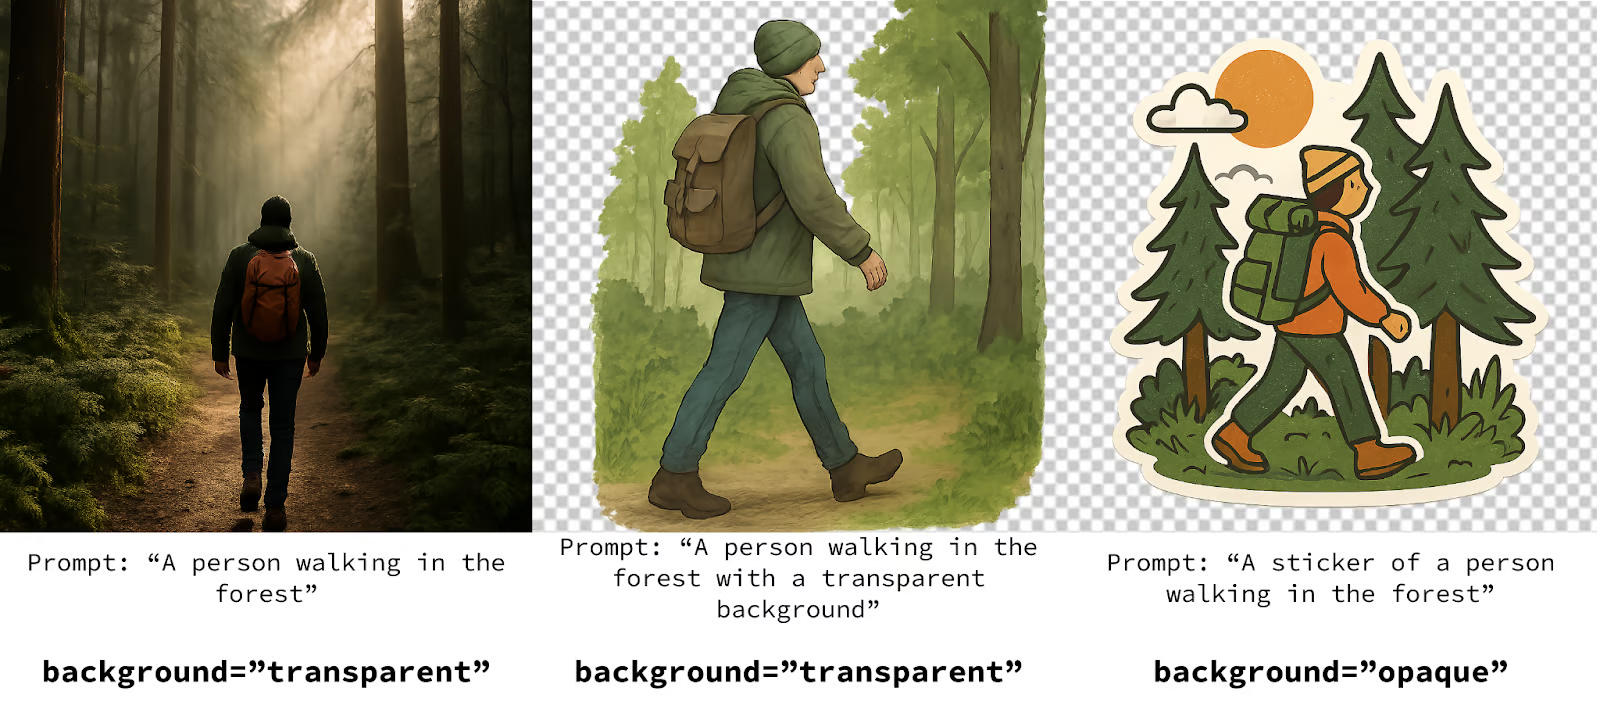
In het eerste voorbeeld werd de transparantieparameter genegeerd. In het tweede voegde ik de transparantie-instructies toe aan de prompt, en dat werkte iets beter. In het laatste vroeg ik om een ondoorzichtige achtergrond maar specificeerde ik in de prompt dat ik een sticker wilde, en kreeg ik een transparante achtergrond.
Ik raad nog steeds aan om de parameter te gebruiken zodat die overeenkomt met wat je wilt, maar zorg er ook voor dat je het gewenste resultaat in de prompt specificeert om het te versterken.
Zoals ik in de introductie al zei, is het meest spannende aan GPT-Image-1 het vermogen om afbeeldingen te bewerken. Laten we beginnen met hoe je het kunt vragen een afbeelding te bewerken en daarna een paar usecases verkennen.
Voor het bewerken kan het grootste deel van de code worden hergebruikt. Het enige dat verandert, is dat we in plaats van de functie client.images.generate() de functie client.images.edit() gebruiken.
Hier is een voorbeeld:
img = client.images.edit(
  model="gpt-image-1",
  image=[
    open("my-image.jpg", "rb"),
  ],
  prompt=prompt,
  n=1,
  quality="high",
  size="1024x1536",
)
De nieuwe parameter is image. Dit is een lijst met invoerafbeeldingen die in de bewerking worden gebruikt. In dit geval geven we slechts één afbeelding, my-image.jpg, die zich in dezelfde map bevindt als het script.
Hier is een voorbeeld van GPT Image 1 die een van mijn foto's bewerkt:
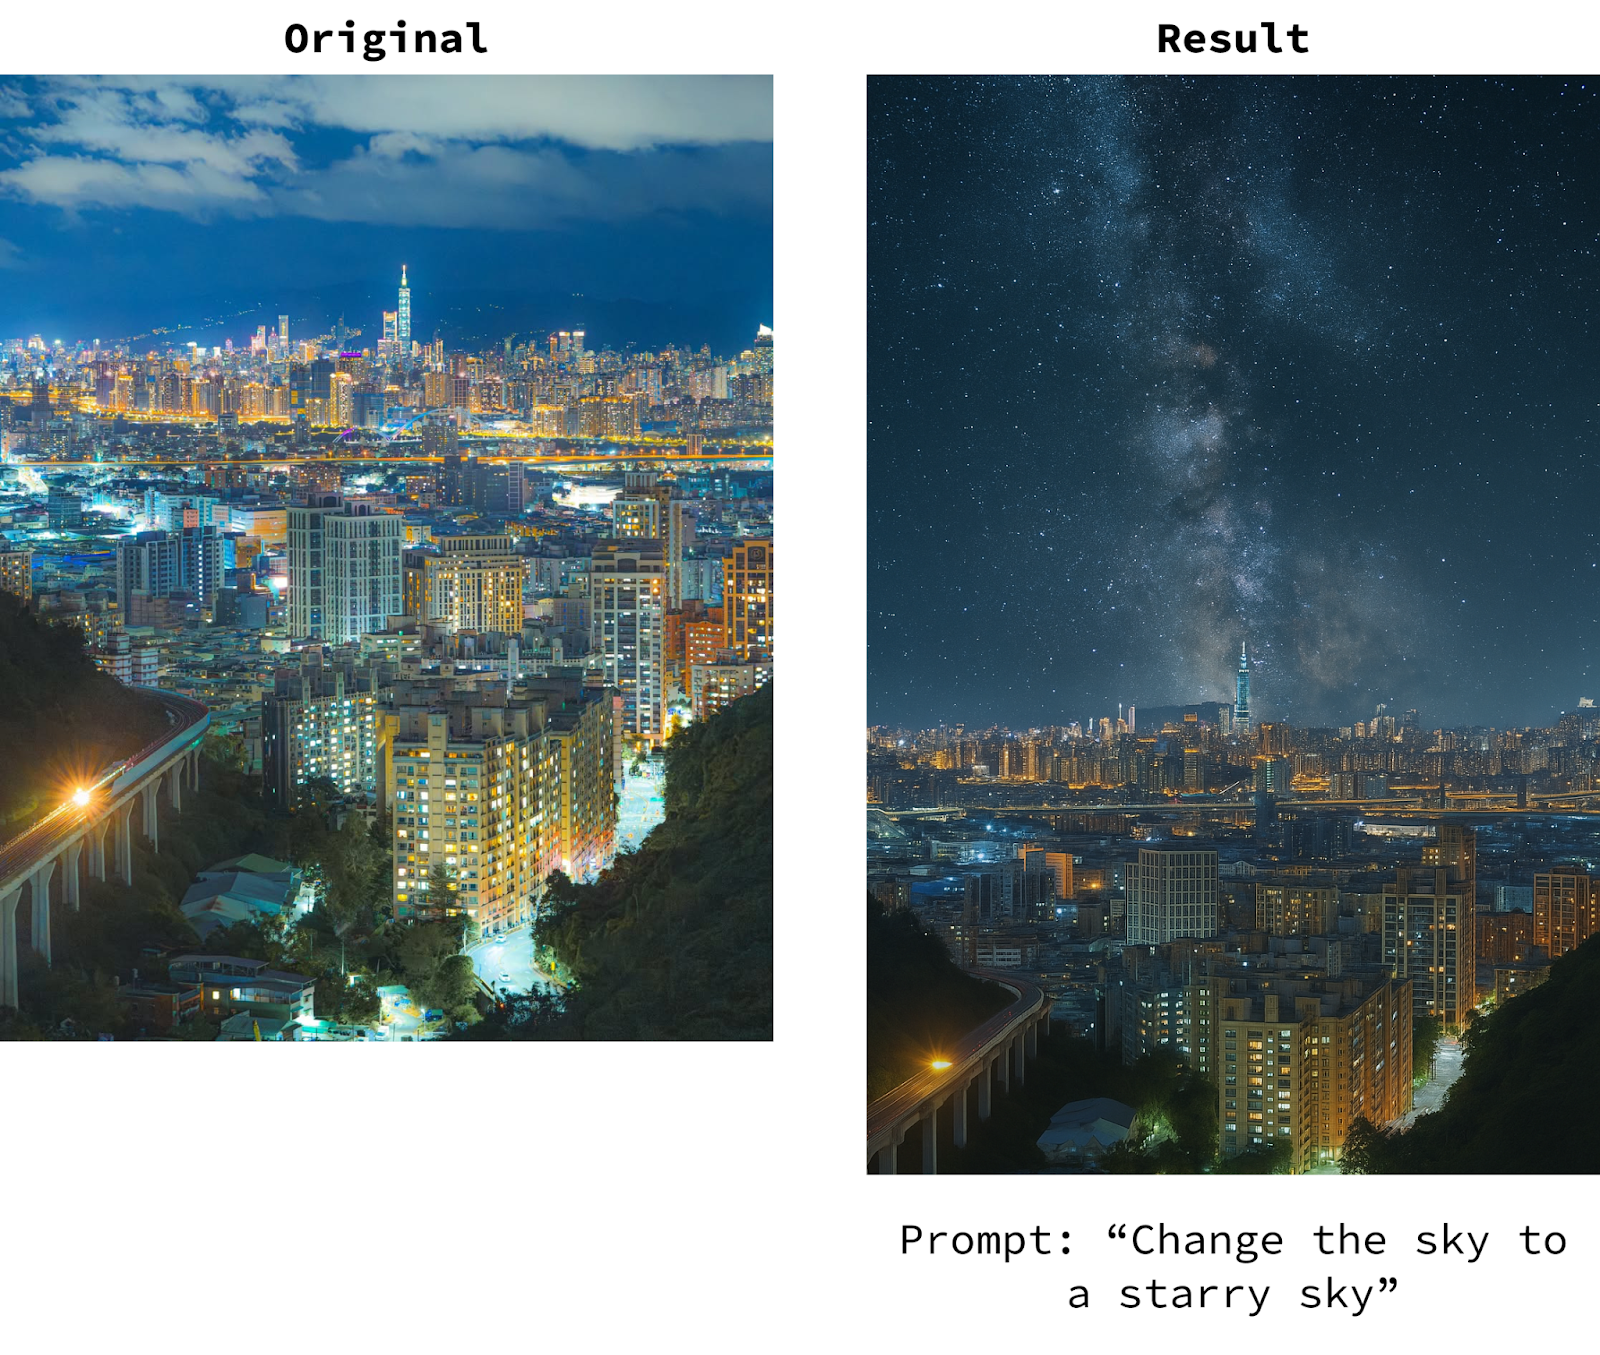
Omdat de originele afbeelding een staand formaat heeft, gebruikte ik het staande formaat 1024x1536. Dit is echter niet dezelfde verhouding als de oorspronkelijke afbeelding. Zelfs in bewerkingsmodus kan het model alleen afbeeldingen produceren in de drie hierboven gespecificeerde groottes.
Het volledige bewerkingsscript is hier te vinden.
De bewerkingsmodus biedt een mask-parameter die we kunnen gebruiken om aan te geven welke gebieden in de afbeelding bewerkt moeten worden. Het masker moet een PNG-afbeelding zijn van maximaal 4 MB en dezelfde afmetingen hebben als de afbeelding. Gebieden met 100% transparantie komen overeen met de gebieden die GPT Image 1 mag bewerken.
We geven het masker op dezelfde manier door als de afbeelding, behalve dat het in dit geval geen lijst is:
img = client.images.edit(
  model="gpt-image-1",
  image=[
    open(sys.argv[1], "rb"),
  ],
  # We provide the mask like this
  mask=open("mask.png", "rb"),
  prompt=prompt,
  n=1,
  quality="high",
  size="1536x1024",
)
Toen ik ermee experimenteerde, werkte het echter niet erg goed, en ik heb online vergelijkbare ervaringen gezien.
Hier is een voorbeeld:
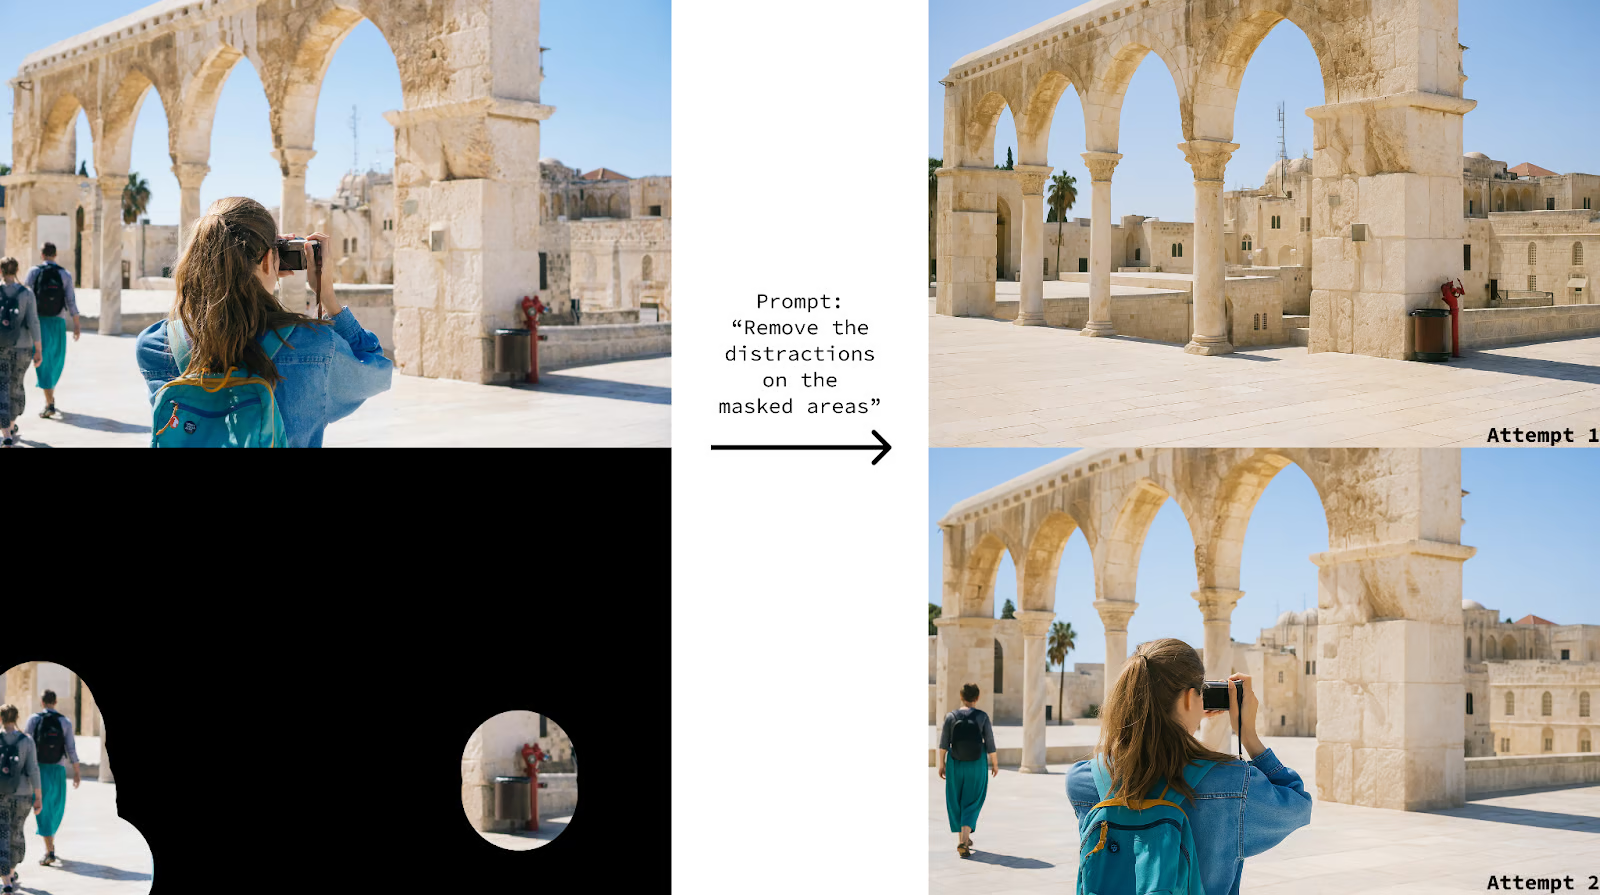
Ik heb ook geprobeerd om elementen op specifieke locaties toe te voegen, en dat werkte niet consistent. Net als bij het gebruik van de background-parameter voor afbeeldingsgeneratie, bleek het voor mij het beste te werken om in de prompt te beschrijven wat ik wil.
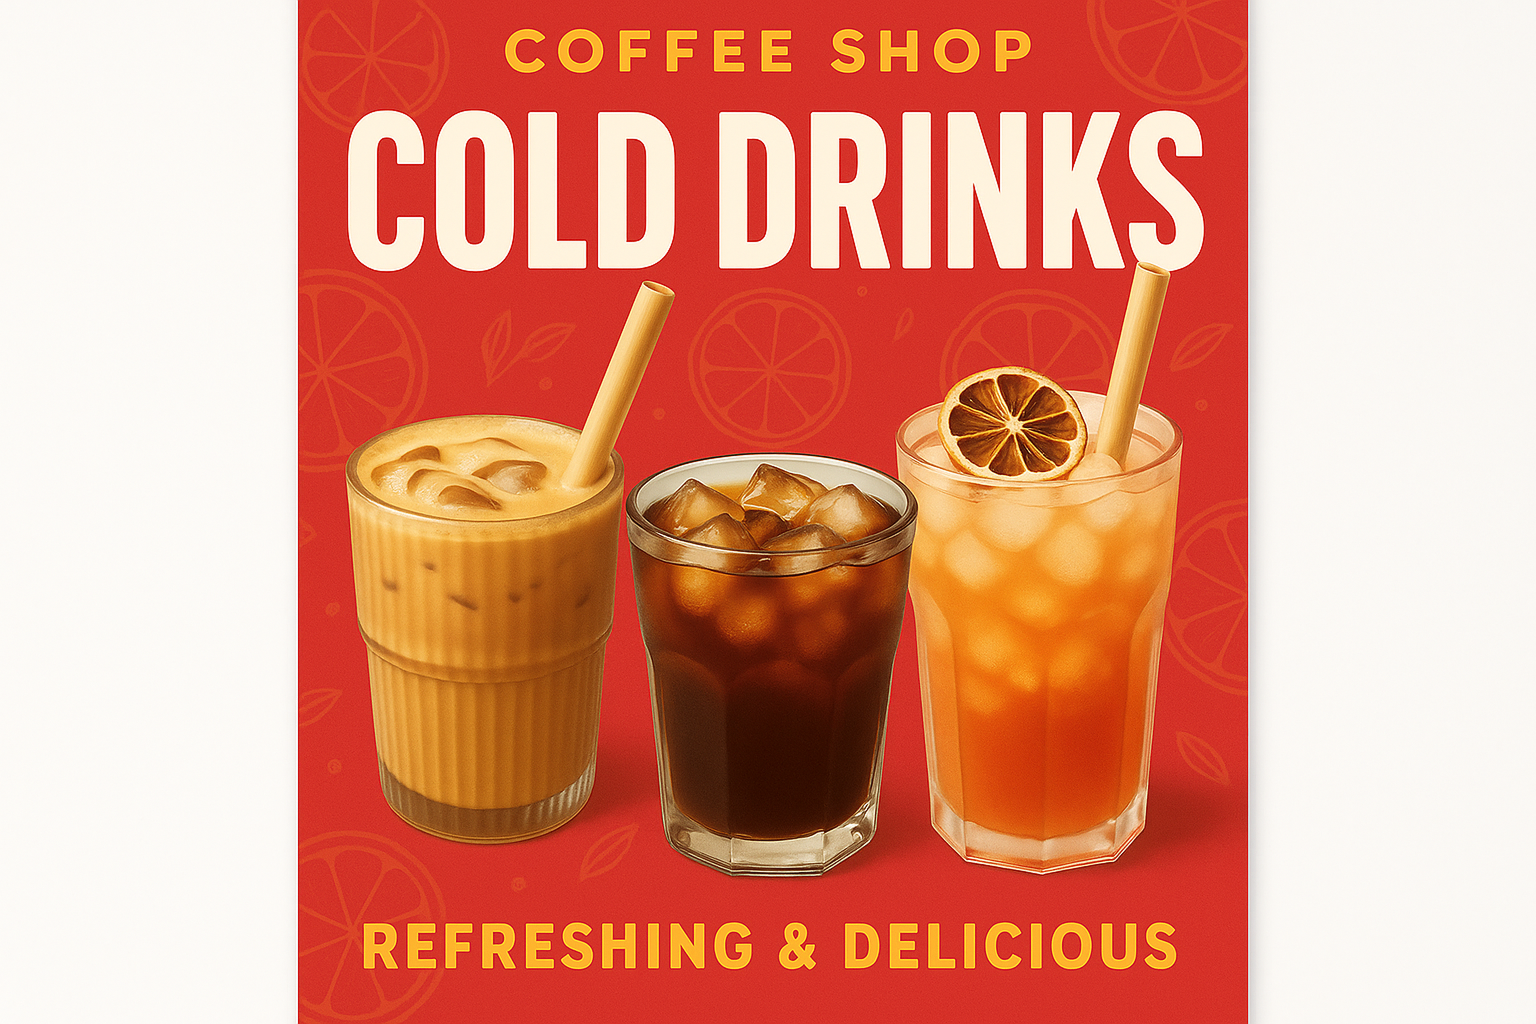
Het model kan meerdere afbeeldingen tegelijk verwerken en combineren. In het onderstaande voorbeeld gebruiken we het om een marketingposter te maken door de afbeeldingen van deze drie individuele drankjes te combineren:
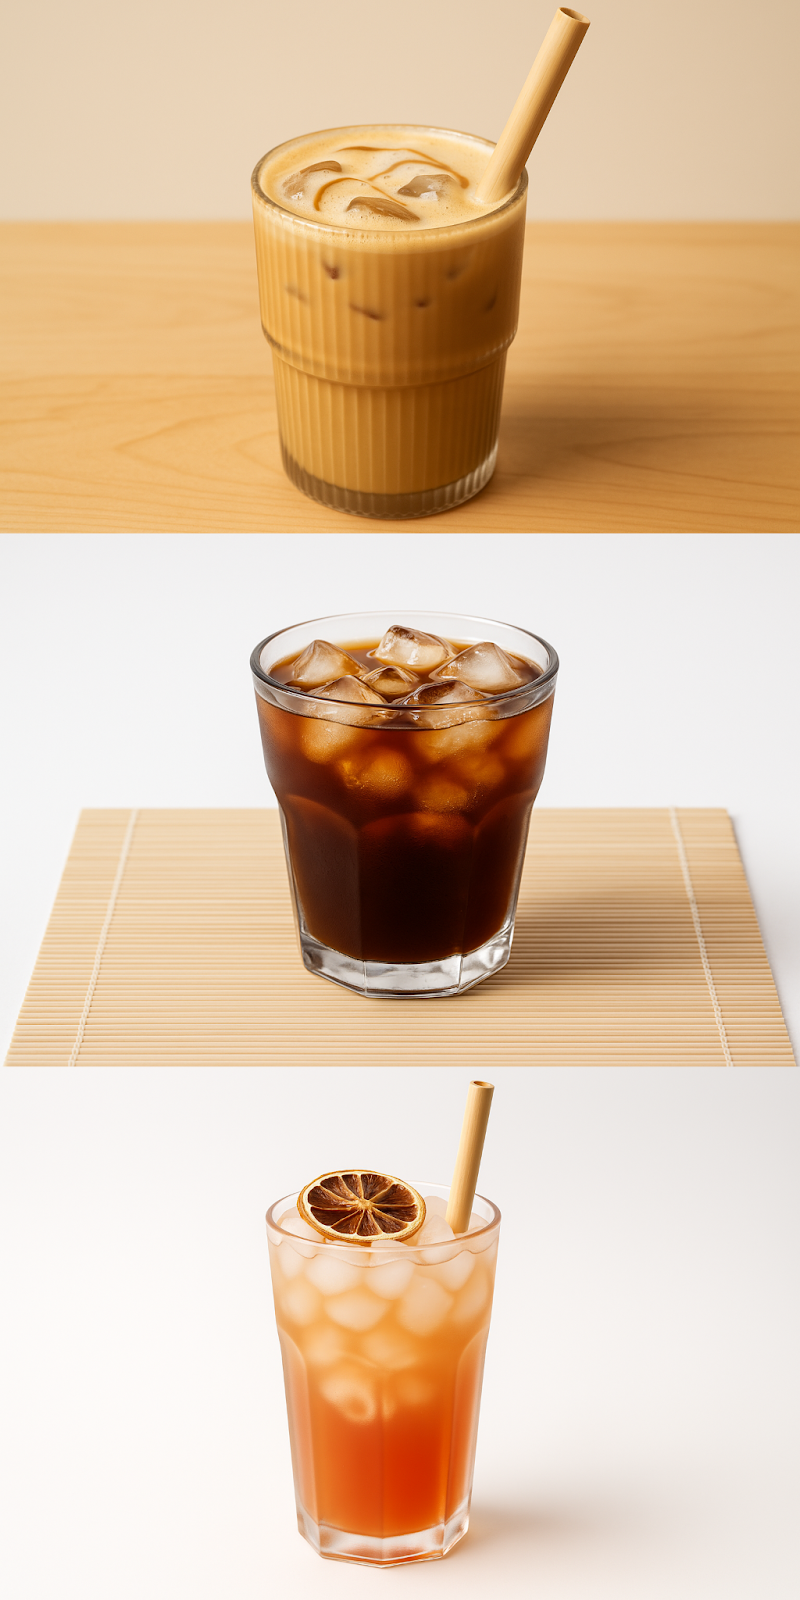
We geven de drie afbeeldingen door als een lijst in de image-parameter, als volgt:
prompt = """
Create a vibrant and eye-catching marketing poster to
promote the cold drinks offerings at our coffee shop.
"""

img = client.images.edit(
  model="gpt-image-1",
  # We can provide multiple images at once
  image=[
    open("latte.png", "rb"),
    open("americano.png", "rb"),
    open("icetea.png", "rb"),
  ],
  prompt=prompt,
  size="1536x1024",
)
Hier is het resultaat:
Afbeeldingen genereren wordt in rekening gebracht op basis van:
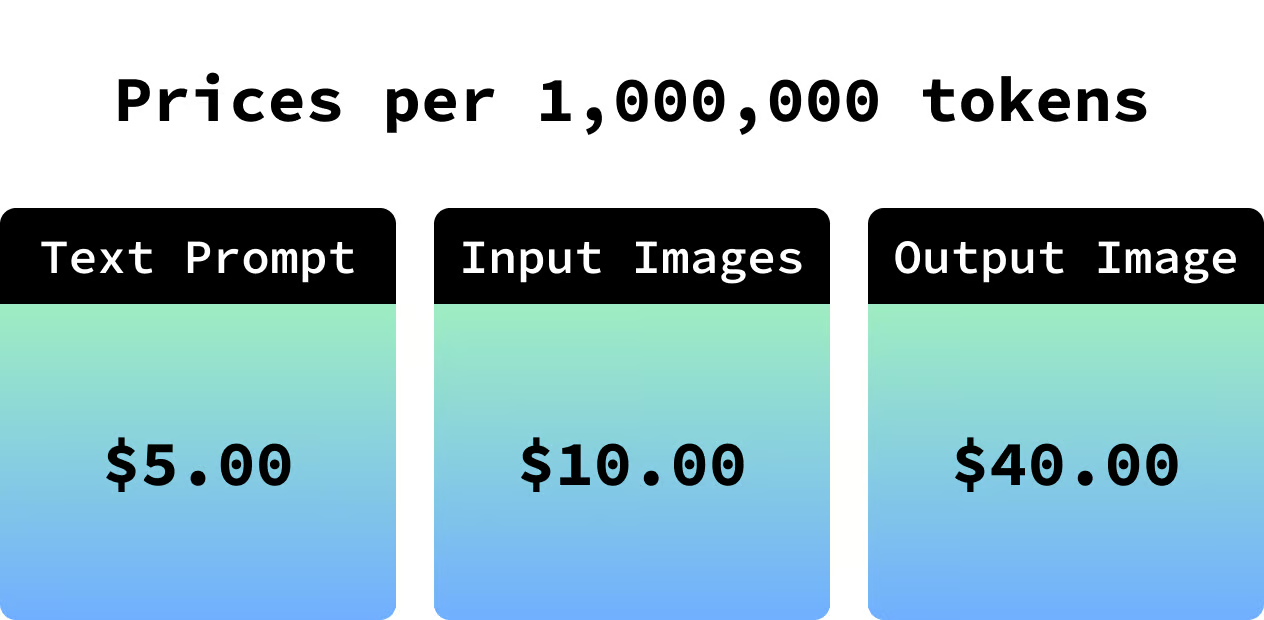
Soms is het lastig om in te schatten wat deze kosten voorstellen, omdat we niet weten uit hoeveel tokens een afbeelding bestaat.
Omdat de dimensies van de uitvoerafbeeldingen bekend zijn, weten we hoeveel tokens er voor elk nodig zijn. We kunnen dus exacte waarden geven voor de prijs van de tokens voor de uitvoerafbeelding (wat het duurste deel is):
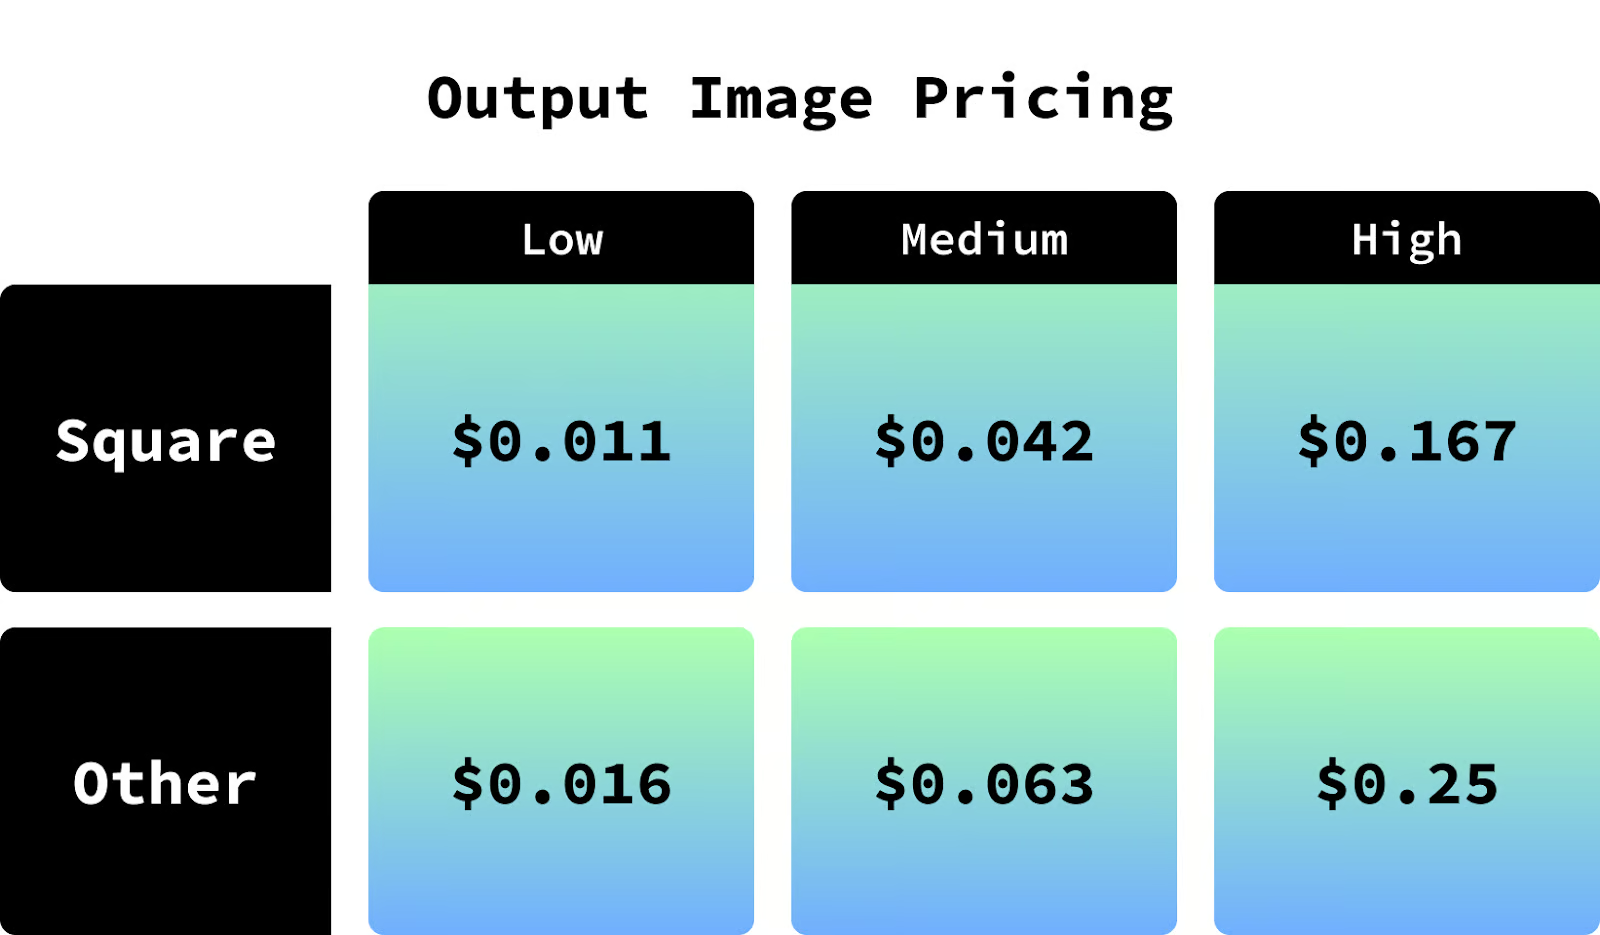
Deze prijs is afhankelijk van de kwaliteit en de grootte van de afbeelding. Voor meer details, bekijk de prijspagina van GPT Image 1.
Wanneer we een afbeelding genereren, retourneert de API het aantal gebruikte tokens. We kunnen dit combineren met de bovenstaande informatie om precies te weten hoeveel het kost.
We kunnen het aantal gebruikte tokens tonen door het veld usage van het resultaat af te drukken:
img = client.images.generate(
  model="gpt-image-1",
  prompt=prompt,
  background="transparent",
  n=1,
  quality="medium",
  size="1024x1024",
  moderation="auto",
  output_format="png",
)
# Add this to see the usage
print("Prompt tokens:", img.usage.input_tokens_details.text_tokens)
print("Input images tokens:", img.usage.input_tokens_details.image_tokens)
print("Output image tokens:", img.usage.output_tokens)
Output:
Prompt tokens: 8
Input images tokens: 0
Output image tokens: 272Ondanks een paar tekortkomingen van de API, zoals dat maskeren en transparantie niet betrouwbaar genoeg zijn, kan het model de instructies in de prompt met hoge precisie uitvoeren.
Ik denk dat dit model veel mogelijkheden biedt om erop voort te bouwen. In deze tutorial hebben we de basis geleerd van hoe je het gebruikt. Hier zijn een paar ideeën die je kunt verkennen om voort te bouwen op wat je hier hebt geleerd:
Leer AI met deze cursussen!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

