
Corso
Lavorare con l'API di OpenAI
3 ore
178.4K
Il nuovo modello di immagini GPT è protetto, il che significa che sono richieste verifiche aggiuntive per poterlo utilizzare. In questa sezione vediamo come configurare l’API. Se hai già una chiave API, puoi saltare il primo passaggio.
Il primo passo è generare una chiave API. Possiamo crearla accedendo alla loro piattaforma e andando alla pagina delle chiavi API. Poi, clicchiamo sul pulsante "Create new secret key".
Una volta generata la chiave, crea un file chiamato .env e incollala con il seguente formato:
OPENAI_API_KEY=<paste_your_api_key_here>Una grande differenza rispetto agli altri modelli OpenAI è che usare l’API di immagini GPT richiede la verifica dell’organizzazione. Il motivo è che GPT-Image-1 può generare immagini realistiche e dettagliate, il che solleva preoccupazioni su potenziali abusi, come la creazione di deepfake o contenuti inappropriati. Verificando le organizzazioni, OpenAI può monitorare meglio l’uso ed applicare le sue policy di sicurezza.
Puoi verificare la tua organizzazione anche se non hai un’azienda. Nota però che questo processo richiede di fornire un documento di identità e completare una verifica facciale.
Per eseguire la verifica, vai alla scheda generale nella piattaforma OpenAI API e clicca il pulsante sotto la sezione "Verifications".
Il processo è svolto da una terza parte e consiste in:
Il processo richiede solo un paio di minuti per essere completato e circa 15 minuti per l’elaborazione.
Per questo tutorial installeremo i seguenti pacchetti Python:
openai: Il pacchetto ufficiale OpenAI che ci permette di interagire con la loro API.dotenv: Un pacchetto Python che rende semplice caricare in sicurezza la chiave API dal file .env creato sopra.Possiamo installarli con il comando:
pip install openai dotenvVediamo come generare un’immagine con gpt-image-1. Crea un nuovo file Python, ad esempio generate_image.py, nella stessa cartella del file .env.
Poi importa i pacchetti necessari:
# Import the packages
from openai import OpenAI
from dotenv import load_dotenv
import os
import base64
import time
Nota che os e base64 sono pacchetti integrati in Python e non vanno installati.
Successivamente, carichiamo la chiave API e inizializziamo il client OpenAI:
# Load the API key
load_dotenv()
api_key = os.getenv("OPENAI_API_KEY")
# Initialize the OpenAI client
client = OpenAI(api_key=api_key)
Poi chiediamo all’utente di inserire un prompt testuale usando la funzione built-in input() e inviamo una richiesta di generazione immagine all’API:
# Ask the user to input a prompt in the terminal
print("What do you want to generate?")
prompt = input("> ")
print("Generating image...")
# Send the prompt to the API
img = client.images.generate(
  model="gpt-image-1",
  prompt=prompt,
  background="auto",
  n=1,
  quality="high",
  size="1024x1024",
  output_format="png",
  moderation="auto",
)
Infine, salviamo l’immagine generata in un file:
# Save the image into a file
image_bytes = base64.b64decode(img.data[0].b64_json)
with open(f"output_{int(time.time())}.png", "wb") as f:
  f.write(image_bytes)
Lo script completo è disponibile qui. Per eseguirlo, usa il comando:
python generate_image.pyEcco un esempio con l’output:
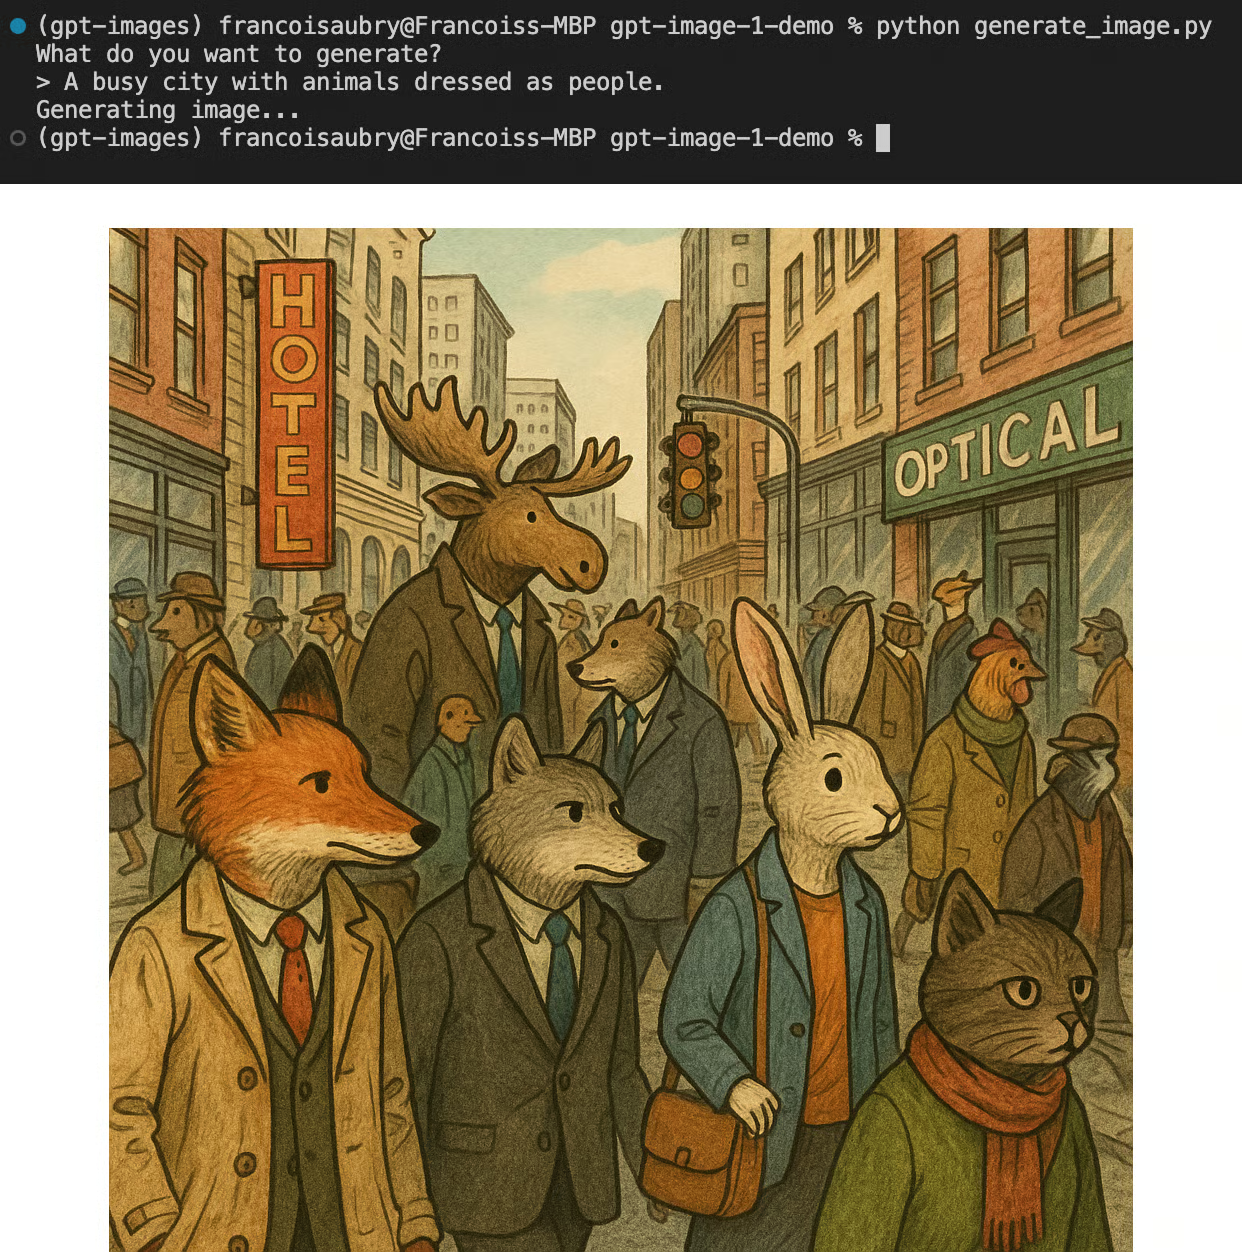
In questa sezione descriviamo i parametri più rilevanti del modello gpt-image-1:
prompt: L’istruzione testuale che descrive l’immagine che vogliamo generare.background: Il tipo di sfondo per l’immagine. Deve essere uno tra "transparent", "opaque" o "auto". Il valore predefinito è "auto", in cui il modello decide in base al contenuto qual è il miglior tipo di sfondo. Nota che le immagini JPEG non supportano lo sfondo trasparente.n: Il numero di immagini da generare. Deve essere un numero da 1 a 10.quality: La qualità dell’immagine generata. Deve essere una tra "high", "medium" o "low", con predefinita "high".size: La dimensione dell’immagine in pixel. Deve essere una tra "1024x1024" (quadrata), "1536x1024" (orizzontale), "1024x1536" (verticale).output_format: Il formato dell’immagine. Deve essere uno tra "png", "jpeg" o "webp". Il predefinito è "png".moderation: Il livello di moderazione dei contenuti. Deve essere "low" per un filtro meno restrittivo oppure "auto", che è il valore predefinito.Abbiamo coperto i parametri più importanti disponibili per il modello gpt-image-1. Per maggiori dettagli e l’elenco completo dei parametri, consulta la documentazione API ufficiale.
Ecco un confronto affiancato di immagini generate con lo stesso prompt ma qualità diverse:
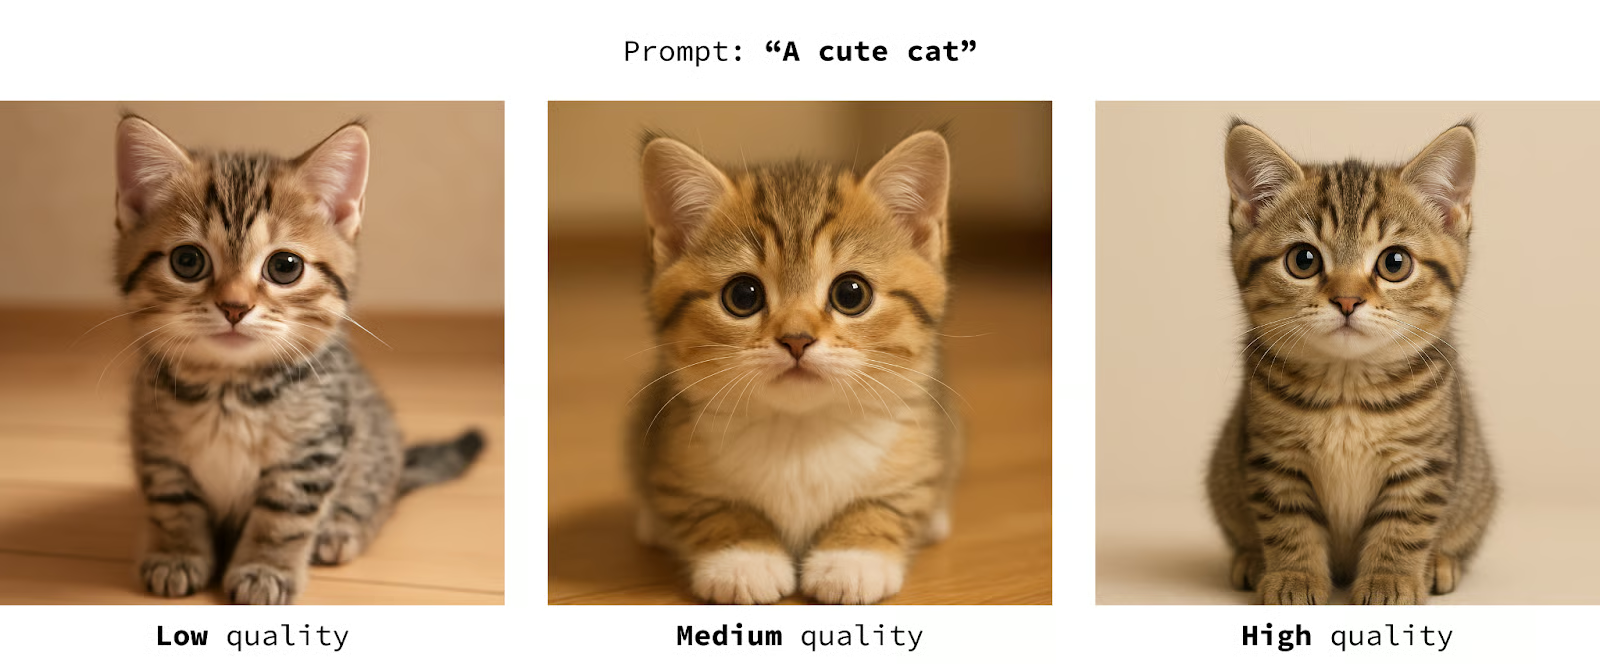
Vediamo che il primo gatto (con qualità più bassa) ha alcuni artefatti attorno agli occhi e che l’immagine diventa sensibilmente più realistica all’aumentare della qualità.
Ecco un altro esempio con un output in stile cartone animato:
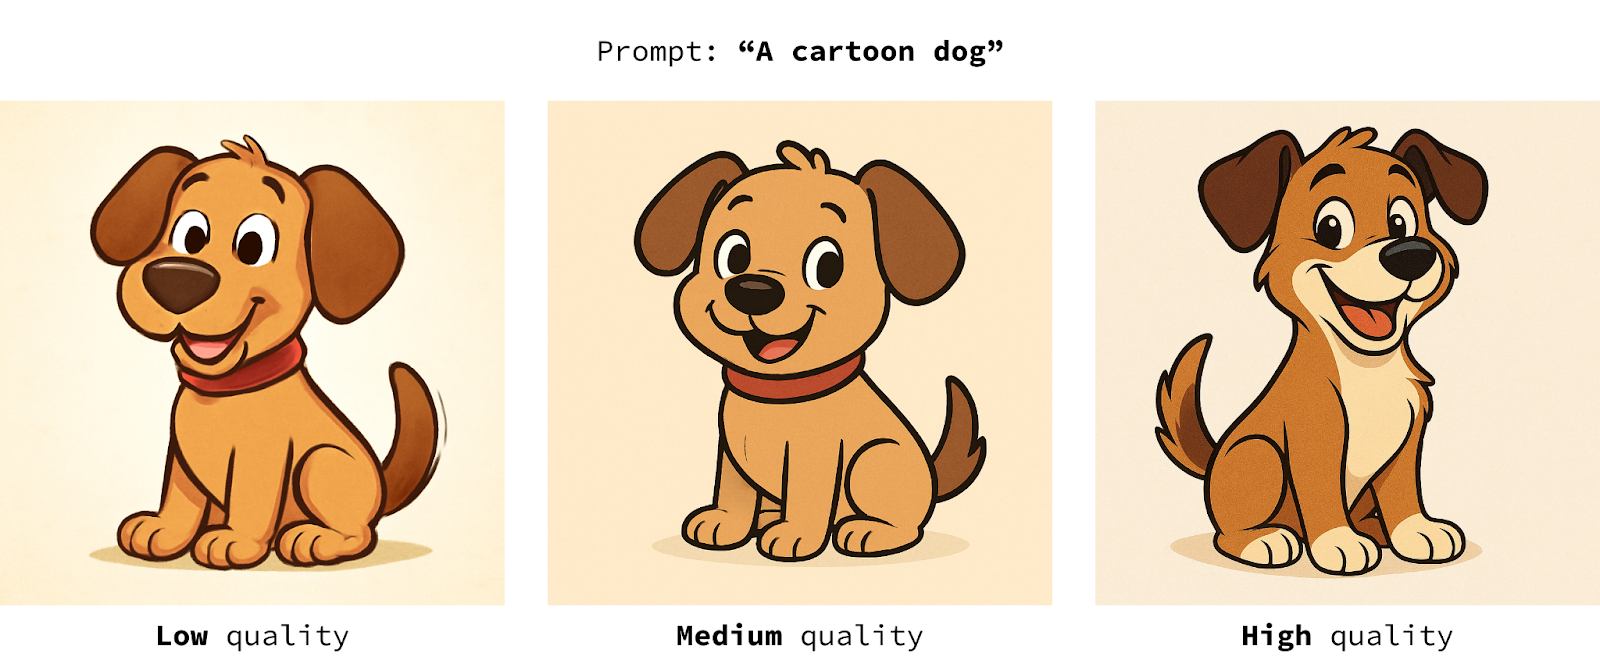
Anche in questo caso notiamo che più alta è la qualità, più rifinita è l’immagine. A mio avviso, però, questo è meno rilevante per contenuti che non devono essere realistici.
Ricorda che maggiore qualità significa costi e tempi di calcolo più alti, quindi conviene trovare un buon compromesso in base al caso d’uso. Ti consiglio di provare i parametri dal basso verso l’alto per individuare il valore minimo che dà risultati accettabili per ciascun caso.
Nei miei esperimenti ho notato che il modello per lo più ignorava questo parametro. Ecco esempi affiancati in cui ho variato sia il parametro background sia le istruzioni sulla trasparenza nel prompt:
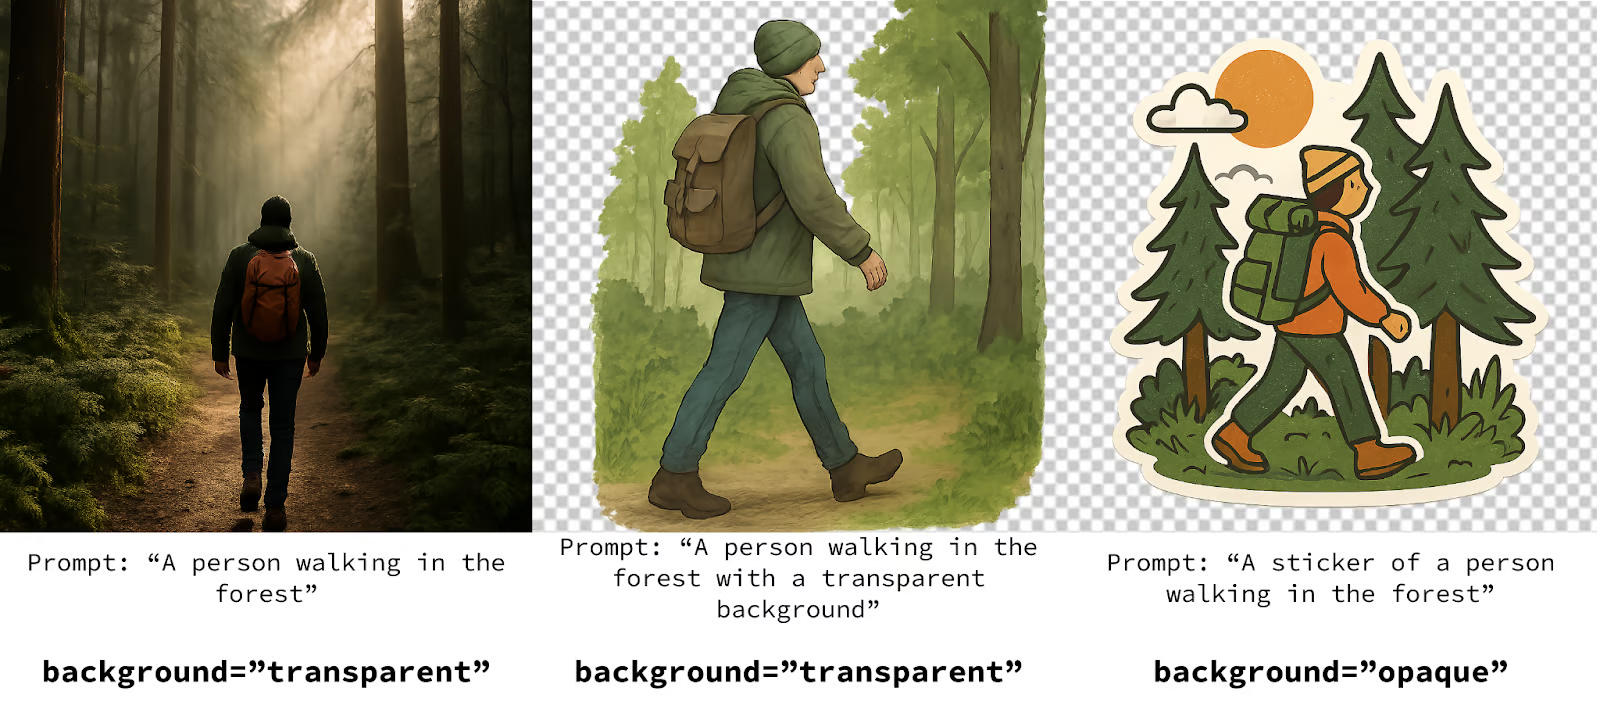
Nel primo esempio, il parametro di trasparenza è stato ignorato. Nel secondo, ho aggiunto le istruzioni di trasparenza nel prompt ed è andata un po’ meglio. Nell’ultimo, ho chiesto uno sfondo opaco ma ho specificato nel prompt che volevo uno sticker e ho ottenuto uno sfondo trasparente.
Consiglio comunque di usare il parametro per farlo corrispondere a ciò che vuoi, ma assicurati anche di specificare il risultato desiderato nel prompt per rafforzarlo.
Come accennato nell’introduzione, l’aspetto più entusiasmante di GPT-Image-1 è la sua capacità di modificare le immagini. Iniziamo imparando come chiedergli di modificare un’immagine e poi esploriamo alcuni casi d’uso.
Per modificare le immagini, gran parte del codice può essere riutilizzata. L’unica parte che cambia è che, invece di usare la funzione client.images.generate(), usiamo la funzione client.images.edit().
Ecco un esempio:
img = client.images.edit(
  model="gpt-image-1",
  image=[
    open("my-image.jpg", "rb"),
  ],
  prompt=prompt,
  n=1,
  quality="high",
  size="1024x1536",
)
Il nuovo parametro è image. È un elenco di immagini di input da usare nella modifica. In questo caso forniamo una sola immagine chiamata my-image.jpg nella stessa cartella dello script.
Ecco un esempio di utilizzo di GPT-Image-1 per modificare una mia foto:
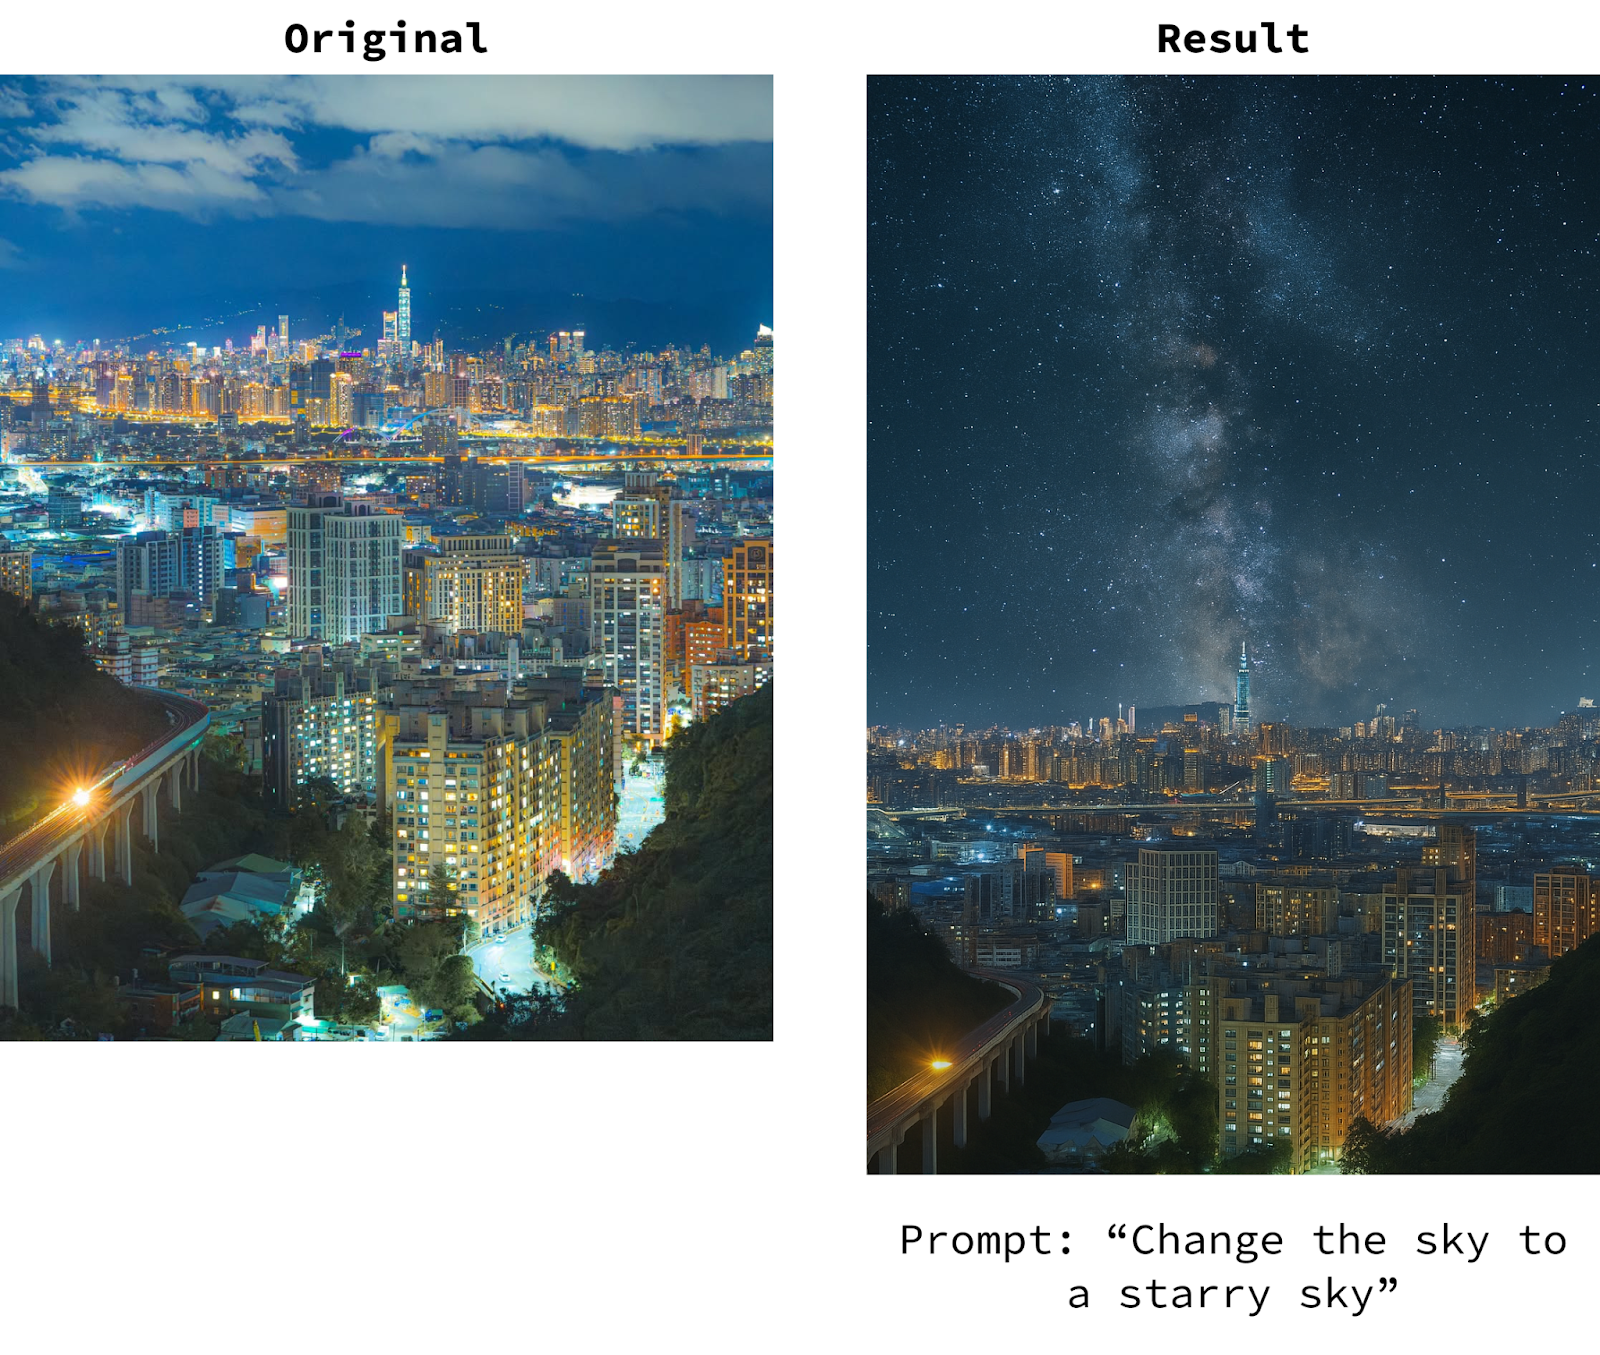
Nota che, poiché l’immagine originale ha un formato verticale, ho usato la dimensione verticale 1024x1536. Tuttavia, questo non è lo stesso rapporto dell’immagine originale. Anche in modalità modifica, il modello può produrre immagini solo nelle tre dimensioni specificate sopra.
Lo script completo per la modifica è disponibile qui.
La modalità di modifica offre un parametro mask che possiamo usare per specificare le aree in cui l’immagine deve essere modificata. La maschera deve essere un’immagine PNG di massimo 4 MB e avere la stessa dimensione dell’immagine. Le aree con trasparenza al 100% corrispondono alle zone che GPT-Image-1 è autorizzato a modificare.
Forniamo la maschera nello stesso modo dell’immagine, tranne che in questo caso non è un elenco:
img = client.images.edit(
  model="gpt-image-1",
  image=[
    open(sys.argv[1], "rb"),
  ],
  # We provide the mask like this
  mask=open("mask.png", "rb"),
  prompt=prompt,
  n=1,
  quality="high",
  size="1536x1024",
)
Tuttavia, quando l’ho provato, non ha funzionato molto bene, e ho visto online segnalazioni di persone con problemi simili.
Ecco un esempio:
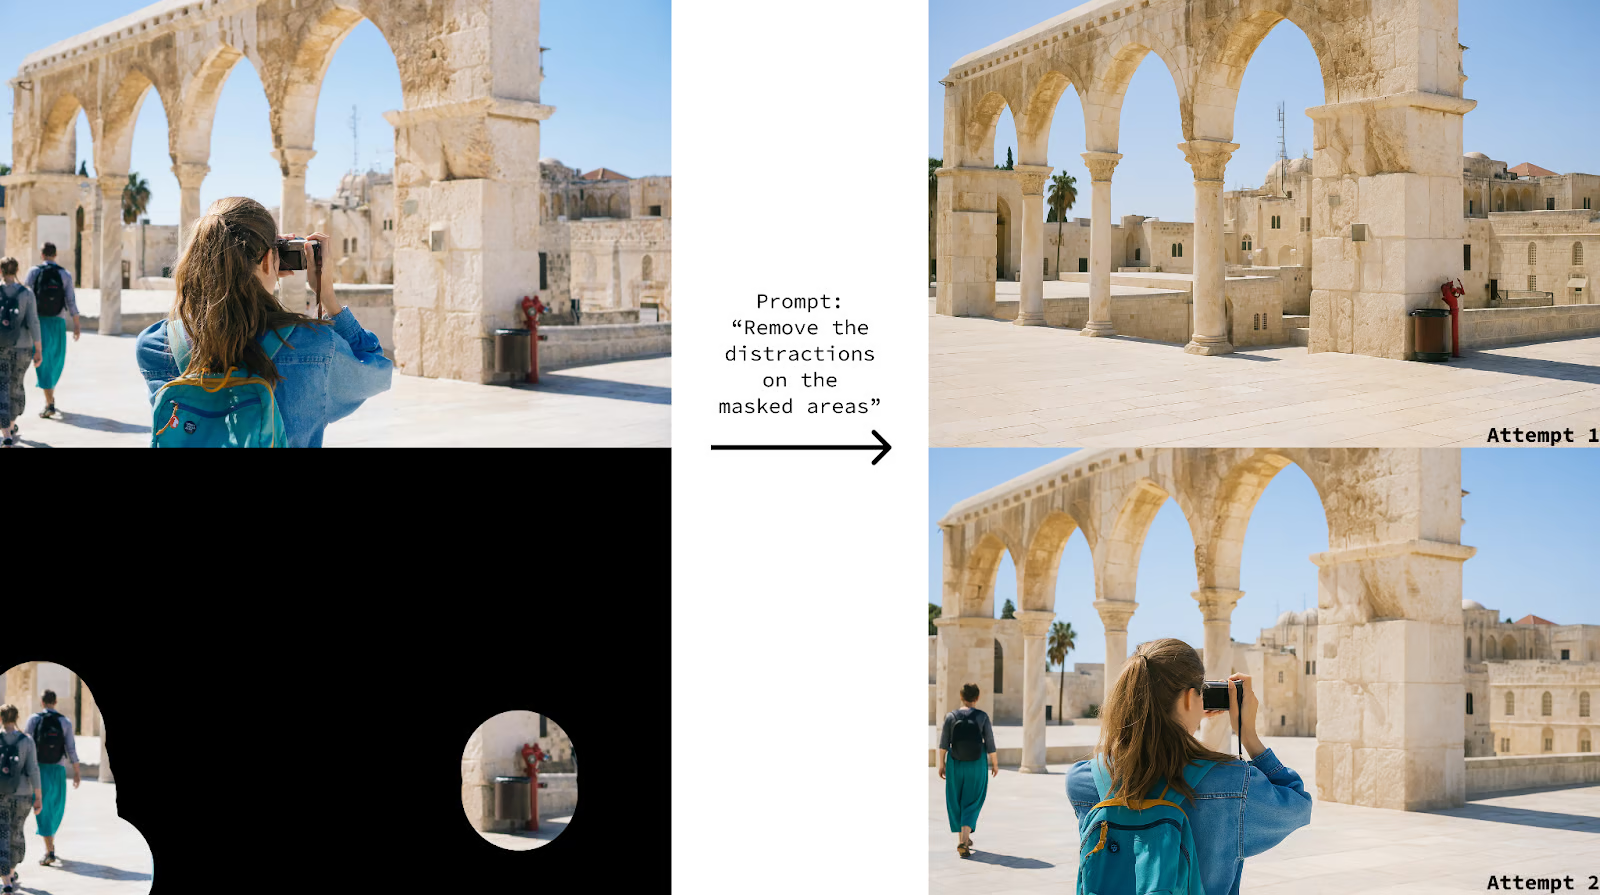
Ho anche provato a usarla per aggiungere elementi in posizioni specifiche e non ha funzionato in modo coerente. Proprio come per il parametro background nella generazione di immagini, ho riscontrato che descrivere ciò che voglio nel prompt funziona meglio.
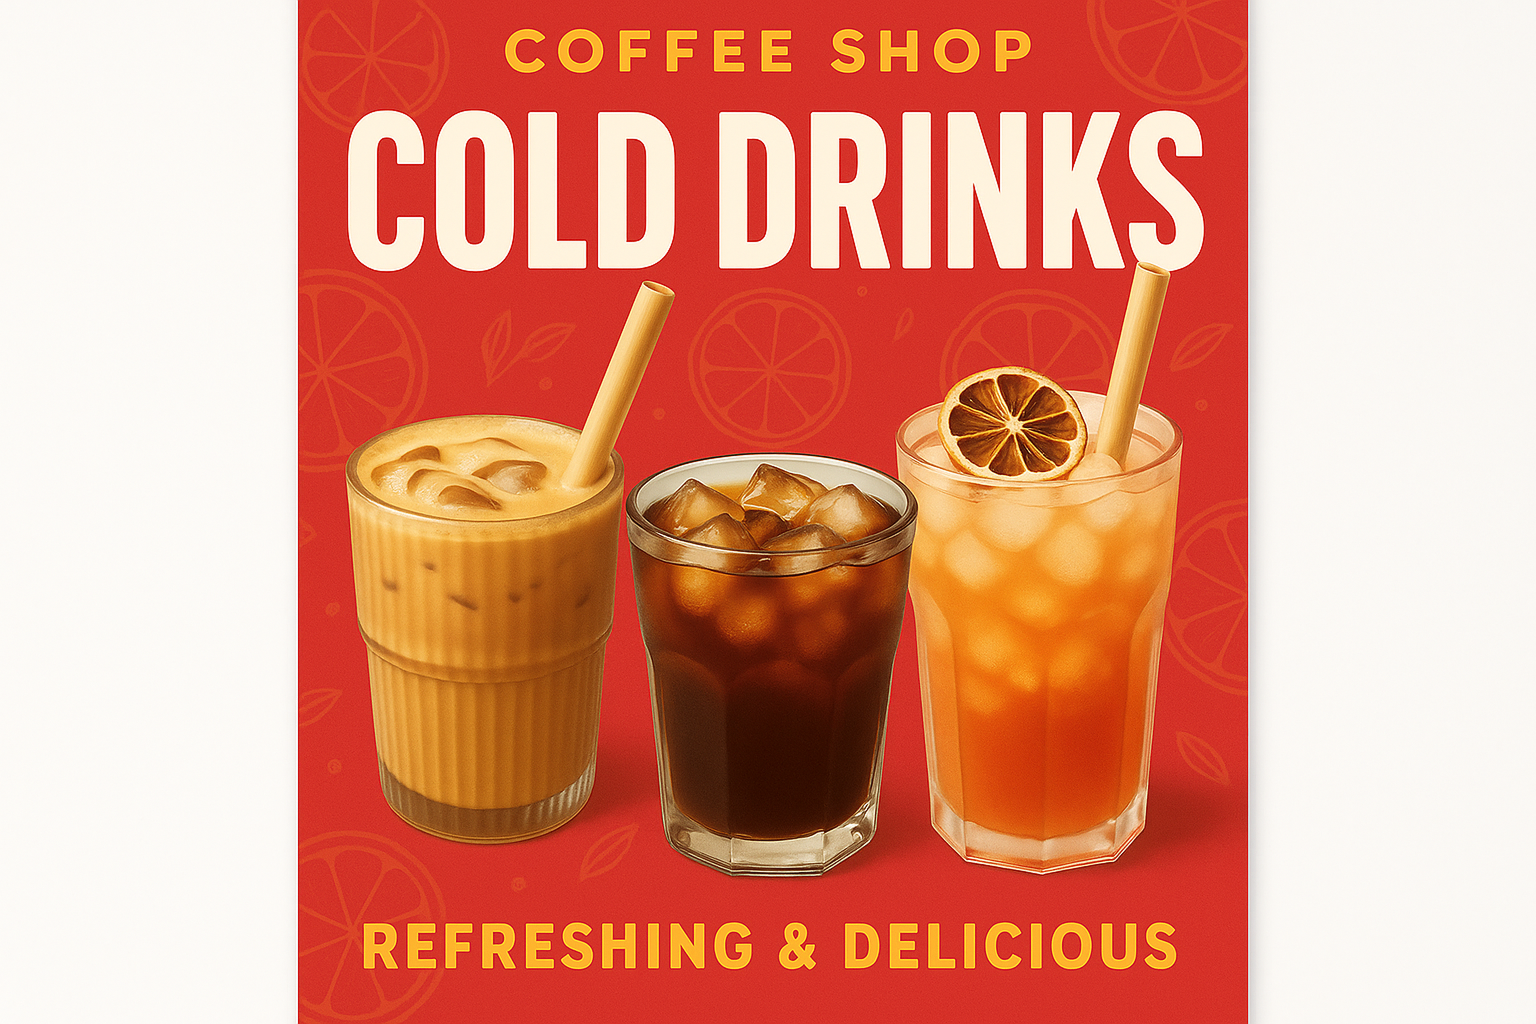
Il modello può elaborare e combinare più immagini alla volta. Nell’esempio seguente lo usiamo per creare un poster pubblicitario combinando le immagini di tre bevande:
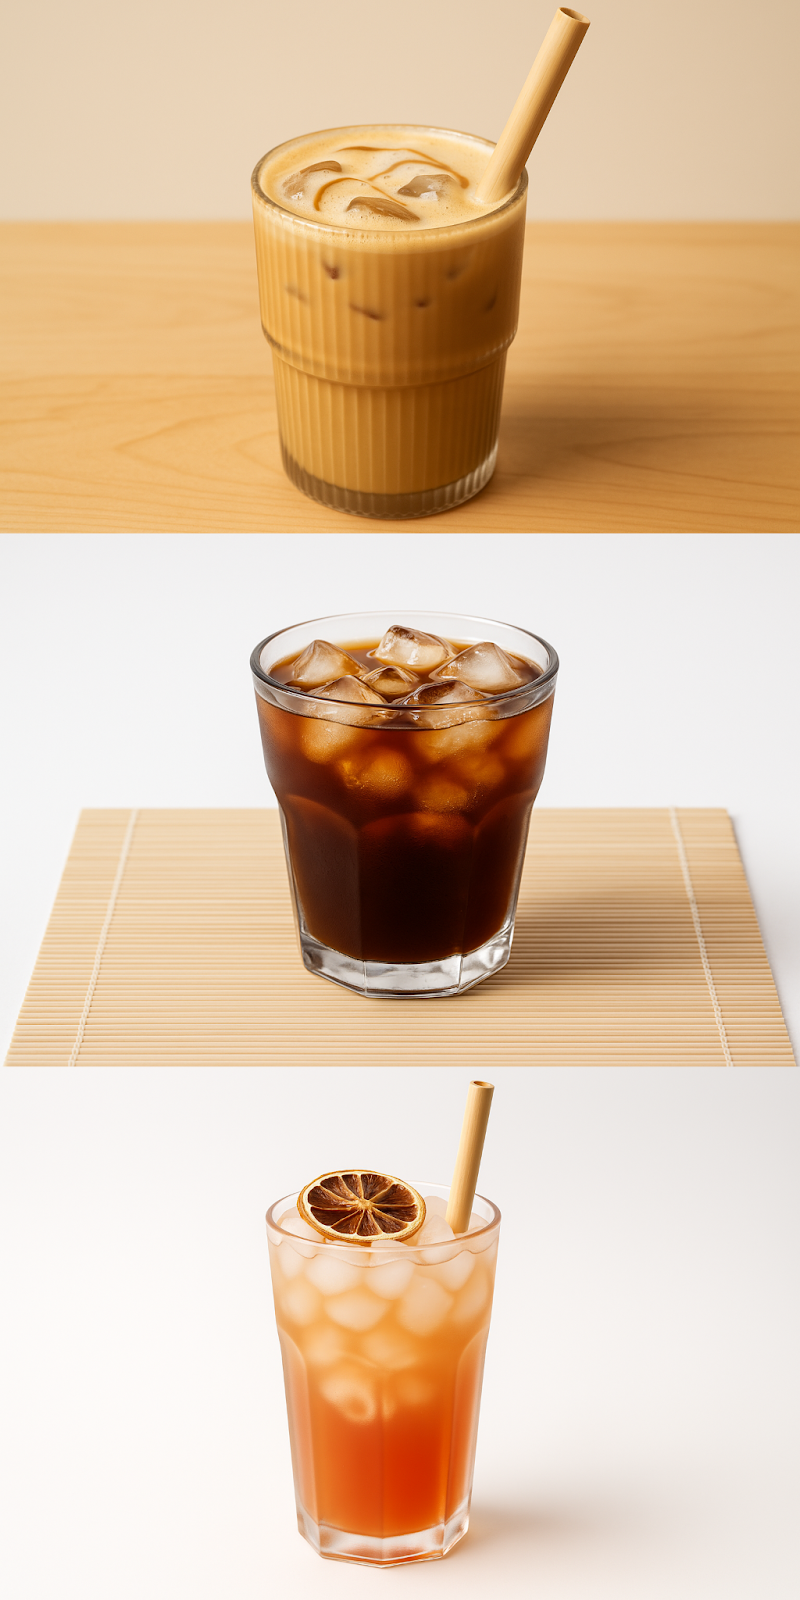
Forniamo le tre immagini come elenco nel parametro image, come segue:
prompt = """
Create a vibrant and eye-catching marketing poster to
promote the cold drinks offerings at our coffee shop.
"""

img = client.images.edit(
  model="gpt-image-1",
  # We can provide multiple images at once
  image=[
    open("latte.png", "rb"),
    open("americano.png", "rb"),
    open("icetea.png", "rb"),
  ],
  prompt=prompt,
  size="1536x1024",
)
Ecco il risultato:
La generazione di immagini viene tariffata in base a:
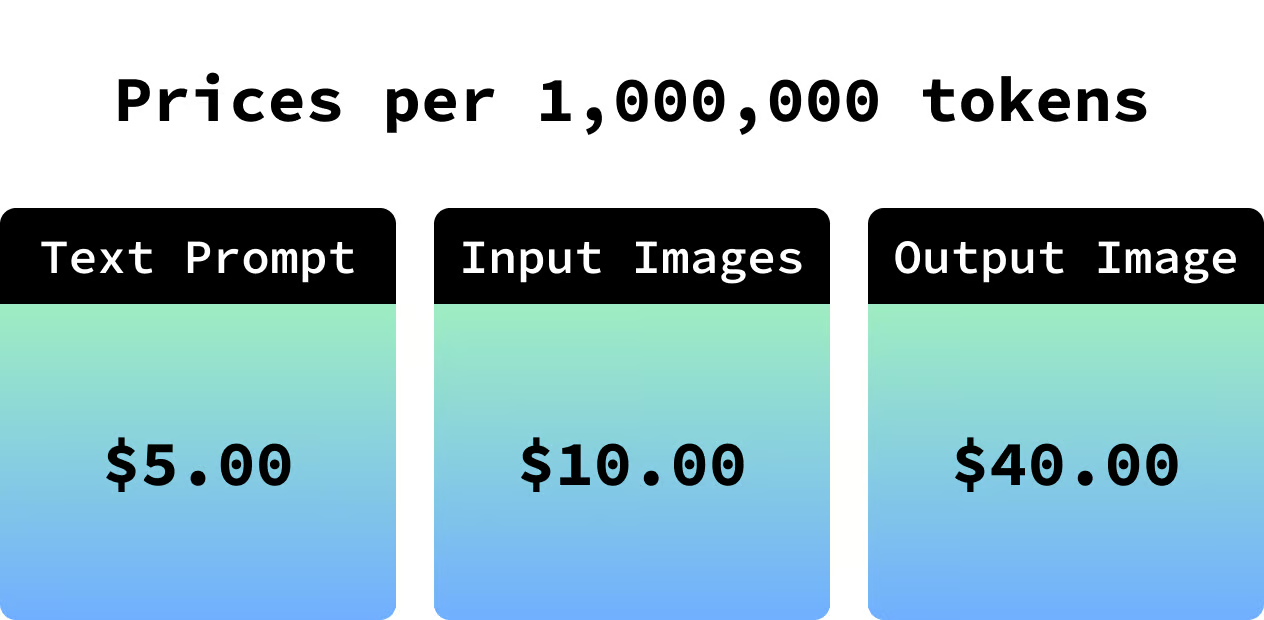
A volte è difficile farsi un’idea di cosa rappresentino questi costi perché non sappiamo da quanti token è composta un’immagine.
Poiché le dimensioni delle immagini di output sono note, sappiamo quanti token sono necessari per ciascuna e possiamo quindi fornire valori precisi per il prezzo dei token dell’immagine di output (che è la parte più costosa):
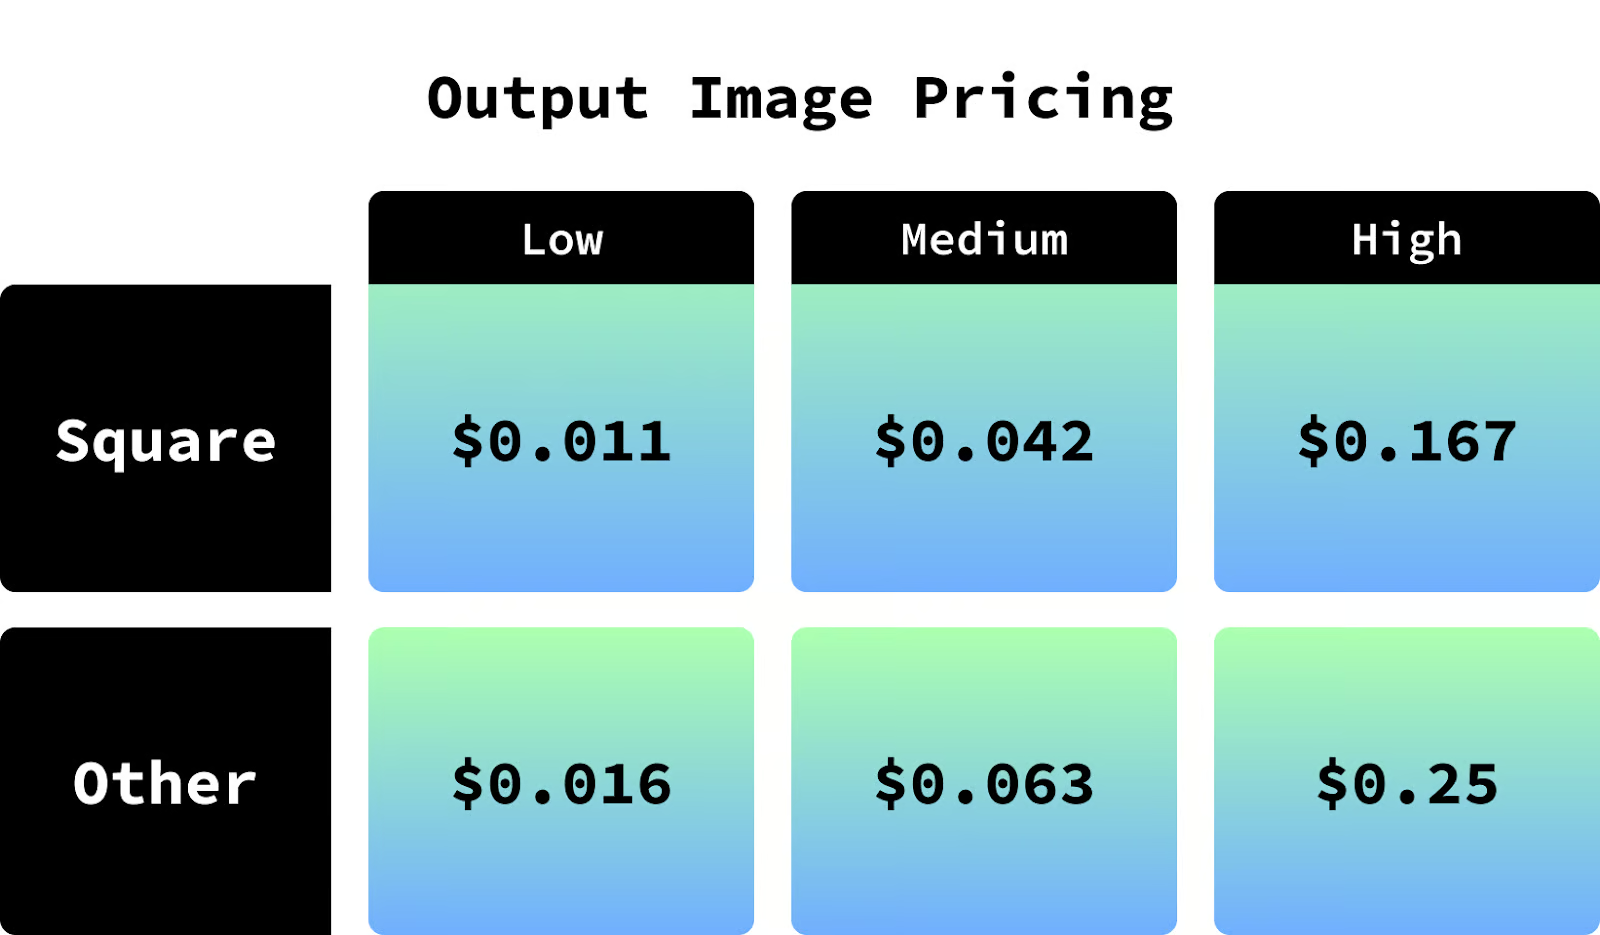
Questi prezzi dipendono dalla qualità dell’immagine e dalla dimensione. Per maggiori dettagli, consulta la pagina dei prezzi di GPT-Image-1.
Quando generiamo un’immagine, l’API restituisce il numero di token utilizzati, quindi possiamo combinarlo con le informazioni sopra per sapere esattamente quanto costa.
Possiamo visualizzare la quantità di token usati stampando il campo usage del risultato:
img = client.images.generate(
  model="gpt-image-1",
  prompt=prompt,
  background="transparent",
  n=1,
  quality="medium",
  size="1024x1024",
  moderation="auto",
  output_format="png",
)
# Add this to see the usage
print("Prompt tokens:", img.usage.input_tokens_details.text_tokens)
print("Input images tokens:", img.usage.input_tokens_details.image_tokens)
print("Output image tokens:", img.usage.output_tokens)
Output:
Prompt tokens: 8
Input images tokens: 0
Output image tokens: 272Nonostante alcune mancanze dell’API, come masking e trasparenza non sempre affidabili, il modello può eseguire con alta precisione le istruzioni fornite nel prompt.
Penso che questo modello apra molte possibilità per costruirci intorno. In questo tutorial abbiamo visto le basi su come usarlo. Ecco alcune idee che potresti voler esplorare per costruire su quanto hai imparato qui:
Impara l’AI con questi corsi!
Corso
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



