
Kurs
OpenAI API ile Çalışmak
3 sa
178.4K
Yeni GPT görsel modeli korumalıdır; yani kullanabilmek için ek doğrulamaların yapılması gerekir. Bu bölümde API’nin nasıl kurulacağını açıklıyoruz. Zaten bir API anahtarınız varsa ilk adımı atlayabilirsiniz.
İlk adım, bir API anahtarı oluşturmaktır. Platformlarına giriş yapıp API keys sayfasına giderek bir tane oluşturabiliriz. Ardından "Create new secret key" düğmesine tıklarız.
Anahtar oluşturulduktan sonra .env adlı bir dosya oluşturun ve şu biçimde kopyalayın:
OPENAI_API_KEY=<paste_your_api_key_here>Diğer OpenAI modellerinden büyük bir fark, GPT görsel API’sini kullanmak için organizasyonumuzu doğrulamamızın gerekmesidir. Bunun nedeni, GPT-Image-1’in gerçekçi ve detaylı görseller üretebilmesi; bu da deepfake veya uygunsuz içerik üretimi gibi kötüye kullanım risklerine dair endişeleri artırır. Organizasyonları doğrulayarak OpenAI kullanımın izlenmesini ve güvenlik politikalarının uygulanmasını daha iyi sağlayabilir.
Bir şirketiniz olmasa bile organizasyonunuzu doğrulayabilirsiniz. Ancak bu sürecin devlet kimliğinizi vermeyi ve yüz doğrulamasını tamamlamayı gerektirdiğini unutmayın.
Doğrulama yapmak için OpenAI API platformundaki genel sekmeye gidin ve "Verifications" bölümünün altındaki düğmeye tıklayın.
Süreç üçüncü bir tarafça yürütülür ve şunlardan oluşur:
Sürecin tamamlanması birkaç dakika, işlenmesi ise yaklaşık 15 dakika sürer.
Bu eğitimde aşağıdaki Python paketlerini kuracağız:
openai: API ile etkileşime geçmemizi sağlayan resmi OpenAI paketi.dotenv: Yukarıda oluşturduğumuz .env dosyasından API anahtarını güvenli biçimde yüklemeyi kolaylaştıran bir Python paketi.Bunları şu komutla kurabiliriz:
pip install openai dotenvHadi gpt-image-1 ile nasıl görsel üretebileceğimize bakalım. generate_image.py gibi yeni bir Python dosyası oluşturup .env dosyasıyla aynı klasöre kaydederek başlayın.
Ardından gerekli paketleri içe aktarın:
# Import the packages
from openai import OpenAI
from dotenv import load_dotenv
import os
import base64
import time
Dikkat edin, os ve base64 yerleşik Python paketleridir ve kurulmaları gerekmez.
Sonraki adımda API anahtarını yüklüyor ve OpenAI istemcisini başlatıyoruz:
# Load the API key
load_dotenv()
api_key = os.getenv("OPENAI_API_KEY")
# Initialize the OpenAI client
client = OpenAI(api_key=api_key)
Daha sonra, yerleşik input() işlevini kullanarak kullanıcıdan bir metin yönergesi istiyor ve API’ye görsel üretim isteği gönderiyoruz:
# Ask the user to input a prompt in the terminal
print("What do you want to generate?")
prompt = input("> ")
print("Generating image...")
# Send the prompt to the API
img = client.images.generate(
  model="gpt-image-1",
  prompt=prompt,
  background="auto",
  n=1,
  quality="high",
  size="1024x1024",
  output_format="png",
  moderation="auto",
)
Son olarak, oluşturulan görseli bir dosyaya kaydediyoruz:
# Save the image into a file
image_bytes = base64.b64decode(img.data[0].b64_json)
with open(f"output_{int(time.time())}.png", "wb") as f:
  f.write(image_bytes)
Tam betiği burada bulabilirsiniz. Bu betiği çalıştırmak için şu komutu kullanın:
python generate_image.pyÇıktıyla birlikte bir örnek:
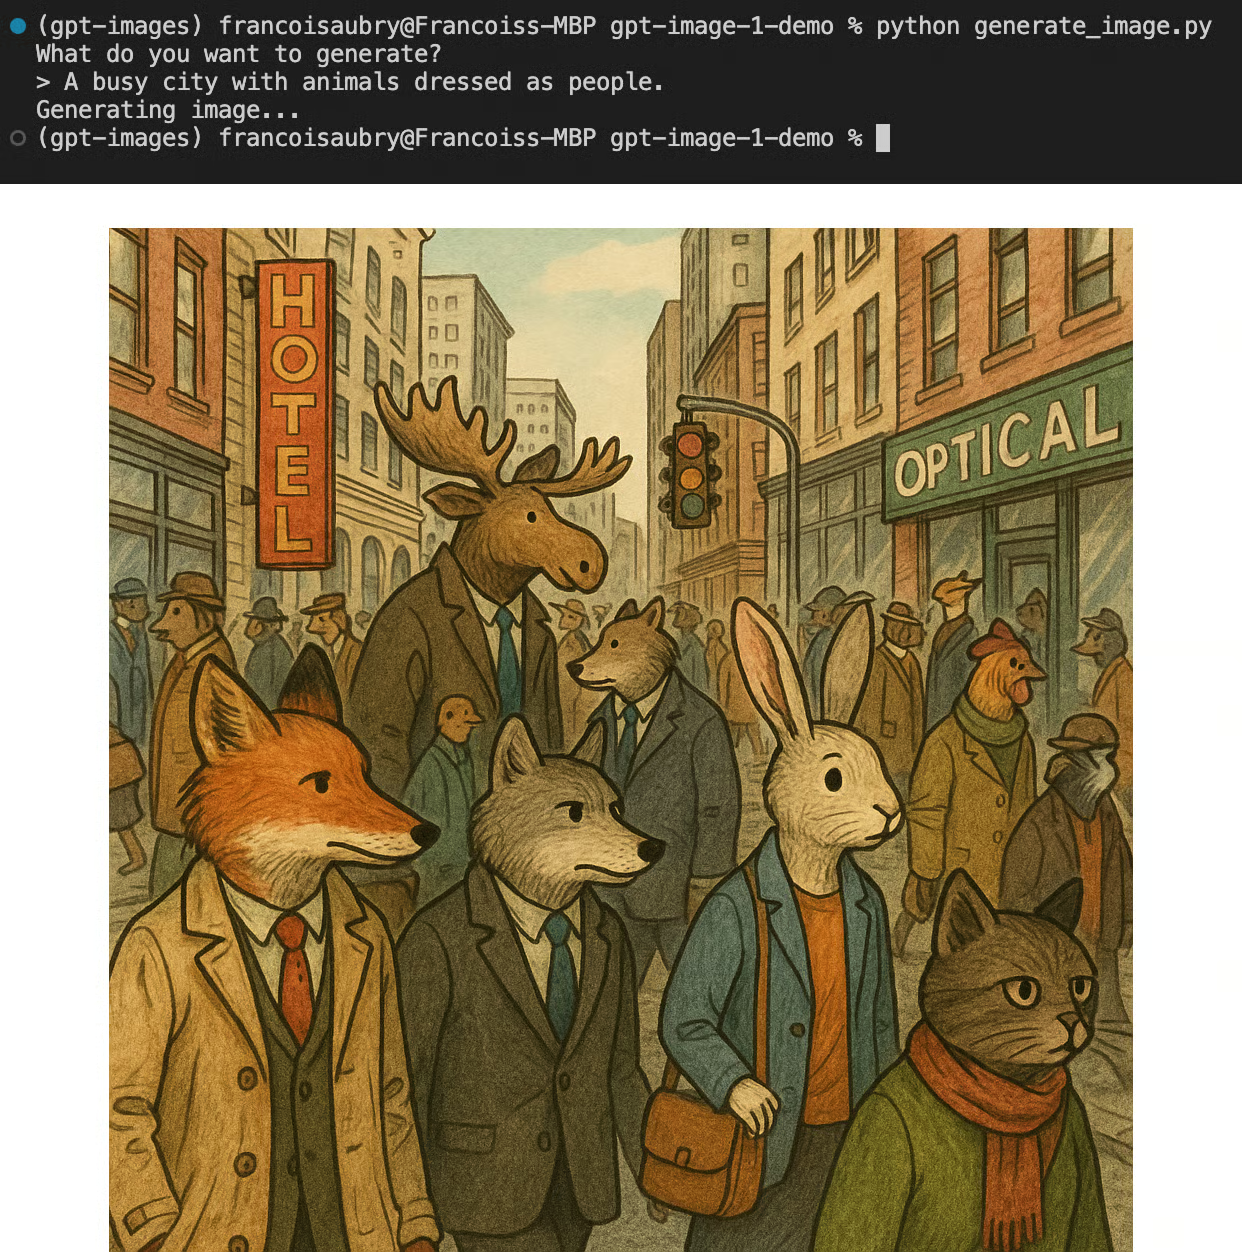
Bu bölümde gpt-image-1 modelinin en ilgili parametrelerini açıklıyoruz:
prompt: Modelin hangi görseli üretmesini istediğimizi tanımlayan metinsel yönerge.background: Görsel için arka plan türü. "transparent", "opaque" veya "auto" değerlerinden biri olmalıdır. Varsayılan değer "auto"’dur; bu durumda model içeriğe göre en uygun arka plan türüne karar verir. JPEG görsellerin saydam arka planı desteklemediğini unutmayın.n: Üretilecek görsel sayısı. 1 ile 10 arasında bir sayı olmalıdır.quality: Üretilen görselin kalitesi. "high", "medium" veya "low" değerlerinden biri olmalı; varsayılan "high"’tır.size: Görselin piksel cinsinden boyutu. "1024x1024" (kare), "1536x1024" (yatay), "1024x1536" (dikey) değerlerinden biri olmalıdır.output_format: Görsel formatı. "png", "jpeg" veya "webp" değerlerinden biri olmalıdır. Varsayılan "png"’dir.moderation: İçerik denetimi seviyesi. Daha az kısıtlayıcı bir filtre için "low" ya da varsayılan olan "auto" olmalıdır.gpt-image-1 modeli için mevcut en önemli parametreleri ele aldık. Daha fazla detay ve tam parametre listesi için resmi API dokümantasyonuna bakın.
Aynı yönerge kullanılarak farklı kalite ayarlarında üretilen görsellerin yan yana karşılaştırması:
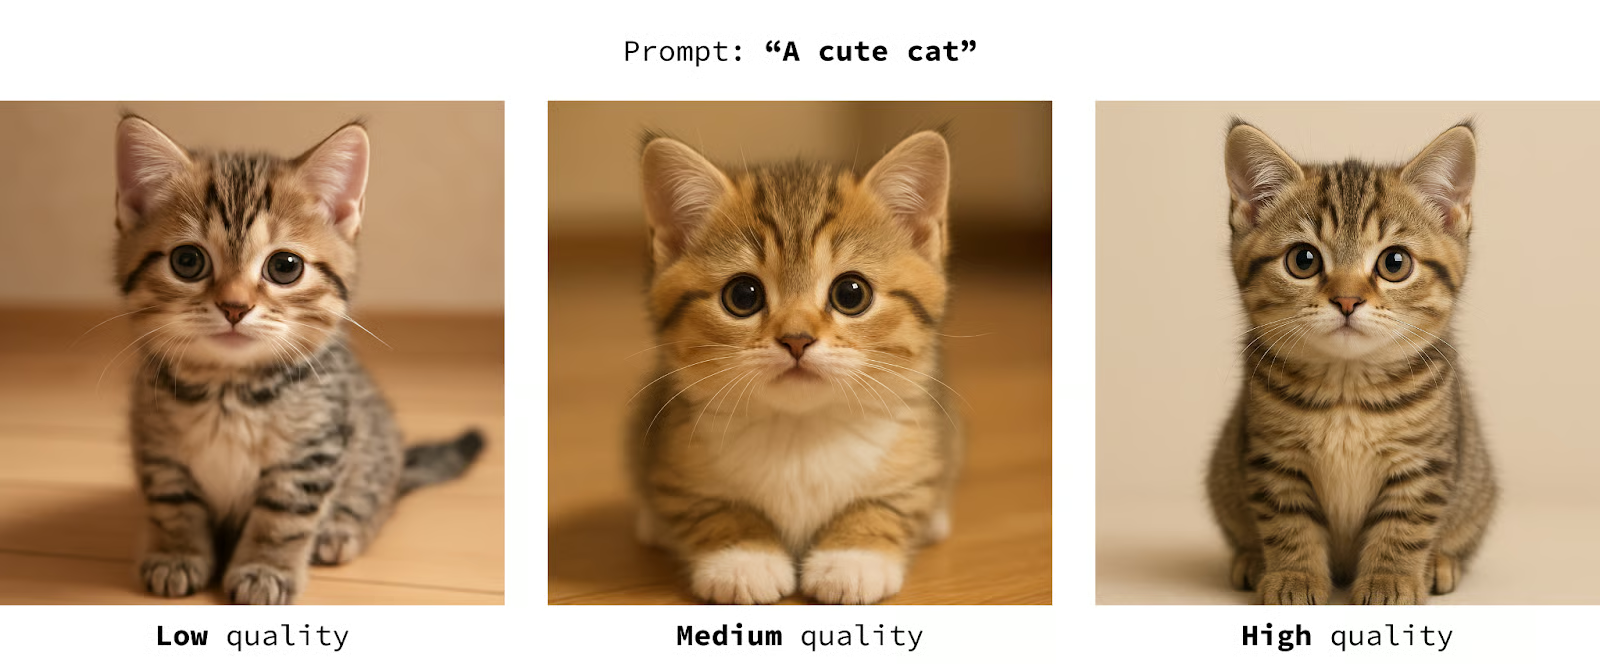
İlk kedinin (en düşük kalitede) gözlerinin etrafında bazı yapaylıklar olduğunu ve kalite arttıkça görselin belirgin biçimde daha gerçekçi hale geldiğini görüyoruz.
İşte çizgi film tarzı bir çıktıyla başka bir örnek:
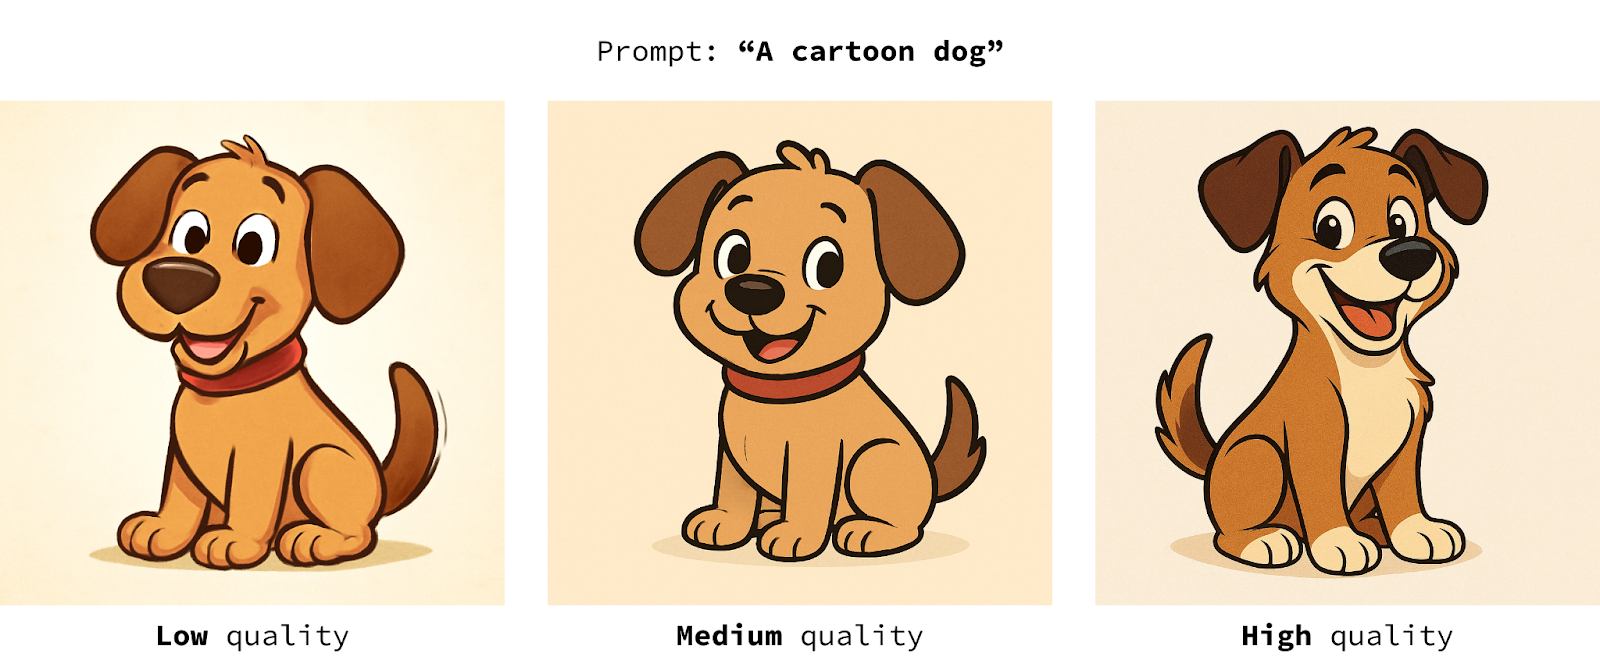
Bu durumda da kalite yükseldikçe görselin daha cilalı olduğunu fark ediyoruz. Ancak bana göre, gerçekçi olması gerekmeyen içerikler için bu daha az önem taşıyor.
Unutmayın: kalite yükseldikçe maliyet ve hesaplama süresi de artar; bu nedenle kullanım durumuna bağlı olarak iyi bir denge bulmak faydalıdır. Her kullanım durumu için kabul edilebilir sonuç veren en düşük değeri görmek adına parametreleri düşükten yükseğe denemenizi öneririm.
Deneylerimde modelin bu parametreyi çoğunlukla göz ardı ettiğini gördüm. Aşağıda, background parametresini ve yönergede saydamlık talimatlarını değiştirdiğim yan yana örnekler yer alıyor:
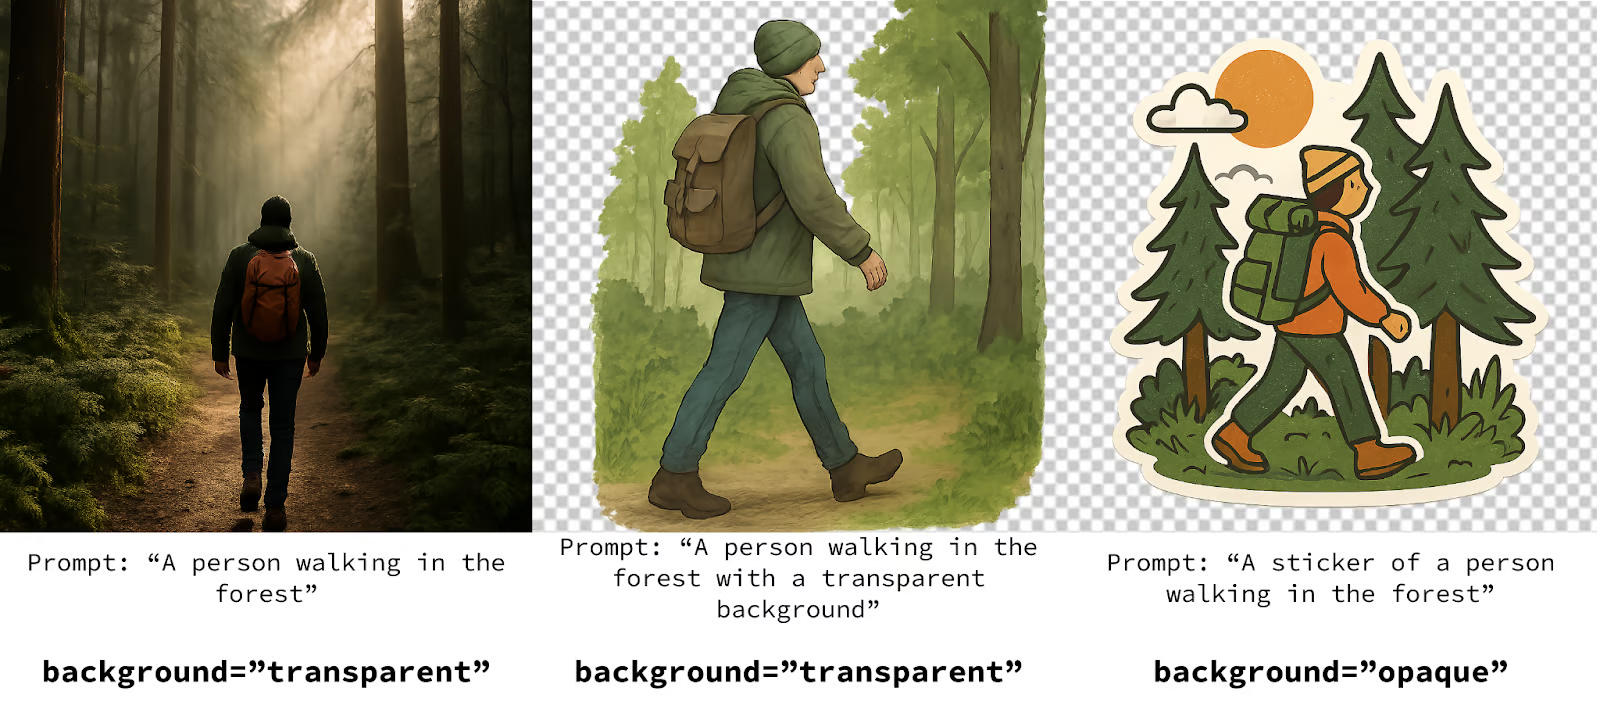
İlk örnekte saydamlık parametresi yok sayıldı. İkincide saydamlık talimatlarını yönergeye ekledim ve biraz daha iyi çalıştı. Sonuncuda opak bir arka plan istedim ancak yönergede çıkartma (sticker) istediğimi belirttim ve saydam arka plan elde ettim.
Yine de istediğinize uygun şekilde parametreyi kullanmanızı öneririm; ancak bunu pekiştirmek için aynı sonucu yönergede de belirtmeyi unutmayın.
Girişte belirttiğim gibi, GPT-Image-1’in en heyecan verici kısmı görselleri düzenleme yeteneği. Önce bir görseli düzenlemesini nasıl isteyeceğimizi öğrenelim, sonra birkaç kullanım senaryosunu inceleyelim.
Görsel düzenlemek için kodun çoğu yeniden kullanılabilir. Değişen tek kısım, client.images.generate() işlevi yerine client.images.edit() işlevini kullanmamızdır.
İşte bir örnek:
img = client.images.edit(
  model="gpt-image-1",
  image=[
    open("my-image.jpg", "rb"),
  ],
  prompt=prompt,
  n=1,
  quality="high",
  size="1024x1536",
)
Yeni parametre image. Bu, düzenlemede kullanılacak giriş görsellerinin bir listesidir. Bu durumda, betikle aynı klasörde bulunan my-image.jpg adlı tek bir görsel sağlıyoruz.
İşte GPT Image 1’i kendi fotoğraflarımdan birini düzenlemek için kullanmaya bir örnek:
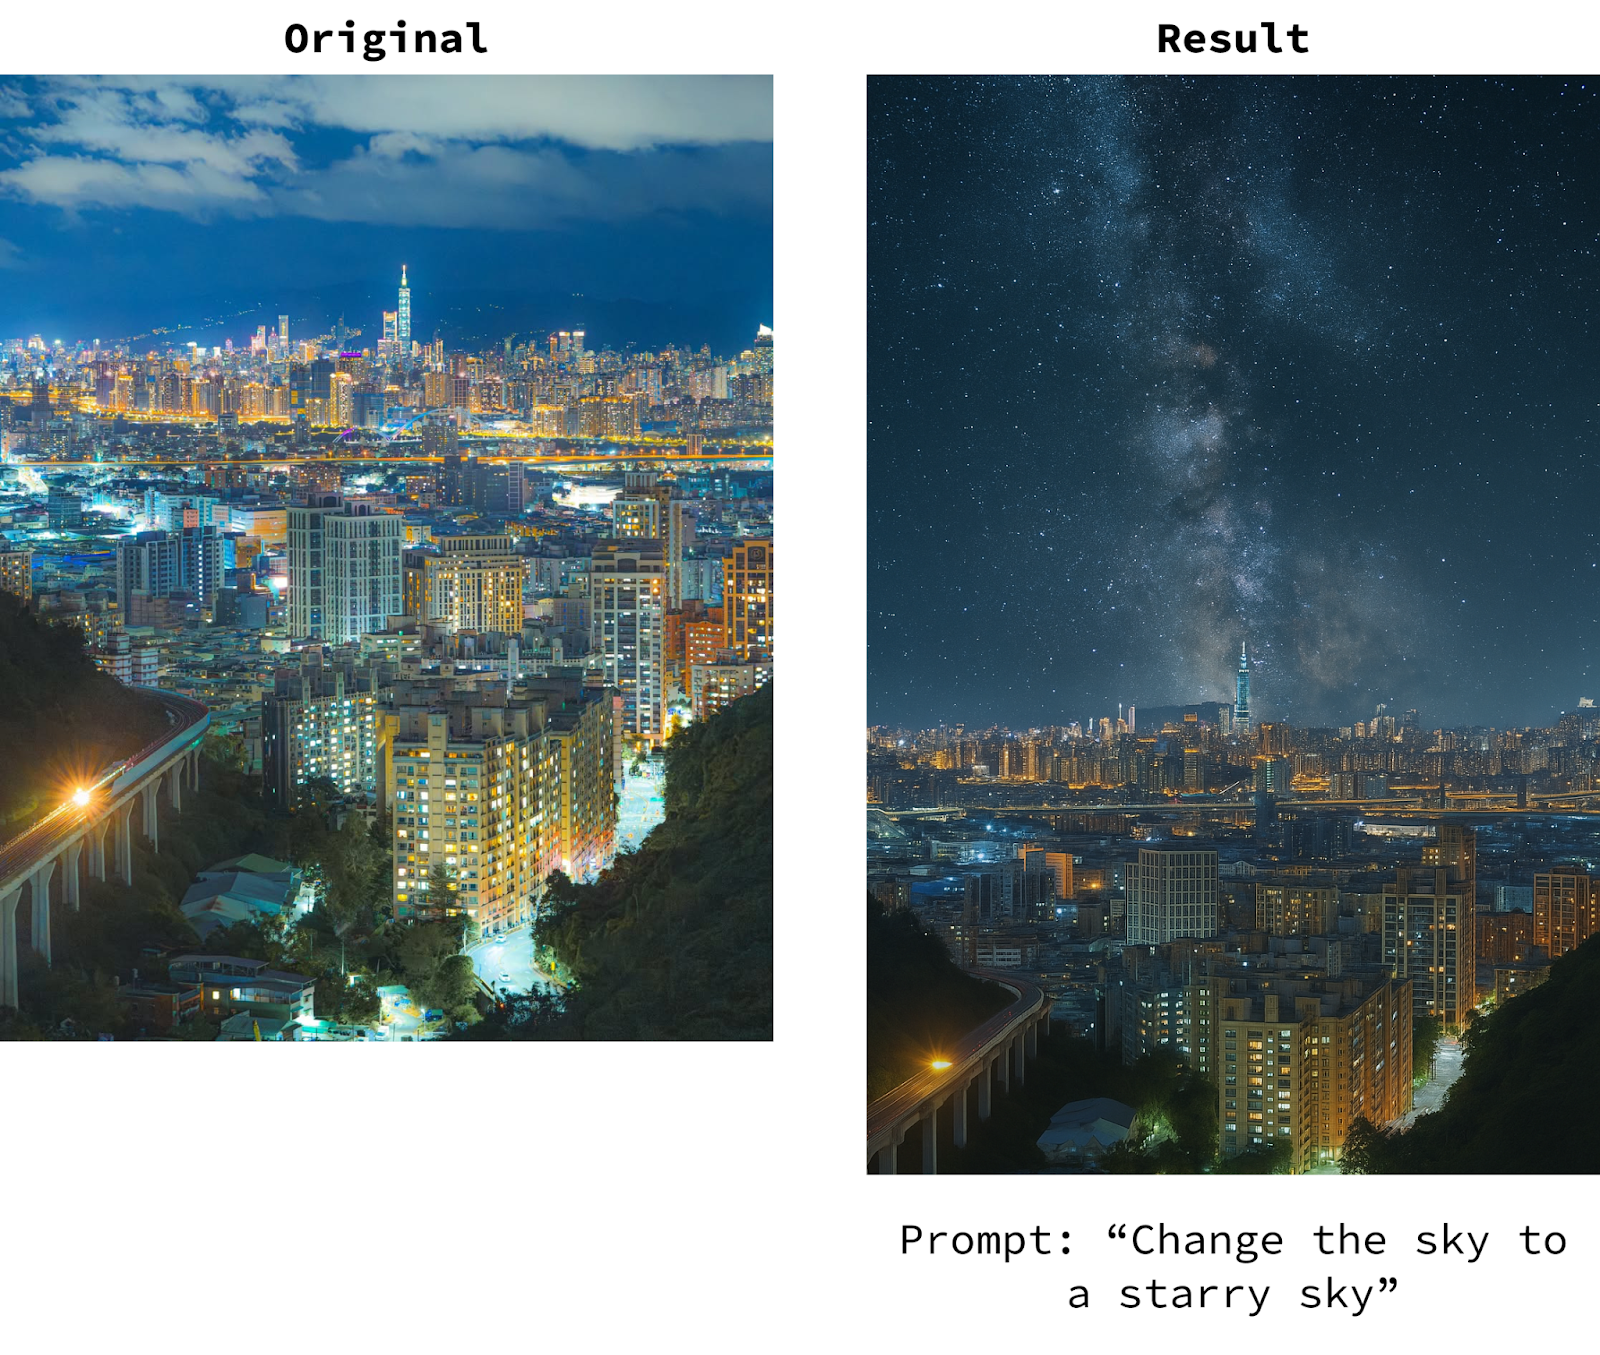
Orijinal görsel dikey oranlı olduğundan, 1024x1536 dikey boyutunu kullandığımı unutmayın. Ancak bu, orijinal görselle aynı oran değildir. Düzenleme modunda bile model yalnızca yukarıda belirtilen üç boyutta çıktı verebilir.
Tam düzenleme betiğini burada bulabilirsiniz.
Düzenleme modu, görselin hangi alanlarının düzenleneceğini belirtebileceğimiz bir mask parametresi sağlar. Maske, en fazla 4 MB boyutunda, görselle aynı boyutta bir PNG olmalıdır. %100 saydam alanlar, GPT Image 1’in düzenleyebileceği alanlara karşılık gelir.
Maskeyi görselle aynı şekilde sağlarız; tek fark bu sefer bir liste olmamasıdır:
img = client.images.edit(
  model="gpt-image-1",
  image=[
    open(sys.argv[1], "rb"),
  ],
  # We provide the mask like this
  mask=open("mask.png", "rb"),
  prompt=prompt,
  n=1,
  quality="high",
  size="1536x1024",
)
Ancak denediğimde çok iyi çalışmadı ve çevrimiçi olarak benzer sorunlar yaşayan kişilerin paylaşımlarını gördüm.
İşte bir örnek:
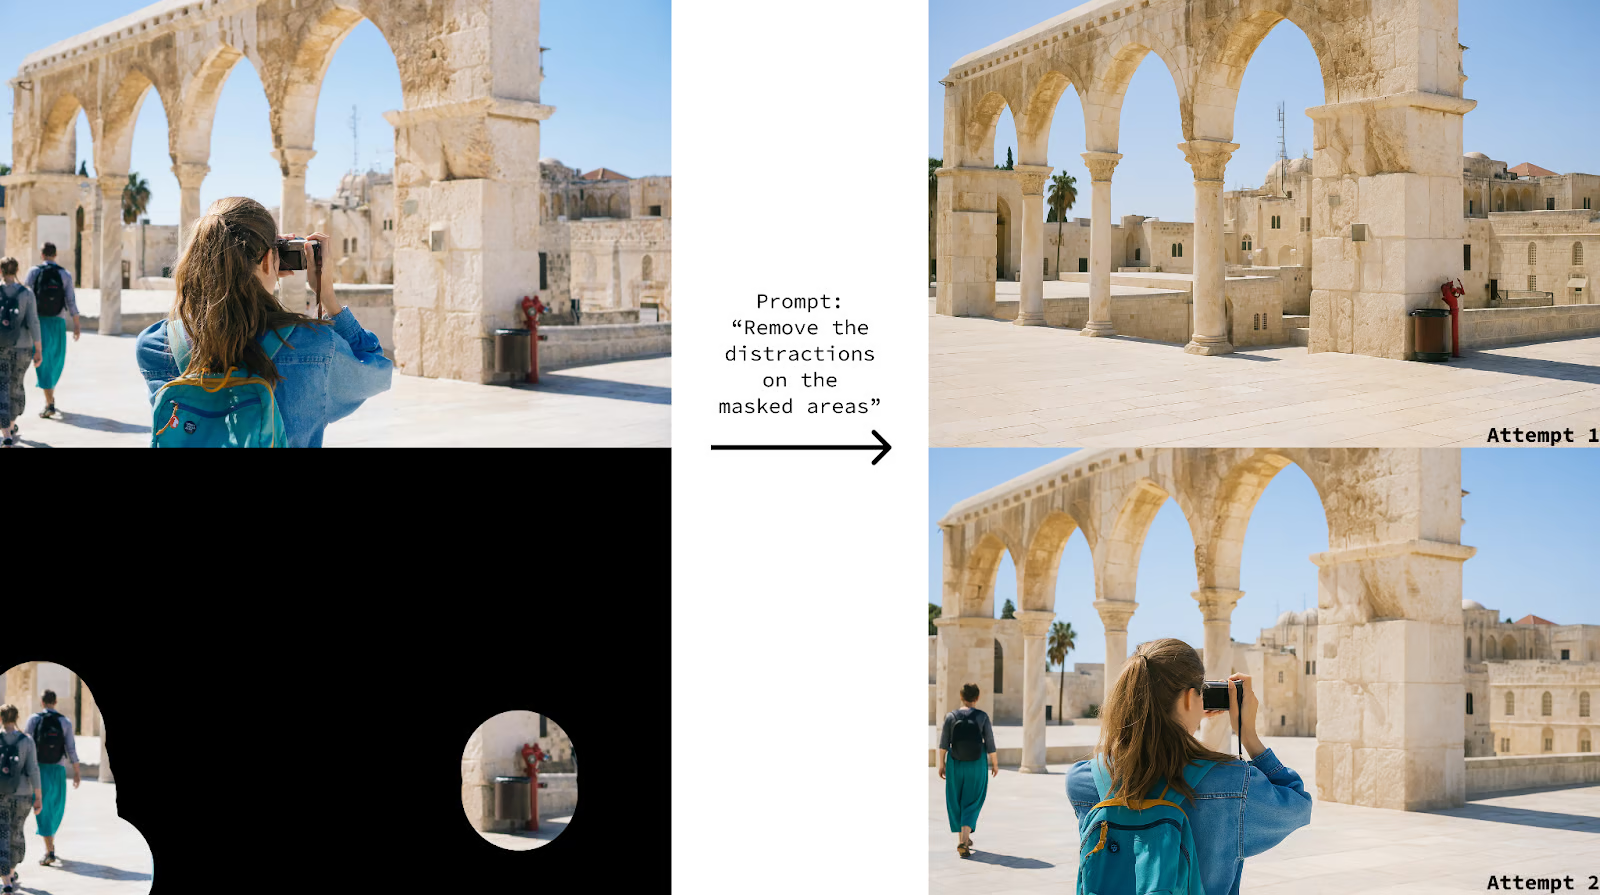
Belirli konumlara öğeler eklemek için de kullanmayı denedim ve tutarlı çalışmadı. Tıpkı görsel üretiminde background parametresini kullanmak gibi, ne istediğimi yönergede anlatmanın en iyi sonuç verdiğini gördüm.
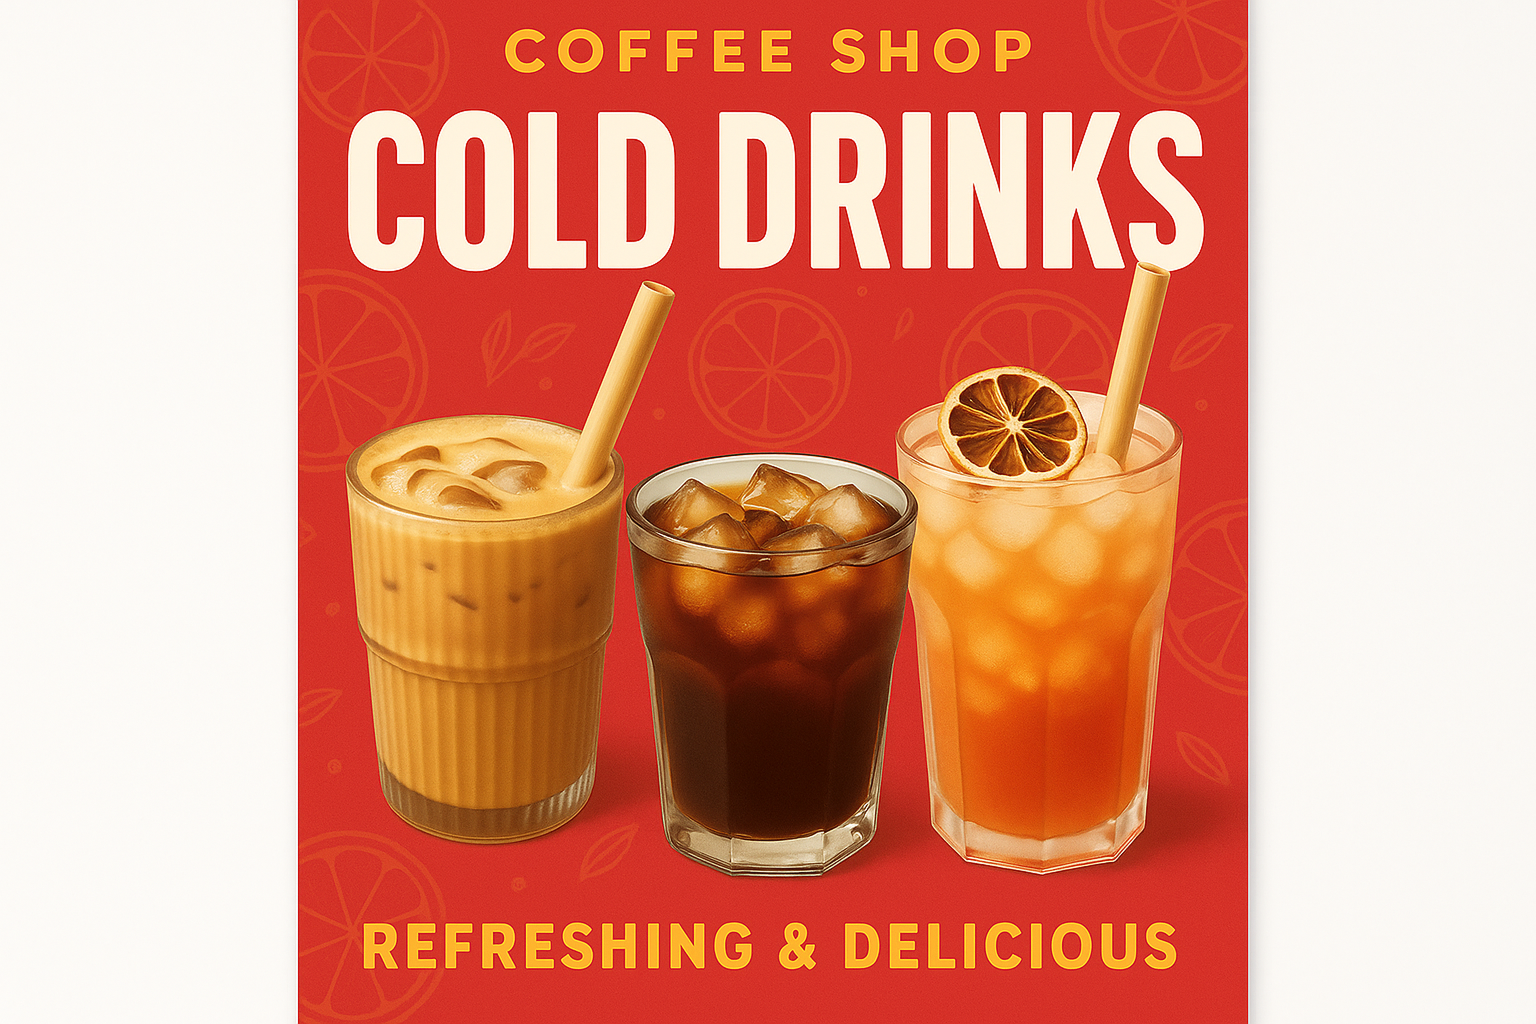
Model bir seferde birden çok görseli işleyip birleştirebilir. Aşağıdaki örnekte, bu üç içeceğin ayrı görüntülerini birleştirerek bir pazarlama posteri oluşturmak için kullanıyoruz:
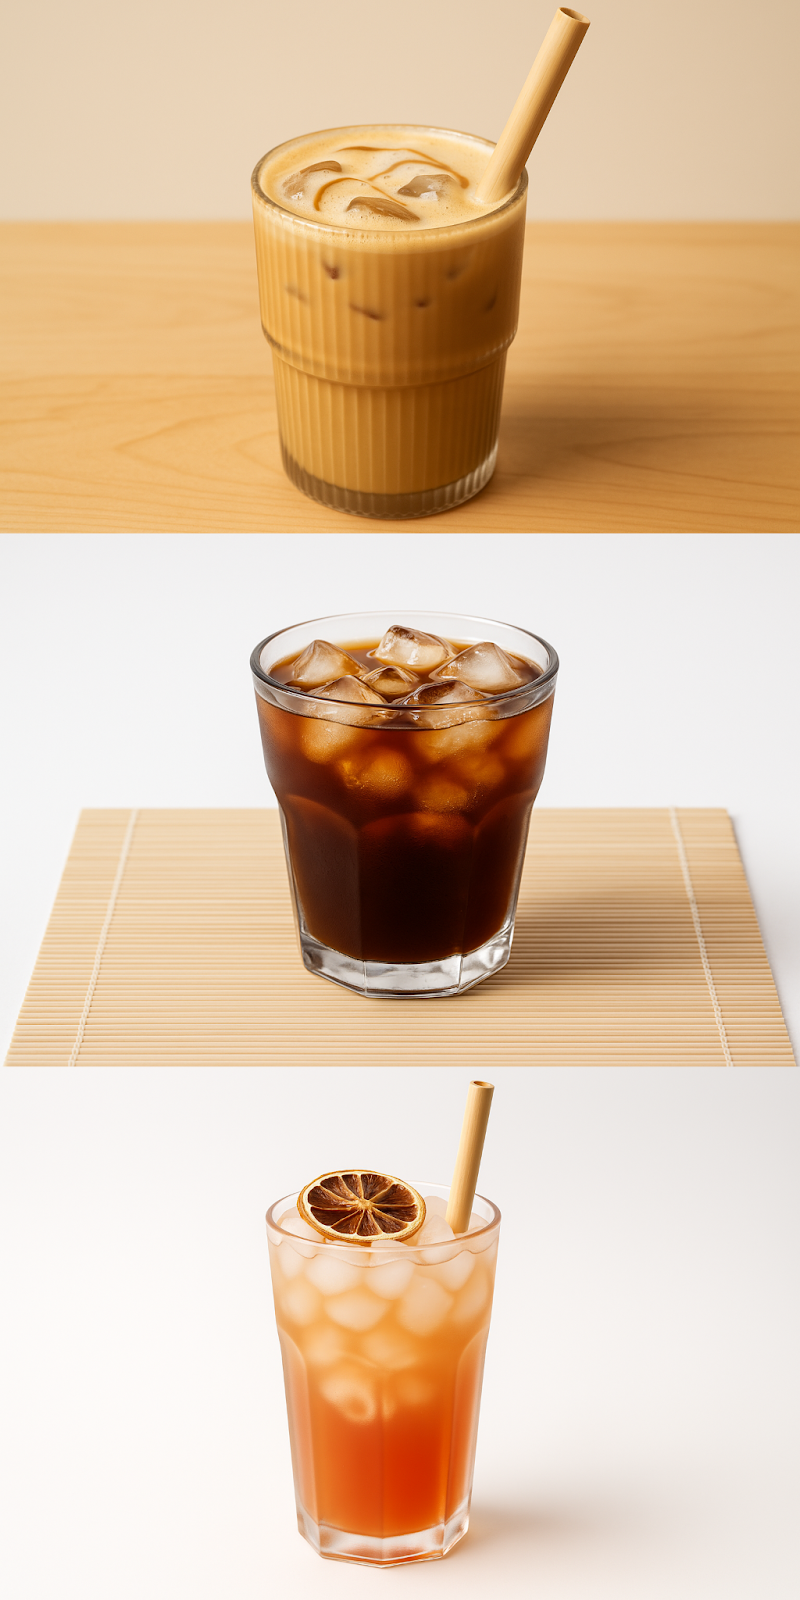
Üç görseli image parametresinde bir liste olarak aşağıdaki gibi sağlıyoruz:
prompt = """
Create a vibrant and eye-catching marketing poster to
promote the cold drinks offerings at our coffee shop.
"""

img = client.images.edit(
  model="gpt-image-1",
  # We can provide multiple images at once
  image=[
    open("latte.png", "rb"),
    open("americano.png", "rb"),
    open("icetea.png", "rb"),
  ],
  prompt=prompt,
  size="1536x1024",
)
İşte sonuç:
Görsel üretimi şu temellere göre ücretlendirilir:
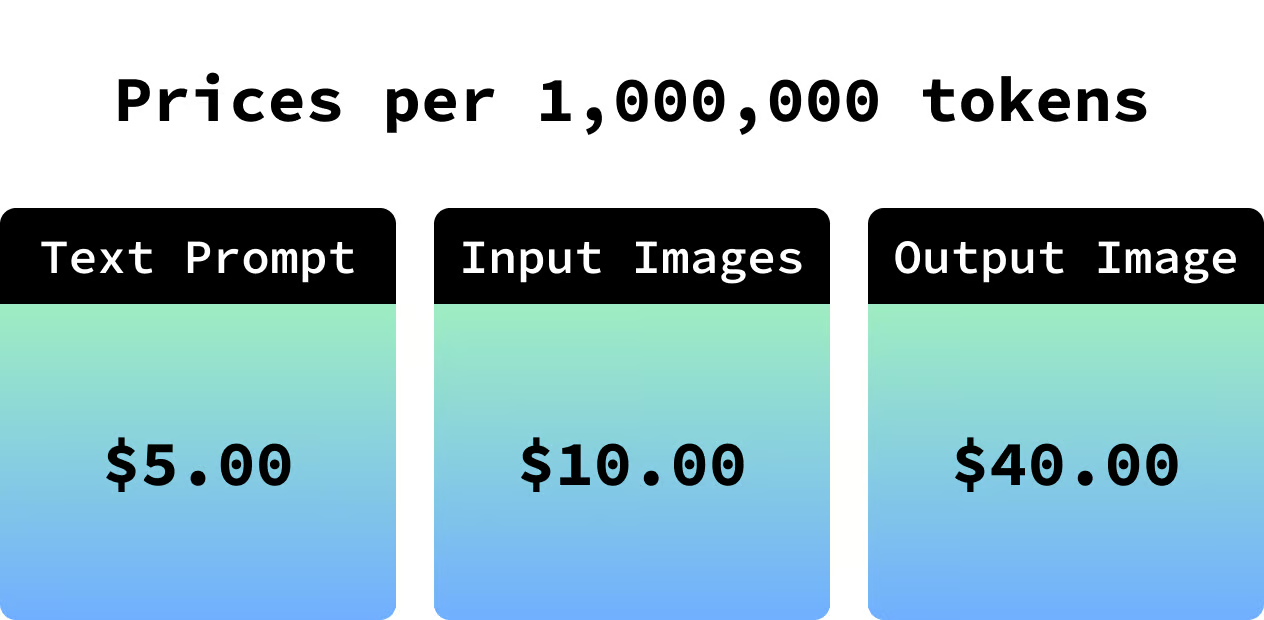
Bazen bu maliyetlerin ne ifade ettiğini anlamak zor olabilir; çünkü bir görselin kaç tokenden oluştuğunu bilmiyoruz.
Çıktı görsellerinin boyutları bilindiği için her biri için kaç token gerektiğini de biliyoruz; dolayısıyla çıktı görseli token fiyatı (ki en pahalı kısımdır) için kesin değerler verebiliriz:
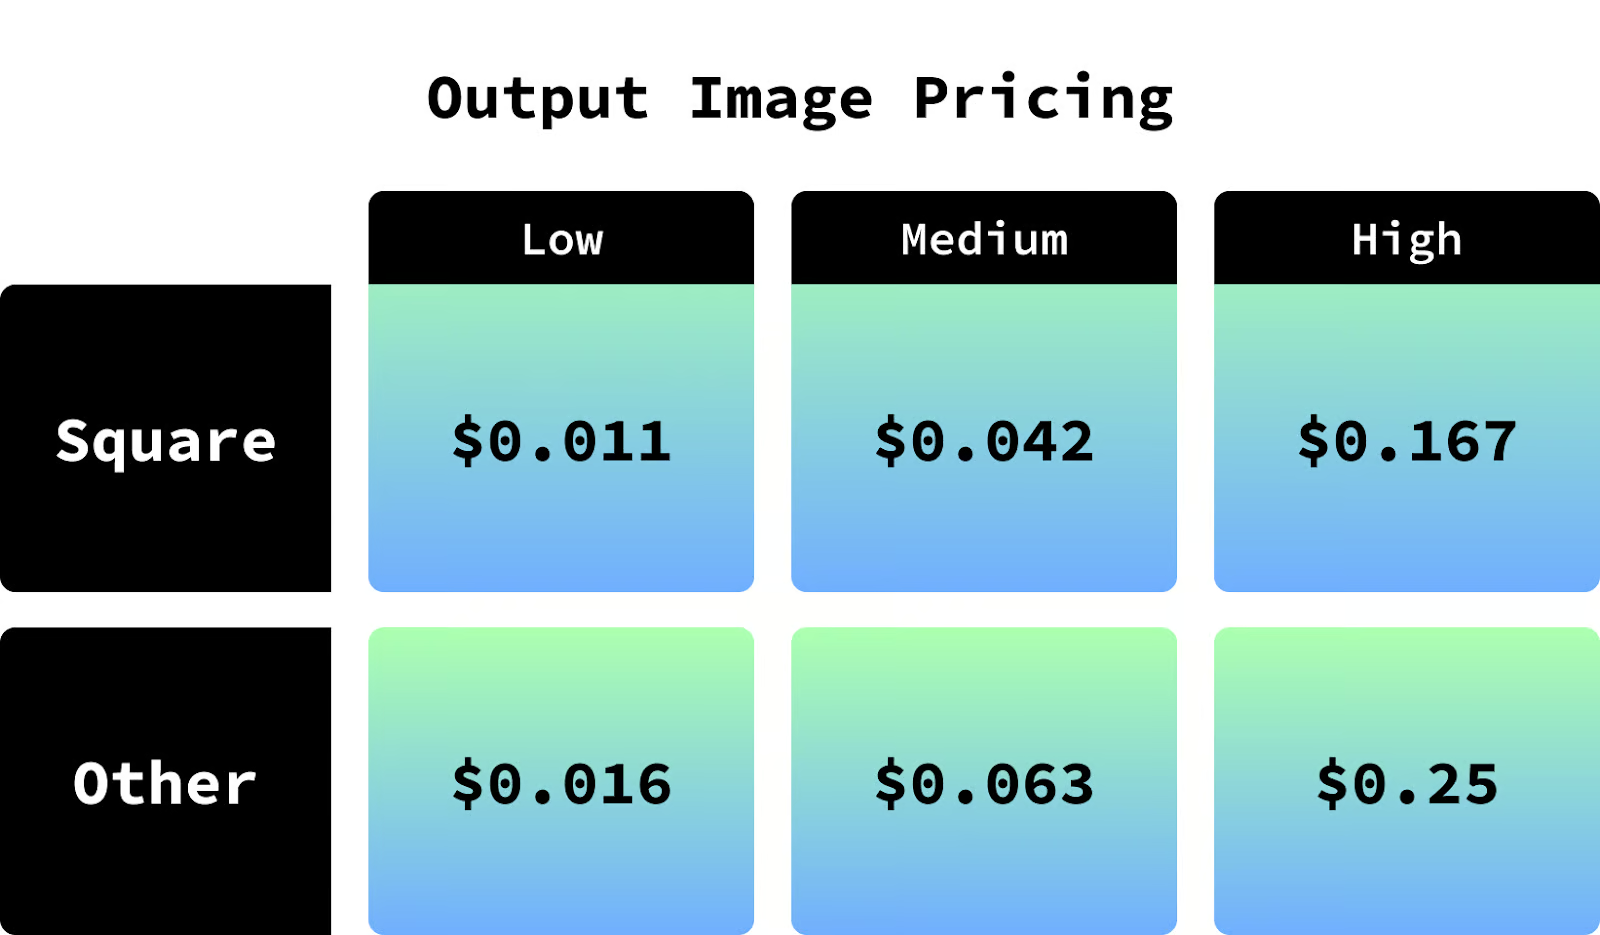
Bu fiyatlandırma, görselin kalitesine ve boyutuna bağlıdır. Daha fazla detay için GPT Image 1 fiyatlandırma sayfasına bakın.
Bir görsel ürettiğimizde, API kullandığı token sayısını döndürür; böylece yukarıdaki bilgilerle birleştirip tam maliyeti bilebiliriz.
Kullanılan token miktarını, sonucun usage alanını yazdırarak görüntüleyebiliriz:
img = client.images.generate(
  model="gpt-image-1",
  prompt=prompt,
  background="transparent",
  n=1,
  quality="medium",
  size="1024x1024",
  moderation="auto",
  output_format="png",
)
# Add this to see the usage
print("Prompt tokens:", img.usage.input_tokens_details.text_tokens)
print("Input images tokens:", img.usage.input_tokens_details.image_tokens)
print("Output image tokens:", img.usage.output_tokens)
Çıktı:
Prompt tokens: 8
Input images tokens: 0
Output image tokens: 272Maskeleme ve saydamlık gibi bazı API eksiklikleri yeterince güvenilir olmasa da, model yönergede verilen talimatları yüksek hassasiyetle uygulayabiliyor.
Bence bu model, etrafında ürünler inşa etmek için pek çok olasılığın kapısını açıyor. Bu eğitimde, nasıl kullanılacağına dair temel bilgileri öğrendik. Burada öğrendiklerinizin üzerine inşa etmek için keşfedebileceğiniz birkaç fikir:
Bu kurslarla yapay zekâyı öğrenin!
Kurs
Program
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



