Twee belangrijke klassen van numerieke problemen die voorkomen bij data-analyse zijn optimalisatie- en integratieproblemen. Het is niet altijd mogelijk om de schatters die bij een model horen analytisch te berekenen, waardoor we vaak uitkomen op numerieke oplossingen. Eén manier om dat probleem te omzeilen is simulatie gebruiken. Monte Carlo-schatting betekent dat je hypothetische trekkingen uit een kansverdeling simuleert om belangrijke grootheden van die verdeling te berekenen.
Het basisidee van Monte Carlo bestaat eruit de integraal te schrijven als een verwachtingswaarde ten opzichte van een kansverdeling, en die vervolgens te benaderen met de momentenmethode ($E[g(X)] \approx \overline{g(X)} = \dfrac{1}{n}\sum g(X_{i})$).
Als we een continue functie $g(\theta)$ hebben en we willen integreren over het interval (a,b), dan kunnen we onze integraal herschrijven als een verwachtingswaarde van een uniforme verdeling $U \sim U[a,b]$, namelijk:
Met de momentenmethode is onze integraalbenadering:
Waarbij de
gesimuleerde waarden uit een uniforme verdeling zijn.
Voorbeeld 1: Exponentiële integraalbenadering
1) Gegeven een functie $f(x)= e^{x}$ is de integraal op het interval [3,5]:
De Monte Carlo-benadering van de integraal is:
# Declaring the desired function
f =function(x){return(exp(x))}# Declaring the absolute error function
error =function(x,y){return(abs(x-y))}# The actual integral answer
ans = exp(5)-exp(3)
set.seed(6971)# number of iterations
n =10^2# simulated uniform data
x= runif(n,3,5)# MonteCarlo approximation
MCa=(5-3)*mean(f(x))# Approximation error
e = error(ans,MCa)
rest = data.frame(n = n,MCapprox = MCa,error = e)
set.seed(6971)for(k in3:6){
n =10^k
x = runif(n,3,5)
mca =(5-3)*mean(f(x))
rest = rbind(rest,c(n,mca,error(ans,mca)))}
kable(rest,digits =5,align ='c',caption ="Integral Monte Carlo approximation results",
col.names =c("Number of simulations","Monte Carlo approximation","Error approximation"))Mogelijk gemaakt door
Gegeneraliseerde Monte Carlo-benadering
In het algemene geval is de integraalbenadering voor een gegeven verdeling f:
Een algoritme voor de constructie van $\widehat{I}$ kan worden beschreven met de volgende stappen:
1) Genereer uit een f-verdeling
2) Bereken:
3) Neem het steekproefgemiddelde: $$\overline{I} = \dfrac{1}{n}\sum_{k=1}^{n}\dfrac{g(\theta_k)}{f(\theta_k)}$$
In de volgende codeblok laten we de eenvoudige Monte Carlo-benaderingsfunctie zien om te illustreren hoe het algoritme werkt, waarbij a en b de parameters van de uniforme dichtheid zijn, n het aantal gewenste simulaties, en f de functie die we willen integreren.
# The simple Monte Carlo function
MCaf =function(n,a,b,f){
x = runif(n,a,b)
MCa =(b-a)*mean(f(x))
return(MCa)}Mogelijk gemaakt door
Monte Carlo-methoden in Bayesiaanse data-analyse
Het belangrijkste idee van Bayesiaanse data-analyse is een model (zoals een regressie- of tijdreeksmodel) fitten met een Bayesiaanse inferentie-aanpak. We nemen aan dat onze parameters van interesse een theoretische verdeling hebben; deze verdeling (posterior) wordt bijgewerkt met de verdeling van de geobserveerde data (likelihood) en de eerdere of externe informatie over onze parameters (priorverdeling) via de stelling van Bayes.
Het grootste probleem in de Bayesiaanse aanpak is het schatten van de posteriorverdeling. De Markov Chain Monte Carlo-methoden (mcmc) genereren een steekproef uit de posteriorverdeling en benaderen de verwachtingswaarden, kansen of kwantielen met Monte Carlo-methoden.
In de volgende twee secties geven we twee voorbeelden voor het benaderen van kansen en kwantielen van een theoretische verdeling. De hierboven beschreven procedure zijn de gebruikelijke methodologieën binnen een Bayesiaanse aanpak.
Voorbeeld 2: Kansbenadering van een gammaverdeling
Stel dat we de kans willen berekenen dat een willekeurige variabele $\theta$ tussen nul en 5 ligt, $P(0 < \theta < 5)$, waarbij $\theta$ een gammaverdeling heeft met parameter a = 2 en b = 1/3 ($\theta \sim Gamma(a = 2,b = 1/3)$); de kans is dan:
Waar $I_{[0,5]}(\theta) = 1$ als $\theta$ in het interval [0,5] ligt. Het idee van de Monte Carlo-benadering is het aantal observaties tellen dat in het interval [0,5] valt, en dat delen door het totaal aantal gesimuleerde data.
set.seed(6972)# number of iterations
n =10^2# simulated uniform data
x= rgamma(n,shape =2,1/3)# MonteCarlo approximation
MCa= mean(x <=5)# Approximation error
e = error(pgamma(5,2,1/3),MCa)
rest = data.frame(n = n,MCapprox = MCa,error = e)for(k in3:6){
n =10^k
x= rgamma(n,shape =2,1/3)
mca= mean(x <=5)
rest = rbind(rest,c(n,mca,error(pgamma(5,2,1/3),mca)))}
kable(rest,digits =5,align ='c',caption ="Probability Monte Carlo approximation results",
col.names =c("Number of simulations","Monte Carlo approximation","Error approximation"))Mogelijk gemaakt door
Voorbeeld 3: Kwantielbenadering van een normale verdeling
Stel dat we het 0,95-kwantiel willen berekenen van een willekeurige variabele $\theta$ met een normale verdeling met parameters $\mu = 20$ en $\sigma = 3$ ($\theta \sim normal(\mu = 20,\sigma^{2} = 9)$); het 0,95-kwantiel is dan:
Het idee is de grootste steekproefwaarde te vinden die een kans geeft die gelijk is aan of kleiner is dan 0,95. De Monte Carlo-benadering van het kwantiel schatten we met de functie quantile() op de gesimuleerde data.
set.seed(6973)# number of iterations
n =10^2# simulated uniform data
x= rnorm(n,20,3)# MonteCarlo approximation
MCa= quantile(x,0.95)# Approximation error
e = error(qnorm(0.95,20,3),MCa)
rest = data.frame(n = n,MCapprox = MCa,error = e)for(k in3:6){
n =10^k
x= rnorm(n,20,3)
mca= quantile(x,0.95)
rest = rbind(rest,c(n,mca,error(qnorm(0.95,20,3),mca)))}
kable(rest,digits =5,align ='c',caption ="Quantile Monte Carlo approximation results",
col.names =c("Number of simulations","Monte Carlo approximation","Error approximation"),row.names =FALSE)Mogelijk gemaakt door
Discussie en conclusies
Monte Carlo-benaderingen bieden een alternatieve methode voor integraalbenadering en zijn een onmisbaar hulpmiddel binnen Bayesiaanse inferentie, vooral wanneer we met geavanceerde en complexe modellen werken. Zoals in onze drie voorbeelden te zien is, leveren Monte Carlo-methoden een uitstekende benadering op, maar ze vereisen een zeer groot aantal simulaties om een benaderingsfout dicht bij nul te krijgen.
Referenties
1) Introducing Monte Carlo methods with R, Springer 2004, Christian P. Robert and George Casella.
2) Handbook of Markov Chain Monte Carlo, Chapman and Hall, Steve Brooks, Andrew Gelman, Galin L. Jones, and Xiao-Li Meng.
3) Introduction to mathematical Statistics, Pearson, Robert V. Hogg, Joseph W. Mckean, and Allen T. Craig.
4) Statistical Inference An Integrated Approach, Chapman and Hall, Helio S. Migon, Dani Gamerman, Francisco Louzada.



 Adel Nehme · 15 min
Introductie
Twee belangrijke klassen van numerieke problemen die voorkomen bij data-analyse zijn optimalisatie- en integratieproblemen. Het is niet altijd mogelijk om de schatters die bij een model horen analytisch te berekenen, waardoor we vaak uitkomen op numerieke oplossingen. Eén manier om dat probleem te omzeilen is simulatie gebruiken. Monte Carlo-schatting betekent dat je hypothetische trekkingen uit een kansverdeling simuleert om belangrijke grootheden van die verdeling te berekenen.
Het basisidee van Monte Carlo bestaat eruit de integraal te schrijven als een verwachtingswaarde ten opzichte van een kansverdeling, en die vervolgens te benaderen met de momentenmethode ($E[g(X)] \approx \overline{g(X)} = \dfrac{1}{n}\sum g(X_{i})$).
Als we een continue functie $g(\theta)$ hebben en we willen integreren over het interval (a,b), dan kunnen we onze integraal herschrijven als een verwachtingswaarde van een uniforme verdeling $U \sim U[a,b]$, namelijk:
Met de momentenmethode is onze integraalbenadering:
Waarbij de
gesimuleerde waarden uit een uniforme verdeling zijn.
Voorbeeld 1: Exponentiële integraalbenadering
1) Gegeven een functie $f(x)= e^{x}$ is de integraal op het interval [3,5]:
De Monte Carlo-benadering van de integraal is:
Gegeneraliseerde Monte Carlo-benadering
In het algemene geval is de integraalbenadering voor een gegeven verdeling f:
Een algoritme voor de constructie van $\widehat{I}$ kan worden beschreven met de volgende stappen:
1) Genereer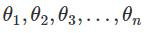 uit een f-verdeling
2) Bereken: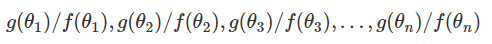
3) Neem het steekproefgemiddelde: $$\overline{I} = \dfrac{1}{n}\sum_{k=1}^{n}\dfrac{g(\theta_k)}{f(\theta_k)}$$
In de volgende codeblok laten we de eenvoudige Monte Carlo-benaderingsfunctie zien om te illustreren hoe het algoritme werkt, waarbij a en b de parameters van de uniforme dichtheid zijn, n het aantal gewenste simulaties, en f de functie die we willen integreren.
Monte Carlo-methoden in Bayesiaanse data-analyse
Het belangrijkste idee van Bayesiaanse data-analyse is een model (zoals een regressie- of tijdreeksmodel) fitten met een Bayesiaanse inferentie-aanpak. We nemen aan dat onze parameters van interesse een theoretische verdeling hebben; deze verdeling (posterior) wordt bijgewerkt met de verdeling van de geobserveerde data (likelihood) en de eerdere of externe informatie over onze parameters (priorverdeling) via de stelling van Bayes.
$$p(\theta / X) \text{ } \alpha\text{ } p(X/\theta)p(\theta)$$ Waarbij:
$p(\theta/X)$ de posteriorverdeling van de parameter is
$p(X/\theta)$ de steekproefverdeling van de geobserveerde data is (likelihood).
$p(\theta)$ de priorverdeling van de parameter is.
Het grootste probleem in de Bayesiaanse aanpak is het schatten van de posteriorverdeling. De Markov Chain Monte Carlo-methoden (mcmc) genereren een steekproef uit de posteriorverdeling en benaderen de verwachtingswaarden, kansen of kwantielen met Monte Carlo-methoden.
In de volgende twee secties geven we twee voorbeelden voor het benaderen van kansen en kwantielen van een theoretische verdeling. De hierboven beschreven procedure zijn de gebruikelijke methodologieën binnen een Bayesiaanse aanpak.
Voorbeeld 2: Kansbenadering van een gammaverdeling
Stel dat we de kans willen berekenen dat een willekeurige variabele $\theta$ tussen nul en 5 ligt, $P(0 < \theta < 5)$, waarbij $\theta$ een gammaverdeling heeft met parameter a = 2 en b = 1/3 ($\theta \sim Gamma(a = 2,b = 1/3)$); de kans is dan:
Waar $I_{[0,5]}(\theta) = 1$ als $\theta$ in het interval [0,5] ligt. Het idee van de Monte Carlo-benadering is het aantal observaties tellen dat in het interval [0,5] valt, en dat delen door het totaal aantal gesimuleerde data.
Voorbeeld 3: Kwantielbenadering van een normale verdeling
Stel dat we het 0,95-kwantiel willen berekenen van een willekeurige variabele $\theta$ met een normale verdeling met parameters $\mu = 20$ en $\sigma = 3$ ($\theta \sim normal(\mu = 20,\sigma^{2} = 9)$); het 0,95-kwantiel is dan:
Het idee is de grootste steekproefwaarde te vinden die een kans geeft die gelijk is aan of kleiner is dan 0,95. De Monte Carlo-benadering van het kwantiel schatten we met de functie quantile() op de gesimuleerde data.
Discussie en conclusies
Monte Carlo-benaderingen bieden een alternatieve methode voor integraalbenadering en zijn een onmisbaar hulpmiddel binnen Bayesiaanse inferentie, vooral wanneer we met geavanceerde en complexe modellen werken. Zoals in onze drie voorbeelden te zien is, leveren Monte Carlo-methoden een uitstekende benadering op, maar ze vereisen een zeer groot aantal simulaties om een benaderingsfout dicht bij nul te krijgen.
Referenties
1) Introducing Monte Carlo methods with R, Springer 2004, Christian P. Robert and George Casella.
2) Handbook of Markov Chain Monte Carlo, Chapman and Hall, Steve Brooks, Andrew Gelman, Galin L. Jones, and Xiao-Li Meng.
3) Introduction to mathematical Statistics, Pearson, Robert V. Hogg, Joseph W. Mckean, and Allen T. Craig.
4) Statistical Inference An Integrated Approach, Chapman and Hall, Helio S. Migon, Dani Gamerman, Francisco Louzada.