In questo tutorial imparerai la metodologia Monte Carlo e le sue applicazioni in data science, come l’approssimazione di integrali e la stima dei parametri.
Due grandi classi di problemi numerici che sorgono nelle procedure di analisi dei dati sono i problemi di ottimizzazione e di integrazione. Non è sempre possibile calcolare analiticamente gli stimatori associati a un dato modello, e spesso siamo portati a considerare soluzioni numeriche. Un modo per aggirare il problema è usare la simulazione. La stima Monte Carlo consiste nel simulare estrazioni ipotetiche da una distribuzione di probabilità, per calcolare quantità rilevanti di quella distribuzione.
L’idea di base di Monte Carlo consiste nello scrivere l’integrale come un valore atteso rispetto a una certa distribuzione di probabilità, per poi approssimarlo usando il metodo dei momenti ($E[g(X)] \approx \overline{g(X)} = \dfrac{1}{n}\sum g(X_{i})$).
Se abbiamo una funzione continua $g(\theta)$ e vogliamo integrarla nell’intervallo (a,b), possiamo riscrivere il nostro integrale come valore atteso di una distribuzione uniforme $U \sim U[a,b]$, cioè:
Usando il metodo dei momenti, la nostra approssimazione dell’integrale è:
Dove
sono valori simulati da una distribuzione uniforme.
Esempio 1: Approssimazione di un integrale esponenziale
1) Data una funzione $f(x)= e^{x}$, l’integrale nell’intervallo [3,5] è:
L’approssimazione Monte Carlo dell’integrale è:
# Declaring the desired function
f =function(x){return(exp(x))}# Declaring the absolute error function
error =function(x,y){return(abs(x-y))}# The actual integral answer
ans = exp(5)-exp(3)
set.seed(6971)# number of iterations
n =10^2# simulated uniform data
x= runif(n,3,5)# MonteCarlo approximation
MCa=(5-3)*mean(f(x))# Approximation error
e = error(ans,MCa)
rest = data.frame(n = n,MCapprox = MCa,error = e)
set.seed(6971)for(k in3:6){
n =10^k
x = runif(n,3,5)
mca =(5-3)*mean(f(x))
rest = rbind(rest,c(n,mca,error(ans,mca)))}
kable(rest,digits =5,align ='c',caption ="Integral Monte Carlo approximation results",
col.names =c("Number of simulations","Monte Carlo approximation","Error approximation"))Offerto da
Approssimazione Monte Carlo generalizzata
In un caso generale, l’approssimazione dell’integrale per una data distribuzione f è:
Un algoritmo per la costruzione di $\widehat{I}$ può essere descritto dai seguenti passaggi:
1) Genera da una distribuzione f
2) Calcola:
3) Ottieni la media campionaria: $$\overline{I} = \dfrac{1}{n}\sum_{k=1}^{n}\dfrac{g(\theta_k)}{f(\theta_k)}$$
Nel prossimo blocco è presentata la funzione di semplice approssimazione Monte Carlo per mostrare come funziona l’algoritmo, dove a e b sono i parametri della densità uniforme, n il numero di simulazioni desiderate e f è la funzione che vogliamo integrare.
# The simple Monte Carlo function
MCaf =function(n,a,b,f){
x = runif(n,a,b)
MCa =(b-a)*mean(f(x))
return(MCa)}Offerto da
Metodi Monte Carlo nell’analisi bayesiana dei dati
L’idea principale dell’analisi bayesiana dei dati è adattare un modello ( come una regressione o un modello di serie temporali ) usando l’approccio dell’inferenza bayesiana. Supponiamo che i nostri parametri di interesse abbiano una distribuzione teorica; questa distribuzione (posteriori) viene aggiornata usando la distribuzione dei dati osservati (verosimiglianza) e le informazioni precedenti o esterne sui parametri (distribuzione a priori) tramite il teorema di Bayes.
Il principale problema dell’approccio bayesiano è stimare la distribuzione a posteriori. I metodi Markov Chain Monte Carlo (MCMC) generano un campione della distribuzione a posteriori e approssimano valori attesi, probabilità o quantili usando metodi Monte Carlo.
Nelle prossime due sezioni forniamo due esempi per approssimare probabilità e quantili di una distribuzione teorica. Le procedure presentate sono le metodologie usuali impiegate in un approccio bayesiano.
Esempio 2: Approssimazione di probabilità di una distribuzione gamma
Supponiamo di voler calcolare la probabilità che una variabile casuale $\theta$ sia tra zero e 5, $P(0 < \theta < 5)$, dove $\theta$ ha distribuzione gamma con parametri a = 2 e b = 1/3 ($\theta \sim Gamma(a = 2,b = 1/3)$); quindi la probabilità è:
Dove $I_{[0,5]}(\theta) = 1$ se $\theta$ appartiene all’intervallo [0,5]. L’idea dell’approssimazione Monte Carlo è contare il numero di osservazioni che appartengono all’intervallo [0,5] e dividerlo per il totale dei dati simulati.
set.seed(6972)# number of iterations
n =10^2# simulated uniform data
x= rgamma(n,shape =2,1/3)# MonteCarlo approximation
MCa= mean(x <=5)# Approximation error
e = error(pgamma(5,2,1/3),MCa)
rest = data.frame(n = n,MCapprox = MCa,error = e)for(k in3:6){
n =10^k
x= rgamma(n,shape =2,1/3)
mca= mean(x <=5)
rest = rbind(rest,c(n,mca,error(pgamma(5,2,1/3),mca)))}
kable(rest,digits =5,align ='c',caption ="Probability Monte Carlo approximation results",
col.names =c("Number of simulations","Monte Carlo approximation","Error approximation"))Offerto da
Esempio 3: Approssimazione di un quantile di una distribuzione normale
Supponiamo di voler calcolare il quantile 0,95 di una variabile casuale $\theta$ con distribuzione normale di parametri $\mu = 20$ e $\sigma = 3$ ($\theta \sim normal(\mu = 20,\sigma^{2} = 9)$); il quantile 0,95 è quindi:
L’idea principale è trovare il valore campionario più grande che dia una probabilità uguale o inferiore a 0,95; l’approssimazione Monte Carlo del quantile si stima usando la funzione quantile() sui dati simulati.
set.seed(6973)# number of iterations
n =10^2# simulated uniform data
x= rnorm(n,20,3)# MonteCarlo approximation
MCa= quantile(x,0.95)# Approximation error
e = error(qnorm(0.95,20,3),MCa)
rest = data.frame(n = n,MCapprox = MCa,error = e)for(k in3:6){
n =10^k
x= rnorm(n,20,3)
mca= quantile(x,0.95)
rest = rbind(rest,c(n,mca,error(qnorm(0.95,20,3),mca)))}
kable(rest,digits =5,align ='c',caption ="Quantile Monte Carlo approximation results",
col.names =c("Number of simulations","Monte Carlo approximation","Error approximation"),row.names =FALSE)Offerto da
Discussioni e conclusioni
I metodi di approssimazione Monte Carlo offrono uno strumento alternativo per l’approssimazione di integrali e sono fondamentali nell’approccio dell’inferenza bayesiana, soprattutto quando si lavora con modelli sofisticati e complessi. Come si vede in tutti e tre gli esempi, i metodi Monte Carlo forniscono un’ottima approssimazione, ma richiedono un numero enorme di simulazioni per ottenere un errore di approssimazione vicino a zero.
Riferimenti
1) Introducing Monte Carlo methods with R, Springer 2004, Christian P. Robert and George Casella.
2) Handbook of Markov Chain Monte Carlo, Chapman and Hall, Steve Brooks, Andrew Gelman, Galin L. Jones, and Xiao-Li Meng.
3) Introduction to mathematical Statistics, Pearson, Robert V. Hogg, Joseph W. Mckean, and Allen T. Craig.
4) Statistical Inference An Integrated Approach, Chapman and Hall, Helio S. Migon, Dani Gamerman, Francisco Louzada.
Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.



 Abid Ali Awan · 15 min


 Tim Lu · 12 min
Introduzione
Due grandi classi di problemi numerici che sorgono nelle procedure di analisi dei dati sono i problemi di ottimizzazione e di integrazione. Non è sempre possibile calcolare analiticamente gli stimatori associati a un dato modello, e spesso siamo portati a considerare soluzioni numeriche. Un modo per aggirare il problema è usare la simulazione. La stima Monte Carlo consiste nel simulare estrazioni ipotetiche da una distribuzione di probabilità, per calcolare quantità rilevanti di quella distribuzione.
L’idea di base di Monte Carlo consiste nello scrivere l’integrale come un valore atteso rispetto a una certa distribuzione di probabilità, per poi approssimarlo usando il metodo dei momenti ($E[g(X)] \approx \overline{g(X)} = \dfrac{1}{n}\sum g(X_{i})$).
Se abbiamo una funzione continua $g(\theta)$ e vogliamo integrarla nell’intervallo (a,b), possiamo riscrivere il nostro integrale come valore atteso di una distribuzione uniforme $U \sim U[a,b]$, cioè:
Usando il metodo dei momenti, la nostra approssimazione dell’integrale è:
Dove
sono valori simulati da una distribuzione uniforme.
Esempio 1: Approssimazione di un integrale esponenziale
1) Data una funzione $f(x)= e^{x}$, l’integrale nell’intervallo [3,5] è:
L’approssimazione Monte Carlo dell’integrale è:
Approssimazione Monte Carlo generalizzata
In un caso generale, l’approssimazione dell’integrale per una data distribuzione f è:
Un algoritmo per la costruzione di $\widehat{I}$ può essere descritto dai seguenti passaggi:
1) Genera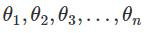 da una distribuzione f
2) Calcola: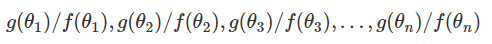
3) Ottieni la media campionaria: $$\overline{I} = \dfrac{1}{n}\sum_{k=1}^{n}\dfrac{g(\theta_k)}{f(\theta_k)}$$
Nel prossimo blocco è presentata la funzione di semplice approssimazione Monte Carlo per mostrare come funziona l’algoritmo, dove a e b sono i parametri della densità uniforme, n il numero di simulazioni desiderate e f è la funzione che vogliamo integrare.
Metodi Monte Carlo nell’analisi bayesiana dei dati
L’idea principale dell’analisi bayesiana dei dati è adattare un modello ( come una regressione o un modello di serie temporali ) usando l’approccio dell’inferenza bayesiana. Supponiamo che i nostri parametri di interesse abbiano una distribuzione teorica; questa distribuzione (posteriori) viene aggiornata usando la distribuzione dei dati osservati (verosimiglianza) e le informazioni precedenti o esterne sui parametri (distribuzione a priori) tramite il teorema di Bayes.
$$p(\theta / X) \text{ } \alpha\text{ } p(X/\theta)p(\theta)$$ Dove:
$p(\theta/X)$ è la distribuzione a posteriori del parametro
$p(X/\theta)$ è la distribuzione campionaria dei dati osservati ( verosimiglianza ).
$p(\theta)$ è la distribuzione a priori del parametro.
Il principale problema dell’approccio bayesiano è stimare la distribuzione a posteriori. I metodi Markov Chain Monte Carlo (MCMC) generano un campione della distribuzione a posteriori e approssimano valori attesi, probabilità o quantili usando metodi Monte Carlo.
Nelle prossime due sezioni forniamo due esempi per approssimare probabilità e quantili di una distribuzione teorica. Le procedure presentate sono le metodologie usuali impiegate in un approccio bayesiano.
Esempio 2: Approssimazione di probabilità di una distribuzione gamma
Supponiamo di voler calcolare la probabilità che una variabile casuale $\theta$ sia tra zero e 5, $P(0 < \theta < 5)$, dove $\theta$ ha distribuzione gamma con parametri a = 2 e b = 1/3 ($\theta \sim Gamma(a = 2,b = 1/3)$); quindi la probabilità è:
Dove $I_{[0,5]}(\theta) = 1$ se $\theta$ appartiene all’intervallo [0,5]. L’idea dell’approssimazione Monte Carlo è contare il numero di osservazioni che appartengono all’intervallo [0,5] e dividerlo per il totale dei dati simulati.
Esempio 3: Approssimazione di un quantile di una distribuzione normale
Supponiamo di voler calcolare il quantile 0,95 di una variabile casuale $\theta$ con distribuzione normale di parametri $\mu = 20$ e $\sigma = 3$ ($\theta \sim normal(\mu = 20,\sigma^{2} = 9)$); il quantile 0,95 è quindi:
L’idea principale è trovare il valore campionario più grande che dia una probabilità uguale o inferiore a 0,95; l’approssimazione Monte Carlo del quantile si stima usando la funzione quantile() sui dati simulati.
Discussioni e conclusioni
I metodi di approssimazione Monte Carlo offrono uno strumento alternativo per l’approssimazione di integrali e sono fondamentali nell’approccio dell’inferenza bayesiana, soprattutto quando si lavora con modelli sofisticati e complessi. Come si vede in tutti e tre gli esempi, i metodi Monte Carlo forniscono un’ottima approssimazione, ma richiedono un numero enorme di simulazioni per ottenere un errore di approssimazione vicino a zero.
Riferimenti
1) Introducing Monte Carlo methods with R, Springer 2004, Christian P. Robert and George Casella.
2) Handbook of Markov Chain Monte Carlo, Chapman and Hall, Steve Brooks, Andrew Gelman, Galin L. Jones, and Xiao-Li Meng.
3) Introduction to mathematical Statistics, Pearson, Robert V. Hogg, Joseph W. Mckean, and Allen T. Craig.
4) Statistical Inference An Integrated Approach, Chapman and Hall, Helio S. Migon, Dani Gamerman, Francisco Louzada.