
परिचय
डेटा विश्लेषण प्रक्रियाओं में उत्पन्न होने वाली संख्यात्मक समस्याओं की दो प्रमुख श्रेणियाँ अनुकूलन (ऑप्टिमाइज़ेशन) और समाकलन (इंटीग्रेशन) हैं। किसी दिए गए मॉडल से जुड़े प्राक्कलकों (एस्टिमेटर्स) की विश्लेषणात्मक गणना हमेशा संभव नहीं होती, और हमें अक्सर संख्यात्मक समाधान अपनाने पड़ते हैं। इस समस्या से बचने का एक तरीका सिमुलेशन का उपयोग करना है। मोंटे कार्लो प्राक्कलन का मतलब है किसी प्रायिकता वितरण से काल्पनिक ड्रॉ का सिमुलेशन करना, ताकि उस वितरण की महत्त्वपूर्ण मात्राएँ निकाली जा सकें।
मोंटे कार्लो का मूल विचार यह है कि समाकलन को किसी प्रायिकता वितरण के सापेक्ष अपेक्षित मान (एक्सपेक्टेड वैल्यू) के रूप में लिखा जाए, और फिर उसे मोमेंट पद्धति के प्राक्कलक से सन्निकटित किया जाए ($E[g(X)] \approx \overline{g(X)} = \dfrac{1}{n}\sum g(X_{i})$)।
यदि हमारे पास एक सतत फलन $g(\theta)$ है और हम उसे (a,b) अंतराल पर समाकलित करना चाहते हैं, तो हम अपने समाकलन को एक समान (यूनिफॉर्म) वितरण $U \sim U[a,b]$ के अपेक्षित मान के रूप में लिख सकते हैं, अर्थात:
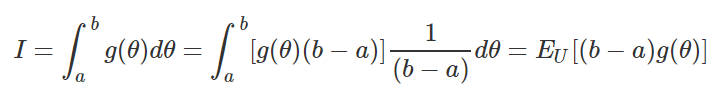
मोमेंट पद्धति के प्राक्कलक का उपयोग करते हुए हमारा समाकलन सन्निकटन होगा:
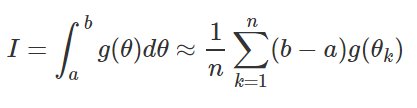
जहाँ
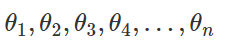
एक समान वितरण से सिमुलेट किए गए मान हैं।
उदाहरण 1: घातीय समाकलन का सन्निकटन
1) दिए गए फलन $f(x)= e^{x}$ के लिए [3,5] अंतराल पर समाकलन है:
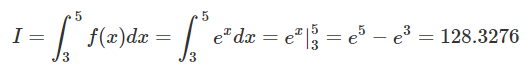
समाकलन का मोंटे कार्लो सन्निकटन:
#       Declaring the desired function
f = function(x){return(exp(x))}
#       Declaring the absolute error function
error = function(x,y){return(abs(x-y))}
#       The actual integral answer
ans = exp(5)-exp(3)

set.seed(6971)
#       number of iterations
n = 10^2
#       simulated uniform data
x= runif(n,3,5)
#       MonteCarlo approximation
MCa= (5-3)*mean(f(x))
#       Approximation error
e = error(ans,MCa)

rest =  data.frame(n = n,MCapprox = MCa,error = e)
set.seed(6971)
for(k in 3:6){
  n = 10^k
  x = runif(n,3,5)
  mca = (5-3)*mean(f(x))
  rest = rbind(rest,c(n,mca,error(ans,mca) ) )
}

kable(rest,digits = 5,align = 'c',caption = "Integral Monte Carlo approximation results",
      col.names =c("Number of simulations","Monte Carlo approximation","Error approximation"))
सामान्यीकृत मोंटे कार्लो सन्निकटन
सामान्य स्थिति में, किसी दिए गए वितरण f के लिए समाकलन का सन्निकटन:
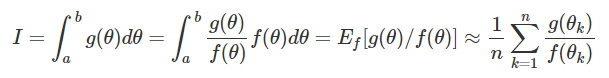
$\widehat{I}$ के निर्माण के लिए एक एल्गोरिदम निम्न चरणों में वर्णित किया जा सकता है:
1) f वितरण से 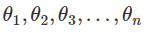 जनरेट करें
2) गणना करें: 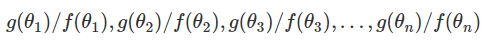
3) नमूना माध्य प्राप्त करें: $$\overline{I} = \dfrac{1}{n}\sum_{k=1}^{n}\dfrac{g(\theta_k)}{f(\theta_k)}$$
अगले भाग में, साधारण मोंटे कार्लो सन्निकटन फ़ंक्शन प्रस्तुत किया गया है ताकि एल्गोरिदम का काम करना दिखाया जा सके, जहाँ a और b एक समान घनत्व के पैरामीटर हैं, n वांछित सिमुलेशन की संख्या है, और f वह फलन है जिसका हमें समाकलन करना है।
# The simple Monte Carlo function
MCaf = function(n,a,b,f){
x = runif(n,a,b)
MCa = (b-a)*mean(f(x))
return(MCa)
}
बेज़ियन डेटा विश्लेषण में मोंटे कार्लो विधियाँ
बेज़ियन डेटा विश्लेषण का मुख्य विचार है किसी मॉडल ( जैसे प्रतिगमन या टाइम सीरीज़ मॉडल ) को बेज़ियन अनुमान पद्धति से फिट करना। हम मानते हैं कि हमारे रूचिकर पैरामीटर का एक सैद्धांतिक वितरण है; इस वितरण (पोस्टेरियर) को अवलोकित डेटा के वितरण (लाइकलीहुड) और हमारे पैरामीटर के पूर्व या बाहरी जानकारी (प्रायर वितरण) की मदद से बेयस प्रमेय द्वारा अद्यतन किया जाता है।
$$p(\theta / X) \text{ } \alpha\text{ } p(X/\theta)p(\theta)$$ जहाँ:
$p(\theta/X)$ पैरामीटर का पोस्टेरियर वितरण है
$p(X/\theta)$ अवलोकित डेटा का सैम्पलिंग वितरण है ( लाइकलीहुड ).
$p(\theta)$ पैरामीटर का प्रायर वितरण है।
बेज़ियन पद्धति में मुख्य समस्या पोस्टेरियर वितरण का आकलन करना है। मार्कोव चेइन मोंटे कार्लो विधियाँ ( mcmc ) पोस्टेरियर वितरण का एक नमूना जनरेट करती हैं और अपेक्षित मान, प्रायिकताएँ या क्वांटाइल्स का सन्निकटन मोंटे कार्लो विधियों से करती हैं।
अगले दो खंडों में, हम सैद्धांतिक वितरण की प्रायिकताओं और क्वांटाइल्स के सन्निकटन के दो उदाहरण देते हैं। उपर्युक्त प्रक्रिया बेज़ियन पद्धति में प्रचलित कार्यविधियाँ हैं।
उदाहरण 2: गामा वितरण की प्रायिकता का सन्निकटन
मान लें हम यह गणना करना चाहते हैं कि एक यादृच्छिक चर $\theta$ के शून्य और 5 के बीच होने की प्रायिकता क्या है, यानी $P(0 < \theta < 5)$, जहाँ $\theta$ का गामा वितरण है जिसके पैरामीटर a = 2 और b = 1/3 हैं ($\theta \sim Gamma(a = 2,b = 1/3)$), तो प्रायिकता है:
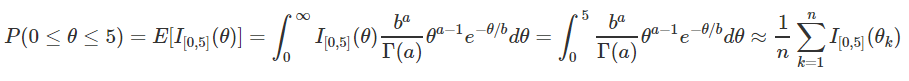
जहाँ $I_{[0,5]}(\theta) = 1$ यदि $\theta$ [0,5] अंतराल में आता है। मोंटे कार्लो सन्निकटन का विचार है कि [0,5] अंतराल में आने वाले प्रेक्षणों की संख्या गिनी जाए और उसे सिमुलेटेड डेटा की कुल संख्या से भाग दे दिया जाए।
set.seed(6972)
#       number of iterations
n = 10^2
#       simulated uniform data
x= rgamma(n,shape = 2,1/3)
#       MonteCarlo approximation
MCa= mean(x <= 5)
#       Approximation error
e = error(pgamma(5,2,1/3),MCa)

rest =  data.frame(n = n,MCapprox = MCa,error = e)

for(k in 3:6){
  n = 10^k
  x= rgamma(n,shape = 2,1/3)
  mca= mean(x <= 5)
 rest = rbind(rest,c(n,mca,error(pgamma(5,2,1/3),mca) ) )
}

kable(rest,digits = 5,align = 'c',caption = "Probability Monte Carlo approximation results",
      col.names =c("Number of simulations","Monte Carlo approximation","Error approximation"))
उदाहरण 3: सामान्य वितरण के क्वांटाइल का सन्निकटन
मान लें हम एक यादृच्छिक चर $\theta$ का 0.95 क्वांटाइल निकालना चाहते हैं, जिसका सामान्य वितरण है जहाँ $\mu = 20$ और $\sigma = 3$ हैं ($\theta \sim normal(\mu = 20,\sigma^{2} = 9)$), तो 0.95 क्वांटाइल है:
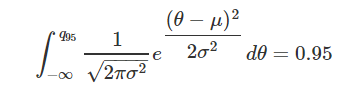
मुख्य विचार है ऐसा सबसे बड़ा नमूना मान खोजना जो 0.95 से कम या बराबर प्रायिकता देता हो; मोंटे कार्लो क्वांटाइल सन्निकटन सिमुलेटेड डेटा की quantile() फ़ंक्शन से आंका जाता है।
set.seed(6973)
#       number of iterations
n = 10^2
#       simulated uniform data
  x= rnorm(n,20,3)
#       MonteCarlo approximation
MCa= quantile(x,0.95)
#       Approximation error
e = error(qnorm(0.95,20,3),MCa)

rest =  data.frame(n = n,MCapprox = MCa,error = e)

for(k in 3:6){
  n = 10^k
  x= rnorm(n,20,3)
  mca= quantile(x,0.95)
 rest = rbind(rest,c(n,mca,error(qnorm(0.95,20,3),mca) ) )
}

kable(rest,digits = 5,align = 'c',caption = "Quantile Monte Carlo approximation results",
      col.names =c("Number of simulations","Monte Carlo approximation","Error approximation"),row.names = FALSE)
चर्चा और निष्कर्ष
मोंटे कार्लो सन्निकटन विधियाँ समाकलन के सन्निकटन के लिए एक वैकल्पिक साधन प्रदान करती हैं और बेज़ियन अनुमान पद्धति में, विशेष रूप से परिष्कृत और जटिल मॉडलों के साथ काम करते समय, अत्यंत महत्वपूर्ण उपकरण हैं। जैसा कि हमारे तीनों उदाहरणों में दिखता है, मोंटे कार्लो विधियाँ उत्कृष्ट सन्निकटन देती हैं, लेकिन शून्य के निकट सन्निकटन त्रुटि पाने के लिए बहुत बड़ी संख्या में सिमुलेशन की आवश्यकता होती है।
संदर्भ
1) Introducing Monte Carlo methods with R, Springer 2004, Christian P. Robert and George Casella.
2) Handbook of Markov Chain Monte Carlo, Chapman and Hall, Steve Brooks, Andrew Gelman, Galin L. Jones, and Xiao-Li Meng.
3) Introduction to mathematical Statistics, Pearson, Robert V. Hogg, Joseph W. Mckean, and Allen T. Craig.
4) Statistical Inference An Integrated Approach, Chapman and Hall, Helio S. Migon, Dani Gamerman, Francisco Louzada.