Introdução
Duas grandes classes de problemas numéricos que surgem em procedimentos de análise de dados são problemas de otimização e de integração. Nem sempre é possível calcular analiticamente os estimadores associados a um modelo, e muitas vezes recorremos a soluções numéricas. Uma forma de contornar isso é usar simulação. A estimação de Monte Carlo consiste em simular amostras hipotéticas de uma distribuição de probabilidade para calcular quantidades relevantes dessa distribuição.
A ideia básica de Monte Carlo consiste em escrever a integral como um valor esperado em relação a alguma distribuição de probabilidade e, em seguida, aproximá-la usando o estimador de momentos ($E[g(X)] \approx \overline{g(X)} = \dfrac{1}{n}\sum g(X_{i})$).
Se temos uma função contínua $g(\theta)$ e queremos integrá-la no intervalo (a,b), podemos reescrever nossa integral como um valor esperado de uma distribuição uniforme $U \sim U[a,b]$, ou seja:
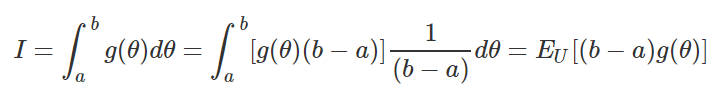
Usando o estimador de momentos, a nossa aproximação da integral é:
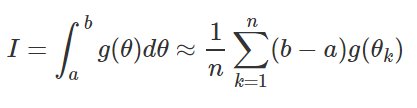
Em que os
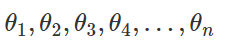
são valores simulados de uma distribuição uniforme.
Exemplo 1: aproximação de integral exponencial
1) Dada a função $f(x)= e^{x}$, a integral no intervalo [3,5] é:
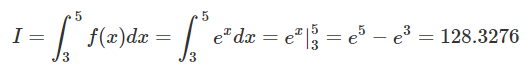
A aproximação de Monte Carlo dessa integral é:
#       Declarando a função desejada
f = function(x){return(exp(x))}
#       Declarando a função de erro absoluto
error = function(x,y){return(abs(x-y))}
#       Valor exato da integral
ans = exp(5)-exp(3)

set.seed(6971)
#       número de iterações
n = 10^2
#       dados uniformes simulados
x= runif(n,3,5)
#       Aproximação de Monte Carlo
MCa= (5-3)*mean(f(x))
#       Erro de aproximação
e = error(ans,MCa)

rest =  data.frame(n = n,MCapprox = MCa,error = e)
set.seed(6971)
for(k in 3:6){
  n = 10^k
  x = runif(n,3,5)
  mca = (5-3)*mean(f(x))
  rest = rbind(rest,c(n,mca,error(ans,mca) ) )
}

kable(rest,digits = 5,align = 'c',caption = "Resultados da aproximação de integrais por Monte Carlo",
      col.names =c("Número de simulações","Aproximação de Monte Carlo","Erro de aproximação"))
Aproximação de Monte Carlo generalizada
De forma geral, a aproximação da integral para uma distribuição f qualquer é:
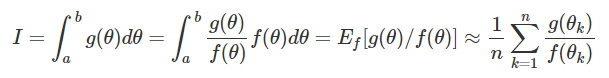
Um algoritmo para construir $\widehat{I}$ pode ser descrito pelos passos a seguir:
1) Gere 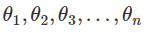 de uma distribuição f
2) Calcule: 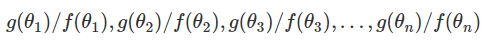
3) Obtenha a média amostral: $$\overline{I} = \dfrac{1}{n}\sum_{k=1}^{n}\dfrac{g(\theta_k)}{f(\theta_k)}$$
No próximo bloco, apresentamos a função simples de aproximação de Monte Carlo para mostrar como o algoritmo funciona, em que a e b são os parâmetros da densidade uniforme, n é o número de simulações desejadas e f é a função que queremos integrar.
# Função simples de Monte Carlo
MCaf = function(n,a,b,f){
x = runif(n,a,b)
MCa = (b-a)*mean(f(x))
return(MCa)
}
Métodos de Monte Carlo na análise bayesiana de dados
A ideia central da análise bayesiana de dados é ajustar um modelo (como regressão ou séries temporais) usando uma abordagem de inferência bayesiana. Assumimos que nossos parâmetros de interesse têm uma distribuição teórica; essa distribuição (posterior) é atualizada usando a distribuição dos dados observados (verossimilhança) e as informações prévias ou externas sobre os parâmetros (distribuição a priori) por meio do teorema de Bayes.
$$p(\theta / X) \text{ } \alpha\text{ } p(X/\theta)p(\theta)$$ Onde:
$p(\theta/X)$ é a distribuição a posteriori do parâmetro
$p(X/\theta)$ é a distribuição amostral dos dados observados (verossimilhança).
$p(\theta)$ é a distribuição a priori do parâmetro.
O principal desafio na abordagem bayesiana é estimar a distribuição a posteriori. Os métodos de Cadeias de Markov via Monte Carlo (mcmc) geram uma amostra da posterior e aproximam valores esperados, probabilidades ou quantis usando métodos de Monte Carlo.
Nas duas seções seguintes, trazemos dois exemplos para aproximar probabilidades e quantis de uma distribuição teórica. O procedimento apresentado é a metodologia usual empregada em uma abordagem bayesiana.
Exemplo 2: aproximação de probabilidade de uma distribuição gama
Suponha que queremos calcular a probabilidade de uma variável aleatória $\theta$ estar entre zero e 5, $P(0 < \theta < 5)$, onde $\theta$ tem distribuição gama com parâmetros a = 2 e b = 1/3 ($\theta \sim Gamma(a = 2,b = 1/3)$). Então, a probabilidade é:
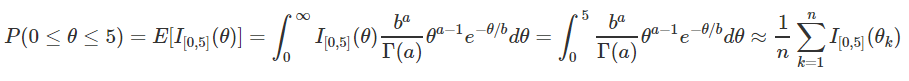
Em que $I_{[0,5]}(\theta) = 1$ se $\theta$ pertence ao intervalo [0,5]. A ideia da aproximação de Monte Carlo é contar quantas observações pertencem ao intervalo [0,5] e dividir pelo total de dados simulados.
set.seed(6972)
#       número de iterações
n = 10^2
#       dados uniformes simulados
x= rgamma(n,shape = 2,1/3)
#       Aproximação de Monte Carlo
MCa= mean(x <= 5)
#       Erro de aproximação
e = error(pgamma(5,2,1/3),MCa)

rest =  data.frame(n = n,MCapprox = MCa,error = e)

for(k in 3:6){
  n = 10^k
  x= rgamma(n,shape = 2,1/3)
  mca= mean(x <= 5)
 rest = rbind(rest,c(n,mca,error(pgamma(5,2,1/3),mca) ) )
}

kable(rest,digits = 5,align = 'c',caption = "Resultados da aproximação de probabilidade por Monte Carlo",
      col.names =c("Número de simulações","Aproximação de Monte Carlo","Erro de aproximação"))
Exemplo 3: aproximação de quantil de uma distribuição normal
Suponha que queremos calcular o quantil de 0,95 de uma variável aleatória $\theta$ que tem distribuição normal com parâmetros $\mu = 20$ e $\sigma = 3$ ($\theta \sim normal(\mu = 20,\sigma^{2} = 9)$). Assim, o quantil de 0,95 é:
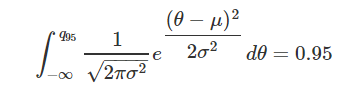
A ideia principal é encontrar o maior valor amostral que gere uma probabilidade menor ou igual a 0,95. A aproximação do quantil por Monte Carlo é estimada usando a função quantile() sobre os dados simulados.
set.seed(6973)
#       número de iterações
n = 10^2
#       dados uniformes simulados
  x= rnorm(n,20,3)
#       Aproximação de Monte Carlo
MCa= quantile(x,0.95)
#       Erro de aproximação
e = error(qnorm(0.95,20,3),MCa)

rest =  data.frame(n = n,MCapprox = MCa,error = e)

for(k in 3:6){
  n = 10^k
  x= rnorm(n,20,3)
  mca= quantile(x,0.95)
 rest = rbind(rest,c(n,mca,error(qnorm(0.95,20,3),mca) ) )
}

kable(rest,digits = 5,align = 'c',caption = "Resultados da aproximação de quantil por Monte Carlo",
      col.names =c("Número de simulações","Aproximação de Monte Carlo","Erro de aproximação"),row.names = FALSE)
Discussões e conclusões
Os métodos de aproximação de Monte Carlo oferecem uma alternativa para aproximação de integrais e são essenciais na abordagem de inferência bayesiana, especialmente quando trabalhamos com modelos sofisticados e complexos. Como vimos nos três exemplos, os métodos de Monte Carlo fornecem ótimas aproximações, mas exigem um número muito grande de simulações para que o erro de aproximação fique próximo de zero.
Referências
1) Introducing Monte Carlo methods with R, Springer 2004, Christian P. Robert and George Casella.
2) Handbook of Markov Chain Monte Carlo, Chapman and Hall, Steve Brooks, Andrew Gelman, Galin L. Jones, and Xiao-Li Meng.
3) Introduction to mathematical Statistics, Pearson, Robert V. Hogg, Joseph W. Mckean, and Allen T. Craig.
4) Statistical Inference An Integrated Approach, Chapman and Hall, Helio S. Migon, Dani Gamerman, Francisco Louzada.