Curso
Introdução ao Python
4 h
7M
A área de data science avançou como poucas. Ela reúne diversos domínios — Estatística, Álgebra Linear, Machine Learning, Bancos de Dados — e os conecta da forma mais inteligente possível. Mas, no coração disso tudo, o que torna esse campo tão fascinante? — Os poderosos algoritmos estatísticos
Um desses algoritmos clássicos é a regressão linear. Apesar de antiga, ela está longe de ser irrelevante para quem está começando em ciência de dados. Entender o princípio por trás do funcionamento da regressão linear é essencial para compreender a evolução de toda uma classe de algoritmos estatísticos chamada de Modelos Lineares Generalizados. Além disso, ajuda você a entender outros componentes típicos de algoritmos estatísticos/de machine learning, como funções de custo, coeficientes, otimização etc.
Como o título deste tutorial sugere, você vai explorar a regressão linear em detalhes. Antes de mergulhar nas teorias por trás dela, vamos clarificar o termo regressão.
Regressão pertence à classe de tarefas de aprendizado supervisionado, nas quais os conjuntos de dados usados para modelagem preditiva/estatística contêm rótulos contínuos. Vamos definir um problema de regressão de forma mais matemática.
Considere a imagem a seguir:  Fonte: notas de aula do Andrew Ng
Na imagem acima, X é o conjunto de valores que correspondem à área útil de várias casas (o espaço de entradas) e y é o preço das respectivas casas, mas repare que esses valores são previstos por h. h é a função que mapeia os valores de X em y (frequentemente chamada de preditor). Por razões históricas, essa h é chamada de função de hipótese. Observe também que este dataset tem apenas uma feature, ou seja, a área útil das casas — encare como um conjunto de brinquedo para fins didáticos.
Note que os valores previstos aqui são contínuos. Seu objetivo final é, dado um conjunto de treino, aprender uma função $h : \mathcal{X} \rightarrow \mathcal{Y}$ tal que h(x) seja um bom preditor para o valor correspondente de y. Lembre-se ainda de que os domínios de valores de X e Y são números reais, ou seja: $\mathcal{X} = \mathcal{Y} = \mathbb{IR}$, onde $\mathbb{IR}$ é o conjunto dos números reais.
Um par (x(i), y(i)) é chamado de exemplo de treino. Você pode definir o conjunto de treino como {(x(i), y(i)) ; i = 1,...,m} (caso ele contenha m instâncias e haja apenas uma feature x no dataset).
Um pouco de matemática para garantir que nada se perca, nem no básico. Segundo Han, Kamber e Pei —
"Em geral, esses métodos são usados para prever o valor de uma variável resposta (dependente) a partir de uma ou mais variáveis preditoras (independentes), quando as variáveis são numéricas." - Data Mining: Concepts and Techniques (3ª ed.)
Simples assim!
Ao entender um problema típico de regressão, você também viu como definir uma hipótese para ele. Mandou bem. Agora, vamos direto para a mecânica da regressão linear.
Antes dos detalhes, vale uma curiosidade histórica: sua origem remonta ao século XVIII. O grande Carl Friedrich Gauss propôs a forma mais elementar de regressão estatística — embora haja debates sobre isso. Se quiser ver as discussões entre Gauss e Adrien-Marie Legendre, confira aqui.
A regressão linear é um dos algoritmos mais conhecidos e compreendidos na estatística e no machine learning. Ela surgiu na estatística como um modelo para entender a relação entre variáveis numéricas de entrada e saída e, com o tempo, virou parte central do arsenal moderno de machine learning.
Vamos usar um dataset simples. Usaremos o mesmo conjunto de preços de casas, agora com duas features. A tarefa continua sendo prever o preço da casa.
 Fonte: notas de aula do Andrew Ng
Como mencionado, agora os x’s são bidimensionais, ou seja, o dataset tem duas features. Por exemplo, x1(i) é a área útil da i-ésima casa no treino e x2(i) é o número de quartos.
Para realizar a regressão, você precisa decidir como representar h. Como escolha inicial, vamos aproximar y como uma função linear de x:
Aqui, os θi são os parâmetros (ou pesos) que parametrizam o espaço das funções lineares de $\mathcal{X}$ para $\mathcal{Y}$. Em termos simples, esses parâmetros fazem o mapeamento preciso de $\mathcal{X}$ para $\mathcal{Y}$. Para simplificar, vamos omitir o subscrito em hθ(x) e escrever apenas h(x). E, para simplificar ainda mais a notação, adotaremos a convenção x0 = 1 (termo de intercepto), de modo que

onde, no lado direito, tratamos θ e x como vetores; aqui n é o número de variáveis de entrada (sem contar x0).
Mas surge a pergunta: como escolher ou aprender os parâmetros θ? Você não pode alterar as entradas para prever os preços — só pode ajustar os θ.
Uma abordagem natural é fazer h(x) ficar o mais próximo possível de y, ao menos nos exemplos de treino. Formalmente, vamos definir uma função que, para cada valor de θ, mede o quão perto os h(x(i)) estão dos respectivos y(i). Ela tem a forma:

Por que usar o erro ao quadrado em vez do valor absoluto? Em resumo, o termo ao quadrado facilita operações futuras no treinamento do modelo. Se quiser aprofundar, veja aqui.
Você acabou de ver uma das fórmulas mais importantes em Data Science/Machine Learning/Estatística: a função de custo.
Essa derivação é essencial porque, além de levar à evolução seguinte da regressão linear (Mínimos Quadrados Ordinários), ela fundamenta toda uma família de algoritmos de modelagem linear (lembra dos Modelos Lineares Generalizados?).
É importante notar que a regressão linear costuma ser dividida em duas formas básicas:
Conceitos diretos, mas que podem gerar confusão.
Você já construiu a base da regressão linear. Agora, vamos estudar maneiras de estimar os parâmetros vistos acima. Essa estimação é, essencialmente, o treinamento da regressão linear. Há vários métodos para treinar um modelo de regressão linear, sendo Mínimos Quadrados Ordinários (OLS) o mais popular. É comum referir-se ao modelo treinado com OLS como Regressão Linear por Mínimos Quadrados ou simplesmente Regressão por Mínimos Quadrados.
Nota: neste contexto, os parâmetros também são chamados de coeficientes do modelo.
Aprender/treinar um modelo de regressão linear significa estimar os valores dos coeficientes/parâmetros da representação usando os dados disponíveis.
Nesta seção, você verá rapidamente algumas técnicas para preparar um modelo de regressão linear.
Você deixou a seção anterior com a ideia de escolher θ para minimizar J(θ). Para isso, vamos usar um algoritmo de busca que parte de um "chute inicial" para θ e o ajusta iterativamente para reduzir J(θ) até, idealmente, convergir para um valor que minimize J(θ). Especificamente, considere o algoritmo de gradiente descendente, que começa com um θ inicial e repete a atualização:
 Fonte: notas de aula do Andrew Ng
(Essa atualização é realizada simultaneamente para j = 0, ..., n.) Aqui, α é a taxa de aprendizado. É um algoritmo natural que dá passos na direção de maior queda de J. Esse α controla o quão grande é o passo rumo à redução de J. Visualmente, fica assim:
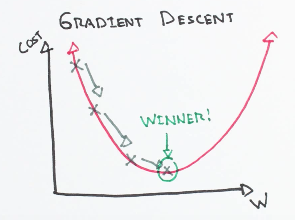 Fonte: ml-cheatsheet
Intuitivamente, a fórmula acima expressa a pequena variação em J em relação ao parâmetro θj e como isso afeta o valor inicial de θj. Há uma derivada parcial envolvida; a dedução completa foge ao escopo deste tutorial.
Para um único exemplo de treino, obtemos a seguinte regra de atualização:
 Fonte: ml-cheatsheet
Essa regra é chamada de LMS ("least mean squares") e também é conhecida como regra de aprendizado de Widrow-Hoff.
Resumindo alguns pontos no contexto de OLS:
"O procedimento de Mínimos Quadrados Ordinários busca minimizar a soma dos resíduos ao quadrado. Dada uma linha de regressão ajustada aos dados, calculamos a distância de cada ponto até a linha, elevamos ao quadrado e somamos todos os erros quadráticos. É essa quantidade que o OLS procura minimizar." - Jason Brownlee
Na regra de treinamento anterior, você já viu como incorporar o gradiente descendente aqui. Essencialmente, é um processo de otimização dos coeficientes minimizando iterativamente o erro do modelo nos dados de treino.
Em resumo, começa-se com valores aleatórios para cada coeficiente. Calcula-se a soma dos erros ao quadrado para cada par de entrada e saída. Usa-se uma taxa de aprendizado como fator de escala e atualizam-se os coeficientes na direção que minimiza o erro. O processo se repete até atingir um erro mínimo ou não haver mais melhoria.
O termo α (taxa de aprendizado) é crucial, pois determina o tamanho do passo de melhoria em cada iteração.
Há duas variantes comuns do gradiente descendente:
É isso sobre gradiente descendente por aqui. Agora, vamos ver outra forma de otimizar um modelo de regressão linear: regularização.
A DataCamp já tem um bom artigo introdutório sobre regularização. Vale conferir antes de seguir.
Em geral, métodos de regularização penalizam coeficientes de features com valores extremamente altos e, assim, reduzem o erro. Isso não só melhora a taxa de erro, como também reduz a complexidade do modelo. É especialmente útil quando você tem um dataset com muitas features e seu modelo base não consegue diferenciar bem a importância entre elas (nem todas as features são igualmente importantes, certo?).
Há duas variantes de regularização para regressão linear:
Lasso Regression: adiciona um termo de penalização equivalente ao valor absoluto da magnitude dos coeficientes (também chamada de regularização L1). O termo de penalização é: 
onde:
Ridge Regression: adiciona um termo de penalização equivalente ao quadrado da magnitude dos coeficientes (também chamada de regularização L2). O termo de penalização é: 
E como! Você viu como a regressão linear apresenta, de forma elegante, conceitos críticos de machine learning como funções de custo, otimização, relações entre variáveis e muito mais. Tudo isso é vital mesmo quando você constrói uma rede neural. A aplicação muda em alguns pontos, mas os conceitos gerais permanecem. Sem entender esses fundamentos, você não consegue diagnosticar por que sua rede neural não está performando bem.
Além disso, a ideia simples de modelar relações entre variáveis deu origem a muitos conceitos e, principalmente, a uma família inteira de algoritmos — Modelos Lineares Generalizados. Para quem aspira a trabalhar com Data Science/Machine Learning/Inteligência Artificial, esse algoritmo é indispensável. Você já percebeu isso!
Agora, vamos implementar uma regressão linear simples em Python. Vai ser divertido!
Neste estudo de caso, primeiro usaremos a biblioteca Statsmodel para Python. Ela é bastante popular e oferece classes e funções para estimar diversos modelos estatísticos, conduzir testes e explorar dados. Para os dados, usaremos o famoso Boston House dataset. O poderoso scikit-learn já inclui esse dataset, então não é preciso baixá-lo separadamente.
Vamos começar importando a biblioteca statsmodels e o dataset:
import statsmodels.api as sm
from sklearn import datasets

data = datasets.load_boston()
O scikit-learn fornece uma descrição do dataset, que pode ser visualizada assim:
print (data.DESCR)
Boston House Prices dataset
===========================

Notes
------
Data Set Characteristics:

    :Number of Instances: 506

    :Number of Attributes: 13 numeric/categorical predictive

    :Median Value (attribute 14) is usually the target

    :Attribute Information (in order):
        - CRIM     per capita crime rate by town
        - ZN       proportion of residential land zoned for lots over 25,000 sq.ft.
        - INDUS    proportion of non-retail business acres per town
        - CHAS     Charles River dummy variable (= 1 if tract bounds river; 0 otherwise)
        - NOX      nitric oxides concentration (parts per 10 million)
        - RM       average number of rooms per dwelling
        - AGE      proportion of owner-occupied units built prior to 1940
        - DIS      weighted distances to five Boston employment centres
        - RAD      index of accessibility to radial highways
        - TAX      full-value property-tax rate per $10,000
        - PTRATIO  pupil-teacher ratio by town
        - B        1000(Bk - 0.63)^2 where Bk is the proportion of blacks by town
        - LSTAT    % lower status of the population
        - MEDV     Median value of owner-occupied homes in $1000's

    :Missing Attribute Values: None

    :Creator: Harrison, D. and Rubinfeld, D.L.

This is a copy of UCI ML housing dataset.
http://archive.ics.uci.edu/ml/datasets/Housing


This dataset was taken from the StatLib library which is maintained at Carnegie Mellon University.

The Boston house-price data of Harrison, D. and Rubinfeld, D.L. 'Hedonic
prices and the demand for clean air', J. Environ. Economics & Management,
vol.5, 81-102, 1978.   Used in Belsley, Kuh & Welsch, 'Regression diagnostics
...', Wiley, 1980.   N.B. Various transformations are used in the table on
pages 244-261 of the latter.

The Boston house-price data has been used in many machine learning papers that address regression
problems.

**References**

   - Belsley, Kuh & Welsch, 'Regression diagnostics: Identifying Influential Data and Sources of Collinearity', Wiley, 1980. 244-261.
   - Quinlan, R. (1993). Combining Instance-Based and Model-Based Learning. In Proceedings on the Tenth International Conference of Machine Learning, 236-243, University of Massachusetts, Amherst. Morgan Kaufmann.
   - many more! (see http://archive.ics.uci.edu/ml/datasets/Housing)
Antes de aplicar a regressão linear, precisamos preparar os dados e separar as features do rótulo. MEDV (valor mediano da casa) é o rótulo aqui. Você pode acessar as features usando o atributo feature_names.
Um pouco de pandas ajuda muito. Este cheat sheet é imperdível para revisar conceitos básicos de pandas.
# Pandas e NumPy
import numpy as np
import pandas as pd

# Definir as features
df = pd.DataFrame(data.data, columns=data.feature_names)

# Definir o target
target = pd.DataFrame(data.target, columns=["MEDV"])
Neste ponto, vale considerar alguns pontos importantes sobre regressão linear antes de aplicá-la aos dados. Poderíamos ter visto antes, mas entender esses fatores agora ajuda a dar o clique.
Mão na massa. Para simplificar, vamos começar apenas com a feature RM — número médio de quartos. Note que o Statsmodels não adiciona um termo constante (lembre o θ0) por padrão. Vamos ver primeiro sem o termo constante:
X = df["RM"]
y = target["MEDV"]

# Ajustar e gerar previsões
model = sm.OLS(y, X).fit()
predictions = model.predict(X)

# Estatísticas do modelo
model.summary()

Uau — muita informação para quem vê pela primeira vez. Vamos aos pontos mais importantes:
OLS para treinar o modelo de regressão linear. RM aumenta em 1, o valor previsto de MEDV aumenta em 3.634. Esses são os pontos essenciais por enquanto (pode ignorar o warning).
É fácil adicionar o termo constante ao modelo: use X = sm.add_constant(X) (X é o dataframe com as variáveis independentes).
X = sm.add_constant(X)

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Perceba que a adição do termo constante afeta diretamente o coeficiente. Sem o termo, o modelo passava pela origem; agora temos intercepto em -34.67. A inclinação do preditor RM também mudou de 3.634 para 9.1021 (coeficiente de RM).
Agora, vamos ajustar um modelo com mais de uma variável — adicionaremos LSTAT (percentual da população de menor status) junto com RM. O procedimento de ajuste é o mesmo:
X = df[["RM", "LSTAT"]]
y = target["MEDV"]

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Interpretando:
Este modelo tem um R² bem mais alto — 0.948, o que significa que captura 94,8% da variância da variável dependente. Agora, vamos entender a relação entre RM, LSTAT e o valor mediano das casas. Quando RM aumenta em 1, MEDV aumenta em 4.9069; quando LSTAT aumenta em 1, MEDV diminui em 0.6557. Isso indica que RM e LSTAT são estatisticamente significativas para prever (ou estimar) o valor mediano das casas.
Em bom português:
Bem mais claro, né?
Esse foi o exemplo de regressão linear simples e múltipla no Statsmodels. Como tarefa, investigue e interprete os resultados com mais features.
Em seguida, veja como implementar regressão linear com o scikit-learn. O dataset já está importado — falta importar a classe linear_model.
from sklearn import linear_model
X = df
y = target["MEDV"]

lm = linear_model.LinearRegression()
model = lm.fit(X,y)
Pronto: modelo treinado. Essa implementação do sklearn também usa OLS. Vamos fazer previsões de MEDV para as cinco primeiras amostras.
predictions = lm.predict(X)
print(predictions[0:5])
[30.00821269 25.0298606 30.5702317 28.60814055 27.94288232]
Se quiser mais detalhes (R², coeficientes etc.) do seu modelo, é fácil obter.
lm.score(X,y)
0.7406077428649427
lm.coef_
array([-1.07170557e-01,  4.63952195e-02,  2.08602395e-02,  2.68856140e+00,
       -1.77957587e+01,  3.80475246e+00,  7.51061703e-04, -1.47575880e+00,
        3.05655038e-01, -1.23293463e-02, -9.53463555e-01,  9.39251272e-03,
       -5.25466633e-01])
Mandou muito bem até aqui. Cobrir um dos algoritmos mais simples e fundamentais não é trivial, mas você conseguiu. Além de entender a regressão linear simples, você viu diversos conceitos, termos e fatores essenciais de machine learning — e ainda fez um estudo de caso em Python.
Este tutorial também pode servir de motivação para você implementar regressão linear do zero. Seguem os passos, em linhas gerais:
Algumas referências usadas na preparação deste tutorial:
Se quiser aprender mais sobre classificadores lineares, faça o curso Linear Classifiers in Python da DataCamp.
Confira também nosso tutorial sobre a equação normal para regressão linear.
Cursos de Python
Curso
Curso
Curso
Tutorial
Avinash Navlani
10 min
Tutorial
DataCamp Team
10 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Zoumana Keita
12 min
Tutorial
Moez Ali
9 min
Tutorial
Karlijn Willems
14 min




