Cours
Introduction à Python
4 h
7M
Le domaine de la data science a connu une progression fulgurante. Il réunit de nombreux champs — statistiques, algèbre linéaire, apprentissage automatique, bases de données — et les combine de la façon la plus pertinente. Mais au cœur du sujet, qu’est-ce qui rend ce domaine aussi fascinant ? — La puissance des algorithmes statistiques
Parmi eux, un des plus élémentaires est la régression linéaire. Bien qu’ancienne, elle reste incontournable pour toute personne qui débute en data science. Comprendre son principe de fonctionnement est essentiel pour saisir l’évolution d’une classe entière d’algorithmes statistiques appelés modèles linéaires généralisés (GLM). Cela vous aidera aussi à comprendre d’autres aspects typiques des algorithmes statistiques/de machine learning, par exemple les fonctions de coût, les coefficients, l’optimisation, etc.
Comme l’indique le titre, ce tutoriel vous propose une exploration détaillée de la régression linéaire. Avant de plonger dans la théorie, clarifions d’abord le terme régression.
La régression appartient à la famille des tâches d’apprentissage supervisé où les jeux de données utilisés pour la modélisation prédictive/statistique comportent des étiquettes continues. Définissons plus formellement un problème de régression.
Considérons l’image ci-dessous :  Source : notes de cours d’Andrew Ng
Dans l’image ci-dessus, X représente les surfaces habitables de différentes maisons (l’espace des variables d’entrée) et y le prix correspondant des maisons, prédit par h. h est la fonction qui associe les valeurs de X à celles de y (souvent appelée prédicteur). Pour des raisons historiques, on parle de fonction d’hypothèse. Notez que ce jeu de données ne comporte qu’une seule caractéristique : la surface habitable. Considérez-le comme un jeu de données jouet pour faciliter la compréhension.
Remarquez que les valeurs prédites sont continues. Votre objectif est donc, étant donné un ensemble d’apprentissage, d’apprendre une fonction $h : \mathcal{X} \rightarrow \mathcal{Y}$ telle que h(x) soit un « bon » prédicteur de la valeur correspondante de y. Gardez aussi à l’esprit que les domaines de X et Y sont les nombres réels, que l’on peut définir ainsi : $\mathcal{X} = \mathcal{Y} = \mathbb{IR}$, où $\mathbb{IR}$ est l’ensemble des réels.
Une paire (x(i), y(i)) est appelée un exemple d’apprentissage. On définit l’ensemble d’apprentissage comme {(x(i), y(i)) ; i = 1,...,m} (si l’ensemble contient m instances et une seule caractéristique x).
Un peu de mathématiques pour ne pas se tromper, même sur les bases. Selon Han, Kamber et Pei :
« De manière générale, ces méthodes servent à prédire la valeur d’une variable réponse (dépendante) à partir d’une ou plusieurs variables prédictives (indépendantes), lorsque les variables sont numériques. » — Data Mining: Concepts and Techniques (3e éd.)
Aussi simple que cela !
En comprenant un problème de régression typique, vous avez également vu comment définir une hypothèse. Parfait. Passons maintenant à la mécanique de la régression linéaire.
Avant d’entrer dans les détails, un bref retour historique ? On remonte au XVIIIe siècle. Le grand Carl Friedrich Gauss a proposé l’une des premières formes de régression statistique, même si le sujet prête à discussion. Si le débat entre Gauss et Adrien-Marie Legendre vous intéresse, voici un lien.
La régression linéaire est sans doute l’un des algorithmes les plus connus et les mieux compris en statistiques et en apprentissage automatique. Développée en statistique pour modéliser la relation entre variables numériques d’entrée et de sortie, elle est devenue, avec le temps, un pilier de la boîte à outils du machine learning moderne.
Reprenons un jeu de données jouet. Nous utiliserons à nouveau le jeu de prédiction des prix immobiliers, cette fois avec deux caractéristiques. La tâche est inchangée : prédire le prix d’une maison.
 Source : notes de cours d’Andrew Ng
Comme mentionné, les x sont maintenant bidimensionnels, votre jeu de données comporte donc deux caractéristiques. Par exemple, x1(i) est la surface habitable de la i-ème maison, et x2(i) est son nombre de chambres.
Pour réaliser la régression, il faut choisir la forme de h. Comme premier choix, supposons que vous approximez y par une fonction linéaire de x :
Ici, les θi sont les paramètres (ou poids) qui paramétrisent l’espace des fonctions linéaires de $\mathcal{X}$ vers $\mathcal{Y}$. En termes simples, ces paramètres servent à associer correctement $\mathcal{X}$ à $\mathcal{Y}$. Pour simplifier, nous omettrons l’indice θ dans hθ(x) et écrirons simplement h(x). Pour alléger encore la notation, nous posons x0 = 1 (le terme d’interception), de sorte que

où, dans le membre de droite, θ et x sont considérés comme des vecteurs, et n est le nombre de variables d’entrée (hors x0).
La question clé devient alors : comment choisir ou apprendre les paramètres θ ? Vous ne pouvez pas modifier vos observations d’entrée pour prédire les prix. Vous n’avez à ajuster que ces paramètres θ.
Une méthode naturelle consiste à rendre h(x) proche de y, au moins pour les exemples d’apprentissage. Pour le formaliser, définissons une fonction qui mesure, pour chaque valeur de θ, à quel point les h(x(i)) sont proches des y(i) correspondants. Cette fonction ressemble à ceci :

Pourquoi le carré plutôt que la valeur absolue ? Le terme au carré facilite les opérations ultérieures pour l’entraînement du modèle de régression. Pour aller plus loin, voir cette discussion.
Vous venez de voir l’une des formules les plus importantes en data science/machine learning/statistiques : la fonction de coût.
C’est une étape essentielle : elle mène non seulement à l’estimateur des moindres carrés ordinaires (Ordinary Least Squares, OLS), mais jette aussi les bases d’une famille entière d’algorithmes de modélisation linéaire (rappelez-vous les modèles linéaires généralisés).
On distingue souvent deux formes de régression linéaire :
Ces distinctions sont simples mais prêtent parfois à confusion.
Vous avez désormais les bases. Étudions maintenant les méthodes d’estimation des paramètres vus ci-dessus. Cette estimation correspond à l’entraînement du modèle. Plusieurs méthodes existent, dont la plus populaire est Ordinary Least Squares (OLS). Un modèle de régression linéaire entraîné par OLS est souvent appelé régression aux moindres carrés (ordinaires).
Notez que, dans ce contexte, les paramètres sont aussi appelés coefficients du modèle.
Apprendre/entraîner une régression linéaire consiste à estimer les valeurs des coefficients/paramètres de la représentation à partir de vos données.
Dans cette section, passons en revue quelques techniques d’entraînement d’un modèle de régression linéaire.
Vous avez quitté la section précédente avec l’idée de choisir θ pour minimiser J(θ). Pour cela, utilisons un algorithme de recherche qui part d’une « valeur initiale » de θ et qui la modifie itérativement pour diminuer J(θ), jusqu’à converger vers une valeur minimisant J(θ). Considérons en particulier l’algorithme de descente de gradient, qui part d’un θ initial, puis applique itérativement la mise à jour :
 Source : notes de cours d’Andrew Ng
(Cette mise à jour est effectuée simultanément pour j = 0, …, n.) Ici, α est le taux d’apprentissage. Cet algorithme procède naturellement par petits pas dans la direction de la plus forte décroissance de J. Le terme α contrôle effectivement l’ampleur de chaque pas. Schématiquement :
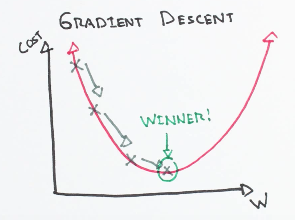 Source : ml-cheatsheet
Intuitivement, la formule ci-dessus représente la petite variation de J par rapport au paramètre θj et son effet sur la valeur initiale de θj. Notez la présence d’une dérivée partielle. La dérivation complète dépasse le cadre de ce tutoriel.
Pour un seul exemple d’apprentissage, on obtient la règle de mise à jour :
 Source : ml-cheatsheet
On l’appelle la règle LMS (« least mean squares ») ou règle d’apprentissage de Widrow-Hoff.
Résumons quelques points dans le contexte d’OLS.
« La méthode des moindres carrés ordinaires vise à minimiser la somme des résidus au carré. Concrètement, pour une droite de régression ajustée aux données, on calcule la distance de chaque point à la droite, on l’élève au carré, puis on somme toutes ces erreurs au carré. C’est cette quantité qu’OLS cherche à minimiser. » — Jason Brownlee
Avec la règle d’entraînement précédente, vous avez déjà entrevu comment intégrer la descente de gradient. Essentiellement, elle optimise itérativement les coefficients en minimisant l’erreur du modèle sur les données d’apprentissage.
Plus concrètement, on démarre avec des valeurs aléatoires pour chaque coefficient. On calcule la somme des erreurs au carré pour chaque paire entrée/sortie. Un taux d’apprentissage sert de facteur d’échelle et l’on met à jour les coefficients dans la direction qui réduit l’erreur. On répète jusqu’à atteindre un minimum de la somme des carrés ou l’absence d’amélioration.
Le terme α (taux d’apprentissage) est crucial, car il détermine l’ampleur du pas d’amélioration à chaque itération.
On distingue couramment deux variantes :
C’est tout pour la descente de gradient ici. Voyons une autre façon d’optimiser une régression linéaire : la régularisation.
DataCamp propose déjà un excellent article d’introduction à la régularisation. Jetez-y un œil avant de poursuivre.
En général, les méthodes de régularisation pénalisent les coefficients dont la valeur est très élevée afin de réduire l’erreur. Elles améliorent non seulement le taux d’erreur, mais réduisent aussi la complexité du modèle. C’est particulièrement utile lorsque vous avez un grand nombre de caractéristiques et que votre modèle de base n’arrive pas à distinguer leur importance (toutes les caractéristiques ne se valent pas, n’est-ce pas ?).
Deux variantes courantes pour la régression linéaire :
Régression Lasso : ajoute un terme de pénalité équivalent à la valeur absolue des coefficients (aussi appelée régularisation L1). Le terme de pénalité ressemble à : 
où :
Régression Ridge : ajoute un terme de pénalité équivalent au carré de la magnitude des coefficients (aussi appelée régularisation L2). Le terme de pénalité ressemble à : 
Sans hésiter. Vous avez vu à quel point la régression linéaire introduit avec élégance des notions cruciales du machine learning : fonctions de coût, optimisation, relations entre variables, etc. Ces éléments sont vitaux, même pour construire un réseau de neurones. L’applicabilité peut varier, mais les concepts clés restent identiques. Sans ces fondamentaux, vous ne saurez pas expliquer pourquoi votre réseau de neurones ne performe pas.
De plus, une simple idée — modéliser les relations entre variables — a donné naissance à de nombreux concepts et, surtout, à une famille complète d’algorithmes : les modèles linéaires généralisés. Pour toute personne souhaitant pratiquer la data science/le machine learning/l’intelligence artificielle, cet algorithme est incontournable. Vous l’avez bien compris désormais !
Passons maintenant à une mise en œuvre simple de la régression linéaire en Python. Vous allez coder !
Pour commencer, vous utiliserez la bibliothèque Statsmodel pour Python. Très populaire, elle fournit des classes et fonctions pour estimer de nombreux modèles statistiques, réaliser des tests et explorer des données. Pour les données, vous utiliserez le célèbre jeu Boston Housing. Scikit-learn l’inclut, vous n’avez donc rien à télécharger.
Commençons par importer statsmodels et le jeu de données :
import statsmodels.api as sm
from sklearn import datasets

data = datasets.load_boston()
Scikit-learn fournit une description pratique du jeu de données, que vous pouvez afficher ainsi :
print (data.DESCR)
Boston House Prices dataset
===========================

Notes
------
Data Set Characteristics:

    :Number of Instances: 506

    :Number of Attributes: 13 numeric/categorical predictive

    :Median Value (attribute 14) is usually the target

    :Attribute Information (in order):
        - CRIM     per capita crime rate by town
        - ZN       proportion of residential land zoned for lots over 25,000 sq.ft.
        - INDUS    proportion of non-retail business acres per town
        - CHAS     Charles River dummy variable (= 1 if tract bounds river; 0 otherwise)
        - NOX      nitric oxides concentration (parts per 10 million)
        - RM       average number of rooms per dwelling
        - AGE      proportion of owner-occupied units built prior to 1940
        - DIS      weighted distances to five Boston employment centres
        - RAD      index of accessibility to radial highways
        - TAX      full-value property-tax rate per $10,000
        - PTRATIO  pupil-teacher ratio by town
        - B        1000(Bk - 0.63)^2 where Bk is the proportion of blacks by town
        - LSTAT    % lower status of the population
        - MEDV     Median value of owner-occupied homes in $1000's

    :Missing Attribute Values: None

    :Creator: Harrison, D. and Rubinfeld, D.L.

This is a copy of UCI ML housing dataset.
http://archive.ics.uci.edu/ml/datasets/Housing


This dataset was taken from the StatLib library which is maintained at Carnegie Mellon University.

The Boston house-price data of Harrison, D. and Rubinfeld, D.L. 'Hedonic
prices and the demand for clean air', J. Environ. Economics & Management,
vol.5, 81-102, 1978.   Used in Belsley, Kuh & Welsch, 'Regression diagnostics
...', Wiley, 1980.   N.B. Various transformations are used in the table on
pages 244-261 of the latter.

The Boston house-price data has been used in many machine learning papers that address regression
problems.

**References**

   - Belsley, Kuh & Welsch, 'Regression diagnostics: Identifying Influential Data and Sources of Collinearity', Wiley, 1980. 244-261.
   - Quinlan, R. (1993). Combining Instance-Based and Model-Based Learning. In Proceedings on the Tenth International Conference of Machine Learning, 236-243, University of Massachusetts, Amherst. Morgan Kaufmann.
   - many more! (see http://archive.ics.uci.edu/ml/datasets/Housing)
Avant d’appliquer une régression linéaire, préparez les données et séparez les caractéristiques de la cible. Ici, MEDV (valeur médiane) est la cible. Vous pouvez accéder aux caractéristiques via l’attribut feature_names.
Un peu de pandas sera utile. Cette fiche mémo est incontournable pour réviser les bases.
# Import de Pandas et NumPy
import numpy as np
import pandas as pd

# Définir les caractéristiques
df = pd.DataFrame(data.data, columns=data.feature_names)

# Définir la cible
target = pd.DataFrame(data.target, columns=["MEDV"])
À ce stade, gardez à l’esprit quelques points importants avant d’appliquer la régression linéaire. Les aborder maintenant vous donnera une meilleure intuition.
Passons à la pratique. Pour simplifier, ne retenons que la caractéristique RM — nombre moyen de pièces. Notez que Statsmodels n’ajoute pas de constante (rappelez θ0) par défaut. Voyons d’abord sans constante :
X = df["RM"]
y = target["MEDV"]

# Ajuster le modèle et produire des prédictions
model = sm.OLS(y, X).fit()
predictions = model.predict(X)

# Afficher les statistiques
model.summary()

Que signifie cette sortie ? Elle est volumineuse au premier abord. Parcourons les points essentiels :
OLS pour entraîner votre régression linéaire. RM augmente de 1, la valeur prédite de MEDV augmente de 3,634. Ce sont les éléments à retenir pour l’instant (vous pouvez ignorer l’avertissement).
On peut facilement ajouter un terme constant à la régression : utilisez X = sm.add_constant(X) (X est la trame contenant les variables indépendantes).
X = sm.add_constant(X)

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

On voit clairement que l’ajout de la constante impacte le coefficient. Sans constante, votre modèle passait par l’origine ; désormais, l’ordonnée à l’origine est -34,67. La pente de RM passe de 3,634 à 9,1021 (coef de RM).
Enchaînons avec un modèle à plusieurs variables — ajoutons LSTAT (pourcentage de population à statut socio-économique faible) en plus de RM. La procédure d’ajustement reste identique :
X = df[["RM", "LSTAT"]]
y = target["MEDV"]

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Interprétons :
Ce modèle présente un R² bien plus élevé — 0,948 — ce qui signifie qu’il capture 94,8 % de la variance de la variable dépendante. Examinons la relation entre RM, LSTAT et la valeur médiane. Quand RM augmente de 1, MEDV augmente de 4,9069, tandis que quand LSTAT augmente de 1, MEDV diminue de 0,6557. RM et LSTAT sont donc statistiquement significatives pour estimer la valeur médiane.
En termes simples :
Plus clair, non ?
Vous avez vu des exemples de régression linéaire simple et multiple avec Statsmodels. À vous d’explorer et d’interpréter les résultats avec d’autres caractéristiques.
Voyons maintenant l’implémentation avec scikit-learn. Le jeu de données est déjà importé ; il faut importer la classe linear_model.
from sklearn import linear_model
X = df
y = target["MEDV"]

lm = linear_model.LinearRegression()
model = lm.fit(X,y)
Le modèle est entraîné. Cette implémentation sklearn utilise aussi OLS. Produisons des prédictions de MEDV pour les cinq premiers échantillons.
predictions = lm.predict(X)
print(predictions[0:5])
[30.00821269 25.0298606 30.5702317 28.60814055 27.94288232]
Pour obtenir des détails (R², coefficients, etc.) du modèle, rien de plus simple.
lm.score(X,y)
0.7406077428649427
lm.coef_
array([-1.07170557e-01,  4.63952195e-02,  2.08602395e-02,  2.68856140e+00,
       -1.77957587e+01,  3.80475246e+00,  7.51061703e-04, -1.47575880e+00,
        3.05655038e-01, -1.23293463e-02, -9.53463555e-01,  9.39251272e-03,
       -5.25466633e-01])
Bravo ! Vous êtes allé au bout. Couvrir l’un des algorithmes les plus simples et fondamentaux n’est pas si trivial, mais vous vous en êtes bien sorti. Vous avez non seulement manipulé la régression linéaire simple, mais aussi revu des notions clés du machine learning et mené une étude de cas approfondie en Python.
Ce tutoriel peut aussi vous motiver à coder une régression linéaire from scratch. Voici les grandes étapes si vous souhaitez vous lancer :
Références utilisées pour préparer ce tutoriel :
Pour aller plus loin avec les classifieurs linéaires, suivez le cours Linear Classifiers in Python de DataCamp.
Consultez aussi notre tutoriel sur l’équation normale pour la régression linéaire.
Cours Python
Cours
Cours
Cours