Kurs
Einführung in Python
4 Std.
7M
Das Feld der Data Science hat sich rasant entwickelt. Es vereint Disziplinen wie Statistik, Lineare Algebra, Maschinelles Lernen und Datenbanken und führt sie sinnvoll zusammen. Was macht dieses Gebiet im Kern so spannend? – Leistungsstarke statistische Algorithmen
Einer der ältesten, aber grundlegenden statistischen Algorithmen ist die lineare Regression. Auch wenn sie alt ist, ist sie für angehende Data Scientists wie dich keineswegs überholt. Das Prinzip hinter der linearen Regression zu verstehen, ist entscheidend, um die Entwicklung einer ganzen Klasse statistischer Algorithmen – der Generalized Linear Models – nachzuvollziehen. Außerdem hilft es dir, typische Bausteine statistischer/ML-Algorithmen zu begreifen, zum Beispiel Kostenfunktionen, Koeffizienten, Optimierung usw.
Wie der Titel schon sagt, tauchst du in diesem Tutorial tief in die lineare Regression ein. Bevor wir in die Theorie einsteigen, klären wir zuerst, was Regression bedeutet.
Regression gehört zur Klasse des überwachten Lernens, bei der die für prädiktive/statistische Modelle verwendeten Datensätze stetige Zielwerte enthalten. Definieren wir ein Regressionsproblem etwas formaler.
Betrachte das folgende Bild:  Quelle: Vorlesungsunterlagen von Andrew Ng
Im obigen Bild ist X die Menge der Wohnflächen verschiedener Häuser (zugleich der Raum der Eingabewerte) und y der jeweilige Hauspreis, der jedoch von h vorhergesagt wird. h ist die Funktion, die X auf y abbildet (oft „Prädiktor“ genannt). Historisch wird h als Hypothesenfunktion bezeichnet. Beachte: Dieser Datensatz hat nur ein Merkmal, nämlich die Wohnfläche – als vereinfachtes Beispiel zur Veranschaulichung.
Die vorhergesagten Werte sind hier stetig. Dein Ziel ist es also, gegeben ein Trainingsset, eine Funktion $h : \mathcal{X} \rightarrow \mathcal{Y}$ zu lernen, sodass h(x) ein „guter“ Prädiktor für den zugehörigen y-Wert ist. Der Wertebereich beider, X und Y, sind reelle Zahlen, formal: $\mathcal{X} = \mathcal{Y} = \mathbb{IR}$, wobei $\mathbb{IR}$ die Menge der reellen Zahlen ist.
Ein Paar (x(i), y(i)) heißt Trainingsbeispiel. Das Trainingsset kannst du definieren als {(x(i), y(i)) ; i = 1,...,m}, falls es m Instanzen gibt und der Datensatz nur ein Merkmal x enthält.
Ein wenig Mathematik, damit auch die Basics sitzen. Nach Han, Kamber und Pei gilt:
„Im Allgemeinen werden diese Methoden verwendet, um den Wert einer Antwort- (abhängigen) Variablen aus einer oder mehreren Prädiktor- (unabhängigen) Variablen vorherzusagen, wobei die Variablen numerisch sind.“ – Data Mining: Concepts and Techniques (3. Aufl.)
So einfach ist das.
Beim Verständnis eines typischen Regressionsproblems hast du auch gleich gesehen, wie man eine Hypothese dafür definiert. Perfekter Einstieg! Jetzt schauen wir uns die Mechanik der linearen Regression an.
Bevor wir ins Detail gehen, ein kurzer Blick in die Geschichte: Das reicht bis ins 18. Jahrhundert zurück. Der große Carl Friedrich Gauss schlug eine frühe Form der statistischen Regression vor – auch wenn es darüber Diskussionen gibt. Wenn dich der Disput zwischen Gauss und Adrien-Marie Legendre interessiert, findest du hier mehr.
Die lineare Regression ist einer der bekanntesten und am besten verstandenen Algorithmen in Statistik und Machine Learning. Ursprünglich in der Statistik entwickelt, dient sie dazu, Beziehungen zwischen numerischen Eingabe- und Ausgabevariablen zu modellieren, ist aber längst ein fester Bestandteil moderner ML-Toolkits.
Nehmen wir wieder ein einfaches Beispiel. Wir verwenden erneut den Hauspreisdatensatz, diesmal mit zwei Merkmalen. Die Aufgabe bleibt: den Hauspreis vorhersagen.
 Quelle: Vorlesungsunterlagen von Andrew Ng
Wie erwähnt sind die x-Werte jetzt zweidimensional, der Datensatz hat also zwei Merkmale. Beispielsweise ist x1(i) die Wohnfläche des i-ten Hauses im Trainingsset und x2(i) die Anzahl der Schlafzimmer.
Für die Regression musst du festlegen, wie du h repräsentierst. Als erste Wahl nehmen wir an, dass y als lineare Funktion von x angenähert wird:
Hier sind die θi die Parameter (Gewichte), die den Raum der linearen Funktionen von $\mathcal{X}$ nach $\mathcal{Y}$ bestimmen. Vereinfacht gesagt, helfen diese Parameter, $\mathcal{X}$ korrekt auf $\mathcal{Y}$ abzubilden. Zur Vereinfachung lassen wir in hθ(x) den θ-Index weg und schreiben einfach h(x). Außerdem setzen wir konventionsgemäß x0 = 1 (das ist der Achsenabschnitt), sodass

wobei rechts θ und x als Vektoren betrachtet werden und n die Anzahl der Eingabemerkmale ist (ohne x0).
Die große Frage ist nun: Wie wählst oder lernst du die Parameter θ? Die Eingaben kannst du nicht ändern, um Preise vorherzusagen. Du kannst nur die θ-Parameter einstellen.
Naheliegend ist es, h(x) möglichst nah an y zu bringen, zumindest für deine Trainingsbeispiele. Definieren wir dazu eine Funktion, die für jeden Parametervektor θ misst, wie nah h(x(i)) an y(i) liegt. Sie sieht so aus:

Warum Quadrate statt Absolutbeträge? Die quadrierte Abweichung erleichtert spätere Rechenschritte beim Training. Wenn du tiefer einsteigen willst, schau hier.
Du hast gerade eine der wichtigsten Formeln in Data Science/Machine Learning/Statistik gesehen: die Kostenfunktion.
Diese Herleitung ist essenziell – sie führt nicht nur zur Methode der kleinsten Quadrate (Ordinary Least Squares), sondern bildet auch die Grundlage einer ganzen Klasse linearer Modelle (Stichwort Generalized Linear Models).
Oft unterscheidet man zwei Grundformen der linearen Regression:
Klingt simpel, führt aber leicht zu Verwechslungen.
Du hast nun das Fundament gelegt. Als Nächstes geht es um Verfahren zur Schätzung der Parameter. Diese Parameterschätzung ist das eigentliche Training der linearen Regression. Es gibt viele Methoden, am populärsten ist Ordinary Least Squares (OLS). Ein mittels OLS trainiertes Regressionsmodell nennt man dementsprechend Ordinary-Least-Squares-Regression oder kurz Least-Squares-Regression.
Merke: Die Parameter heißen in diesem Kontext auch Modellkoeffizienten.
Ein lineares Regressionsmodell zu lernen/trainieren bedeutet, die Werte der Koeffizienten/Parameter anhand der Daten zu schätzen.
In diesem Abschnitt schauen wir kurz auf einige Techniken zur Vorbereitung und Optimierung eines linearen Regressionsmodells.
Wir wollten θ so wählen, dass J(θ) minimal wird. Dazu nutzen wir einen Suchalgorithmus, der mit einem „Startwert“ für θ beginnt und θ iterativ so verändert, dass J(θ) kleiner wird – bis wir hoffentlich bei einem Minimum landen. Konkret betrachten wir den Gradientenabstieg, der mit einem initialen θ startet und wiederholt das Update ausführt:
 Quelle: Vorlesungsunterlagen von Andrew Ng
(Dieses Update wird gleichzeitig für alle j = 0, …, n ausgeführt.) Hier heißt α Lernrate. Der Algorithmus macht bei jedem Schritt einen Move in Richtung des steilsten Abfalls von J. Die Lernrate α steuert, wie groß dieser Schritt ist. Anschaulich sieht das so aus:
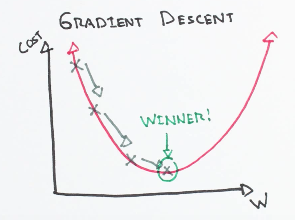 Quelle: ml-cheatsheet
Intuitiv beschreibt die Formel, wie sich J in Bezug auf den Parameter θj ändert und wie das den aktuellen Wert von θj beeinflusst. Die vollständige Ableitung sprengt hier den Rahmen.
Für ein einzelnes Trainingsbeispiel ergibt sich die folgende Aktualisierungsregel:
 Quelle: ml-cheatsheet
Diese Regel heißt LMS-Update (LMS = „least mean squares“) und ist auch als Widrow-Hoff-Lernregel bekannt.
Fassen wir OLS kurz zusammen.
„Das Ordinary-Least-Squares-Verfahren minimiert die Summe der quadrierten Residuen. Gegeben eine Regressionsgerade durch die Daten berechnen wir den Abstand jedes Punkts zur Geraden, quadrieren ihn und summieren alle quadrierten Fehler. Diese Summe wird minimiert.“ – Jason Brownlee
Oben hast du gesehen, wie der Gradientenabstieg hier eingesetzt wird. Im Kern optimiert er die Koeffizienten, indem er den Modellfehler auf den Trainingsdaten iterativ minimiert.
Kurz gesagt: Man startet mit zufälligen Koeffizienten, berechnet die Summe der quadrierten Fehler für alle Eingabe-Ausgabe-Paare, skaliert das Update mit einer Lernrate und passt die Koeffizienten in Richtung Fehlerminimum an. Das wiederholt man, bis die Fehlersumme minimal ist oder keine Verbesserung mehr eintritt.
Die Lernrate α ist dabei entscheidend, denn sie bestimmt die Schrittgröße je Iteration.
Es gibt zwei gängige Varianten des Gradientenabstiegs:
So viel zum Gradientenabstieg. Als Nächstes schauen wir auf eine weitere Optimierungsmethode: Regularisierung.
DataCamp hat bereits einen guten Einführungsartikel zur Regularisierung. Lies den gern vorab.
Im Allgemeinen bestrafen Regularisierungsmethoden Koeffizienten mit sehr großen Werten und senken so den Fehler. Das verbessert nicht nur die Fehlerrate, sondern verringert auch die Modellkomplexität. Das ist besonders hilfreich bei Datensätzen mit vielen Merkmalen, wenn das Basismodell die Wichtigkeit der Features nicht gut unterscheiden kann (nicht alle Merkmale sind gleich wichtig, oder?).
Für die lineare Regression sind zwei Varianten üblich:
Lasso-Regression: fügt einen Strafterm hinzu, der dem Absolutbetrag der Koeffizienten entspricht (auch L1-Regularisierung). Der Strafterm sieht so aus: 
wobei
Ridge-Regression: fügt einen Strafterm hinzu, der dem Quadrat der Koeffizienten entspricht (auch L2-Regularisierung). Der Strafterm sieht so aus: 
Und wie. Du hast gesehen, wie elegant die lineare Regression zentrale Konzepte des Machine Learnings einführt: Kostenfunktionen, Optimierung, Variablenbeziehungen und mehr. All das brauchst du selbst beim Bau neuronaler Netze. Die Anwendung unterscheidet sich, doch die Grundideen bleiben. Ohne diese Grundlagen wirst du nie sauber erklären können, warum dein Netzwerk nicht performt.
Außerdem hat die einfache Idee, Beziehungen zwischen Variablen herzuleiten, unzählige Konzepte hervorgebracht und vor allem eine ganze Algorithmusfamilie – die Generalized Linear Models. Für angehende Praktiker in Data Science/Machine Learning/Künstlicher Intelligenz ist dieser Algorithmus unverzichtbar. Das ist dir inzwischen klar!
Jetzt implementierst du eine einfache lineare Regression in Python. Das macht Spaß!
Zuerst verwenden wir die Bibliothek Statsmodel für Python. Sie bietet Klassen und Funktionen zur Schätzung vieler statistischer Modelle, für Tests und zur Datenexploration. Als Datensatz nutzen wir das bekannte Boston Housing Dataset. scikit-learn bringt es bereits mit – kein separater Download nötig.
Los geht’s mit dem Import von statsmodels und dem Datensatz:
import statsmodels.api as sm
from sklearn import datasets

data = datasets.load_boston()
Scikit-learn stellt eine Beschreibung des Datensatzes bereit, die du dir so anzeigen lassen kannst:
print (data.DESCR)
Boston House Prices dataset
===========================

Notes
------
Data Set Characteristics:

    :Number of Instances: 506

    :Number of Attributes: 13 numeric/categorical predictive

    :Median Value (attribute 14) is usually the target

    :Attribute Information (in order):
        - CRIM     per capita crime rate by town
        - ZN       proportion of residential land zoned for lots over 25,000 sq.ft.
        - INDUS    proportion of non-retail business acres per town
        - CHAS     Charles River dummy variable (= 1 if tract bounds river; 0 otherwise)
        - NOX      nitric oxides concentration (parts per 10 million)
        - RM       average number of rooms per dwelling
        - AGE      proportion of owner-occupied units built prior to 1940
        - DIS      weighted distances to five Boston employment centres
        - RAD      index of accessibility to radial highways
        - TAX      full-value property-tax rate per $10,000
        - PTRATIO  pupil-teacher ratio by town
        - B        1000(Bk - 0.63)^2 where Bk is the proportion of blacks by town
        - LSTAT    % lower status of the population
        - MEDV     Median value of owner-occupied homes in $1000's

    :Missing Attribute Values: None

    :Creator: Harrison, D. and Rubinfeld, D.L.

This is a copy of UCI ML housing dataset.
http://archive.ics.uci.edu/ml/datasets/Housing


This dataset was taken from the StatLib library which is maintained at Carnegie Mellon University.

The Boston house-price data of Harrison, D. and Rubinfeld, D.L. 'Hedonic
prices and the demand for clean air', J. Environ. Economics & Management,
vol.5, 81-102, 1978.   Used in Belsley, Kuh & Welsch, 'Regression diagnostics
...', Wiley, 1980.   N.B. Various transformations are used in the table on
pages 244-261 of the latter.

The Boston house-price data has been used in many machine learning papers that address regression
problems.

**References**

   - Belsley, Kuh & Welsch, 'Regression diagnostics: Identifying Influential Data and Sources of Collinearity', Wiley, 1980. 244-261.
   - Quinlan, R. (1993). Combining Instance-Based and Model-Based Learning. In Proceedings on the Tenth International Conference of Machine Learning, 236-243, University of Massachusetts, Amherst. Morgan Kaufmann.
   - many more! (see http://archive.ics.uci.edu/ml/datasets/Housing)
Bevor du die lineare Regression anwendest, bereitest du die Daten vor und trennst Features und Zielvariable. MEDV (Median der Hauswerte) ist hier das Ziel. Die Feature-Namen findest du über das Attribut feature_names.
Ein wenig pandas-Know-how hilft hier. Dieses Cheat Sheet frischt Grundlagen schnell auf.
# Pandas and NumPy import
import numpy as np
import pandas as pd

# Set the features
df = pd.DataFrame(data.data, columns=data.feature_names)

# Set the target
target = pd.DataFrame(data.target, columns=["MEDV"])
Bevor du loslegst, beachte zwei wichtige Punkte zur linearen Regression. Hier – am praktischen Beispiel – prägen sie sich am besten ein.
Jetzt zur Praxis. Zur Vereinfachung verwenden wir zunächst nur das Merkmal RM — average number of rooms. Beachte: Statsmodels fügt standardmäßig keinen konstanten Term hinzu (das war θ0). Zuerst ohne Konstante:
X = df["RM"]
y = target["MEDV"]

# Fit and make the predictions by the model
model = sm.OLS(y, X).fit()
predictions = model.predict(X)

# Print out the statistics
model.summary()

Ganz schön viel Output für den Anfang. Die wichtigsten Punkte:
OLS. RM um 1, steigt der vorhergesagte MEDV-Wert um 3.634. Das genügt fürs Erste (die Warnung kannst du ignorieren).
Einen konstanten Term kannst du leicht hinzufügen: X = sm.add_constant(X) (X ist das DataFrame mit den unabhängigen Variablen).
X = sm.add_constant(X)

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Du siehst deutlich, dass der konstante Term den Koeffizienten verändert. Ohne Konstante verlief das Modell durch den Ursprung, jetzt gibt es einen y-Achsenabschnitt bei -34.67. Die Steigung für RM hat sich entsprechend von 3.634 auf 9.1021 (coef von RM) geändert.
Als Nächstes passt du ein Modell mit mehr als einer Variablen an – du ergänzt LSTAT (Prozentsatz der Bevölkerung mit niedrigerem Status) zu RM. Das Vorgehen bleibt gleich:
X = df[["RM", "LSTAT"]]
y = target["MEDV"]

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Interpretation:
Dieses Modell hat ein deutlich höheres R-Quadrat von 0.948 – es erklärt also 94,8% der Varianz der Zielvariable. Betrachten wir die Beziehung zwischen RM, LSTAT und dem Medianpreis. Erhöht sich RM um 1, steigt MEDV um 4.9069. Erhöht sich LSTAT um 1, fällt MEDV um 0.6557. Beide Variablen sind damit statistisch signifikant für die Vorhersage des Medianpreises.
Auf gut Deutsch bedeutet das:
Klingt jetzt schlüssig, oder?
Das waren Beispiele für einfache und multiple lineare Regression mit Statsmodels. Deine Aufgabe: Untersuche weitere Features und interpretiere die Ergebnisse.
Als Nächstes siehst du die Umsetzung mit scikit-learn. Der Datensatz ist geladen, wir müssen noch die linear_model-Klasse importieren.
from sklearn import linear_model
X = df
y = target["MEDV"]

lm = linear_model.LinearRegression()
model = lm.fit(X,y)
Das Modell ist trainiert. Auch diese sklearn-Implementierung nutzt OLS. Lassen wir uns die Vorhersagen für die ersten fünf MEDV-Werte ausgeben.
predictions = lm.predict(X)
print(predictions[0:5])
[30.00821269 25.0298606 30.5702317 28.60814055 27.94288232]
Falls du weitere Details zum Modell brauchst (R-Quadrat, Koeffizienten etc.), ist das ebenfalls einfach:
lm.score(X,y)
0.7406077428649427
lm.coef_
array([-1.07170557e-01,  4.63952195e-02,  2.08602395e-02,  2.68856140e+00,
       -1.77957587e+01,  3.80475246e+00,  7.51061703e-04, -1.47575880e+00,
        3.05655038e-01, -1.23293463e-02, -9.53463555e-01,  9.39251272e-03,
       -5.25466633e-01])
Stark! Du bist bis zum Ende dabei geblieben. Einen der einfachsten und grundlegendsten Algorithmen so gründlich zu behandeln, ist nicht trivial – und du hast es sauber geschafft. Du kennst jetzt nicht nur die einfache lineare Regression, sondern auch zentrale Begriffe und Aspekte des Machine Learnings. Außerdem hast du ein ausführliches Python-Fallbeispiel umgesetzt.
Das Tutorial kann dich auch motivieren, die lineare Regression selbst „from scratch“ zu implementieren. Die groben Schritte:
Folgende Referenzen wurden für dieses Tutorial herangezogen:
Wenn du mehr über lineare Klassifikatoren lernen willst, nimm den DataCamp-Kurs Linear Classifiers in Python.
Sieh dir auch unser Tutorial zur Normalengleichung für lineare Regression an.
Python-Kurse
Kurs
Kurs
Kurs