

Configurando o Great Expectations
Neste tutorial, você vai aprender a usar o GX Core, a versão open-source do Great Expectations, para validar um DataFrame do Pandas. Vamos configurar o contexto, registrar uma fonte de dados do Pandas, definir expectations e validar lotes de dados.
Observação: recomendamos que você acompanhe pelo notebook no DataLab, mas você também pode criar seu próprio script em Python.
1. Instalando o Great Expectations
Pré-requisitos
- Python 3.9 a 3.12 instalado.
- Para evitar conflitos, é altamente recomendado instalar o Great Expectations em um ambiente virtual (disclaimer: a configuração de ambientes virtuais está fora do escopo deste artigo).
- Um conjunto de dados de exemplo.
Observação: se você usar o notebook do DataLab fornecido, esses pré-requisitos já estão atendidos. Fique à vontade para pular esta etapa.
Use o comando abaixo para instalar o GX via pip:
pip install great_expectationsEsse comando instala o pacote principal e todas as dependências necessárias.
2. Inicializando o data context
O Great Expectations precisa de um data context para gerenciar configurações. Vamos usar um data context efêmero para evitar persistir configurações.
import great_expectations as gx
# Get the Ephemeral Data Context
context = gx.get_context()
assert type(context).__name__ == "EphemeralDataContext"Criando sua primeira suíte de validação de dados
Agora que o GX está configurado, vamos criar uma suíte de validação.
1. Conectando a uma fonte de dados e criando um data asset
Uma fonte de dados conecta o Great Expectations aos seus dados, enquanto um data asset representa um subconjunto específico (por exemplo, uma tabela, DataFrame ou arquivo).
Neste caso, vamos preparar tudo para conectar a um DataFrame chamado inventory_parts_df. O dataset de exemplo está disponível no DataLab e é criado quando executamos o bloco SQL:
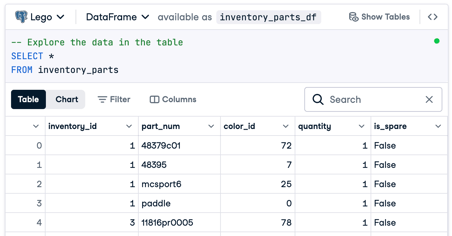
Se você não estiver usando o DataLab, crie seu próprio DataFrame com dados de exemplo.
Agora, crie sua fonte e o asset:
# Add a Pandas Data Source
data_source = context.data_sources.add_pandas(name="inventory_parts")
# Add a Data Asset to the Data Source
data_asset = data_source.add_dataframe_asset(name="inventory_parts_asset")2. Adicionando uma definição de lote
Uma definição de lote (batch definition) identifica e organiza seus dados para validação. Aqui, adicionamos uma definição que cobre o DataFrame inteiro:
# Define the Batch Definition name
batch_definition_name = "inventory_parts_batch"
# Add the Batch Definition
batch_definition = data_asset.add_batch_definition_whole_dataframe(batch_definition_name)
assert batch_definition.name == batch_definition_name3. Recuperando um lote
Um lote (batch) é um conjunto de dados atrelado a uma batch definition. Para validar, você precisa recuperar e vincular o lote ao seu DataFrame — neste caso, o inventory_parts_df:
# Define the Batch Parameters
batch_parameters = {"dataframe": inventory_parts_df}
# Retrieve the Batch
batch = batch_definition.get_batch(batch_parameters=batch_parameters)4. Criando uma suíte e definindo expectations
Expectations são regras para validar dados. Neste exemplo, vamos definir as seguintes expectativas simples:
- Garantir que os valores de
inventory_idnão sejam nulos. - Garantir que os valores de
part_numsejam únicos.
# Create an Expectation Suite
expectation_suite_name = "inventory_parts_suite"
suite = gx.ExpectationSuite(name=expectation_suite_name)
# Add Expectations
suite.add_expectation(
gx.expectations.ExpectColumnValuesToNotBeNull(column="inventory_id")
)
suite.add_expectation(
gx.expectations.ExpectColumnValuesToBeUnique(column="part_num")
)
# Add the Expectation Suite to the Context
context.suites.add(suite)Você pode explorar todas as expectations disponíveis na Expectation Gallery. Recomendamos adicionar mais algumas!
Depois de definir as expectations, o GX gera a configuração da suíte:
{
"name": "inventory_parts_suite",
"id": "b2de0b69-0869-4163-8dde-6c09884483f7",
"expectations": [
{
"type": "expect_column_values_to_not_be_null",
"kwargs": {
"column": "inventory_id"
},
"meta": {},
"id": "53d6c42a-d190-412f-a113-783b706531f4"
},
{
"type": "expect_column_values_to_be_unique",
"kwargs": {
"column": "part_num"
},
"meta": {},
"id": "362a2bdc-616d-4b3a-b7f0-c73808caee78"
}
],
"meta": {
"great_expectations_version": "1.2.4"
},
"notes": null
}A suíte inclui os seguintes detalhes:
- Nome e ID da suíte: um nome único (
inventory_parts_suite) e um identificador para rastrear e gerenciar a suíte. - Expectations: cada regra especifica:
- O tipo de checagem (por exemplo, garantir que uma coluna não tenha valores nulos ou que tenha entradas únicas).
- Parâmetros, como a coluna a ser validada.
- Metadados e um ID único para cada expectation, facilitando o rastreamento e a customização.
- Metadados: informações de versão do Great Expectations, garantindo compatibilidade com a ferramenta.
- Notas: espaço para adicionar comentários descritivos sobre a suíte (opcional).
Essa saída estruturada funciona como documentação e como uma configuração reutilizável para validar seu dataset — suas expectativas ficam bem definidas, rastreáveis e prontas para uso futuro.
5. Validando os dados
Por fim, valide o lote com as expectations definidas e avalie os resultados.
# Validate the Data Against the Suite
validation_results = batch.validate(suite)
# Evaluate the Results
print(validation_results)Após executar a validação, o Great Expectations fornece um relatório detalhado indicando se o dataset atende às expectativas definidas:
{
"success": false,
"results": [
{
"success": true,
"expectation_config": {
"type": "expect_column_values_to_not_be_null",
"kwargs": {
"batch_id": "inventory_parts-inventory_parts_asset",
"column": "inventory_id"
},
"meta": {},
"id": "53d6c42a-d190-412f-a113-783b706531f4"
},
"result": {
"element_count": 580069,
"unexpected_count": 0,
"unexpected_percent": 0.0,
"partial_unexpected_list": [],
"partial_unexpected_counts": [],
"partial_unexpected_index_list": []
},
"meta": {},
"exception_info": {
"raised_exception": false,
"exception_traceback": null,
"exception_message": null
}
},
{
"success": false,
"expectation_config": {
"type": "expect_column_values_to_be_unique",
"kwargs": {
"batch_id": "inventory_parts-inventory_parts_asset",
"column": "part_num"
},
"meta": {},
"id": "362a2bdc-616d-4b3a-b7f0-c73808caee78"
},
"result": {
"element_count": 580069,
"unexpected_count": 568352,
"unexpected_percent": 97.98006788847535,
"partial_unexpected_list": [
"48379c01",
"paddle",
"11816pr0005",
"2343",
"3003",
"30176",
"3020",
"3022",
"3023",
"30357",
"3039",
"3062b",
"3068b",
"3069b",
"3069b",
"33291",
"33291",
"3795",
"3941",
"3960"
],
"missing_count": 0,
"missing_percent": 0.0,
"unexpected_percent_total": 97.98006788847535,
"unexpected_percent_nonmissing": 97.98006788847535,
"partial_unexpected_counts": [
{
"value": "3069b",
"count": 2
},
{
"value": "33291",
"count": 2
},
{
"value": "11816pr0005",
"count": 1
},
{
"value": "2343",
"count": 1
},
{
"value": "3003",
"count": 1
},
{
"value": "30176",
"count": 1
},
{
"value": "3020",
"count": 1
},
{
"value": "3022",
"count": 1
},
{
"value": "3023",
"count": 1
},
{
"value": "30357",
"count": 1
},
{
"value": "3039",
"count": 1
},
{
"value": "3062b",
"count": 1
},
{
"value": "3068b",
"count": 1
},
{
"value": "3795",
"count": 1
},
{
"value": "3941",
"count": 1
},
{
"value": "3960",
"count": 1
},
{
"value": "48379c01",
"count": 1
},
{
"value": "paddle",
"count": 1
}
],
"partial_unexpected_index_list": [
0,
3,
4,
5,
6,
7,
8,
9,
10,
11,
12,
13,
14,
15,
16,
17,
18,
19,
20,
21
]
},
"meta": {},
"exception_info": {
"raised_exception": false,
"exception_traceback": null,
"exception_message": null
}
}
],
"suite_name": "inventory_parts_suite",
"suite_parameters": {},
"statistics": {
"evaluated_expectations": 2,
"successful_expectations": 1,
"unsuccessful_expectations": 1,
"success_percent": 50.0
},
"meta": {
"great_expectations_version": "1.2.4",
"batch_spec": {
"batch_data": "PandasDataFrame"
},
"batch_markers": {
"ge_load_time": "20241129T122532.416424Z",
"pandas_data_fingerprint": "84a1e1939091fcf54324910def3b89cd"
},
"active_batch_definition": {
"datasource_name": "inventory_parts",
"data_connector_name": "fluent",
"data_asset_name": "inventory_parts_asset",
"batch_identifiers": {
"dataframe": "<DATAFRAME>"
}
}
},
"id": null
}Esse relatório detalha a qualidade dos seus dados, destacando sucessos e falhas. Aqui vai uma explicação simplificada dos resultados:
Validação geral: o resultado foi parcialmente bem-sucedido: 50% das expectations passaram e 50% falharam. Uma expectation com falha indica um problema de qualidade que precisa de atenção. Neste caso, uma coluna não atendeu à regra definida.
Expectation 1: inventory_id não deve ter valores ausentes
- Resultado: aprovado
- Explicação: todos os valores na coluna
inventory_idestão presentes, sem nulos ou ausentes. Isso indica boa completude dos dados nessa coluna.
Expectation 2: part_num deve ter valores únicos
- Resultado: reprovado
- Explicação: a coluna
part_numcontém 97,98% de valores duplicados, ou seja, poucos valores são únicos. - Destaques:
- Exemplos de duplicados incluem "3069b" e "33291".
- A ferramenta também mostra a frequência desses duplicados e suas posições nas linhas, facilitando localizar e corrigir os problemas.
Claro, este é apenas um dataset de exemplo — incluímos de propósito uma expectation aprovada e outra reprovada para você ver os dois resultados.
É isso! Você executou validações de dados de ponta a ponta com sucesso.
Integrando o Great Expectations aos pipelines de dados
Em produção, as validações precisam estar embutidas no fluxo de trabalho para monitorar continuamente a qualidade dos dados em cada etapa.
Nesta seção, vamos falar sobre como integrar o Great Expectations aos seus pipelines de dados.
Estes são exemplos para dar uma ideia; configurações extras podem ser necessárias. Consulte a documentação de cada ferramenta para a sintaxe mais recente!
Integração com ferramentas de ETL
Integrar o Great Expectations a ferramentas populares de ETL como Apache Airflow ou Prefect é relativamente simples. Incluir etapas de validação diretamente nos processos de ETL permite detectar e corrigir problemas em tempo real, antes que afetem análises a jusante.
Vamos ver um exemplo simples de integração do Great Expectations com o Prefect para rodar validação como parte de um workflow de ETL automatizado:
from prefect import task, Flow
import great_expectations as ge
# Define a task to run Great Expectations validation
@task
def validate_data():
context = ge.data_context.DataContext()
batch_kwargs = {"path": "path/to/your/datafile.csv", "datasource": "your_datasource"}
batch = context.get_batch(batch_kwargs, suite_name="your_expectation_suite")
results = context.run_validation_operator("action_list_operator", assets_to_validate=[batch])
# Check validation results and raise an alert if validation fails
if not results["success"]:
raise ValueError("Data validation failed!")
# Define your ETL flow
with Flow("ETL_with_GE_Validation") as flow:
validation = validate_data()
# Execute the flow
flow.run()Neste exemplo, definimos um flow no Prefect com uma task para executar a validação do Great Expectations.
A função validate_data() carrega o contexto do Great Expectations, recupera o lote de dados e aplica a suíte de expectations.
Se os dados não atenderem aos critérios, a task gera um alerta e interrompe o workflow, evitando erros a jusante.
Validação contínua de dados
Você pode agendar execuções de validação com várias ferramentas, como cron em sistemas Unix ou serviços gerenciados como o Apache Airflow. Neste exemplo, vamos mostrar como agendar validações usando o Airflow, excelente para orquestrar pipelines.
Veja como configurar um DAG do Airflow (Directed Acyclic Graph) para rodar validações do Great Expectations diariamente:
from airflow import DAG
from airflow.operators.python_operator import PythonOperator
from datetime import datetime
import great_expectations as ge
# Define the DAG and set the schedule to run daily
default_args = {
'owner': 'airflow',
'start_date': datetime(2024, 1, 1),
'retries': 1,
}
dag = DAG(
'great_expectations_validation',
default_args=default_args,
schedule_interval='@daily', # Runs once a day
)
# Define the function to run the validation
def run_validation():
context = ge.data_context.DataContext()
batch = context.get_batch(batch_kwargs, suite_name="your_expectation_suite")
results = context.run_validation_operator("action_list_operator", assets_to_validate=[batch])
return results
# Set up the task in Airflow
validation_task = PythonOperator(
task_id='run_great_expectations_validation',
python_callable=run_validation,
dag=dag,
)
# Set the task in the DAG
validation_taskNeste exemplo, definimos um DAG que agenda uma execução de validação uma vez por dia (@daily).
A função run_validation() executa a validação carregando o contexto do Great Expectations e rodando a suíte de expectations definida contra os dados.
Boas práticas para validação de dados com Great Expectations
Seguir boas práticas é essencial para escalar com eficiência — e com o Great Expectations não é diferente.
Comece pequeno e evolua
Comece com checagens básicas de qualidade e amplie gradualmente. É melhor focar primeiro em expectativas fundamentais para evitar complexidade desnecessária, facilitar a integração e simplificar a solução de problemas. Conforme você entende melhor o dataset, adicione validações mais complexas.
Colabore entre times
Qualidade de dados não é só uma preocupação técnica. Colabore com áreas de negócio para definir expectations e garantir que a validação implementada esteja alinhada à lógica e aos objetivos do negócio. Essa abordagem multifuncional assegura que os dados atendam às necessidades de todas as partes interessadas.
Automatize sempre que possível
Automatize o que for viável para integrar a validação aos pipelines. Checagens automatizadas permitem monitoramento contínuo da qualidade sem intervenção manual, aumentando bastante a eficiência.
Conclusão
Mandou bem! Você aprendeu a configurar e validar dados com o Great Expectations. Essas técnicas vão ajudar a manter alta qualidade e transparência nos seus fluxos de trabalho.
Para continuar desenvolvendo suas habilidades, confira estes recursos:
- ETL and ELT in Python: aprenda a transformar e movimentar dados com eficiência.
- Introduction to Data Quality: explore os fundamentos da gestão de qualidade de dados.
- Cleaning Data in Python: domine técnicas de limpeza para garantir precisão e consistência.
- Data Quality Dimensions Cheat Sheet: um guia prático sobre dimensões de qualidade de dados.
FAQs
Como o Great Expectations se compara a outras ferramentas de validação de dados?
O Great Expectations é open-source, flexível e integra-se bem a pipelines de dados modernos. Ele se destaca pela extensa biblioteca de expectations e pela documentação robusta.
Preciso saber Python para usar o Great Expectations?
Embora conhecimentos básicos de Python ajudem, o Great Expectations oferece uma CLI amigável e documentação extensa, o que o torna acessível também para quem não programa.
Quais tipos de fontes de dados o Great Expectations suporta?
O Great Expectations é compatível com uma ampla gama de fontes de dados, incluindo:
- Bancos de dados relacionais como PostgreSQL, MySQL e SQL Server.
- Armazenamento em nuvem como AWS S3, Google Cloud Storage e Azure Blob Storage.
- Formatos de arquivo como CSV, Parquet e Excel.
- Frameworks de big data como Apache Spark e Databricks. Você pode conectar facilmente o Great Expectations a essas fontes usando a configuração apropriada para a sua datasource.
Posso usar o Great Expectations com dados em streaming?
O Great Expectations é voltado principalmente para validação em batch. Embora não ofereça suporte nativo a streaming, é possível integrá-lo a frameworks como Apache Kafka ou Spark Structured Streaming validando snapshots ou microbatches periodicamente.
É possível versionar as expectations e os resultados de validação?
Sim. Você pode versionar expectations e configurações armazenando-as como arquivos YAML ou JSON em um repositório Git. Para resultados de validação, é possível configurar um repositório em banco de dados ou em arquivos para acompanhar a evolução ao longo do tempo e integrá-los aos seus pipelines de CI/CD para monitoramento contínuo.
Como o Great Expectations lida com evolução de esquema em datasets?
O Great Expectations lida com evolução de esquema por meio de seu framework flexível de expectations. Se seu esquema mudar, você pode:
- Usar
expect_table_columns_to_match_setou expectations semelhantes para validar nomes de colunas de forma dinâmica. - Modificar ou criar novas suítes de expectations para se adaptar ao novo esquema.
- Aproveitar ferramentas de inferência de esquema para atualizar automaticamente as expectations de colunas recém-adicionadas.


Thalia Barrera é editora sênior de ciência de dados da DataCamp, com mestrado em ciência da computação e mais de uma década de experiência em engenharia de software e dados. Thalia gosta de simplificar conceitos de tecnologia para engenheiros e cientistas de dados por meio de publicações em blogs, tutoriais e cursos em vídeo.


Qualidade de dados e consistência são como a base de uma casa — sem um alicerce sólido, tudo o que vem em cima fica em risco. É aqui que a validação de dados desempenha um papel essencial. A validação ajuda você a garantir que seus dados sejam precisos, consistentes e confiáveis.
Great Expectations é uma ferramenta open-source de validação de dados que permite identificar problemas logo no início e garante que seus dados atendam aos padrões de qualidade necessários.
Neste guia, vamos mostrar passo a passo como usar Great Expectations para validar dados, com um exemplo prático de ponta a ponta para você começar!
O que é Great Expectations?
Great Expectations (GX) é um framework open-source que ficou popular para gerenciar e automatizar a validação de dados em pipelines de dados modernos.
Seu framework em Python foi feito para ajudar times de dados a garantir a qualidade e a consistência de suas informações. Os usuários podem definir "expectations" — regras ou testes que descrevem como os dados válidos devem ser — para validar automaticamente se os dados atendem a esses padrões.
Alguns benefícios do Great Expectations incluem:
Agora, vamos a um exemplo de ponta a ponta!