Curso
ETL e ELT em Python
4 h
39.5K
Dados são essenciais para empresas e organizações, e é na tarefa de organizar o fluxo dessas informações que os data pipelines brilham. Afinal, o que são data pipelines e o que você precisa saber para construir o seu?
Dados são o motor dos negócios modernos, impulsionando decisões, insights e inovação. Mas gerenciar e aproveitar esse poder pode ser complexo. É aí que entram os data pipelines. Mas, afinal, o que são data pipelines?
Um data pipeline é um sistema que busca dados de várias fontes e os direciona para um novo destino, como um banco de dados, repositório ou aplicação, realizando as transformações necessárias no caminho (converter dados de um formato ou estrutura para outro). Os usuários finais desse pipeline podem ser analistas, cientistas de dados ou líderes de negócios.
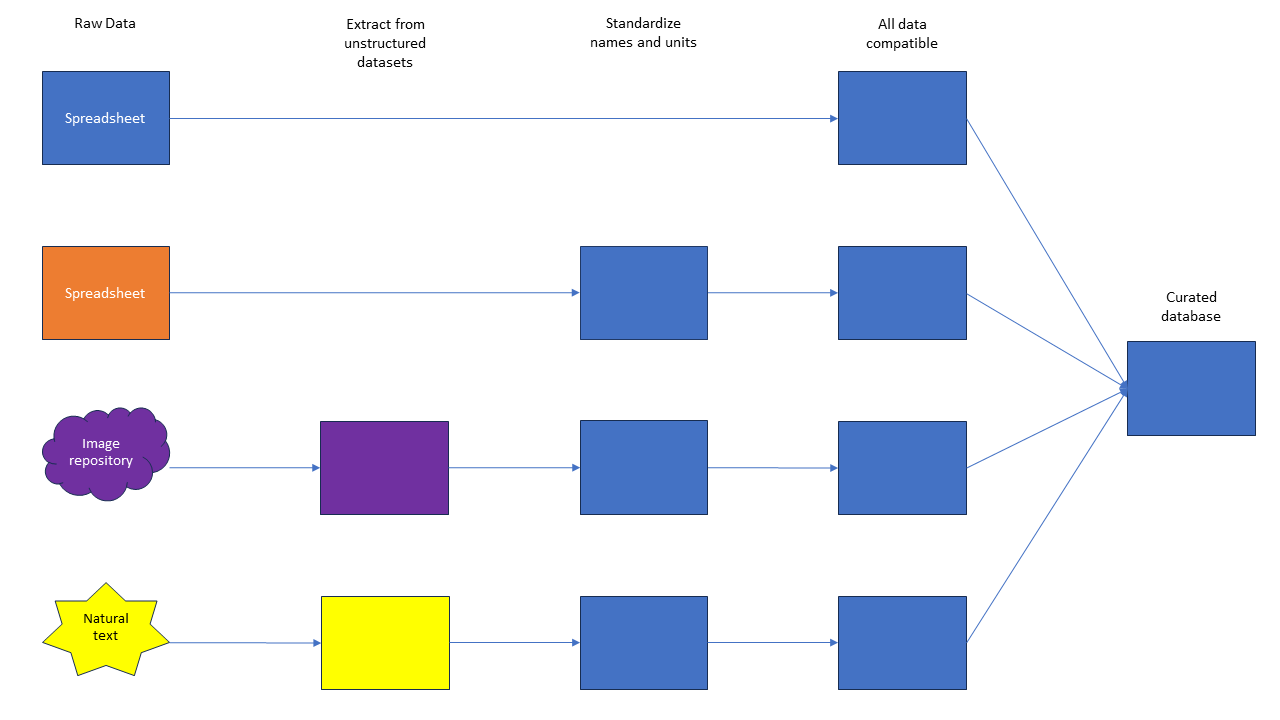
Figura 1: Exemplo de um data pipeline simples. Neste exemplo, há quatro fontes de dados: duas estruturadas e duas não estruturadas. Em uma série de etapas, você extrai dados estruturados dos conjuntos não estruturados, padroniza nomes e unidades e, quando tudo está compatível, cria um banco de dados único e curado com todas as informações necessárias. Esse banco pode então ser usado por analistas, cientistas ou líderes de negócio.
Embora pareça simples, há muitas decisões e possíveis dores de cabeça. Em várias organizações, construir e manter pipelines é um trabalho inteiro, executado por engenheiros de dados. Em outras, é apenas uma das muitas tarefas do cientista de dados. Quem mantém o pipeline depende do porte da organização, da complexidade dos pipelines e do orçamento disponível.
Construir um pipeline confiável, seguro e pontual é crucial para decisões orientadas por dados. Seja você alguém interessado em engenharia de dados ou em qualquer outra etapa do processo de dados, vale a pena entender data pipelines.
Talvez você se pergunte por que precisaria construir um pipeline. Se você tem trabalhado com conjuntos de dados prontos ou dados de uma única fonte, como os do Kaggle ou exercícios da DataCamp, provavelmente não precisou de um pipeline. Esses datasets curados já foram preparados para que analistas pudessem consumir e trabalhar diretamente.
Mas, se você quer combinar informações de várias fontes, pode ser necessário configurar um pipeline para garantir que todos os dados fiquem acessíveis para a sua análise.
Algumas razões pelas quais você pode considerar o uso de data pipelines:
Imagine que você quer saber se a média do GPA dos alunos em um distrito escolar se correlaciona com a renda média do condado ou com o tamanho da população. Para essa análise, talvez você precise buscar dados de GPA de cada distrito escolar, dados de renda do IRS e dados de população do Census Bureau.
Você até conseguiria coletar isso manualmente uma vez. Mas, se precisar repetir a análise com frequência, construir um pipeline confiável ajuda a automatizar a coleta, economizando tempo e evitando retrabalho.
Além de reunir os dados em um só lugar, pipelines ajudam a lidar com inconsistências entre fontes. Por exemplo, o Census Bureau pode identificar condados pelo nome completo, enquanto o IRS pode usar abreviações.
No pipeline, você pode padronizar como os condados são identificados no repositório final. Ou, talvez, a população esteja em unidades diferentes em cada entrada e você precise unificar as unidades no destino final. Esse tipo de ajuste são as chamadas transformações.
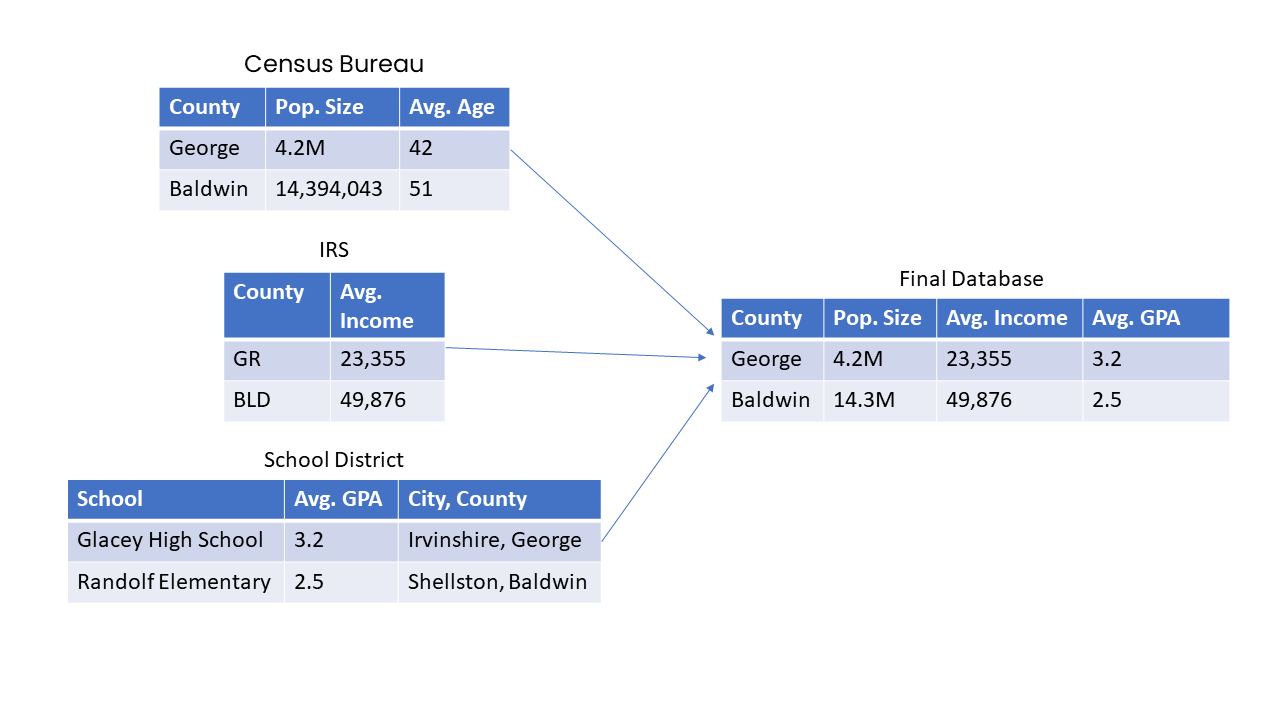
Figura 2: ao combinar informações de diferentes fontes, transformações como troca de unidades e padronização de nomes podem ser necessárias.
Geralmente, data pipelines são desenvolvidos e mantidos por engenheiros de dados.
Depois que os dados são coletados, limpos e organizados no fim do pipeline, diversos perfis podem consumi-los, como analistas de dados, cientistas de dados ou analistas de negócios.
Os dados podem ser usados em análises em tempo real, abastecer um dashboard atualizado ou alimentar um modelo de machine learning. Às vezes, o fim do pipeline é um aplicativo ou dashboard usado por um líder de negócios ou usuário final.
Pipelines são usados em praticamente todos os setores que trabalham com grandes volumes de dados. Em grandes empresas, como as de tecnologia, os pipelines tendem a ser complexos, altamente regulados e gerenciados por um time especializado.
Em organizações menores, como um(a) único(a) pesquisador(a) coletando dados de múltiplos sensores no mundo, o pipeline pode ser direto e simples, com poucas etapas. Outros exemplos incluem um corretor de ações reunindo informações financeiras para decidir compras ou um sistema hospitalar centralizando prontuários de diferentes unidades.
Pipelines também são vitais para modelos de machine learning. Esses modelos consomem enormes quantidades de dados, e um pipeline adequado é indispensável para o bom funcionamento. Este tutorial de MLOps traz mais detalhes sobre o uso de pipelines em ML.
Dados podem ser armazenados de várias formas, dependendo do tipo de dado e do uso desejado. Três termos comuns no contexto de armazenamento são data lake, banco de dados e data warehouse. Vamos ver rapidamente cada um.
Um data lake é um repositório amplo e flexível que comporta dados estruturados e não estruturados em escala. Ele permite armazenar dados brutos, não processados, de fontes diversas, como logs de web, sensores, redes sociais e mais, no formato nativo.
Data lakes são versáteis e permitem que cientistas e analistas explorem, transformem e analisem dados de várias maneiras. São valiosos em casos de big data e análises avançadas em que o esquema e a estrutura não estão definidos previamente, dando flexibilidade para extrair insights de fontes diversas.
Bancos de dados são sistemas mais gerais para armazenar, gerenciar e recuperar dados estruturados com eficiência. Embora compartilhem semelhanças com data warehouses, são usados normalmente para dados transacionais, operações do dia a dia e aplicações em tempo real. Há vários tipos, como bancos relacionais, NoSQL e in-memory, cada um adequado a requisitos específicos de armazenamento e processamento. Garantem integridade, acesso concorrente e oferecem mecanismos de consulta e recuperação.
Data warehouses são repositórios altamente estruturados e otimizados para armazenar, organizar e consultar dados estruturados com foco em análises. Seguem um esquema predefinido, impõem qualidade e consistência, e são otimizados para consultas complexas e relatórios.
São ideais para empresas que querem tomar decisões com base em dados históricos, pois fornecem uma fonte única de verdade para relatórios e análises padronizadas. Os dados são extraídos de várias fontes, transformados para um formato consistente e carregados no data warehouse para análise.
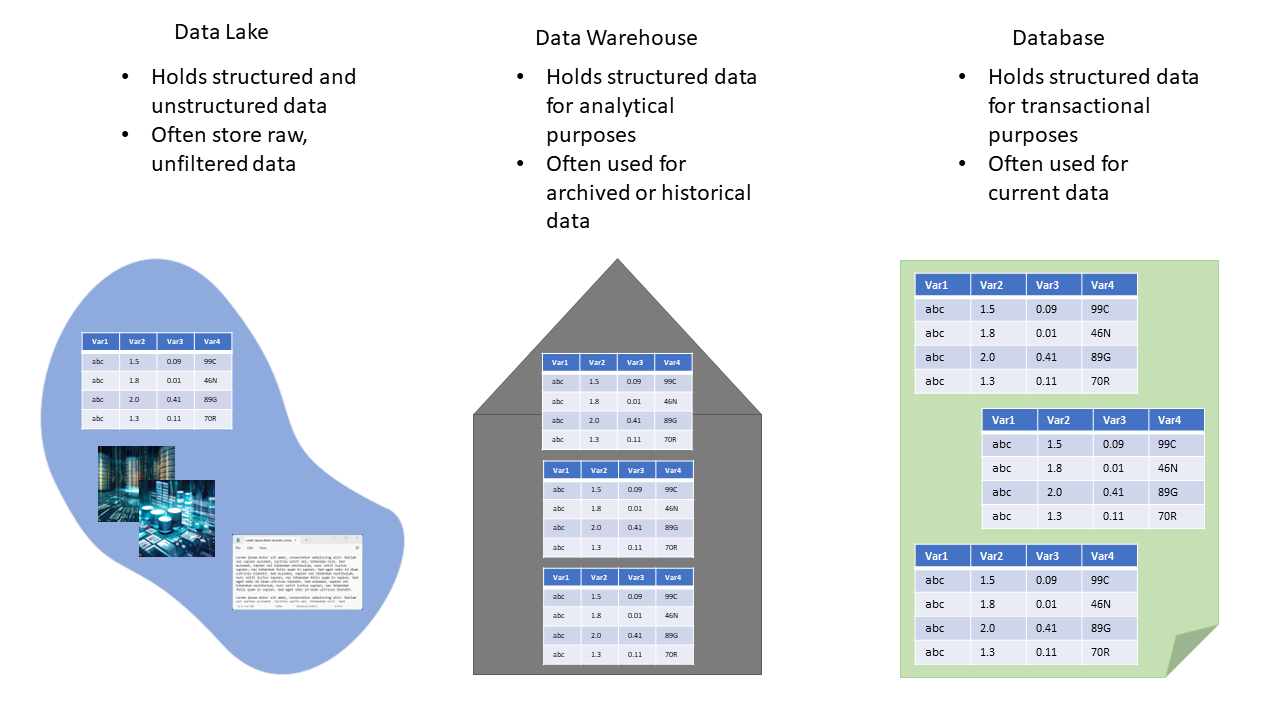
Figura 3: diferenças entre um data lake, um data warehouse e um banco de dados. Um data lake pode ser uma etapa anterior em um pipeline que termina em um warehouse ou banco de dados.
Pipelines geralmente seguem um de dois esquemas principais: ETL (Extract, Transform, Load) ou ELT (Extract, Load, Transform).
No ETL, a abordagem é sequencial. Primeiro, os dados são extraídos de vários sistemas de origem, como bancos de dados, arquivos, APIs ou outros repositórios.
Após a extração, os dados são transformados para atender ao esquema, à qualidade e às regras de negócio desejados. Isso pode envolver limpeza, agregação e estruturação. Por fim, os dados transformados são carregados no data warehouse ou sistema de armazenamento alvo, geralmente em um formato otimizado para relatórios e análises.
ETL é útil quando os dados precisam de reestruturação ou limpeza significativa antes de serem armazenados, garantindo que fiquem prontos para análise. Este curso de ETL com Python traz uma visão detalhada usando Python e SQL.
No ELT, a ordem da transformação se inverte. Os dados são extraídos das fontes e carregados como estão em um data warehouse, ou às vezes em um data lake, sem transformação prévia relevante. A transformação ocorre dentro do próprio data warehouse.
Essa abordagem aproveita o poder de processamento e a flexibilidade dos data warehouses modernos e plataformas de big data, sendo adequada quando você quer armazenar grandes volumes de dados brutos e transformar sob demanda.
ELT costuma ser preferido quando a sua solução de data warehousing lida bem com transformações complexas, como data warehouses em nuvem ou frameworks distribuídos como Hadoop.
Há muitas ferramentas para desenvolver pipelines. A escolha certa depende do tamanho do pipeline, necessidades de escala, orçamento e objetivos. Você pode montar um pipeline completo usando Python e SQL (ou R e SQL), ou recorrer a ferramentas comerciais.
Aqui vai uma lista breve de tecnologias e ferramentas comerciais comuns.
Confira nossa lista com as melhores ferramentas de ETL e por que usá-las em outro artigo.
A primeira etapa para criar um data pipeline é coletar os dados que entrarão nele. Há muitos locais para obter informações atualizadas on-line, incluindo páginas do governo, redes sociais e algumas organizações sem fins lucrativos. Muitas vezes, essas fontes oferecem uma API simples de usar.
Uma API (application programming interface) é essencialmente um software que permite a comunicação entre duas ou mais aplicações. Por exemplo, você pode incorporar a API do Twitter no seu aplicativo em Python para que ele publique ou "leia" tweets em seu nome. É um intermediário.
Você pode usar uma API no início do pipeline para coletar dados de várias fontes. Por exemplo, dá para usar uma API para buscar arquivos de empresas na SEC ou coletar dados clínicos de tabelas mantidas pelo NIH.
Outra técnica de coleta é o web scraping. Trata-se de um script personalizado para extrair informações de páginas na internet. Bibliotecas Python como BeautifulSoup e Scrapy facilitam bastante, mas você ainda precisa navegar por HTML ou XML para encontrar o que precisa.
Se quiser saber mais sobre web scraping, a DataCamp tem materiais sobre Beautiful Soup em Python, web scraping em R e web scraping para NLP.
Também existem serviços no-code para scraping. Aqui está um exemplo que permite coletar informações de páginas e monitorar mudanças.
Seu processo de coleta pode envolver uma mistura de dados estruturados (como planilhas ou bancos) e não estruturados (como textos ou imagens).
Dependendo do objetivo do seu pipeline, você pode extrair informações dos dados não estruturados para criar um conjunto uniformemente estruturado, ou manter parte deles não estruturados e apenas garantir um bom cruzamento para o usuário final.
Dados estruturados podem ser extraídos com consultas SQL ou ferramentas de ETL, enquanto dados não estruturados podem exigir técnicas de processamento de linguagem natural (NLP) ou ferramentas especializadas.
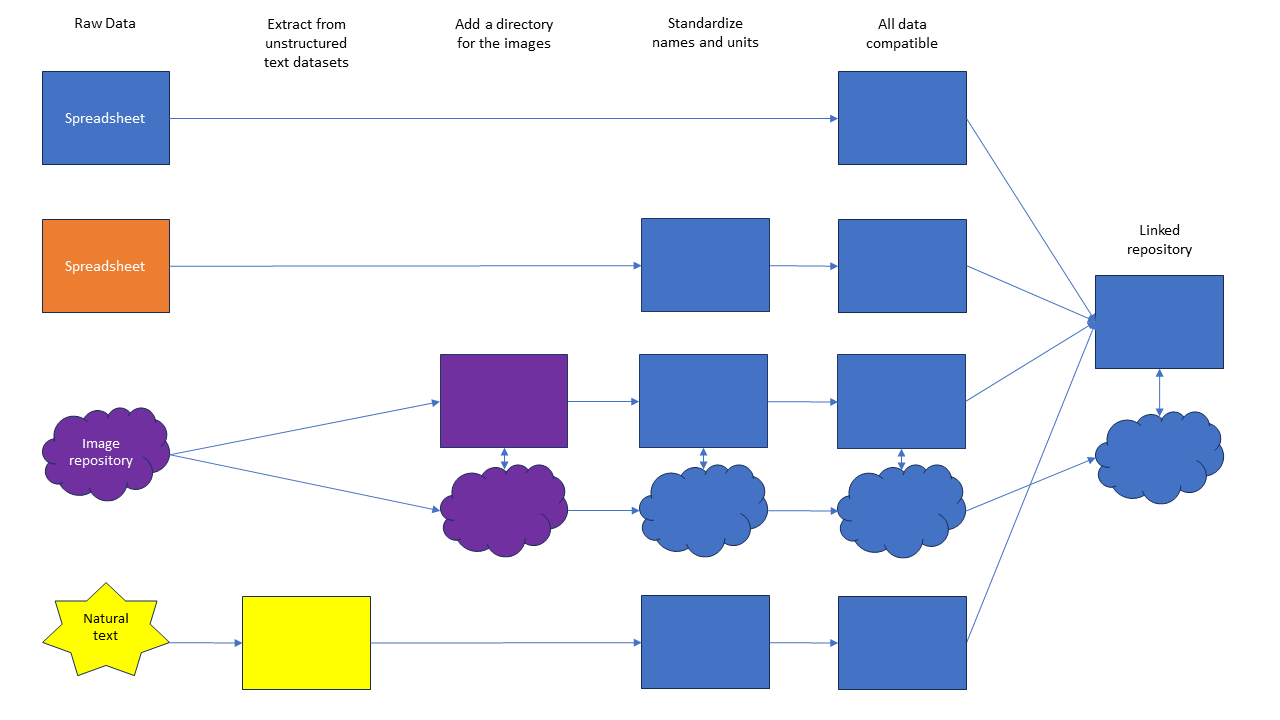
Figura 4: exemplo de data pipeline com dados não estruturados mantidos ao final. Aqui, queremos um repositório de dados estruturados curados e imagens vinculadas. Isso também poderia ser um data lake. Em vez de extrair dados estruturados das imagens, criamos um diretório que vincula as imagens aos dados relevantes no banco. O usuário final pode puxar a imagem bruta para cada linha de uma planilha, conforme necessário. Alternativamente, poderíamos ter analisado as imagens e fornecido versões com trechos isolados ou removidos. Para saber como, confira este tutorial de análise de imagens.
Depois de definir as fontes de dados e o objetivo final, você pode começar a configurar seu pipeline.
A primeira coisa é planejar. Sugiro mapear no papel. À esquerda, escreva suas fontes de dados; à direita, seu objetivo final. No meio, distribua todas as etapas necessárias para ir das fontes ao objetivo.
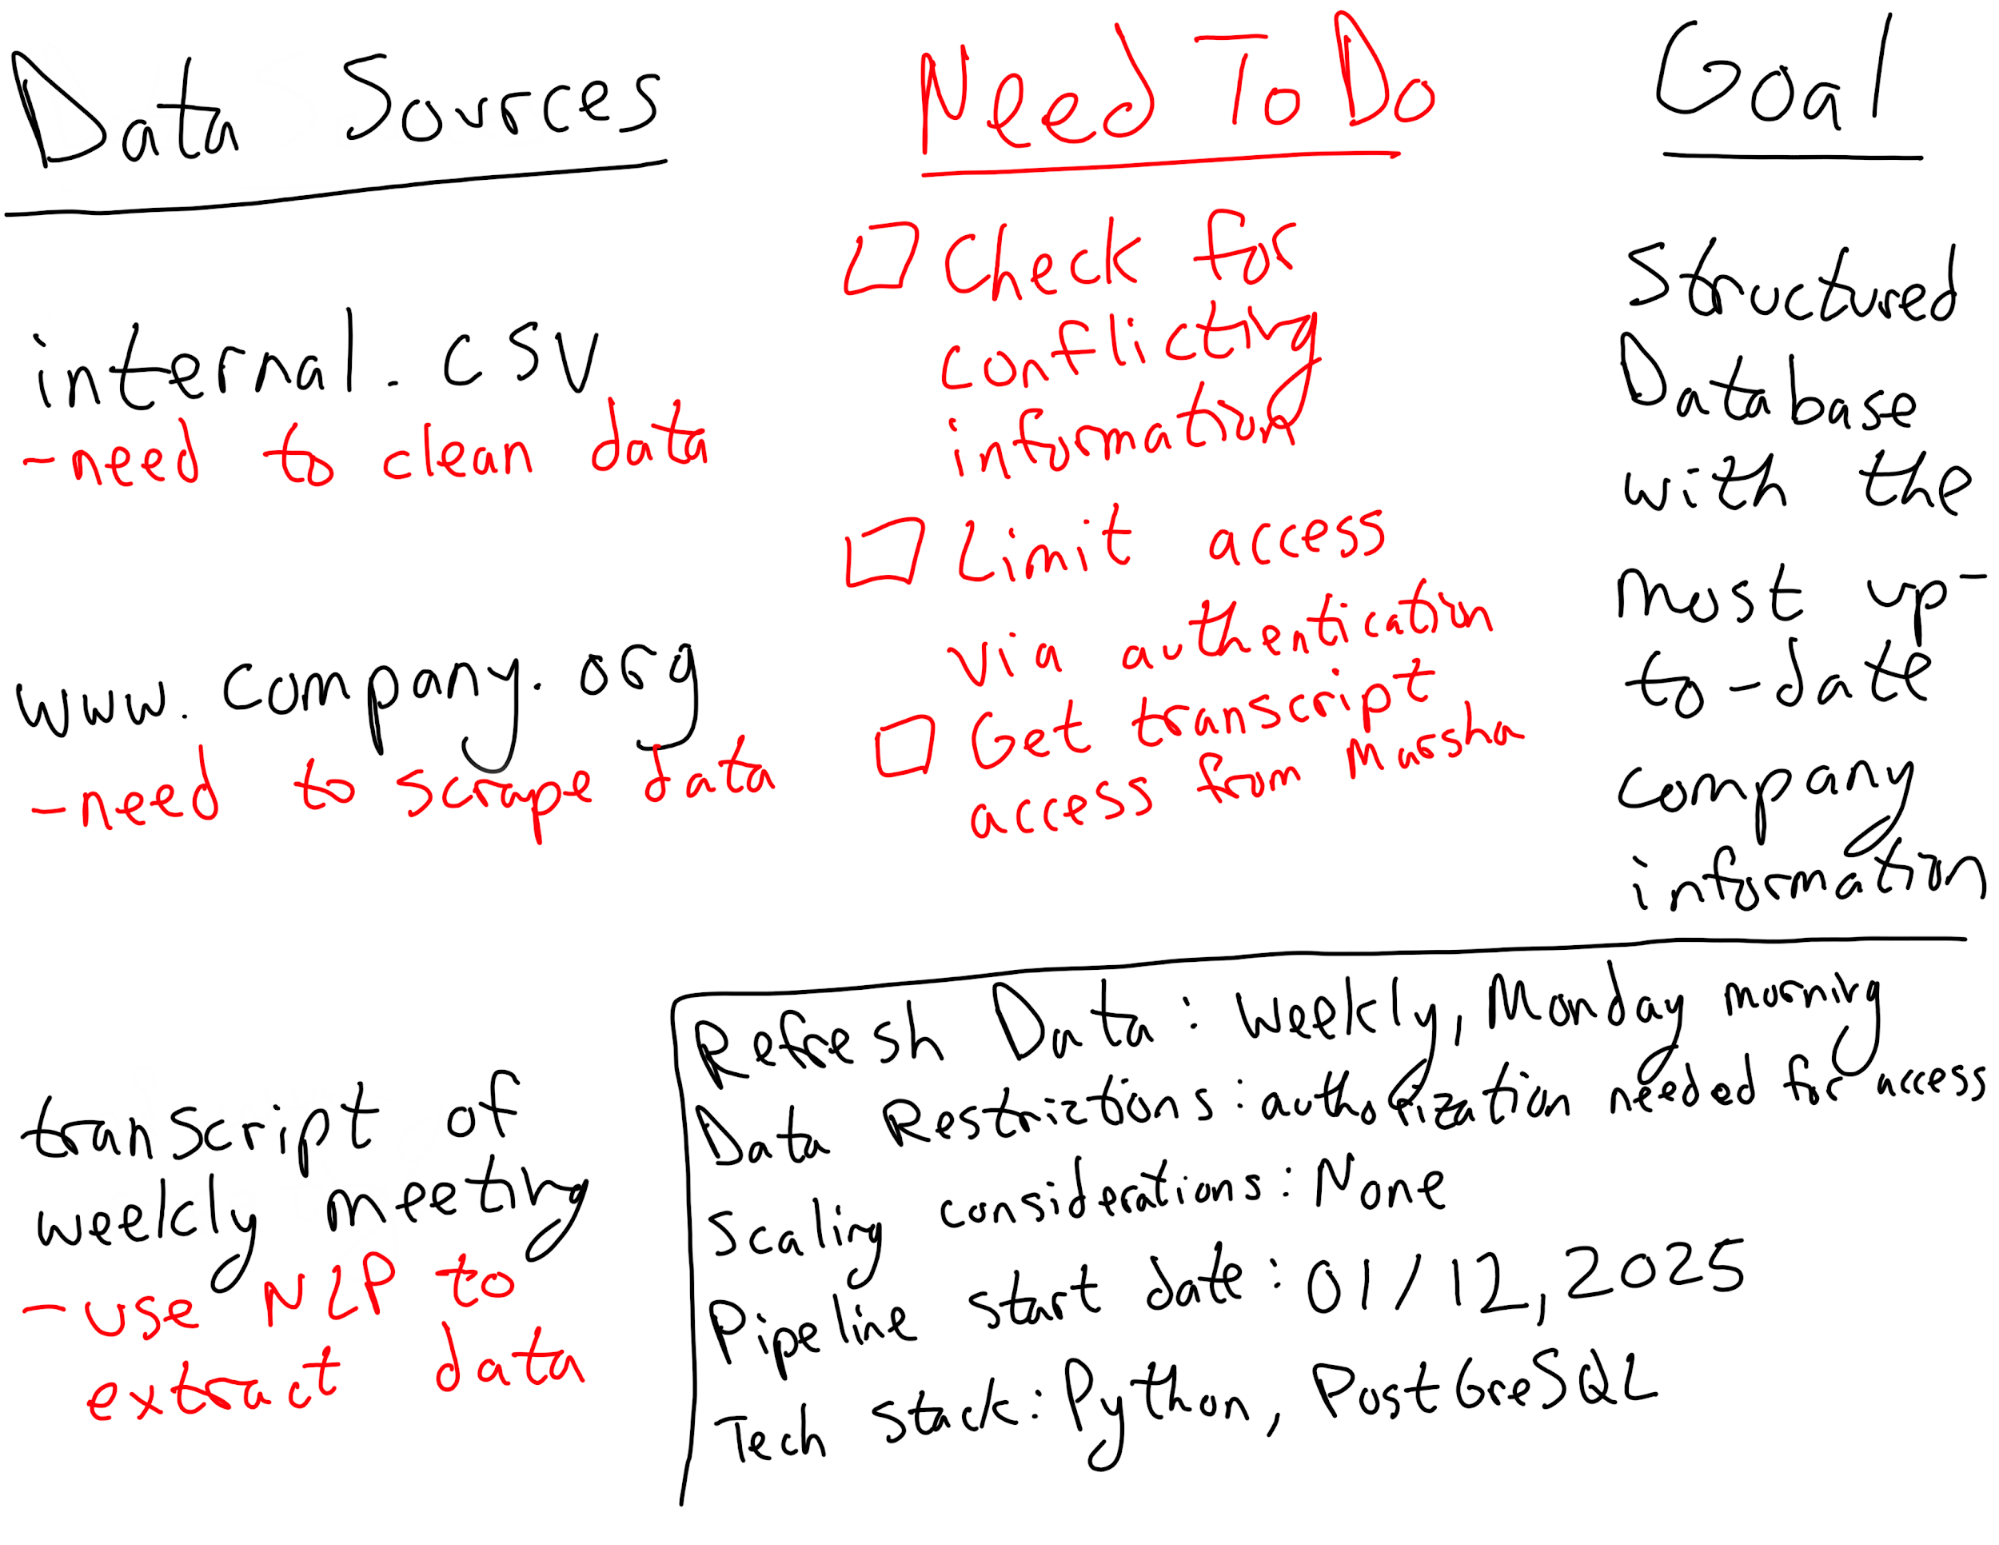
Figura 5: plano de exemplo para um pipeline.
Algumas etapas que você pode incluir:
Com o plano mapeado, é hora de construir. Você pode codificar tudo na sua linguagem favorita ou incluir um ou mais serviços voltados a pipelines. É importante manter o usuário final em mente e o que ele vai precisar durante toda a construção.
Uma decisão-chave é a frequência de atualização dos dados. Se informação em tempo quase real for necessária, você deve criar um pipeline para processamento em tempo real. Se não, considere processamento em lote para economizar recursos. Nesse caso, os dados passam pelas etapas em lotes (por exemplo, diário ou semanal), em vez de continuamente.
Outro ponto ao construir é como você fará a manutenção. Crie uma forma de monitorar o funcionamento do pipeline e detectar/corrigir problemas inesperados.
Erros de digitação, entradas incompletas ou duplicadas e tipos de arquivo diferentes são alguns dos desafios que podem surgir muito depois da configuração inicial. Um bom sistema de monitoramento e tratamento de erros evita muitas dores de cabeça.
Para um olhar mais detalhado sobre o design de pipelines, especialmente em machine learning, confira o curso da DataCamp Designing Machine Learning Workflows in Python.
Como em tudo em dados, faça seu pipeline tão complexo quanto necessário, e só. Pipelines simples são mais fáceis e baratos de manter, mais simples de atualizar e mais compreensíveis caso você precise repassá-los para outro engenheiro.
No início do design, avalie os requisitos do projeto, incluindo possíveis necessidades futuras de escala. Isso ajuda a escolher o nível de complexidade adequado.
Por exemplo, se você precisa de um pipeline temporário para coletar dados de três sensores por alguns meses, pode optar por um pipeline simples de uma etapa usando um recurso gratuito e amplamente disponível, como o Google Drive.
Já se você lida com dados sensíveis ou múltiplas transformações, talvez precise criar código personalizado em Python ou C# com criptografia.
Por fim, você pode estar montando um pipeline pequeno agora, mas com grande expansão prevista nos próximos anos. Nesse caso, vale criar infraestrutura suficiente para suportar o crescimento.
Pode ser tentador projetar um pipeline menor no início e deixar para criar outro quando a escala aumentar. Pode funcionar, mas cuidado!
Muitos engenheiros de dados acabam remendando um pipeline que não foi pensado para a escala atual porque construir um novo é visto como caro ou demorado.
Embora a simplicidade seja essencial, se o pipeline for de longo prazo, é prudente construí-lo já considerando a expansão prevista.
Perguntas úteis no início do projeto:
Um erro comum de profissionais juniores é seguir tendências em vez de usar a melhor ferramenta para o trabalho.
Um exemplo é tentar encaixar IA generativa no stack sem um bom caso de uso.
Como profissional de dados, você deve se manter atualizado sobre novas tecnologias e tendências, mas escolha o que é melhor para o seu projeto — e não apenas o que está na moda.
Com o plano em mãos, pense em como otimizar. Você quer obter os dados no nível de detalhe e na cadência desejados, minimizando recursos computacionais e o tempo de trânsito pelo pipeline.
Um componente essencial é monitorar e registrar o fluxo de dados pelo pipeline. Isso traz visibilidade sobre gargalos que podem estar atrasando o fluxo ou consumindo recursos demais.
Gargalos típicos incluem fontes de dados lentas, restrições de recursos ou transformações ineficientes.
Depois de identificar gargalos, considere otimizações:
Outra consideração é a taxa de atualização. Se os dados são atualizados a cada minuto, mas você só precisa de atualizações a cada cinco, reduzir o número de refreshes desnecessários libera processadores e reduz consumo de energia.
Alguns tipos de dados que passam pelos seus pipelines exigem cuidados de segurança e privacidade. Dados médicos, por exemplo, são altamente regulados pelo governo dos EUA e requerem medidas mais rigorosas do que dados de hábitos de consumo de mídia. Outros exemplos incluem dados financeiros e senhas.
As medidas de segurança vão depender do tipo de dado e de suas preocupações específicas. Em alguns casos, a anonimização é suficiente, dissociando ou removendo informações pessoais. Isso pode ser usado em pesquisas médicas quando dados de identificação não são necessários, mas o restante do prontuário é.
Outras medidas incluem criptografia e controle de acesso por autorizações de login. Esses métodos podem ser usados para dados financeiros ou segredos corporativos.
Para dados sensíveis, é essencial conhecer e cumprir regulamentações como GDPR (Regulamento Geral de Proteção de Dados) ou HIPAA (Lei de Portabilidade e Responsabilidade de Seguros de Saúde).
Dependendo do setor e dos dados tratados, pode ser necessário cumprir normas adicionais, como CCPA (California Consumer Privacy Act) ou FERPA (Family Educational Rights and Privacy Act).
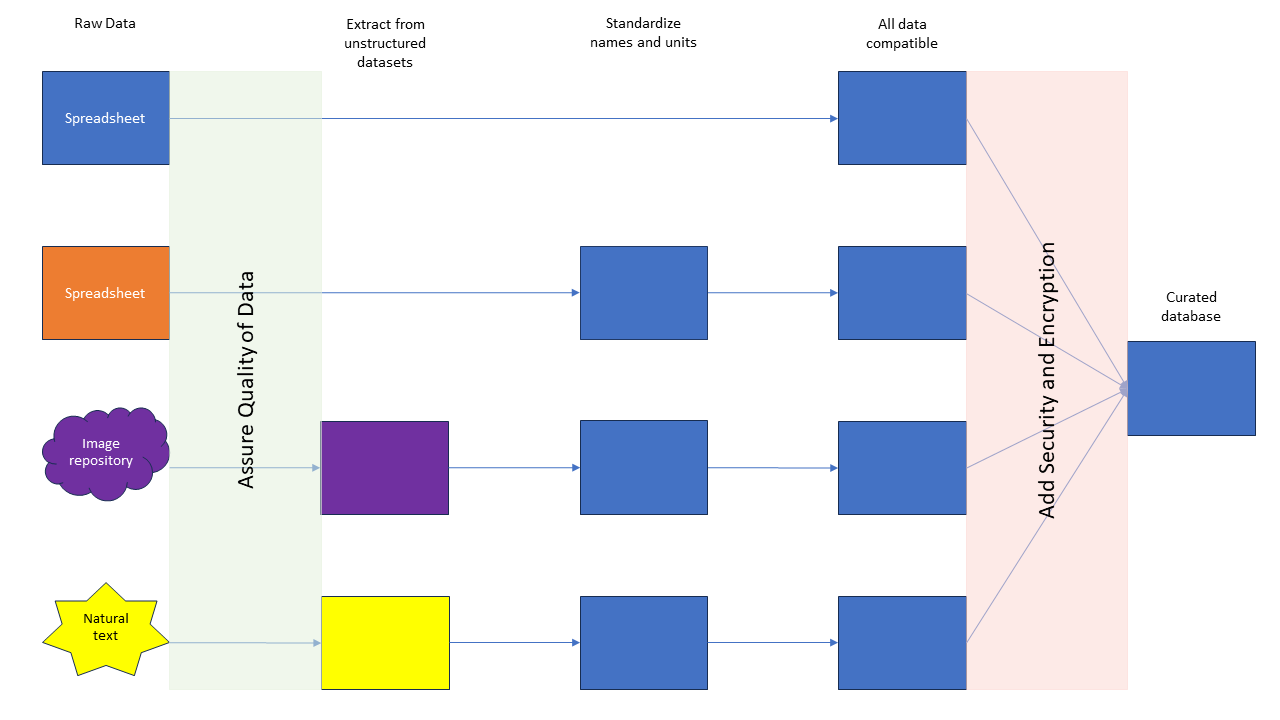
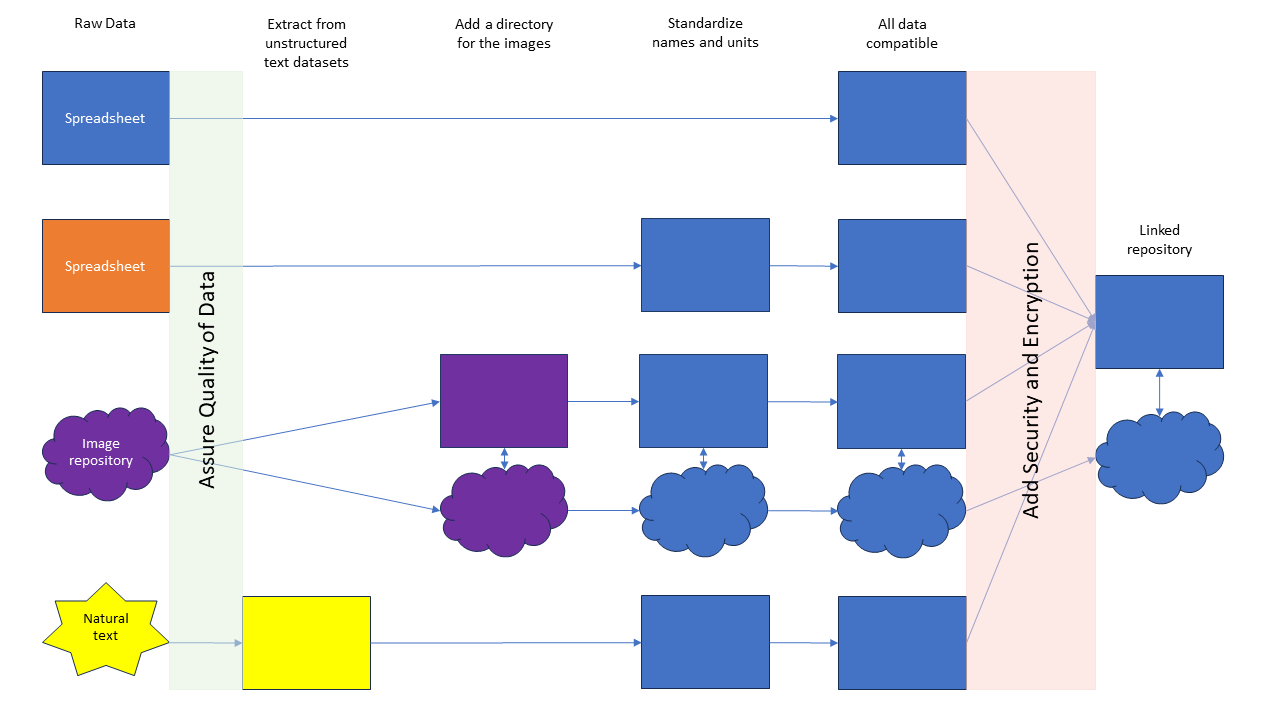
Figura 6: exemplo de como incluir etapas de garantia de qualidade e segurança em um pipeline.
Data pipelines — e os engenheiros que os constroem — são heróis anônimos do mundo dos dados. Eles permitem que a informação flua de forma contínua, organizada e utilizável. Segundo a Statista, o mundo gerou, consumiu e armazenou 64,2 zettabytes de dados apenas em 2020, e esse número cresce a cada ano.
Construir e manter pipelines robustos é cada vez mais crítico nesse cenário. Se este tutorial despertou seu interesse, confira este curso introdutório para uma visão mais aprofundada. Se você quer aprender a construir data pipelines, veja este curso de Python para engenharia de dados para começar. E, se você quer iniciar sua carreira e comprovar suas credenciais para empregadores, confira nossa Data Engineer Certification.
Nossos programas de certificação ajudam você a se destacar e a provar que suas habilidades estão prontas para o trabalho para possíveis empregadores.

Comece a aprender a usar data pipelines hoje mesmo!
Curso
Curso
blog
Tim Lu
12 min
blog
Abid Ali Awan
9 min
blog
Matt Crabtree
9 min
blog
Javier Canales Luna
15 min
Tutorial
Karlijn Willems
15 min
Tutorial
DataCamp Team
13 min