
Kurs
Claude Modellerine Giriş
3 sa
14.9K
GPT-6 Astra, OpenAI'nin GPT-5.6 Sol'un yerini alan öncü amiral modelidir ve sohbetten ziyade ajan yürütmesi etrafında inşa edilmiştir. OpenAI, modeli bilgisayar kullanımı, profesyonel işler ve yazılım mühendisliği için konumlandırıyor; ayrıca şirketin Hazırlık Çerçevesi'nde "Kritik" siber güvenlik eşiğini aşan ilk OpenAI modeli. 1.050.000 belirteçlik bağlam penceresi, 128K maksimum çıktı ve 30 Nisan 2026 bilgi kesimine sahiptir.
Duyuruda iki nokta öne çıkıyor. Codex içinde Astra, notları özet halinde sıkıştırmak yerine bağlam pencereleri arasında tutuyor; böylece önceki pencereler aranabilir kalıyor ve her zaman tahmin etmek ya da soru sormak yerine ne zaman açıklayıcı bir soru soracağına kendi karar veriyor.
Tüm özellik listesi, kıyaslama tabloları ve erişim detayları için GPT-6 Astra rehberimize bakın. Ayrıca selefinin kapsamıyla birlikte, GPT-5.6 Sol, Terra ve Luna yazımızla birlikte okumanızı öneririz.
Claude Fable 5.1, zorlu akıl yürütme ve uzun ufuklu ajan işleri için genel erişime açık Anthropic öncü modelidir. 1M belirteçlik bağlam penceresi, 128K maksimum çıktı, her zaman açık uyarlamalı düşünme ve Haziran 2026 bilgi kesimiyle çalışır. Anthropic dokümanları, gecikmesini, fiyat olarak altında konumlanan Claude Opus 5 ve Claude Sonnet 5'ten daha yavaş olarak değerlendiriyor.
Claude Mythos 5.1, farklı güvenlik önlemleriyle aynı modeldir ve Project Glasswing davetiyle sunulur. Diğer herkes için manşet değişiklik, liste fiyatları sabit kalırken önbellek okuma ücretinin milyon başına 0,25$'a çekilerek %75 düşürülmesidir.
Claude Fable 5.1 rehberimiz tam kıyaslama dökümünü içerir; Claude Fable 5.1 API öğreticimiz ise depo farkındalığı olan bir geliştirici ajanı kurar ve farklı çaba düzeyleri için gerçek maliyet dökümü sunar.
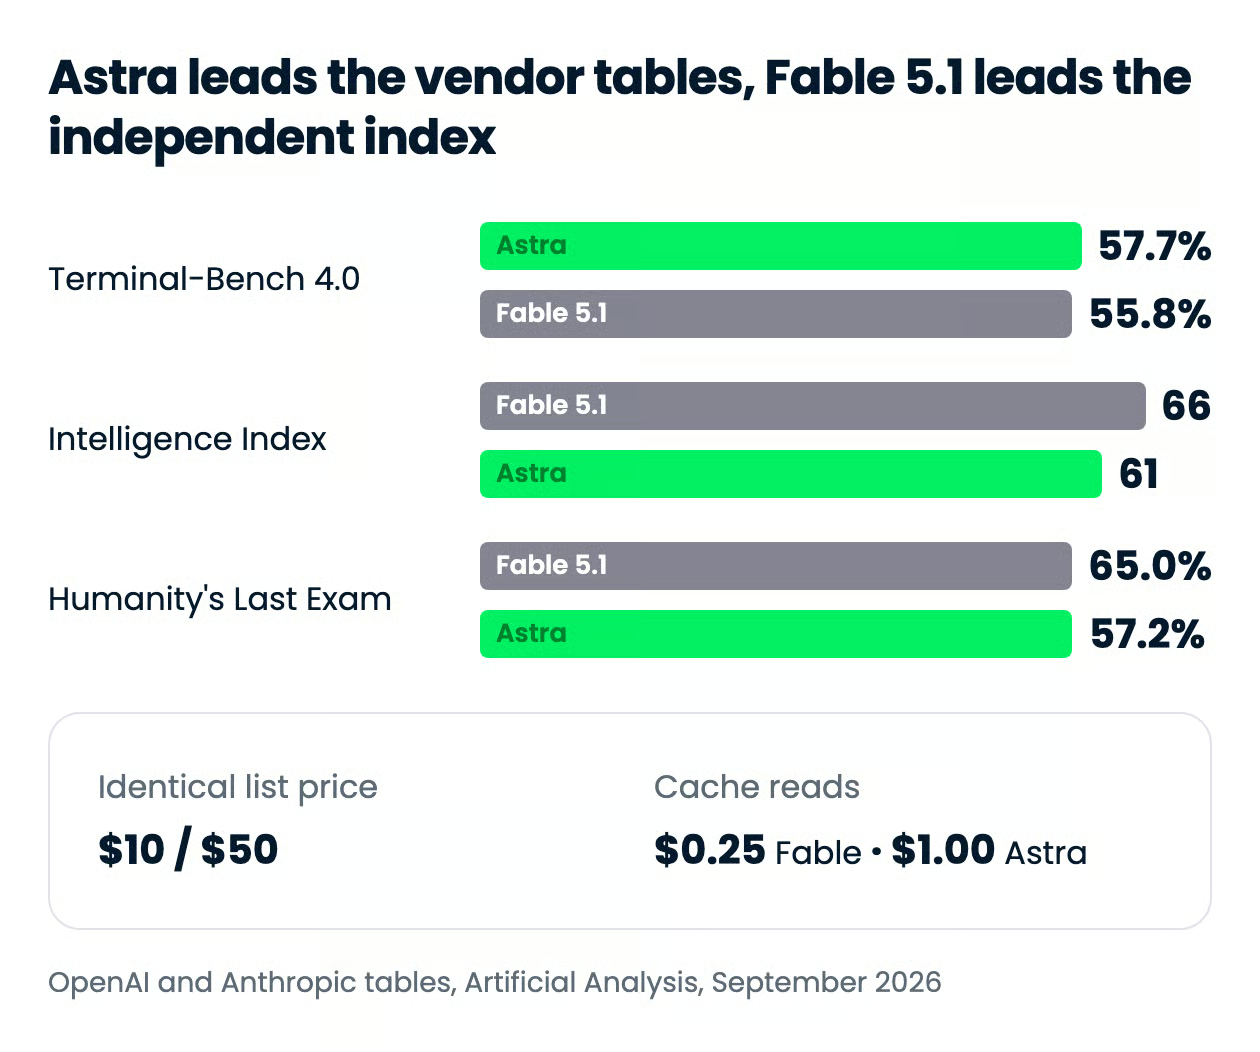
Kısa sürüm: OpenAI'nin karşılaştırma tablosu, yayımladığı satırların neredeyse tamamında Astra'yı Fable 5.1'in önünde gösteriyor; Artificial Analysis ise her iki endeksinde tersini gösteriyor. Hangisine ağırlık vereceğiniz, bir tedarikçinin rakibini puanlamasına ne kadar itibar ettiğinize bağlı.
| Özellik | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Çıkış tarihi | 3 Eylül 2026 | 1 Eylül 2026 |
| API model kimliği | gpt-6-astra |
claude-fable-5-1 |
| Bağlam penceresi | 1,05M belirteç | 1M belirteç |
| Maksimum çıktı | 128K belirteç | 128K belirteç |
| Bilgi kesimi | 30 Nisan 2026 | Haziran 2026 |
| Milyon başına liste fiyatı | 10$ giriş / 50$ çıkış | 10$ giriş / 50$ çıkış |
| Milyon başına önbellekten okuma | 1,00$ (272K üstünde 2,00$) | 0,25$ |
| 272K giriş belirteci üstü oranlar | Giriş ve önbellek 2x, çıkış 1,5x | Ek ücret yok |
| FrontierMath Seviye 4 (v2) | %97,6 | %87,8 |
| Humanity's Last Exam, araçlarla | %57,2 | %65,0 |
| ScreenSpot-Pro (araçsız) | %92,7 | %87,3 (Mythos'tan Fable 5) |
| AutomationBench | %41,4 | %31,4 |
| ExploitBench | %100 | %70 |
| AA Intelligence Index (maks çaba) | 61 | 66 |
| AA görev başı maliyet (maks) | 1,67$ | 3,76$ |
| En güçlü alan | Bilgisayar kullanımı, matematik, siber güvenlik, görev başı maliyet | Derin akıl yürütme, önbellek ağırlıklı ajan döngüleri |
Astra, OpenAI'nin yayımlamayı seçtiği kodlama kıyaslarında önde; ancak marjlar dar ve bağımsız endeks aynı fikirde değil. Terminal-Bench 4.0'da (terminalde yazılım mühendisliği, sistem yapılandırma ve veri analizi), OpenAI, Astra için %57,7, Fable 5.1 için %55,8 raporluyor. Anthropic de aynı %55,8 değerini yayımlıyor; dolayısıyla en azından bu satır tartışmasız.
Boşluk DeepSWE v1.1'de açılıyor: Astra %74,1'e ulaşırken Fable 5.1 %67,4'te kalıyor. FrontierCode 1.1 Main'de ise fark neredeyse kapanıyor: %53,3'e karşı %50,9; bu da zaten Claude Fable 5 (%53,5) ve Claude Opus 5'in (%53,4) aralığı içinde.
| Kıyas | GPT-6 Astra | Claude Fable 5.1 | Notlar |
|---|---|---|---|
| Terminal-Bench 4.0 | %57,7 | %55,8 | OpenAI'nin tablosu %57,7 diyor, kendi grafik altyazısı %57,9 |
| DeepSWE v1.1 | %74,1 | %67,4 | OpenAI bildirimi |
| FrontierCode 1.1 Main | %53,3 | %50,9 | Fable 5 (%53,5) ve Opus 5 (%53,4) ile fiilen başa baş |
| Dahili veritabanı geçişi | %63,9 | %57,8 | OpenAI iç değerlendirmesi, dış doğrulama yok |
| CursorBench 3.2.0 | Yayımlanmadı | %73,4 | Anthropic bildirimi; SpaceXAI, maks çabada %73,4'ü doğruladı |
| AA Coding Agent Index | Codex'te 67 | Claude Code'da 70 | Bağımsız, fakat farklı iskeletler |
Asıl döndüğüm satır sonuncusu. Artificial Analysis, Claude Code'da Fable 5.1'i 70 ile Kodlama Ajanı Endeksi'nin en yüksek puanı olarak, Codex'te Astra'yı ise 67 ile Claude Opus 5 ve Claude Fable 5 seviyelerinde derecelendiriyor. Burada iki uyarı önemli:
Astra, yayımlanan kodlama satırlarını kıl payı kazanıyor ve verimlilik tartışmasını net biçimde alıyor; Fable 5.1 ise ikisinin de üzerine çıkan tek bağımsız kodlama-ajan puanını elinde tutuyor.
Bu, tüm karşılaştırmadaki en net ayrım ve iki yöne birden gidiyor. Astra, matematik ve fen satırlarını alıyor: FrontierMath Seviye 4 v2'de %97,6'ya karşı %87,8; GPQA Diamond'da %96,0'a karşı %93,7; ve Anthropic'in kendi lansmanını üzerine kurduğu ajan araştırma kıyaslaması Terminal-Bench Science 0.1'de %64,6'ya karşı %52,6.
Fable 5.1 ise Humanity's Last Exam'i araçlarla %65,0'a karşı %57,2 ile açık farkla alıyor. Artificial Analysis de bunu bağımsız olarak destekliyor; Zekâ Endeksi'nde Fable 5.1'i 66, Astra'yı 61 puanla, şimdiye kadar ölçtüğü en yüksek skorla derecelendiriyor.
Şu 66 için bir uyarı. Artificial Analysis, Fable 5.1'i Anthropic'in varsayılan sunucu tarafı geri dönüşüne (güvenlik işaretli istekleri Claude Opus 4.8 veya Claude Opus 5'e yönlendirir) açık halde çalıştırdı ve geri dönüş, endeks genelinde çıkış belirteçlerinin yaklaşık %4'ünü üretti. Puan, çoğu kişinin fiilen çağıracağı haliyle Fable 5.1'indir; ham modelin izole hali değil.
Çalışmanız lisansüstü seviyede matematik ya da fen ise Astra. Humanity's Last Exam'in yokladığı türden geniş ve zor akıl yürütmeyse Fable 5.1.
Astra bu boyuta sahip; çoğunlukla Anthropic benzer sayılar yayımlamadığı için. OpenAI, OSWorld 2.0'ın çevrimdışı setinde Astra için %72,6'ya karşı Claude Opus 5 için %70,2 ve ScreenSpot-Pro'da %92,7'ye karşı Claude Fable 5 için %87,3 rapor ediyor. Anthropic'in Fable 5.1 için verdiği %77,9 kısmi ve %41,7 katı değerler, farklı bir görev sürümü ve derecelendirme kurulumundan geliyor.
Eser (artifact) rakamları daha az muğlak: BenchCAD'de %95,9'a karşı %84,3 ve AutomationBench'te %41,4'e karşı %31,4.
Gerçek yazılımlarda tıklayan ve slayt ya da CAD çıktısı üreten ajanlar için Astra daha güçlü seçim.
Astra'nın hizalama sayıları lansmanın en az konuşulan kısmı. OpenAI'nin dahili bilgisayar kullanımı güvenlik kıyaslamasında (düşük daha iyidir) Astra %2,4'e, Fable 5.1 ise %9,5'e puanlanmış.
Siber güvenlikte ise başka bir kulvarda: ExploitBench'te %100 ve Irregular'ın bağımsız testlerinde 226 FrontierCyber meydan okumasından 86'sını çözmüş; GPT-5.6 Sol ise 34'te kalmış. Anthropic, Fable 5.1'i zafiyet bulabilecek kadar esnetmiş ama sömüremeyecek kadar kısıtlamış.
İkisi de tuzağa değer iki uyarı:
Astra hem daha güvenli bir ajan hem de daha yetenekli bir saldırgan; bu nedenle erişimi kademeli.
Liste oranları aynı; bu nedenle ücret kartında iki model arasındaki fark yalnızca önbellekleme ve uzun bağlamdan gelir. Bu çerçeveleme, her iki model de aynı görevde aynı sayıda belirteç harcarsa geçerli olur; ama harcamazlar. Bu yüzden aşağıdaki görev başına ölçülen rakamlar ücret kartından daha önemlidir.
| Oran | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Girdi, milyon başına | 10,00$ | 10,00$ |
| Çıktı, milyon başına | 50,00$ | 50,00$ |
| Önbellekten okuma, milyon başına | 1,00$ | 0,25$ |
| Önbelleğe yazma (5 dk), milyon başına | 12,50$ | 12,50$ |
| Toplu indirim | %50 | %50 |
| 272K girdi belirteci üstü oranlar | 20,00$ giriş / 2,00$ önbellek / 75,00$ çıkış | Ek ücret yok |
Girdi, çıktı, önbelleğe yazma ve toplu indirim sentine kadar aynı. Önbellekten okuma satırı istisna ve 4 kat fark var: Anthropic, Fable 5.1'in önbellek okumalarını 0,25$'a çekiyor; OpenAI ise Astra'yı 1,00$ olarak fiyatlıyor; bu da giriş oranına göre %90 indirim.
272K girdi belirteci üzerinde fark 8 kata açılıyor; çünkü OpenAI'nin ek ücreti, girdiyle birlikte önbellek okumalarını da 2,00$'a katlıyor; Anthropic'in fiyat dokümanları ise tam 1M belirteçlik bağlam penceresini standart oranda tutuyor. Eşik, Astra'nın duyurduğu değere göre hayli düşük: 272K, 1,05M pencerenin yaklaşık dörtte biri; dolayısıyla bağlamın dörtte birini aşan her istek üst kademeden faturalandırılıyor.
Uzun bir döngü boyunca bileşikleşen oran önbellekten okumadır; çünkü bir ajan her turda aynı sistem istemini, araç tanımlarını ve depo bağlamını yeniden gönderir. İstem önbellekleme rehberimiz, bu ayrımı ilk kez duyuyorsanız, önbelleğe yazma–okuma ayrımının mekaniklerini açıklar.
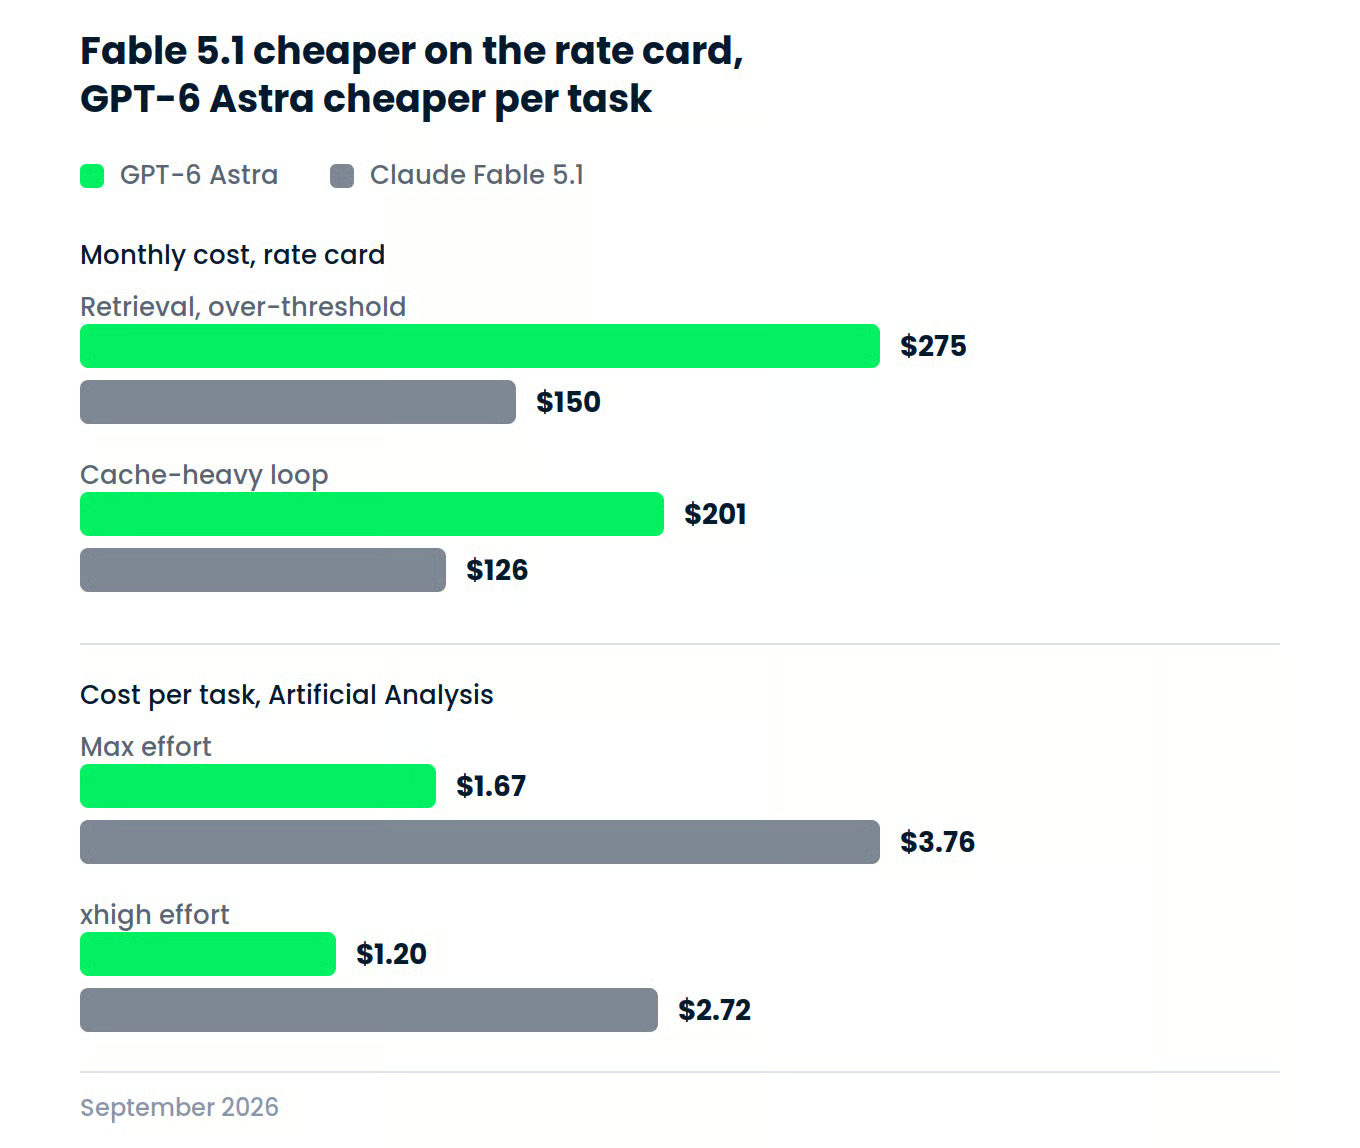
Bu tablodaki her şey, sabit bir belirteç şekli üzerinden liste oranı aritmetiğidir; ölçülmüş bir sonuç değildir. "İki model de aynı belirteçleri harcasaydı ücret kartı ne yazardı?" sorusunu yanıtlar. Bir sonraki bölüm ise fiilen ne harcadıklarını yanıtlar.
| İş yükü | GPT-6 Astra | Claude Fable 5.1 | Fark |
|---|---|---|---|
| Dengeli asistan: 1M giriş / 250K çıkış | 22,50$ | 22,50$ | 0$, %0 |
| Getirme, eşik altı: 10M giriş / 1M çıkış | 150$ | 150$ | 0$, %0 |
| Getirme, eşik üstü: 10M giriş / 1M çıkış | 275$ | 150$ | 125$, Astra için %83 daha fazla |
| Önbellek ağırlıklı döngü: 100K önek, 1.000 okuma | 201$ | 126$ | 75$, Astra için %59 daha fazla |
Formül her satırda aynı: (hacim ÷ 1M) × oran; taze giriş, önbellek okumaları, önbelleğe yazmalar ve çıkış toplamı. Önbellek ağırlıklı satır, bir kez yazılan 100K öneğin 1.000 kez okunmasını; ayrıca istek başına 5K taze giriş ve 1K çıkışı varsayar.
Eşik üstü getirme satırı manşet niteliğinde. Her isteği 272K giriş belirtecinin altında tutarsanız, iki modelin maliyeti de tam 150$ olur. Aynı 10M belirteci, her biri 272K'yı aşan isteklerde gönderirseniz, Anthropic 1M bağlamı standart oranda fiyatladığı için Fable 5.1 150$'da kalırken Astra 275$'a çıkar.
Önbellek ağırlıklı döngü, çoğu okurun karşılaşacağı şekil. 100K öneğin 1.000 kez önbellekten okunmasında, milyon başına 0,75$'lık fark, diğer her şey aynıyken 75$ fark yaratır. Ancak iş yükünün şekline dikkat: Kasıtlı olarak çıktı hafif; istek başına 100K önbellek okumasına karşı 1K çıktı belirteci. Fable 5.1'in önbellek avantajının faturayı belirlediği tek şekil budur.
Varsaymak yerine gerçek belirteç tüketimini ölçtüğünüzde tablo tersine dönüyor. Artificial Analysis, her modeli Zekâ Endeksi görevi başına fiyatlıyor ve yöntemi zaten girdi, önbellek isabeti, önbelleğe yazma, düşünme ve cevap belirteçlerini içeriyor; dolayısıyla Fable 5.1'in daha ucuz önbelleği sayıya yedirilmiş durumda.
| Çaba düzeyi | GPT-6 Astra: puan/maliyet | Claude Fable 5.1: puan/maliyet |
|---|---|---|
| maks | 61 / 1,67$ | 66 / 3,76$ |
| xhigh | 61 / 1,20$ | 65 / 2,72$ |
Maks çabada, Fable 5.1 aynı görev seti için aynı liste fiyatında Astra'nın 2,25 katına mal oluyor. Artificial Analysis, kodlama endeksinde de aynı sonuca varıyor; burada Astra, Fable 5 ile "belirgin belirteç verimliliği kazanımlarıyla maliyetin yarısından daha azına" eşleşiyor. Astra'nın aralığı düşük çabada görev başına 0,46$'a kadar iniyor.
Fable 5.1 burada ücret kartı tarafından değil, çıktı hacmi tarafından cezalandırılıyor. Artificial Analysis, maks çabada Fable 5'e göre yaklaşık 1,7 kat çıktı belirteci kullandığını ölçtü; bu nedenle önbellek indirimi olmasına rağmen selefinden görev başına %20 daha pahalı. İndirimi çıkarırsanız rakam yaklaşık 5,16$ olurdu; yani indirim işe yarıyor, ama yeterince değil.
Bu primi bir şey için ödüyorsunuz. Fable 5.1 aynı endekste 5 puan daha yüksek ve xhigh'da 4 puan daha yüksek. 5 puanın 2,25 kat farka değip değmeyeceğine siz karar verin; ancak liste fiyatlarının aynı olmasının faturaların da aynı olacağı varsayımı ölçümlerle çelişiyor.
OpenAI'nin kendi altyazıları da benzer yöne işaret ediyor; bir tedarikçi raporunun değeri kadar. Terminal-Bench Science 0.1'de görev başına tahmini API maliyetini Fable 5.1'in yaklaşık %31 altına, Terminal-Bench 4.0'da yaklaşık %63 altına ve BenchCAD'de yaklaşık %86 altına koyuyor; her model için OpenAI'nin seçtiği çaba ayarlarında ölçülmüş.
Genelde Astra, testimizi hafifçe kazandı; yine de her iki model de ilk denemede çalışan bir simülasyon üretti.
Birden çok yüzeysel görev yerine, aynı koşullar altında iki modele tek zor görev koştum. Bu karşılaştırma için seçilen test, kütüphane desteği olmadan, uzun bir inşa boyunca sürdürülebilir doğruluğu ölçen ve her iki tedarikçinin de geliştirdiğini iddia ettiği noktayı yoklayan, tek HTML dosyası olarak sıfırdan bir fizik simülasyonudur.
Bu örnek, testin tazelenmiş bir sürümüdür. Yayımlanan varyant dönen kare bir kap kullanıyordu; bu çalışmada, içte ters yönde dönen bir engeli olan dönen bir altıgen ve boyuta orantılı kütle ile değiştirildi. Bu, sınırları net kalan bir tutma/kaçma testini korurken zorluğu artırıyor. İşte her modelde yeni bir sohbete bire bir yapıştırılan istem:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external libraries, no network) that simulates a few dozen balls of varying sizes bouncing under gravity inside a **slowly rotating hexagonal container**, with a **smaller counter-rotating obstacle at the centre** that the balls also collide with.
Ball mass should scale with size, so larger balls shove smaller ones around.
The balls should collide with each other, with the hexagon's walls, and with the central obstacle, and lose a little energy on each collision so the system settles rather than gaining energy over time.
Both the hexagon and the inner obstacle keep rotating throughout, so the balls should slosh and re-pile as they turn.

Ship it as one working file named `index.html` that starts animating on load.
Do not install packages.
Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Her iki model de yüksek akıl yürütme çabasında, tekrar deneme olmadan birer deneme, aynı kodlama ajanı ve aynı araçlarla çalıştı. Puanlama, önce çalıştırılabilirlik geçer/kalır kontrolü; ardından fizik doğruluğu, 30 saniyelik kararlılık ve görsel kalite için 1'den 5'e bir rubrik.
Astra çalıştırılabilirlik kontrolünü geçti ve üç rubrik ekseninin tamamında 5/5 aldı. 6 tur ve 9 araç çağrısında oraya vardı; araç karması ilginç kısım: dosyayı yazdı, 5 kez geri okudu, iki kez grep yaptı ve bitirdiğini ilan etmeden önce iki kez yamadı.
Simülasyon doğru. 44 top, alanla ölçeklenen kütle, altıgen dönerken tam 30 saniye boyunca tutma. Astra, iç engeli odaya göre büyük tuttu; böylece toplar, erişemeyeceği bir yerde yerleşmek yerine onunla çarpmaya devam etti.
Ayrıca simülasyonun etrafına tamamıyla editoryal bir sayfa inşa etti: serif bir başlık, aralıklı monospace etiketler ve canlı dönüş hızlarını raporlayan bir telemetri paneli. Kimse bunu istemedi ama bence oldukça hoş görünüyor. İstem talep etmemiş olsa da duraklatma ve yeniden başlatma kontrolleri de ekledi; bu da eseri incelemeyi kolaylaştırdı.
Astra, dış duvarı 0,09 rad/sn ve engeli -0,16 rad/sn döndürüyor; bu, dış duvarda Fable'dan yaklaşık 3 kat, engelde 5 kat daha yavaş. İzlemesi daha kolay ve hareketli sınır için daha nazik bir test. İstem yavaş dönen bir kap istediği için bu gayet uygun.
| Ölçüt | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Turlar | 6 | 2 |
| Araç çağrıları | 9 | 1 |
| Çalıştırılabilirlik | Geçti | Geçti |
| Fizik doğruluğu | 5 | 4 |
| Zamanla kararlılık | 5 | 5 |
| Görsel kalite | 5 | 4 |
| Rubrik puanı | 5,0 | 4,3 |
Astra bu raundu kaliteyle alıyor; fark fizik kısmından çok sunumda açılıyor. Ayrıştıkları nokta ise her modelin işi nasıl okuduğu: Astra, istemi yorumlanacak bir brif olarak görüyor; kontroller, tam bir editoryal yerleşim ve izlemeye uygun daha yavaş bir dönüş ekliyor. Fable ise bunu karşılanacak bir teknik şartname olarak okuyor, tek yazışta karşılıyor ve kalan gayretini tanılama HUD'una ayırıyor.
Bu, model başına tek çalıştırma; dolayısıyla bir kıyas değil, bir veri noktası olarak değerlendirin. Belirteç ya da maliyet yerine tur sayısını raporluyor ve yukarıda ele alınan bilgisayar kullanımı veya akıl yürütme boyutlarını değil, sıfırdan simülasyon kodunu yokluyor.
Liste oranları aynı olduğundan karar; iş yükü şekline, ölçülen belirteç tüketimine ve zaten kullandığınız kodlama ajanına kalıyor. Sizi en çok etkilemesi gereken üç sayı: 4x önbellek okuma farkı, 272K ek ücret eşiği ve 2,25x ölçülen görev başına maliyet.
| Yüzey | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Tüketici uygulaması | ChatGPT Plus, Pro, Business, Enterprise | Claude web, mobil, masaüstü (Pro, Max, Team, Enterprise) |
| Birinci taraf API | OpenAI API | Claude API |
| Bulut platformları | Amazon Bedrock, Microsoft Azure/Foundry | Amazon Bedrock, Google Cloud, Microsoft Azure/Foundry |
| Kodlama ajanları | Codex | Claude Code, Cursor |
| Üçüncü taraf yönlendiriciler | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| API model kimliği | gpt-6-astra |
claude-fable-5-1 |
İlk çağrınızdan önce iki erişim detayı sizi durdurabilir. Astra, kurumsal çalışma alanlarında varsayılan olarak kapalı gelir ve bir yönetici tarafından açılması gerekir; Fable 5.1 ise 30 günlük veri saklama gerektirir ve Priority Tier'da desteklenmez. Bulut kapsamı iki model arasında büyük ölçüde dengeli; halihazırda Fable 5.1'in bulunduğu ve GPT-6 Astra'nın olmadığı tek platform Google Cloud.
Her model kendi iskeletinde yerlidir: Astra Codex'te, Fable 5.1 Claude Code'da; burada /model claude-fable-5-1 veya --model bayrağı ile geçiş yaparsınız. API üzerinden değişim tek bir dizedir; ancak SDK'lar farklıdır.
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-fable-5-1",  # OpenAI SDK equivalent: model="gpt-6-astra"
    max_tokens=16000,          # thinking plus response share this budget
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Refactor this module..."}],
)
print(response.content[0].text)
Fable 5.1'de üç değişiklik Fable 5'e göre yazılmış kodu bozabilir: zorunlu araç seçimi artık 400 döndürür; önceki modeller düşünme bloklarını okuyamaz ve düşünme blokları kendilerinden önceki tam geçmişe bağlıdır. Üçünü de Claude Fable 5.1 API öğreticimizde işliyoruz; diğer tarafta eşdeğer kurulumu ise OpenAI API'ye yeni başlayanlar rehberimiz kapsıyor.
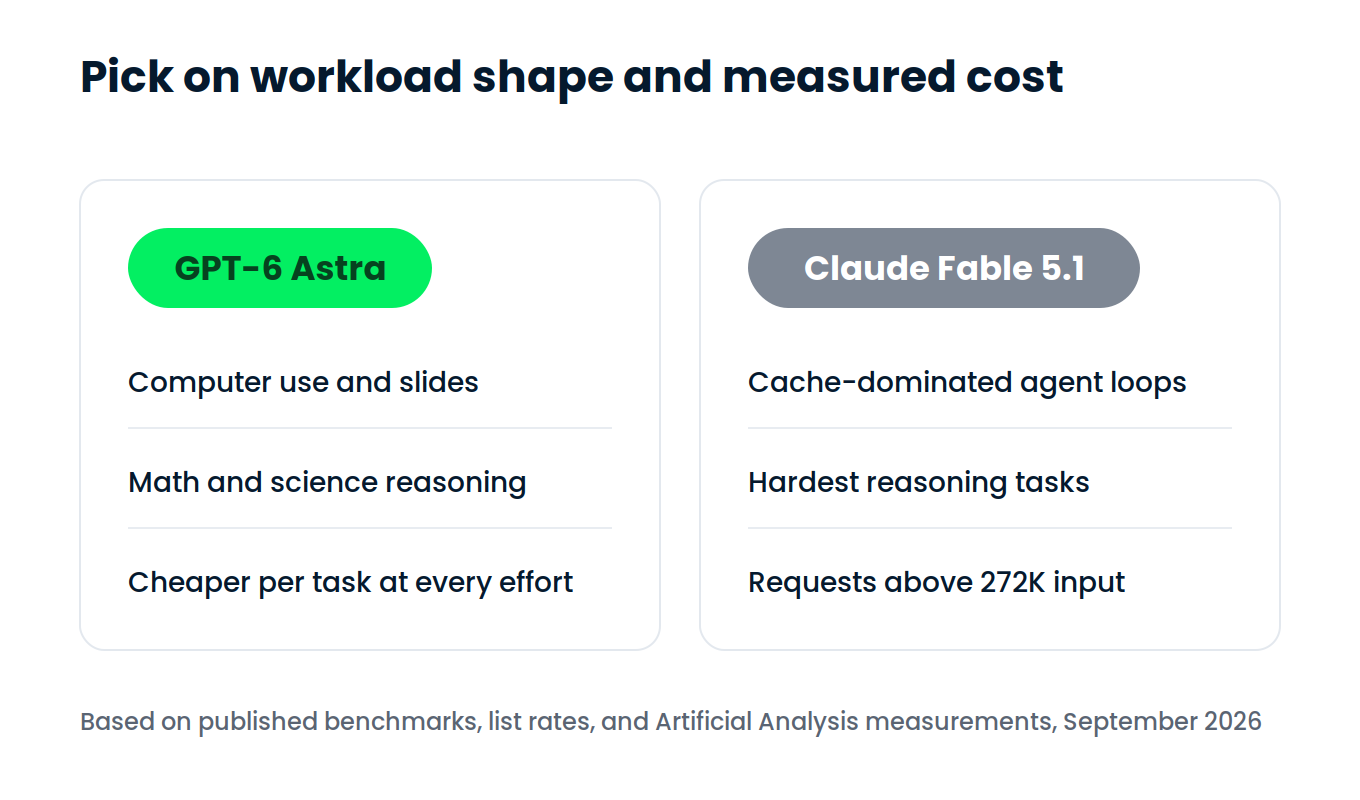
Kararı kıyaslama tablolarına değil, iş yükü şekline ve ölçülen maliyete göre verin. GPT-6 Astra, yazılımlarda tıklayan, matematik yapan ya da müşteri hazır eserler üreten ajanlar için daha güçlü ve aynı ücret kartına rağmen görev başına daha ucuz görünüyor. Claude Fable 5.1 ise mevcut en yüksek bağımsız akıl yürütme puanını sağlıyor ve çok büyük isteklerde ve önbellek ağırlıklı döngülerde daha az maliyetli.
Bu karşılaştırmada ücret kartı tuzaktır. 10$ ve 50$'dan iki model fiyat açısından birbirinin yerine geçebilir görünür; görünen tek fark olan önbellek okuması ise Anthropic lehine 4x'tir. Sonra her birinin bir görevi bitirmek için gerçekte ne harcadığını ölçersiniz ve Astra, Fable 5.1 maliyetinin %44'ünde çıkar. Bunu fiyatlandırma sayfalarından öngöremezdim ve bağlanmadan önce kendi trafiğinizde kontrol edeceğim tek şey bu olurdu.
Her iki modelle çalışmak istiyor, okumak istemiyorsanız Anthropic tarafı için Introduction to Claude Models kursumuzu ve OpenAI için Working with the OpenAI API kursumuzu öneririm.
DataCamp ile Yapay Zekâyı Öğrenin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




