
易用性
Azure Data Factory 的拖拽式界面使其相对易于使用,即便是技术背景有限的用户也能上手。其专注于低代码/无代码的管道开发,简化了数据工作流的创建与管理。
Databricks 虽然功能强大,但对技术熟练度要求更高。它依赖编码(如使用 Python、Scala 与 SQL 等语言)与较复杂的配置选项,更适合熟悉代码与大数据框架的数据工程师与数据科学家。
可伸缩性与性能
ADF 与 Databricks 都具有很强的可伸缩性,但各有所长。ADF 旨在处理大规模数据集成与迁移任务,非常适合编排复杂的 ETL 工作流。
Databricks 基于 Apache Spark,在大数据处理与分析方面提供无与伦比的性能,是需要高性能计算与可伸缩性的场景下的首选。
成本考量
在评估 Azure Data Factory 与 Databricks 的使用成本时,了解其定价模型及其对预算的影响至关重要:
- ADF 的定价基于管道活动数量、数据移动与数据量。随着管道复杂度与数据量增加,成本可能上升,但对于简单的 ETL 任务,ADF 通常具有较高的性价比。
- Databricks 的定价基于所用计算资源,通常以每小时 Databricks Units(DBUs)计量。对于大规模数据处理与机器学习工作负载,特别是在需要高性能集群时,成本可能显著增加。
评估成本时,请考虑您组织的具体需求,例如数据量、转换复杂度与管道执行频率。
在某些情况下,使用 ADF 进行编排、Databricks 负责处理的组合方案,能够兼顾两者优势,同时有效管理成本。
Azure Data Factory vs Databricks:总结
下表从多个方面比较了 Azure Data Factory 与 Databricks:
|
类别 |
Azure Data Factory(ADF) |
Databricks |
|
概览 |
基于云的数据集成服务,用于编排与自动化数据移动与转换。 |
专注于大数据处理与机器学习的统一分析平台。 |
|
主要用例 |
数据集成、ETL/ELT 管道、数据编排与工作流自动化。 |
大数据分析、实时数据处理与机器学习。 |
|
数据转换 |
主要用于编排数据转换,可使用内置或外部计算资源(如 Databricks 或 Synapse Spark 池)。 |
借助 Apache Spark 与 Delta Lake 进行高级、的大规模数据转换,支持批处理与实时处理。 |
|
ETL/ELT |
专注于 ETL/ELT 编排,连接多个数据源与目标,内置复制数据、数据流与 Azure 服务等活动。 |
功能强大的 ETL 能力,尤其适用于复杂的大数据转换,借助 Spark 实现内存计算。 |
|
计算引擎 |
无原生计算引擎;数据转换依赖 Azure Databricks、Azure Synapse 或 Azure HDInsight 等外部计算选项。 |
基于 Apache Spark 的计算引擎,支持实时与批处理。 |
|
数据移动 |
提供广泛的内置连接器(如数据库、云存储、SaaS 平台),适合在不同环境间编排大规模数据移动。 |
通常与 Azure Data Lake、S3、Delta Lake 等存储方案集成,但数据移动并非其主要侧重点。 |
|
数据集成 |
具备强大的数据集成能力,支持 90 多种连接器,包括 Azure 服务、本地数据库与第三方系统。 |
数据集成主要聚焦于大数据存储与处理平台(Azure Data Lake、Delta Lake),连接器种类相对更少。 |
|
数据处理 |
通过可视化、低代码映射的数据流在规模上进行数据转换;更高级的转换则使用 Databricks 或 Azure Synapse。 |
基于 Spark 的高级数据处理;针对实时与大规模批处理负载做了优化。 |
|
协作 |
通过 Git 集成(Azure DevOps 与 GitHub)进行管道协作。 |
借助 Databricks Workspaces 提供高级协作功能,并与 GitHub 或 Databricks Repos 集成版本控制。 |
|
开发者体验 |
用于构建 ETL 工作流的拖拽式 UI;非技术用户也能轻松创建数据管道。 |
高级开发者体验,提供笔记本环境并支持基于代码的转换(Python、Scala、R、SQL)。 |
|
调度与编排 |
出色的调度与编排能力,提供触发器与管道执行控制。 |
编排能力有限。Databricks 可通过 ADF 或其他工具进行外部编排。 |
|
数据治理 |
与 Azure Purview 集成,实现数据治理、血缘追踪与元数据管理。 |
治理通常由外部工具处理,如 Azure Purview 或其他第三方方案。 |
|
监控与日志 |
通过 Azure Monitor、警报与 ADF 监控仪表板提供内置监控与日志。 |
通过 Databricks REST API、与 Azure Monitor 集成以及自定义仪表板实现广泛的日志与监控能力。 |
|
可伸缩性 |
可在按需的数据集成与数据移动中轻松扩展。数据处理的扩展依赖外部计算服务。 |
高度可伸缩,特别适合大型数据工作负载与机器学习管道,支持自动集群伸缩。 |
|
成本模型 |
按使用量计费,基于数据移动、编排与所用外部计算服务(Databricks、Synapse 等)。 |
存储与计算按需计费。集群可自动伸缩以优化成本。 |
|
机器学习 |
无内置机器学习能力。可通过编排 Azure ML 或 Databricks 等服务来集成机器学习。 |
内置如 MLlib 等机器学习库,并与 MLflow 集成以进行模型跟踪与管理。 |
|
安全性 |
基于角色的访问控制(RBAC)、与 Azure Active Directory 集成、内置数据加密与托管身份。 |
RBAC、数据加密、与 Azure Active Directory 集成以及自定义安全模型。 |
|
BI 集成 |
可编排数据管道并将数据供给 Power BI、Azure Synapse Analytics 及其他 Azure 服务等 BI 工具。 |
支持与 Power BI、Tableau 等 BI 工具集成以直接消费数据。 |
|
实时数据处理 |
可通过触发器编排实时数据摄取,并使用 Stream Analytics 或 Databricks 等实时计算服务。 |
针对使用 Spark Streaming 的实时数据处理进行了优化。 |
|
易用性 |
低代码界面友好,便于非技术用户构建数据管道。 |
需要更多技术知识,面向大数据工程师、数据科学家与开发者。 |
|
多云支持 |
主要聚焦 Azure,但可通过连接器连接到部分其他云服务。 |
支持包括 Azure、AWS 与 GCP 在内的多云环境。 |
|
部署 |
全托管服务,管道自动更新与扩展。 |
托管服务,但在集群配置与伸缩方面给予用户更多控制权。 |
|
社区与生态 |
庞大的 Azure 社区,微软强力支持并深度融入 Azure 生态。 |
社区规模大,Databricks 与开源 Apache Spark 社区贡献显著。 |
|
合规与认证 |
符合多种行业标准,包括 GDPR、HIPAA 与 ISO 认证。 |
同样符合多种行业标准与认证,包括 GDPR、HIPAA 与 SOC 合规。 |
何时使用 Azure Data Factory
当数据集成与迁移是首要关注点时,Azure Data Factory 是首选。更具体地说,它非常适合以下场景:
- 数据集成与迁移:当组织需要在本地与云端等多种来源之间移动数据时,ADF 可高效完成相关工作。
- 编排数据管道:ADF 擅长在多个数据源之间管理并自动化数据工作流,非常适合数据环境复杂的组织。
- 简单到中等复杂度的数据转换:ADF 的 Data Flow 功能为涉及基础到中等复杂度转换的 ETL 流程提供了足够能力。
- 需要调度与监控的 ETL 工作流:ADF 内置的调度与监控工具,便于自动化并跟踪 ETL 工作流的性能。
何时使用 Databricks
Databricks 是需要大数据处理、分析与机器学习场景的首选平台。它最适用于:
- 大数据处理与分析:Databricks 擅长处理大型数据集,适合需要分析海量数据的组织。
- 机器学习与 AI 模型开发:Databricks 提供开发与部署机器学习模型的高级工具,是构建 AI 驱动应用的强大平台。
- 协作式数据科学环境:Databricks 的协作笔记本使数据科学家与分析师能够实时协作,促进团队式数据科学项目。
- 使用 Apache Spark 的复杂数据转换:当需要大量数据操作与计算时,Databricks 基于 Apache Spark 的转换提供足够的能力与灵活性来处理复杂任务。
整合 Azure Data Factory 与 Databricks
在许多情况下,可以将 Azure Data Factory 与 Databricks 搭配使用,以构建完整的数据管道。
ADF 可编排数据管道,管理从多种来源的数据抽取、转换与加载。随后,Databricks 可执行更复杂的数据处理与分析任务,发挥其在大数据处理与机器学习方面的高级能力。
例如,一个典型的端到端数据管道可能由 ADF 从多个来源抽取数据并加载到数据湖。接着 Databricks 对数据进行处理、执行高级转换并应用机器学习模型,最终将结果加载到数据仓库以供进一步分析。
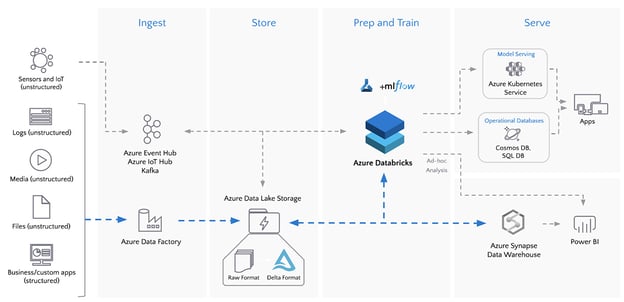
使用 Azure Data Factory 与 Azure Databricks 的批处理 ETL。图片来源:Databricks
结论
Azure Data Factory 与 Databricks 均是 Azure 生态中的强大工具,各有优势与适用场景。在许多情况下,将 ADF 与 Databricks 结合使用,能够提供兼具两者所长的完整解决方案!
若您希望更深入地了解这些平台,可参考以下资源:
这些资源将为您理解 Azure Data Factory 与 Databricks 的核心概念,以及如何用它们构建强大的数据管道与分析解决方案打下坚实基础。
FAQs
Azure Data Factory 与 Databricks 的主要区别是什么?
Azure Data Factory 主要用于数据集成、迁移与编排;而 Databricks 专为大数据处理、高级分析与机器学习而设计。
Azure Data Factory 和 Databricks 能一起使用吗?
可以。ADF 可用于编排涉及 Databricks 的数据管道来完成复杂的数据处理任务,从而构建完整的数据管理解决方案。
哪个工具更适合做数据转换:Azure Data Factory 还是 Databricks?
Databricks 借助 Apache Spark 提供更高级的数据转换能力,更适合处理复杂转换。ADF 则更适用于较为直接的 ETL 任务。
使用 Azure Data Factory 的成本与 Databricks 相比如何?
对于简单的 ETL 任务,ADF 通常更具性价比;而 Databricks 因计算资源需求,在大规模分析与机器学习场景下成本可能更高。
Azure Data Factory 适合大数据处理吗?
ADF 能处理大数据量,但更侧重数据集成与编排。对于高性能大数据处理,Databricks 是更佳选择。

首席 BI 顾问 - Power BI 认证 | Azure 认证 | 前 Microsoft | 前 Tableau | 前 Salesforce - 作者
高效整合、处理与分析数据的能力,对于希望获取洞见并保持竞争优势的组织至关重要。
在 Azure 生态系统中,两款强大的工具 Azure Data Factory 与 Databricks 已成为管理数据管道与开展高级分析的领先解决方案。尽管它们乍看之下相似,但在数据工程与分析的不同层面各有侧重。
本文将探讨 Azure Data Factory 与 Databricks 的能力,对比其功能,并提供何时使用各自工具的实用建议。
什么是 Azure Data Factory?
Azure Data Factory(ADF)是一项基于云的 ETL(抽取、转换、加载)服务,支持跨各类数据存储进行数据集成、迁移与编排。它旨在促进将分散来源的数据移动与转换到集中位置,从而便于进行
商业智能分析。
借助 ADF,您可以创建与管理数据管道,自动化从多种来源抽取数据、将其转换为可用格式并加载至目标以供分析的全过程。
Azure Data Factory 的功能
以下是不分先后的一些 ADF 亮点功能:
如您所见,ADF 提供了在 Azure 生态中构建数据管道所需的一切!
Azure Data Factory 擅长连接并整合多元数据源。图片来源:Microsoft。
Introduction to Azure 课程非常适合想要入门 Azure 的读者。对于更有经验的读者,Azure Management and Governance 课程是不二之选。
什么是 Databricks?
Databricks 是一款分析平台,为大数据处理与机器学习提供协作环境。基于 Apache Spark,Databricks 专为大规模数据处理任务而设计,使您能够执行复杂分析并开发机器学习模型。
Databricks 提供统一平台,让数据工程师、数据科学家与分析师在精简的工作流中协作处理、分析与可视化数据。
Databricks 的功能
以下功能让 Databricks 成为广受欢迎的工具:
Databricks 数据湖仓架构要素。图片来源:Databricks
就是这样!如果您对 Databricks 的广泛能力感兴趣,可以从 Introduction to Databricks 课程开始。
Azure Data Factory vs. Databricks:主要差异
此时,您或许已经能看出 ADF 与 Databricks 的不同之处。下面我们将从多个维度更深入地分析这些差异。
目的与使用场景
Azure Data Factory 主要面向数据集成与编排。它擅长在各类来源之间移动数据、进行转换并加载到集中位置以便进一步分析。对于需要在多个环境间自动化与管理数据工作流的场景,ADF 是理想之选。
相对而言,Databricks 专注于数据处理、分析与机器学习。对于希望进行大规模数据分析、开发机器学习模型并在数据科学项目上协作的公司而言,这是首选平台。Databricks 尤其适合大数据环境与 AI 驱动的应用。
数据转换能力
Azure Data Factory 通过其 Data Flow 功能提供数据转换能力,使用户能够在管道中直接执行多种转换。虽然功能强大,但总体上更适合 ETL 流程,灵活性与广度可能不及 Databricks。
Databricks 基于 Apache Spark,提供高级数据转换能力。用户可充分发挥 Spark 的强大功能,执行复杂转换、聚合与数据处理任务,是需要大量数据操作与计算场景的优选。
与其他 Azure 服务的集成
ADF 与 Databricks 均可与其他 Azure 服务集成,但侧重点不同。ADF 专为 ETL 与编排而设计,是管理涉及 Azure Synapse Analytics 与 Azure Blob Storage 等多个 Azure 服务的数据工作流的理想工具。
而 Databricks 更专注于高级分析与 AI,可与 Delta Lake 等服务集成用于数据存储,并与 Azure Machine Learning 集成用于模型部署。