
Cursus
Microsoft Azure-architectuur en -services begrijpen
2 uur
22.3K
Oefen en volg je voortgang.
Ga Verder Met GoogleDe mogelijkheid om data efficiënt te integreren, verwerken en analyseren is belangrijk voor organisaties die inzichten willen verkrijgen en concurrerend willen blijven.
Twee krachtige tools, Azure Data Factory en Databricks, zijn uitgegroeid tot toonaangevende oplossingen voor het beheren van datapijplijnen en het uitvoeren van geavanceerde analyses binnen het Azure-ecosysteem. Hoewel deze tools op het eerste gezicht op elkaar kunnen lijken, richten ze zich op verschillende aspecten van data engineering en analytics.
In dit artikel bekijken we de mogelijkheden van Azure Data Factory en Databricks, vergelijken we hun features en geven we inzicht in wanneer je welke tool gebruikt.
Azure Data Factory (ADF) is een cloudgebaseerde ETL-service (Extract, Transform, Load) die data-integratie, migratie en orkestratie over verschillende dataopslagplaatsen mogelijk maakt. Het is ontworpen om de verplaatsing en transformatie van data van uiteenlopende bronnen naar centrale locaties te faciliteren, waar deze geanalyseerd en benut kan worden voor
business intelligence.
Met ADF kun je datapijplijnen maken en beheren die het proces automatiseren van het extraheren van data uit meerdere bronnen, het transformeren naar een bruikbaar formaat en het laden in een bestemming voor analyse.
Dit zijn de meest interessante features van ADF, in willekeurige volgorde:
Zoals je ziet, biedt ADF alles wat je nodig hebt om datapijplijnen te bouwen binnen het Azure-ecosysteem!
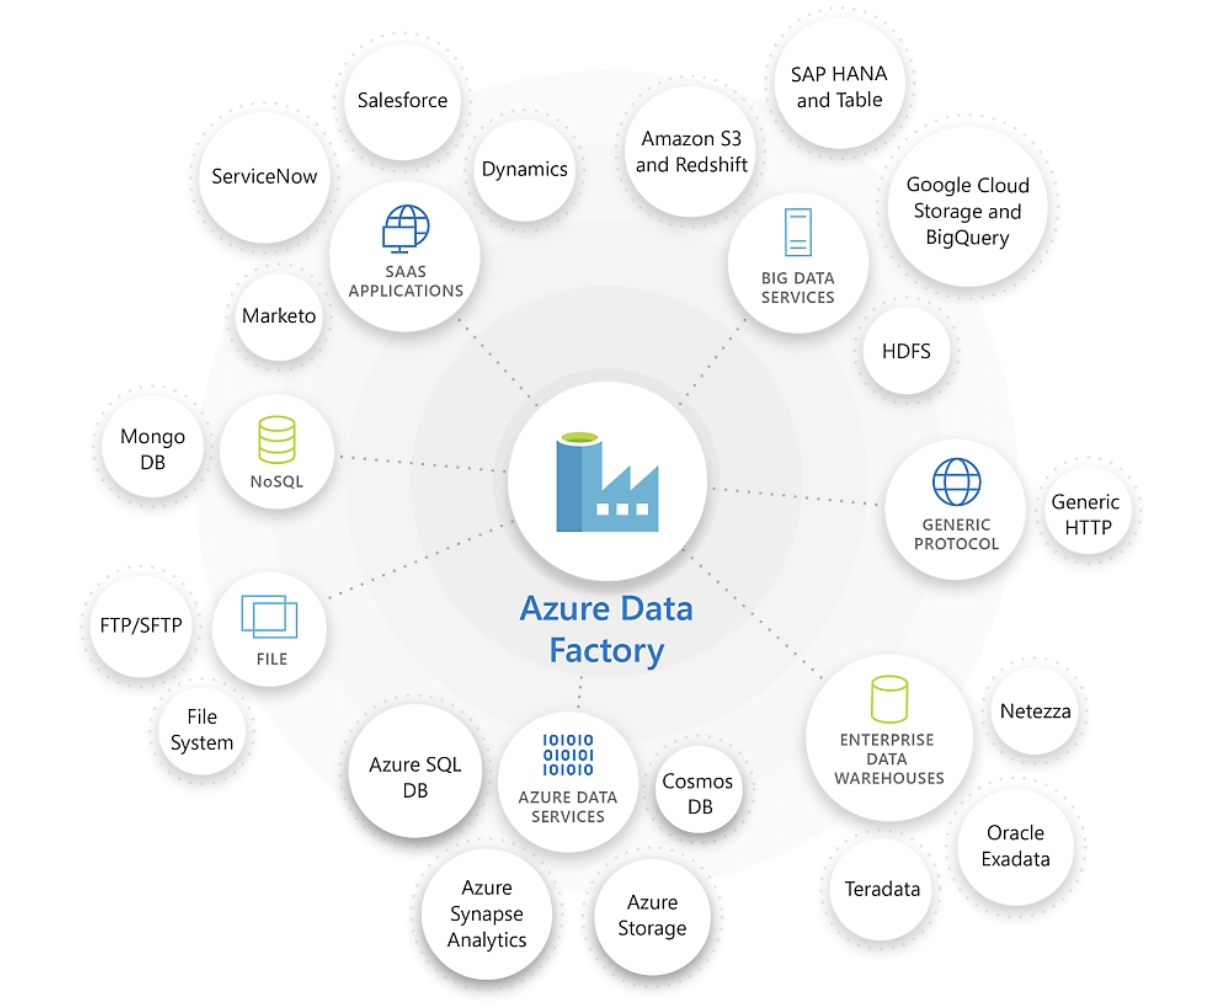
Azure Data Factory blinkt uit in het verbinden en integreren van diverse databronnen. Afbeeldingsbron: Microsoft.
De cursus Introduction to Azure is een uitstekende bron voor wie met Azure wil beginnen. De cursus Azure Management and Governance is ideaal voor meer ervaren gebruikers.
Databricks is een analyticsplatform dat een collaboratieve omgeving biedt voor big data-verwerking en machine learning. Gebaseerd op Apache Spark is Databricks ontworpen om grootschalige dataverwerking aan te kunnen, zodat je complexe analyses kunt uitvoeren en machinelearningmodellen kunt ontwikkelen.
Databricks biedt een uniform platform waarop data engineers, data scientists en analisten kunnen samenwerken om data te verwerken, analyseren en visualiseren in een gestroomlijnde workflow.
Dit zijn enkele features die van Databricks zo’n populaire tool maken:
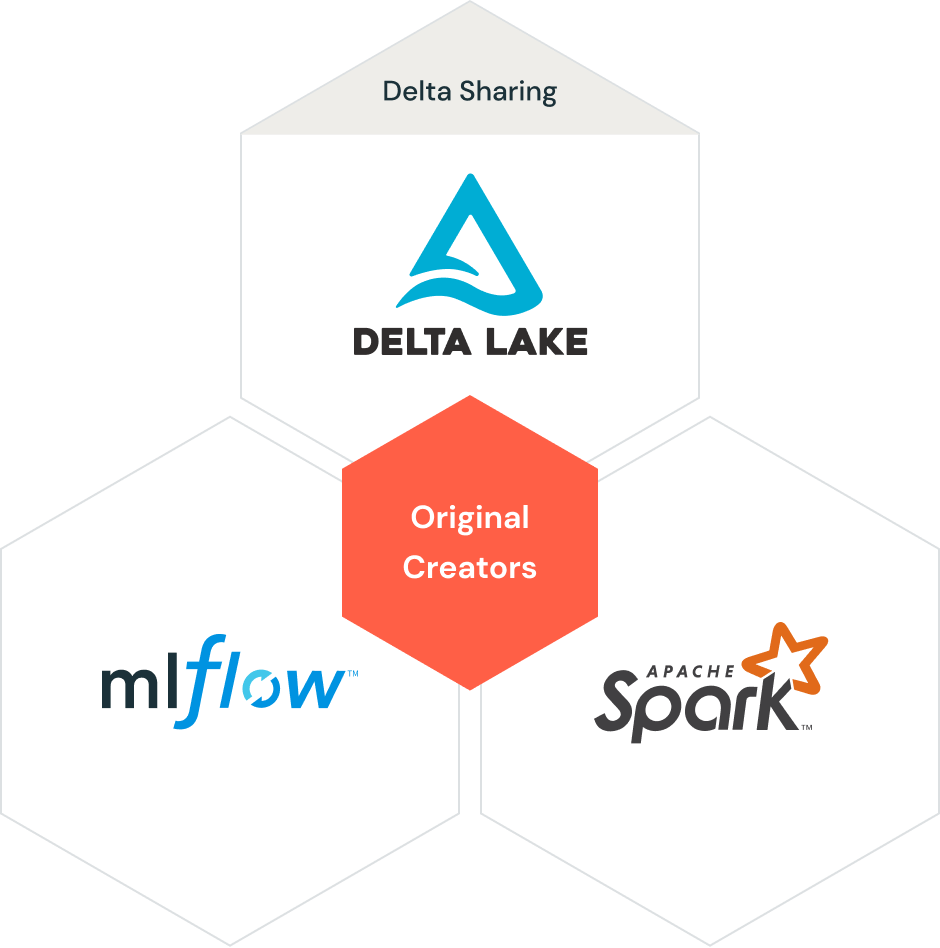
Architectuurelementen van het Databricks Data Lakehouse. Afbeeldingsbron: Databricks
Daar heb je het! Als Databricks je aandacht heeft getrokken vanwege de uitgebreide mogelijkheden, kun je beginnen met de cursus Introduction to Databricks.
Je ziet nu waarschijnlijk al hoe ADF en Databricks van elkaar verschillen. Laten we nu dieper ingaan op die verschillen binnen verschillende categorieën.
Azure Data Factory is primair ontworpen voor data-integratie en orkestratie. Het blinkt uit in het verplaatsen van data tussen diverse bronnen, het transformeren ervan en het laden in een centrale locatie voor verdere analyse. ADF is ideaal in scenario’s waarin je dataworkflows over meerdere omgevingen moet automatiseren en beheren.
Databricks daarentegen richt zich op dataverwerking, analytics en machine learning. Het is het voorkeursplatform voor bedrijven die grootschalige data-analyse willen uitvoeren, machinelearningmodellen willen ontwikkelen en willen samenwerken aan datascienceprojecten. Databricks is bijzonder geschikt voor bigdata-omgevingen en AI-gedreven toepassingen.
Azure Data Factory biedt mogelijkheden voor datatransformatie via de Data Flow-feature, waarmee gebruikers verschillende transformaties rechtstreeks binnen de pijplijn kunnen uitvoeren. Hoewel krachtig, zijn deze transformaties over het algemeen beter geschikt voor ETL-processen en mogelijk niet zo uitgebreid of flexibel als die van Databricks.
Databricks biedt, met zijn basis in Apache Spark, geavanceerde mogelijkheden voor datatransformatie. Gebruikers kunnen de volle kracht van Spark benutten om complexe transformaties, aggregaties en dataverwerkingstaken uit te voeren, waardoor het de voorkeurskeuze is voor scenario’s die zware datamanipulatie en -berekening vereisen.
Zowel ADF als Databricks integreren met andere Azure-services, maar met verschillende accenten. ADF is ontworpen voor ETL en orkestratie en is daarmee de ideale tool voor het beheren van dataworkflows die meerdere Azure-services omvatten, zoals Azure Synapse Analytics en Azure Blob Storage.
Databricks daarentegen is meer gericht op geavanceerde analytics en AI, met integratie met services zoals Delta Lake voor dataopslag en Azure Machine Learning voor modeluitrol.
De drag-and-drop-interface van Azure Data Factory maakt het relatief eenvoudig in gebruik, zelfs voor wie beperkte technische kennis heeft. De focus op low-code/no-code pijplijnontwikkeling vereenvoudigt het maken en beheren van dataworkflows.
Hoewel krachtig, vereist Databricks een hoger niveau van technische vaardigheid. De afhankelijkheid van coderen (in talen zoals Python, Scala en SQL) en complexe configuratieopties maken het geschikter voor data engineers en -scientists die comfortabel zijn met code en bigdataframeworks.
ADF en Databricks zijn zeer schaalbaar, maar blinken uit op verschillende gebieden. ADF is ontworpen om grootschalige data-integratie- en migratietaken aan te kunnen en is daardoor ideaal voor het orkestreren van complexe ETL-workflows.
Databricks biedt, met zijn fundament in Apache Spark, ongeëvenaarde prestaties voor bigdataverwerking en analytics, waardoor het de voorkeurskeuze is voor scenario’s die high-performance computing en schaalbaarheid vereisen.
Bij het overwegen van de kosten van Azure Data Factory en Databricks is het essentieel om hun prijsmodellen te begrijpen en hoe die je budget kunnen beïnvloeden:
Houd bij het evalueren van kosten rekening met de specifieke behoeften van je organisatie, zoals het datavolume, de complexiteit van transformaties en de frequentie van pijplijnuitvoering.
In sommige gevallen kan het gebruik van ADF voor orkestratie en Databricks voor verwerking een gebalanceerde aanpak bieden, waarbij je de sterke punten van beide tools benut en de kosten effectief beheert.
Hieronder staat een tabel met een vergelijking tussen Azure Data Factory en Databricks over een breed scala aan aspecten:
|
Categorie |
Azure Data Factory (ADF) |
Databricks |
|
Overzicht |
Een cloudgebaseerde data-integratieservice voor het orkestreren en automatiseren van dataverplaatsing en -transformatie. |
Een uniform analyticsplatform gericht op bigdataverwerking en machine learning. |
|
Primaire use-case |
Data-integratie, ETL/ELT-pijplijnen, dataorkestratie en workflowautomatisering. |
Big data-analytics, realtime dataverwerking en machine learning. |
|
Datatransformatie |
Wordt primair gebruikt om datatransformaties te orkestreren, met ingebouwde of externe compute-resources zoals Databricks of Synapse Spark-pools. |
Geavanceerde, grootschalige datatransformatie met Apache Spark en Delta Lake voor zowel batch- als realtimeverwerking. |
|
ETL/ELT |
Gespecialiseerd in ETL/ELT-orkestratie, het verbinden van meerdere databronnen en -bestemmingen, met ingebouwde activiteiten zoals copy data, data flow en Azure-services. |
Krachtige ETL-mogelijkheden, vooral voor complexe bigdatatransformaties, met gebruik van Apache Spark voor in-memory verwerking. |
|
Compute-engine |
Heeft geen eigen compute-engine; vertrouwt op externe compute-opties zoals Azure Databricks, Azure Synapse of Azure HDInsight voor datatransformatie. |
Apache Spark-gebaseerde compute-engine voor realtime- en batchverwerking. |
|
Databeweging |
Biedt een breed scala aan ingebouwde connectors (bijv. voor databases, cloudopslag, SaaS-platforms) en is daardoor geschikt voor het orkestreren van grootschalige databeweging over verschillende omgevingen. |
Integreert doorgaans met opslagoplossingen zoals Azure Data Lake, S3 en Delta Lake, maar databeweging is niet de primaire focus. |
|
Dataintegratie |
Sterke dataintegratiemogelijkheden met ondersteuning voor meer dan 90 connectors, inclusief Azure-services, on-prem-databases en systemen van derden. |
Dataintegratie is vooral gericht op bigdataopslag- en verwerkingsplatforms (Azure Data Lake, Delta Lake). Minder divers in connectoropties. |
|
Dataverwerking |
Maakt gebruik van data flows om data op schaal te transformeren met visuele, low-code mapping. Voor meer geavanceerde transformaties wordt Databricks of Azure Synapse gebruikt. |
Geavanceerde dataverwerking met Spark; geoptimaliseerd voor realtime- en grootschalige batchworkloads. |
|
Samenwerking |
Pijplijnsamenwerking via Git-integratie (Azure DevOps en GitHub). |
Geavanceerde samenwerkingsfeatures met Databricks Workspaces en geïntegreerde versiecontrole met GitHub of Databricks Repos. |
|
Developer experience |
Drag-and-drop-UI voor het bouwen van ETL-workflows; eenvoudig voor niet-technische gebruikers om datapijplijnen te maken. |
Geavanceerde developer experience, met een notebookomgeving en ondersteuning voor codegebaseerde transformaties (Python, Scala, R, SQL). |
|
Planning & orkestratie |
Uitstekende plannings- en orkestratiemogelijkheden, met triggers en controle over pijplijnuitvoering. |
Beperkte orkestratiemogelijkheden. Databricks kan extern georkestreerd worden met ADF of andere tools. |
|
Data governance |
Integratie met Azure Purview voor data governance, lineage-tracking en metadatabeheer. |
Governance wordt doorgaans extern afgehandeld, met tools zoals Azure Purview of andere oplossingen van derden. |
|
Monitoring & logging |
Ingebouwde monitoring en logging via Azure Monitor, Alerts en het ADF-monitoringdashboard. |
Uitgebreide logging- en monitoringsmogelijkheden via de Databricks REST API, integratie met Azure Monitor en aangepaste dashboards. |
|
Schaalbaarheid |
Schaalt eenvoudig met on-demand data-integratie en databeweging. Gebruikt externe compute-services om dataverwerking op te schalen. |
Zeer schaalbaar, vooral voor grote dataworkloads en machinelearningpijplijnen, met automatische clusterschaalvergroting. |
|
Kostenmodel |
Betalen per gebruik op basis van databeweging, orkestratie en de gebruikte externe compute-services (Databricks, Synapse, enz.). |
Pay-as-you-go voor opslag en compute. Clusters kunnen automatisch schalen voor kostenoptimalisatie. |
|
Machine learning |
Geen ingebouwde machinelearningmogelijkheden. Machine learning kan worden geïntegreerd door services zoals Azure ML of Databricks te orkestreren. |
Ingebouwde machinelearningbibliotheken zoals MLlib en integraties met MLflow voor modeltracking en -beheer. |
|
Beveiliging |
Role-based access control (RBAC), integratie met Azure Active Directory, ingebouwde data-encryptie en managed identities. |
RBAC, data-encryptie, integratie met Azure Active Directory en aangepaste beveiligingsmodellen. |
|
BI-integratie |
Kan datapijplijnen orkestreren en data aanleveren aan BI-tools zoals Power BI, Azure Synapse Analytics en andere Azure-services. |
Ondersteunt integratie met BI-tools zoals Power BI, Tableau en andere voor directe dataconsumptie. |
|
Realtime dataverwerking |
Kan realtime data-ingestie orkestreren met triggers en realtime compute-services gebruiken zoals Stream Analytics of Databricks. |
Geoptimaliseerd voor realtime dataverwerking met Spark Streaming. |
|
Gebruiksgemak |
Gebruiksvriendelijk met een low-code-interface, waardoor niet-technische gebruikers eenvoudig datapijplijnen kunnen bouwen. |
Vereist meer technische kennis, omdat het is gericht op bigdata-engineers, data scientists en developers. |
|
Multi-cloud-ondersteuning |
Primair gericht op Azure, maar kan via connectors met enkele andere clouddiensten verbinden. |
Ondersteunt multicloud-omgevingen, waaronder Azure, AWS en GCP. |
|
Deployment |
Volledig beheerde service met automatische updates en schaalvergroting van pijplijnen. |
Beheerde service, maar met meer controle voor gebruikers over clusterconfiguraties en -schaalvergroting. |
|
Community & ecosysteem |
Uitgebreide Azure-community, met sterke ondersteuning van Microsoft en integratie in het Azure-ecosysteem. |
Grote community, met aanzienlijke bijdragen van Databricks en de open-source Apache Spark-community. |
|
Compliance & certificeringen |
Voldoet aan diverse industrienormen, waaronder GDPR, HIPAA en ISO-certificeringen. |
Voldoet ook aan verschillende industrienormen en certificeringen, waaronder GDPR, HIPAA en SOC-compliance. |
Azure Data Factory is de voorkeurskeuze in scenario’s waarin data-integratie en -migratie de primaire aandachtspunten zijn. Meer specifiek is het ideaal voor:
Databricks is het voorkeursplatform voor scenario’s die bigdataverwerking, analytics en machine learning vereisen. Het is het best geschikt voor:
In veel gevallen kunnen Azure Data Factory en Databricks samen worden gebruikt om een volledige datapijplijn te creëren.
ADF kan de datapijplijn orkestreren en het extraheren, transformeren en laden van data uit verschillende bronnen beheren. Databricks kan vervolgens de complexere dataverwerkings- en analytische taken uitvoeren, waarbij het zijn geavanceerde mogelijkheden op het gebied van bigdataverwerking en machine learning benut.
Een typische end-to-end datapijplijn kan bijvoorbeeld inhouden dat ADF data uit meerdere bronnen extraheert en in een data lake laadt. Databricks kan de data vervolgens verwerken, geavanceerde transformaties uitvoeren en machinelearningmodellen toepassen voordat de resultaten in een datawarehouse worden geladen voor verdere analyse.
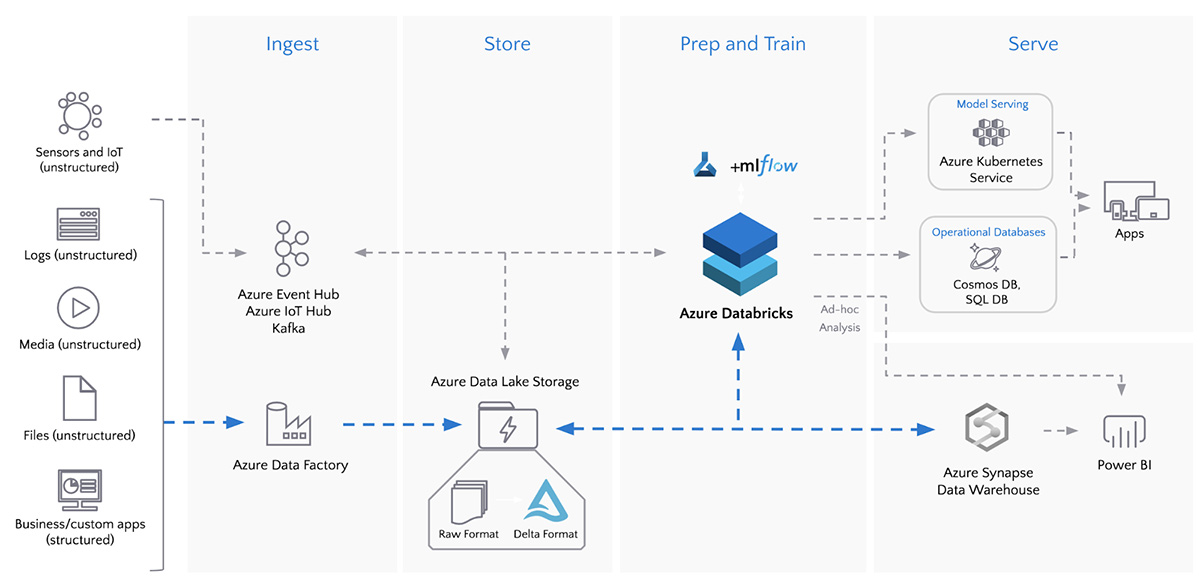
Batch-ETL met Azure Data Factory en Azure Databricks. Afbeeldingsbron: Databricks
Azure Data Factory en Databricks zijn krachtige tools binnen het Azure-ecosysteem, elk met hun eigen sterke punten en ideale use-cases. In veel gevallen kan het combineren van ADF en Databricks een complete oplossing bieden die het beste van twee werelden benut!
Voor wie dieper in deze platforms wil duiken, bekijk de volgende bronnen:
Deze bronnen bieden een solide basis om Azure Data Factory en Databricks te begrijpen en hoe je ze kunt gebruiken om krachtige datapijplijnen en analyticssoplossingen te bouwen.
Leer meer over Azure en de services met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

