
Corso
Comprendere l'architettura e i servizi di Microsoft Azure
2 ore
22.3K
Pratica and corso your progress.
Continua Con GoogleIntegrare, elaborare e analizzare i dati in modo efficiente è fondamentale per le organizzazioni che puntano a ottenere insight e mantenere un vantaggio competitivo.
Due strumenti potenti, Azure Data Factory e Databricks, si sono affermati come soluzioni di punta per la gestione delle pipeline di dati e l’analisi avanzata nell’ecosistema Azure. Sebbene a prima vista possano sembrare simili, rispondono a esigenze diverse della data engineering e dell’analytics.
In questo articolo esploreremo le funzionalità di Azure Data Factory e Databricks, ne confronteremo le caratteristiche e forniremo indicazioni su quando usare ciascuno strumento.
Azure Data Factory (ADF) è un servizio ETL (Extract, Transform, Load) basato sul cloud che consente integrazione, migrazione e orchestrazione dei dati tra vari archivi. È progettato per facilitare lo spostamento e la trasformazione dei dati da fonti eterogenee verso posizioni centralizzate, dove possono essere analizzati e sfruttati per
business intelligence.
Con ADF puoi creare e gestire pipeline di dati che automatizzano l’estrazione da più fonti, la trasformazione in un formato utilizzabile e il caricamento in una destinazione per l’analisi.
Queste sono le funzionalità più interessanti di ADF, in ordine sparso:
Come vedi, ADF offre tutto ciò che ti serve per creare pipeline di dati nell’ecosistema Azure!
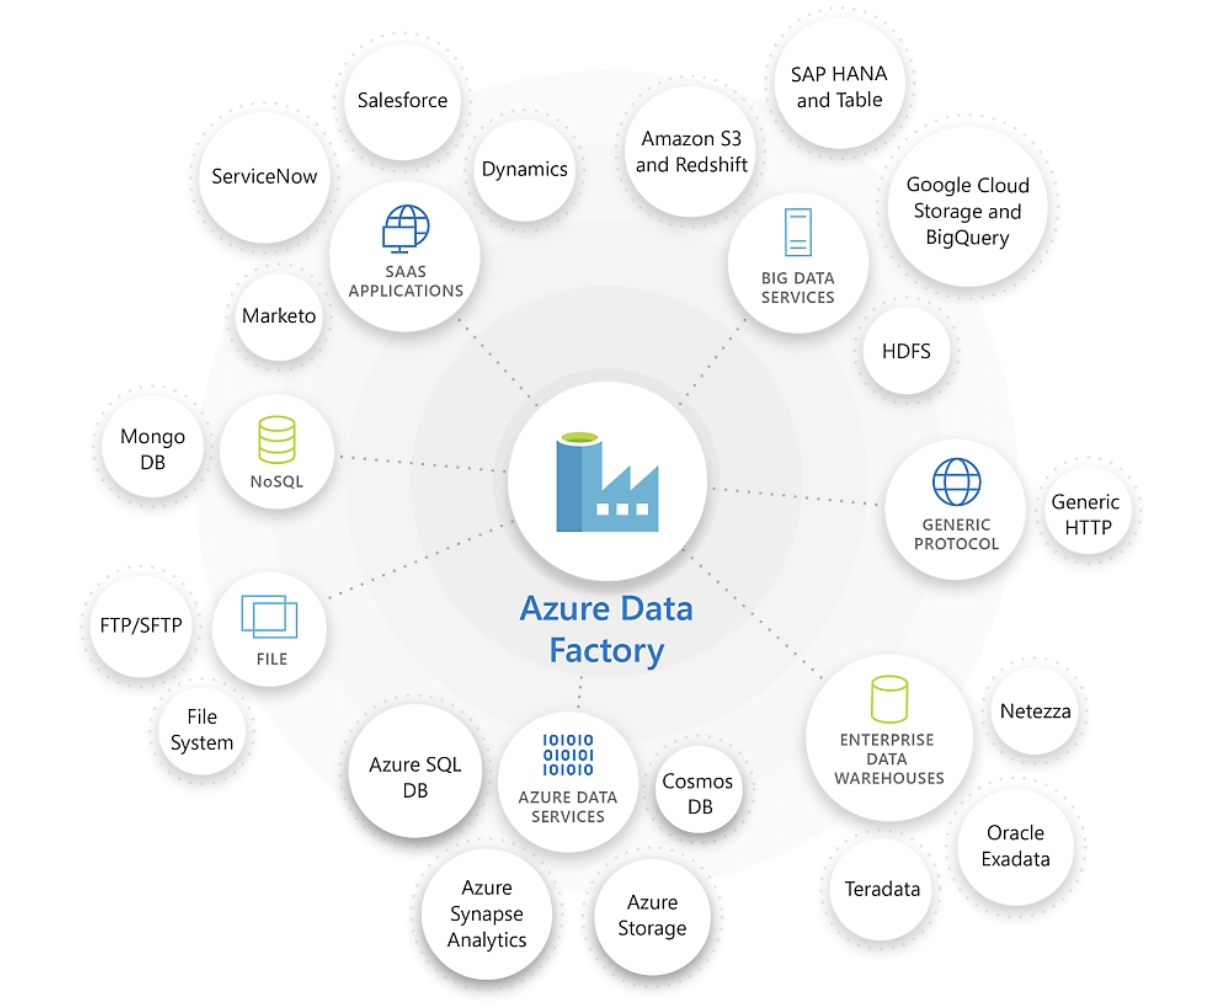
Azure Data Factory eccelle nel connettere e integrare fonti di dati eterogenee. Fonte immagine: Microsoft.
Il corso Introduction to Azure è un’ottima risorsa per chi vuole iniziare con Azure. Il corso Azure Management and Governance è ideale per chi ha già esperienza.
Databricks è una piattaforma di analytics che offre un ambiente collaborativo per l’elaborazione di big data e il machine learning. Basata su Apache Spark, Databricks è progettata per gestire attività di elaborazione dati su larga scala, consentendoti di eseguire analisi complesse e sviluppare modelli di machine learning.
Databricks offre una piattaforma unificata su cui data engineer, data scientist e analisti possono collaborare per elaborare, analizzare e visualizzare i dati in un workflow snello.
Ecco alcune delle caratteristiche che rendono Databricks uno strumento così popolare:
Elementi dell’architettura Databricks Data Lakehouse. Fonte immagine: Databricks
Ecco fatto! Se Databricks ha catturato la tua attenzione per le sue ampie capacità, puoi iniziare con il corso Introduction to Databricks.
A questo punto dovresti riuscire a vedere come ADF e Databricks differiscono tra loro. Ora andiamo più a fondo e analizziamo queste differenze in diverse categorie.
Azure Data Factory è progettato principalmente per l’integrazione e l’orchestrazione dei dati. Eccelle nello spostare i dati tra varie fonti, trasformarli e caricarli in una posizione centralizzata per ulteriori analisi. ADF è ideale quando devi automatizzare e gestire workflow di dati in più ambienti.
Databricks, invece, è incentrato su elaborazione dati, analytics e machine learning. È la piattaforma di riferimento per le aziende che vogliono effettuare analisi su larga scala, sviluppare modelli di machine learning e collaborare su progetti di data science. Databricks è particolarmente adatto ad ambienti big data e ad applicazioni guidate dall’AI.
Azure Data Factory fornisce funzionalità di trasformazione tramite Data Flow, che consente di eseguire varie trasformazioni direttamente nella pipeline. Pur essendo potente, questo approccio è generalmente più adatto ai processi ETL e potrebbe non essere così esteso o flessibile quanto quello offerto da Databricks.
Databricks, grazie alle basi in Apache Spark, offre funzionalità avanzate di trasformazione. Gli utenti possono sfruttare tutta la potenza di Spark per eseguire trasformazioni, aggregazioni e attività di elaborazione complesse, diventando la scelta preferita quando servono manipolazioni e calcoli intensivi sui dati.
Sia ADF che Databricks si integrano con altri servizi Azure, ma con focus diversi. ADF è pensato per ETL e orchestrazione, quindi è lo strumento ideale per gestire workflow di dati che coinvolgono più servizi Azure come Azure Synapse Analytics e Azure Blob Storage.
Databricks, invece, è più focalizzato su analytics avanzata e AI, integrandosi con servizi come Delta Lake per l’archiviazione dei dati e Azure Machine Learning per il deployment dei modelli.
L’interfaccia drag-and-drop di Azure Data Factory lo rende relativamente facile da usare, anche per chi ha competenze tecniche limitate. Il focus sullo sviluppo di pipeline low-code/no-code semplifica la creazione e la gestione dei workflow di dati.
Pur essendo potente, Databricks richiede un livello di competenza tecnica più elevato. L’uso del codice (in linguaggi come Python, Scala e SQL) e le opzioni di configurazione complesse lo rendono più adatto a data engineer e data scientist a loro agio con il codice e i framework big data.
ADF e Databricks sono altamente scalabili, ma eccellono in aree diverse. ADF è progettato per gestire integrazione e migrazione dei dati su larga scala, risultando ideale per orchestrare workflow ETL complessi.
Databricks, grazie alle fondamenta in Apache Spark, offre prestazioni senza pari per l’elaborazione e l’analisi di big data, diventando la scelta preferita quando servono calcolo ad alte prestazioni e scalabilità.
Quando valuti i costi di Azure Data Factory e Databricks, è essenziale comprenderne i modelli di prezzo e come possono incidere sul budget:
Nella valutazione dei costi, considera le esigenze specifiche della tua organizzazione, come volume dei dati, complessità delle trasformazioni e frequenza di esecuzione delle pipeline.
In alcuni casi, usare ADF per l’orchestrazione e Databricks per l’elaborazione può offrire un approccio bilanciato, sfruttando i punti di forza di entrambi e gestendo efficacemente i costi.
Di seguito trovi una tabella che confronta Azure Data Factory e Databricks su un’ampia gamma di aspetti:
|
Categoria |
Azure Data Factory (ADF) |
Databricks |
|
Panoramica |
Servizio di integrazione dati basato sul cloud per orchestrare e automatizzare lo spostamento e la trasformazione dei dati. |
Piattaforma di analytics unificata incentrata su big data processing e machine learning. |
|
Caso d’uso primario |
Integrazione dati, pipeline ETL/ELT, orchestrazione dei dati e automazione dei workflow. |
Big data analytics, elaborazione dati in tempo reale e machine learning. |
|
Trasformazione dei dati |
Usato principalmente per orchestrare trasformazioni, con risorse di calcolo integrate o esterne come Databricks o pool Spark di Synapse. |
Trasformazioni avanzate e su larga scala con Apache Spark e Delta Lake, sia batch che in tempo reale. |
|
ETL/ELT |
Specializzato nell’orchestrazione ETL/ELT, collegando più fonti e destinazioni, con attività integrate come copia dati, data flow e servizi Azure. |
Capacità ETL potenti, soprattutto per trasformazioni big data complesse, sfruttando l’elaborazione in-memory di Apache Spark. |
|
Motore di calcolo |
Non dispone di un motore di calcolo nativo; si affida a opzioni esterne come Azure Databricks, Azure Synapse o Azure HDInsight per le trasformazioni. |
Motore di calcolo basato su Apache Spark per elaborazione in tempo reale e batch. |
|
Spostamento dei dati |
Offre un’ampia gamma di connettori integrati (ad es. per database, cloud storage, piattaforme SaaS), rendendolo adatto a orchestrare movimenti di dati su larga scala attraverso ambienti diversi. |
Si integra tipicamente con soluzioni di storage come Azure Data Lake, S3 e Delta Lake, ma lo spostamento dei dati non è il focus principale. |
|
Integrazione dei dati |
Forti capacità di integrazione con oltre 90 connettori, inclusi servizi Azure, database on-prem e sistemi di terze parti. |
Integrazione focalizzata soprattutto su piattaforme di archiviazione ed elaborazione big data (Azure Data Lake, Delta Lake). Meno diversificato nelle opzioni di connettori. |
|
Elaborazione dei dati |
Sfrutta i data flow per trasformare dati su larga scala con mapping visuale e low-code. Per trasformazioni più avanzate, utilizza Databricks o Azure Synapse. |
Elaborazione avanzata con Spark; ottimizzato per workload batch su larga scala e in tempo reale. |
|
Collaborazione |
Collaborazione sulle pipeline tramite integrazione Git (Azure DevOps e GitHub). |
Funzionalità di collaborazione avanzate con Databricks Workspaces e controllo versione integrato con GitHub o Databricks Repos. |
|
Esperienza sviluppatore |
Interfaccia drag-and-drop per costruire workflow ETL; semplice per utenti non tecnici creare pipeline di dati. |
Esperienza sviluppatore avanzata, con ambiente a notebook e supporto a trasformazioni basate su codice (Python, Scala, R, SQL). |
|
Pianificazione e orchestrazione |
Ottime capacità di pianificazione e orchestrazione, con trigger e controllo dell’esecuzione delle pipeline. |
Capacità di orchestrazione limitate. Databricks può essere orchestrato esternamente tramite ADF o altri strumenti. |
|
Data governance |
Integrazione con Azure Purview per governance dei dati, tracciamento della lineage e gestione dei metadati. |
La governance è in genere gestita esternamente, con strumenti come Azure Purview o soluzioni di terze parti. |
|
Monitoraggio e logging |
Monitoraggio e logging integrati tramite Azure Monitor, Alerts e dashboard di monitoraggio di ADF. |
Capacità estese di logging e monitoraggio tramite REST API di Databricks, integrazione con Azure Monitor e dashboard personalizzate. |
|
Scalabilità |
Scala facilmente con integrazione e movimento dati on demand. Usa servizi di calcolo esterni per scalare l’elaborazione. |
Altamente scalabile, soprattutto per grandi workload di dati e pipeline di machine learning, con autoscaling dei cluster. |
|
Modello di costo |
Pay-per-use basato su movimento dati, orchestrazione e servizi di calcolo esterni utilizzati (Databricks, Synapse, ecc.). |
Pay-as-you-go per storage e compute. I cluster possono essere auto-scalati per ottimizzare i costi. |
|
Machine learning |
Nessuna funzionalità ML integrata. Il machine learning può essere integrato orchestrando servizi come Azure ML o Databricks. |
Librerie ML integrate come MLlib e integrazioni con MLflow per il tracciamento e la gestione dei modelli. |
|
Sicurezza |
Controllo di accesso basato sui ruoli (RBAC), integrazione con Azure Active Directory, crittografia integrata dei dati e managed identities. |
RBAC, crittografia dei dati, integrazione con Azure Active Directory e modelli di sicurezza personalizzati. |
|
Integrazione BI |
Può orchestrare pipeline e alimentare strumenti BI come Power BI, Azure Synapse Analytics e altri servizi Azure. |
Supporta l’integrazione con strumenti BI come Power BI, Tableau e altri per il consumo diretto dei dati. |
|
Elaborazione dati in tempo reale |
Può orchestrare l’ingestione in tempo reale con trigger e usare servizi di calcolo real-time come Stream Analytics o Databricks. |
Ottimizzato per l’elaborazione in tempo reale con Spark Streaming. |
|
Facilità d’uso |
Intuitivo con interfaccia low-code, facilita agli utenti non tecnici la creazione di pipeline di dati. |
Richiede maggiori competenze tecniche, poiché è focalizzato su big data engineer, data scientist e sviluppatori. |
|
Supporto multi-cloud |
Focalizzato principalmente su Azure, ma può connettersi ad alcuni altri servizi cloud tramite connettori. |
Supporta ambienti multi-cloud, inclusi Azure, AWS e GCP. |
|
Deployment |
Servizio completamente gestito con aggiornamenti automatizzati e scaling delle pipeline. |
Servizio gestito, ma con maggiore controllo agli utenti su configurazioni e scaling dei cluster. |
|
Community ed ecosistema |
Vasta community Azure, con forte supporto da Microsoft e integrazione nell’ecosistema Azure. |
Ampia community, con contributi significativi da Databricks e dalla community open-source di Apache Spark. |
|
Compliance e certificazioni |
Conforme a vari standard di settore, inclusi GDPR, HIPAA e certificazioni ISO. |
Anch’essa conforme a vari standard e certificazioni, tra cui GDPR, HIPAA e conformità SOC. |
Azure Data Factory è la scelta preferita negli scenari in cui l’integrazione e la migrazione dei dati sono le priorità. Più nello specifico, è ideale per:
Databricks è la piattaforma di riferimento quando servono elaborazione big data, analytics e machine learning. È particolarmente adatto per:
In molti casi, Azure Data Factory e Databricks possono essere usati insieme per creare una pipeline di dati completa.
ADF può orchestrare la pipeline, gestendo l’estrazione, la trasformazione e il caricamento dei dati da varie fonti. Databricks può quindi occuparsi dell’elaborazione e dell’analisi più complesse, sfruttando le sue capacità avanzate nel big data processing e nel machine learning.
Ad esempio, una pipeline end-to-end tipica può prevedere che ADF estragga dati da più fonti e li carichi in un data lake. Databricks potrebbe quindi elaborare i dati, applicare trasformazioni avanzate e modelli di machine learning, prima che i risultati vengano caricati in un data warehouse per ulteriori analisi.
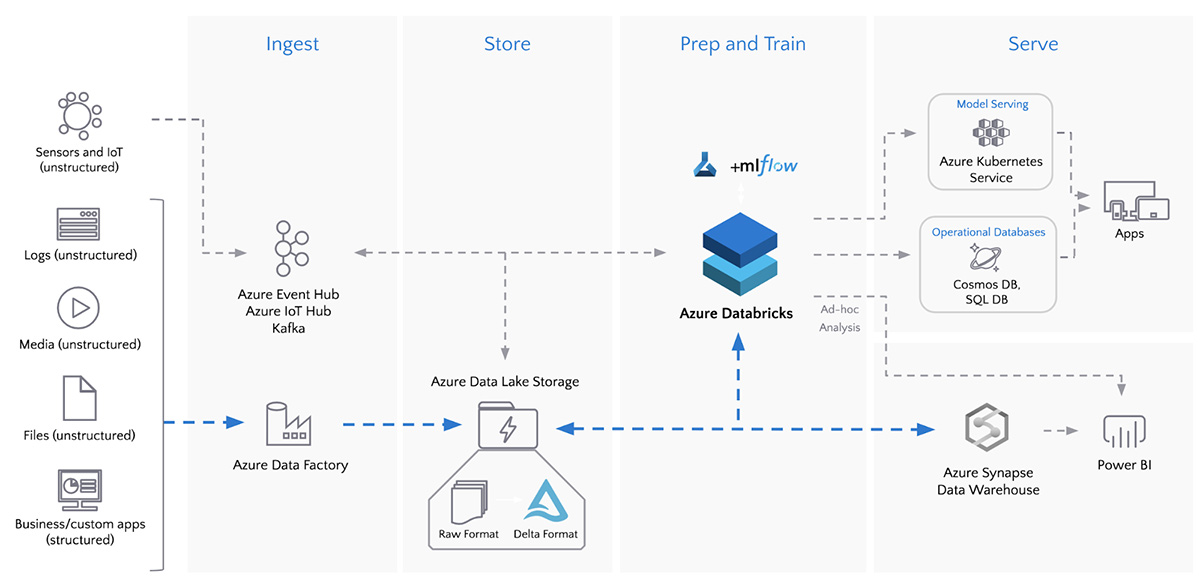
Batch ETL con Azure Data Factory e Azure Databricks. Fonte immagine: Databricks
Azure Data Factory e Databricks sono strumenti potenti dell’ecosistema Azure, ciascuno con i propri punti di forza e casi d’uso ideali. In molti casi, combinarli può offrire una soluzione completa che unisce il meglio di entrambi i mondi!
Se vuoi approfondire queste piattaforme, valuta le seguenti risorse:
Queste risorse offrono basi solide per comprendere Azure Data Factory e Databricks e come usarli per costruire pipeline e soluzioni di analytics potenti.
Approfondisci Azure e i suoi servizi con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



