
उपयोग में सरलता
Azure Data Factory का ड्रैग-एंड-ड्रॉप इंटरफ़ेस, सीमित तकनीकी विशेषज्ञता वाले उपयोगकर्ताओं के लिए भी, इसे अपेक्षाकृत उपयोग में आसान बनाता है। इसका लो-कोड/नो-कोड पाइपलाइन विकास पर फोकस डेटा वर्कफ़्लो बनाना और प्रबंधित करना सरल करता है।
शक्तिशाली होते हुए भी, Databricks के लिए उच्च स्तर की तकनीकी दक्षता की आवश्यकता होती है। कोडिंग (Python, Scala, और SQL जैसी भाषाओं में) और जटिल कॉन्फ़िगरेशन विकल्पों पर इसकी निर्भरता इसे उन डेटा इंजीनियरों और वैज्ञानिकों के लिए अधिक उपयुक्त बनाती है जो कोड और बिग डेटा फ़्रेमवर्क के साथ सहज हैं।
स्केलेबिलिटी और प्रदर्शन
ADF और Databricks दोनों अत्यधिक स्केलेबल हैं, लेकिन अलग-अलग क्षेत्रों में उत्कृष्ट हैं। ADF बड़े पैमाने पर डेटा एकीकरण और माइग्रेशन कार्यों को संभालने के लिए डिज़ाइन किया गया है, जो जटिल ETL वर्कफ़्लो के ऑर्केस्ट्रेशन के लिए आदर्श है।
Databricks, जो Apache Spark पर आधारित है, बिग डेटा प्रोसेसिंग और एनालिटिक्स के लिए अद्वितीय प्रदर्शन प्रदान करता है, जिससे यह उच्च-प्रदर्शन कंप्यूटिंग और स्केलेबिलिटी की आवश्यकता वाले परिदृश्यों के लिए पसंदीदा विकल्प बनता है।
लागत संबंधी विचार
Azure Data Factory और Databricks के उपयोग की लागत पर विचार करते समय, उनके प्राइसिंग मॉडल को समझना और यह जानना आवश्यक है कि वे आपके बजट को कैसे प्रभावित कर सकते हैं:
- ADF की प्राइसिंग पाइपलाइन गतिविधियों की संख्या, डेटा मूवमेंट, और डेटा वॉल्यूम पर आधारित है। जटिल पाइपलाइनों और बड़े डेटा वॉल्यूम के साथ लागत बढ़ सकती है, लेकिन सीधे-सादे ETL कार्यों के लिए ADF आमतौर पर किफायती है।
- Databricks प्राइसिंग प्रयुक्त कम्प्यूटेशनल संसाधनों पर आधारित है, जिसे आमतौर पर प्रति घंटे Databricks Units (DBUs) में मापा जाता है। बड़े पैमाने की डेटा प्रोसेसिंग और मशीन लर्निंग वर्कलोड के लिए, विशेषकर जब उच्च-प्रदर्शन क्लस्टर्स की आवश्यकता हो, लागत में उल्लेखनीय वृद्धि हो सकती है।
लागत का मूल्यांकन करते समय, अपने संगठन की विशिष्ट आवश्यकताओं पर विचार करें, जैसे डेटा की मात्रा, ट्रांसफ़ॉर्मेशन की जटिलता, और पाइपलाइन निष्पादन की आवृत्ति।
कुछ मामलों में, ऑर्केस्ट्रेशन के लिए ADF और प्रोसेसिंग के लिए Databricks का उपयोग एक संतुलित दृष्टिकोण दे सकता है, जिससे दोनों टूल की ताकतों का लाभ उठाते हुए लागतों का प्रभावी प्रबंधन किया जा सके।
Azure Data Factory बनाम Databricks: एक सारांश
नीचे कई पहलुओं में Azure Data Factory और Databricks की तुलना करने वाली एक तालिका दी गई है:
|
श्रेणी |
Azure Data Factory (ADF) |
Databricks |
|
सारांश |
डेटा मूवमेंट और ट्रांसफ़ॉर्मेशन के ऑर्केस्ट्रेशन और स्वचालन के लिए क्लाउड-आधारित डेटा इंटीग्रेशन सेवा। |
बिग डेटा प्रोसेसिंग और मशीन लर्निंग पर केंद्रित एकीकृत एनालिटिक्स प्लेटफ़ॉर्म। |
|
प्रमुख उपयोग मामला |
डेटा इंटीग्रेशन, ETL/ELT पाइपलाइन्स, डेटा ऑर्केस्ट्रेशन, और वर्कफ़्लो ऑटोमेशन। |
बिग डेटा एनालिटिक्स, रीयल-टाइम डेटा प्रोसेसिंग, और मशीन लर्निंग। |
|
डेटा ट्रांसफ़ॉर्मेशन |
मुख्यतः डेटा ट्रांसफ़ॉर्मेशन के ऑर्केस्ट्रेशन के लिए उपयोग, बिल्ट-इन या बाहरी कम्प्यूट संसाधनों जैसे Databricks या Synapse Spark पूल्स का उपयोग। |
Apache Spark और Delta Lake के साथ उन्नत, बड़े पैमाने पर डेटा ट्रांसफ़ॉर्मेशन, बैच और रीयल-टाइम दोनों के लिए। |
|
ETL/ELT |
ETL/ELT ऑर्केस्ट्रेशन में विशेषज्ञ, कई डेटा स्रोतों और डेस्टिनेशनों को जोड़ना, और copy data, data flow, तथा Azure सेवाओं जैसी बिल्ट-इन गतिविधियाँ। |
शक्तिशाली ETL क्षमताएँ, विशेषकर जटिल बिग डेटा ट्रांसफ़ॉर्मेशन के लिए, इन-मैमोरी प्रोसेसिंग हेतु Apache Spark का लाभ। |
|
कम्प्यूट इंजन |
नैटिव कम्प्यूट इंजन नहीं है; डेटा ट्रांसफ़ॉर्मेशन के लिए Azure Databricks, Azure Synapse, या Azure HDInsight जैसे बाहरी कम्प्यूट विकल्पों पर निर्भर। |
Apache Spark-आधारित कम्प्यूट इंजन, रीयल-टाइम और बैच प्रोसेसिंग के लिए। |
|
डेटा मूवमेंट |
इनबिल्ट कनेक्टर्स की विस्तृत श्रृंखला (जैसे डेटाबेस, क्लाउड स्टोरेज, SaaS प्लेटफ़ॉर्म) प्रदान करता है, जिससे विभिन्न वातावरणों में बड़े पैमाने पर डेटा मूवमेंट के ऑर्केस्ट्रेशन के लिए उपयुक्त। |
आम तौर पर Azure Data Lake, S3, और Delta Lake जैसे स्टोरेज समाधानों के साथ एकीकृत होता है, लेकिन डेटा मूवमेंट प्राथमिक फोकस नहीं है। |
|
डेटा इंटीग्रेशन |
90 से अधिक कनेक्टर्स के समर्थन के साथ मजबूत डेटा इंटीग्रेशन क्षमताएँ, जिनमें Azure सेवाएँ, ऑन-प्रिम डेटाबेस, और थर्ड-पार्टी सिस्टम शामिल हैं। |
डेटा इंटीग्रेशन मुख्यतः बिग डेटा स्टोरेज और प्रोसेसिंग प्लेटफ़ॉर्म (Azure Data Lake, Delta Lake) पर केंद्रित। कनेक्टर विकल्पों में कम विविधता। |
|
डेटा प्रोसेसिंग |
विज़ुअल, लो-कोड मैपिंग के साथ बड़े पैमाने पर डेटा ट्रांसफ़ॉर्मेशन के लिए Data Flows का लाभ उठाता है। अधिक उन्नत ट्रांसफ़ॉर्मेशन के लिए Databricks या Azure Synapse का उपयोग करता है। |
Spark का उपयोग कर उन्नत डेटा प्रोसेसिंग; रीयल-टाइम और बड़े पैमाने की बैच वर्कलोड्स के लिए अनुकूलित। |
|
सहयोग |
Git इंटीग्रेशन (Azure DevOps और GitHub) के माध्यम से पाइपलाइन सहयोग। |
Databricks Workspaces और GitHub या Databricks Repos के साथ इंटीग्रेटेड वर्ज़न कंट्रोल के साथ उन्नत सहयोग सुविधाएँ। |
|
डेवलपर अनुभव |
ETL वर्कफ़्लोज़ बनाने के लिए ड्रैग-एंड-ड्रॉप UI; गैर-तकनीकी उपयोगकर्ताओं के लिए डेटा पाइपलाइन बनाना आसान। |
उन्नत डेवलपर अनुभव, नोटबुक वातावरण और कोड-आधारित ट्रांसफ़ॉर्मेशन (Python, Scala, R, SQL) का समर्थन। |
|
शेड्यूलिंग और ऑर्केस्ट्रेशन |
ट्रिगर्स और पाइपलाइन निष्पादन नियंत्रण के साथ उत्कृष्ट शेड्यूलिंग और ऑर्केस्ट्रेशन क्षमताएँ। |
सीमित ऑर्केस्ट्रेशन क्षमताएँ। Databricks को बाहरी रूप से ADF या अन्य टूल्स के माध्यम से ऑर्केस्ट्रेट किया जा सकता है। |
|
डेटा गवर्नेंस |
डेटा गवर्नेंस, लिनिएज ट्रैकिंग, और मेटाडेटा मैनेजमेंट के लिए Azure Purview के साथ इंटीग्रेशन। |
गवर्नेंस आमतौर पर बाहरी रूप से संभाली जाती है, जैसे Azure Purview या अन्य थर्ड-पार्टी समाधानों का उपयोग। |
|
मॉनिटरिंग और लॉगिंग |
Azure Monitor, अलर्ट्स, और ADF के मॉनिटरिंग डैशबोर्ड के माध्यम से बिल्ट-इन मॉनिटरिंग और लॉगिंग। |
Databricks REST API, Azure Monitor के साथ इंटीग्रेशन, और कस्टम डैशबोर्ड्स के माध्यम से व्यापक लॉगिंग और मॉनिटरिंग क्षमताएँ। |
|
स्केलेबिलिटी |
ऑन-डिमांड डेटा इंटीग्रेशन और डेटा मूवमेंट के साथ आसानी से स्केल करता है। डेटा प्रोसेसिंग को स्केल करने के लिए बाहरी कम्प्यूट सेवाओं का उपयोग करता है। |
अत्यधिक स्केलेबल, विशेषकर बड़े डेटा वर्कलोड्स और मशीन लर्निंग पाइपलाइन्स के लिए, स्वचालित क्लस्टर स्केलिंग के साथ। |
|
कॉस्ट मॉडल |
डेटा मूवमेंट, ऑर्केस्ट्रेशन, और प्रयुक्त बाहरी कम्प्यूट सेवाओं (Databricks, Synapse, आदि) के आधार पर पे-पर-यूज़। |
स्टोरेज और कम्प्यूट के लिए पे-एज़-यू-गो। लागत अनुकूलन हेतु क्लस्टर्स ऑटो-स्केल किए जा सकते हैं। |
|
मशीन लर्निंग |
बिल्ट-इन मशीन लर्निंग क्षमताएँ नहीं। Azure ML या Databricks जैसी सेवाओं का ऑर्केस्ट्रेशन करके ML एकीकृत किया जा सकता है। |
MLlib जैसी बिल्ट-इन मशीन लर्निंग लाइब्रेरीज़ और मॉडल ट्रैकिंग व मैनेजमेंट के लिए MLflow के साथ इंटीग्रेशन। |
|
सुरक्षा |
रोल-आधारित एक्सेस कंट्रोल (RBAC), Azure Active Directory के साथ इंटीग्रेशन, बिल्ट-इन डेटा एन्क्रिप्शन, और मैनेज्ड आइडेंटिटीज़। |
RBAC, डेटा एन्क्रिप्शन, Azure Active Directory के साथ इंटीग्रेशन, और कस्टम सुरक्षा मॉडल्स। |
|
BI इंटीग्रेशन |
डेटा पाइपलाइनों का ऑर्केस्ट्रेशन कर Power BI, Azure Synapse Analytics, और अन्य Azure सेवाओं जैसी BI टूल्स को डेटा फीड कर सकता है। |
Power BI, Tableau, और अन्य BI टूल्स के साथ डायरेक्ट डेटा कंजम्प्शन हेतु इंटीग्रेशन का समर्थन। |
|
रीयल-टाइम डेटा प्रोसेसिंग |
ट्रिगर्स के साथ रीयल-टाइम डेटा इन्जेशन का ऑर्केस्ट्रेशन कर सकता है, और Stream Analytics या Databricks जैसी रीयल-टाइम कम्प्यूट सेवाओं का उपयोग कर सकता है। |
Spark Streaming का उपयोग कर रीयल-टाइम डेटा प्रोसेसिंग के लिए अनुकूलित। |
|
उपयोग में सरलता |
लो-कोड इंटरफ़ेस के साथ उपयोगकर्ता-अनुकूल, जिससे गैर-तकनीकी उपयोगकर्ताओं के लिए डेटा पाइपलाइन बनाना आसान हो जाता है। |
अधिक तकनीकी ज्ञान की आवश्यकता, क्योंकि यह बिग डेटा इंजीनियर्स, डेटा वैज्ञानिकों, और डेवलपर्स पर केंद्रित है। |
|
मल्टी-क्लाउड समर्थन |
मुख्य रूप से Azure पर केंद्रित, लेकिन कनेक्टर्स का उपयोग कर कुछ अन्य क्लाउड सेवाओं से कनेक्ट कर सकता है। |
Azure, AWS, और GCP सहित मल्टी-क्लाउड वातावरण का समर्थन। |
|
परिनियोजन |
पूरी तरह मैनेज्ड सेवा, जिसमें पाइपलाइनों के स्वचालित अपडेट और स्केलिंग शामिल हैं। |
मैनेज्ड सेवा, लेकिन क्लस्टर कॉन्फ़िगरेशन और स्केलिंग पर उपयोगकर्ताओं को अधिक नियंत्रण देता है। |
|
समुदाय और इकोसिस्टम |
विस्तृत Azure समुदाय, Microsoft से मजबूत समर्थन, और Azure इकोसिस्टम में गहरा एकीकरण। |
बड़ा समुदाय, Databricks और ओपन-सोर्स Apache Spark समुदाय से महत्वपूर्ण योगदान के साथ। |
|
कम्प्लायंस और प्रमाणन |
विभिन्न उद्योग मानकों के अनुरूप, जिनमें GDPR, HIPAA, और ISO प्रमाणन शामिल हैं। |
GDPR, HIPAA, और SOC कम्प्लायंस सहित विभिन्न उद्योग मानकों और प्रमाणनों को भी पूरा करता है। |
Azure Data Factory कब उपयोग करें
वे परिदृश्य जहाँ प्राथमिक चिंता डेटा इंटीग्रेशन और माइग्रेशन है, वहाँ Azure Data Factory पसंदीदा विकल्प है। विशेष रूप से, यह इनके लिए आदर्श है:
- डेटा इंटीग्रेशन और माइग्रेशन: जब संगठनों को ऑन-प्रिमाइसेज़ और क्लाउड-आधारित वातावरण सहित विभिन्न स्रोतों के बीच डेटा स्थानांतरित करना हो, ADF ऐसा करने के लिए आवश्यक टूल्स प्रदान करता है।
- डेटा पाइपलाइनों का ऑर्केस्ट्रेशन: ADF कई डेटा स्रोतों में डेटा वर्कफ़्लो को प्रबंधित और स्वचालित करने में उत्कृष्ट है, जिससे यह जटिल डेटा वातावरण वाले संगठनों के लिए आदर्श बनता है।
- सरल से मध्यम डेटा ट्रांसफ़ॉर्मेशन: ADF का Data Flow फीचर बेसिक से लेकर मध्यम जटिलता वाले ETL ट्रांसफ़ॉर्मेशन के लिए पर्याप्त क्षमताएँ प्रदान करता है।
- शेड्यूलिंग और मॉनिटरिंग की आवश्यकता वाले ETL वर्कफ़्लोज़: ADF के बिल्ट-इन शेड्यूलिंग और मॉनिटरिंग टूल्स ETL वर्कफ़्लोज़ का स्वचालन और उनके प्रदर्शन को ट्रैक करना आसान बनाते हैं।
Databricks कब उपयोग करें
वे परिदृश्य जिनमें बिग डेटा प्रोसेसिंग, एनालिटिक्स, और मशीन लर्निंग की आवश्यकता होती है, उनके लिए Databricks पसंदीदा प्लेटफ़ॉर्म है। यह इनके लिए सबसे उपयुक्त है:
- बिग डेटा प्रोसेसिंग और एनालिटिक्स: Databricks बड़े डेटासेट्स को प्रोसेस करने में उत्कृष्ट है, जिससे यह विशाल मात्रा के डेटा का विश्लेषण करने वाले संगठनों के लिए आदर्श बनता है।
- मशीन लर्निंग और AI मॉडल विकास: Databricks मशीन लर्निंग मॉडल विकसित और परिनियोजित करने के लिए उन्नत टूल्स प्रदान करता है, जिससे यह AI-संचालित एप्लिकेशनों के लिए एक शक्तिशाली प्लेटफ़ॉर्म बनता है।
- सहयोगात्मक डेटा साइंस वातावरण: Databricks की सहयोगात्मक नोटबुक्स डेटा वैज्ञानिकों और विश्लेषकों को रीयल-टाइम में सहयोग करने देती हैं, जिससे टीम-आधारित डेटा साइंस प्रोजेक्ट्स सुगम होते हैं।
- Apache Spark के साथ जटिल डेटा ट्रांसफ़ॉर्मेशन: जब भारी डेटा हेर-फेर और कम्प्यूटेशन की आवश्यकता होती है, तो Databricks के Apache Spark-आधारित ट्रांसफ़ॉर्मेशन जटिल कार्यों को संभालने के लिए आवश्यक शक्ति और लचीलापन प्रदान करते हैं।
Azure Data Factory और Databricks का एकीकरण
कई मामलों में, Azure Data Factory और Databricks को साथ में उपयोग कर व्यापक डेटा पाइपलाइन बनाई जा सकती है।
ADF डेटा पाइपलाइन का ऑर्केस्ट्रेशन कर सकता है, विभिन्न स्रोतों से डेटा के एक्स्ट्रैक्शन, ट्रांसफ़ॉर्मेशन, और लोडिंग का प्रबंधन करते हुए। इसके बाद Databricks अपने बिग डेटा प्रोसेसिंग और मशीन लर्निंग की उन्नत क्षमताओं का उपयोग करते हुए अधिक जटिल डेटा प्रोसेसिंग और एनालिटिक्स कार्य कर सकता है।
उदाहरण के लिए, एक सामान्य एंड-टू-एंड डेटा पाइपलाइन में ADF मल्टिपल स्रोतों से डेटा निकालकर उसे डेटा लेक में लोड कर सकता है। इसके बाद Databricks डेटा को प्रोसेस कर सकता है, उन्नत ट्रांसफ़ॉर्मेशन कर सकता है, और मशीन लर्निंग मॉडल लागू कर सकता है, जिसके बाद परिणामों को आगे के विश्लेषण के लिए डेटा वेयरहाउस में लोड किया जाता है।
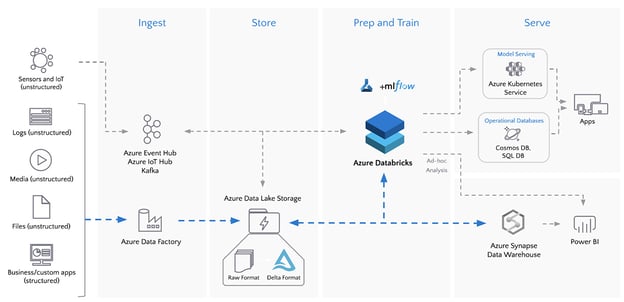
Azure Data Factory और Azure Databricks के साथ बैच ETL। छवि स्रोत: Databricks
निष्कर्ष
Azure पारिस्थितिकी तंत्र में Azure Data Factory और Databricks दोनों ही शक्तिशाली टूल हैं, जिनकी अपनी-अपनी ताकतें और आदर्श उपयोग के मामले हैं। कई स्थितियों में, ADF और Databricks को साथ मिलाकर उपयोग करने से दोनों दुनियाओं का सर्वश्रेष्ठ लाभ उठाने वाला एक व्यापक समाधान मिल सकता है!
जो लोग इन प्लेटफ़ॉर्म्स में और गहराई से जाना चाहते हैं, वे निम्न संसाधनों का अन्वेषण कर सकते हैं:
ये संसाधन Azure Data Factory और Databricks को समझने और शक्तिशाली डेटा पाइपलाइन्स और एनालिटिक्स समाधान बनाने में उनके उपयोग के लिए ठोस नींव प्रदान करते हैं।
FAQs
Azure Data Factory और Databricks के बीच प्राथमिक अंतर क्या हैं?
Azure Data Factory मुख्य रूप से डेटा इंटीग्रेशन, माइग्रेशन, और ऑर्केस्ट्रेशन के लिए उपयोग होता है, जबकि Databricks बिग डेटा प्रोसेसिंग, उन्नत एनालिटिक्स, और मशीन लर्निंग के लिए डिज़ाइन किया गया है।
क्या Azure Data Factory और Databricks को साथ में उपयोग किया जा सकता है?
हाँ, ADF को जटिल डेटा प्रोसेसिंग कार्यों के लिए Databricks को शामिल करने वाली डेटा पाइपलाइनों के ऑर्केस्ट्रेशन में उपयोग किया जा सकता है, जिससे एक व्यापक डेटा प्रबंधन समाधान बनता है।
डेटा ट्रांसफ़ॉर्मेशन के लिए कौन सा टूल बेहतर है: Azure Data Factory या Databricks?
Databricks Apache Spark का उपयोग कर अधिक उन्नत डेटा ट्रांसफ़ॉर्मेशन क्षमताएँ प्रदान करता है, जिससे यह जटिल ट्रांसफ़ॉर्मेशन के लिए बेहतर उपयुक्त है। ADF अधिक सीधे-सादे ETL कार्यों के लिए आदर्श है।
Azure Data Factory का उपयोग करने की लागत Databricks की तुलना में कैसी है?
सीधे-सादे ETL कार्यों के लिए ADF आमतौर पर अधिक किफायती होता है, जबकि बड़े पैमाने की एनालिटिक्स और मशीन लर्निंग के लिए आवश्यक कम्प्यूटेशनल संसाधनों के कारण Databricks महँगा हो सकता है।
क्या Azure Data Factory बिग डेटा प्रोसेसिंग के लिए उपयुक्त है?
हालाँकि ADF बड़े डेटा वॉल्यूम संभाल सकता है, यह डेटा इंटीग्रेशन और ऑर्केस्ट्रेशन पर अधिक केंद्रित है। उच्च-प्रदर्शन बिग डेटा प्रोसेसिंग के लिए Databricks बेहतर विकल्प है।

लीड BI कंसल्टेंट - Power BI प्रमाणित | Azure प्रमाणित | पूर्व-Microsoft | पूर्व-Tableau | पूर्व-Salesforce - लेखक
डेटा को प्रभावी ढंग से एकीकृत करना, संसाधित करना, और विश्लेषित करना उन संगठनों के लिए महत्वपूर्ण है जो इनसाइट्स प्राप्त करना और प्रतिस्पर्धात्मक बढ़त बनाए रखना चाहते हैं।
Azure पारिस्थितिकी तंत्र में डेटा पाइपलाइनों के प्रबंधन और उन्नत एनालिटिक्स करने के लिए दो शक्तिशाली टूल—Azure Data Factory और Databricks—अग्रणी समाधान के रूप में उभरे हैं। पहली नज़र में ये टूल समान दिख सकते हैं, लेकिन ये डेटा इंजीनियरिंग और एनालिटिक्स के अलग-अलग पहलुओं को संबोधित करते हैं।
इस लेख में, हम Azure Data Factory और Databricks की क्षमताओं का अन्वेषण करेंगे, उनकी विशेषताओं की तुलना करेंगे, और यह समझ प्रदान करेंगे कि किस टूल का उपयोग कब करना चाहिए।
Azure Data Factory क्या है?
Azure Data Factory (ADF) एक क्लाउड-आधारित ETL (Extract, Transform, Load) सेवा है, जो विभिन्न डेटा स्टोर्स में डेटा एकीकरण, माइग्रेशन, और ऑर्केस्ट्रेशन सक्षम करती है। इसका उद्देश्य भिन्न-भिन्न स्रोतों से डेटा को स्थानांतरित और रूपांतरित कर केंद्रीकृत स्थानों तक पहुँचाना है, जहाँ इसका उपयोग किया जा सके
बिज़नेस इंटेलिजेंस के लिए।
ADF के साथ, आप डेटा पाइपलाइन बना और प्रबंधित कर सकते हैं जो कई स्रोतों से डेटा निकालने, उसे उपयोगी प्रारूप में रूपांतरित करने, और विश्लेषण के लिए गंतव्य में लोड करने की प्रक्रिया को स्वचालित करती हैं।
Azure Data Factory की विशेषताएँ
ADF की कुछ प्रमुख विशेषताएँ, किसी विशेष क्रम में नहीं:
जैसा कि आप देख सकते हैं, ADF Azure पारिस्थितिकी तंत्र के भीतर डेटा पाइपलाइनों के लिए आपको आवश्यक हर चीज़ प्रदान करता है!
Azure Data Factory विविध डेटा स्रोतों से कनेक्ट और एकीकृत करने में उत्कृष्ट है। छवि स्रोत: Microsoft.
Introduction to Azure कोर्स Azure से शुरुआत करने के इच्छुक लोगों के लिए एक उत्कृष्ट संसाधन है। Azure Management and Governance कोर्स अधिक अनुभवी लोगों के लिए आदर्श है।
Databricks क्या है?
Databricks एक एनालिटिक्स प्लेटफ़ॉर्म है जो बिग डेटा प्रोसेसिंग और मशीन लर्निंग के लिए सहयोगात्मक वातावरण प्रदान करता है। Apache Spark पर आधारित, Databricks बड़े पैमाने पर डेटा प्रोसेसिंग कार्यों को संभालने के लिए डिज़ाइन किया गया है, जिससे आप जटिल एनालिटिक्स कर सकें और मशीन लर्निंग मॉडल विकसित कर सकें।
Databricks एक एकीकृत प्लेटफ़ॉर्म प्रदान करता है, जहाँ डेटा इंजीनियर, डेटा वैज्ञानिक, और विश्लेषक सुव्यवस्थित वर्कफ़्लो में डेटा को प्रोसेस, विश्लेषित और विज़ुअलाइज़ करने के लिए सहयोग कर सकते हैं।
Databricks की विशेषताएँ
ये कुछ विशेषताएँ हैं जो Databricks को इतना लोकप्रिय टूल बनाती हैं:
Databricks Data Lakehouse आर्किटेक्चर तत्व। छवि स्रोत: Databricks
बस इतना ही! यदि Databricks ने अपनी व्यापक क्षमताओं के कारण आपका ध्यान खींचा है, तो आप Introduction to Databricks कोर्स से शुरुआत कर सकते हैं।
Azure Data Factory बनाम Databricks: मुख्य अंतर
इस बिंदु पर, आप देख पाएंगे कि ADF और Databricks एक-दूसरे से कैसे भिन्न हैं। अब, आइए गहराई में जाकर इन अंतरों का विभिन्न श्रेणियों के तहत विश्लेषण करते हैं।
उद्देश्य और उपयोग के मामले
Azure Data Factory मुख्य रूप से डेटा एकीकरण और ऑर्केस्ट्रेशन के लिए डिज़ाइन किया गया है। यह विभिन्न स्रोतों के बीच डेटा को स्थानांतरित करने, उसे रूपांतरित करने, और आगे के विश्लेषण के लिए केंद्रीकृत स्थान में लोड करने में उत्कृष्ट है। ADF उन परिदृश्यों के लिए आदर्श है जहाँ आपको कई वातावरणों में डेटा वर्कफ़्लो को स्वचालित और प्रबंधित करना होता है।
दूसरी ओर, Databricks डेटा प्रोसेसिंग, एनालिटिक्स, और मशीन लर्निंग पर केंद्रित है। यह उन कंपनियों के लिए पसंदीदा प्लेटफ़ॉर्म है जो बड़े पैमाने पर डेटा विश्लेषण करना, मशीन लर्निंग मॉडल विकसित करना, और डेटा साइंस प्रोजेक्ट्स पर सहयोग करना चाहती हैं। Databricks विशेष रूप से बिग डेटा वातावरण और AI-संचालित एप्लिकेशनों के लिए उपयुक्त है।
डेटा ट्रांसफ़ॉर्मेशन क्षमताएँ
Azure Data Factory अपने Data Flow फीचर के माध्यम से डेटा ट्रांसफ़ॉर्मेशन क्षमताएँ प्रदान करता है, जो उपयोगकर्ताओं को सीधे पाइपलाइन के भीतर विभिन्न ट्रांसफ़ॉर्मेशन करने देता है। यद्यपि शक्तिशाली हैं, ये ट्रांसफ़ॉर्मेशन सामान्यतः ETL प्रक्रियाओं के लिए अधिक उपयुक्त हैं और Databricks की तुलना में उतने व्यापक या लचीले नहीं हो सकते।
Databricks, जो Apache Spark पर आधारित है, उन्नत डेटा ट्रांसफ़ॉर्मेशन क्षमताएँ प्रदान करता है। उपयोगकर्ता Spark की पूरी शक्ति का उपयोग करके जटिल ट्रांसफ़ॉर्मेशन, एग्रीगेशन, और डेटा प्रोसेसिंग कार्य कर सकते हैं, जिससे यह भारी डेटा हेर-फेर और कम्प्यूटेशन की आवश्यकता वाले परिदृश्यों के लिए पसंदीदा विकल्प बनता है।
अन्य Azure सेवाओं के साथ एकीकरण
ADF और Databricks दोनों अन्य Azure सेवाओं के साथ एकीकृत होते हैं, लेकिन अलग फोकस के साथ। ADF ETL और ऑर्केस्ट्रेशन के लिए डिज़ाइन किया गया है, जिससे यह Azure Synapse Analytics और Azure Blob Storage जैसी कई Azure सेवाओं को शामिल करने वाले डेटा वर्कफ़्लो प्रबंधित करने का आदर्श टूल बनता है।
दूसरी ओर, Databricks उन्नत एनालिटिक्स और AI पर अधिक केंद्रित है, और डेटा स्टोरेज के लिए Delta Lake तथा मॉडल परिनियोजन के लिए Azure Machine Learning जैसी सेवाओं के साथ एकीकृत होता है।