
Khóa học
Tìm hiểu Kiến trúc và Dịch vụ Microsoft Azure
2 giờ
22.3K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleKhả năng tích hợp, xử lý và phân tích dữ liệu hiệu quả rất quan trọng đối với các tổ chức muốn rút ra insight và duy trì lợi thế cạnh tranh.
Hai công cụ mạnh mẽ, Azure Data Factory và Databricks, đã nổi lên như những giải pháp hàng đầu để quản lý pipeline dữ liệu và thực hiện phân tích nâng cao trong hệ sinh thái Azure. Mặc dù thoạt nhìn chúng có vẻ tương đồng, nhưng mỗi công cụ lại giải quyết những khía cạnh khác nhau của kỹ thuật dữ liệu và phân tích.
Trong bài viết này, chúng ta sẽ khám phá năng lực của Azure Data Factory và Databricks, so sánh các tính năng của chúng, và cung cấp góc nhìn về thời điểm nên sử dụng từng công cụ.
Azure Data Factory (ADF) là dịch vụ ETL (Extract, Transform, Load) trên đám mây cho phép tích hợp, di chuyển và điều phối dữ liệu trên nhiều kho dữ liệu khác nhau. Nó được thiết kế để hỗ trợ việc di chuyển và biến đổi dữ liệu từ các nguồn rời rạc về những vị trí tập trung, nơi dữ liệu có thể được phân tích và tận dụng cho
business intelligence.
Với ADF, bạn có thể tạo và quản lý các pipeline dữ liệu tự động hóa quy trình trích xuất dữ liệu từ nhiều nguồn, biến đổi dữ liệu thành định dạng có thể sử dụng, và nạp dữ liệu vào đích đến để phân tích.
Dưới đây là những tính năng thú vị nhất của ADF, không theo thứ tự cụ thể:
Như bạn thấy, ADF cung cấp mọi thứ bạn cần để tạo các pipeline dữ liệu trong hệ sinh thái Azure!
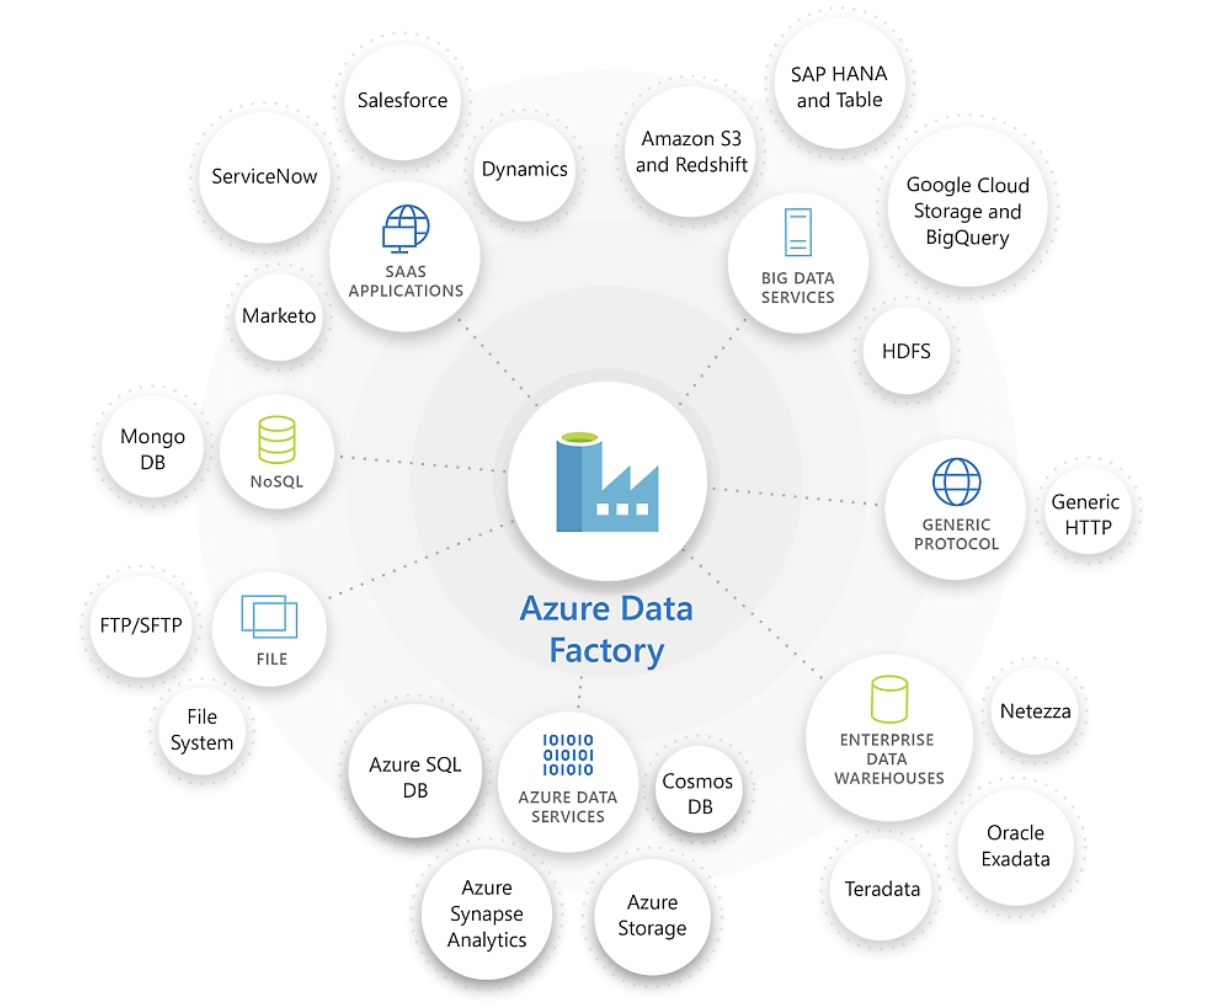
Azure Data Factory xuất sắc trong việc kết nối và tích hợp các nguồn dữ liệu đa dạng. Nguồn ảnh: Microsoft.
Khóa học Giới thiệu về Azure là nguồn tài liệu tuyệt vời cho những ai muốn bắt đầu với Azure. Khóa học Quản trị và Quản trị tổng thể Azure phù hợp với những người đã có kinh nghiệm.
Databricks là một nền tảng phân tích cung cấp môi trường cộng tác cho xử lý dữ liệu lớn và machine learning. Dựa trên Apache Spark, Databricks được thiết kế để xử lý các tác vụ xử lý dữ liệu quy mô lớn, cho phép bạn thực hiện phân tích phức tạp và phát triển mô hình machine learning.
Databricks cung cấp một nền tảng hợp nhất nơi kỹ sư dữ liệu, nhà khoa học dữ liệu và nhà phân tích có thể cộng tác để xử lý, phân tích và trực quan hóa dữ liệu trong một quy trình làm việc liền mạch.
Dưới đây là một số tính năng khiến Databricks trở thành công cụ phổ biến:
Các thành phần kiến trúc Databricks Data Lakehouse. Nguồn ảnh: Databricks
Vậy là xong! Nếu Databricks thu hút bạn nhờ khả năng phong phú, bạn có thể bắt đầu với khóa học Giới thiệu về Databricks.
Đến đây, có lẽ bạn đã thấy ADF và Databricks khác nhau như thế nào. Giờ hãy đi sâu hơn và phân tích các khác biệt theo nhiều khía cạnh.
Azure Data Factory chủ yếu được thiết kế cho tích hợp dữ liệu và điều phối. Nó vượt trội trong việc di chuyển dữ liệu giữa nhiều nguồn, biến đổi dữ liệu và nạp vào vị trí tập trung để phân tích. ADF lý tưởng cho các kịch bản cần tự động hóa và quản lý luồng công việc dữ liệu trên nhiều môi trường.
Ngược lại, Databricks tập trung vào xử lý dữ liệu, phân tích và machine learning. Đây là nền tảng ưu tiên cho các công ty muốn thực hiện phân tích dữ liệu quy mô lớn, phát triển mô hình machine learning và cộng tác trong các dự án khoa học dữ liệu. Databricks đặc biệt phù hợp với môi trường dữ liệu lớn và các ứng dụng vận hành bằng AI.
Azure Data Factory cung cấp khả năng biến đổi dữ liệu thông qua tính năng Data Flow, cho phép người dùng thực hiện nhiều biến đổi trực tiếp trong pipeline. Dù mạnh mẽ, các biến đổi này thường phù hợp hơn với quy trình ETL và có thể không linh hoạt hay mở rộng như những gì Databricks cung cấp.
Databricks, với nền tảng là Apache Spark, cung cấp khả năng biến đổi dữ liệu nâng cao. Người dùng có thể tận dụng toàn bộ sức mạnh của Spark để thực hiện các biến đổi, tổng hợp và tác vụ xử lý dữ liệu phức tạp, khiến nó trở thành lựa chọn ưu tiên cho các kịch bản đòi hỏi thao tác và tính toán dữ liệu nặng.
Cả ADF và Databricks đều tích hợp với các dịch vụ Azure khác nhưng tập trung khác nhau. ADF được thiết kế cho ETL và điều phối, là công cụ lý tưởng để quản lý các luồng công việc dữ liệu liên quan đến nhiều dịch vụ Azure như Azure Synapse Analytics và Azure Blob Storage.
Databricks, ngược lại, tập trung nhiều hơn vào phân tích nâng cao và AI, tích hợp với các dịch vụ như Delta Lake cho lưu trữ dữ liệu và Azure Machine Learning để triển khai mô hình.
Giao diện kéo-thả của Azure Data Factory giúp việc sử dụng tương đối dễ dàng, ngay cả với những người có kiến thức kỹ thuật hạn chế. Trọng tâm low-code/no-code trong phát triển pipeline giúp đơn giản hóa việc tạo và quản lý luồng công việc dữ liệu.
Mặc dù mạnh mẽ, Databricks đòi hỏi trình độ kỹ thuật cao hơn. Việc phụ thuộc vào viết mã (bằng các ngôn ngữ như Python, Scala và SQL) và các tùy chọn cấu hình phức tạp khiến nó phù hợp hơn với kỹ sư dữ liệu và nhà khoa học dữ liệu quen làm việc với mã và các framework dữ liệu lớn.
ADF và Databricks đều có khả năng mở rộng cao nhưng nổi trội ở các khía cạnh khác nhau. ADF được thiết kế để xử lý các tác vụ tích hợp và di chuyển dữ liệu quy mô lớn, phù hợp để điều phối các workflow ETL phức tạp.
Databricks, với nền tảng Apache Spark, mang lại hiệu năng vượt trội cho xử lý dữ liệu lớn và phân tích, là lựa chọn ưu tiên cho các kịch bản đòi hỏi điện toán hiệu năng cao và khả năng mở rộng.
Khi xem xét chi phí sử dụng Azure Data Factory và Databricks, điều quan trọng là phải hiểu mô hình định giá của chúng và cách chúng có thể tác động đến ngân sách của bạn:
Khi đánh giá chi phí, hãy cân nhắc nhu cầu cụ thể của tổ chức bạn, như khối lượng dữ liệu, độ phức tạp của biến đổi và tần suất chạy pipeline.
Trong một số trường hợp, sử dụng ADF để điều phối và Databricks để xử lý có thể là cách tiếp cận cân bằng, tận dụng điểm mạnh của cả hai công cụ đồng thời quản lý chi phí hiệu quả.
Dưới đây là bảng so sánh Azure Data Factory và Databricks trên nhiều khía cạnh:
|
Danh mục |
Azure Data Factory (ADF) |
Databricks |
|
Tổng quan |
Dịch vụ tích hợp dữ liệu trên đám mây để điều phối và tự động hóa di chuyển và biến đổi dữ liệu. |
Nền tảng phân tích hợp nhất tập trung vào xử lý dữ liệu lớn và machine learning. |
|
Trường hợp sử dụng chính |
Tích hợp dữ liệu, pipeline ETL/ELT, điều phối dữ liệu và tự động hóa workflow. |
Phân tích dữ liệu lớn, xử lý dữ liệu theo thời gian thực và machine learning. |
|
Biến đổi dữ liệu |
Chủ yếu dùng để điều phối biến đổi dữ liệu, sử dụng tài nguyên tính toán tích hợp sẵn hoặc bên ngoài như Databricks hoặc cụm Synapse Spark. |
Biến đổi dữ liệu nâng cao, quy mô lớn với Apache Spark và Delta Lake cho xử lý theo lô và thời gian thực. |
|
ETL/ELT |
Chuyên về điều phối ETL/ELT, kết nối nhiều nguồn và đích dữ liệu, với các hoạt động tích hợp như copy data, data flow và dịch vụ Azure. |
Khả năng ETL mạnh mẽ, đặc biệt cho các biến đổi dữ liệu lớn phức tạp, tận dụng Apache Spark cho xử lý trong bộ nhớ. |
|
Engine tính toán |
Không có engine tính toán gốc; dựa vào các tùy chọn tính toán bên ngoài như Azure Databricks, Azure Synapse hoặc Azure HDInsight để biến đổi dữ liệu. |
Engine tính toán dựa trên Apache Spark cho xử lý thời gian thực và theo lô. |
|
Di chuyển dữ liệu |
Cung cấp nhiều connector tích hợp sẵn (ví dụ: cho cơ sở dữ liệu, lưu trữ đám mây, nền tảng SaaS), phù hợp để điều phối di chuyển dữ liệu quy mô lớn trên các môi trường khác nhau. |
Thường tích hợp với các giải pháp lưu trữ như Azure Data Lake, S3 và Delta Lake, nhưng di chuyển dữ liệu không phải trọng tâm chính. |
|
Tích hợp dữ liệu |
Khả năng tích hợp dữ liệu mạnh với hơn 90 connector, bao gồm dịch vụ Azure, cơ sở dữ liệu on-prem và hệ thống bên thứ ba. |
Tích hợp dữ liệu chủ yếu tập trung vào nền tảng lưu trữ và xử lý dữ liệu lớn (Azure Data Lake, Delta Lake). Ít đa dạng về tùy chọn connector hơn. |
|
Xử lý dữ liệu |
Tận dụng data flow để biến đổi dữ liệu ở quy mô lớn bằng ánh xạ trực quan, low-code. Với các biến đổi nâng cao hơn, sử dụng Databricks hoặc Azure Synapse. |
Xử lý dữ liệu nâng cao bằng Spark; tối ưu cho khối lượng công việc theo thời gian thực và theo lô quy mô lớn. |
|
Cộng tác |
Cộng tác pipeline thông qua tích hợp Git (Azure DevOps và GitHub). |
Tính năng cộng tác nâng cao với Databricks Workspaces và kiểm soát phiên bản tích hợp với GitHub hoặc Databricks Repos. |
|
Trải nghiệm nhà phát triển |
Giao diện kéo-thả để xây dựng workflow ETL; dễ dàng cho người không chuyên kỹ thuật tạo pipeline dữ liệu. |
Trải nghiệm nâng cao cho nhà phát triển, cung cấp môi trường notebook và hỗ trợ biến đổi dựa trên mã (Python, Scala, R, SQL). |
|
Lập lịch & điều phối |
Khả năng lập lịch và điều phối xuất sắc, với trigger và kiểm soát thực thi pipeline. |
Khả năng điều phối hạn chế. Databricks có thể được điều phối bên ngoài bằng ADF hoặc công cụ khác. |
|
Quản trị dữ liệu |
Tích hợp với Azure Purview cho quản trị dữ liệu, theo dõi phả hệ và quản lý metadata. |
Quản trị thường được xử lý bên ngoài, sử dụng công cụ như Azure Purview hoặc giải pháp bên thứ ba khác. |
|
Giám sát & ghi log |
Giám sát và ghi log tích hợp sẵn qua Azure Monitor, Alerts và bảng điều khiển giám sát của ADF. |
Khả năng ghi log và giám sát phong phú thông qua Databricks REST API, tích hợp với Azure Monitor và dashboard tùy chỉnh. |
|
Khả năng mở rộng |
Dễ mở rộng với tích hợp và di chuyển dữ liệu theo nhu cầu. Sử dụng dịch vụ tính toán bên ngoài để mở rộng xử lý dữ liệu. |
Rất linh hoạt mở rộng, đặc biệt cho khối lượng dữ liệu lớn và pipeline machine learning, với auto-scaling cho cụm. |
|
Mô hình chi phí |
Trả theo mức sử dụng dựa trên di chuyển dữ liệu, điều phối và các dịch vụ tính toán bên ngoài (Databricks, Synapse, v.v.) được sử dụng. |
Trả theo mức sử dụng cho lưu trữ và tính toán. Cụm có thể auto-scale để tối ưu chi phí. |
|
Machine learning |
Không có khả năng machine learning tích hợp sẵn. Có thể tích hợp machine learning bằng cách điều phối các dịch vụ như Azure ML hoặc Databricks. |
Thư viện machine learning tích hợp như MLlib và tích hợp với MLflow để theo dõi và quản lý mô hình. |
|
Bảo mật |
Kiểm soát truy cập dựa trên vai trò (RBAC), tích hợp với Azure Active Directory, mã hóa dữ liệu tích hợp và managed identities. |
RBAC, mã hóa dữ liệu, tích hợp với Azure Active Directory và mô hình bảo mật tùy chỉnh. |
|
Tích hợp BI |
Có thể điều phối pipeline dữ liệu và cung cấp dữ liệu cho các công cụ BI như Power BI, Azure Synapse Analytics và dịch vụ Azure khác. |
Hỗ trợ tích hợp với công cụ BI như Power BI, Tableau và các công cụ khác để tiêu thụ dữ liệu trực tiếp. |
|
Xử lý dữ liệu thời gian thực |
Có thể điều phối ingestion dữ liệu thời gian thực với trigger, và sử dụng dịch vụ tính toán thời gian thực như Stream Analytics hoặc Databricks. |
Tối ưu cho xử lý dữ liệu thời gian thực bằng Spark Streaming. |
|
Dễ sử dụng |
Thân thiện với người dùng với giao diện low-code, giúp người không chuyên kỹ thuật dễ dàng xây dựng pipeline dữ liệu. |
Yêu cầu kiến thức kỹ thuật cao hơn, do tập trung vào kỹ sư dữ liệu lớn, nhà khoa học dữ liệu và nhà phát triển. |
|
Hỗ trợ đa đám mây |
Chủ yếu tập trung vào Azure, nhưng có thể kết nối đến một số dịch vụ đám mây khác qua connector. |
Hỗ trợ môi trường đa đám mây, bao gồm Azure, AWS và GCP. |
|
Triển khai |
Dịch vụ được quản lý hoàn toàn với cập nhật và mở rộng pipeline tự động. |
Dịch vụ được quản lý, nhưng người dùng có nhiều quyền kiểm soát hơn đối với cấu hình và mở rộng cụm. |
|
Cộng đồng & hệ sinh thái |
Cộng đồng Azure rộng lớn, được Microsoft hỗ trợ mạnh và tích hợp sâu trong hệ sinh thái Azure. |
Cộng đồng lớn, với đóng góp đáng kể từ Databricks và cộng đồng mã nguồn mở Apache Spark. |
|
Tuân thủ & chứng chỉ |
Tuân thủ nhiều tiêu chuẩn ngành, bao gồm GDPR, HIPAA và các chứng nhận ISO. |
Cũng đáp ứng nhiều tiêu chuẩn và chứng chỉ ngành, bao gồm GDPR, HIPAA và tuân thủ SOC. |
Azure Data Factory là lựa chọn ưu tiên trong các kịch bản mà tích hợp và di chuyển dữ liệu là mối quan tâm chính. Cụ thể, nó lý tưởng cho:
Databricks là nền tảng ưu tiên cho các kịch bản đòi hỏi xử lý dữ liệu lớn, phân tích và machine learning. Nó phù hợp nhất cho:
Trong nhiều trường hợp, Azure Data Factory và Databricks có thể được sử dụng cùng nhau để tạo nên một pipeline dữ liệu toàn diện.
ADF có thể điều phối pipeline dữ liệu, quản lý việc trích xuất, biến đổi và nạp dữ liệu từ nhiều nguồn. Sau đó Databricks có thể thực hiện các tác vụ xử lý và phân tích dữ liệu phức tạp hơn, tận dụng khả năng nâng cao trong xử lý dữ liệu lớn và machine learning.
Ví dụ, một pipeline dữ liệu end-to-end điển hình có thể bao gồm ADF trích xuất dữ liệu từ nhiều nguồn và nạp vào data lake. Databricks sau đó có thể xử lý dữ liệu, thực hiện các biến đổi nâng cao và áp dụng mô hình machine learning trước khi kết quả được nạp vào data warehouse để phân tích tiếp.
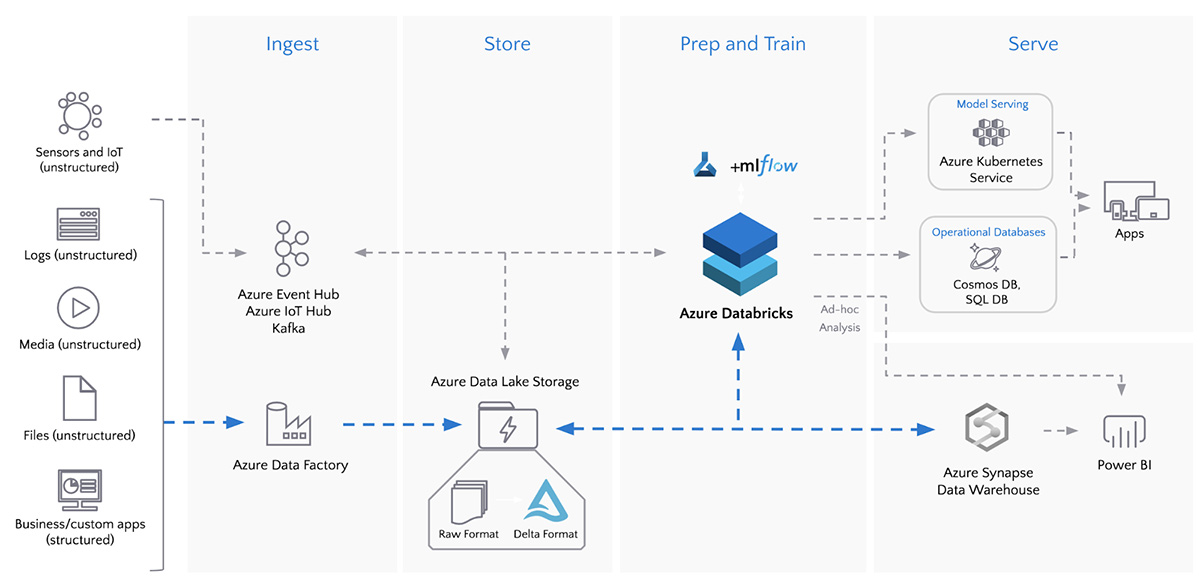
Batch ETL với Azure Data Factory và Azure Databricks. Nguồn ảnh: Databricks
Azure Data Factory và Databricks là những công cụ mạnh mẽ trong hệ sinh thái Azure, mỗi công cụ có thế mạnh và trường hợp sử dụng lý tưởng riêng. Trong nhiều tình huống, kết hợp ADF và Databricks có thể mang lại giải pháp toàn diện, tận dụng những điểm tốt nhất của cả hai!
Nếu bạn muốn tìm hiểu sâu hơn về các nền tảng này, hãy tham khảo các tài nguyên sau:
Những tài nguyên này cung cấp nền tảng vững chắc để hiểu Azure Data Factory và Databricks cũng như cách dùng chúng để xây dựng pipeline dữ liệu và giải pháp phân tích mạnh mẽ.
Tìm hiểu thêm về Azure và các dịch vụ của nó với những khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
