Cours
Comprendre l'architecture et les services Microsoft Azure
2 h
22.2K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleLa capacité à intégrer, traiter et analyser efficacement les données est essentielle pour les organisations qui souhaitent générer des insights et garder une longueur d’avance.
Deux outils puissants, Azure Data Factory et Databricks, se sont imposés comme des solutions de référence pour gérer des pipelines de données et réaliser des analyses avancées dans l’écosystème Azure. Même s’ils peuvent paraître similaires au premier regard, ils couvrent des besoins distincts en ingénierie des données et en analytique.
Dans cet article, nous passons en revue les capacités d’Azure Data Factory et de Databricks, comparons leurs fonctionnalités et indiquons dans quels cas privilégier l’un ou l’autre.
Azure Data Factory (ADF) est un service ETL (Extract, Transform, Load) dans le cloud qui permet l’intégration, la migration et l’orchestration de données sur divers stockages. Il est conçu pour faciliter le déplacement et la transformation de données issues de sources hétérogènes vers des emplacements centralisés, où elles peuvent être analysées et exploitées pour la
business intelligence.
Avec ADF, vous pouvez créer et gérer des pipelines de données qui automatisent l’extraction depuis plusieurs sources, la transformation en un format exploitable, puis le chargement vers une destination pour analyse.
Voici, sans ordre particulier, les fonctionnalités les plus intéressantes d’ADF :
Comme vous le voyez, ADF fournit tout le nécessaire pour construire des pipelines de données dans l’écosystème Azure !
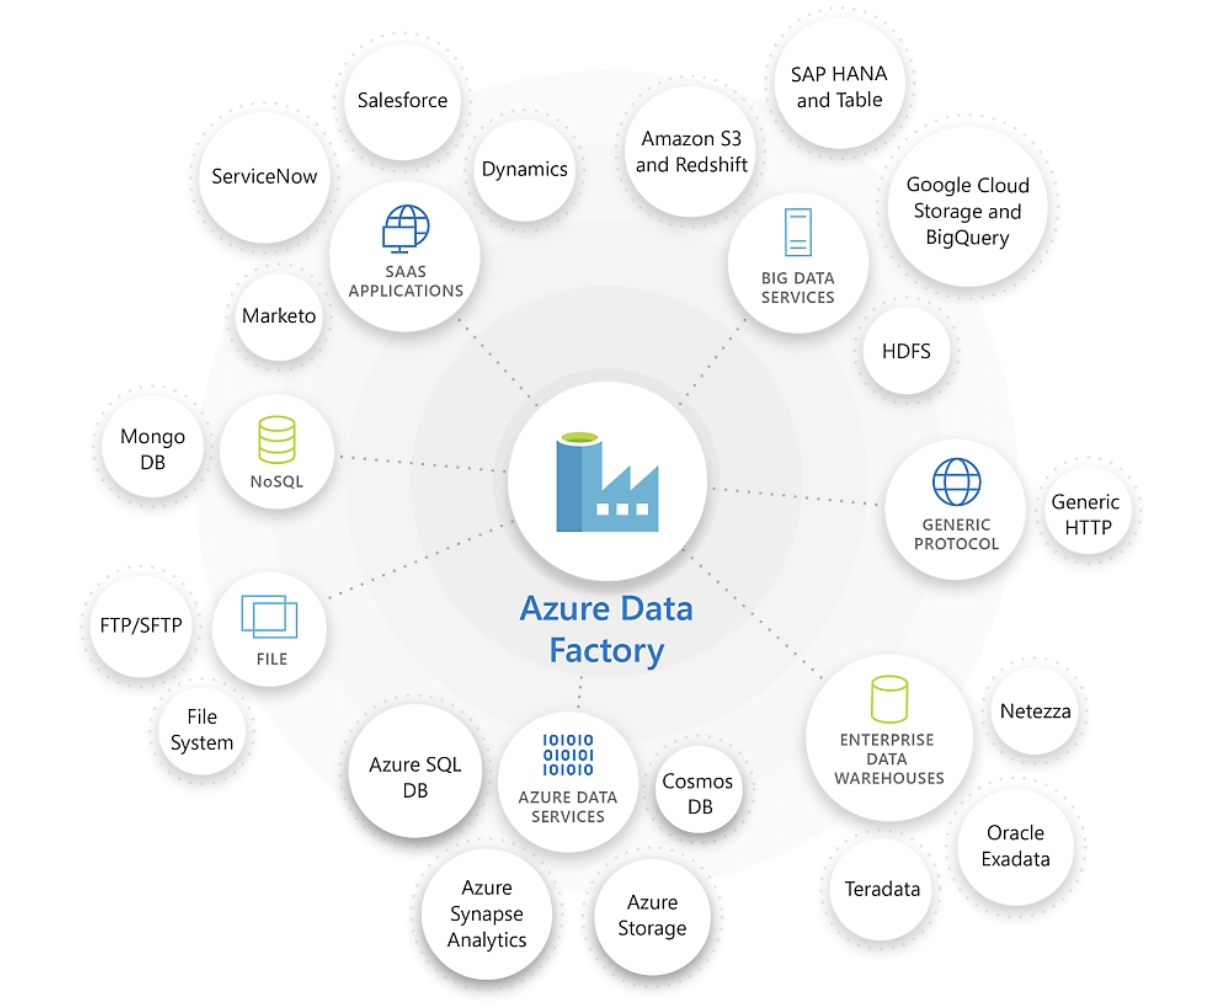
Azure Data Factory excelle pour se connecter à des sources de données diverses et les intégrer. Source : Microsoft.
Le cours Introduction to Azure est une excellente porte d’entrée pour débuter sur Azure. Le cours Azure Management and Governance conviendra mieux aux profils plus expérimentés.
Databricks est une plateforme d’analytique qui offre un environnement collaboratif pour le traitement de données massives et le machine learning. Reposant sur Apache Spark, Databricks est conçu pour traiter des volumes de données à grande échelle, réaliser des analyses complexes et développer des modèles de machine learning.
Databricks propose une plateforme unifiée sur laquelle ingénieurs data, data scientists et analystes peuvent collaborer pour traiter, analyser et visualiser les données au sein d’un flux de travail fluide.
Voici quelques fonctionnalités qui expliquent la popularité de Databricks :
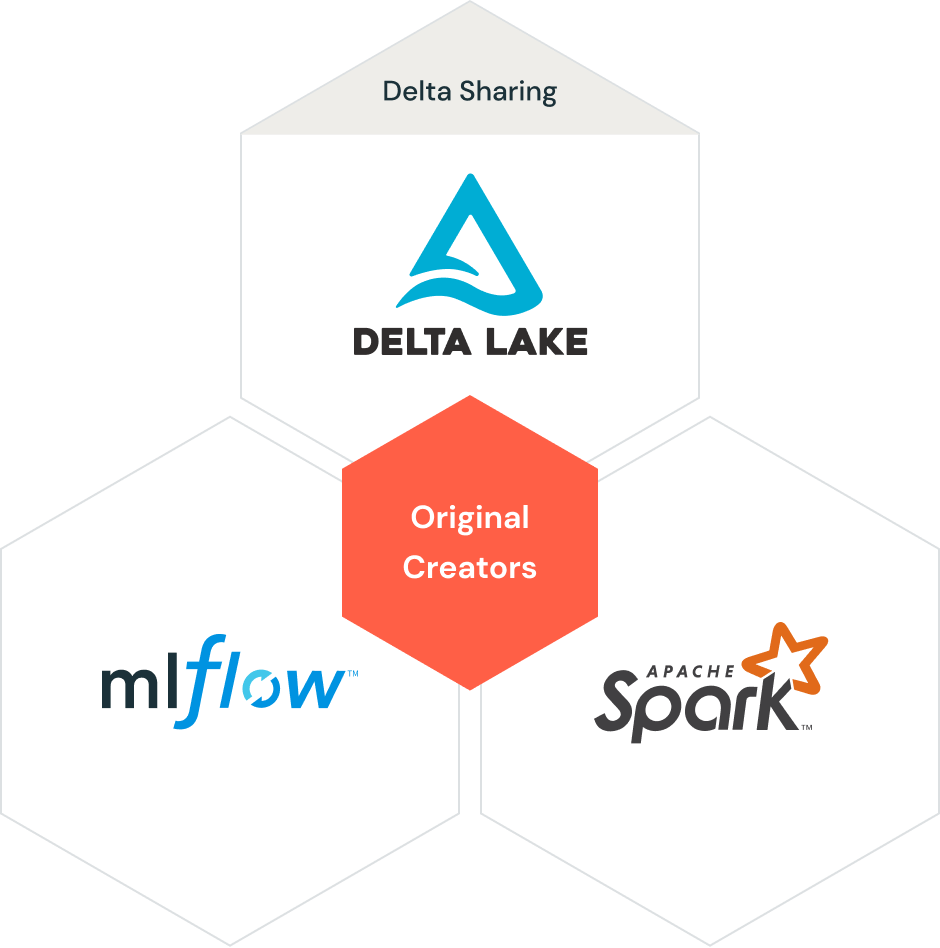
Éléments d’architecture du Databricks Data Lakehouse. Source : Databricks
Voilà ! Si les capacités étendues de Databricks ont retenu votre attention, commencez par le cours Introduction to Databricks.
À ce stade, vous percevez sans doute en quoi ADF et Databricks diffèrent. Allons plus loin en analysant ces différences par grandes catégories.
Azure Data Factory est avant tout conçu pour l’intégration et l’orchestration de données. Il excelle pour déplacer des données entre diverses sources, les transformer, puis les charger dans un emplacement centralisé pour analyse. ADF est idéal lorsque vous devez automatiser et piloter des workflows de données à travers plusieurs environnements.
Databricks, à l’inverse, se concentre sur le traitement des données, l’analytique et le machine learning. C’est la plateforme de choix pour les entreprises qui souhaitent réaliser des analyses à grande échelle, développer des modèles de machine learning et collaborer sur des projets de data science. Databricks est particulièrement adapté aux environnements big data et aux applications pilotées par l’IA.
Azure Data Factory offre des capacités de transformation via Data Flow, permettant d’effectuer diverses opérations directement dans le pipeline. Puissantes, elles restent toutefois davantage orientées ETL et moins étendues ou flexibles que celles de Databricks.
Databricks, fondé sur Apache Spark, propose des transformations avancées. Vous pouvez exploiter toute la puissance de Spark pour des agrégations complexes et des traitements intensifs, ce qui en fait le choix privilégié lorsque la manipulation et le calcul de données sont lourds.
ADF et Databricks s’intègrent tous deux avec d’autres services Azure, mais avec des focales différentes. ADF, dédié à l’ETL et à l’orchestration, est l’outil idéal pour piloter des workflows impliquant plusieurs services Azure comme Azure Synapse Analytics et Azure Blob Storage.
Databricks, pour sa part, se concentre davantage sur l’analytique avancée et l’IA, avec des intégrations comme Delta Lake pour le stockage et Azure Machine Learning pour le déploiement de modèles.
L’interface par glisser-déposer d’Azure Data Factory le rend relativement simple à prendre en main, même avec peu de connaissances techniques. Son approche low-code/no-code facilite la création et la gestion de workflows de données.
Bien que puissant, Databricks requiert un niveau de maîtrise technique plus élevé. Il repose sur le code (Python, Scala, SQL) et des configurations avancées, ce qui le destine plutôt aux data engineers et data scientists à l’aise avec le code et les frameworks big data.
ADF et Databricks sont très scalables, mais excellent sur des terrains distincts. ADF est conçu pour gérer des intégrations et migrations de données à grande échelle, idéal pour orchestrer des workflows ETL complexes.
Databricks, grâce à Apache Spark, offre des performances inégalées pour le traitement big data et l’analytique, ce qui en fait le choix privilégié lorsque la puissance de calcul et l’évolutivité sont déterminantes.
Pour évaluer le coût d’Azure Data Factory et de Databricks, il est essentiel de comprendre leurs modèles tarifaires et leur impact budgétaire :
Lorsque vous évaluez les coûts, tenez compte de vos besoins spécifiques : volume de données, complexité des transformations, fréquence d’exécution des pipelines.
Dans certains cas, combiner ADF pour l’orchestration et Databricks pour le traitement constitue une approche équilibrée qui tire parti des forces de chaque outil tout en maîtrisant les dépenses.
Ci-dessous, un tableau comparatif d’Azure Data Factory et de Databricks sur un large éventail d’aspects :
|
Catégorie |
Azure Data Factory (ADF) |
Databricks |
|
Vue d’ensemble |
Service cloud d’intégration de données pour orchestrer et automatiser le déplacement et la transformation des données. |
Plateforme d’analytique unifiée axée sur le traitement big data et le machine learning. |
|
Cas d’usage principal |
Intégration de données, pipelines ETL/ELT, orchestration et automatisation de workflows. |
Analytique big data, traitement temps réel et machine learning. |
|
Transformation des données |
Principalement utilisé pour orchestrer des transformations, avec des moteurs internes ou externes comme Databricks ou les pools Spark de Synapse. |
Transformations avancées et à grande échelle avec Apache Spark et Delta Lake, en batch comme en temps réel. |
|
ETL/ELT |
Spécialisé dans l’orchestration ETL/ELT, connectant de multiples sources et cibles avec des activités intégrées (copie, data flow, services Azure). |
Capacités ETL puissantes, notamment pour des transformations big data complexes, grâce au traitement en mémoire d’Apache Spark. |
|
Moteur de calcul |
Pas de moteur de calcul natif ; s’appuie sur des options externes (Azure Databricks, Azure Synapse, Azure HDInsight) pour les transformations. |
Moteur de calcul basé sur Apache Spark pour le traitement batch et temps réel. |
|
Mouvement de données |
Large éventail de connecteurs intégrés (bases de données, stockages cloud, plateformes SaaS), idéal pour orchestrer des mouvements de données à grande échelle entre environnements. |
S’intègre généralement avec des stockages comme Azure Data Lake, S3 et Delta Lake ; le mouvement de données n’est pas son objectif premier. |
|
Intégration de données |
Fortes capacités d’intégration avec plus de 90 connecteurs (services Azure, bases on-premises, systèmes tiers). |
Intégration principalement axée sur les plateformes de stockage et de traitement big data (Azure Data Lake, Delta Lake). Connecteurs moins variés. |
|
Traitement des données |
S’appuie sur les data flows pour transformer à l’échelle via du mapping visuel low-code. Pour des transformations plus avancées, recourt à Databricks ou Azure Synapse. |
Traitement avancé avec Spark, optimisé pour les charges temps réel et batch à grande échelle. |
|
Collaboration |
Collaboration sur les pipelines via l’intégration Git (Azure DevOps et GitHub). |
Collaboration avancée avec Databricks Workspaces et contrôle de version intégré (GitHub, Databricks Repos). |
|
Expérience développeur |
Interface drag-and-drop pour construire des workflows ETL ; accessible aux profils moins techniques. |
Expérience avancée avec environnement de notebooks et transformations basées code (Python, Scala, R, SQL). |
|
Planification et orchestration |
Excellentes capacités de planification et d’orchestration, avec déclencheurs et contrôle d’exécution des pipelines. |
Capacités d’orchestration limitées. Databricks peut être orchestré via ADF ou d’autres outils. |
|
Gouvernance des données |
Intégration avec Azure Purview pour la gouvernance, la traçabilité (lineage) et la gestion des métadonnées. |
La gouvernance est généralement gérée via des outils externes comme Azure Purview ou des solutions tierces. |
|
Supervision et logs |
Suivi et journalisation intégrés via Azure Monitor, Alerts et le tableau de bord ADF. |
Journalisation et monitoring étendus via l’API REST de Databricks, l’intégration à Azure Monitor et des tableaux de bord personnalisés. |
|
Scalabilité |
Monte facilement en charge pour l’intégration et le mouvement de données à la demande. Utilise des services de calcul externes pour étendre le traitement. |
Très haute scalabilité, notamment pour les charges big data et les pipelines de ML, avec autoscaling des clusters. |
|
Modèle de coûts |
Paiement à l’usage selon le mouvement, l’orchestration et les services de calcul externes utilisés (Databricks, Synapse, etc.). |
Paiement à l’usage pour le stockage et le calcul. Clusters à mise à l’échelle automatique pour optimiser les coûts. |
|
Machine learning |
Pas de capacités ML natives. Intégration possible via l’orchestration de services comme Azure ML ou Databricks. |
Bibliothèques ML intégrées (MLlib) et intégrations avec MLflow pour le suivi et la gestion des modèles. |
|
Sécurité |
Contrôle d’accès basé sur les rôles (RBAC), intégration avec Azure Active Directory, chiffrement intégré et identités managées. |
RBAC, chiffrement des données, intégration avec Azure Active Directory et modèles de sécurité personnalisés. |
|
Intégration BI |
Peut orchestrer des pipelines et alimenter des outils BI comme Power BI, Azure Synapse Analytics et d’autres services Azure. |
Prend en charge l’intégration avec des outils BI comme Power BI, Tableau, etc., pour une consommation directe des données. |
|
Traitement temps réel |
Peut orchestrer l’ingestion en temps réel via des déclencheurs et utiliser des services de calcul temps réel comme Stream Analytics ou Databricks. |
Optimisé pour le traitement temps réel via Spark Streaming. |
|
Facilité d’utilisation |
Interface conviviale low-code, qui facilite la création de pipelines pour des profils non techniques. |
Nécessite davantage de compétences techniques ; s’adresse aux ingénieurs big data, data scientists et développeurs. |
|
Support multi-cloud |
Principalement centré sur Azure, avec possibilité de connexion à d’autres clouds via des connecteurs. |
Prise en charge multi-cloud, dont Azure, AWS et GCP. |
|
Déploiement |
Service entièrement managé avec mises à jour et montée en charge automatiques des pipelines. |
Service managé, laissant davantage de contrôle sur la configuration et la mise à l’échelle des clusters. |
|
Communauté et écosystème |
Large communauté Azure, solide support Microsoft et intégration profonde à l’écosystème Azure. |
Grande communauté, avec des contributions importantes de Databricks et de l’écosystème open source Apache Spark. |
|
Conformité et certifications |
Conforme à de nombreuses normes (RGPD, HIPAA, certifications ISO). |
Respecte également diverses normes et certifications (RGPD, HIPAA, conformité SOC). |
Azure Data Factory est à privilégier lorsque l’intégration et la migration de données sont au premier plan. Plus précisément, il est idéal pour :
Databricks est la plateforme de référence lorsque le traitement big data, l’analytique et le machine learning sont au cœur des besoins. Il est tout indiqué pour :
Dans de nombreux cas, Azure Data Factory et Databricks peuvent être combinés pour créer un pipeline de données complet.
ADF peut orchestrer le pipeline, en gérant l’extraction, la transformation et le chargement de données depuis diverses sources. Databricks prend ensuite en charge les traitements et analyses plus complexes, en s’appuyant sur ses capacités avancées en big data et en machine learning.
Par exemple, un pipeline de bout en bout typique peut voir ADF extraire des données de multiples sources et les charger dans un data lake. Databricks peut ensuite traiter ces données, appliquer des transformations avancées et des modèles de machine learning, avant de charger les résultats dans un entrepôt de données pour des analyses ultérieures.
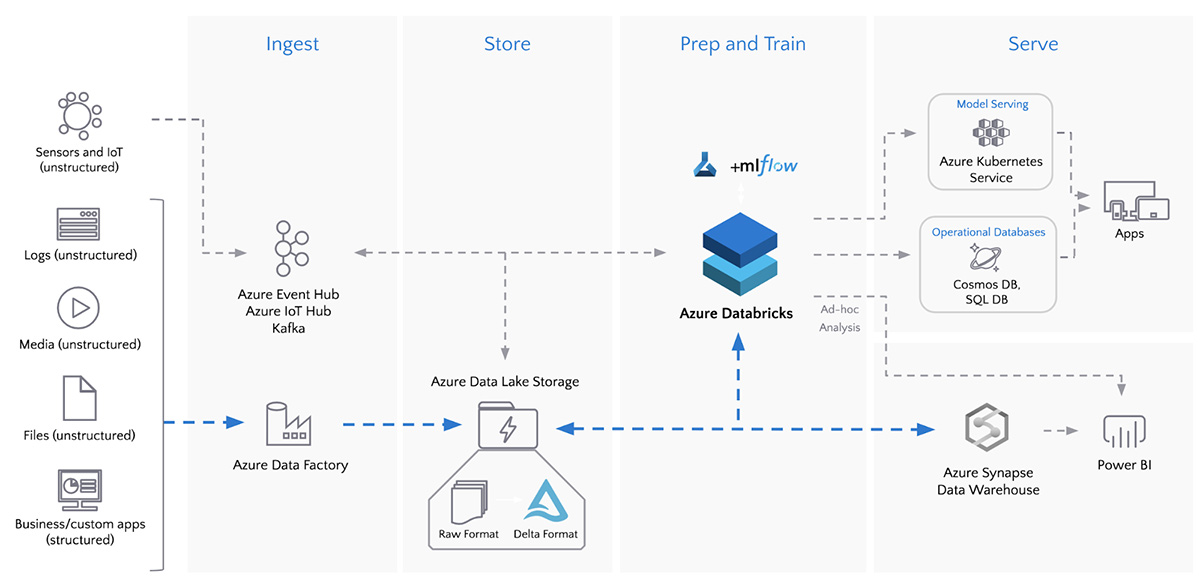
ETL batch avec Azure Data Factory et Azure Databricks. Source : Databricks
Azure Data Factory et Databricks sont deux piliers de l’écosystème Azure, chacun avec ses points forts et ses cas d’usage privilégiés. Dans bien des situations, les combiner permet de bâtir une solution complète qui tire le meilleur des deux mondes.
Pour aller plus loin sur ces plateformes, explorez les ressources suivantes :
Ces ressources constituent une base solide pour comprendre Azure Data Factory et Databricks, et apprendre à construire des pipelines et solutions d’analytique performants.
Nos programmes de certification vous aident à vous démarquer et à prouver aux employeurs potentiels que vos compétences sont adaptées à l'emploi.
Approfondissez Azure et ses services avec ces cours !
Cours
Cours
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
Kurtis Pykes
15 min
blog
Zoumana Keita
15 min
blog
Nathaniel Taylor-Leach
8 min
blog
Tutoriel
Samuel Shaibu
9 min
Tutoriel
Laiba Siddiqui
14 min