Kurs
Verstehen der Microsoft Azure Architektur und Dienste
2 Std.
21.3K
Die Fähigkeit, Daten effizient zu integrieren, zu verarbeiten und zu analysieren, ist für Unternehmen entscheidend, um Erkenntnisse zu gewinnen und die Nase vorn zu behalten.
Mit Azure Data Factory und Databricks haben sich zwei leistungsstarke Tools als führende Lösungen für die Verwaltung von Datenpipelines und fortgeschrittene Analysen im Azure-Ökosystem etabliert. Auch wenn die Tools auf den ersten Blick ähnlich wirken, adressieren sie unterschiedliche Aspekte von Data Engineering und Analytics.
In diesem Artikel schauen wir uns die Möglichkeiten von Azure Data Factory und Databricks an, vergleichen ihre Funktionen und geben Empfehlungen, wann welches Tool die bessere Wahl ist.
Azure Data Factory (ADF) ist ein cloudbasiertes ETL-System (Extract, Transform, Load), das Datenintegration, -migration und -orchestrierung über verschiedenste Datenspeicher hinweg ermöglicht. Es ist darauf ausgelegt, Daten aus verteilten Quellen in zentrale Umgebungen zu bewegen und zu transformieren, wo sie für
Business Intelligence genutzt werden können.
Mit ADF kannst du Datenpipelines erstellen und verwalten, die das Extrahieren von Daten aus mehreren Quellen, deren Transformation in ein nutzbares Format und das Laden in ein Zielsystem für Analysen automatisieren.
Das sind die interessantesten Features von ADF, ohne bestimmte Reihenfolge:
Wie du siehst, bringt ADF alles mit, um Datenpipelines im Azure-Ökosystem aufzubauen!
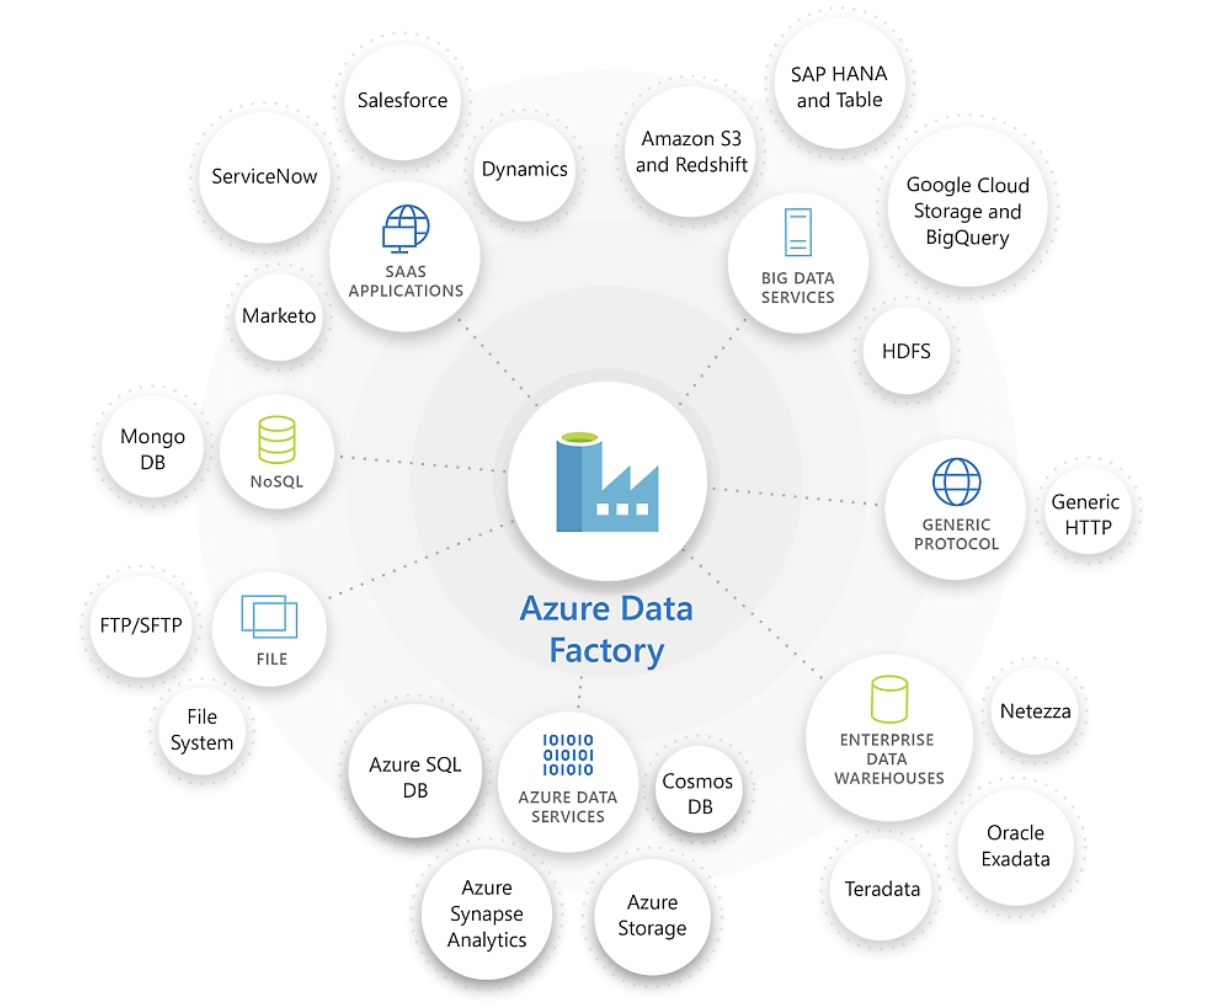
Azure Data Factory punktet beim Verbinden und Integrieren vielfältiger Datenquellen. Bildquelle: Microsoft.
Der Kurs Introduction to Azure ist ein hervorragender Einstieg. Für Fortgeschrittene eignet sich der Kurs Azure Management and Governance.
Databricks ist eine Analytics-Plattform, die eine kollaborative Umgebung für Big-Data-Verarbeitung und Machine Learning bereitstellt. Auf Basis von Apache Spark konzipiert, bewältigt Databricks großskalige Datenverarbeitungsaufgaben, ermöglicht komplexe Analysen und den Aufbau von Machine-Learning-Modellen.
Databricks bietet eine einheitliche Plattform, auf der Data Engineers, Data Scientists und Analysten nahtlos zusammenarbeiten, um Daten zu verarbeiten, zu analysieren und zu visualisieren.
Diese Features machen Databricks so beliebt:
Architekturelemente des Databricks Data Lakehouse. Bildquelle: Databricks
Klingt spannend? Wenn dich die umfangreichen Funktionen von Databricks überzeugen, starte mit dem Kurs Introduction to Databricks.
An diesem Punkt ist der Unterschied zwischen ADF und Databricks wahrscheinlich schon erkennbar. Jetzt gehen wir tiefer und betrachten die Unterschiede entlang mehrerer Kategorien.
Azure Data Factory ist in erster Linie für Datenintegration und Orchestrierung gedacht. ADF glänzt beim Bewegen, Transformieren und Laden von Daten aus verschiedenen Quellen in zentrale Ziele. Ideal ist es, wenn Datenworkflows über mehrere Umgebungen automatisiert und gemanagt werden müssen.
Databricks hingegen fokussiert sich auf Datenverarbeitung, Analytics und Machine Learning. Es ist die erste Wahl für Unternehmen, die Big-Data-Analysen durchführen, ML-Modelle entwickeln und in datenwissenschaftlichen Projekten zusammenarbeiten wollen. Besonders geeignet ist Databricks für Big-Data-Umgebungen und KI-getriebene Anwendungen.
Azure Data Factory bietet mit Data Flow integrierte Funktionen für Transformationen direkt in der Pipeline. Diese sind leistungsfähig, richten sich aber primär an ETL-Szenarien und sind nicht so umfassend und flexibel wie bei Databricks.
Databricks bietet dank Apache Spark erweiterte Transformationsmöglichkeiten. Du kannst die volle Spark-Power für komplexe Transformationen, Aggregationen und Verarbeitungsaufgaben nutzen – ideal, wenn umfangreiche Datenmanipulation und Rechenleistung gefragt sind.
Beide Tools integrieren sich in andere Azure-Services, aber mit unterschiedlichem Schwerpunkt. ADF ist auf ETL und Orchestrierung ausgelegt und damit ideal für Workflows, die mehrere Azure-Dienste wie Azure Synapse Analytics und Azure Blob Storage einbeziehen.
Databricks hingegen fokussiert sich stärker auf Advanced Analytics und KI und integriert sich etwa mit Delta Lake für Datenspeicherung und Azure Machine Learning für das Ausrollen von Modellen.
Die Drag-and-drop-Oberfläche von Azure Data Factory macht den Einstieg leicht – auch mit begrenzter Technik-Erfahrung. Der Low-Code/No-Code-Fokus vereinfacht das Erstellen und Verwalten von Datenworkflows.
Databricks ist sehr leistungsfähig, verlangt aber mehr technisches Know-how. Da es auf Code (z. B. in Python, Scala und SQL) und komplexeren Konfigurationen basiert, eignet es sich besonders für Data Engineers und Data Scientists, die mit Code und Big-Data-Frameworks vertraut sind.
ADF und Databricks sind hochskalierbar, glänzen aber in unterschiedlichen Bereichen. ADF ist auf großflächige Datenintegration und -migration ausgelegt und ideal zur Orchestrierung komplexer ETL-Workflows.
Databricks liefert dank Apache Spark herausragende Performance für Big-Data-Verarbeitung und Analytics und ist die bevorzugte Wahl, wenn hohe Rechenleistung und Skalierbarkeit gefragt sind.
Bei den Kosten für Azure Data Factory und Databricks ist es wichtig, die Preislogik zu verstehen und deren Auswirkungen auf dein Budget einzuschätzen:
Berücksichtige bei der Bewertung deine spezifischen Anforderungen, etwa Datenvolumen, Transformationskomplexität und Ausführungsfrequenz der Pipelines.
In manchen Fällen ist eine Kombination sinnvoll: ADF für die Orchestrierung und Databricks für die Verarbeitung. So lassen sich die Stärken beider Tools nutzen und die Kosten im Griff behalten.
Die folgende Tabelle vergleicht Azure Data Factory und Databricks in vielen Aspekten:
|
Kategorie |
Azure Data Factory (ADF) |
Databricks |
|
Überblick |
Ein cloudbasierter Dienst zur Datenintegration für Orchestrierung und Automatisierung von Datenbewegung und -transformation. |
Eine einheitliche Analytics-Plattform mit Fokus auf Big-Data-Verarbeitung und Machine Learning. |
|
Primärer Use Case |
Datenintegration, ETL/ELT-Pipelines, Datenorchestrierung und Workflow-Automatisierung. |
Big-Data-Analytics, Echtzeitverarbeitung und Machine Learning. |
|
Datentransformation |
Primär zur Orchestrierung von Transformationen, mit integrierter oder externer Compute wie Databricks oder Synapse Spark-Pools. |
Erweiterte, großskalige Transformationen mit Apache Spark und Delta Lake für Batch- und Echtzeitverarbeitung. |
|
ETL/ELT |
Spezialisiert auf ETL/ELT-Orchestrierung, verbindet viele Quellen und Ziele, mit integrierten Activities wie Copy Data, Data Flow und Azure-Services. |
Leistungsstarke ETL-Funktionen, besonders für komplexe Big-Data-Transformationen, mit In-Memory-Verarbeitung durch Apache Spark. |
|
Compute-Engine |
Keine native Compute-Engine; nutzt externe Compute-Optionen wie Azure Databricks, Azure Synapse oder Azure HDInsight für Transformationen. |
Apache-Spark-basierte Compute-Engine für Echtzeit- und Batch-Verarbeitung. |
|
Datenbewegung |
Viele integrierte Connectoren (z. B. Datenbanken, Cloud Storage, SaaS), ideal zur Orchestrierung großskaliger Datenbewegung über Umgebungen hinweg. |
Typisch in Verbindung mit Speichern wie Azure Data Lake, S3 und Delta Lake, jedoch nicht mit Fokus auf Datenbewegung. |
|
Datenintegration |
Starke Integrationsfähigkeiten mit über 90 Connectoren, inkl. Azure-Services, On-Prem-Datenbanken und Drittsystemen. |
Integration fokussiert auf Big-Data-Speicher- und -Verarbeitungsplattformen (Azure Data Lake, Delta Lake). Weniger Vielfalt bei Connectoren. |
|
Datenverarbeitung |
Skalierbare Transformation per Data Flows über visuelles Low-Code-Mapping. Für erweiterte Transformationen nutzt es Databricks oder Azure Synapse. |
Fortgeschrittene Verarbeitung mit Spark; optimiert für Echtzeit- und großskalige Batch-Workloads. |
|
Zusammenarbeit |
Pipeline-Kollaboration über Git-Integration (Azure DevOps und GitHub). |
Erweiterte Kollaboration mit Databricks Workspaces und integrierter Versionskontrolle über GitHub oder Databricks Repos. |
|
Developer Experience |
Drag-and-drop-UI zum Aufbau von ETL-Workflows; ermöglicht auch weniger technischen Nutzern das Erstellen von Pipelines. |
Erweiterte Developer Experience mit Notebook-Umgebung und Code-basierten Transformationen (Python, Scala, R, SQL). |
|
Scheduling & Orchestrierung |
Exzellente Planungs- und Orchestrierungsfunktionen mit Triggern und Steuerung der Pipeline-Ausführung. |
Begrenzte Orchestrierung. Databricks kann extern, etwa mit ADF, orchestriert werden. |
|
Data Governance |
Integration mit Azure Purview für Data Governance, Lineage und Metadatenmanagement. |
Governance wird typischerweise extern gehandhabt, z. B. mit Azure Purview oder Drittanbieter-Lösungen. |
|
Monitoring & Logging |
Integriertes Monitoring und Logging via Azure Monitor, Alerts und dem ADF-Dashboard. |
Umfangreiches Logging und Monitoring über die Databricks REST API, Integration mit Azure Monitor und Custom Dashboards. |
|
Skalierbarkeit |
Einfache Skalierung bei Datenintegration und -bewegung on demand. Nutzt externe Compute-Services für skalierende Verarbeitung. |
Hoch skalierbar, besonders für große Datenlasten und ML-Pipelines, mit automatischem Cluster-Scaling. |
|
Kostenmodell |
Pay-per-Use basierend auf Datenbewegung, Orchestrierung und genutzten externen Compute-Services (Databricks, Synapse etc.). |
Pay-as-you-go für Storage und Compute. Cluster können zur Kostenoptimierung automatisch skaliert werden. |
|
Machine Learning |
Keine integrierten ML-Funktionen. ML lässt sich durch Orchestrierung von Diensten wie Azure ML oder Databricks einbinden. |
Integrierte ML-Bibliotheken wie MLlib und Integrationen mit MLflow für Modell-Tracking und -Management. |
|
Sicherheit |
Rollenbasierte Zugriffskontrolle (RBAC), Integration mit Azure Active Directory, integrierte Verschlüsselung und Managed Identities. |
RBAC, Datenverschlüsselung, Integration mit Azure Active Directory und anpassbare Sicherheitsmodelle. |
|
BI-Integration |
Kann Pipelines orchestrieren und BI-Tools wie Power BI, Azure Synapse Analytics und andere Azure-Dienste mit Daten versorgen. |
Unterstützt die Anbindung von BI-Tools wie Power BI, Tableau und weiteren zur direkten Datennutzung. |
|
Echtzeitverarbeitung |
Kann Echtzeit-Ingestion mit Triggern orchestrieren und Echtzeit-Compute-Services wie Stream Analytics oder Databricks nutzen. |
Optimiert für Echtzeitverarbeitung mit Spark Streaming. |
|
Benutzerfreundlichkeit |
Nutzerfreundliche Low-Code-Oberfläche – ideal, um ohne tiefes Technik-Wissen Pipelines zu bauen. |
Erfordert mehr technisches Wissen, da es sich an Big-Data-Engineers, Data Scientists und Entwickler richtet. |
|
Multi-Cloud-Support |
Primär auf Azure fokussiert, kann aber über Connectoren auch andere Clouds anbinden. |
Unterstützt Multi-Cloud-Umgebungen, darunter Azure, AWS und GCP. |
|
Bereitstellung |
Voll gemanagter Service mit automatischen Updates und skalierenden Pipelines. |
Gemanagter Service, bietet aber mehr Kontrolle über Cluster-Konfiguration und Skalierung. |
|
Community & Ökosystem |
Umfassende Azure-Community, starke Microsoft-Unterstützung und tiefe Einbettung ins Azure-Ökosystem. |
Große Community mit wichtigen Beiträgen von Databricks und der Open-Source-Community rund um Apache Spark. |
|
Compliance & Zertifizierungen |
Erfüllt diverse Branchenstandards, darunter GDPR, HIPAA und ISO-Zertifizierungen. |
Erfüllt ebenfalls verschiedene Standards und Zertifizierungen, darunter GDPR, HIPAA und SOC-Compliance. |
Azure Data Factory ist die erste Wahl, wenn Datenintegration und -migration im Vordergrund stehen. Konkret eignet es sich für:
Databricks ist die Plattform der Wahl, wenn Big-Data-Verarbeitung, Analytics und Machine Learning im Fokus stehen. Am besten geeignet ist es für:
In vielen Szenarien lassen sich Azure Data Factory und Databricks kombinieren, um eine durchgängige Datenpipeline aufzubauen.
ADF orchestriert die Pipeline, steuert das Extrahieren, Transformieren und Laden aus verschiedenen Quellen. Databricks übernimmt anschließend komplexere Verarbeitung und Analytik und nutzt dafür seine Stärken in Big-Data und Machine Learning.
Ein typisches End-to-End-Beispiel: ADF extrahiert Daten aus mehreren Quellen und lädt sie in einen Data Lake. Databricks verarbeitet die Daten weiter, führt erweiterte Transformationen durch und wendet ML-Modelle an, bevor die Ergebnisse für weitere Analysen in ein Data Warehouse geladen werden.
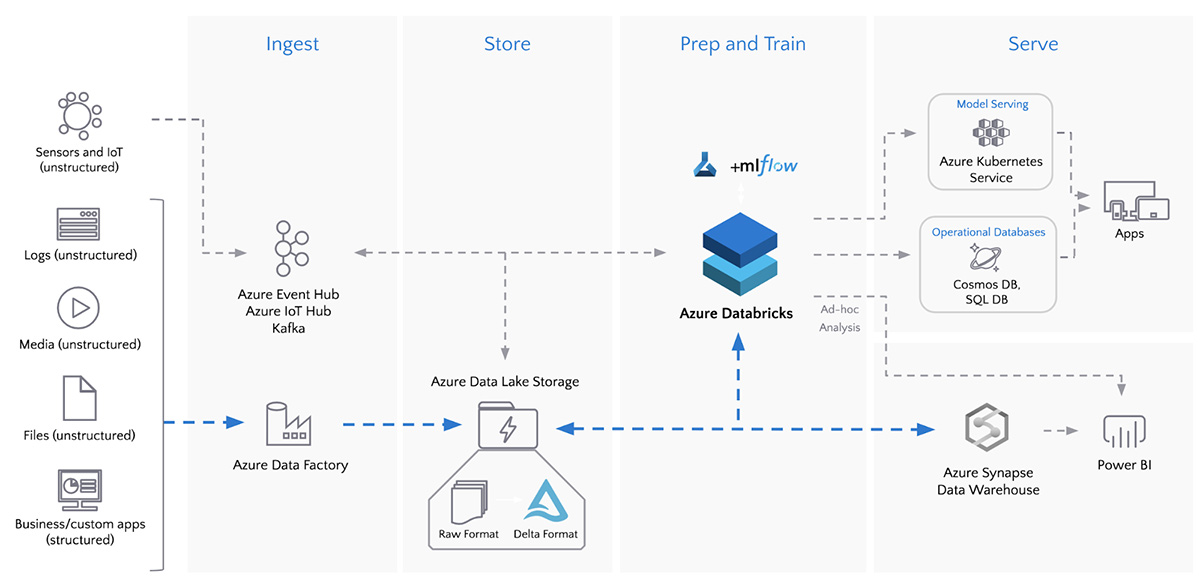
Batch-ETL mit Azure Data Factory und Azure Databricks. Bildquelle: Databricks
Azure Data Factory und Databricks sind starke Tools im Azure-Ökosystem – jedes mit eigenen Stärken und idealen Einsatzszenarien. Oft liefert die Kombination aus ADF und Databricks die umfassendste Lösung und vereint das Beste aus beiden Welten.
Wenn du tiefer einsteigen möchtest, empfehlen wir diese Ressourcen:
Diese Inhalte vermitteln dir ein solides Verständnis von Azure Data Factory und Databricks und zeigen, wie du damit leistungsfähige Datenpipelines und Analytics-Lösungen aufbaust.
Unsere Zertifizierungsprogramme helfen dir, dich von anderen abzuheben und potenziellen Arbeitgebern zu beweisen, dass deine Fähigkeiten für den Job geeignet sind.

Learn more about Azure and its services with these courses!
Kurs
Kurs
Lernpfad