

Kursus
Pengantar Model Claude
3 jam
15K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleAnthropic kembali meluncurkan model terbaik kedua yang benar-benar baru.
Kali ini, namanya Claude Opus 5, yang dipasarkan sebagai kecerdasan yang mendekati frontier, tetapi dengan setengah harga Claude Fable 5 dan, lebih dari itu, Opus 5 sebenarnya mengungguli Fable 5 pada sejumlah evaluasi pengodean dan kerja pengetahuan, termasuk Frontier-Bench dan GDPval-AA. Ia hanya berada di posisi kedua setelah Mythos 5 yang masih belum tersedia luas.
Di bawah ini adalah penjelasan tentang apa yang baru di Opus 5, bagaimana kinerjanya pada lebih banyak uji tolok ukur, apa yang dikatakan Anthropic tentang alignment dan profil keamanannya, serta biayanya.
Opus 5 adalah rilis terbaru dalam tier Opus milik Anthropic, yang dalam hal kapabilitas puncak berada di bawah Mythos, tetapi di atas Sonnet dan Haiku.
Anthropic menyebut model terbarunya "penuh pertimbangan dan proaktif" (mereka selalu sedikit mengantropomorfisasi). Mereka juga mengatakan model ini dibuat untuk penggunaan harian, yang bagi seorang insinyur AI berarti cukup efisien untuk dijalankan terus-menerus.
Pada evaluasi pengodean dan kerja pengetahuan seperti Frontier-Bench dan GDPval-AA, Anthropic mengatakan Opus 5 kini menjadi yang terdepan di antara model-modelnya, meski masih tertinggal dari Mythos 5 khususnya pada tugas keamanan siber, yang kami bahas secara rinci dalam artikel Mythos 5 kami.
Untuk melihat perbandingan langsung dengan model pesaing dan sesaudara, baca panduan perbandingan kami:
Dua hal menonjol dalam kerangka Anthropic tentang apa yang benar-benar baru: pergeseran menuju penyelesaian tugas alih-alih berhenti pada jawaban yang terlihat masuk akal, dan lonjakan kualitas keluaran visual.
Perubahan kualitatif terbesar Opus 5 adalah kesediaannya untuk terus bekerja hingga suatu tugas benar-benar berhasil. Anthropic memberikan gambaran seperti apa bentuknya:
Kesediaan untuk terus melakukan iterasi alih-alih puas dengan jawaban yang tampak masuk akal inilah yang tampaknya mendorong lonjakan Opus 5 pada tolok ukur agentik seperti Frontier-Bench.
Anthropic juga menandai Opus 5 mampu menghasilkan keluaran visual yang bermakna lebih kuat dibanding model sebelumnya, menunjuk pada contoh seperti visualisasi ala terowongan angin aliran udara di atas objek aerodinamis, seperti mobil. Contoh ini cukup meyakinkan, dan kabar baik jika pekerjaan Anda melibatkan pembuatan diagram generatif.
Tabel ini hanya mencakup model-model milik Anthropic. Saya meninjau rilis masing-masing dan menyelaraskan yang bisa saya cocokkan. Saya akan membandingkan Opus 5 dengan model pesaing di bagian berikutnya.
Catatan: "tidak diungkap" atau "tidak dipublikasikan" berarti model tersebut tidak disertakan pada tolok ukur spesifik dalam rilis asalnya, bukan berarti nilainya nol.
| Tolok ukur | Haiku 4.5 | Sonnet 4.6 | Opus 4.7 | Opus 4.8 | Sonnet 5 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|---|---|
| SWE-bench Verified | 73.3% | 79.6% | 87.6% | 88.6% | — | 95.0% | 96.0% |
| SWE-bench Pro | — | 58.1% | 64.3% | 69.2% | 63.2% | 80.3% | 79.2% |
| Terminal-Bench | 41% | 67.0% (2.1) | 69.4% (2.0) | 74.6% (2.1) | 80.4% (2.1) | 88.0% (2.1) | not published |
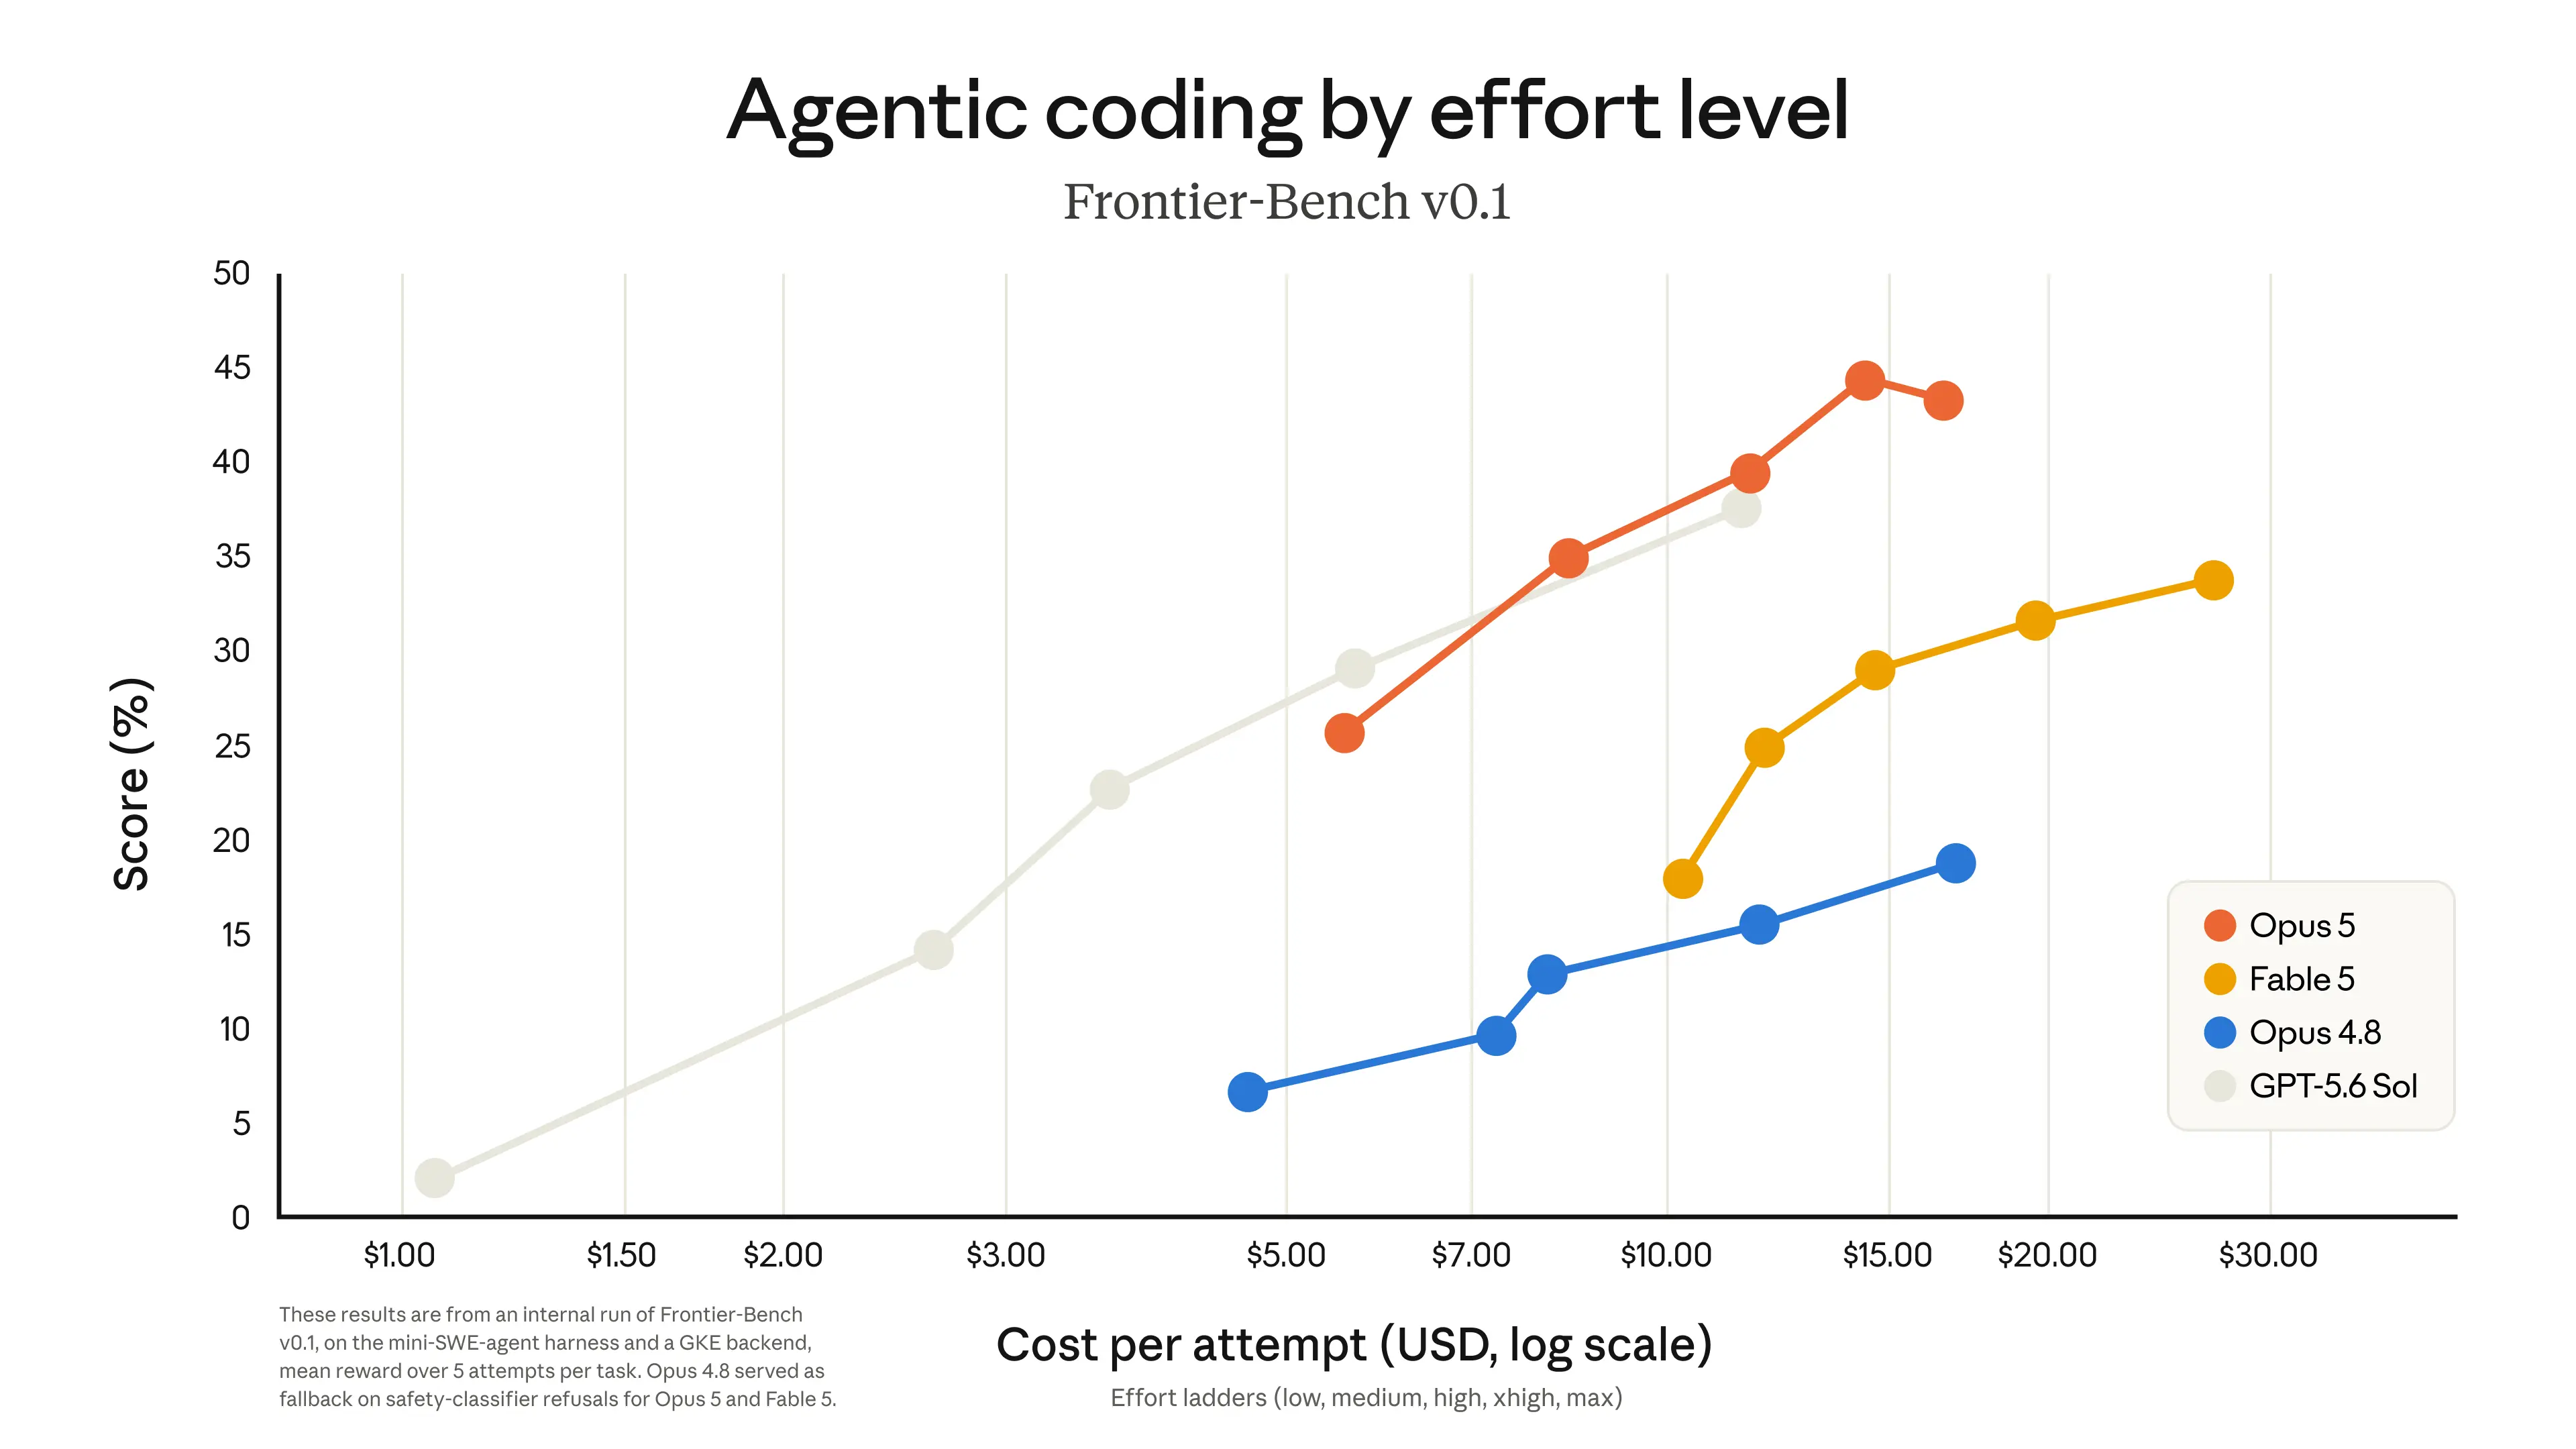
| Frontier-Bench v0.1 (eval baru) | — | — | — | 18.7% | — | 33.7% | 43.3% |
| GDPval-AA / v2 (Elo, /2000) | — | — | 1,753 | 1,890 (v1) / 1,593 (v2) | 1,618 (v2) | 1,747 (v2) | 1,861 (v2) |
| Audit perilaku tidak selaras (lebih rendah = lebih baik) | — | — | — | not disclosed | not disclosed | not disclosed | 2.3 (terbaik sejauh ini) |
| Harga ($/MTok masuk/keluar) | $1/$5 | $3/$15 | $5/$25 | $5/$25 | $2–3/$10–15 | $10/$50 | $5/$25 |
Anda dapat melihat pada tabel di atas bahwa Opus 5 sebenarnya mengalahkan saudaranya yang lebih mahal pada Frontier-Bench v0.1 (43,3% vs. 33,7%) dan GDPval-AA v2 (1861 vs. 1747) — lagi-lagi, dengan setengah harga Fable 5.
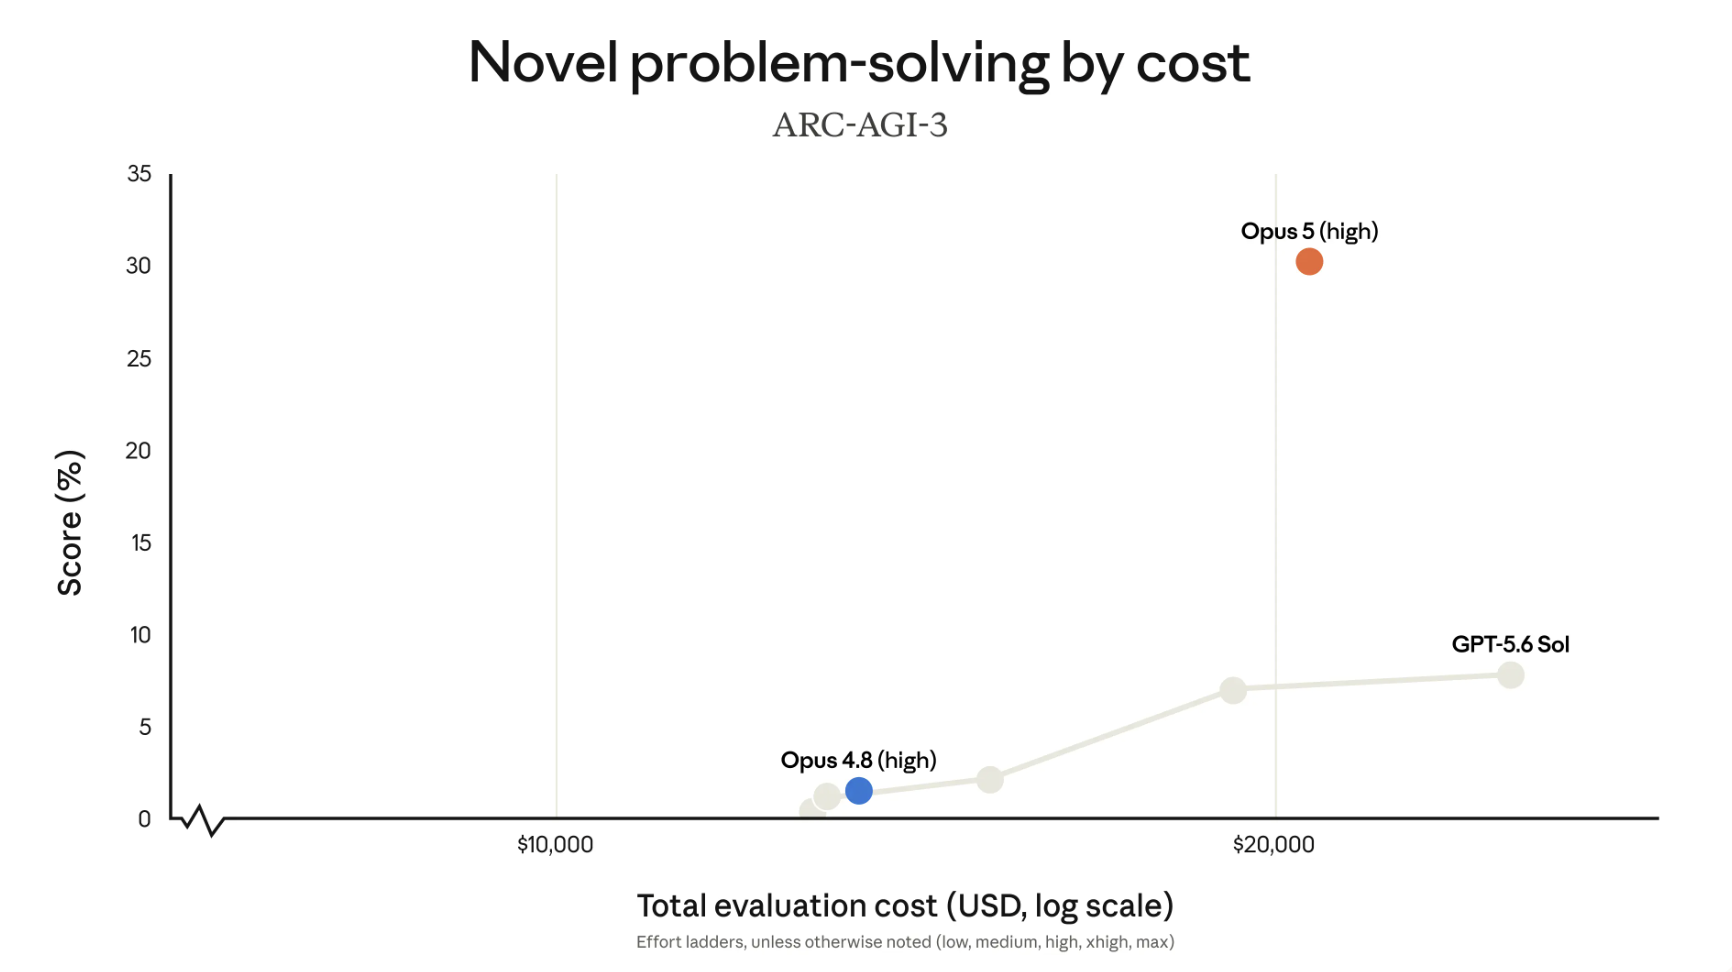
Yang satu ini adalah lompatan generasi paling jelas: Opus 5 memimpin pendahulunya pada ARC-AGI-3, yang melonjak dari 1,5% menjadi 30,2%, dan Frontier-Bench v0.1, yang, seperti terlihat pada tabel di atas, lebih dari dua kali lipat (43,3% vs. 18,7%). Perlu diingat, Opus 4.8 baru dirilis dua bulan lalu.
Perbandingan berikut dikompilasi dengan menarik hasil tolok ukur langsung dari pengumuman rilis model yang diterbitkan oleh Anthropic, OpenAI, dan Google. Saya membuat penilaian untuk memasukkan baris-baris ketika cukup banyak model memiliki skor yang dipublikasikan dan dapat dibandingkan agar baris tersebut bermakna. Selain itu, tolok ukur yang hanya dilaporkan sebagai klaim relatif yang samar, saya keluarkan.
| Kategori | Tolok ukur | Claude Opus 5 | GPT-5.6 Sol | GPT-5.6 Sol Ultra | GPT-5.6 Terra | GPT-5.6 Luna | GPT-5.5 | Gemini 3.6 Flash | Gemini 3.5 Flash-Lite | Gemini 3.5 Flash | Gemini 3.1 Pro Preview |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Pekerjaan Pengetahuan | GDPval-AA v2 (Elo) | 1861 | 1736 | — | 1593 | 1591.8 | 1493.7 | 1421 | — | 1348.8 | 962.3 |
| Pemrograman | SWE-Bench Pro | 79.2% | 64.6% | — | 63.4% | 62.7% | 59.4% | — | 54.2% | — | 54.2% |
| Pemrograman | DeepSWE v1.1 | 68.8% | 72.7% | — | 69.6% | 67.2% | 67% | 49% | — | 37% (baseline) | 11.8% |
| Pemrograman | Terminal-Bench 2.1 | — | 88.8% | 91.9% | 87.4% | 84.7% | 85.6% | — | 54% (vs 3.1 Flash-Lite baseline 31%) | — | 70.7% |
| Pemrograman | Frontier-Bench v0.1 (terminal coding) | 43.3% | 37.5% | — | — | — | — | — | — | — | — |
| Penggunaan Komputer | BrowseComp | 90.8% | 90.4% | 92.2% | 87.5% | 83.3% | 84.4% | — | — | — | 85.9% |
| Penggunaan Komputer | OSWorld 2.0* | 70.6% | 62.6% | — | 50.2% | 45.6% | 47.5% | — | — | — | — |
| Penalaran Abstrak | ARC-AGI-3 | 30.2% | 7.78% | — | 0.8% | 0.18% | 0.43% | — | — | — | 0.42% |
| Penggunaan Alat | AutomationBench | 26.0% | 18.1% | — | 15.2% | 14.9% | 12.9% | — | — | 14.5% |
— |
Perlu saya sampaikan: Setiap angka di sini dilaporkan sendiri oleh lab yang merilis model, dijalankan pada harness evaluasi, pengaturan prompt, dan (dalam beberapa kasus) konfigurasi tingkat upaya atau penalaran milik lab tersebut.
Opus 5 memimpin pada tugas penalaran yang lebih sulit dan lebih baru (ARC-AGI-3, Frontier-Bench, AutomationBench) sementara GPT-5.6 Sol sedikit unggul pada tolok ukur pengodean yang lebih mapan seperti SWE-Bench Pro dan DeepSWE. Ini mungkin menunjukkan Opus 5 memiliki keunggulan dalam pemecahan masalah yang terbuka atau kurang bertemplate, sementara Sol tampak kuat pada tugas pengodean yang terdefinisi jelas dan sangat dilatih.
Rilis terbaru Gemini berfokus pada model tier Flash yang hemat biaya alih-alih flagship frontier, sehingga sebagian besar baris tidak memiliki data Gemini atau hanya angka Flash/Flash-Lite yang tertinggal jauh dari Opus 5 dan GPT-5.6. Perbandingan ini lebih banyak berbicara tentang tier model daripada kemampuan frontier Google.
Di area yang saling tumpang tindih, Opus 5 memimpin pada tugas penalaran baru dan agentik (ARC-AGI-3, BrowseComp, OSWorld 2.0, AutomationBench), sementara GPT-5.6 Sol sedikit unggul pada pengodean cakrawala panjang (DeepSWE). Sol Ultra, Terra, dan Luna sebagian besar muncul pada tolok ukur pengodean terpisah di mana Opus 5 tidak memiliki skor yang dipublikasikan, sehingga ini sebenarnya adalah "satu flagship Anthropic vs. seluruh keluarga OpenAI" alih-alih perbandingan satu-satu yang bersih.
Opus 5 tersedia hari ini di seluruh platform Claude dengan harga yang sama seperti pendahulunya:
Mode cepat berjalan sekitar 2,5x dari kecepatan default, dihargai dua kali tarif dasar Opus 5 di Platform Claude (atau melalui kredit penggunaan di Claude Code) — struktur yang sama seperti Opus 4.8.
Pengembang dapat mengakses model melalui API menggunakan string model claude-opus-5.
Dua fitur terkait diluncurkan dalam versi beta bersamaan dengan Opus 5:
Seperti rilis Opus sebelumnya, Opus 5 tidak membawa persyaratan retensi data untuk akses umum.
Jika terasa kami belakangan ini sering menulis tentang model Claude, itu karena memang demikian. Anthropic sangat fokus melakukan peningkatan cepat untuk mengoptimalkan kapabilitas dan efisiensi model.
Kini, Anthropic telah menghasilkan sesuatu yang secara keseluruhan lebih baik daripada model terbaiknya sebelumnya, Fable 5. Harganya secara bermakna lebih rendah, sambil juga melaporkan angka alignment terbaik hingga saat ini.
Selanjutnya apa? Nah, model Haiku adalah model Anthropic tertua, dan kita masih menunggu peningkatan ke seri 5. Itu salah satu tebakan tentang yang berikutnya, tetapi Anthropic terus membuat kejutan.
Belajar bersama DataCamp
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt




