

Cursus
Introductie tot Claude-modellen
3 uur
15K
Oefen en volg je voortgang.
Ga Verder Met GoogleAnthropic heeft opnieuw een gloednieuw op een-na-beste model.
Dit keer is het Claude Opus 5, gepositioneerd als intelligentie dicht bij de frontier, maar voor de helft van de prijs van Claude Fable 5 en, wat meer is, Opus 5 presteert op verschillende codeer- en kenniswerk-evaluaties zelfs beter dan Fable 5, waaronder Frontier-Bench en GDPval-AA. Het staat alleen nog op de tweede plaats achter het nog niet breed beschikbare Mythos 5.
Hieronder vind je een overzicht van wat er nieuw is in Opus 5, hoe het scoort op meer benchmarktests, wat Anthropic zegt over de alignment- en veiligheidsprofielen, en wat het kost.
Opus 5 is de nieuwste release in de Opus-klasse van Anthropic, die qua topcapaciteit onder Mythos valt, maar boven Sonnet en Haiku.
Anthropic zegt dat het nieuwste model “doordacht en proactief” is (ze vermenselijken het altijd een beetje). Ze zeggen ook dat het model is gebouwd voor dagelijks gebruik, wat voor een AI-engineer betekent dat het efficiënt genoeg is om continu te draaien.
Op codeer- en kenniswerk-evaluaties zoals Frontier-Bench en GDPval-AA zegt Anthropic dat Opus 5 nu state-of-the-art is binnen hun modellen, al blijft het specifiek achter op Mythos 5 bij cybersecurity-taken, waar we uitgebreid op ingaan in ons Mythos 5-artikel.
Wil je het model head-to-head zien tegen concurrerende en verwante modellen, bekijk dan onze vergelijkingsgidsen:
Twee dingen springen eruit in hoe Anthropic het nieuwe model zelf neerzet: een verschuiving naar taken echt afronden in plaats van stoppen bij een plausibel ogend antwoord, en een sprong in de kwaliteit van visuele output.
De grootste kwalitatieve verandering in Opus 5 is de bereidheid om door te werken tot een taak echt slaagt. Anthropic schetst hoe dat eruitziet:
Die bereidheid om te blijven itereren in plaats van genoegen te nemen met een plausibel antwoord lijkt de reden achter Opus 5’s sprong op agentische benchmarks zoals Frontier-Bench.
Anthropic benadrukt ook dat Opus 5 aanzienlijk sterkere visuele output kan leveren dan eerdere modellen, en verwijst naar voorbeelden zoals een windtunnelachtige visualisatie van luchtstroming over aerodynamische objecten, zoals een auto. Het was een overtuigend voorbeeld, en goed nieuws als jouw werk het bouwen van generatieve diagrammen omvat.
Deze tabel bevat alleen de modellen van Anthropic zelf. Ik heb hun respectieve releases bekeken en op één lijn gelegd wat mogelijk was. In de volgende sectie vergelijk ik Opus 5 met concurrerende modellen.
Opmerking: “niet bekendgemaakt” of “niet gepubliceerd” betekent dat dat model niet was opgenomen op die specifieke benchmark in de release waar het vandaan komt, niet dat het nul scoorde.
| Benchmark | Haiku 4.5 | Sonnet 4.6 | Opus 4.7 | Opus 4.8 | Sonnet 5 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|---|---|
| SWE-bench Verified | 73.3% | 79.6% | 87.6% | 88.6% | — | 95.0% | 96.0% |
| SWE-bench Pro | — | 58.1% | 64.3% | 69.2% | 63.2% | 80.3% | 79.2% |
| Terminal-Bench | 41% | 67.0% (2.1) | 69.4% (2.0) | 74.6% (2.1) | 80.4% (2.1) | 88.0% (2.1) | niet gepubliceerd |
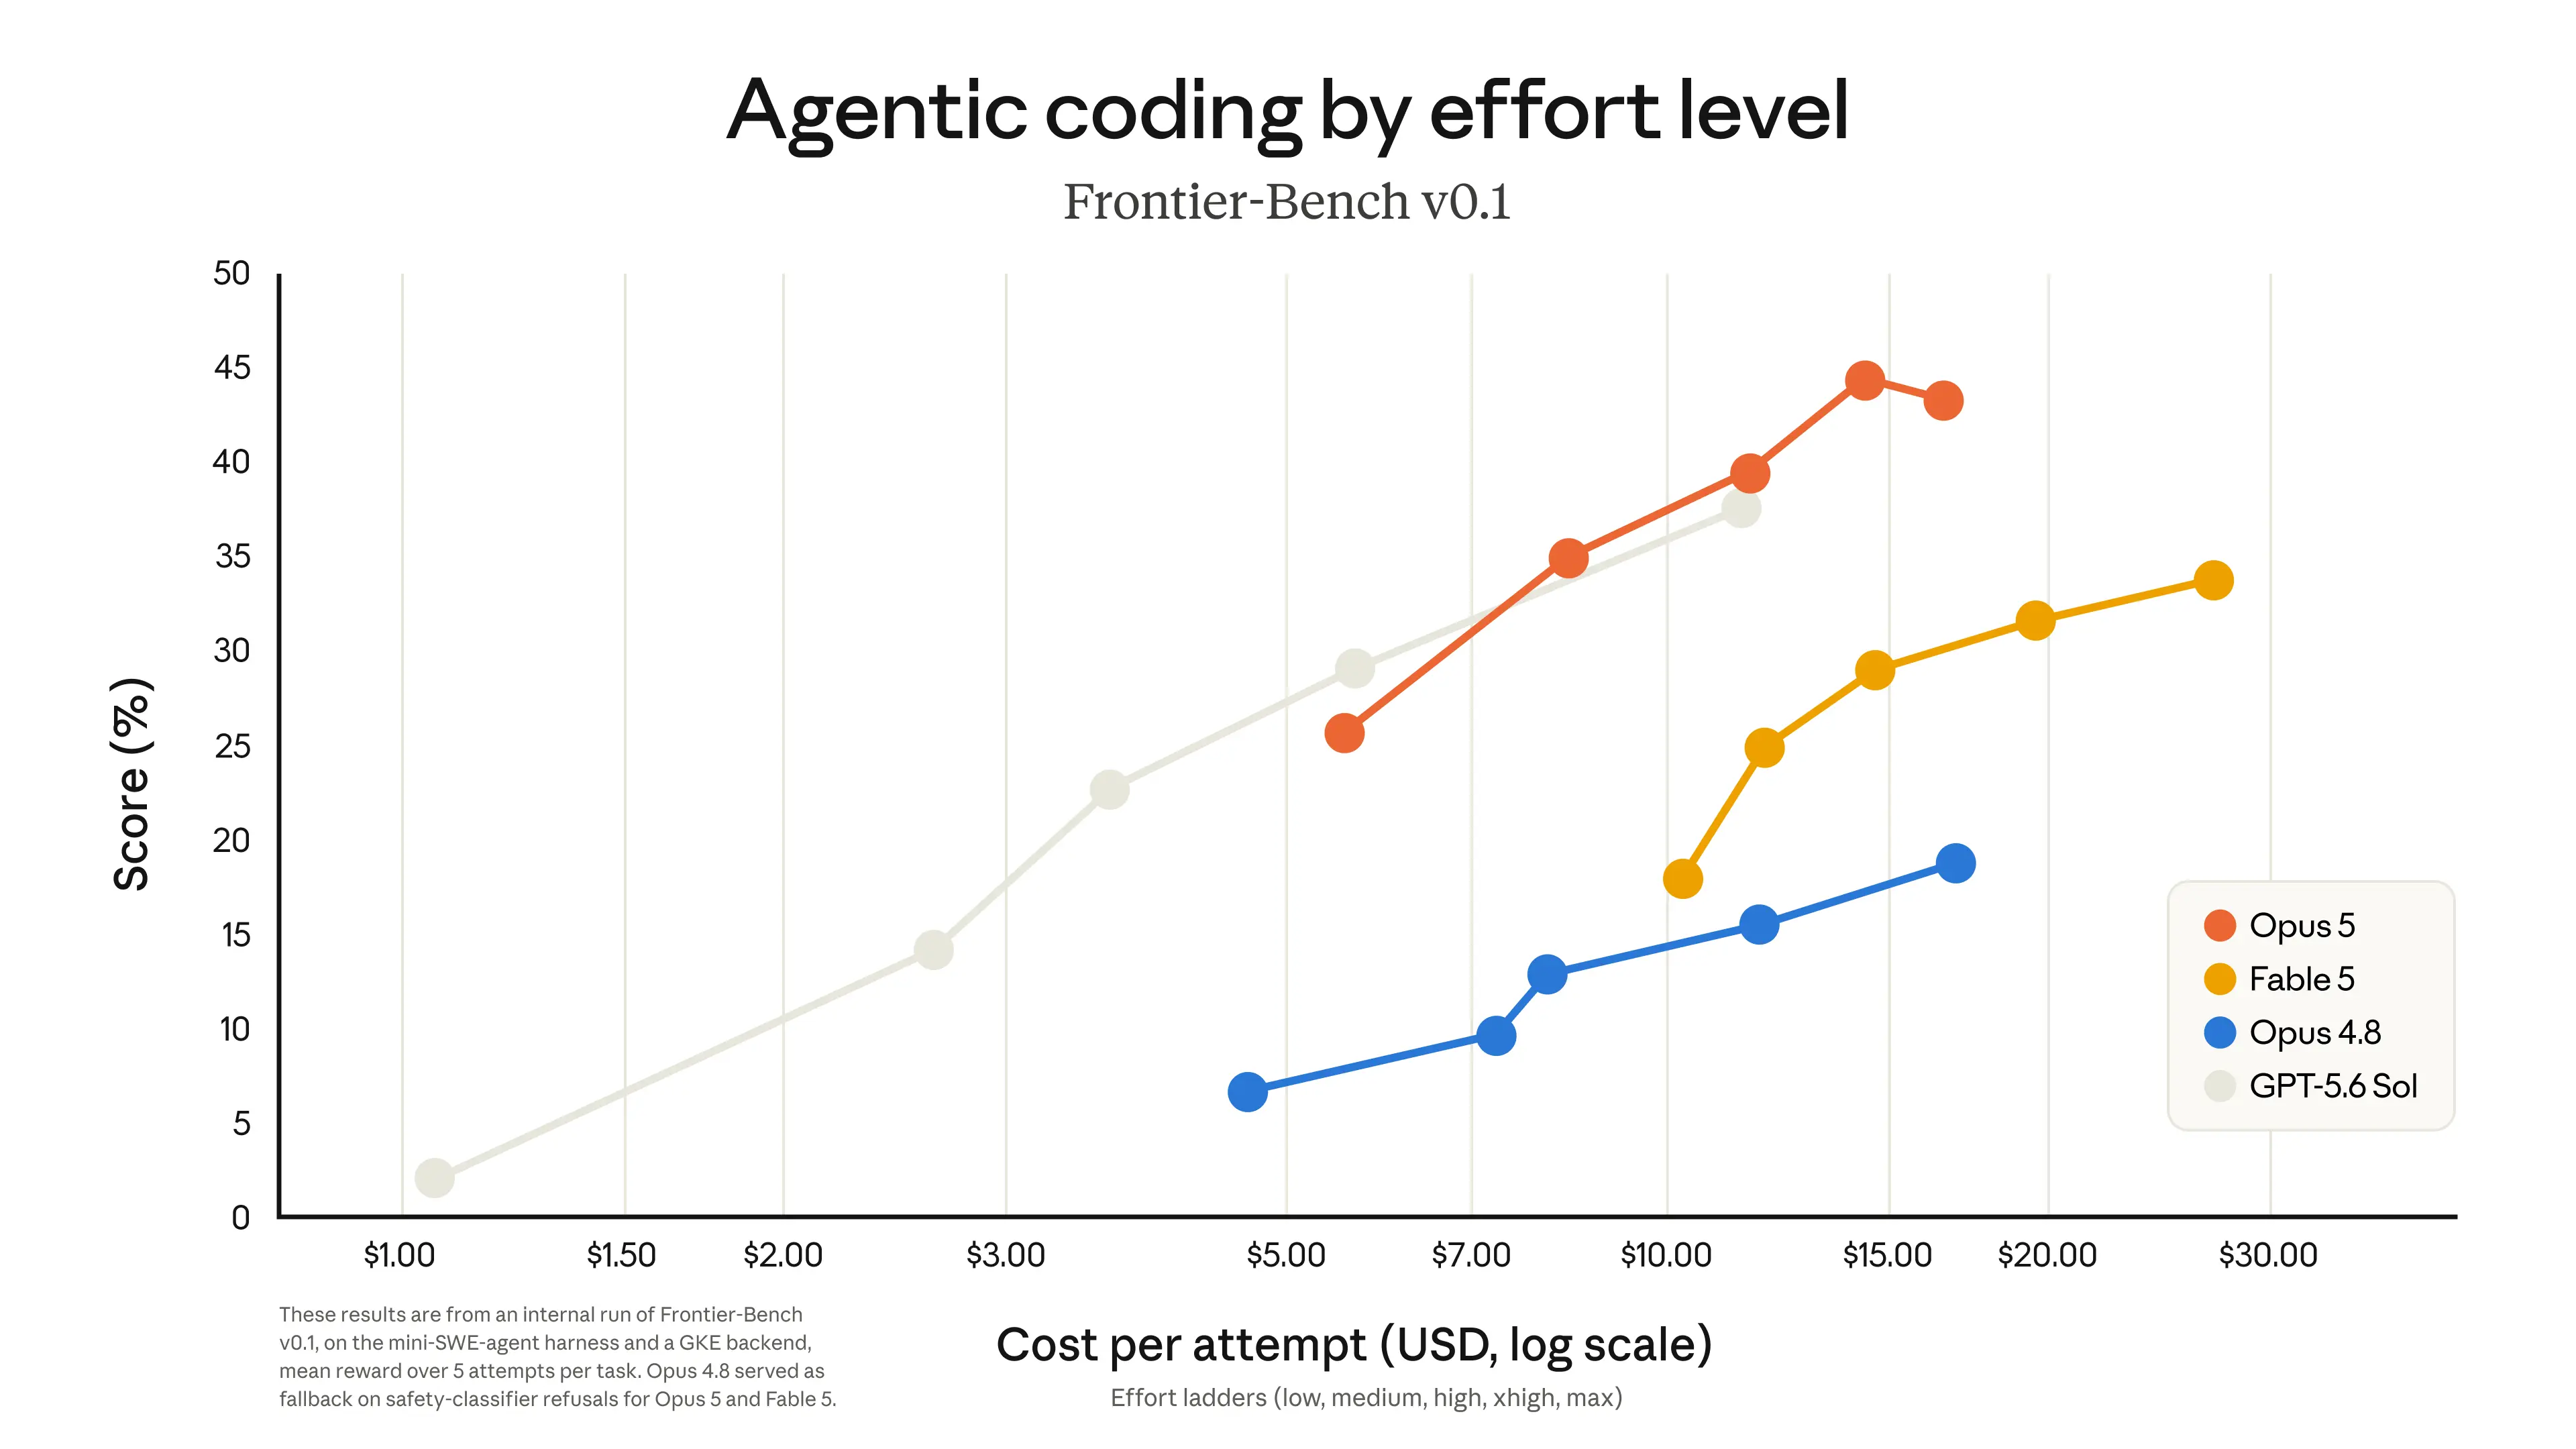
| Frontier-Bench v0.1 (nieuwe evaluatie) | — | — | — | 18.7% | — | 33.7% | 43.3% |
| GDPval-AA / v2 (Elo, /2000) | — | — | 1.753 | 1.890 (v1) / 1.593 (v2) | 1.618 (v2) | 1.747 (v2) | 1.861 (v2) |
| Audit misaligned gedrag (lager = beter) | — | — | — | niet bekendgemaakt | niet bekendgemaakt | niet bekendgemaakt | 2,3 (beste tot nu toe) |
| Prijs ($/MTok in/out) | $1/$5 | $3/$15 | $5/$25 | $5/$25 | $2–3/$10–15 | $10/$50 | $5/$25 |
In de tabel hierboven zie je dat Opus 5 zijn duurdere broer daadwerkelijk verslaat op Frontier-Bench v0.1 (43,3% vs. 33,7%) en GDPval-AA v2 (1861 vs. 1747) — opnieuw voor de helft van de prijs van Fable 5.
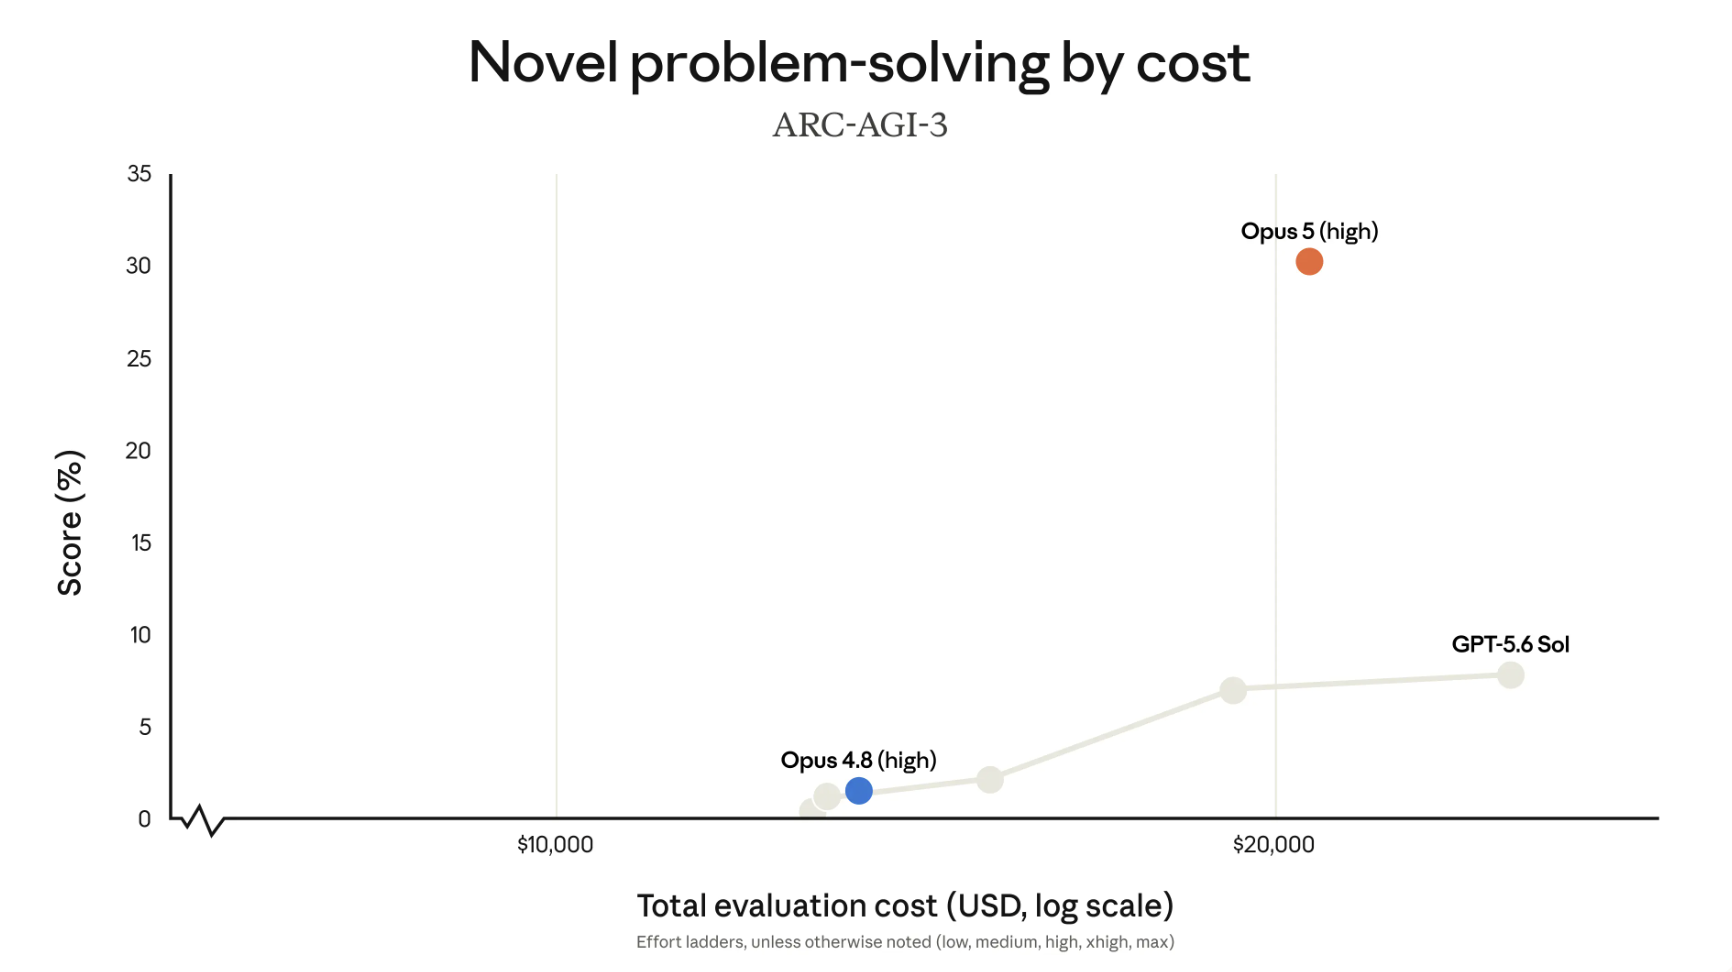
Dit is de duidelijkste generatie-sprong: Opus 5 loopt voor op zijn voorganger op ARC-AGI-3, dat stijgt van 1,5% naar 30,2%, en op Frontier-Bench v0.1, dat — zoals je in de tabel hierboven ziet — meer dan verdubbelt (43,3% vs. 18,7%). Bedenk dat Opus 4.8 pas twee maanden geleden is uitgebracht.
De volgende vergelijking is samengesteld door benchmarkresultaten rechtstreeks te halen uit de modelaankondigingen van Anthropic, OpenAI en Google. Ik heb ervoor gekozen rijen op te nemen waar genoeg modellen een gepubliceerde, vergelijkbare score hadden om de rij betekenisvol te maken. Benchmarks die alleen als vage relatieve claims werden gerapporteerd, heb ik weggelaten.
| Categorie | Benchmark | Claude Opus 5 | GPT-5.6 Sol | GPT-5.6 Sol Ultra | GPT-5.6 Terra | GPT-5.6 Luna | GPT-5.5 | Gemini 3.6 Flash | Gemini 3.5 Flash-Lite | Gemini 3.5 Flash | Gemini 3.1 Pro Preview |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Kenniswerk | GDPval-AA v2 (Elo) | 1861 | 1736 | — | 1593 | 1591,8 | 1493,7 | 1421 | — | 1348,8 | 962,3 |
| Coding | SWE-Bench Pro | 79,2% | 64,6% | — | 63,4% | 62,7% | 59,4% | — | 54,2% | — | 54,2% |
| Coding | DeepSWE v1.1 | 68,8% | 72,7% | — | 69,6% | 67,2% | 67% | 49% | — | 37% (baseline) | 11,8% |
| Coding | Terminal-Bench 2.1 | — | 88,8% | 91,9% | 87,4% | 84,7% | 85,6% | — | 54% (vs 3.1 Flash-Lite baseline 31%) | — | 70,7% |
| Coding | Frontier-Bench v0.1 (terminal coding) | 43,3% | 37,5% | — | — | — | — | — | — | — | — |
| Computergebruik | BrowseComp | 90,8% | 90,4% | 92,2% | 87,5% | 83,3% | 84,4% | — | — | — | 85,9% |
| Computergebruik | OSWorld 2.0* | 70,6% | 62,6% | — | 50,2% | 45,6% | 47,5% | — | — | — | — |
| Abstract redeneren | ARC-AGI-3 | 30,2% | 7,78% | — | 0,8% | 0,18% | 0,43% | — | — | — | 0,42% |
| Toolgebruik | AutomationBench | 26,0% | 18,1% | — | 15,2% | 14,9% | 12,9% | — | — | 14,5% |
— |
Ik moet erbij zeggen: elk getal hier is zelf gerapporteerd door het lab dat het model heeft uitgebracht, uitgevoerd op de eigen evaluatieharnassen, promptopzet en (in sommige gevallen) inspannings- of redeneerniveaus van dat lab.
Opus 5 leidt op de lastigere, meer nieuwe redeneertaken (ARC-AGI-3, Frontier-Bench, AutomationBench), terwijl GPT-5.6 Sol iets voorligt op meer gevestigde codeerbenchmarks zoals SWE-Bench Pro en DeepSWE. Dit kan erop duiden dat Opus 5 een voordeel heeft bij open-einde of minder getemplate probleemoplossing, terwijl Sol sterk oogt op goed gedefinieerde, zwaar getrainde codeertaken.
Google’s recente release richt zich op Flash-tier, kostenefficiënte modellen in plaats van een frontier-vlaggenschip, dus de meeste rijen hebben of geen Gemini-data of alleen Flash/Flash-Lite-cijfers die ruim achterblijven bij zowel Opus 5 als GPT-5.6. Deze vergelijking zegt meer over de modelklasse dan over Google’s frontiercapaciteit.
Waar de twee vlaggenschepen overlappen, leidt Opus 5 op nieuwe redeneer- en agentische taken (ARC-AGI-3, BrowseComp, OSWorld 2.0, AutomationBench), terwijl GPT-5.6 Sol iets voorligt op long-horizon coding (DeepSWE). Sol Ultra, Terra en Luna duiken vooral op bij aparte codeerbenchmarks waar Opus 5 geen gepubliceerde score heeft, dus dit is eigenlijk “Anthropic’s ene vlaggenschip vs. OpenAI’s volledige familie” in plaats van een zuivere één-op-één vergelijking.
Opus 5 is per direct beschikbaar op de platformen van Claude voor dezelfde prijs als zijn voorganger:
Fast-modus draait op ongeveer 2,5x de standaardsnelheid, geprijsd op tweemaal het basistarief van Opus 5 op het Claude Platform (of via gebruikskredieten in Claude Code) — dezelfde structuur als Opus 4.8.
Developers kunnen het model benaderen via de API met de modelstring claude-opus-5.
Twee gerelateerde features lanceren in bèta naast Opus 5:
Net als bij eerdere Opus-releases kent Opus 5 geen vereisten voor gegevensretentie voor algemene toegang.
Als het voelt alsof we de laatste tijd veel schrijven over Claude-modellen, dan komt dat omdat het zo is. Anthropic richt zich sterk op snelle verbeteringen om modelcapaciteit en efficiëntie te optimaliseren.
Nu heeft Anthropic iets neergezet dat over het geheel genomen beter is dan hun eerdere topmodel, Fable 5. Het komt met een beduidend lagere prijs, en tegelijkertijd rapporteren ze hun beste alignmentcijfers tot nu toe.
Wat is de volgende stap? Nou, het Haiku-model is het oudste Anthropic-model, en we wachten nog op een upgrade naar de 5-serie. Dat is één gok voor wat eraan komt, maar Anthropic blijft ons verrassen.
Leren met DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

